PAPER DEEP DIVE
IdeaScientist:科研构思智能体编排
自动科研系统大多把提出想法与实现、实验、写作耦合在一起,难以判断成功究竟来自想法还是执行。IdeaScientist 把科研构思剥离为独立任务:给定问题定义与当前方案未满足的挑战,产出有据的研究提案。系统由 orchestrator 协调三个子智能体——gap finder 在同问题先前工作中定位方法论缺口,innovator 到其他领域寻找解决过同类挑战的机制并迁移,report writer 把存活的直觉写成完整提案;每个角色用异步 GRPO 与参考锚定的 rubric 奖励单独训练。为支撑跨域检索与时间可控评测,作者构建 Svalbard Idea Vault:从 470 万篇 arXiv 论文中分解出 277 万条(问题、挑战、缺口、直觉、提案)五元组,并以 2026-01-01 为截止线,用截止后 14,977 篇方法论文中的 277 篇做留出测试。在 Qwen3.6-27B 上,IdeaScientist 总分 74.6%,比最强开源 autoresearch 基线高 14.0%,优势主要来自新颖性;在同一开放骨干上还超过 Claude Code SDK(Claude-4.8-Opus)5.9%、Codex SDK(GPT-5.4)5.1%。
论文:IdeaScientist: Orchestrating Agents for Grounded Scientific Ideation(arXiv:2610.04074,arxiv.org/abs/2610.04074,2026-10-02 提交)
作者:Jiarui Liu、Renjie Tao、Yiwei Liao、Chuanyang Jin、Kai Sun、Xiao Yang、Xinyuan Zhang、Xilun Chen、Zhuangqun Huang、Lechen Zhang、Yongjin Yang、Yinghui He、Weihao Xuan、Rakesh Wanga、Anuj Kumar、Mona T. Diab、Wen-tau Yih、Xin Luna Dong(Carnegie Mellon University、Meta Reality Labs;通讯作者 Jiarui Liu)
代码:github.com/jiarui-liu/IdeaScientist(已开源:ideation harness、Svalbard Idea Vault 构建、RL 奖励、训练与评测六类入口,CC BY-NC 4.0;论文明说消融臂、人类研究与 LaTeX 制表脚本不发布) 数据:Svalbard Idea Vault
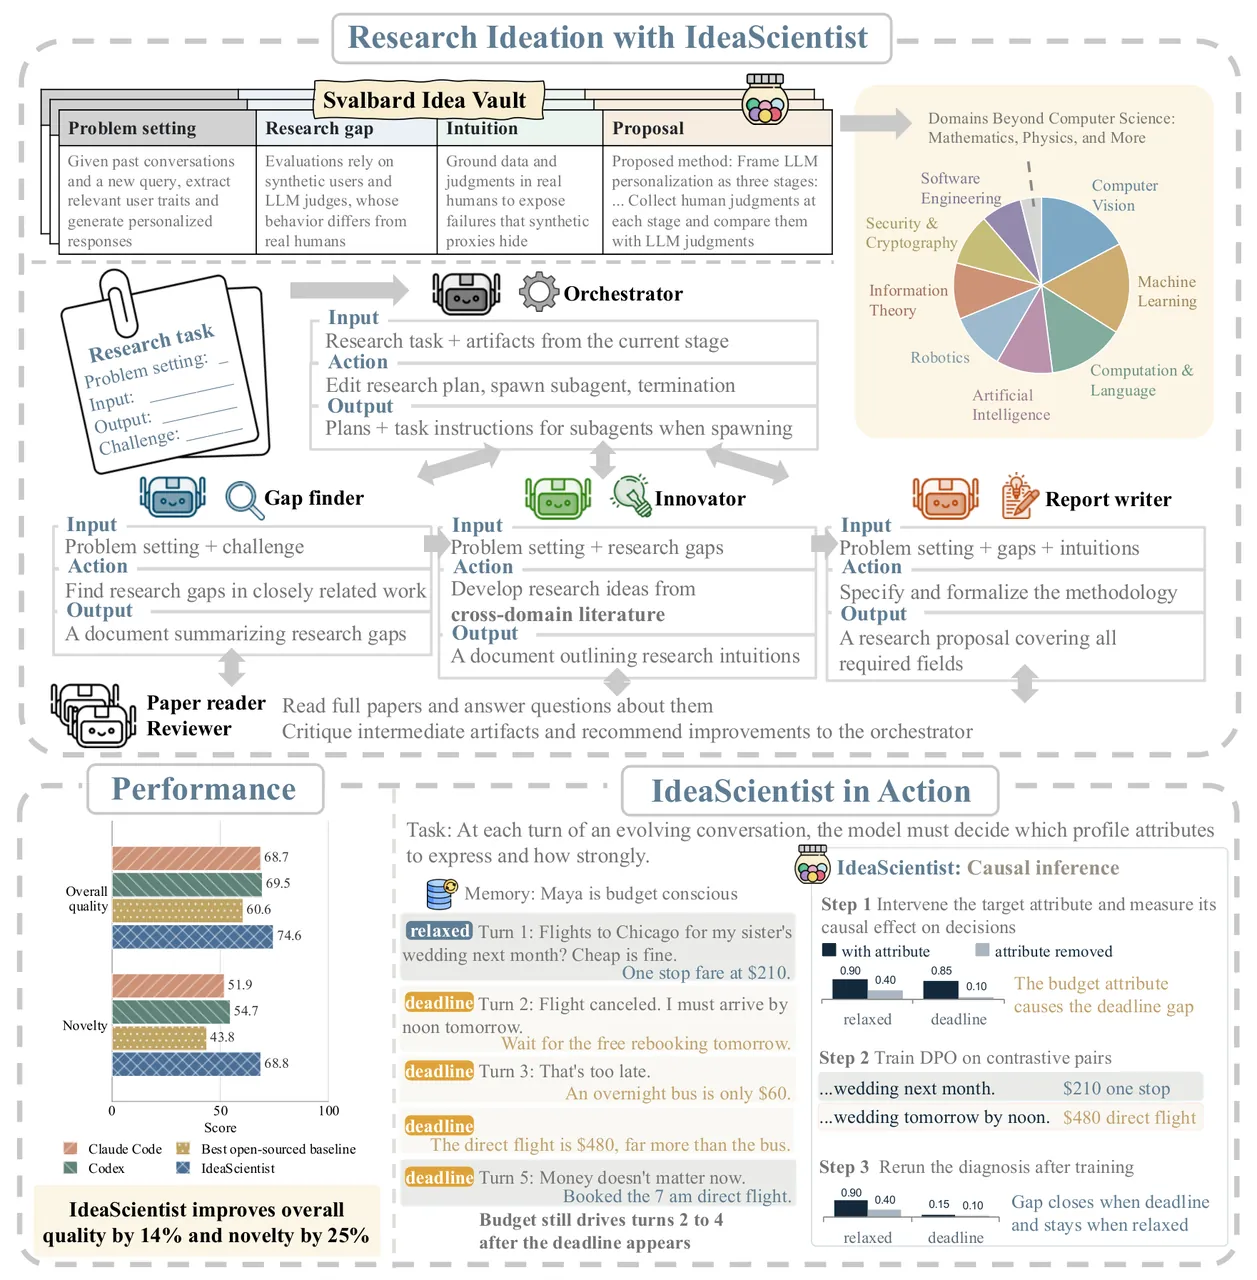
图 1:IdeaScientist 总览。上:Svalbard Idea Vault 把每篇论文分解为问题设定、挑战、研究缺口、直觉与提案五个结果掩码视图;中:orchestrator 只维护研究计划并调度 gap finder、innovator、report writer 与 reviewer,全文只由 paper reader 在隔离上下文里读;下:性能条与一个在途示例,展示跨域机制迁移如何改写提案。
一句话总结
IdeaScientist 把「科研构思」从自动科研中剥离出来,作为可以单独训练、单独评测的任务:orchestrator 指挥 gap finder、innovator、report writer 三个各自用 GRPO 训过的子智能体,借助 Svalbard Idea Vault 中 277 万条分解后的研究想法做跨域检索,在 Qwen3.6-27B 上以 74.6% 的总分超过最强开源 autoresearch 基线 14.0%,并在同一开放骨干上压过 Claude Code SDK(Claude-4.8-Opus)5.9%、Codex SDK(GPT-5.4)5.1%。
研究背景与动机
自动科研(AutoResearch)的进展大多发生在下游。现有系统把「提出解决方案」与实现、实验、写作耦合在一起,于是很难判断一次成功究竟来自好的研究想法,还是来自强的下游执行。前沿实验室自己也在报告这种不对称:OpenAI 称其「automated research intern」聚焦人类指挥下的 well-defined 任务,而高层规划只占 agent 输出的极小比例。构思这一半,恰恰是自动化程度最低的一半。
本文把研究构思形式化为一个独立任务:给定问题定义(任务输入与期望输出)加上一个当前方案未满足的挑战,产出一份有据的研究提案。挑战可以指向输出或过程的任何 desideratum:质量差、推理延迟高、隐私风险等。作者提出两个问题:其一,agent 如何为开放研究问题生成高质量提案;其二,当 plausible 的解很多且没有唯一正解时,如何在实验之前可靠地评测这些提案。
研究想法从哪来?论文的答案扎根于认知科学与心理科学的一个反复出现的观点:新颖性来自以新的方式连接既有知识;当两个问题共享同一种底层结构时,为一个问题发展的解可以迁移到看似无关的另一个问题(Mednick, 1962;Uzzi et al., 2013;Gentner, 1983;Gick & Holyoak, 1983;Loewenstein et al., 1999)。因此 IdeaScientist 不从同域先前工作中取洞察,而是从「在别的领域解决过同类挑战」的工作中取。
论文给的例子很具体:web search 用低成本检索先取候选集、再上精排器来降延迟;推荐系统面对同样的延迟挑战时,用的正是同一种两阶段结构——一阶段过滤在前,细粒度打分在后。机制不同、领域不同,但「先便宜地缩小候选、再昂贵地精挑」这一结构是共享的,所以可以迁移。整篇方法就是把这个直觉做成可执行、可训练、可评测的流程。
已有路线各自付了代价。端到端 autoresearch 系统的目标通常奖励实验选择或下游成功,把提案质量与 coding、实验结果纠缠在一起;用执行反馈监督构思更直接,但昂贵且把构思与实现能力混为一谈。评测侧,reference-free rubric 依赖 LLM judge,而 judge 会分歧、会 self-preference、会奖励风格特征;learned reviewers 估计的是「像不像会被接收」;factuality 指标只测声明是否被引用证据支撑。专家研究还发现,更高的新颖性在真实执行中可能以可行性为代价。
训练侧同样棘手:提案不像代码那样有可直接验证的奖励。基于 rubric 的强化学习把定性标准变成标量监督,但单一的 proposal 级 rubric 信用分配很弱,还招 reward hacking。多智能体设置下,先前方法要么在共享 terminal objective 下做角色 specialization,要么把多条轨迹蒸馏进一个 policy,结果说不清到底是哪个推理阶段变好了、specialization 是否活到部署。IdeaScientist 的回答是:把构思拆成有明确输入输出的阶段,每阶段用从人类论文重建的参考 artifact 单独训练,再放回完整 agentic loop 里重组。
预备知识
结果掩码记录。Svalbard Idea Vault 里每篇论文被压成一条 results-masked record:研究问题、方法、模型设计、related work 与局限性都保留,但所有实测结果被移除,只留下作者「提出的」评测与他们方法隐含的可证伪预测。一条记录因此描述人类团队打算往哪个方向做,而不透露这个方向是否成功。从该记录派生四个散文视图:problem_definition、challenge、intuition、solution,它们既是检索空间,也是参考 artifact 的构建单元。
时间截止与留出方向。截止线设为 2026-01-01。截止后的 14,977 篇方法论文是 post-cutoff targets:一部分用来生成训练数据(agent 只拿问题定义与挑战,产出提案后与目标论文的真实解对比,得到监督信号),其余留出评测。因为评测时 agent 不能检索截止后文献,这个设计测的是「在一个研究方向出现之前,能否推断出这个方向」。
GRPO 与角色奖励。三个生产者各训一个 LoRA adapter,用异步 Group Relative Policy Optimization(GRPO)。奖励不是单一 proposal 级标量,而是参考锚定的 rubric:既评生成 artifact 自身的独立质量,也评它与对应人类参考在实质研究决策上的一致性,再加一个确定性的引用集合 F1。
方法详解
harness:五个角色与一条 artifact 链
IdeaScientist 把研究构思分解为三个生产者子智能体,由一个 orchestrator 协调:gap finder 检查目标域 closely related 的先前解,找出让挑战未被解决、甚至被放大的共享方法论局限;innovator 到其他 problem setting 寻找解决过同类挑战的机制并适配到目标场景;report writer 把存活下来的直觉发展成完整提案。orchestrator 维护不断演化的研究计划并决定下一步调用谁,允许在需要更多证据或 refinement 时回到 earlier stages。
角色之间的接口是文件,不是对话。gap finder 写 gaps.md:每个被指派的 axis 一节,含 prior work 的机制级总结与至多两个 gap;每个 gap 必须填对比句式(先前方法通过 Y 做 X,但 Y 留下方法级问题 Z 未解决)、near-miss 方法与覆盖情况、方法论缺陷的种类标签(missing mechanism、algorithmic limitation、wrong inductive bias、credit-assignment flaw、training-objective mismatch、representation limitation、scalability limit)、why it matters,以及 evidence route——能证明未来方法闭上这个缺口的可观察证据,但不许提案。
innovator 写 candidates.md,每次调用追加一个 candidate 块:一句话直觉、它攻击的 gap、source inspiration(源论文 id、借用的机制、novelty 类型三选一:new topic、recombination of distant concepts、reinforcing a weak connection)、到本问题的 plain-language 映射(明确禁止 pseudocode、公式、架构与超参)、why it could work 与必须成立的关键假设、相对最近同域工作的差异、以及最可能让直觉失败的主风险。report writer 输出单个 JSON 对象 report.json,走 results-masked schema:标题、30 词内且不含指标数字的一句话 thesis、core problem、key novelty、problem definition、related work、method、model details、与 SOTA 的逐条差异、作为计划的 proposed evaluation(无实测结果)、falsifiable predictions 及其 refutation conditions、三到五条 limitations;所有引用一律 inline database id。
全文阅读被隔离在第二层。paper reader 在独立的单轮上下文里接收一篇论文的全文(单次 30,000 token 上限),做 targeted QA 后把 digest 返回给请求者;一层 agent 的上下文里永远没有全文。仓库 README 说这条是在 tool-availability 层强制的,而不是靠 prompt:full-text cap 为 0 的角色根本拿不到那个 tool。reviewer 是第二层的另一个角色,写 scores.md:verdict 取 survive、revise(点出最弱维度)或 reject,evidence 每条 bullet 必须带 paper id,外加一句 strongest objection。
检索只有一个 keyword-search 接口,但两种使用 regime,区别在于角色如何措辞查询。gap finder 被指派一个 challenge axis,被要求发 4 到 8 条用该 axis 与目标问题定义的精确术语措辞的查询,返回池薄就换说法重查,目标是把 same-challenge、same-problem 的 prior art 收全——它的 gap schema 要求 near-miss 论文与各自差在哪,只有这种 regime 才填得出。innovator 被要求发 6 到 10 条查询,刻意离开问题自己的 sub-field、跨至少三个不同 sub-field 去猎可迁移机制;同域来源只有当迁移 non-trivial 而非最近工作的 rediscovery 时才允许。reviewer 用 gap finder 的 regime,因为它的任务是拿同问题 prior art 证伪新颖性声明;report writer 按它要 grounding 的声明选 regime,因为它既要引被 displaces 的 related work,也要引机制的来源。
orchestrator 的 action space 刻意窄:只维护计划与调度角色,正因此作者不训它。若它在最终提案存在前试图停止,最多收到 8 条 continuation prompt;生产者若没往必需 artifact 写满 20 个非空白字符就想返回,最多收到 3 条 completion prompt;每个一层子智能体每任务至多请求 20 次 paper reading,并受角色 turn 上限约束。
flowchart TD
  TASK[Research task
problem definition plus challenge axes] --> ORCH[Orchestrator
owns plan.md only, cannot search or read]
  ORCH --> GF[Gap finder
4 to 8 exact-terminology queries
writes gaps.md, at most 2 gaps per axis]
  GF --> ORCH
  ORCH --> IN[Innovator
6 to 10 cross-domain queries
writes candidates.md with source ids]
  IN --> RV[Reviewer
falsifies novelty against same-problem prior art
writes scores.md verdicts]
  RV --> ORCH
  ORCH --> RW[Report writer
results-masked report.json
falsifiable predictions plus limitations]
  RW --> ORCH
  ORCH --> OUT[Grounded research proposal]
  VAULT[Svalbard Idea Vault
2.77M decomposed ideas
retrieval cutoff 2026-01-01] --> GF
  VAULT --> IN
  VAULT --> RW
  READER[Paper reader
isolated single-turn full-text context
30000 token cap per read] --> GF
  READER --> IN
  READER --> RW
图 2:harness 的控制流。orchestrator 不读论文,只读子智能体写的文件;每个阶段的 artifact 是阶段间的全部接口,也是各角色可以单独训练的原因。
训练:每角色一个 LoRA,参考锚定的 rubric 奖励
为什么分开训?作者最初的设计是用最终提案奖励训整条 pipeline,但 base model 很少走完整条 pipeline,多数样本拿不到有信息的信号。分角色训练避开这个冷启动:每个角色有明确的输入输出,人类论文又能提供可重建的参考 artifact,于是稀疏的 proposal 级结果被拆成阶段级学习信号,且不需要规定单一 tool-use 轨迹。训练与部署保持同样的输入、输出、信息访问与动作集合。
奖励由三个互补分量组成。参考无关分 $r_{\mathrm{free}}$ 由 LLM judge 评生成 artifact 的 specificity、methodological significance、feasibility 与 evidential support,衡量它脱离参考是否自洽成形。参考锚定分 $r_{\mathrm{ref}}$ 做 field-level 对比,衡量与人类参考在实质研究决策上的一致:core limitations、proposed method、evaluation design、related work,同时允许一个 valid alternative 拿高分。引用分 $r_{\mathrm{cit}}$ 是确定性集合 F1,衡量生成 artifact 引用的论文与参考引用的论文的重叠,捕捉文献 grounding 与检索上的一致。三者经有效性门组合成 rubric 奖励:
$$r_{\mathrm{rubric}}=g\cdot\left(\lambda_{\mathrm{free}}\,r_{\mathrm{free}}+\lambda_{\mathrm{ref}}\,r_{\mathrm{ref}}+\lambda_{\mathrm{cit}}\,r_{\mathrm{cit}}\right),\qquad \lambda_{\mathrm{free}}=\lambda_{\mathrm{ref}}=\lambda_{\mathrm{cit}}=1/3. \tag{1}$$
门 $g\in\{0,1\}$ 由 structural、task-compliance、citation-grounding、tool-validity 检查决定,gap finder 与 innovator 还加一条 judged methodological criterion。最终训练奖励再混入一个规则项:
$$r=0.85\,g\left(\frac{r_{\mathrm{free}}+r_{\mathrm{ref}}+r_{\mathrm{cit}}}{3}\right)+0.15\,r_{\mathrm{proc}}, \tag{2}$$
其中 $r_{\mathrm{proc}}$ 只罚协议违规(disallowed tool calls、invalid formats、missing required fields),不正向奖励搜索或阅读的体量——这一点直接对着「刷检索量」的 reward hacking。引用分即两个引用集合上的集合 F1:
$$r_{\mathrm{cit}}=F_{1}\left(C_{\mathrm{gen}},C_{\mathrm{ref}}\right)=\frac{2\,|C_{\mathrm{gen}}\cap C_{\mathrm{ref}}|}{|C_{\mathrm{gen}}|+|C_{\mathrm{ref}}|}. \tag{3}$$
每个角色的有效性门各不相同:gap finder 要求 schema 合法、落在被指派 axis 上、至多两个 gap、每个被引 id 可解析且本轮读过、judged methodological focus 满分;innovator 要求 schema 合法、一个建立在给定 gap 上的 candidate、同样的引用检查、judged methodological contribution;report writer 要求所有必需字段齐备加引用检查。门失败时 rubric 分量归零,但 $r_{\mathrm{proc}}$ 仍然可用,模型至少还能从「别违规」上学到东西。
附录 B.2 记录了两个被否掉的替代设计,都很有信息量。其一是 metadata-only digest 代替全文:该变体训练直接崩溃,mean reward 近零、多数 rollout 在初始化阶段就被截断,而全文 reader 的 mean reward 约 0.5;作者保留全文,用异步 GRPO 换吞吐,而不是靠缩短输入。其二是 pairwise innovator reward(逐字段问「是否比参考对应字段好」):它越来越偏好长而 elaborate 的回答,训练奖励冲到约 0.83 后反复崩溃,说明 judge 在独立于实质地奖励长度;绝对参考锚定 rubric 则稳定在 0.66 左右,于是保留。此外,gap depth 从软罚改成每 axis 硬上限两个 gap;report writer 从带 anchor 的参考列表改成裸 inline citation id,因为早期约一半 episode 挂在 read-before-cite 检查上;「拒绝任何数字串」的脆规则被换成 judged penalty(把预测陈述为实测结果才罚)。
优化配置(附录 E.1):每个 adapter 为 LoRA rank 32、缩放 $\alpha=64$、无 dropout,作用于除 output projection 与 visual tower 外的所有 linear 模块;AdamW,常数学习率 $5\times10^{-6}$,weight decay 0.01,无 warmup,梯度范数裁剪 1.0,bfloat16,tensor parallel 8,H100。每个 GRPO step 抽 64 个 prompt、每 prompt 8 条生成,共 512 条 rollout,每 step 做 2 次梯度更新、训练 batch 256;概率比 clip 为非对称 $[0.2,\,0.28]$,奖励中无 KL 惩罚,最大策略 staleness 一步并加 importance sampling 校正。序列长度与步数按角色校准:gap finder 最长 26,624 token、至多 2 epochs 或 800 步;innovator 30,720 token、至多 1 epoch 或 600 步;report writer 49,152 token、至多 2 epochs 或 600 步。每角色选 held-out 验证奖励最高的 checkpoint:gap finder step 380、innovator step 310、report writer step 194。judge 为 Qwen3.6-27B 关推理、temperature 0.7、top-p 0.8。每个角色训练用 40 节点 × 8 H100,其中 32 节点做策略优化、8 节点做异步 rollout 生成。
推理预算同样写死:gap finder 至多 15 turns、每 turn 8,192 token;innovator 至多 20 turns、每 turn 6,144 token;report writer 至多 20 turns、每 turn 16,384 token;orchestrator 全局至多 100 turns。三个 IdeaScientist-Base 对照(Qwen3.6-27B、Gemma-4-31B、GPT-OSS-120B)跑同样上限;开源 autoresearch 系统与通用 agent 跑自己的 native loop,不施加这些上限。
Svalbard Idea Vault:277 万条分解后的研究想法
语料用官方 arXiv API 构建,覆盖所有 subject area,好让 innovator 能向邻域借力;收录 1986 年至 2026-06-18 的论文,去重并尽量收全文;对 2026-01-01 及之后收录的论文再沿参考列表走一跳,把库里缺失的被引论文补进来。最终库含 470 万篇论文,其中 280 万篇(60%)有全文。对每篇论文做 idea decomposition:重建 problem definition 与 challenge 作为输入,重建三个链式参考 artifact 作为目标——methodological gap、research intuition、complete research proposal,正好对应三个生产者的输出。语料取名自 Svalbard Global Seed Vault:一座研究想法的种子库。
训练样本从 2026-01-01 之后发表的机器学习论文出发:初始 104K 候选,先保留有 LaTeX source 可下载、且超过 70% 被引工作在本库有可用全文者;再限制为方法类论文(贡献新方法、模型、算法、架构、训练过程或技术框架),排除 survey、position paper、dataset 与 benchmark、纯经验工程报告。过滤后剩 14,977 篇 target,随机切成 14,500 训练、200 验证、277 留出测试,三个角色共用同一 partition,于是一篇论文不会在一个角色那里是训练目标、在另一个角色那里是测试目标。Qwen3.6-27B 把每篇人类目标论文转成 results-masked proposal schema:保留研究问题、proposed method、模型设计、related work 与 limitations,移除所有实测结果。
参考 artifact 的产量分布值得记一笔:gap finder 阶段 Qwen3.6-27B 产出 14,970 条、GPT-5.4 补 7 条;innovator 14,934 与 43;report writer 14,951 与 26;三阶段合计 44,855 与 76,共 44,931 条,GPT-5.4 占比不足 0.2%。泄漏审计也做了:问题定义与挑战由完整目标论文重建,理论上可能残留方法线索;作者人工比对 50 个随机样本与其源论文,0/50 暴露目标方法——包括方法专属术语、假设、例子或会泄露解的问题分解。
实验结果
设置与指标
被测系统是 IdeaScientist-Base 与 IdeaScientist-Trained(Qwen3.6-27B 骨干,后者组合三个训好的 adapter)。对照分三族:通用研究 agent(Claude Code 配 Claude Opus 4.8、Codex 配 GPT 5.4);开源 autoresearch 系统,含端到端的 AutoResearchClaw、Dr. Claw、DeepScientist 与构思类的 ResearchAgent、CycleResearcher 配 DeepReviewer、SciAgents、AI-Researcher,骨干覆盖 Qwen3.6-27B、Gemma-4-31B、GPT-OSS-120B;以及同骨干上的 IdeaScientist-Base 自身。公平性安排:所有系统拿同样的问题定义与输出 schema、用同样的工具访问同一个离线论文库,目标论文隐藏、断网;端到端系统被指示「机器学习提案完成即停」,不继续实现或实验。
指标分两组。新颖性对三档文献测:All(相对完整对比语料中给出的 closest papers 的 1–10 判断)、Cutoff(只用截止前文献的同一判断)、In-domain(binary:提案是否从不同 problem setting 引入机制、并经共享底层结构适配;与另两档不同,它是 transfer 判断而非 1-10 比较)。提案质量按会议审稿常用的六维:relevance、clarity、specificity、actionability、soundness、impact,各 1–10 分。总分取两组均值之均值:
$$\mathrm{Overall}=\frac{1}{2}\left(\overline{\mathrm{Novelty}}+\overline{\mathrm{Quality}}\right). \tag{4}$$
检索消融额外报 Mechanism non-obviousness:第一次 judge 调用只拿目标问题、挑战与先前论文(绝不看提案),独立推导候选机制;第二次拿这批冻结候选加提案,判断是否有 ex-ante 候选能不靠 hindsight 新配方就达到提案的核心机制。四级映射到 $\{0,\,1/3,\,2/3,\,1\}$,对应 trivial combination、routine extension、non-obvious step、surprising;候选集非法则不评分并重试。主 judge 是 Qwen3.6-27B(关推理),另有 Claude-4.8、Gemma-4-31B、GPT-OSS-120B、GPT-5.4 四个 corroborating judge。
主结果:新颖性是主战场
277 篇留出测试上的主表里,IdeaScientist-Base 不训就已经有竞争力:对 Claude Code SDK(Claude-4.8-Opus)总分 77.7 对 68.7(+9.0),对 Codex SDK(GPT-5.4)71.9 对 69.5(+2.4);对最强同骨干基线的领先从 GPT-OSS-120B 上的 3.3% 到 Qwen3.6-27B 上的 12.9%。训练后,IdeaScientist-Trained 总分 74.6%,是最强开放系统,比 Qwen3.6-27B 上最好的基线高 14.0%。隔离的 held-out 角色评测显示训练确实在改进生产者本身:gap finder 验证奖励 56.6% 到 66.7%(+10.1),innovator 58.8% 到 69.5%(+10.7),report writer 78.6% 到 89.1%(+10.5);重组进 harness 后,Trained 比 Base 平均新颖性 +1.9%、平均提案质量 +0.4%。
| 系统(Qwen3.6-27B 组,除两行 SDK) | Novelty All | Cutoff | In-domain | Novelty Avg | Quality Avg | Overall |
|---|---|---|---|---|---|---|
| Claude Code SDK(Claude-4.8-Opus) | 68.3 | 70.4 | 17.0 | 51.9 | 85.5 | 68.7 |
| Codex SDK(GPT-5.4) | 72.4 | 71.8 | 19.9 | 54.7 | 76.1 | 69.5 |
| AutoResearchClaw | 52.2 | 50.9 | 18.4 | 40.5 | 74.6 | 57.6 |
| Dr. Claw | 47.5 | 47.5 | 18.4 | 37.8 | 73.9 | 55.9 |
| ResearchAgent | 46.1 | 44.5 | 11.2 | 33.9 | 75.0 | 54.4 |
| CycleResearcher | 49.9 | 48.8 | 10.5 | 36.4 | 75.8 | 56.1 |
| SciAgents | 44.7 | 44.3 | 9.0 | 32.7 | 73.9 | 53.3 |
| AI-Researcher | 54.6 | 56.7 | 19.5 | 43.6 | 75.3 | 59.4 |
| DeepScientist | 57.6 | 58.5 | 15.2 | 43.8 | 77.5 | 60.6 |
| IdeaScientist-Base | 66.0 | 67.1 | 67.5 | 66.9 | 80.0 | 73.5 |
| IdeaScientist-Trained | 67.3 | 68.3 | 70.9 | 68.8 | 80.4 | 74.6 |
表 1:论文 Table 1 的 Qwen3.6-27B 组与两行通用 SDK 对照(277 篇留出测试,Qwen3.6-27B judge)。In-domain 一列的断层是全文最醒目的信号:基线普遍在 9–20 分,IdeaScientist 两版在 67–71 分。
维度分解说明优势从哪来。平均提案质量上,Base 与最强基线持平或略高(Gemma-4-31B 上 +1.8% 到 Qwen3.6-27B 上 +2.5%);平均新颖性上的增益大得多,Qwen3.6-27B 上至 +23.1%,其中对全部文献 +8.4%、对截止前文献 +8.6%、对同域文献 +48.0%。相对自己研究域的新颖性要求跳出该域的既定做法,作者称这是最难的一种新颖性,也正是本方法站得最稳的地方。图 2(a) 显示这一优势横跨全部六个 domain group,Trained 的估计profile 在五个上超过 Base。
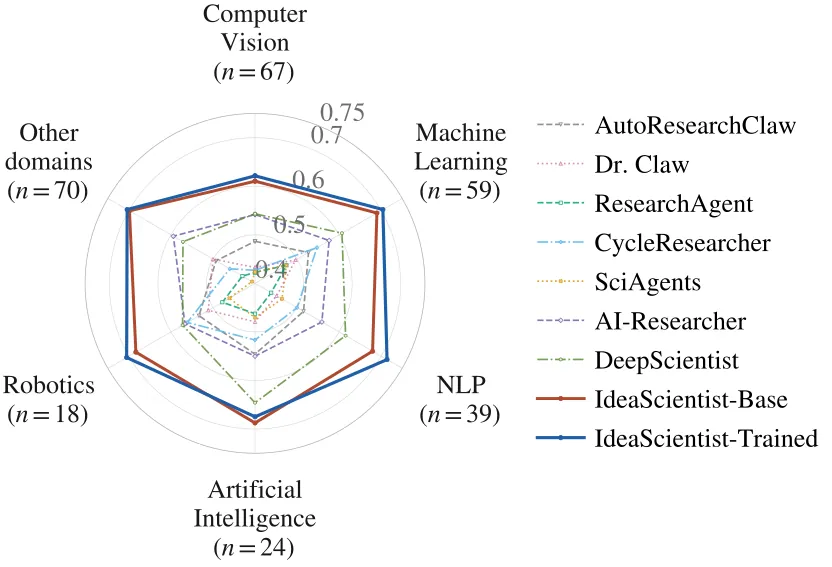
图 3:论文图 2(a)。Qwen3.6-27B 上六个研究域的提案新颖性雷达(括号内为各域测试论文数):IdeaScientist-Base 与 Trained 的外圈明显包住七个开源基线。
人类盲评给了独立佐证。作者在留出测试中随机抽 50 篇,每篇由两名标注者在系统名隐藏的条件下,把 IdeaScientist-Trained 的提案与同骨干其他系统(含 Base)的提案做配对比较:Trained 对除 DeepScientist 外的所有系统显著胜出;对 Base 的胜率更高但差异不显著。生成失败率也是同一方向:277 题中 Trained 与三个 Base 运行零失败,Claude Code SDK 有 5 题、Codex SDK 有 8 题拿不出可评分提案。
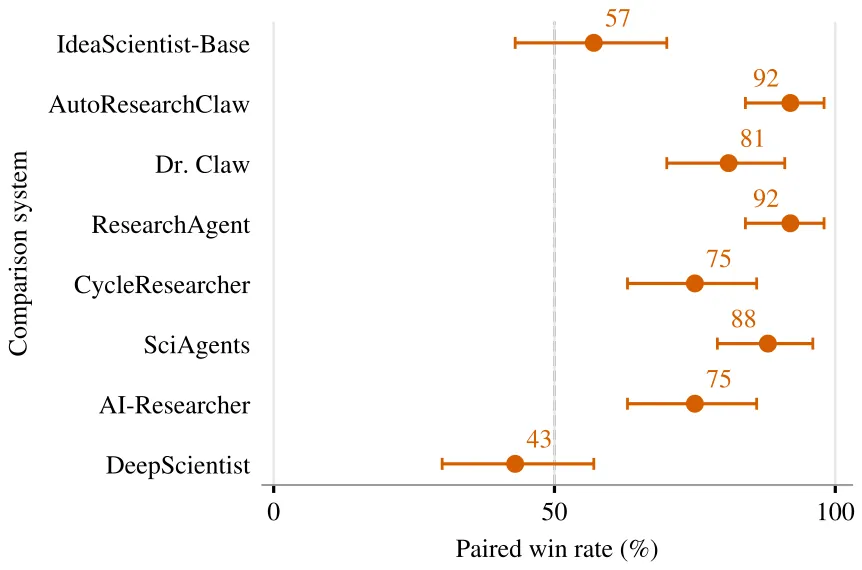
图 4:论文图 2(b)。50 篇配对盲评中 IdeaScientist-Trained 对各系统的胜率与 bootstrap 95% 置信区间:除 DeepScientist 外均显著过半,对 Base 的优势不显著。
案例研究(附录 I)解释了分数背后的行为差异:Trained 通常在「陈述的失败」与「用来解决它的机制」之间建立更紧的连接,关键决策规则从问题结构推出,使假设与预期效应更容易检验;基线则倾向引入 plausible 但 justification 较弱的控制规则。四个案例覆盖 composable safety alignment、adaptive rollout allocation、capability-grounded subagent abstention 与 adaptive multimodal speculative decoding,每例把人类方法、Base、Trained 与七个外部系统放在同一问题定义、同一模型设置下对比。
消融:每个子智能体与跨域检索都付了钱
子智能体消融比较三种配置:只有 Report Writer(能写提案的最小设置)、Report Writer 加 Gap Finder、再加 Innovator 的完整 pipeline。每加一个子智能体,All 与 Cutoff 新颖性都上升;Qwen3.6-27B 上 All 从 0.595 到 0.634 再到 0.660、Cutoff 从 0.594 到 0.640 再到 0.671,至多 +7.7%;较弱的 Gemma-4-31B 受益更多,至多 +13.0%。先识别研究缺口、再在缺口上创新,帮助系统到达仅凭问题陈述难以推导的想法。
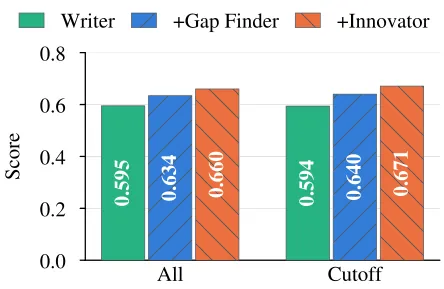
图 5:论文图 3(a)。Qwen3.6-27B 上的子智能体消融:Writer、Writer+Gap Finder、完整 pipeline 三档在 All 与 Cutoff 新颖性上单调上升。
检索范围消融直接检验「跨域」这个核心直觉:把 innovator 的检索限制在同域,与跨域对比。跨域检索在每一项新颖性上都更好:All +5.3%(0.605 到 0.658)、Cutoff +3.7%(0.623 到 0.660)、In-domain +30.7%(0.363 到 0.670);Mechanism non-obviousness 对两个变体都是最难的指标,跨域仍把它从 0.335 抬到 0.357(+2.2%)。换句话说,离开问题自己的 sub-field 去借机制,正是 In-domain 新颖性那 +48% 的来源。
| 新颖性度量(Qwen3.6-27B) | 同域检索 | 跨域检索(本文) | 差值 |
|---|---|---|---|
| All | 0.605 | 0.658 | +5.3% |
| Cutoff | 0.623 | 0.660 | +3.7% |
| In-domain | 0.363 | 0.670 | +30.7% |
| Mechanism non-obviousness | 0.335 | 0.357 | +2.2% |
表 2:论文图 3(c) 的读数。跨域检索的最大收益落在 In-domain 新颖性上,即「相对本域既有做法的新颖」。
| 角色 | 选中 checkpoint | Base 验证奖励 | Trained 验证奖励 | 差值 |
|---|---|---|---|---|
| Gap finder | step 380 | 0.566 | 0.667 | +0.101 |
| Innovator | step 310 | 0.588 | 0.695 | +0.107 |
| Report writer | step 194 | 0.786 | 0.891 | +0.105 |
表 3:论文 Table 11。三个角色在隔离的 held-out 评测上都提升约 0.10,说明 rubric 奖励确实把信号送到了对应阶段。
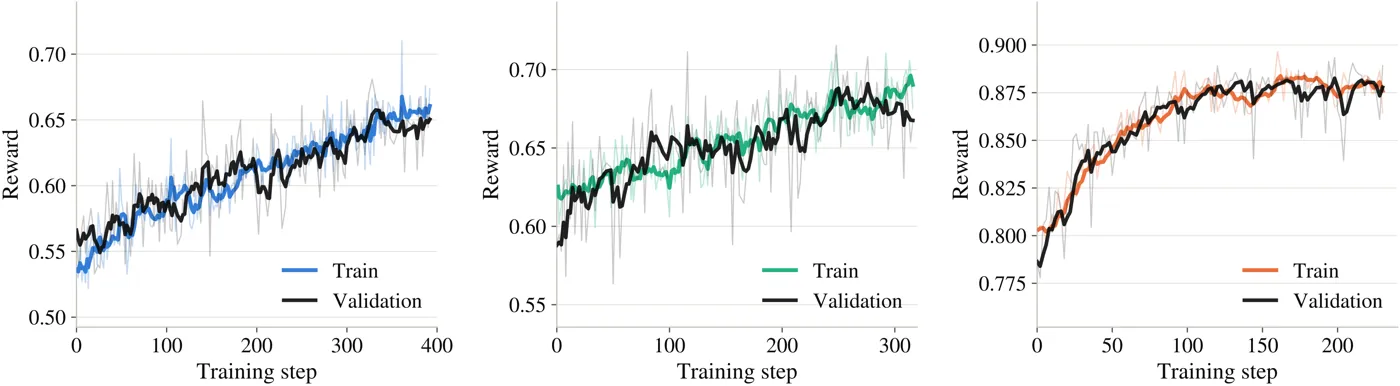
图 6:论文图 5。三个角色的 GRPO 训练奖励与 held-out 验证奖励曲线(左 gap finder、中 innovator、右 report writer)。
训练诊断还支持奖励设计本身:27,225 个 gap finder episode 的中位奖励 0.603,没有非正奖励;3,473 个 GRPO 组的平均组内标准差 0.104,仅 0.4% 的组零方差,即几乎每个采样组都提供可用学习信号。在选中的 gap-finder checkpoint 上,512 条训练 episode 的中位序列长度 17.8K token、p95 22.4K、最大 25.8K(上限 26,624),中位 6 turns 读 6 篇不同论文;奖励与序列长度(r=-0.024)、turns(r=-0.031)、读论文数(r=-0.017)基本不相关——模型不是靠写得更长或读得更多拿分。
评测可信度与计算量
LLM judge 的分数可信吗?作者让两名人类专家对 9 个系统生成的 50 份提案按同样维度打分。两个观察:其一,提案评分本来就主观,两位专家之间在单篇上的 Pearson 相关只有 r=0.56,与会议审稿的分歧程度相当;其二,各 LLM judge 与人类均值的相关和人类彼此的相关处于同一量级(top-3 judge 为 r=0.51 到 0.59),因此 LLM judge 是专家评估的合理代理。系统级排序上,Qwen3.6-27B 与 leave-one-out 共识的一致性仅次于 Claude-4.8,且两者差异不显著;其 self-preference bias 可忽略且低于 Claude-4.8,这是选它当主 judge 的理由。report 级与共识的 Pearson 一致为:Qwen3.6-27B 0.71、Claude-4.8 0.77、Gemma-4-31B 0.77、GPT-OSS-120B 0.67、GPT-5.4 0.78,五个 judge 都落在同一可靠带内。
计算量方面,Trained 每交付一份提案用 168,916 个 output token,比 Base 的 189,942 少 11.1%,所以增益不来自更大的生成预算。受控的 test-time compute sweep 在固定 40 篇子集上只改 per-role turn budget:从低档到高档,report-writer 奖励从 0.290 升到 0.465,completion rate(产出提案并通过有效性门的比例)从 0.60 升到 1.00,实际消耗的 orchestrator turns 从 34 升到 55,确认低档确实算力不足。上限放松后,更多 test-time compute 仍然提质量,与角色训练的增益互补。
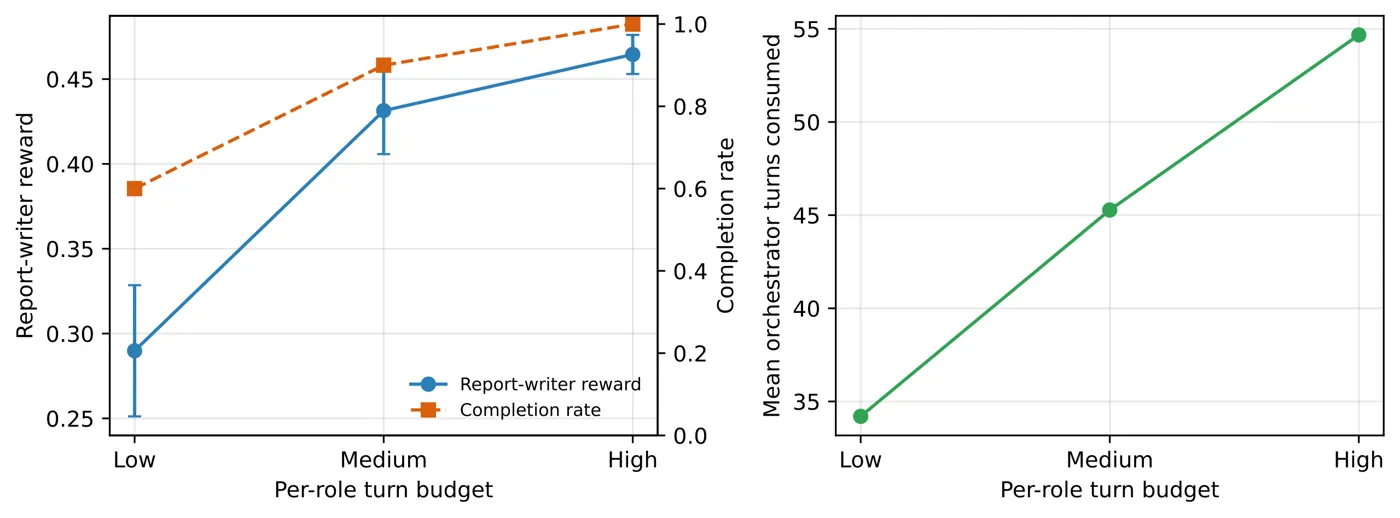
图 7:论文图 6。固定 40 篇子集上只变 per-role turn budget 的受控 sweep:左为 report-writer 奖励与 completion rate,右为实际消耗的 orchestrator turns。
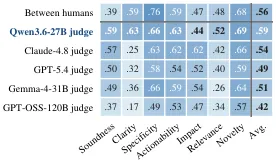
图 8:论文图 4(a)。两名人类标注者之间、以及各 judge 与人类均值之间的 Pearson 相关矩阵(末列为七维平均):judge 与人类均值的相关和人类彼此的相关同带。
局限性
作者自述的第一条局限是回顾式评测的残留模型记忆污染(附录 E.2):时间切分只控制检索,控制不了参数里的知识。作者对五个被评模型各做 10 篇截止后论文的 title-only probe(共 50 次查询,只给标题、不给摘要、不开检索),没有一个模型能把任何一篇识别或描述为已知工作;但作者明确说这查不出 latent、paraphrased 或 method-level 的记忆,因此不能排除污染。结果应解读为「受控检索截止下的表现」,而不是「每个被评模型在参数上都不知道目标论文」的证明。
第二条局限来自评测本身的性质,论文在 related work 与实验里都承认:所有质量分都是执行前代理。LLM judge 与人类专家在单篇上只有 r=0.56 的一致,说明「提案质量」并非稳定真值;而 §2.2 引用的专家研究发现,更高的新颖性在真实执行中可能以可行性为代价。IdeaScientist 的提案从不被执行,「grounded」指的是文献有据、机制可溯,不等于实验验证过的可行性。
本文的判断再补两条。其一,参考 artifact 与训练监督几乎全部由 Qwen3.6-27B 自己生成(GPT-5.4 只补 76/44,931),于是 $r_{\mathrm{ref}}$ 与 $r_{\mathrm{cit}}$ 的锚点继承该模型的偏好与盲区,训练在某种意义上是在向「自己老师的解题风格」对齐;judge 又同为 Qwen3.6-27B,尽管作者用四个外部 judge 与人类标注做了交叉验证。其二,In-domain 新颖性是一个 binary transfer 判断,依赖 judge 按四条 checklist(命名源 setting、引入具体机制、指出共享结构、说明适配)打分,边界案例敏感;而每角色 40 节点 × 8 H100 的训练成本与 470 万篇语料的分解质量,决定了这条路线的复现门槛与上限。
总结与展望
IdeaScientist 把科研构思 isolates 成一项可以独立于下游实现来训练与评测的能力:识别 closely related work 的方法论局限,到其他 problem setting 搜索可能解决同一挑战的机制,再把它发展成有据的研究提案。用 role-specific training 加上时间留出的人类论文作参考方向,它在每个构思阶段都取得改进,并成为 proposal 级评测中最强的开放系统。作者认为,结构化的 agent 环境能让科学构思变得 amenable to controlled learning and evaluation,而不是端到端 autoresearch 的一个不透明副产品;下一步是与 automated research-topic identification、automated experimentation 组合,走向更强的端到端自动科研。
对读者而言,这篇论文最有复用价值的部分是评测协议本身:一条时间截止线、一批留出的真实人类论文、一组交叉验证过的 judge、以及一个把「想法」与「执行」分开的任务定义。代码与 Svalbard Idea Vault 全量开源(harness、vault 构建、奖励、训练、评测六个命令行入口),复现的主要门槛在算力而不在物料。它也为「AI 科学家」方向提供了一个少见的可控基准:比的不是谁跑出了实验,而是谁在方向出现之前就想到了方向。
金句
「新颖性来自以新的方式连接既有知识;当两个问题共享同一种底层结构时,为一个问题发展的解,可以迁移到看似无关的另一个问题。」