
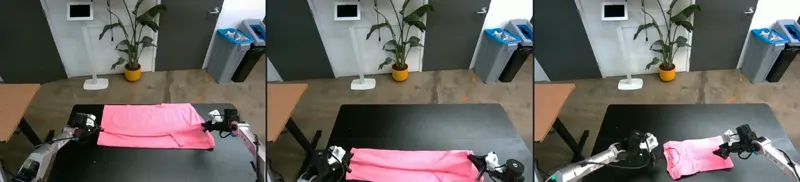
D&A:解耦描述与评估,让视觉语言模型成为零样本机器人奖励模型
现有视觉语言模型在机器人奖励估计中容易受确认偏差影响,把失败轨迹误判为成功。D&A 将奖励预测拆成两个无共享上下文的阶段:描述器不看任务指令,客观叙述视频中的机器人行为;评估器先给出明确的任务成功标准,再依据标准为每一帧分配密集进度奖励。该方法无需机器人数据或微调,能够惩罚失败执行并保留成功过程中的部分进展;在多项基准以及真实机器人在线与离线强化学习中,性能可匹配或超过经过后训练的奖励模型。
Marius Memmel, Shawn Yin, Urvi Rutia · 24次阅读 · 2026年11月2日
视觉语言模型Robot Reward Modeling
2026年11月2日