PAPER DEEP DIVE
VAP-TAMP 精读:用动作知识引导 VLM 主动感知——机器人在执行中发现「门只开了一半」怎么办
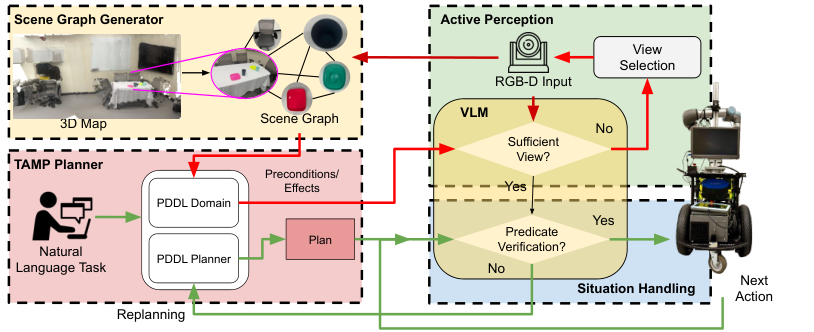
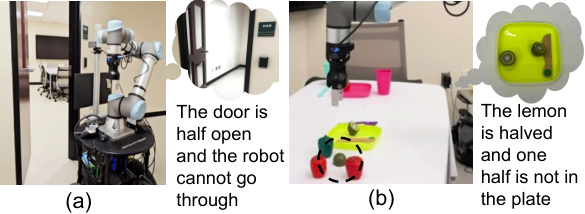
SUNY Binghamton + CMU + Ford Research + Agility Robotics,TAMP(任务与运动规划)+ VLM 主动感知框架。核心问题:TAMP 规划假设全知世界,但真实执行中随时冒出计划外状况——门只半开过不去、柠檬切半后一半掉出盘子。既有开放世界规划方法隐含假设「状况是完全可观测的」,而现实中机器人只能靠不靠谱的机载传感器。VAP-TAMP 的关键创新是 **VLM 与动作知识的双向交互**:用当前动作 PDDL 前置条件/效果构造视觉问句去 prompt VLM,再用 VLM 输出更新动作知识。三个模块:① 场景图生成器(RGB-D 点云+实例分割+CLIP 嵌入,几何规则判定 on/inside/near,动作驱动+观测驱动双通道更新);② 主动感知(对每个谓词生成 N 个语义等价问句让 VLM 多数投票,响应不一致→VLM 建议视角方向(left/right/closer/above)→导航过去再看,预算 K 内循环直至视图充分);③ 状况处理(verify-execute-verify 闭环:动作前验前置条件、动作后验效果,任一失败→修正场景图→PDDL 重规划;诊断区分感知错误/世界状态变化/执行失败三种根源)。真机实验:Segway RMP+UR5e+Robotiq 夹爪,4 个家务任务×25 次共 100 试,**成功率 88%**(OK-Robot 76%、COWP 69%、Closed-World 33%),72/100 试验中至少出现一次计划外状况;VLM 引导选视角平均 1.61 个 vs 贪心遍历 4.35 个(省 63%);失败模式显示 VAP-TAMP 的失败集中在操作硬件(42%),感知瓶颈被转移走。仿真实验(OmniGibson,5 任务+注入故障概率)证明基于具体状态谓词的验证优于 SuccessVQA/AffordanceVQA 及其组合,效果验证贡献大于前置条件验证(抓取/切割各 50% 组合故障率只能靠后验发现)。
一句话导读
机器人规划做得再漂亮,也架不住执行时世界变了:门只开了一半过不去、切柠檬时半个掉出了盘子、抓杯子时杯子早被人挪走。TAMP(任务与运动规划)方法普遍假设状态估计完美、环境静态,遇到计划外状况要么停机要么等人来救。SUNY Binghamton 联合 CMU、Ford Research、Agility Robotics 的这篇 IROS 工作 VAP-TAMP 给出解法:用 PDDL 动作知识(前置条件/效果)去构造 VLM 的视觉问句,让机器人主动选视角、验证谓词、诊断状况、重规划。真机 100 次家务任务试验成功率 88%。
RGB-D 点云 + 实例分割 + CLIP 嵌入
on / inside / near 几何谓词"] SG --> P["PDDL 规划器
生成动作序列"] P --> EXE["执行动作 a"] EXE --> PRE{"前置条件验证
VerifyPredicate"} PRE -- "False" --> CORR["修正场景图"] --> P PRE -- "True" --> ACT["执行 + 应用效果到场景图"] ACT --> EFF{"效果验证"} EFF -- "False" --> CORR EFF -- "True" --> NEXT["下一动作"] PRE & EFF --> AP["主动感知
N 个等价问句多数投票
响应不一致 → VLM 建议视角
导航重观察,预算 K 内循环"]
问题:开放世界的三重挑战
论文先摆清楚现实世界的三重动态性,每一重都对应经典 TAMP 的一个盲区:
- 感知不可靠:遮挡、杂乱、视角不佳都会让谓词判断出错(杯子到底在不在桌上?),而且 VLM 不输出置信度信号——你不知道它什么时候错了。
- 规划与执行之间环境会变:物体被人挪动、通路被堵,基于初始观测算出的计划到执行时就失效了。
- 执行本身不完美:抓取打滑、放置脱靶。经典系统遇到这些失败,要么停下要么要人。
作者对先前开放世界规划工作的批评一针见血:失败解释的知识表示、LLM 动态扩充动作知识(COWP)、不确定时呼叫人类——这些方法都隐含假设状况是完全可观测的,直接跳到"处理状况",跳过了"可靠地感知到状况"这一步。
与 VLM 相关工作的差别同样关键:SayCan / Code as Policies / PaLM-E / VoxPoser 这条线把 VLM 输出当一次性的、不会错的谕示——查一次、信到底、不验证。VAP-TAMP 反其道而行:把 VLM 的不确定性转化为可行动的信号,触发刻意的主动信息获取。主动感知一节里还要再强调一次这个对比:经典 next-best-view 算法最大化几何覆盖,但无法判断哪个视角能解开 VLM 对"包含""支撑"这类语义谓词的犹豫;交互式感知通过物理接触揭示被遮挡表面,但改变世界本身有代价。VAP-TAMP 走的是第三条路:让 VLM 自己说"我需要往哪儿看"。
历史脉络上,主动感知在机器人学里是老命题(Bajcsy 1988),但它的经典形态处理的是几何问题——重建一个物体需要哪些视角。LLM/VLM 时代的问题变了:不再是"看得全不全",而是"符号谓词的真值得不到可靠判定"。VAP-TAMP 本质上是把主动感知从几何空间搬到了符号空间:视角选择的优化目标从几何覆盖换成了谓词验证置信度。
方法:三个模块 + 一个闭环
场景图生成器:符号状态的守门人
系统用 RGB-D 探索构建初始场景图:观测聚合成点云地图,实例分割切成对象集合 $O$,每个对象存 3D 质心、包围盒和 CLIP 嵌入(开放词汇检索用)。关系集合 $R$ 由几何规则评估——on 要求质心位于支撑面之上且在阈值内、inside 要求包围盒被包含、near 要求质心距离低于阈值。
维护走双通道:动作驱动更新(执行 pick(cup, table) 后立即删 on(cup,table)、加 holding(robot,cup))与观测驱动更新(谓词验证发现场景图与物理现实不符时纠正,纠正即触发重规划)。这样 PDDL 规划器永远在一个准确的世界模型上搜索。
主动感知:把 VLM 的犹豫变成行动
这是全文最精巧的设计。算法 VerifyPredicate 的流程:
- 对目标谓词 $p$(如
on(cup, table))生成 $N$ 个语义等价的自然语言问句:"杯子在桌上吗?"、"杯子搁在桌面上了吗?"、"杯子是不是放在桌子上面?" - 逐句问 VLM,得二值回答,多数投票出谓词值;
- 若各问句回答一致,再问 VLM"当前视图信息充分吗?"——充分则接受结论;
- 不一致或视图不足:让 VLM 建议一个方向(left / right / closer / above…),机器人导航过去重新观察,进入下一轮,直至视图充分或预算 $K$ 耗尽。
这里的核心洞察是:VLM 对具体状态谓词("机器人拿着杯子吗?")的判断远比对抽象动作结果("抓取成功了吗?")可靠——这被仿真实验定量证实。而且"视角选择"不是几何覆盖驱动的 next-best-view(NBV 只优化几何基元,无法判断哪个视角能解开 VLM 对"包含关系"这类语义谓词的犹豫),而是 VLM 自己说"我需要往哪儿看"。
状况处理:verify-execute-verify
每个动作的执行是三段式:动作前验证全部前置条件(pick(cup,table) 需要 on(cup,table)、reachable(cup)、hand_empty 逐个过)、执行、动作后验证预期效果是否真的发生。任一失败 → 按观测修正场景图 → PDDL 重规划。状况的定义是"使正常情况下成功的计划无法完成任务的意外世界状态",来源三类:环境变化(人挪了东西)、感知错误(初始状态估错)、执行失败(抓取失败)。框架的设计目标正是诊断失败根源:感知错误靠主动感知修正,世界状态变化需要计划适配,执行失败需要恢复动作。
动作知识怎么"教"VLM:一个 PDDL 片段的旅程
论文第 IV 节给了完整示例。域里的 pick 动作长这样:
:action pick :parameters (?a - robot ?o - object ?s - surface) :precondition (and (on ?o ?s) (reachable ?o) (hand_empty ?a)) :effect (and (holding ?a ?o) (not (hand_empty ?a)) (not (on ?o ?s)))
执行前的状况处理循环把这段结构逐谓词拆开,转成具体的视觉问句:"杯子在桌上吗?"、"机器人手空着吗?"——每问完一个,VLM 结合当前观测回答,若 hand_empty 判 False(手还拿着别的东西),框架不会硬抓:先按观测修正场景图(比如发现杯子其实在柜子里而不是桌上),再从修正后的状态重新规划,可能整个 pick 换了目标位置。动作后则验证 holding(robot, cup) 是否成立——抓取打滑杯子掉在地上,效果验证立刻发现,场景图记下"杯子在地上",重规划可能插入一个 pick(floor) 恢复动作。整个闭环没有一步需要人工干预。
动作表:每个动作都要过哪些关
论文 Table I 列出了九个动作的前置条件与可注入状况,是理解实验设计的钥匙:
| 动作 | 前置条件 | 必须检测与恢复的状况 |
|---|---|---|
| find | 对象与机器人在同一房间 | 导航后对象不在视野;对象附近无空闲空间;导航途中持握物掉落 |
| grasp | 对象在视野;手空 | 抓取失败对象未动;抓取失败对象掉落附近 |
| placein | 对象在手;容器在视野;容器开着 | 放置失败对象仍在手;放置失败对象掉落附近 |
| placeon | 对象在手;支撑面在视野 | 同上两类 |
| open / close | 对象在视野 | 开/关失败,对象保持原状态 |
| turnon | 对象在视野 | 开启失败,对象保持关闭 |
| cut | 对象在视野;刀在手 | 切割失败刀仍在手;切割失败刀掉落附近 |
注意"状况"全部是具体的、可观测的物理状态("对象掉落附近"而非"任务出了问题")——这正是谓词验证能逐条检测的原因。
场景图的"双重账本"机制
场景图维护的双通道设计值得单独展开。动作驱动更新是"乐观账本"——假设执行成功,立即把效果记入符号状态(删 on(cup,table)、加 holding(robot,cup)),这让规划器能马上继续;观测驱动更新是"悲观对账"——效果验证发现 holding(robot,cup) 实际为 False 时,立刻按观测改账,并把修正事件作为"状况"上报触发重规划。两本账的张力正是框架的敏感性来源:如果只做乐观记账(很多纯 LLM-VLA 系统如此),失败会静默累积到某个动作彻底做不下去才暴露;如果只做悲观对账,每个动作后都要全域重观测,效率崩溃。verify-execute-verify 把对账成本限制在每个动作的效果谓词上,兼顾了及时性与效率。
主动感知的预算哲学
VerifyPredicate 的循环上限 $K$(视角预算)是个容易被忽略但工程上极关键的参数。真实机器人不能无限"再看一眼"——每一次移动都有时间与能耗成本,而且某些谓词在物理上不可判(杯子锁在关着的柜子里,任何视角都看不到 inside 状态)。预算耗尽后算法返回当前多数投票结果,系统带着"这是 K 次观察后最好的判断"继续走:要么按此执行并在效果验证兜底,要么由状况处理在失败后恢复。这与"LLM 不确定就问人"(Ren et al.)形成对照——VAP-TAMP 的选择是先用主动感知消歧,消不掉的不确定性留给闭环的恢复机制,而不是中断任务流。
真机实验:100 次试验,88% 成功率
平台与任务
硬件是 Segway RMP 底盘 + UR5e 机械臂 + Robotiq 2F-85 夹爪 + 腕部 RealSense D435i;VLM 用 Gemini Vision,运动基元(navigate/pick/place/push)由 MoveIt 实现。四个家务任务、三个房间、每任务 25 次、共 100 次:
| 任务 | 内容 | VAP-TAMP | OK-Robot | COWP | Closed-World |
|---|---|---|---|---|---|
| T1 收集杯子 | 跨房间取杯 | 92% | 84% | 80% | 40% |
| T2 切柠檬 | 找柠檬找刀再切(状况率最高) | 84% | 72% | 64% | 24% |
| T3 收木柴 | 拾木块放入储物间 | 92% | 76% | 76% | 36% |
| T4 取盘子 | 从杂乱桌面取盘放上架子 | 84% | 72% | 64% | 28% |
| 总计 | 100 次试验 | 88% | 76% | 69% | 33% |
状况分布本身就很说明问题:100 次试验里 72 次至少出现一次计划外状况(抓取失败 24、掉落 18、场景变化 16、视觉 14),T2 切柠檬因多步骤 + 执行中频繁的场景扰动状况率最高。基线选择覆盖三种范式:OK-Robot(开放词汇移动操作 SOTA,无主动感知)、COWP(LLM 常识动态扩充动作知识,但只有任务规划没有运动规划)、Closed-World(经典 TAMP,假设完美状态估计、无状况处理)。
视角效率:1.61 vs 4.35
针对"VLM 引导选视角是否真的更高效",与贪心感知(穷举访问目标周围全部预定义视角)对比:贪心平均 4.35 个视角/次消歧,VLM 引导只去有判别力的视角,平均 1.61 个——省 63%。
失败模式:瓶颈从感知转移到了硬件
失败分布图是这篇论文最有意思的一张:VAP-TAMP 的 12 次失败里 42% 是操作硬件错误,视觉歧义只占 17%;而 OK-Robot(24 次失败)和 COWP(31 次)的视觉歧义占比高达 42%/39%,Closed-World 更是 65% 失败源于视觉歧义。作者的总结很精辟:主动感知 + 状况处理把可靠性瓶颈从"缺感知信息"挪到了"缺物理能力"——系统失败在硬件力所不及处,而不是被视觉骗到。
仿真消融:谓词验证为何优于"成功了吗"
OmniGibson 仿真、5 个任务(烧水/取瓶/加热派/切蛋/集柴),按概率注入故障(grasp 和 cut 各 50% 组合故障率,open/close/turnon 各 10%)。对比五种 VLM 验证策略:
- VLM-planner / Classical-planner:完全不验证,注入故障下恢复能力最差(平均 15%/25%);
- SuccessVQA:只在执行后问"动作成功了吗"(平均 52%);
- AffordanceVQA:只在执行前问"能做吗"(平均 35%);
- Suc.Aff.-QA:两者组合(平均 67%)仍不及基于谓词的验证(平均 75%)——因为 VLM 对具体可观测状态谓词的推理比抽象动作结果更可靠。
验证阶段消融:前后验证都开 66.5%、只验效果 53.0%、只验前置条件 41.5%——效果验证贡献更大,因为抓取/切割这类高概率故障只能靠执行后的效果验证发现。
执行时间曲线与稳健性
除了成功率,执行时间曲线(300 秒超时)显示 VAP-TAMP 在最低执行时间区间就达到最高成功率——主动感知看似"多花时间看",实际上因避免了失败后的重复尝试,整体更快。逐任务看,基线的方差明显更大(OK-Robot 在不同任务间 64–84% 波动,Closed-World 24–40%),而 VAP-TAMP 稳定在 84–92%——状况处理的价值不只是提升均值,更是压平方差:在状况多发的任务里不崩盘,才是长期自主的底座。
与 OK-Robot 的正面对比说明了什么
OK-Robot 是最值得细比的基线:它同样用 CLIP 检索 + VLM 处理状况,差别只在"没有主动感知"——VLM 一次判断定终身。两者 12 个百分点的差距(88% vs 76%)几乎完全归因于主动感知这一项改动,相当于给了一个干净的消融:在同一个开放世界、同一批状况里,"再看一眼的能力"值 12 个点。而 COWP 与 Closed-World 的差距(69% vs 33%)则度量了状况处理本身的贡献——经典 TAMP 在 72/100 试验有状况的环境里近乎不可用。三个数字拼起来就是全文论点的定量版:主动感知(+12)与状况处理(+36)是正交且可叠加的两级台阶。
仿真任务的故障注入设计
仿真实验的另一个贡献是可控的故障注入协议:给每类动作分配显式的故障概率(grasp:25% 对象未动 + 25% 对象掉落;cut 同为 25%+25%;placein/placeon/open/close/turnon 各 10% 或 10%+10%;fill 各 5%;导航途中持握物掉落 10%)。这使五种验证策略的比较不受随机环境扰动污染——所有方法面对完全相同的故障分布,性能差异纯粹来自检测与恢复机制本身。这个协议对后续做执行监测研究的团队有直接复用价值。
为什么这篇值得细读
- 它回答了 VLM 落地机器人最扎心的问题:错了怎么办?多数系统把 VLM 当谕示,VAP-TAMP 用动作知识构造问句、用一致性检验暴露犹豫、用主动移动消解歧义,让 VLM 的不确定性成为规划循环的一等公民。
- PDDL 不是装饰:前置条件/效果既是规划器的输入,也是 VLM 问句的生成器——符号知识与神经感知形成双向闭环,这正是"主动"二字的来源。
- 实验设计有对照意识:状况率 72/100 说明测试难度真实;失败模式分析证明瓶颈转移而非笼统报成功率;仿真注入故障概率使消融可解释。
- 对做家庭服务机器人、开放世界执行监测的团队,verify-execute-verify 这个执行时结构可以直接迁移。
局限与展望
作者列出三个方向:全身优化(目前底盘导航与上身操作分开优化);引入强化学习让机器人从失败中改进;交互式感知——通过物理改变世界配置来获取信息(比如推一下遮挡物再确认谓词)。
此外,框架目前假定机器人能在已知地图中定位、目标对象可检测,符号属性的推断全部压在 VLM 上;VLM 幻觉在失败分布中占 8%,虽已是各方法中最低,但仍是值得继续压缩的份额。随着 VLM 推理能力迭代,同样的 verify-execute-verify 骨架可以直接升级更强模型而不改结构——这也是把"验证逻辑"与"感知能力"解耦设计的红利。
参考资料
- 论文:arXiv:2604.26988 — Robot Planning and Situation Handling with Active Perception(IROS 2026,SUNY Binghamton / CMU / Ford Research / Agility Robotics)
- 项目页:vap-tamp.github.io/vap-tamp
- 相关系统:OK-Robot(RSS 2024)、COWP(Autonomous Robots 2023)、LLM-GROP(IJRR 2025)、TAMPURA、PDDLStream / FFRob、SayCan、PaLM-E、VoxPoser
- 基础概念:Integrated Task and Motion Planning(Annual Review 2021)、Active Perception(Bajcsy, Proc. IEEE 1988)