PAPER DEEP DIVE
NavJev:动作中心视觉压缩导航
NavJev 用动作中心视觉压缩与判别式动作语义记忆,把 VLN 化为类型化选择;R2R-CE 达 27.0% SR、22.4% SPL,单步 0.65 秒。
论文元信息
标题:NavJev: Efficient Vision-Language Navigation via Action-Centric Visual Compression and Discriminative Action-Semantic Memory
作者:Kai Sheng、Liuyi Wang、Jinlong Li、Haojie Dai、Chengju Liu、Qijun Chen(同济大学电子与信息工程学院)
链接:arXiv:2609.34969 | 项目页
代码:NavJev-Code 已开放,关键实现在 ACVC 表达构造、共享标签过滤、Jev 请求构建与导航主循环中。
一句话总结
NavJev 不让多模态大模型每一步反复“看图—生成推理文本”,而是先把每个候选路点压成“方向、距离、图像描述、去共享语义标签”的结构化动作档案,再由类型化决策器直接在有限动作集合上输出概率化选择,从而用 0.65 秒/步取得 27.0% 成功率和 22.4% SPL。
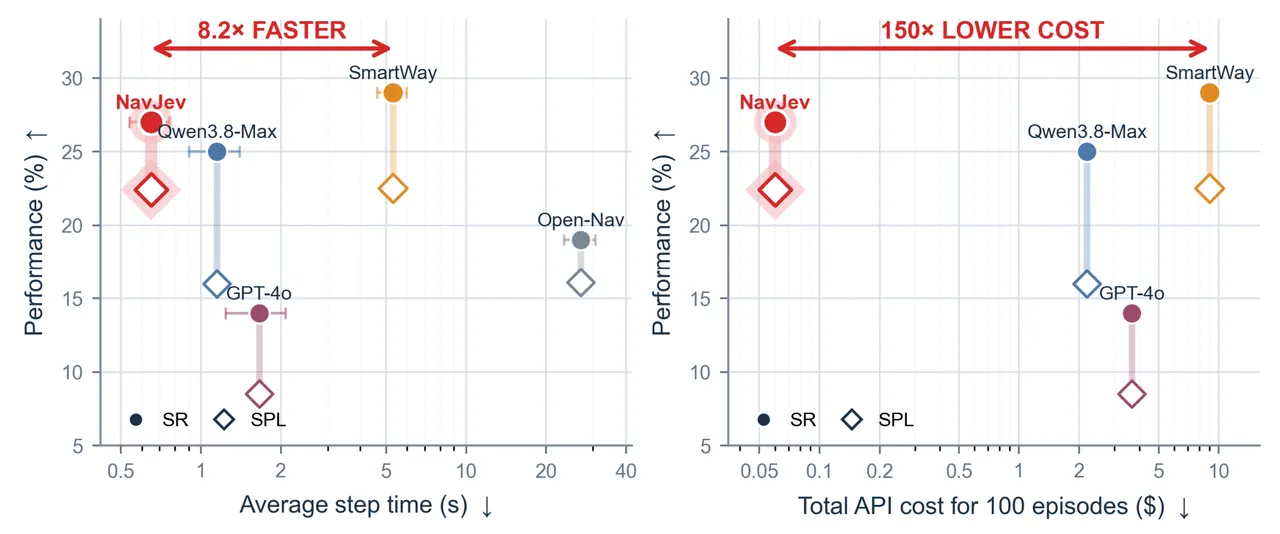
图1:NavJev 在 R2R-CE 上以更低的平均步时和 API 成本取得更高成功率;图中展示约 8.2 倍相对 SmartWay 的速度优势和约 150 倍成本降低。
研究背景与动机
视觉语言导航要解决的问题很直接:机器人收到自然语言指令后,必须在连续变化的室内场景中判断往哪个候选路点移动、何时停止,并把语言中的空间关系映射到真实地形与视觉证据上。近年的零样本方法常把这个问题交给多模态大模型,让模型在每一步读取全景图、指令、历史和候选动作,再生成解释或动作。这种方式不需要为导航任务微调模型,迁移到陌生环境时也更灵活。
但闭环导航的结构和开放文本生成的结构并不相同。机器人虽然看到了高维全景图像,真正要做的却是在少量可导航路点和停止动作之间做一次选择。候选方向通常只有几个,动作空间是有限集合,每一步的决策也应该可校验、可复现。传统多模态大模型却要重新编码图像、重新生成文本,再从自由文本中抽取动作,这把一个受约束的选择问题包装成了高成本的生成问题。
这种错配在闭环导航中被不断放大。机器人在每个导航步都要调用模型,图像帧和路点候选随运动持续变化;若每步消耗数百毫秒到数秒,真实环境中的安全裕度、任务吞吐和硬件成本都会被压低。若把大模型部署在机器人端,显存需求又会限制可用模型尺寸;若部署在云端,则要承受网络往返、API 计费和服务延迟。
NavJev 的出发点是把视觉理解与动作选择解耦。论文认为,视觉模型不需要在每一步生成自由解释;它只需要把每个候选方向附近的可执行线索压缩成紧凑描述。也就是回答两个问题:这个方向可以把机器人带到哪里,沿途有哪些和指令匹配的物体或场景语义。其余共享背景信息可以在候选动作之间去重,避免把同一段场景重复传给决策器。
另一个关键选择来自 Jev。Jev 是一个类型化决策模型,可以直接从结构化状态映射到预定义选项的概率分布,而不是先写推理文本再解析答案。导航动作本来就是有限集合,这让 Jev 与路点级导航天然契合。难点在于 Jev 目前接收文本或结构化状态,不直接读取原始图像;因此必须先设计一个既足够紧凑又保留判别信息的视觉接口。
作者由此提出 NavJev:ACVC 负责把候选路点图像压成动作中心的文本表示,DASM 负责删除跨方向共享语义、保留动作特有证据并组织历史,Jev 负责在这个结构化状态上做类型化选择。整个框架没有把“快”理解为简单地换更小模型,而是改变信息接口与决策结构。
预备知识:路点级导航与有限动作集合
在第 t 步,机器人从全景相机获得一组 RGB-D 图像。论文用 K 表示组成全景观测的视角数量,观测集合写作:
$$\mathcal{I}_{t}=\left\{(I^{\mathrm{rgb}}_{t,i},I^{\mathrm{depth}}_{t,i})\right\}_{i=1}^{K}.$$
waypoint 预测器在这些 RGB-D 视角上估计可导航热图,非极大值抑制后得到最多 5 个候选路点。每个候选既包含相对方向角,也包含相对距离,还关联一个局部图像:
$$w_{t}^{i}=\left(\theta_{t}^{i},d_{t}^{i},I_{t}^{i}\right).$$
导航不是只从 w 中选一个;机器人还要决定本轮是否停止。动作空间因此写成候选路点加终止动作:
$$\mathcal{A}_{t}=\{w_{t}^{1},\ldots,w_{t}^{M_{t}},\mathrm{Stop}\}.$$
这个定义很重要。它说明 NavJev 的在线决策是路点级宏动作,不是低层离散转向或平移。后文的效率表会显示,任务级微调的 MLLM 方法常常每步预测低层动作,步数达到 68.9 到 118.7;NavJev 的平均步数只有 9.3,因此即便单步时间相近,整条轨迹的时间显著更短。
方法详解:ACVC、DASM 与类型化决策
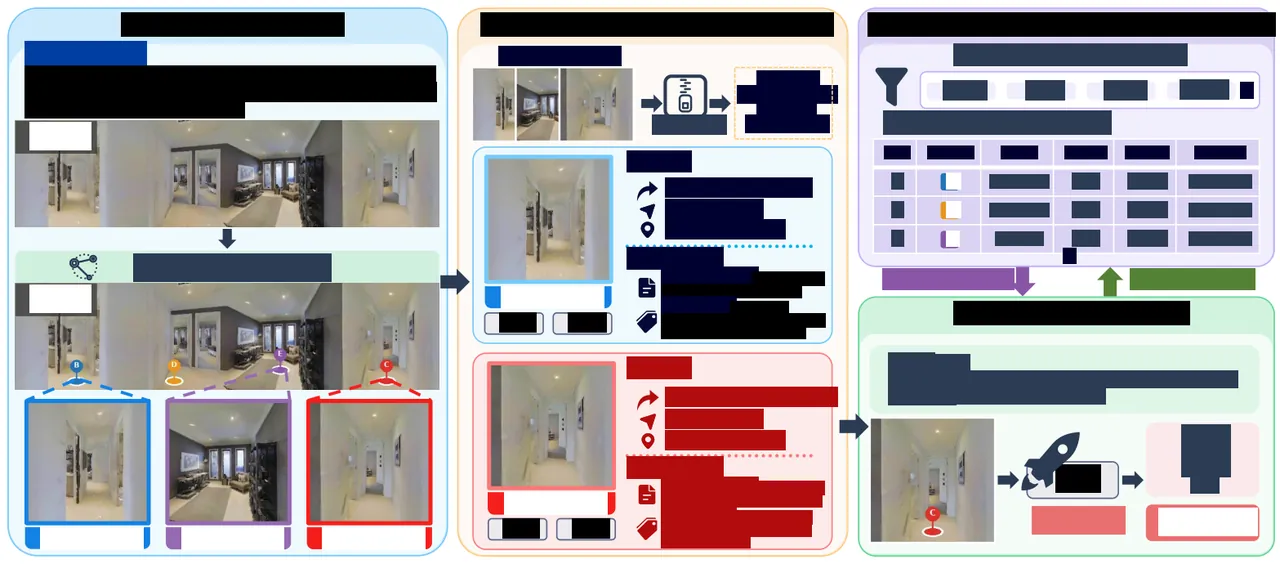
图2:NavJev 总览。全景 RGB-D 先产生候选路点,再由 ACVC 压缩为动作中心的描述;DASM 删除共享标签并组织历史;Jev 输出类型化动作选择。
flowchart LR
  A[Panoramic RGB-D] --> B[RGB and depth encoders]
  B --> C[Waypoint heatmap]
  C --> D[NMS up to 5 waypoints]
  D --> E[Action geometry
heading and distance]
  E --> F[ACVC batch]
  F --> G[BLIP captions]
  F --> H[RAM tags]
  G --> I[Action profiles Z]
  H --> I
  I --> J[Common tag intersection G]
  J --> K[Remove shared tags from each action]
  K --> L[DASM action-specific evidence]
  M[Executed action history] --> L
  L --> N[Structured state S]
  O[Navigation instruction] --> N
  N --> P[Jev typed action selection]
  P --> Q{Selected action}
  Q -- waypoint --> R[Move to theta and d]
  Q -- stop --> S[Terminate episode]
  R --> M
1. 保留几何先验的候选路点构建
NavJev 沿用 SmartWay 的预训练 waypoint 预测器。RGB 编码器提取外观特征,深度编码器提取局部几何,两者经过交叉注意力融合,再交给 Transformer 预测可导航性热图:
$$\mathbf{P}_{t}=f_{\mathrm{wp}}\!\left(f_{\mathrm{rgb}}(\mathcal{I}_{t}^{\mathrm{rgb}}),f_{\mathrm{depth}}(\mathcal{I}_{t}^{\mathrm{depth}})\right).$$
代码实现把热图离散成 120 个方向扇区与 12 个距离类别,也就是每个方向约 3 度,随后在 max_predictions=5 的约束下做 NMS。这个设计保证进入后续流程的不是一段自由视觉描述,而是真实可执行的候选动作。方向与距离也不是事后补上的注释,而是决策状态的核心字段。
2. 把候选图像压成动作档案
直接把候选图像逐张送进多模态大模型会引入两次开销:视觉编码开销和自回归文本生成开销。NavJev 改用 BLIP 与 RAM 并行描述同一批候选图像。BLIP 输出局部场景描述,RAM 输出显著物体与场景标签:
$$C_{t}^{i}=f_{\mathrm{BLIP}}(I_{t}^{i}),\qquad R_{t}^{i}=f_{\mathrm{RAM}}(I_{t}^{i}).$$
BLIP 的句子告诉模型场景的整体布局与空间关系,例如“房间里有大量家具”“通道尽头有门”;RAM 的标签则提供更高召回的词汇锚点,例如桌子、扶手椅、吊灯、通道、电梯、自动售货机。两者互补:句子偏连贯上下文,标签偏离散概念。NavJev 把二者与动作几何绑定:
$$Z_{t}^{i}=\left(m_{t}^{i},\theta_{t}^{i},d_{t}^{i},C_{t}^{i},R_{t}^{i}\right).$$
其中 m 是由方向角转成的运动语义。源码 one_stage_prompt_manager.py::get_action_concept_backtrack() 按 30 度阈值把相对航向分成“急左转”“左转”“轻微左转”“直行”“轻微右转”等档位。这样 Z 不只是五个字段的拼接,而是“向哪个方向走、走多远、那里像什么、有哪些关键概念”的完整动作描述。完整候选集合表示为:
$$\mathcal{Z}_{t}=\left\{Z_{t}^{i}\right\}_{i=1}^{M_{t}}.$$
3. 批处理与并行让压缩不出新瓶颈
ACVC 的一个容易忽视的细节是延迟控制。相邻候选可能对应同一张全景切片,重复图像只处理一次,结果被多个动作复用。BLIP 和 RAM 又可以在同一图像批上并行执行,因此感知耗时不是两个模块相加,而近似取最大值:
$$T_{\mathrm{ACVC}}\approx\max\!\left(T_{\mathrm{BLIP}},T_{\mathrm{RAM}}\right)+\epsilon.$$
源码 base_il_trainer.py 中使用 ThreadPoolExecutor 和 CUDA stream 组织两条感知路径,主循环随后调用 build_jev_request() 构造结构化请求。实测中 BLIP-RAM 感知只占 72.4 毫秒,是 647.9 毫秒总步时的 11.2%。这说明 ACVC 并不是把一个昂贵大模型换成另一组小模型那么简单,工程接口也参与了延迟塑造。
4. DASM:先删共同语义,再保留差异
相邻候选方向来自同一全景场景,自然会共享大量标签。比如三个方向可能都看到地毯、天花板、走廊、家具;若这些词重复出现在每个候选档案里,决策器需要阅读很多无效文本,却得不到区分方向的信息。DASM 首先做 Common-Tag Filtering,求所有候选标签集合的交集:
$$G_{t}=\bigcap_{i=1}^{M_{t}}R_{t}^{i}.$$
G 代表当前候选方向共同可见的场景上下文。它不是删除后就丢掉,而是保留为共享上下文;每个动作的标签集合则减去这批共同标签:
$$\widetilde{R}_{t}^{i}=R_{t}^{i}\setminus G_{t},\qquad i=1,\ldots,M_{t}.$$
过滤后的动作状态变为:
$$D_{t}^{i}=\left(m_{t}^{i},\theta_{t}^{i},d_{t}^{i},C_{t}^{i},\widetilde{R}_{t}^{i}\right).$$
代码对应非常直接:jev_caption.py::_deduplicate_shared_ram_tags() 先用大小写折叠把标签归一,再计算集合交集,最后从各候选标签集合中移除共同部分;build_jev_request() 负责把过滤后的选项、几何字段、运动描述和共享上下文组织成 Jev 可读的结构化 payload。这使“场景里有什么”和“这个方向独特地有什么”不再混在一起。
5. 历史不是轨迹日志,而是动作语义记忆
很多导航系统把历史写成“第 1 步向前、第 2 步左转”。这对轨迹重建有用,但对下一步语言匹配帮助有限。NavJev 把每个已执行动作的语义写进历史。设 φ(a_t) 表示执行动作的运动描述、航向、距离、BLIP 描述和过滤后 RAM 标签,则历史更新为:
$$\mathcal{H}_{t+1}=\mathcal{H}_{t}\oplus\phi(a_{t}).$$
这样,如果机器人已经走过“有黑色沙发和长桌的大厅”,后续再遇到相似视觉场景时,历史中保留了上一次的判别证据,而不是只留下“前进 2.3 米”。当前状态由历史、共享上下文和过滤后的当前候选组成:
$$\mathcal{S}_{t}=\left(\mathcal{H}_{t},G_{t},\left\{D_{t}^{i}\right\}_{i=1}^{M_{t}}\right).$$
DASM 因此承担两个角色:在单步内降低冗余,在多步间保留动作特异性。消融实验显示,从“BLIP + RAM”到加入 DASM,成功率从 21.0% 升至 27.0%,SPL 从 16.1% 升至 22.4%,提升幅度甚至大于加入 RAM 标签本身。
6. Jev 的类型化选择
得到结构化状态后,NavJev 不再要求模型生成推理段落。每个候选动作分配一个选项标签,Jev 直接在这些标签上输出分布:
$$a_{t}=f_{\mathrm{Jev}}\!\left(\mathcal{L},\mathcal{S}_{t},\mathcal{A}_{t}\right),\qquad a_{t}\in\mathcal{A}_{t}.$$
若选中的是第 j 个路点,就转换为控制指令:
$$u_{t}=\left(\theta_{t}^{j},d_{t}^{j}\right),\qquad a_{t}=w_{t}^{j};$$
若选中停止,则终止当前 episode。类型化接口的意义不只是省掉文本解码。它把动作合法性放进 schema 中:模型只能选择已有候选,不能虚构不存在的方向;输出带有概率,方便后续日志分析、阈值约束和异常检测。由于导航指令仍然以自然语言提供,决策器仍要理解语言,但视觉与语言的重叠部分已经被压成紧凑状态,不再由原始图像参与每一步自回归推理。
实验结果:效率优势是主结果,性能并非牺牲品
主评测在 Habitat 的 R2R-CE val-unseen 上进行,主要指标包括导航误差 NE、最优子路径覆盖率 OSR、成功率 SR、按路径长度加权的 SPL 和轨迹归一化动态时间规整 nDTW。仿真实验统一使用 NVIDIA RTX PRO 6000 GPU;Jev 决策通过官方 API 调用。真机使用带 Insta360 X4 全景相机的轮式机器人,waypoint 提取沿用 CLASH 的聚类策略,其余感知与决策链路和仿真一致。
| 方法 | 决策模型 | NE ↓ | OSR ↑ | SR ↑ | SPL ↑ |
|---|---|---|---|---|---|
| Random | – | 8.63 | 12.0 | 2.0 | 1.5 |
| MapGPT-CE | GPT-4o | 8.16 | 21.0 | 7.0 | 5.0 |
| DiscussNav-CE | GPT-4 | 7.77 | 15.0 | 11.0 | 10.5 |
| Open-Nav | Llama3.1-70B | 7.25 | 23.0 | 16.0 | 12.9 |
| Open-Nav | GPT-4o | 6.70 | 23.0 | 19.0 | 16.1 |
| CA-Nav | GPT-4 | 7.58 | 48.0 | 25.3 | 10.8 |
| SmartWay | GPT-4o | 7.01 | 51.0 | 29.0 | 22.5 |
| P2DNav | Qwen3-VL-32B | 6.61 | 65.0 | 50.0 | 30.6 |
| NavJev | Jev | 7.48 | 35.0 | 27.0 | 22.4 |
与 Open-Nav GPT-4o 版相比,NavJev 把成功率从 19.0% 提高到 27.0%,SPL 从 16.1% 提高到 22.4%,分别提升 8.0 和 6.3 个百分点。与 Llama3.1-70B 版 Open-Nav 相比,提升更大。NavJev 的 SPL 与 SmartWay 基本持平,但仍明显低于 P2DNav;论文的证据链更偏向“在轻量闭环中保持竞争力”,而不是宣称全面超过最强零样本方法。
推理效率
| 方法 | 平均步时 ↓ | 平均 episode 时间 ↓ | 平均步数 | 峰值 GPU 显存 ↓ |
|---|---|---|---|---|
| NaVid | 0.28 s | 24.60 s | 89.2 | 17.95 GiB |
| NaVILA | 0.21 s | 24.30 s | 118.7 | 17.46 GiB |
| StreamVLN | 0.23 s | 16.69 s | 73.6 | 23.63 GiB |
| JanusVLN | 0.64 s | 44.22 s | 68.9 | 35.80 GiB |
| NavJev | 0.65 s | 6.03 s | 9.3 | 4.46 GiB |
这张表的关键是三类数字同时看。单步时间上,NavJev 0.65 秒,与 JanusVLN 相近,但慢于 NaVid、NaVILA 和 StreamVLN;步数上,NavJev 只有 9.3 步,因为路点级宏动作一次跨越更长空间;显存上,NavJev 只需 4.46 GiB。结果就是 episode 总时间降到 6.03 秒,显著低于所有对比方法。论文进一步给出与 Open-Nav、SmartWay、P2DNav 的速度比约为 41.5 倍、8.2 倍和 7.6 倍。
延迟分解显示,总步时 647.9 毫秒中 Jev 决策占 534.6 毫秒(82.5%),BLIP-RAM 感知占 72.4 毫秒(11.2%),waypoint 预测占 25.1 毫秒(3.9%),环境交互占 14.9 毫秒(2.3%)。这说明瓶颈已从视觉感知转移到远程类型化决策调用;若要进一步压低延迟,下一步优化点不是继续换视觉骨干,而是减少网络往返或本地化 Jev 推理。
换掉决策模型的对照
| 决策模型 | SR ↑ | SPL ↑ | OSR ↑ | nDTW ↑ | 决策延迟 ↓ | 平均步时 ↓ | 总成本 ↓ |
|---|---|---|---|---|---|---|---|
| GPT-4o | 14.0 | 8.5 | 42.0 | 23.8 | 1.54 ± 0.42 s | 1.66 ± 0.42 s | $3.67 |
| Qwen3.8-Max | 25.0 | 16.0 | 46.0 | 34.2 | 1.03 ± 0.25 s | 1.15 ± 0.25 s | $2.19 |
| Jev | 27.0 | 22.4 | 35.0 | 43.5 | 0.53 ± 0.11 s | 0.65 ± 0.11 s | $0.06 |
这个对照比单纯总表更有说服力:三个决策器都拿到相同的 ACVC-DASM 状态和候选动作,推理能力都被关闭,只做下一步选择。Jev 的成功率高于 Qwen3.8-Max 2 个百分点、高于 GPT-4o 13 个百分点,SPL 高出 Qwen3.8-Max 6.4 个百分点,nDTW 也最高。成本只有 Qwen3.8-Max 的约 2.7%,相对 GPT-4o 降约 98.4%。OSR 下降说明 Jev 并没有更强的目标区域粗定位能力;但 nDTW 和 SPL 表明它在既定路线的约束选择上更稳。
组件消融
| BLIP | RAM | DASM | TL ↓ | NE ↓ | OSR ↑ | SR ↑ | SPL ↑ | nDTW ↑ |
|---|---|---|---|---|---|---|---|---|
| ✓ | ✗ | ✗ | 12.10 | 8.80 | 33.0 | 19.0 | 14.4 | 36.2 |
| ✓ | ✓ | ✗ | 15.83 | 8.13 | 34.0 | 21.0 | 16.1 | 35.0 |
| ✓ | ✓ | ✓ | 11.58 | 7.48 | 35.0 | 27.0 | 22.4 | 43.5 |
RAM 标签让 SR 从 19.0% 升到 21.0%,SPL 从 14.4% 升到 16.1%,但轨迹长度反而变长;加入 DASM 后 SR 增加 6.0 个百分点,SPL 增加 6.3 个百分点,轨迹长度又下降。这个对比说明,更多语义并不必然更好;把共享语义与判别语义分开,才是对有限上下文的正确使用。
真机结果
| 决策模型 | 办公室 OSR/SR ↑ | 咖啡厅 OSR/SR ↑ | 平均 OSR/SR ↑ | 决策延迟 ↓ | 平均步时 ↓ |
|---|---|---|---|---|---|
| Qwen3.8-Max | 30.0 / 30.0 | 40.0 / 40.0 | 35.0 / 35.0 | 1.10 s | 1.23 s |
| NavJev | 50.0 / 40.0 | 70.0 / 60.0 | 60.0 / 50.0 | 0.65 s | 0.79 s |
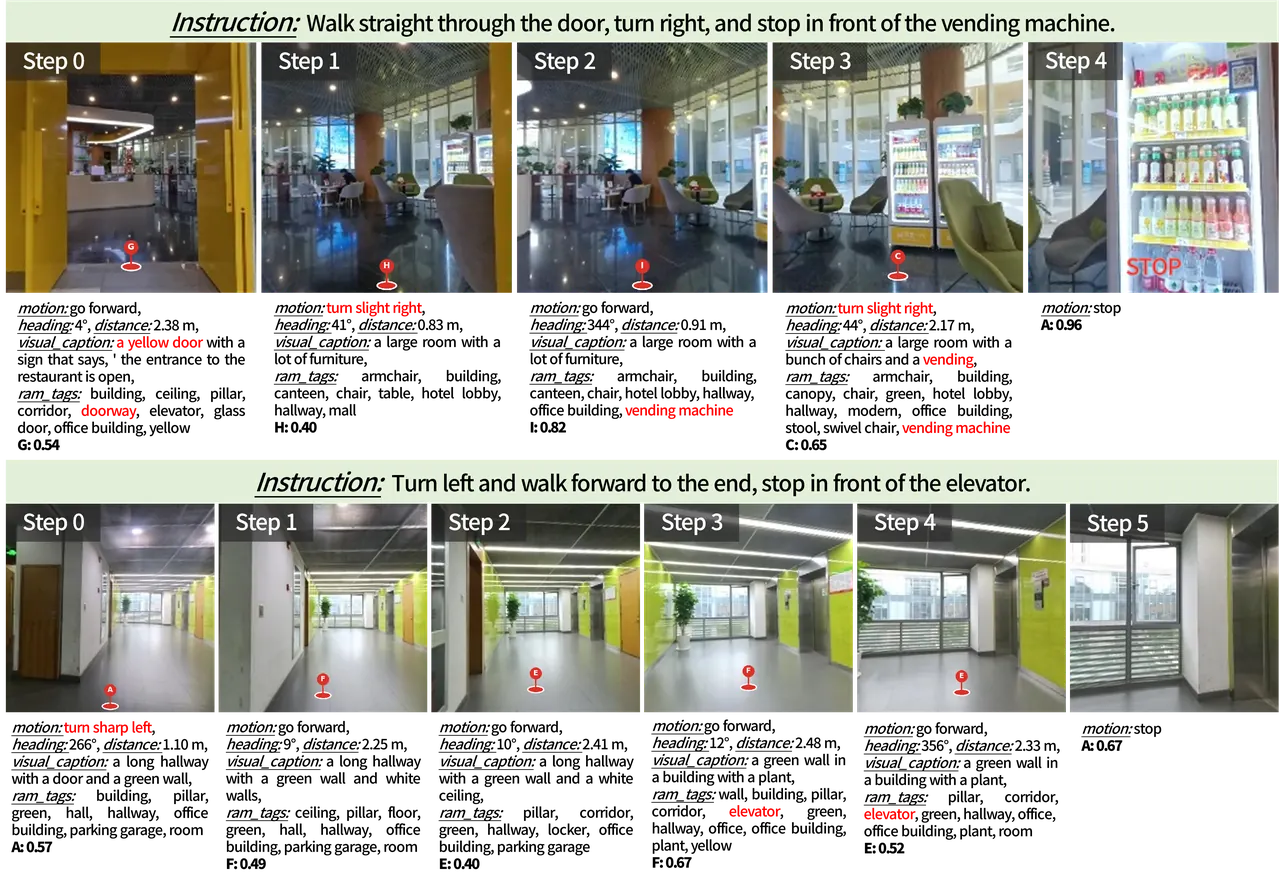
图3:两条真机任务展示每一步的 motion、heading、distance、BLIP 描述和 RAM 标签。第一条在步骤 3 出现 vending machine 后以 0.96 概率停止,第二条在识别 elevator 后停止。
办公室和咖啡厅各 10 个任务。NavJev 平均 OSR 60.0%、SR 50.0%,Qwen3.8-Max 两项均为 35.0%;决策延迟从 1.10 秒降到 0.65 秒,平均步时从 1.23 秒降到 0.79 秒。真机样本量不大,但它验证了两个重要事实:结构化动作状态在真实相机与聚类路点上可用,效率优势也会迁移到物理部署。
失败分析:瓶颈在候选方向的细粒度判别
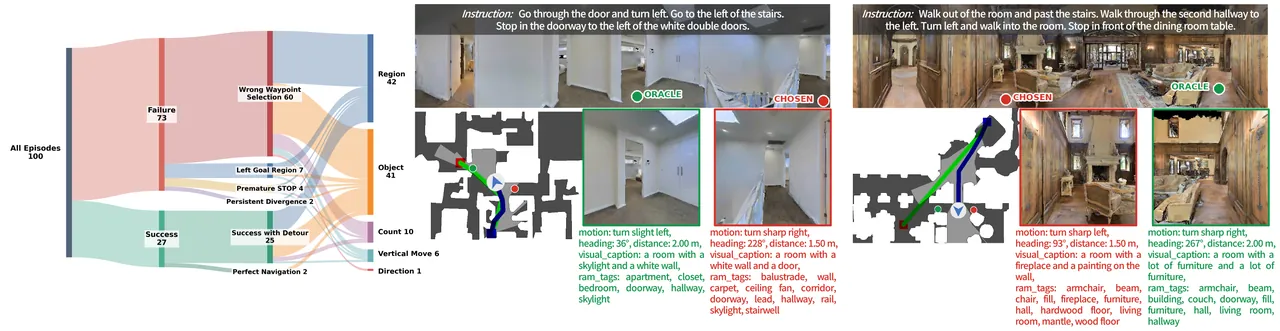
图4:100 个 episode 中成功 27 个、失败 73 个;失败里 60 个来自错误路点选择,其余包括进入错误区域 7 个、过早停止 4 个、持续偏离 2 个。右侧两个案例显示所选方向与 oracle 方向的视觉线索高度相似。
失败归因比平均指标更能暴露边界。73 个失败 episode 中,60 个(82.2%)是错误路点选择,7 个进入错误区域,4 个过早停止,2 个持续偏离。这不是停止机制或宏观规划崩溃,而是局部方向判别的问题。两个代表案例里,错误候选与正确候选的房间布局、家具和语义标签差异很小;指令却要求理解“楼梯左侧”“第二走廊左转”这类精细空间关系。
这说明 ACVC-DASM 的文本压缩有清晰边界:它很擅长把视觉证据绑定到有限动作,但不等价于全景像素级几何推理。BLIP 句子和 RAM 标签会丢失物体的精确相对位姿、遮挡关系和微小视角差。当语言指令需要这些细粒度关系时,决策器只能看到“房间、桌子、走廊”等较粗的词汇锚点,可能选出一个语义上合理但几何上错误的方向。
局限性与工程判断
第一,作者明确指出主要瓶颈是细粒度空间关系与相似视觉语义下的方向判别。60/73 的失败集中在错误路点,论文给出的改进方向也是更强的空间定位和关系推理,而不是单纯把状态压得更短。
第二,Jev 目前通过官方 API 调用,且占据 82.5% 的步时。类型化接口降低了生成延迟,但引入了服务可达性、网络波动、并发排队和计费问题。对长时间运行的真实机器人,API 依赖比视觉感知的 72.4 毫秒更值得工程化关注。
第三,ACVC 是有损压缩。它保留了动作相关的语义和几何,但丢掉了原始像素中的稠密几何、遮挡顺序、精确相对角度和局部细节。对于依靠颜色、纹理或细小标志物区分方向的指令,当前接口的召回能力有限。
第四,评测规模仍然偏小。仿真中的决策模型对照、组件消融和失败分析都基于 100 episode 子集;真机只有 20 个任务。R2R-CE val-unseen 的 27.0% SR 明显低于任务微调方法的 37.4%-65.0%,也低于 P2DNav 的 50.0%。它的价值主张是大幅降低闭环成本,同时保持可用的零样本性能,而非零成本地达到最强精度。
总结与展望
NavJev 的贡献可以拆成三层。接口层:用动作中心的状态代替原始图像,把“看图选路”变成“读取有限候选的结构化档案”。记忆层:DASM 把共同场景语义和动作特异语义分开,并在历史中保留已执行动作的判别证据。决策层:Jev 用类型化概率选择替代自由文本生成,使动作空间、合法性和输出形状都在 schema 层受到约束。
这篇论文对机器人系统设计的启示不只是“用更小模型”。NavJev 把导航决策的真正输入从高维帧重新定义为可执行候选;把视觉模型的作用限定为压缩与检索语义证据;把历史从轨迹日志提升为跨步记忆;再用概率化选项接口闭环。后续工作若能把 Jev 本地化、加入细粒度空间关系编码,并在更大的真实环境集中验证,这套范式会更有工程竞争力。
金句
“闭环导航不需要每一步都重新看见整张图;它需要记住这个方向为什么不同。”