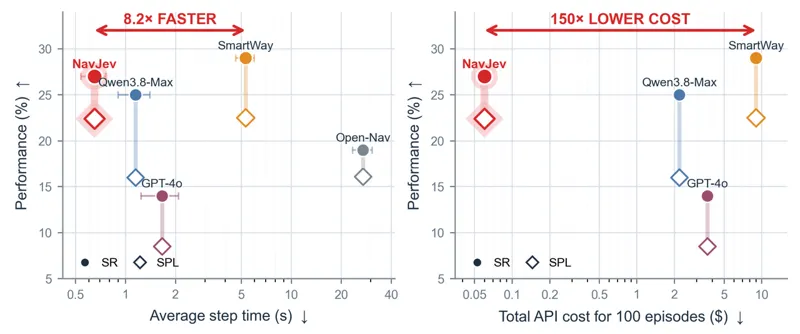
NavJev:动作中心视觉压缩导航NavJev 用动作中心视觉压缩与判别式动作语义记忆,把 VLN 化为类型化选择;R2R-CE 达 27.0% SR、22.4% SPL,单步 0.65 秒。Kai Sheng, Liuyi Wang, Jinlong Li · 172次阅读 · 2026年9月28日视觉语言导航零样本2026年9月28日
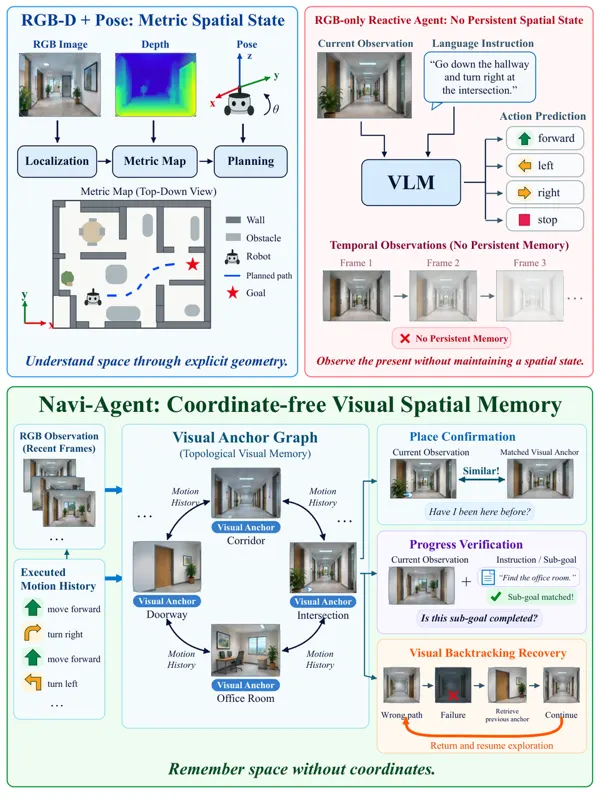
Navi-Agent:无定位单目导航智能体Navi-Agent 仅用单目 RGB 构建无坐标视觉锚点图,以视觉重访做地点确认、进度校验与失败恢复,R2R-CE_100 成功率 33.4%。Xie, Wenyuan, Hong, Mengyang, Wang, Yongzhong · 797次阅读 · 2026年9月17日VLN视觉语言导航2026年9月17日
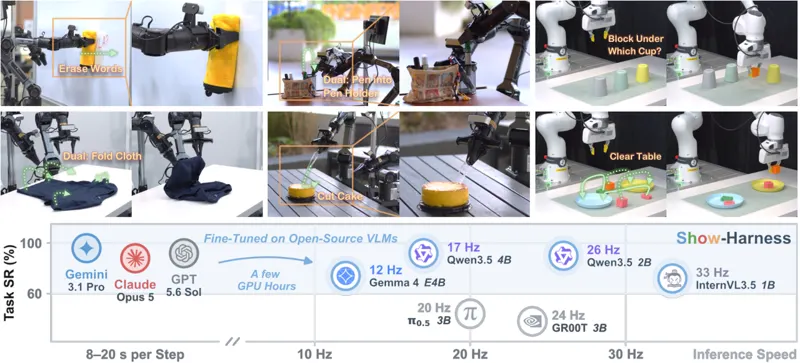
Show-Harness:仅凭一个 VLM 智能体就能「玩」机器人基础视觉语言模型(VLM)对世界已有广泛认知,但把这种认知转成机器人控制仍然困难。我们提出 Show-Harness——一套「具身 harness」,通过连接意图与动作的紧凑语义接口,让 VLM 直接「玩」机器人。Show-Harness 对外暴露 VLM 天然可推理的离散语义动作单元,再由机体专属的解释器把它们确定性地接地为局部机器人动作,使 VLM 始终对细粒度物理决策负责。基于同一接口,我们验证了两条路径:(1)直接解锁闭源前沿 VLM 实现零样本机器人控制;(2)只需几 GPU 小时微调,即可把小规模开源 VLM 适配为低成本部署的策略。我们进一步做出 GUMI(GUI 操作界面),把同一语义动作空间延伸到基于 GUI 的演示采集,让人类与智能体无需专用遥操作硬件即可跨机体「玩」机器人。大量实验表明,装配 Show-Harness 的 VLM 智能体在任务、机体与环境之间稳健泛化,优于代表性的 agentic 与 VLA 范式。这些结果说明:合适的接口本身就能从基础 VLM 中释放大量具身能力,无需额外的模型容量,也无需昂贵的机体专属预训练。Yanzhe Chen, Zechen Bai, Zhijun Cao · 1198次阅读 · 2026年9月9日视觉语言模型Agentic Harness2026年9月9日
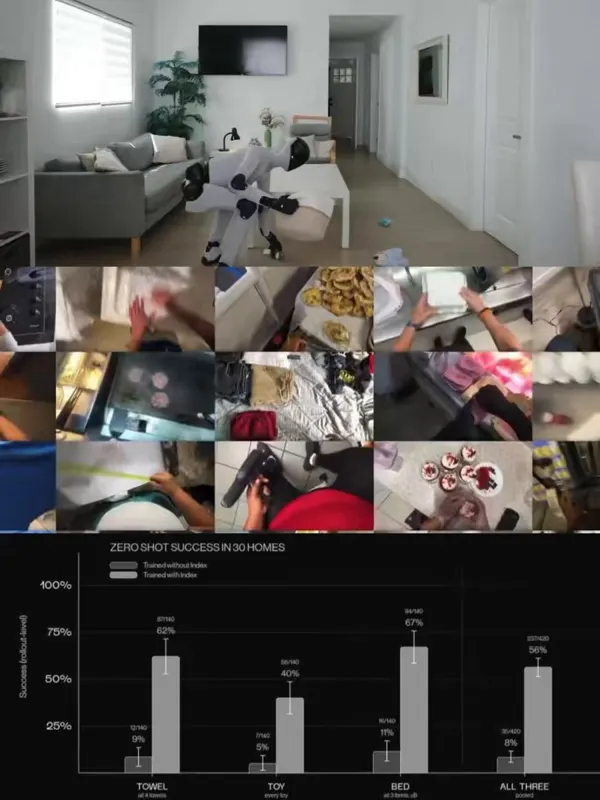
2:26Coupled 世界模型训练 G1 接触操作@chris_j_paxton · 1019次播放 · 2026-09-04Coupled Local and Global World ModelsFoG
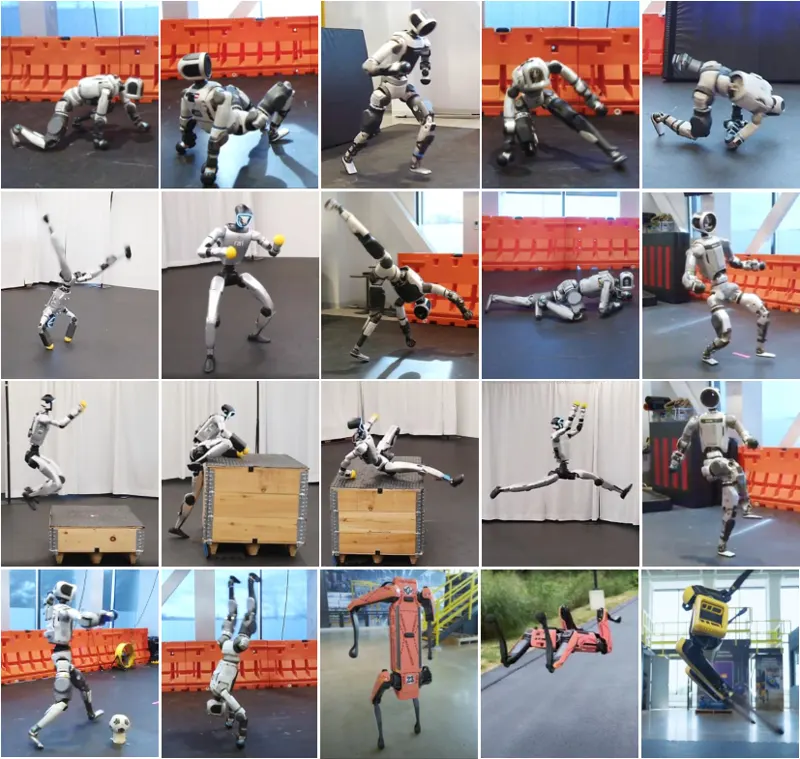
ZEST:面向运动型机器人控制的零样本具身技能迁移ZEST 用单阶段强化学习,把动作捕捉、单目视频和关键帧动画三类异构参考动作统一训练成模拟策略,零样本部署到 Atlas、Unitree G1 和 Spot,实现全尺寸人形机器人上首个动态多接触技能,无需接触标签、状态估计器或逐技能调参。Jean Pierre Sleiman, He Li, Alphonsus Adu-Bredu · 874次阅读 · 2026年1月30日ZEST仿真到现实2026年1月30日
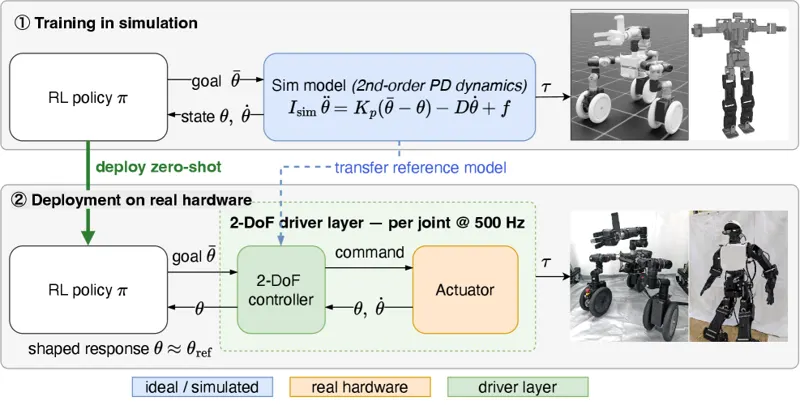
执行器现实塑形实现零样本 sim-to-real 机器人学习每关节2-DoF控制器(前馈+反馈)+可选扰动观测器让物理执行器复现仿真器二阶参考动力学,将 sim-to-real 适配从策略层移到透明驱动层,实现零样本迁移无需硬件特定数据。Satoshi Yamamori, Koji Ishihara, Kenjiro Minamikawa · 526次阅读 · 2026年7月2日仿真到现实零样本2026年7月2日
航空多模态大模型智能体的零样本任务级评估多模态大模型正成为航空任务的核心,本工作提出零样本任务级评估框架。Suman Navaratnarajah, Taehyoung Kim, Jona Ruthardt · 468次阅读 · 2026年7月24日AerialMLLM2026年7月24日
前沿论文rt2-2024RT-2:视觉-语言-动作模型将网络知识迁移到机器人视觉语言动作模…谷歌具身智能RT-2: 视觉-语言-动作模型将网络知识迁移到机器人RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。Google DeepMind · 610次阅读视觉语言动作模型谷歌