
PAPER DEEP DIVE
视觉语言动作模型谷歌具身智能
RT-2: 视觉-语言-动作模型将网络知识迁移到机器人
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
PAPER DEEP DIVE
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
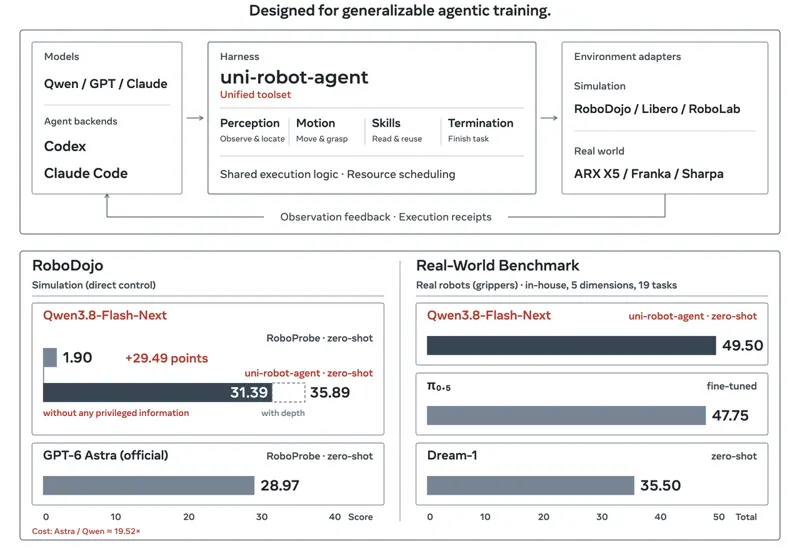
uni-robot-agent 将模型、调度、共享工具、服务与后端拆成统一机器人使用框架,通过异步流水线、不可变观测、可追踪执行和结构化反馈,让不具备特权输入的开放权重模型直接操控机器人;Qwen3.8-Flash-Next 在 RoboDojo 上取得 31.39 分,超过已发表的 GPT-6 Astra–RoboProbe 28.97 分,并在 19 项真实任务上取得 49.50 分。
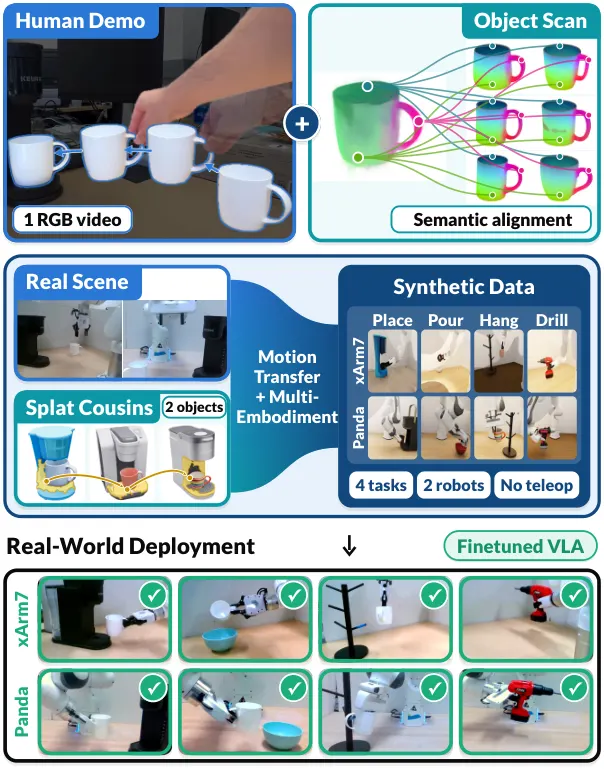
人类视频采集成本低且不依赖机器人硬件,但现有方法通常需要深度传感器、把机器人叠加到二维视频中,或只针对已演示的单个物体生成数据。本文提出 Real2Sem2Real(R2Sem2R),将一段单目 RGB 人类演示转化为覆盖同类别多个语义实例的数千条机器人示范。方法先用蒸馏了 DINOv3 特征的高斯泼溅通过渲染比较跟踪物体 SE(3) 位姿,再以语义整体对齐和功能区域加权对齐把仅由一张或几张照片生成的数字表亲映射到演示场景。人类手部抓取经 HaMeR 恢复后转换为可行平行夹爪抓取,并随语义对齐迁移到不同实例。机器人示范可在 IsaacSim 中生成照片级渲染,或在 MuJoCo 中计算接触物理;单张 RTX 5090 约两小时可生成 2000 条示范。作者在两种真实机器人和四类任务上训练视觉语言动作策略,发现仅用每个任务的一段人类视频生成的数据即可匹敌或超过遥操作数据。
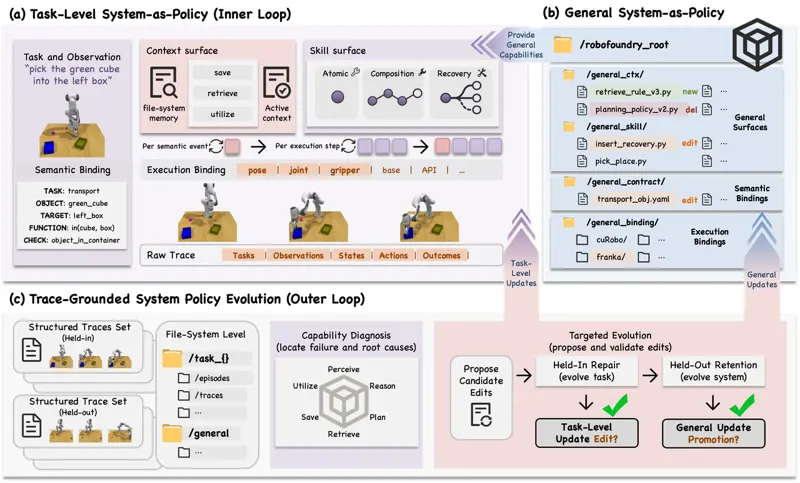
RoboFoundry 冻结基础模型,把上下文、技能与语义绑定组成可演化系统,在多个基准和真实机器人上持续修复失败并迁移经验。
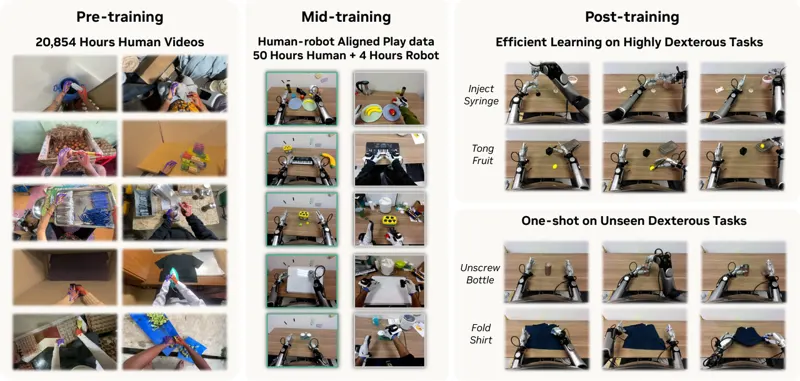
提出基于大规模第一视角人类视频的 VLA 训练框架 EgoScale:在 20,854 小时动作标注人类数据上预训练,发现数据规模与验证损失呈对数线性关系;再通过少量对齐的人机协同中训练接地到机器人控制。22 自由度灵巧手策略相对无预训练基线平均成功率提升 54%,并能迁移到低自由度手。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。