PAPER DEEP DIVE
VideoJev:面向视频理解与交互的系统一模型
VideoJev 将时序定位与多选视频问答统一为候选打分,共享打分头直接评估区间与选项,免去自回归解码;两种推理模式复用视频前缀,七基准精度更优、加速最高百倍。
一句话总结
VideoJev 把视频理解与交互改写成"对候选打分"的结构化决策:用一个共享打分头替换大语言模型的自回归生成头,让时序定位和选择题问答在同一次前向里直接读出概率,从而以百分之一到三百分之一的推理延迟逼近甚至超过思考模式的生成式模型。
研究背景与动机
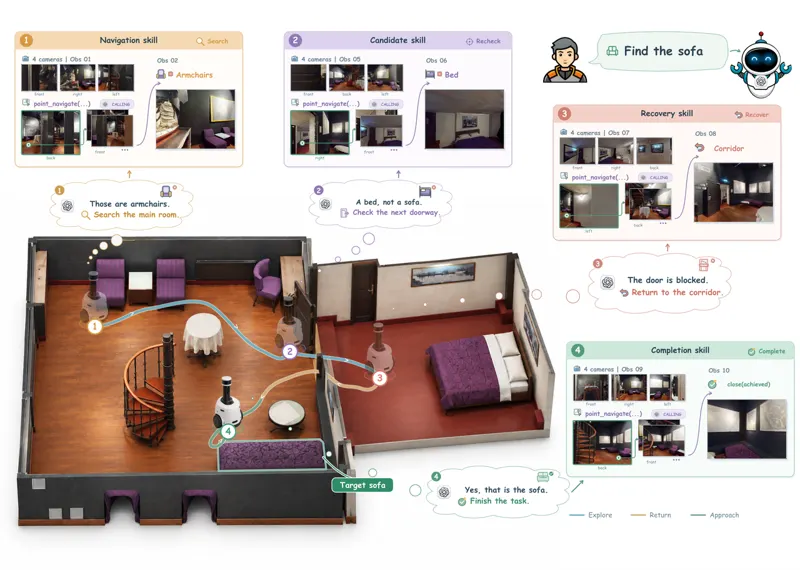
视觉智能体要在真实交互中不断对视频做出判断:定位某件事发生在哪一段时间、核对某个前置条件是否满足、在若干候选动作里挑出最合适的一个。一个跟着菜谱做菜的助手,可能要先确认"调料是否已经下锅",再决定下一步。这类判断的共同点是输出结构紧凑、可被程序直接消费,而不是长篇自由文本。
现有两条技术路线各有短板。判别式视觉模型预测高效,但往往依赖任务专用设计与固定标签空间,换一个任务就要换一套头。视频多模态大模型(MLLM)语义宽、接口灵活,却习惯用自回归生成来表达一切决策:时序定位要逐 token 生成时间戳,选择题要生成答案文本,哪怕最终答案只是一个区间或一个字母。
System One(系统一)范式为此提供了思路。Jev 系列工作提出"类型化概率判断":模型一次前向就输出带概率的结构化结论,软件可以直接取用,无需逐 token 生成。该范式此前已被扩展到图像(Visual Jev、PixelJev),但视频带来两个额外要求:决策必须反映时间结构,且多次查询要共享昂贵的视觉上下文。
当交互逐步展开时,新目标和中间结果会不断触发对同一段视觉历史的追问。此时"每一次额外判断的边际成本"成为交互是否跟手的关键。如果每问一次都要重新编码整段视频、重新自回归生成一遍答案,延迟会线性堆叠,智能体无法实时响应。
VideoJev 因此围绕两条原则设计:直接候选打分(direct candidate scoring)与可复用视觉计算(reusable visual computation)。前者让时序区间与文本选项共用一个打分架构,靠任务特定的监督与输出规则保留各自结构;后者让视频前缀只编码一次,后续查询以 Cached 或 Joint 两种模式复用。
预备知识:从生成到决策的读出头
VideoJev 的出发点是一个观察:预训练 MLLM 在进入末层 MLP 之前的特征就已经很好地支撑语义相似度(这一观察来自 FreeRet 等工作)。因此作者删掉最后一层的 MLP 分支,并把语言模型的输出头替换为一个候选打分头。打分头不生成 token,而是对序列中特定标记位置的隐状态做投影与归一化,再算余弦相似度得到 logit。
为承载"候选"与"决策"两类读出,作者新增两个特殊标记 <|option_end|> 与 <|decide|>,二者嵌入均从预训练的 <|im_end|> 嵌入复制初始化。每个候选以 <|option_end|> 结尾,候选列表末尾放一个 <|decide|>。因果注意力使得每个候选读出能看到视频、查询与它之前的候选,而决策读出能看到完整列表。
打分的具体形式是:把决策隐状态与各候选隐状态分别经线性投影到 512 维并做 L2 归一化,取余弦相似度乘以固定尺度 10 再加一个可学习标量偏置,得到 logit:
$$u=\frac{W_{q}h_{d}+b_{q}}{\|W_{q}h_{d}+b_{q}\|_{2}},\qquad v_{i}=\frac{W_{k}h_{i}+b_{k}}{\|W_{k}h_{i}+b_{k}\|_{2}},\qquad s_{i}=10\,u^{\top}v_{i}+b \tag{1}$$
其中 $h_{d}$ 与 $h_{i}$ 分别是决策状态与第 $i$ 个候选状态,$W_{q},W_{k},b_{q},b_{k}$ 为可学习投影参数,尺度固定为 10、偏置 $b$ 可学习。这个式子是整个模型的"决策接口":时序任务与选项任务共用它,只是后续如何把 logit 变成输出不同。
方法详解
统一的候选表示
给定视频 $V$、语言查询 $q$ 与 $K$ 个候选 $C=\{c_{1},\ldots,c_{K}\}$,序列排布为:视频 token 在前,随后是任务指令、查询、候选列表。指令指明当前是时序定位还是选择题问答。时序候选是把视频前缀里的时间戳文本复制进候选列表,每个时间戳标识一个"帧对区间";选项候选则是答案文本。候选与输出规则共同决定任务类型,架构本身不变。
由于因果建模使视频前缀独立于后续查询,这段计算可以被共享。Cached 推理把视频编码并预填充一次,每个到达的查询从缓存前缀分叉,只需对自身查询、候选与读出 token 做一次语言模型前向。Joint 推理则把多个查询及其候选列表拼在同一个视频前缀之后,每个查询各带一个 <|decide|> 读出,一次因果前向即得全部查询的分数。训练时也采用同样的拼接布局,让视觉计算在多个问题间共享。
时序定位:区间成员判定 + 覆盖监督
骨干网络的两级时间压缩把帧两两分组,作者据此把时间轴划分为 $K$ 个候选区间,每对帧一个。对区间 $B_{i}=[\ell_{i},r_{i}]$,$t_{i}$ 取两帧时间戳的均值,内部边界取相邻帧对之间的中点,$\ell_{1}=0$、$r_{K}$ 等于视频时长。设 $G$ 为标注事件区间的并集,则候选标签为 $y_{i}=\mathds{1}\{t_{i}\in G\}$,成员概率为 $p_{i}=\sigma(s_{i})$。一个事件可能覆盖多个候选,故用多标签二元交叉熵独立监督每一个候选:
$$\mathcal{L}_{\mathrm{BCE}}=-\frac{1}{K}\sum_{i=1}^{K}\left[y_{i}\log p_{i}+(1-y_{i})\log(1-p_{i})\right] \tag{2}$$
BCE 只监督局部成员关系,不直接奖励"把事件整体盖住"。为此作者加入按区间时长加权的软 IoU 损失。记区间时长 $d_{i}=r_{i}-\ell_{i}$:
$$\mathcal{L}_{\mathrm{IoU}}=1-\frac{\sum_{i}d_{i}p_{i}y_{i}}{\sum_{i}d_{i}\left[y_{i}+p_{i}(1-y_{i})\right]} \tag{3}$$
分子奖励对事件的覆盖,分母惩罚事件之外的响应;按 $d_{i}$ 加权是为了处理不等长区间。当没有任何中点为正时软 IoU 项被省略,BCE 也只作用于有效候选。
把区间分数拼成事件跨度时,作者对 logit 做概率阈值 $\tau$ 的平移,再取和最大的非空连续段,全程固定 $\tau=0.25$、平滑窗口 1:
$$(a^{\star},b^{\star})=\arg\max_{1\leq a\leq b\leq K}\sum_{i=a}^{b}\left[s_{i}-\log\frac{\tau}{1-\tau}\right] \tag{4}$$
该最大子段问题用 Kadane 算法在 $O(K)$ 时间内求解;选中候选的区间边界即连续预测 $[\ell_{a^{\star}},r_{b^{\star}}]$。若所有平移后的 logit 都为负,解码器退回到分数最强的单个候选区间,再做轻量边界后处理得到合法非空区间。代码 timejev/temporal.py::decode 中 z = z - np.log(threshold/(1-threshold)) 与随后的 Kadane 循环正是式 (4) 的逐字实现,且注释说明"全负序列返回最强单帧、不使用真值"。
选择题问答:softmax 偏好 + 位置偏置抑制
选择题要求从 $K$ 个文本选项中选一个。共享打分头给选项 $i$ 赋 logit $s_{i}$,设正确选项下标为 $y$。由于恰好一个答案正确,用 softmax 归一化并以交叉熵训练:
$$p_{i}=\frac{\exp(s_{i})}{\sum_{j=1}^{K}\exp(s_{j})},\qquad \mathcal{L}_{\mathrm{CE}}=-\log p_{y} \tag{5}$$
为抑制"靠选项位置走捷径",作者对每条可置换的训练题施加一个可复现、与答案无关的选项排列,并同步更新正确选项下标;涉及选项位置或指代前文的题目保留原序以免改变语义。推理时保持给定顺序,选 $p_{i}$ 最大者。代码 timejev/qa_option_permutation.py 以 PROTOCOL='qa_option_permutation_sha256_v1' 记录协议,并在报告里显式声明 permutation_independent_of_correct_answer=True、evaluation_permuted=False,即评测不做置换。
两阶段训练配方
时序成员监督用 TimeLens-100K 与 TimeLens2-93K,把标注区间转成候选级标签;选项监督用一个内部 curated 语料,约 24 万道选择题、覆盖 1.9 万条视频,内容含游戏、体育、烹饪、音乐舞蹈、户外与手工,问题覆盖实体与动作识别、时空推理、信息检索、事件理解、计数、OCR 与摘要,视频时长从 4 分钟到近 2 小时,每题四或五个选项。同视频的多条查询围绕共享前缀分组。
受 MLLM 投影层对齐的启发,作者先冻住骨干、只训打分头,再联合微调骨干。第一阶段只在 30% 视频上训头(骨干与新标记嵌入冻结),目标为:
$$\mathcal{L}_{\mathrm{TG}}=\mathcal{L}_{\mathrm{BCE}},\qquad \mathcal{L}_{\mathrm{QA}}=\mathcal{L}_{\mathrm{CE}} \tag{6}$$
第二阶段在剩余 70% 视频上联合训练语言骨干、标记嵌入与对齐后的头,时序任务加入软 IoU 覆盖监督,问答保持交叉熵:
$$\mathcal{L}_{\mathrm{TG}}=\mathcal{L}_{\mathrm{BCE}}+2\,\mathcal{L}_{\mathrm{IoU}} \tag{7}$$
$$\mathcal{L}_{\mathrm{QA}}=\mathcal{L}_{\mathrm{CE}} \tag{8}$$
任务损失在问题间等权平均;视觉编码器与 merger 全程冻结;每阶段一个 epoch、各自独立的优化器与学习率调度。两阶段分别跑 160 与 375 次优化更新,64 张 H200、BF16、全局批 64 条打包序列,训练视频 2fps 采样、最长 144K token、视觉 token 预算 80%;AdamW 权重衰减 0.01、梯度裁剪 1.0,5% 预热后余弦衰减到峰值的 10%;头学习率对齐期 3e-4、联合期 1e-4,骨干学习率 4B 为 5e-6、35B-A3B 为 2e-6;4B 用 DeepSpeed ZeRO-2、35B-A3B 用 ZeRO-3。代码 timejev/staged_training.py 以 timejev_head_stage_v1 检查点格式强制"头阶段→联合阶段"的交接,且每阶段新建 AdamW。
方法流程总览
flowchart TD
  V["视频 V 按 2fps 采样 帧两两分组"] --> ENC["视觉编码器 + merger 全程冻结"]
  ENC --> PREF["共享视频前缀 只编码一次"]
  Q["语言查询 q 与任务指令"] --> PREF
  C["K 个候选 时间戳区间 或 文本选项"] --> SEQ["序列拼接 视频 + 指令 + q + 候选 + option_end + decide"]
  PREF --> SEQ
  SEQ --> ATT["因果注意力 末层仅注意力 删除 MLP"]
  ATT --> HEAD["共享打分头 余弦相似度 x10 + 可学习偏置"]
  HEAD --> TG["时序分支 sigmoid 成员概率 p_i"]
  HEAD --> QA["选项分支 softmax 概率 p_i"]
  TG --> KAD["Kadane O K 取阈值平移后最大连续段 tau=0.25"]
  KAD --> SPAN["输出事件区间"]
  QA --> ARG["argmax p_i"]
  ARG --> ANS["输出答案选项"]
  PREF --> CI["Cached 推理 查询逐条到达 复用缓存"]
  PREF --> JI["Joint 推理 多查询一次前向 各自 decide 读出"]
源码与论文的对应
删末层 MLP 在 timejev/readout.py 中体现为把最后一层重新归类为 AttentionOnlyDecoderLayer 并删除两个子模块:
# timejev/readout.py::adapt_readout
final.__class__ = AttentionOnlyDecoderLayer
del final.mlp
del final.post_attention_layernorm
新标记从 <|im_end|> 嵌入复制初始化、打分尺度固定 10 且偏置可学习,见 timejev/decision_model.py:
# timejev/decision_model.py
im_end = tokenizer.convert_tokens_to_ids('<|im_end|>')
initial = embedding.weight[im_end].detach().clone()
for token in SPECIAL_TOKENS:            # ['<|decide|>', '<|option_end|>']
    embedding.weight[tokenizer.convert_tokens_to_ids(token)].copy_(initial)
# head: similarity='cosine', logit_scale=10.0, trainable_scale=False, trainable_bias=True
软 IoU 的时长加权交并比在 timejev/decision_model.py::_duration_soft_iou_loss 中按 intersection = (durations*probabilities*targets).sum(1)、union = (durations*(targets+probabilities*(1-targets))).sum(1) 计算,且"无正中点时保持纯 BCE";任务损失的组合在 timejev/losses.py::decision_losses 中写作 per_query = where(choice, ce, bce) + soft_iou_weight*iou,与式 (6)-(8) 一致。
实验结果
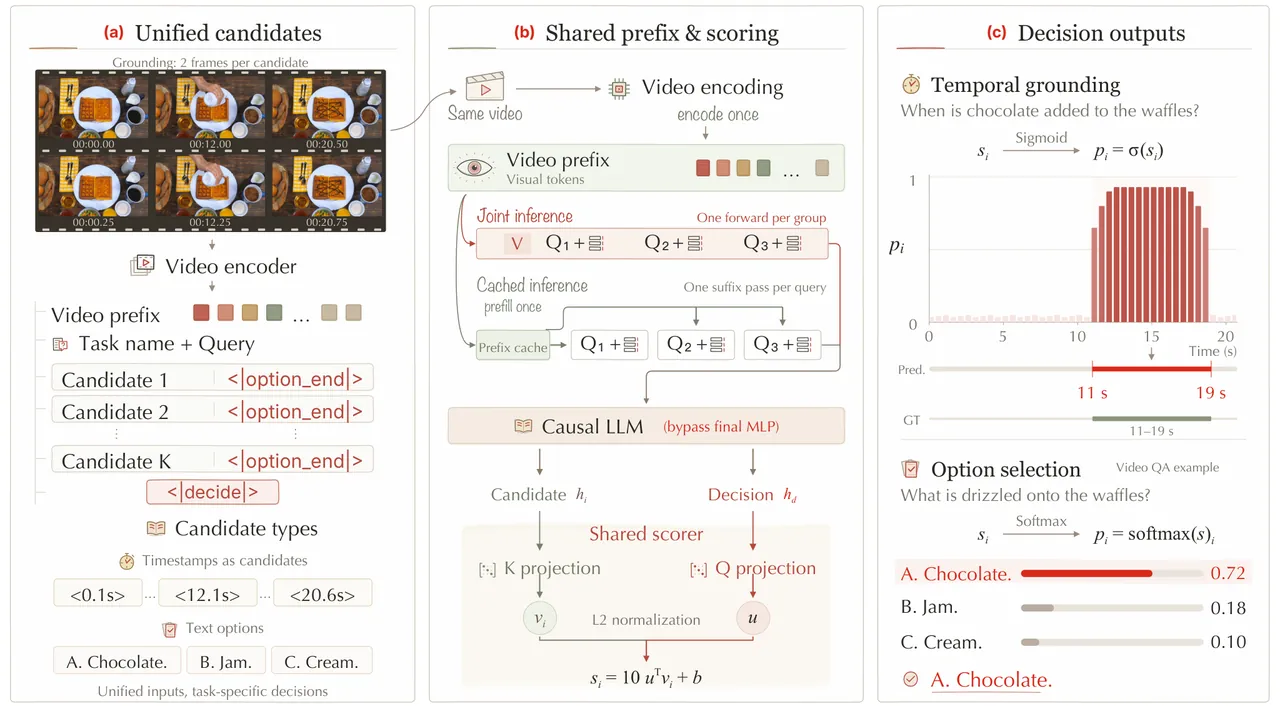
图1:VideoJev 的统一候选打分架构。(a) 时序区间与文本选项共用输入格式;(b) Cached 与 Joint 两种推理模式共享骨干与打分头;(c) 时序分数解出事件跨度、选项分数选出答案。
时序定位:全面领先且延迟最低
在 TimeLens-Bench 精修标注的 Charades-STA、ActivityNet Captions、QVHighlights 三个基准上,VideoJev-4B 以 0.276 秒/查询的实测前向时间取得 65.3 的平均 mIoU,比其骨干 Qwen3.5-4B 高 6.7 点、比专门的 TimeLens2-4B 高 3.3 点;在更严格的 R1@0.7 上相对 TimeLens2-4B 还高出 2.8-4.8 点,说明区间成员打分确实恢复了更精确的时间边界。VideoJev-35B-A3B 把平均 mIoU 推到 67.7,比 Qwen3.6-35B-A3B 高 10.8 点;从 4B 扩到 35B-A3B 只增加 22% 实测延迟就换来 2.4 点提升。两个尺寸在各自开源组内所有指标领先且延迟最低,相对骨干有 2.8-3.1 倍加速;由于生成式基线同样共享视频预填充,这一加速纯粹来自"不再自回归生成时间戳"。
| 模型 | 秒/查询 | Charades mIoU | ActivityNet mIoU | QVHighlights mIoU | 平均 mIoU |
|---|---|---|---|---|---|
| VideoJev-4B | 0.276 | 60.1 | 62.8 | 73.2 | 65.3 |
| Qwen3.5-4B(骨干 Instruct) | 0.763 | 52.3 | 55.6 | 67.9 | 58.6 |
| TimeLens2-4B | 0.646 | 57.7 | 59.0 | 69.3 | 62.0 |
| VideoChat3-4B | 1.067 | 56.1 | 54.6 | 67.0 | 59.2 |
| VideoJev-35B-A3B | 0.336 | 63.7 | 65.5 | 74.0 | 67.7 |
| Qwen3.6-35B-A3B(骨干 Instruct) | 1.054 | 47.3 | 56.0 | 67.5 | 56.9 |
| Gemini-2.5-Pro | - | 52.8 | 58.1 | 70.4 | 60.4 |
选择题问答:用百分之一延迟追平思考模式
在 LVBench、Video-MME、LongVideoBench、MLVU 四个基准上,VideoJev-4B 与 35B-A3B 相对各自 Instruct 骨干分别提升 8.0 与 5.7 点,四基准均值达 74.3 与 79.5,且每个基准都有增益。更有说服力的是与思考模式的对比:VideoJev-4B 均值 74.3 仅比 Qwen3.5-4B Thinking 的 74.9 低 0.6 点,而 VideoJev-35B-A3B 的 79.5 反超 Qwen3.6-35B-A3B Thinking 的 78.8 达 0.7 点;两者在 LVBench 上均胜过各自的 Thinking 版本。代价方面,Thinking 基线单题实测 144.929 秒与 149.777 秒,VideoJev 为 1.123 秒与 1.493 秒,即 129 倍与 100 倍加速。Thinking 仅在 Video-MME 与 MLVU 上保留优势,说明显式推理对某些需要长链推导的题目仍有用,但对多数结构化判断而言直接打分已足够。
| 模型 | 秒/题 | LVBench | Video-MME | LongVideoBench | MLVU | 四基准均值 |
|---|---|---|---|---|---|---|
| VideoJev-4B | 1.123 | 67.9 | 75.0 | 73.6 | 80.6 | 74.3 |
| Qwen3.5-4B Instruct | 1.355 | 60.0 | 70.6 | 61.2 | 73.3 | 66.3 |
| Qwen3.5-4B Thinking | 144.929 | 66.4 | 76.9 | 73.6 | 82.8 | 74.9 |
| VideoJev-35B-A3B | 1.493 | 73.4 | 81.8 | 77.1 | 85.9 | 79.5 |
| Qwen3.6-35B-A3B Instruct | 2.379 | 66.0 | 77.1 | 72.4 | 79.5 | 73.8 |
| Qwen3.6-35B-A3B Thinking | 149.777 | 71.4 | 82.5 | 74.9 | 86.2 | 78.8 |
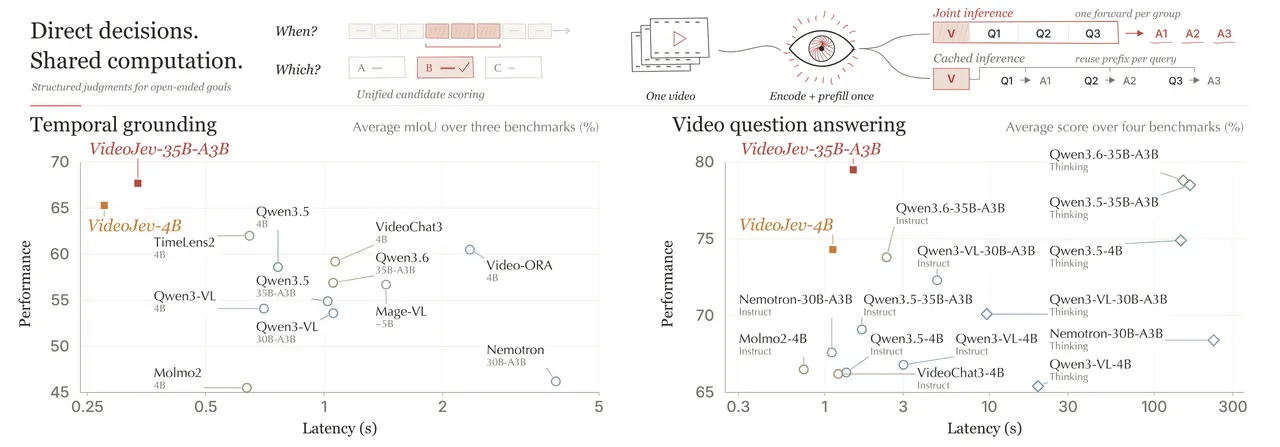
图2:teaser。上排为共享候选打分与可复用视觉计算示意;下排为两个尺寸下"预测质量 vs 模型前向延迟"的散点,VideoJev 位于左上(高质量、低延迟)区域。
消融:增益来自架构而非数据
为排除"只是数据好"的解释,作者用完全相同的后训练数据单阶段微调一个保留原生末层 MLP 与语言模型头的普通 Qwen3.5-4B 自回归模型。结果 VideoJev-4B 在平均 grounding mIoU 与平均 QA 上仍分别高 1.3 与 1.9 点,说明直接监督时序成员与选项偏好让读出头与所需决策对齐,是架构层面的收益。其余消融同样指向设计的有效性:Joint 推理相对 Cached 推理在 4B 上把 grounding/QA 均值提高 0.8/0.5 点、35B 上提高 0.3/0.7 点(14 个模型-基准对比中 13 个提升),与训练布局一致;时序与问答联合训练比单任务训练在全部七个基准上都更好(grounding +0.7、QA +1.3,LongVideoBench 上 +1.9);软 IoU 把 grounding 均值从 60.7 抬到 65.3(+4.6)、QA 从 73.9 抬到 74.3;删除末层 MLP 不降反升约 0.2 点,作者据此采用更简读出头;两阶段调度与单阶段性能相当,但骨干只在 70% 视频上更新,成本更低。
| 设置(VideoJev-4B) | grounding 平均 mIoU | QA 四基准均值 | 相对基线变化 |
|---|---|---|---|
| 完整模型(Joint + 软IoU + 去MLP + 两阶段) | 65.3 | 74.3 | 基线 |
| 同数据自回归 SFT 对照 | 64.1(-1.3 对 65.4 单阶段) | 72.8(-1.9 对 74.7) | 架构增益 +1.3 / +1.9 |
| 改用 Cached 推理 | 64.5 | 73.8 | -0.8 / -0.5 |
| 去掉软 IoU(仅 BCE/CE) | 60.7 | 73.9 | -4.6 / -0.4 |
| 保留末层 MLP | 65.1 | 74.1 | -0.2 / -0.2 |
| 单阶段(100% 视频) | 65.4 | 74.7 | +0.1 / +0.4(但骨干全量更新) |
多查询扩展与置信度校准
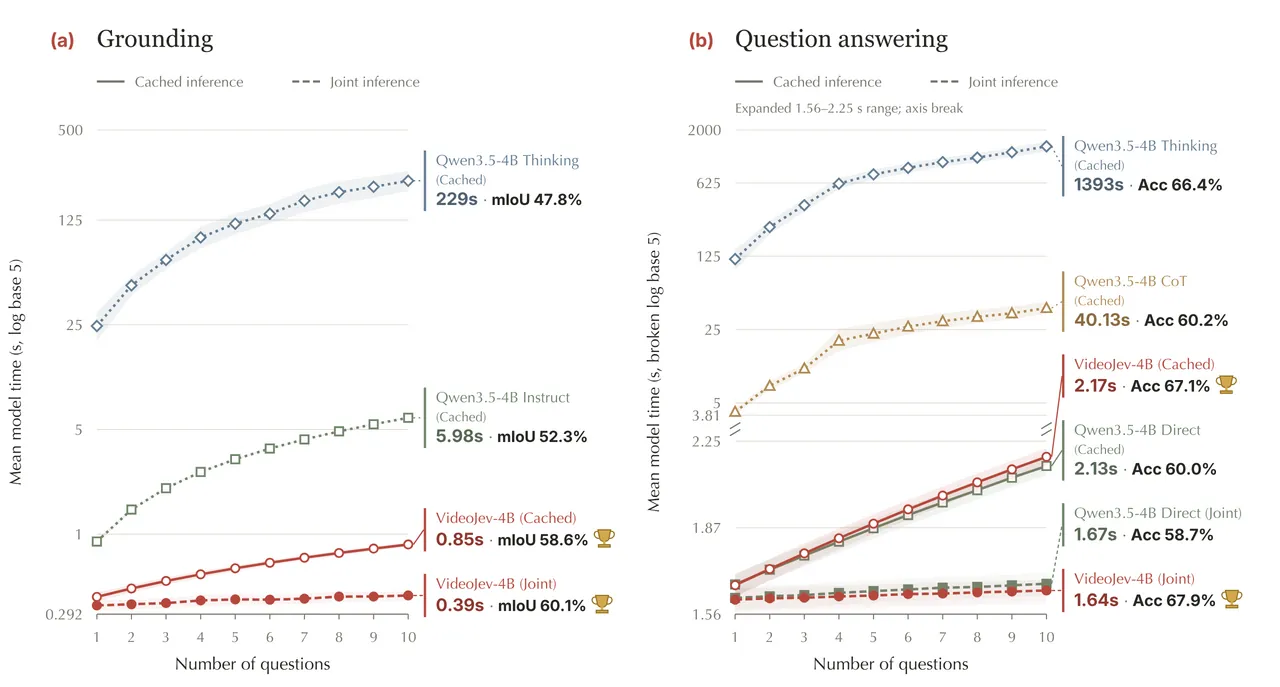
图3:1-10 条查询下的平均前向时间。(a) Charades 时序定位;(b) Video-Holmes 问答。Joint 推理(虚线)随查询数增长几乎水平,Cached 与多 token 生成(点线)显著上扬。
对同一段视频从 1 条查询增加到 10 条,Joint 推理只额外增加 55 毫秒(grounding)与 31 毫秒(QA);10 条查询时前向时间为 0.39 秒与 1.64 秒,而 Cached 推理为 0.85 秒与 2.17 秒,且独立测得的 Charades mIoU 与 LVBench 准确率还分别高 1.5 与 0.8 点。对照之下,自回归 Direct 问答在 Joint 下准确率从 60.0% 掉到 58.7%(VideoJev 同延迟下 67.9%);Qwen3.5-4B Instruct 跑 10 条 grounding 查询要 5.98 秒且 mIoU 仅 52.3;Qwen Thinking 跑 10 条 QA 查询要 1393 秒、准确率 66.4%。边际成本近乎为零且不损失质量,是 VideoJev 作为"可组合决策接口"的核心卖点。
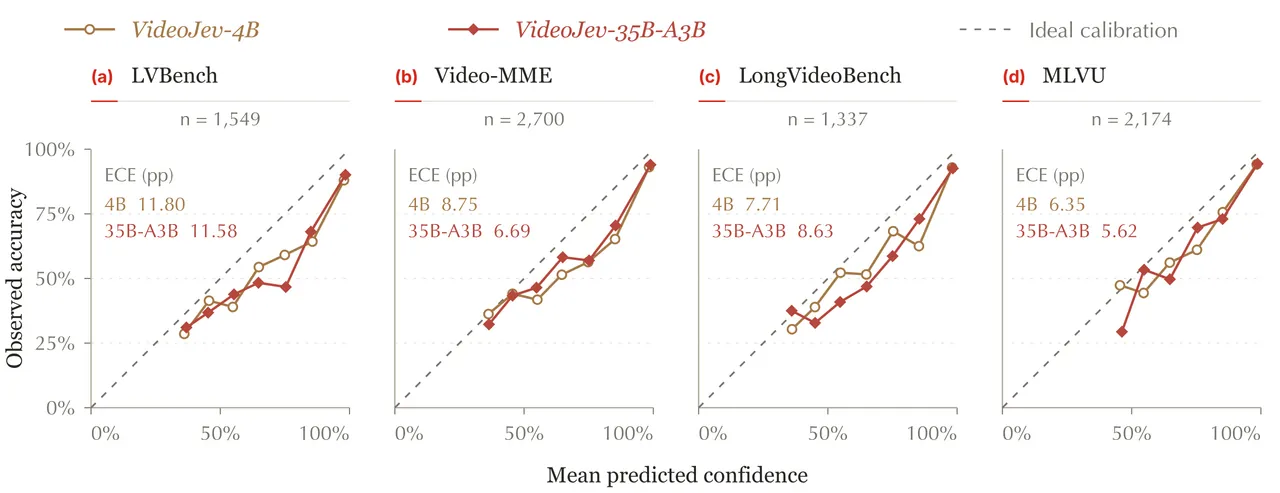
图4:四个基准上的置信度-准确率校准曲线。高置信区间准确率显著更高,但整体概率偏高(过自信)。
候选分数还可用作"何时可信"的信号。取最高选项概率 $\max_{i}p_{i}$,在 LVBench 上 35B-A3B 模型对 591 条置信度不低于 99% 的预测达到 95.8% 准确率,而整体准确率仅 73.4%,这种分离为"选择性采纳高置信答案、把不确定的升级给上层推理"提供了空间。但作者也坦承校准并不完美:四基准平均期望校准误差(ECE,十个等宽 bin)为 8.65 与 8.13 个百分点(4B 与 35B-A3B),概率系统性高估正确率,因为 VideoJev 没有接受任何校准专用训练(Jev 用强化学习显式优化校准)。
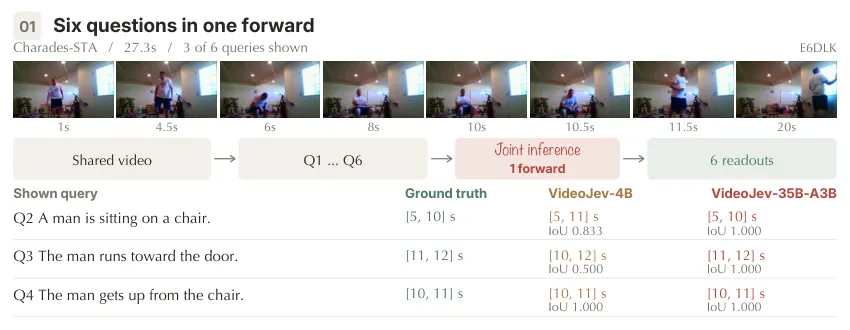
图5:Joint 推理一次前向回答六条 Charades 查询的定性对比,绿色为真值,两个尺寸都能对齐一秒级的转场,35B-A3B 对相邻动作定位更准。
局限性
其一(作者自述):决策被限制在闭集候选内。VideoJev 只能对"给定的候选区间或给定选项"打分,无法开放生成;作者在 Future Work 中明确表示需要由上层 System Two 智能体来提议候选、组织决策空间,才能覆盖开放目标。其二(作者自述):概率过自信、缺乏校准训练,ECE 达 8-9 个百分点,需要温度缩放或校准感知训练来补救;流式输入也尚未支持,需要增量视觉编码与记忆管理。其三(本文判断):选择题评测只覆盖 MCQ 形式,内部 24 万问答语料未公开,第三方难以复现 QA 增益的来源;固定 $\tau=0.25$ 与平滑窗口 1 在所有数据集与尺寸上不做调参,虽保证可比性,但可能在某些分布上并非最优阈值。其四(本文判断):Joint 推理让后续查询能注意到先前查询与候选,尽管作者验证了答案不泄漏,但查询顺序仍可能影响分数,作为对外接口时顺序敏感性值得警惕。
总结与展望
VideoJev 的贡献在于把"视频理解"从生成问题改写成决策问题:一个共享打分头同时承担时序成员判定与选项偏好,配合 Cached 与 Joint 两种前缀复用模式,让重复判断的边际成本趋近于零。七个基准上的结果与同数据自回归对照共同说明,收益既来自数据也来自架构,且两个任务在联合训练中互相促进。展望部分,作者计划把候选接口扩展到动作识别、事件检测、场景状态分类与视觉条件核验等更多决策类型,让上层智能体用标准作业流程或生成计划把开放目标分解为可视检查,由 System One 对视觉证据逐条评估;同时推进流式编码、校准感知训练与选择性预测,以决定何时采纳系统一判断、何时上交更高层推理。对机器人开发者而言,这条路线意味着感知层可以返回带置信度的结构化判断而非自由文本,便于直接嵌入规划与执行循环。
金句
"结构化视觉判断可以支撑开放行为,而无需在每一步都做开放式生成。"
"当连续的问题共享同一段观测时,每一次额外判断的成本就成为响应式交互的核心。"
"System Two 组织决策空间,System One 对视觉证据评估它。"