PAPER DEEP DIVE
LoopWAM:从部署回放中闭环改进的通才机器人策略
只堆专家示范,通才机器人策略并不会因为「上了真机」就变强:部署回放里既有成功,也有次优动作和彻底失败,逐个动作照抄会把坏行为一起学进去,而把失败样本直接丢掉,又丢掉了物理交互及其后果的证据。LoopWAM 是一个闭环的世界动作模型(world-action model),它直接从这份「全质量谱系」的回放里学习,回放既可以来自它自己,也可以来自别的已部署策略(X-VLA、π0.5)。方法上有三块互相咬合的设计:源相关噪声采样把行为学习与动作条件世界建模统一进同一个联合去噪目标——示范数据只对视频加噪、回放数据只对动作加噪,两条流在每一层的联合注意力里交互,学到的「后果」因此能直接参与动作生成;质量引导把质量分数写进指令后缀 Quality: q,部署时固定取最高档,使同一个模型既能被引导也能被评估;质量加权监督用 λ(q) 调节动作项的模仿强度(q=1,2 为 0.0,q=3 为 0.3,q=4 为 0.6,q=5 为 1.0),视频监督则在全质量段完整保留。模型由 Wan2.2-TI2V-5B 初始化,视频 DiT 30 层 3072 维、动作 DiT 30 层 1024 维,flow matching 训练。结果:RoboChallenge Table30-V2 上三轮「部署—采集—再训练」把成功率从 23.67% 拉到 43.33%(+19.7 个百分点),总分 36.10→56.80;RoboTwin 2.0 平均成功率 94.5%(用 LoopWAM、X-VLA、π0.5 三个策略共 22,500 条回放训练);RoboCasa365 总成功率 14.9%→49.5%,三项基准在对比方法中都是最好,且没有做额外的具身预训练。最难的叠衣服任务上,单任务后训练之后再跑两轮部署驱动改进,成功率从 13.20% 升到 55.56%。消融显示:完全不做质量引导只有 72.3%,粗粒度标注加上质量加权动作监督才到 94.5%。项目页 https://loop-wam.github.io/
论文元信息
标题:LoopWAM: Closed-Loop Generalist Policy Improvement from Deployment Rollouts
作者:Wenxuan Guo、Yingping Liang、Zhaoguo Wang(共同一作),Ziyuan Li、Angyuan Ma、Zhenyu Wu、Chengkun Wang、Bingyao Yu、Ze Chen、Borui Zhang、Xiuwei Xu、Meng Zhang、Erjin Zhou、Jiwen Lu(通讯)等(清华大学、Dexmal、Loopeva)
链接:arXiv:2610.18873(v2,2026-10-15)· 项目主页 · 代码仓库 · HuggingFace 数据集
代码状态:代码与权重均已公开。仓库含训练/评测脚本、Hydra 配置、四个真机 embodiment 的 checkpoint 与 RoboTwin 2.0 checkpoint,混合质量 rollout 数据以数据集形式发布;训练在阿里云 PPU-810E(非 NVIDIA)上完成。
一句话总结:LoopWAM 让一个世界动作模型直接吃下部署产生的全部回放——成功、次优、失败——用「源相关噪声采样」把行为学习与动作条件下的世界建模统一进同一次并行去噪,用「质量转向 + 质量加权监督」决定每条轨迹教多少动作、而视频监督一律保留,从而在 RoboChallenge Table30-V2 上经三轮部署-训练把成功率从 23.67% 提到 43.33%,并在 RoboTwin 2.0 与 RoboCasa365 上取得对比方法中的最佳总体成绩。
研究背景与动机
扩大人类示范的规模让通用操作策略变得越来越能干,但示范Scaling本身关不上「部署」与「持续改进」之间的环。真实部署会暴露 curated 示范之外的状态、交互与失败模式,这些经验本可以构成一个具身数据飞轮。真机强化学习确实能在部署期间提升策略,但它往往收窄模型的预测分布,且很难学出多任务通用策略;把多个 RL 专家蒸馏进一个通用策略可以缓解后者,但通用策略的监督仍来自筛选过的成功回放,而不是完整的交互历史。于是作者把问题定在一个更难的版本上:能否直接从成功、次优、失败混合的部署回放中改进通用策略?
难点在于「怎么用」。模仿每一条记录下来的动作,会把不良行为一起吸进策略;只保留高质量轨迹,又丢掉了失败交互所提供的物理后果证据——恰恰是这些证据告诉模型「这样做会发生什么」。已有的两条技术路线各解决了一半:VLA 一侧,π0.6 用 advantage 条件化吸收自主经验与人工干预,π0.7 用质量/速度/失误元数据吸收混合质量数据并把专家能力蒸进通用策略,它们在训练时用 steering 建模不同质量的行为分布、推理时指定高质量模式,但缺少对「动作-视频转移」这一物理动力学的显式学习目标;世界模型一侧,WAM 把预测性视觉表征与动作生成耦合,ACWM 则在动作条件下预测未来观测,τ0-WM 分别训练 WAM 与 ACWM、把失败与恢复数据路由给 ACWM 并用它做策略改进的选择器,FACT 在共享模型内实现两种角色但仍是「先生成动作、再预测后果」的串行结构,失败后果只能通过共享表征间接影响策略。
作者要的回答是:一个 WAM 能否直接从混合质量部署回放中学习,让所有质量的轨迹都监督模型、且学到的后果直接参与动作生成?LoopWAM 的答案由三个机制组成:源相关噪声采样(source-dependent noise sampling)在同一模型、同一生成阶段内统一 WAM 的行为学习与 ACWM 的后果学习;质量转向(quality steering)用数值质量分条件化指令、部署时取专家分;质量加权监督(quality-weighted supervision)按质量调节动作模仿强度,失败轨迹的动作目标被屏蔽但视频监督保留。视频与动作 token 在一次并行去噪中双向交互,学到的未来表征无需额外的后果评估阶段即可参与动作形成。
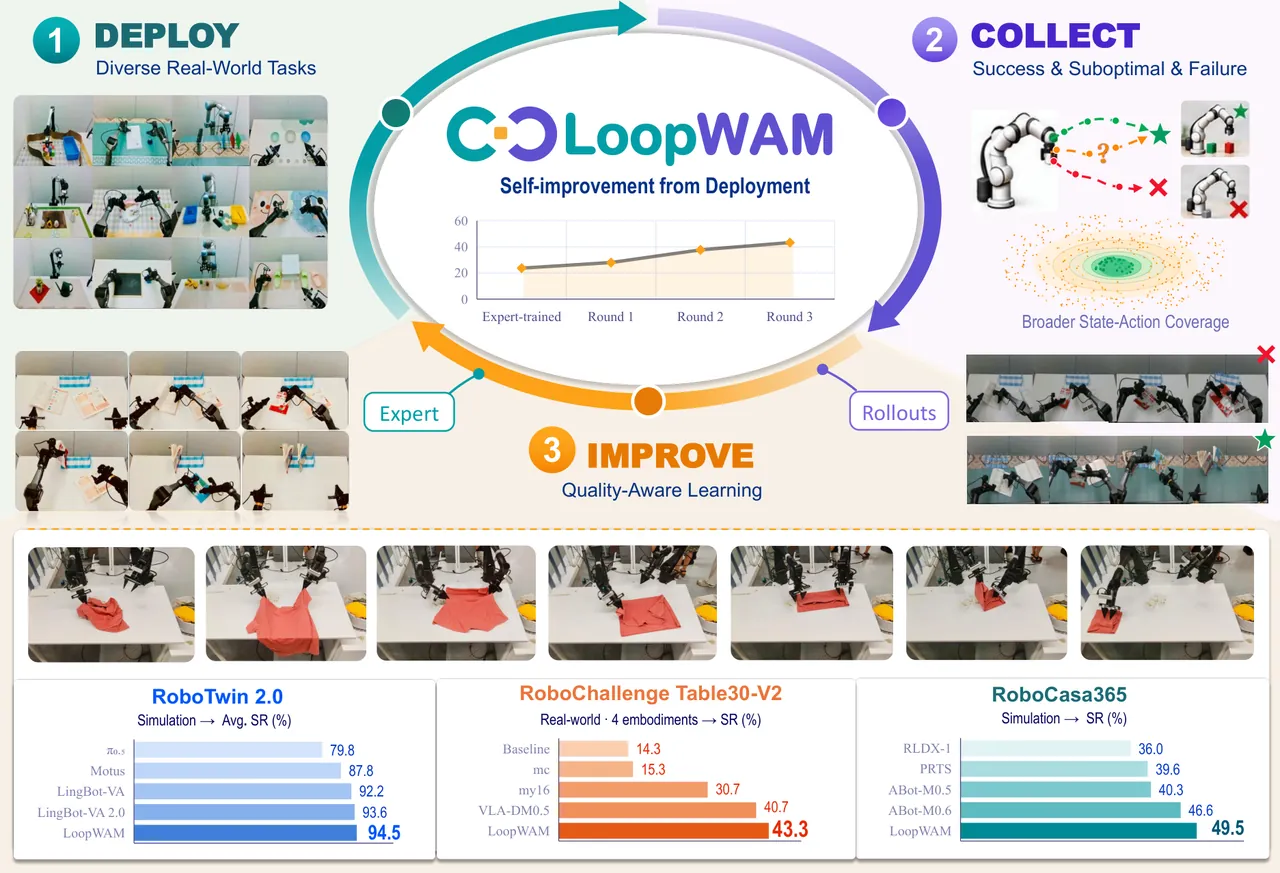
图1:LoopWAM 从部署中学习。外环是「部署—采集—改进」闭环:多样真机任务产生成功/次优/失败混合回放,经质量感知学习回到训练;中心为 Table30-V2 上三轮部署-重训把总体成功率从 23.67% 抬到 43.33%;下方为三个基准上与对比方法的成绩对比。
预备知识
世界动作模型(WAM)与动作条件世界模型(ACWM)。WAM 在生成动作的同时预测未来视觉观测,用预测性监督迫使表征捕捉场景动力学;ACWM 则在给定动作的条件下预测未来观测,学的是「动作的后果」。LoopWAM 的关键主张是这两者不必是两个模型或两个阶段:只要噪声采样方式合适,一个联合模型就能同时承担两种角色。
流匹配(flow matching)。对目标 $X$ 与噪声 $\epsilon\sim\mathcal{N}(0,I)$,用噪声水平 $\sigma\in[0,1]$ 做线性插值 $X^{\sigma}=(1-\sigma)X+\sigma\epsilon$,网络学习速度场 $v_\theta$ 去匹配目标 $u=\epsilon-X$;推理时从纯噪声沿调度 $\sigma_k$ 做欧拉积分回到干净样本。$\sigma=0$ 表示干净数据、$\sigma=1$ 表示纯噪声,这一标量因此可以直接充当「该模态被破坏程度」的旋钮。
Mixture-of-Transformers(MoT)。视频与动作两条流各自持有 token 投影、transformer 参数与预测头,通过联合注意力在每一层交换特征。LoopWAM 的视频骨干初始化自 Wan2.2-TI2V-5B,动作流是一个 hidden 1024 的 ActionDiT(由 Wan DiT 线性插值初始化)。
方法详解
联合世界-动作建模:一次并行去噪出视频与动作
设定为语言条件下的操作:视觉观测 $o_t$、机器人状态 $s_t$、指令 $\ell$;预测目标是同一 horizon 上的动作块 $A_t=(a_t,\ldots,a_{t+H-1})$ 与未来观测 $V_t$。预训练视频 VAE 把 $(o_t,V_t)$ 映到观测潜变量 $z_o$ 与未来潜变量 $Z_t$。LoopWAM 建模联合分布
$$p_\theta(A_t,Z_t\mid o_t,s_t,\ell,q), \tag{1}$$其中 $q$ 是轨迹质量的数值评分。模型实例化为双流扩散 transformer:视频与动作流有各自的 token 投影、transformer 参数与预测头,联合注意力在每一层连接两条流。训练用流匹配,对每个目标 $X_m$($X_v=Z_t$、$X_a=A_t$)独立加噪
$$X_m^{\sigma_m}=(1-\sigma_m)X_m+\sigma_m\epsilon_m,\qquad \epsilon_m\sim\mathcal{N}(0,I),\quad m\in\{v,a\}, \tag{2}$$联合网络预测速度场 $(v_\theta^v,v_\theta^a)$,目标为 $u_m=\epsilon_m-X_m$;观测潜变量 $z_o$ 始终保持干净。注意力结构用块掩码把两条预测在整个去噪过程中耦合起来:记观测、未来视频、动作 token 为 $O,V,A$,以 query 为行、key 为列,
$$M_{(O,V,A)}=\begin{pmatrix}1&0&0\\ 1&1&1\\ 1&1&1\end{pmatrix}, \tag{3}$$即观测 token 只在首帧内部自注意,而视频与动作 token 互相可见、并都交叉注意质量条件化的指令(机器人状态 token 额外条件化动作流)。这一结构带来两个后果:世界预测损失会训练到用于动作生成的特征;「任务如何完成」与「某个动作如何影响结果」两类学习被耦合在一起,视频与动作生成因此保持一致。
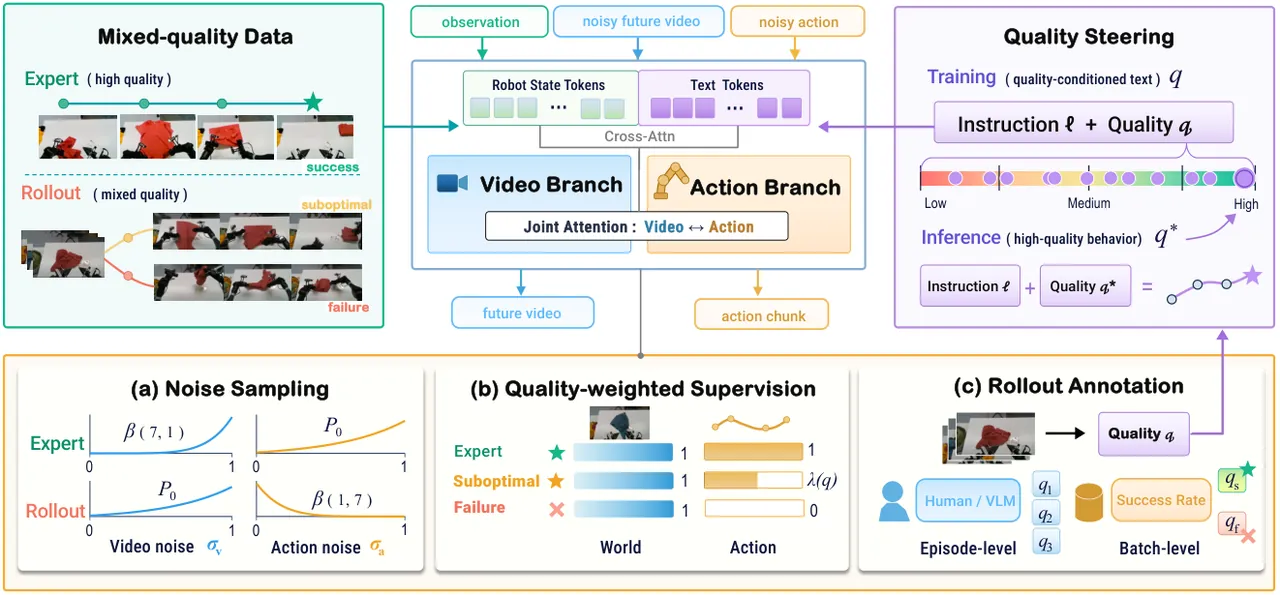
图2:方法总览。左:混合质量数据(专家与成功/次优/失败回放);中:MoT 双流(视频分支 + 动作分支)经联合注意力交互,机器人状态与文本 token 交叉注入;右上:质量转向——训练用「指令 + Quality q」条件化,部署取 $q^\star$;下排:(a) 源相关噪声采样,专家段视频噪声走 Beta(7,1)、动作走基分布 P0,回放段相反;(b) 质量加权监督,世界监督权重恒为 1、动作监督权重为 λ(q),失败为 0;(c) 回放标注,episode 级(人/VLM)或 batch 级(成功率)。
源相关噪声采样:让记录下来的动作教出它的后果
联合预测视频与动作本身并不保证「预测的未来」反映「生成动作的后果」。要在同一模型、同一训练阶段内强化 ACWM 能力,作者让回放段在预测其被观测到的后果时,能「看到」记录下来的动作:对专家段与回放段选不同的噪声分布,段内视频与动作噪声水平独立采样:
$$d=E:\quad \sigma_v\sim\mathrm{Beta}(7,1),\quad \sigma_a\sim\mathcal{P}_0;\qquad d=R:\quad \sigma_v\sim\mathcal{P}_0,\quad \sigma_a\sim\mathrm{Beta}(1,7). \tag{4}$$其中 $\mathcal{P}_0$ 是基噪声分布:采 $u\sim\mathcal{U}(0,1)$ 后令 $\sigma=\phi_\kappa(u)=\kappa u/[1+(\kappa-1)u]$,$\kappa=5$。专家段视频噪声偏高,强调从强破坏输入恢复专家未来;回放段动作噪声偏低,保留大部分记录下来的运动,让视频流去预测这些运动的视觉后果。于是世界模型见到的动作-结果分布被显著拓宽,包括任务未完成、交互失败这类转移;联合注意力再把后果学习的信号接到动作生成所用的表征上。代码实现里这一机制就是 beta_sigma_timesteps: timestep 取 $k\times T$,$k\sim\mathrm{Beta}(a,b)$ 并夹到 $[10^{-4},1-10^{-4}]$;training_loss 用逐样本的 supervise_action 标志做 torch.where(expert_m, tv_expert, tv_weak) 与 torch.where(expert_m, ta_expert, ta_weak),首帧潜变量被替换为干净值并从视频损失中剔除。
质量转向与质量加权监督:一条轨迹教多少,由它的质量决定
每条轨迹被赋一个数值质量分 $q$,其所有训练段继承同一分数;质量以指令后缀编码,$\ell_q=[\ell;\texttt{Quality: } q]$,其文本嵌入同时条件化视频与动作两条流。标注支持两种粒度:episode 级(人或 VLM 逐条打分)与 coarse 级(按 checkpoint 的总体成功率与动作平滑度给该 checkpoint 的所有成功回放一个共享分,失败回放取最低分,每个 checkpoint 只需一次标注)。专家示范被赋一个高于回放分数上限的专家分 $q^\star$;部署时条件化 $q=q^\star$,把采样转向专家质量行为。
监督侧,视频预测在所有质量上保留,动作监督则由非降权重 $\lambda(q)\in[0,1]$ 调节:专家 $\lambda(q^\star)=1$,失败 $\lambda(q)=0$。对样本 $i$、模态 $m$ 定义去噪损失
$$\ell_{m,i}=\omega(\sigma_{m,i})\left\|v_{\theta,i}^m-(\epsilon_{m,i}-X_{m,i})\right\|_{\mathrm{valid}}^2, \tag{5}$$其中 $\omega$ 为共享的 timestep 加权函数,范数只取有效目标元素,干净观测潜变量与 padding 均被排除。 minibatch 含 $B$ 段时完整目标为
$$\mathcal{L}_{\mathrm{LoopWAM}}=\underbrace{\frac{1}{B}\sum_{i=1}^{B}\ell_{v,i}}_{\text{世界监督}}+\underbrace{\frac{\sum_{i=1}^{B}\lambda(q_i)\,\ell_{a,i}}{\max\!\left(1,\sum_{i=1}^{B}\lambda(q_i)\right)}}_{\text{质量加权动作监督}}. \tag{6}$$源标志决定「破坏程度」,质量决定「行为条件与动作权重」。$\lambda(q)=0$ 去掉对该轨迹动作的直接模仿,但联合注意力下的视频与动作表征仍把世界模型梯度传给它——这正是「失败也有用但不被模仿」的形式化。公开配置给出了具体的 $\lambda$ 表:质量 1、2(失败)权重 0.0,质量 3 为 0.3,质量 4 为 0.6,专家 5 为 1.0;代码里动作损失即 (per-sample loss × timestep weight × mask).sum() / mask.sum().clamp(min=1),与式 (6) 的分母逐字对应,另支持把分数线性映射到权重的 action_loss_quality_score_linear 选项。
闭环自改进:部署、打分、重训、再部署
部署策略取联合模型的高质量动作边缘分布
$$\pi_\theta(A_t\mid o_t,s_t,\ell;q^\star)=\int p_\theta(A_t,Z_t\mid o_t,s_t,\ell,q^\star)\,\mathrm{d}Z_t. \tag{7}$$实践中从高斯噪声联合去噪视频与动作、固定当前观测潜变量来采样该边缘。从专家训练模型出发,收集并给部署回放打分,再用式 (6) 在专家示范与全部累积回放上更新模型;更新后的模型以 $q^\star$ 重新部署,循环继续。更一般地,这一更新可以接受任意已部署策略的回放——包括表现很差的策略——因为联合架构与质量感知目标会按每条轨迹的观测转移与行为质量分配贡献。RoboTwin 2.0 与 RoboCasa365 上的实验验证的正是这种「向别人学的」设定。
flowchart TD
  DEMO["expert demos D_E
quality q*"] --> MIX["training corpus
D_E + accumulated D_R"]
  POL["deploy pi_theta at q*
joint video+action denoising
sample 64 run 32 then replan"] --> ROLL["rollouts D_R
success / suboptimal / failure"]
  ROLL --> ANN["quality annotation
episode-level 1-12 or coarse 1-5
failed always q=1"]
  ANN --> MIX
  MIX --> NS["source-dependent noise
d=E: sigma_v Beta(7,1), sigma_a P0
d=R: sigma_v P0, sigma_a Beta(1,7)"]
  NS --> MOT["MoT joint denoising
video branch + action branch
bidirectional attention every layer
clean observation latent fixed"]
  MOT --> LV["world loss l_v
kept on every quality"]
  MOT --> LA["action loss l_a x lambda(q)
lambda(1)=0 lambda(5)=1"]
  LV --> OBJ["L_LoopWAM Eq.6
mean l_v + lambda-normalized l_a"]
  LA --> OBJ
  OBJ --> POL
图2补:按论文方法绘制的闭环数据流。部署回放经质量标注进入训练语料;源相关噪声采样决定每条段「谁教世界、谁教动作」;质量加权监督把动作模仿集中到高质量行为,而世界监督覆盖全部质量;更新后的模型以专家分重新部署。
实验结果
基准与实现细节
三个基准覆盖真机与仿真:RoboChallenge Table30-V2(30 个桌面操作任务、ALOHA/DOS-W1/ARX5/UR5 四种 embodiment,考察闭环自改进)、RoboTwin 2.0(50 个双臂任务,clean 与 domain-randomized 两档)、RoboCasa365(50 任务,含 held-out 组合)。Table30-V2 上每个 embodiment 一个专家训练的多任务模型,每轮部署每任务约 100 条回放,质量标注后与专家示范及历史各轮回放一起再训练;RoboTwin 2.0 用 2500 条 clean + 25000 条强随机专家示范,并加入专家训练 LoopWAM、X-VLA、π0.5 三个策略的回放(每任务每策略 20 条 clean + 130 条随机,共 22500 条,总时长与专家语料相当),采集与评测用不同随机种子防泄漏;RoboCasa365 则加入两个专家训练 LoopWAM(64 步与 32 步动作块)与 RLDX-1 的回放。
实现上,视频骨干、文本编码器与视频 VAE 初始化自 Wan2.2-TI2V-5B,动作 DiT hidden 1024;每个训练段为 64 步动作块配 9 帧 RGB(含初始观测、视觉步长 8 个控制步),多相机拼接成单图,动作与状态用专家数据统计做归一化;Table30-V2 关节目标相对动作块起点的关节状态、夹爪命令保持绝对。仓库配置补充了更多可复现细节:batch 16、学习率 1e-4 余弦调度、5 个 epoch、weight decay 1e-2、save_every 2500;视频 DiT 30 层 hidden 3072、动作 DiT 30 层 hidden 1024;文本嵌入用 umT5 预计算缓存(load_text_encoder: false);RoboTwin 评测在 8×A100 上每阶段 100 回合、采样 64 步执行 32 步后重规划、prompt_quality_score=5、夹爪二值化。作者还报告工程侧收益:视频预解码与按采样帧解码的数据加载优化把训练时间从 70+ 小时压到 40 小时。
Table30-V2:三轮部署-训练把成功率翻倍近一倍
| 方法 | ALOHA SR | DOS-W1 SR | ARX5 SR | UR5 SR | 总分 | 总体 SR |
|---|---|---|---|---|---|---|
| Baseline Model | 6.00 | 6.00 | 32.86 | 26.67 | 31.48 | 14.33 |
| mc | 7.00 | 0.00 | 47.14 | 20.00 | 23.63 | 15.33 |
| my16 | 13.00 | 27.00 | 54.29 | 46.67 | 41.27 | 30.67 |
| VLA-DM0.5 | 18.00 | 42.00 | 58.57 | 70.00 | 54.42 | 40.67 |
| LoopWAM(专家训练) | 8.00 | 38.00 | 24.29 | 26.67 | 36.10 | 23.67 |
| LoopWAM(三轮后) | 26.00 | 42.00 | 55.71 | 76.67 | 56.80 | 43.33 |
表1:RoboChallenge Table30-V2(成功率 %,节选自官方榜单 12 个条目)。三轮部署-训练后 LoopWAM 总分 56.80、总体成功率 43.33%,比第二名 VLA-DM0.5 高 2.38 分与 2.67 个百分点;相对自己的专家训练起点(23.67% / 36.10)提升 19.7 个百分点。注意 ARX5 一列 LoopWAM 的 55.71 仍低于 VLA-DM0.5 的 58.57。
逐轮数字是这篇文章最有说服力的部分:总体成功率 23.67% → 28.00% → 37.67% → 43.33%,总分 36.10 → 42.63 → 51.65 → 56.80,两个聚合指标在每一轮都单调上升。单任务后训练设定下,叠衬衫这一涉及可变形物体、初始状态杂乱(衬衫被随手扔进工作区、角可能被压住)的任务,从 DOS-W1 多任务模型后训练出发,两轮部署-训练把成功率从 13.20% 提到 32.54% 再到 55.56%,分数从 14.44 到 38.89 再到 67.78——说明部署反馈在多任务与单任务两种训练制度下都有效。
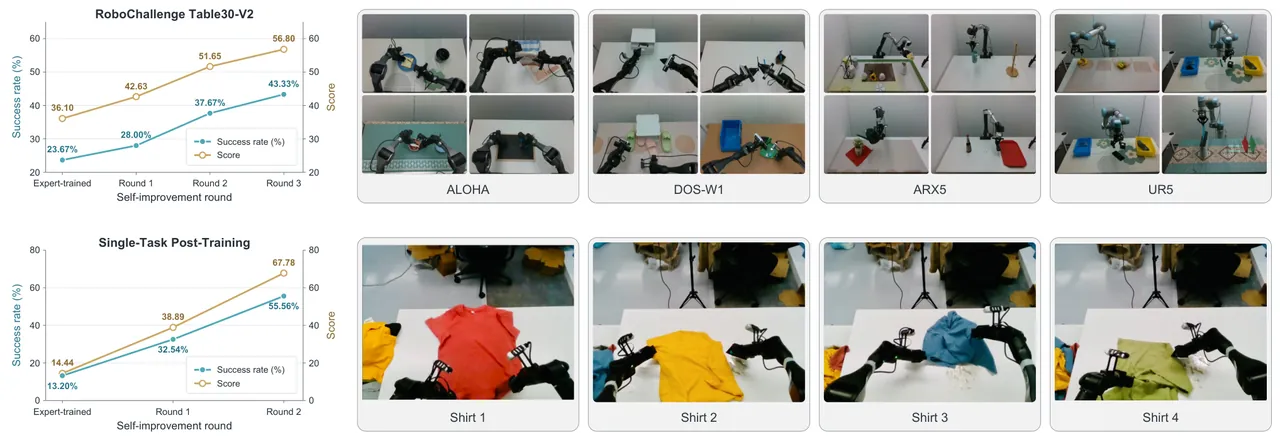
图3:真机部署的闭环改进。上:Table30-V2 三轮部署-训练的成功率/分数曲线(23.67→43.33,36.10→56.80)与 ALOHA/DOS-W1/ARX5/UR5 四平台任务快照;下:叠衬衫单任务后训练两轮(13.20→55.56,14.44→67.78)与四件衬衫的初始状态示例。
RoboTwin 2.0 与 RoboCasa365:无额外具身预训练的最佳总体成绩
| 方法 | 具身预训练 | Clean | Randomized | 平均 |
|---|---|---|---|---|
| π0 | 有 | 65.9 | 58.4 | 62.2 |
| X-VLA | 有 | 72.9 | 72.8 | 72.9 |
| π0.5 | 有 | 82.7 | 76.8 | 79.8 |
| Motus(from Wan2.2) | 无 | 77.6 | 77.0 | 77.3 |
| LingBot-VA | 有 | 92.9 | 91.5 | 92.2 |
| Fast-WAM | 无 | 91.9 | 91.8 | 91.8 |
| AHA-WAM | 无 | 93.4 | 92.2 | 92.8 |
| LingBot-VA 2.0 | 有 | 93.8 | 93.4 | 93.6 |
| LoopWAM | 无 | 94.6 | 94.4 | 94.5 |
表2:RoboTwin 2.0 成功率(%,节选)。LoopWAM 无额外具身预训练,平均 94.5%,比 AHA-WAM 高 1.7 个百分点、比做过预训练的 LingBot-VA 2.0 高 0.9 个百分点;clean 与 randomized 两档几乎持平(94.6 / 94.4),说明混合回放带来的状态-动作-结果覆盖确实转化为随机化场景下的稳健性。
| 方法 | 具身预训练 | Atomic Seen | Composite Seen | Composite Unseen | Overall |
|---|---|---|---|---|---|
| Diffusion Policy | 无 | 15.7 | 0.2 | 1.3 | 6.1 |
| π0.5 | 有 | 39.6 | 7.1 | 1.2 | 16.9 |
| GR00T N1.5 | 有 | 50.7 | 14.8 | 2.7 | 23.9 |
| RLDX-1 | 有 | 67.6 | 27.9 | 8.5 | 36.0 |
| PRTS | 有 | 66.3 | 30.3 | 18.8 | 39.6 |
| ABot-M0.6 | 有 | 79.4 | 48.3 | 7.9 | 46.6 |
| LoopWAM | 无 | 79.7 | 50.3 | 14.9 | 49.5 |
表3:RoboCasa365 成功率(%,节选)。LoopWAM 总体 49.5%,比 ABot-M0.6 高 2.9 个百分点且无需具身预训练;提升延伸到 held-out 组合任务(14.9%),但 PRTS 在 Composite Unseen 上以 18.8% 更高,是 LoopWAM 少数落后的一格。
消融:转向是钥匙,加权是增益
| 质量转向 | 质量加权动作监督 | Clean | Rand. | 平均 |
|---|---|---|---|---|
| 无 | 否 | 73.5 | 71.1 | 72.3 |
| Extra-coarse | 否 | 92.2 | 93.3 | 92.8 |
| Extra-coarse | 是 | 93.9 | 93.3 | 93.6 |
| Coarse | 否 | 93.2 | 92.2 | 92.7 |
| Coarse(本文) | 是 | 94.6 | 94.4 | 94.5 |
表4:RoboTwin 2.0 消融。Extra-coarse 只用成功/失败两档(失败=low、成功=medium、专家=high),coarse 则按策略给成功回放共享数值分。三条结论:质量转向是从混合质量回放学习的关键(无转向仅 72.3);极粗标签也有效,细粒度标注并非必需;质量加权动作监督在两种标注方案下都再抬一档。
失败恢复、未来预测与子任务切换
附录给出三组定性证据。其一,迭代执行与失败恢复:首次尝试因执行不确定、交互不完整或物体位移而失败后,模型观察 resulting 环境状态并生成纠正行为,最终完成任务(整理化妆台、粘毛滚除屑、扫垃圾三例)——这正是「世界模型」相对纯动作策略的价值所在。其二,未来观测预测:对「把桌上的笔放进笔筒」任务,预测帧与真值在头部与左腕两个相机上对照,预测保留交互的时间结构但在细节纹理上与真值有差异。其三,子任务切换:Table30-V2 中四个多阶段任务(按按钮、浇花、碎纸、盖章)用 Qwen2.5-VL-7B 做子任务分割,在线执行时按阶段切换语言指令,其余任务保留完整任务指令。
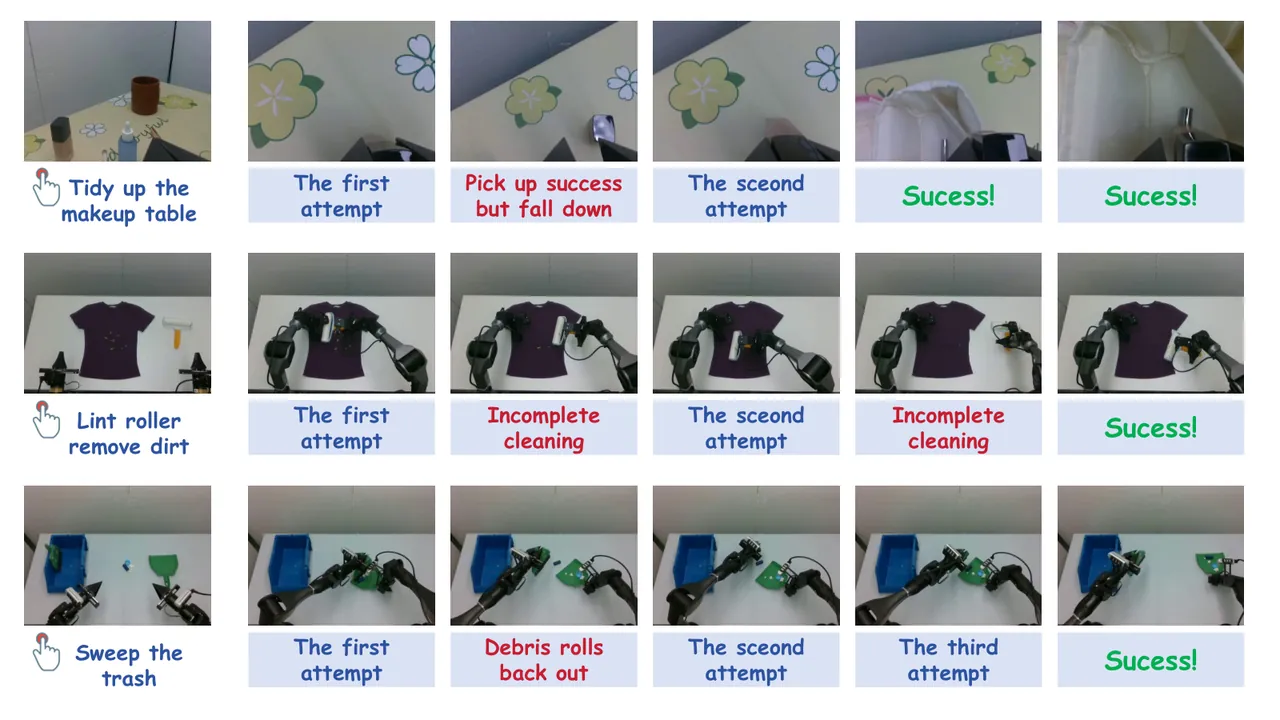
图4:失败恢复与迭代执行(论文附录 C 图9)。三行分别为整理化妆台、粘毛滚除屑、扫垃圾:首次尝试出现「抓起后掉落」「清洁不完整」「垃圾滚出」等失败,模型依据观察到的环境状态发起第二/第三次尝试并最终成功。
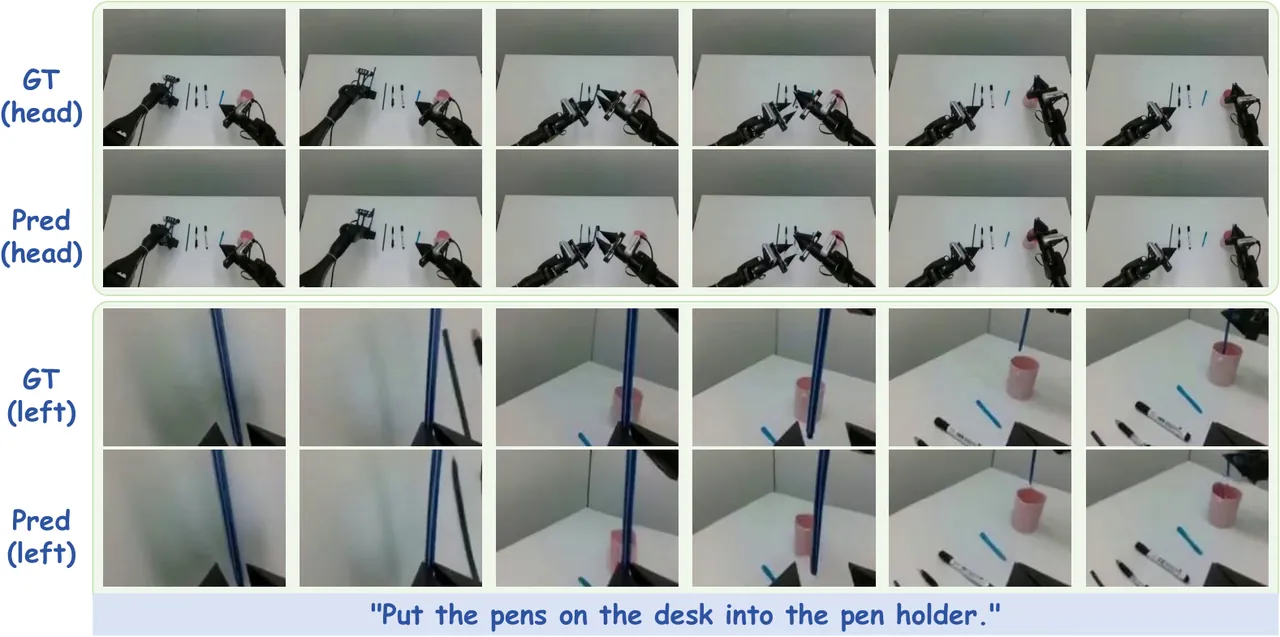
图5:未来观测预测对照(论文附录 D 图10)。任务为「把桌上的笔放进笔筒」,上两行为头部相机真值/预测、下两行为左腕相机真值/预测;预测抓住机械臂运动与物体位移的时间演化,细纹理与真值存在差异。
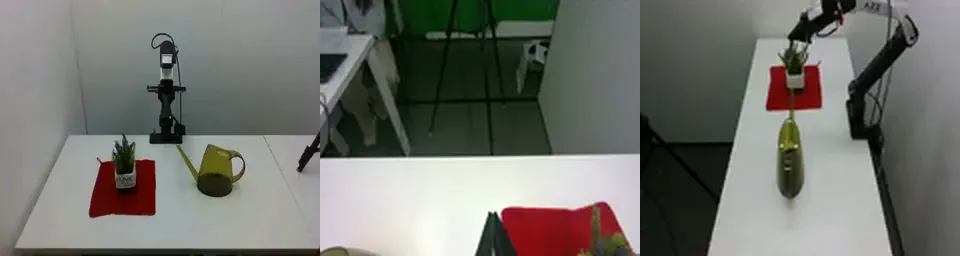
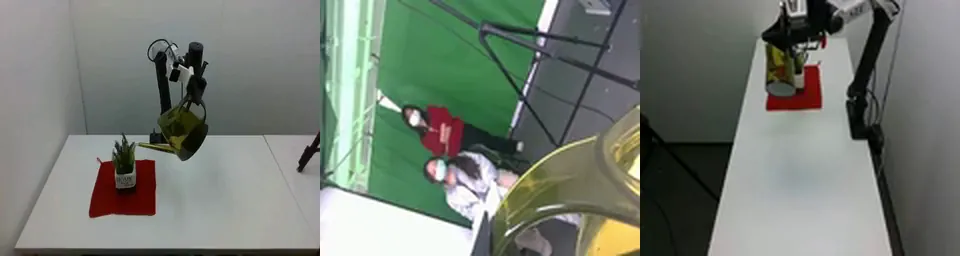
图6:Table30-V2 子任务切换示例(论文附录 A.4)。左为「浇花」任务阶段 1 的三相机拼接输入(拿起浇水壶浇盆栽),右为阶段 2 切换指令「浇完了,把浇水壶放下」时的拼接观测;多相机被拼成单图送入模型,子任务指令由 Qwen2.5-VL-7B 分割产生。
局限性与开放问题
其一,预测的未来只保结构、不保细节(作者自述)。附录 D 明确承认:生成的观测在细视觉细节上与真值图像存在差异,只保留交互过程的时间结构。这意味着 LoopWAM 的世界表征是为控制服务的,尚不能当作可供人检视或供下游视觉规划使用的高保真世界模拟器;「后果学习」的收益目前只能从动作成绩间接读出。
其二,质量标注是一条人力/VLM 依赖的管线(作者自述的设定)。episode 级标注需要人或 VLM 逐条打分(Table30-V2 直接复用平台运营方的 1–10 评分,成功通常 ≥8.5);coarse 级虽把标注量压到「每个 checkpoint 一次」,但仍需统计该策略的总体成功率并人工抽检约 0.7% 的轨迹评估平滑度。标量分数同时编码「完成度」与「平滑度」两种信息,且「失败一律 q=1」是硬约定;标注口径一旦漂移,λ(q) 与转向条件都会跟着偏。
其三,闭环改进的成本与饱和问题。每一轮改进都要在真机上每任务采约 100 条回放并完整重训一次联合模型(RoboTwin 配方 16 卡、数十小时量级),三轮 Table30-V2 意味着四个 embodiment 各三轮真机部署;论文没有给出改进随轮数的饱和曲线,也没有与「只加成功回放」或「随机重放」等更便宜的数据策略做轮级对照,19.7 个百分点的收益中有多少来自失败转移、多少仅来自数据量增加,仍只能靠表 4 的间接证据支撑。
其四,组合泛化与个别 embodiment 仍是短板。RoboCasa365 的 Composite-Unseen 只有 14.9%(PRTS 为 18.8%),Table30-V2 的 ARX5 一列 55.71% 低于 VLA-DM0.5 的 58.57%;混合质量回放拓宽了状态-动作-结果分布,但对训练分布之外的任务组合的迁移仍然有限。
总结与展望
LoopWAM 的贡献是把「部署经验」从筛选对象变成完整监督源:源相关噪声采样让同一次并行去噪同时承担行为学习与后果学习,质量转向与质量加权监督则把「这条轨迹教什么」变成一条可配置的标尺——失败教世界、不教动作,成功按质量教动作,专家分负责部署时的行为选择。三个基准的最佳总体成绩、三轮真机闭环的单调改进、以及「极粗标签也有效」的消融,让这套机制看起来是数据飞轮的一个务实起点而非一次性技巧;代码、权重与 rollout 数据集的公开(含非 NVIDIA 训练栈与 70→40 小时的加载优化)进一步降低了复核门槛。下一步的自然问题包括:质量标注能否被自动化的后果一致性信号替代、改进轮数的饱和点在哪、以及潜空间世界表征能否长出可供规划与检视的高保真未来。
金句:失败的回放不是要丢掉的噪声,而是世界模型最诚实的教材——LoopWAM 用一条质量标尺决定谁教世界、谁教动作,让部署本身成为训练的下一批数据。