PAPER DEEP DIVE
EgoScale:用多样化第一视角人类数据扩展灵巧操作
提出基于大规模第一视角人类视频的 VLA 训练框架 EgoScale:在 20,854 小时动作标注人类数据上预训练,发现数据规模与验证损失呈对数线性关系;再通过少量对齐的人机协同中训练接地到机器人控制。22 自由度灵巧手策略相对无预训练基线平均成功率提升 54%,并能迁移到低自由度手。
人类动作不只是语义素材:EgoScale 把第一视角人类操作视频转换成可预测的机器人控制先验,并用 20,854 小时数据证明灵巧操作迁移首先是一个规模问题。
论文元信息
| 项目 | 内容 |
|---|---|
| 论文 | EgoScale: Scaling Dexterous Manipulation with Diverse Egocentric Human Data |
| 机构 | NVIDIA、加州大学伯克利分校、马里兰大学 |
| 链接 | arXiv:2602.16710;官方项目页见 NVIDIA GEAR |
| 代码状态 | 论文与官方项目页未提供公开代码仓库;本文以论文 HTML 全文与附录为准 |
| 核心平台 | Galaxea R1Pro + Sharpa Wave 22 自由度灵巧手;跨具身验证在 Unitree G1 + 7 自由度三指手 |
一句话总结
EgoScale 把 20,854 小时第一视角人类操作视频变成腕部相对位姿与 22 维手指关节监督,先用大规模人类预训练获得可迁移的运动先验,再用 50 小时人机对齐数据做轻量中间训练,最后在五个高灵巧任务上把平均成功率比无预训练基线提高 54%。
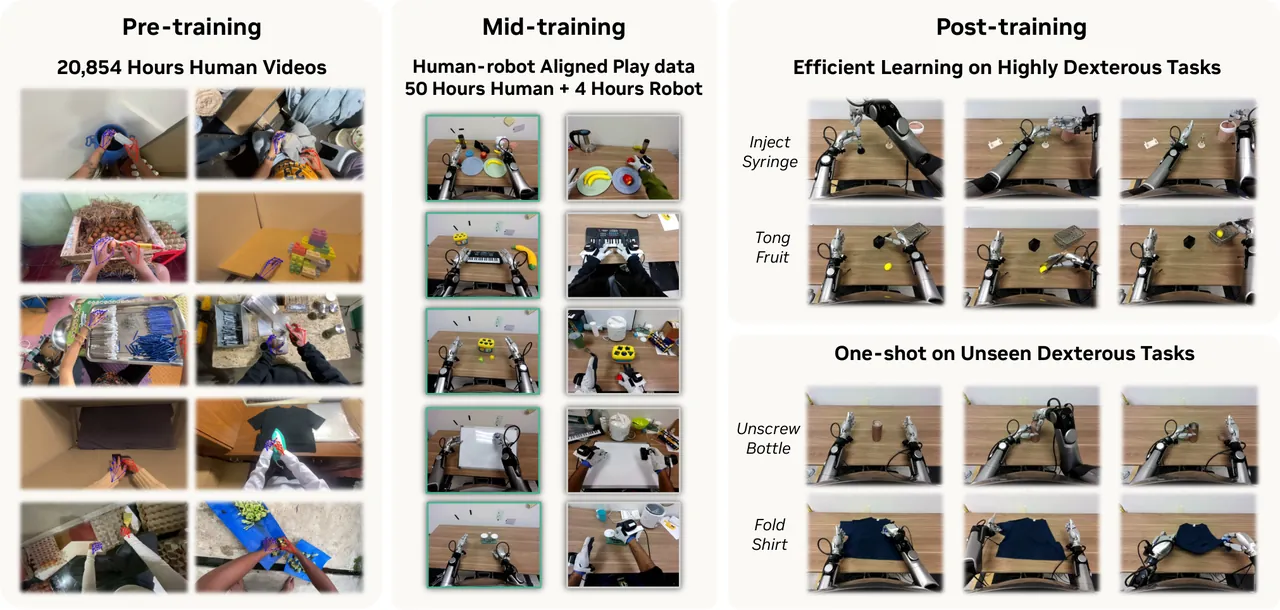
图 1:从 20,854 小时人类视频预训练,到 50 小时人类加 4 小时机器人对齐中间训练,再到灵巧任务与 one-shot 适应。
研究背景与动机
机器人灵巧操作的数据困境很具体:一张卡牌要从紧叠牌堆里分离,一个瓶盖要连续旋转至少三圈,一副 tongs 先要被稳定抓住再反手夹起水果。这些动作不是“抓取-放置”两段式任务,而是腕部姿态、手指关节与接触时序同时变化的过程。遥操作能采到数据,但每个任务成百上千条示教的人力成本,会很快把研究压回少数固定场景。
人类视频看起来是天然替代源。人在家庭、店铺、维修车间、厨房和工坊里持续做出多自由度操作,覆盖的物体、环境和任务类别远超机器人数据集。问题在于,原始人类视频只给了“看见手在做什么”的信号,没有给出可直接执行的机器人动作。要把这种视频变成控制监督,必须解决两件事:一是从无约束视频里稳定恢复手部与相机运动,二是把人类运动映射到不同机器人的控制接口。
此前的人到机器人迁移工作已经证明观测或动作对齐有价值,但多数数据规模只有几十到几百小时,或者把手部压缩成低自由度夹爪动作。这样能验证概念,却难以回答作者真正关心的问题:当人类数据达到两万小时以上,它是否仍能继续改善 22 自由度灵巧手的精细操作?如果没有一个可测量的趋势,我们只能把人类数据当作启发式补充,而不是可规划的训练资源。
EgoScale 的立场更强:人手操作不只是视觉语义,而是一个可学习的运动先验。作者因此把方法拆成“规模”和“对齐”两层。规模层来自大量非任务专属的第一视角人类数据,用来学通用抓取、工具使用、折叠、旋转与松开等动作结构;对齐层只占很小数据量,用来把先验落到机器人相机视野、本体状态和动作解码器上。这个设计避免了让少量机器人数据同时承担语义、运动和控制三种学习负担。
这也解释了论文标题里的 Scale。作者不是在展示一个单点技巧,而是在 1,000 到 20,000 小时数据范围内测量验证损失与机器人表现。结果显示,动作预测损失随数据量按对数线性下降,任务完成分从 1,000 小时的 0.30 提升到 20,000 小时的 0.71。这说明大规模人类视频至少在实验范围内不是收益递减的装饰品,而是可预测的监督源。
预备知识:第一视角下的动作坐标系
第一视角视频的动作标注有一个关键难点:相机长在人头上,头部移动会同时改变画面和手在相机坐标里的位置。若直接把相机系坐标当动作,模型会把“头怎么动”误学成“手怎么操作”。EgoScale 因此先建立世界系、相机系和手部位姿的关系。
设世界系为 $\mathcal{F}_{w}$,时刻 $t$ 的相机系为 $\mathcal{F}_{c}^{t}$。SLAM 输出的相机位姿用 $\mathbf{T}_{w\leftarrow c}^{t}\in\mathbb{SE}(3)$ 表示。手部由 21 个关键点描述,每个关键点在相机系中是一个刚体变换 $\mathbf{H}_{c,i}^{t}\in\mathbb{SE}(3)$,其中 $i=1$ 对应手腕。相机系手腕转换到世界系就是:
$$\mathbf{W}_{w}^{t}=\mathbf{T}_{w\leftarrow c}^{t}\mathbf{H}_{c,1}^{t}$$
相对腕部动作进一步以片段起点为参照:
$$\Delta\mathbf{W}^{t}=(\mathbf{W}_{w}^{0})^{-1}\mathbf{W}_{w}^{t}$$
这个式子把绝对头部漂移从目标里移出去。无论人走进一个新房间还是俯身看桌面,模型学到的都是手腕相对片段起点的增量位姿,而不是一个依赖全局坐标的绝对目标。机器人端同样使用相对末端位姿控制,因此人类和机器人的手臂接口在这里自然汇合。
手指端则不能只保留指尖轨迹。论文把 21 个人手关键点经优化重定向到 Sharpa 手的 22 维关节空间。关键点是观测,关节角是控制;重定向在关节限位和运动学约束下求解,使观测手型转成可执行且保结构的灵巧手动作。作者随后比较了腕部、指尖和关节空间三种表示,发现关节空间监督最稳定。
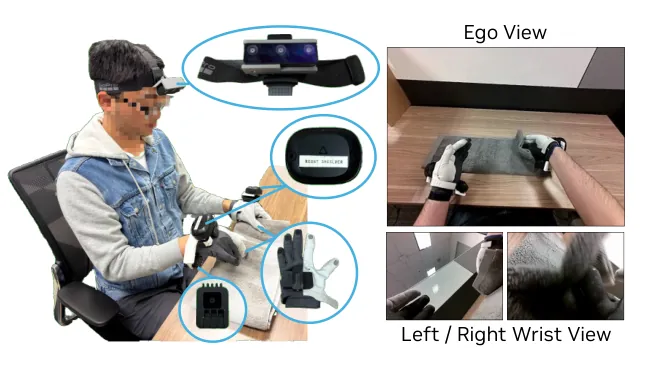
图 2:对齐中间训练采集使用头戴相机、腕部相机、Vive 跟踪器与 Manus 手套,使人类与机器人观测和动作处于同一口径。
方法详解
1. 数据层:把规模与对齐拆开
Stage I 的主体是 20,854 小时第一视角人类活动视频。多数为非约束场景,覆盖 9,869 个场景、6,015 个任务和 43,237 个物体;另有 829 小时 EgoDex 提供较准确的桌面操作腕部和手部跟踪。视频为 30 FPS,先用现成 SLAM 恢复相机运动,再用手姿估计恢复手部轨迹。作者没有假装这些标签很干净,反而把噪声视为扩大数据面必须接受的代价:单条视频可能因遮挡或跟踪漂移出错,但当场景、物体和动作形态足够多时,模型能从统计结构中提取可复用的运动规律。
附录 C 说明了这种数据的覆盖形状。零售与消费品占 20.1%,时尚 11.8%,维修服务 11.5%,食品饮料 11.5%,家庭 9.5%,建筑与五金 7.7%,食品加工 6.7%,印刷设计 4.4%,其余是长尾。环境包括家庭、花店、电子维修店、家具维修店、木工坊和服装店等;任务包括叠衣、洗鞋、盆栽、熨烫、装盒、插花、打磨和食物准备。类别、环境、任务和物体都是长尾分布,说明这不是一个只围绕少数原型任务平滑扩展的数据集。
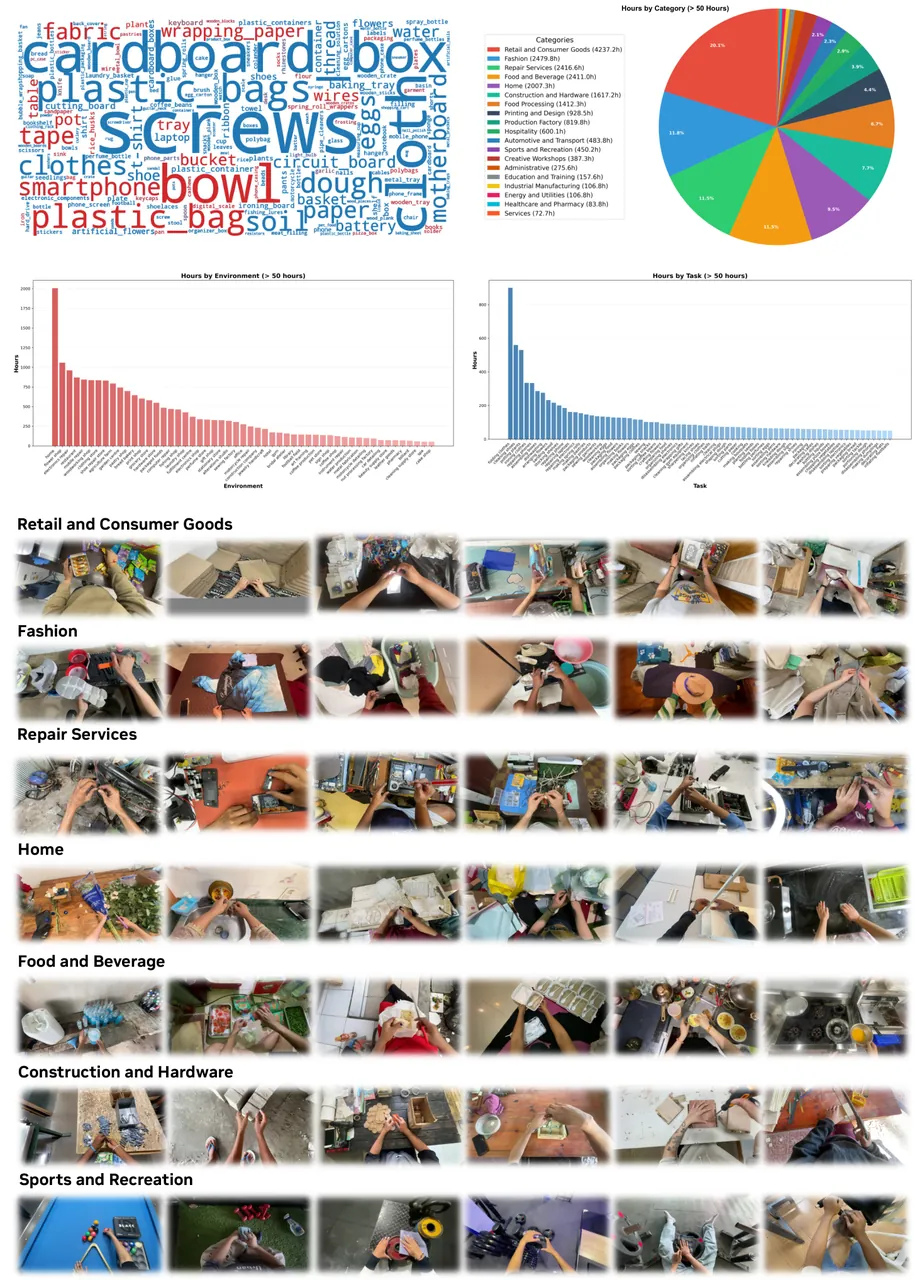
图 3:Stage I 数据在类别、环境、任务与物体上均呈长尾分布,高频任务包括叠衣、清洁、组装和食物准备。
Stage II 只有约 50 小时人类数据与 4 小时机器人数据,分布在 344 个桌面任务,每任务约 30 条人类轨迹和 5 条机器人轨迹。采集端与机器人对齐:Vive 跟踪器提供腕部位姿,Manus 手套记录 25 个手关节变换,头戴相机和左右腕部相机提供一致视角,且相机内参经过标定。这个小集合的作用不是教模型认识更多任务,而是提供人类示教与机器人执行之间的精确对应,把预训练表征锚定到可执行接口。
2. 架构层:共享运动先验,局部适配具身
模型沿用 GR00T N1 风格的流匹配 VLA。时刻 $t$ 的观测是:
$$o_{t}=(I_{t},l_{t})$$
其中 $I_t$ 是图像,$l_t$ 是语言指令;视觉语言模块将其编码为 $\phi_t$,DiT 动作专家在流匹配目标下预测未来动作块。机器人数据额外有本体状态 $q_t$,人类数据没有该信号,于是用一个可学习占位符代替。这让两种数据共享同一套模型结构,而不是给人类视频另开一条网络分支。
不同机器人之间仍存在状态与手空间差异。作者在输入和输出接口加入轻量具身条件 MLP 适配器:输入适配器编码本体状态,输出适配器解码手部动作;腕部相对运动预测、视觉语言主干和 DiT 动作专家保持共享。这样,Sharpa 22 自由度手上学到的手指协调不必完全重新学一遍,才能迁移到 G1 的三指手;只有不可共享的输入输出边界交给适配器。
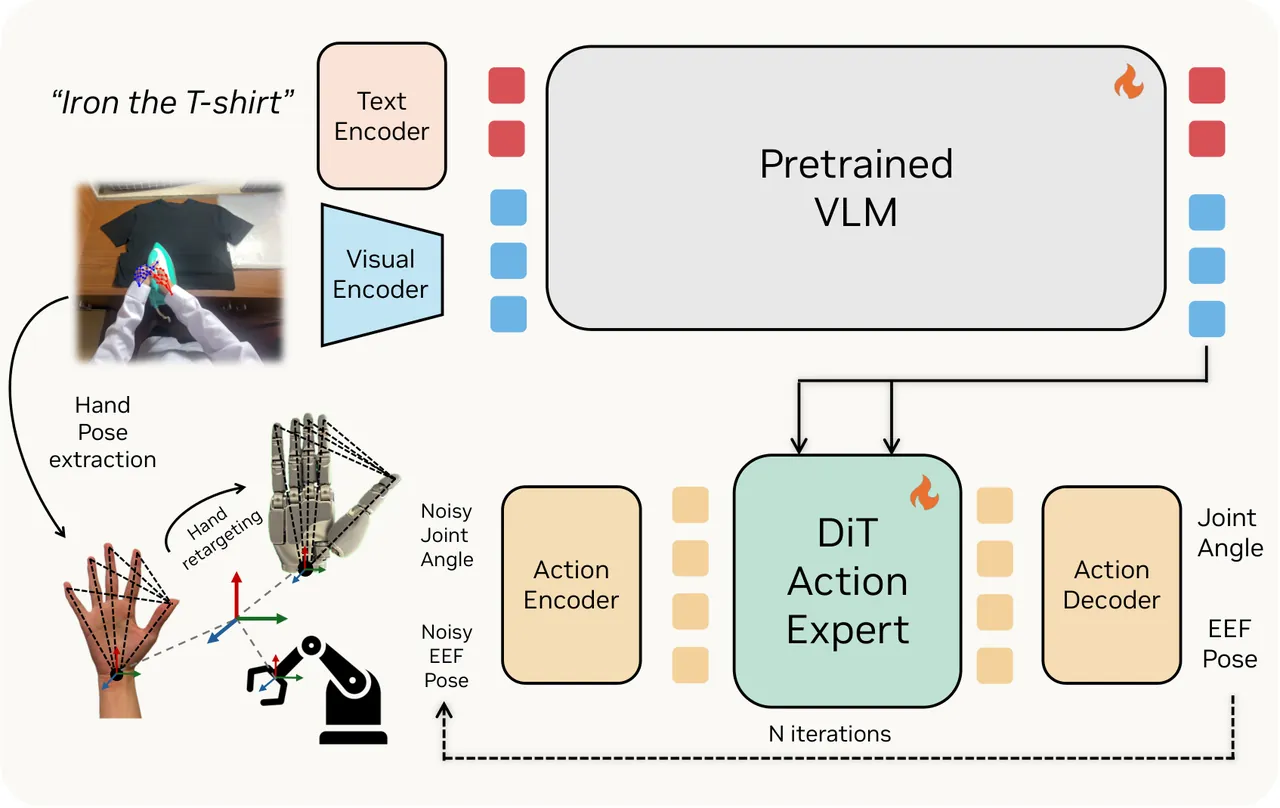
图 4:手姿提取与重定向产生关节角,视觉语言主干与 DiT 动作专家共享,具身适配器处理不同机器人接口。
3. 训练层:三阶段控制可塑性
三阶段训练不只是顺序微调,而是对“哪些模块该吸收哪些数据”的显式调度。Stage I 的数据量大、噪声高但语义广,因此 100,000 步、全局 batch 8,192、学习率 $5\times 10^{-5}$,完全放开 VLA 参数,让主干和动作专家吸收 20K 小时数据。Stage II 数据小而精确,用 50,000 步、batch 2,048、学习率 $3\times 10^{-5}$,冻结视觉语言主干,只更新视觉编码器与 DiT 动作专家,避免小数据把通用表征改写掉。Stage III 在任务上做 10,000 步、batch 512、学习率 $3\times 10^{-5}$;若已经经过中间训练,视觉编码器保持冻结,否则按新具身需要放开。
| 阶段 | 数据 | 步数 | 全局 batch | 学习率 | 关键可塑性 |
|---|---|---|---|---|---|
| Stage I 预训练 | 20,854 小时人类第一视角数据,含 829 小时 EgoDex | 100K | 8,192 | $5\times 10^{-5}$ | 256 块 GB200,VLA 全参数更新 |
| Stage II 中间训练 | 344 任务对齐人机 play 数据:约 50 小时人类 + 4 小时机器人 | 50K | 2,048 | $3\times 10^{-5}$ | 冻结视觉语言主干,更新视觉编码器与 DiT |
| Stage III 后训练 | 任务机器人示教 | 10K | 512 | $3\times 10^{-5}$ | 有中间训练时冻结视觉编码器 |
4. 机器人控制层
Galaxea R1Pro 是双臂轮式人形平台,实验中固定底盘和躯干,只控制两条 7 自由度手臂。动作采用相对末端位姿:目标为增量位置与姿态变化,与人类腕部动作表示一致。两只 Sharpa Wave 手各 22 自由度,直接用关节角控制。感知由三路 RGB 组成:头戴相机提供与人类视频一致的第一视角,两个腕部相机贴近手掌,捕捉细粒度接触。人类视频主要提供第一视角,机器人端加上腕部视角是为了在手指接触点附近补足高分辨率反馈。
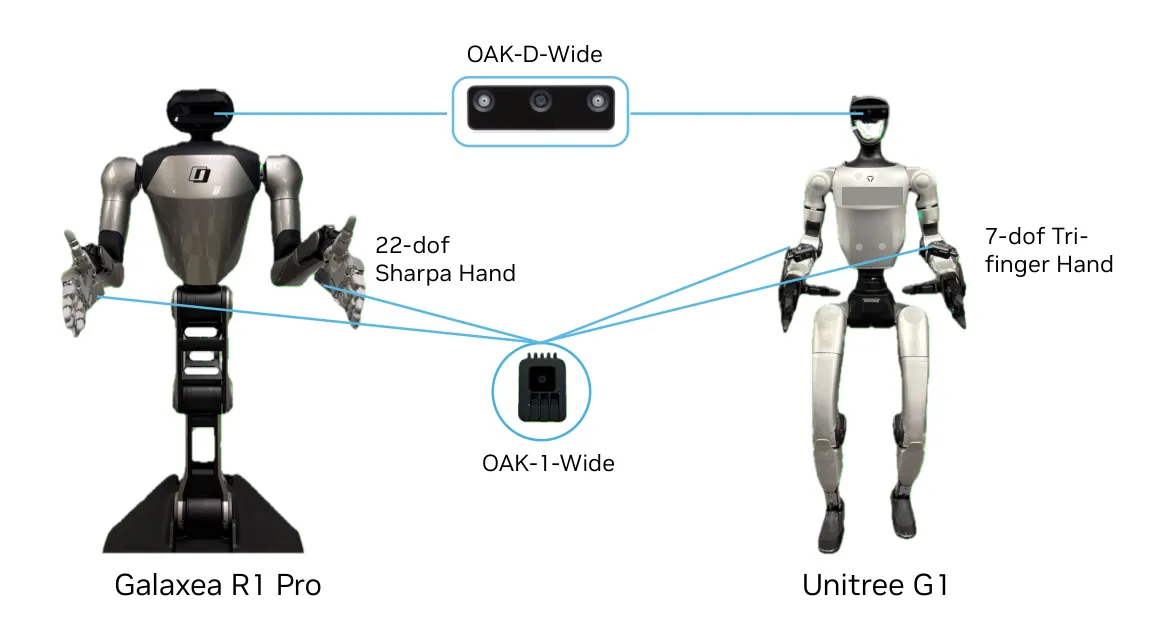
图 5:R1Pro 使用 OAK-D-Wide 头部相机与 OAK-1-Wide 腕部相机,配备 22 自由度 Sharpa 手;G1 使用 7 自由度三指手。
5. 方法流程总览
flowchart LR
  A["First person RGB
30 FPS"] --> B["SLAM
camera pose"]
  A --> C["Hand pose estimation
21 keypoints"]
  B --> D["SE(3) transforms
wrist in world"]
  C --> D
  D --> E["Relative wrist motion
delta W"]
  C --> F["Optimization retargeting
22 DoF joints"]
  E --> G["Human pretraining
20,854 hours"]
  F --> G
  H["Aligned play data
50h human + 4h robot"] --> I["Mid-training
robot sensing and control"]
  G --> I
  I --> J["Task post-training
100 demos per task"]
  J --> K["R1Pro evaluation"]
  I --> L["G1 adapters
tri-finger hand"]
  L --> M["Cross embodiment evaluation"]
实验设计
论文用五个任务回答五个问题:是否优于从零训练或仅中间训练?数据规模是否可预测地带来收益?中间训练是否解锁 one-shot 适应?先验能否跨具身?动作表示怎么选?每个任务提供 100 条遥操作示教,Shirt Rolling 只用 20 条。每方法训练两个随机种子;多数任务每 checkpoint 评估 10 次,Tongs 与 Bottle 按物体实例扩展试验,并用图像叠加初始化降低场景摆放差异。评估同时记录二值成功率和 0 到 1 之间的任务完成分。
任务完成分的设计值得展开。独立子步骤明确的任务用加法评分;可变形物体或紧耦合步骤用里程碑式评分。这样一次失败不再只能记 0 分,而能区分“抓住了工具但没夹起物体”“旋松了瓶盖但没放下”等部分进展。对长程灵巧任务来说,这比单一二值标签更能暴露失败位置。
| 任务 | 执行内容 | 训练示教 | 评分策略 |
|---|---|---|---|
| Shirt Rolling | 双手交替折叠并滚动 T 恤,放入篮子 | 20 | 里程碑:初始折叠 0.3,多次折叠或部分滚动 0.5,连续滚动 0.8,入篮 1.0 |
| Card Sorting | 从紧叠牌堆分离单张卡,按颜色插入卡座 | 100 | 里程碑:单卡拿起 0.5,正确放置无扰动 1.0 |
| Tongs Fruit Transfer | 抓住 tongs,夹起水果并放入篮中 | 100 | 加法:抓 tongs 0.4,夹起 0.2,放置 0.2,归还 0.2 |
| Bottle Cap Unscrewing | 抓住瓶子,连续旋转瓶盖并放下 | 100,四种瓶型各 25 条 | 加法:抓瓶 0.1,至少三圈 0.5,完全取下 0.2,放下 0.2 |
| Syringe Liquid Transfer | 取注射器,从 A 管抽液并注入 B 管,丢弃注射器 | 100 | 加法:取器 0.1,对准 A 0.1,抽液 0.2,对准 B 0.1,注入 0.2,转移或释放 0.2,丢弃 0.1 |
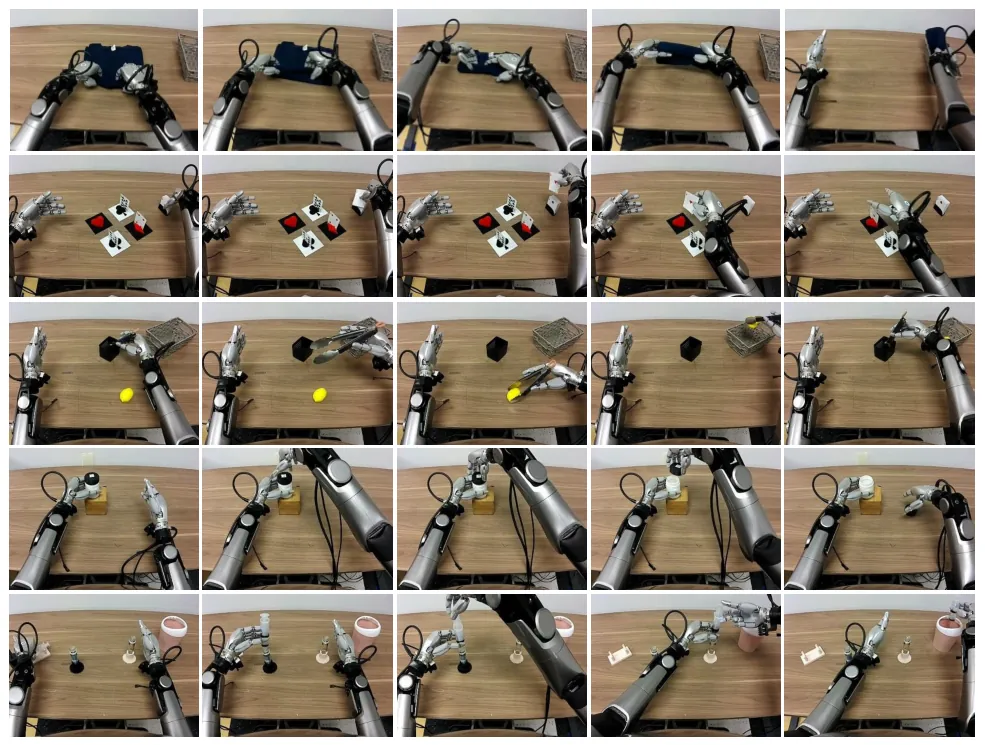
图 6:从上到下分别是 Shirt Rolling、Card Sorting、Tongs Fruit Transfer、Bottle Cap Unscrewing 与 Syringe Liquid Transfer。
结果一:预训练与中间训练的组合收益
作者比较四个 checkpoint:从零训练、只在人机对齐 play 数据上预训练、只做大规模人类预训练、以及人类预训练加中间训练。结论分三层。第一,人类预训练在所有任务上优于从零训练,平均任务完成分提高超过 55%。第二,这种噪声大、非任务专属、也没有与机器人传感器完全对齐的人类预训练,在多数任务上已经超过只用人机对齐小数据预训练。第三,完整组合最好:大规模人类数据提供通用动作结构,中间训练负责把结构接入机器人观测与控制。
论文给出总体成功指标:最终策略相对无预训练基线把平均成功率提高 54%。这个 54% 与“任务完成分提高超过 55%”共同说明,收益不是只在部分进展分数上好看;端到端成功也大幅上升。对长程任务,任务完成分还能显示失败发生在哪一步,这比只看成功更利于诊断。
更重要的是,收益来自人类数据而非机器人数据规模。中间训练只有 4 小时机器人数据,却显著改善可执行性;从零或仅中间训练无法补上大规模运动先验的缺失。这说明小机器人数据的价值在于对齐,不在于独立承担操作泛化。
结果二:验证损失、数据规模与机器人表现
作者在 1k、2k、4k、10k、20k 小时人类数据上分别预训练,然后直接做任务后训练。平均任务完成分从 0.30 提升到 0.71,实验范围内单调上升,没有观察到饱和。离线验证使用 2,000 个保留人类 episode,每条随机取 20 个时刻;每个时刻从流匹配策略采样 16 次,平均预测动作块,再对真实腕部与手部动作计算均方误差。
拟合到的收敛验证损失为:
$$\mathbf{L}=0.024-0.003\cdot\ln(D)$$
其中 $D$ 是人类预训练小时数,拟合的 $R^2=0.9983$。这是一个很干净的对数线性关系。1k 到 2k 数据的曲线会先降后平台化甚至退化,10k 与 20k 数据则在全程稳定改善。作者明确说没有把趋势外推到测量范围之外,但在现有区间内,离线损失与真实任务完成分高度对应。
| 设置 | 人类数据 | 观测指标 | 结果 |
|---|---|---|---|
| 小数据起点 | 1k 小时 | 后训练平均任务完成分 | 0.30 |
| 大数据端点 | 20k 小时 | 后训练平均任务完成分 | 0.71 |
| 缩放拟合 | 1k 到 20k 小时 | 收敛验证损失对 $\ln(D)$ | $R^2=0.9983$ |
| 完整策略 | 20,854 小时预训练 + 对齐中间训练 | 平均成功率相对无预训练基线 | +54% |
结果三:one-shot 适应
One-shot 实验测试更严苛的场景:Fold Shirt 与 Unscrewing Water Bottles 不出现在中间训练数据中,每个任务只有 1 条机器人示教,并配合 100 条对齐人类示教。结果出现明显分层:只做中间训练、只做人类预训练都接近失败;人类预训练加中间训练在 Fold Shirt 上取得 0.92 任务完成分与 0.88 成功率,在 Bottle 上取得 0.64 完成分与 0.556 成功率。
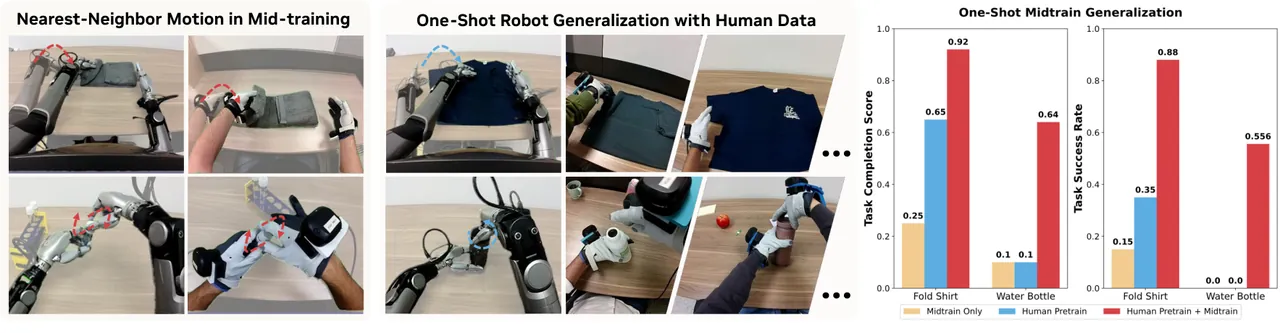
图 7:中间训练中的近邻运动结构帮助策略在新衣物与新瓶型上完成 one-shot 泛化。
| 任务 | 指标 | 仅中间训练 | 仅人类预训练 | 人类预训练 + 中间训练 |
|---|---|---|---|---|
| Fold Shirt | 任务完成分 | 0.25 | 0.65 | 0.92 |
| 成功率 | 0.15 | 0.35 | 0.88 | |
| Water Bottle | 任务完成分 | 0.10 | 0.10 | 0.64 |
| 成功率 | 0.00 | 0.00 | 0.556 |
这个结果解释了为什么“对齐”不能被“规模”替代。人类预训练已经知道袖口折叠、手部开合和工具旋转的运动模式,但不知道机器人视野与控制延迟;中间训练只有 4 小时机器人数据,却提供了这条桥。one-shot 不等于零样本:仍需要 1 条目标机器人示教把任务实例固定下来,但相比传统每任务上百条机器人示教,数据成本已经低一个数量级。
结果四:跨具身迁移
Unitree G1 与 R1Pro 差异很大:手臂更短、可达空间更小,手部是 7 自由度三指结构。EgoScale 在中间训练混入少量 G1 play 数据。两个任务是 Pen in Bin 和 Dish Handover in Rack。Pen in Bin 中,机器人先打开或拿起容器,稳定放下,再拾取 marker 放入;Dish Handover 要求三只盘子可能经过左右手交接并竖直放入碗架。
| G1 任务 | 指标 | 仅中间训练 | 仅人类预训练 | 人类预训练 + 中间训练 |
|---|---|---|---|---|
| Pen in Bin | 任务完成分 | 0.45 | 0.68 | 0.83 |
| 成功率 | 0.30 | 0.30 | 0.67 | |
| Dish in Rack | 任务完成分 | 0.54 | 0.58 | 0.88 |
| 成功率 | 0.20 | 0.20 | 0.50 |
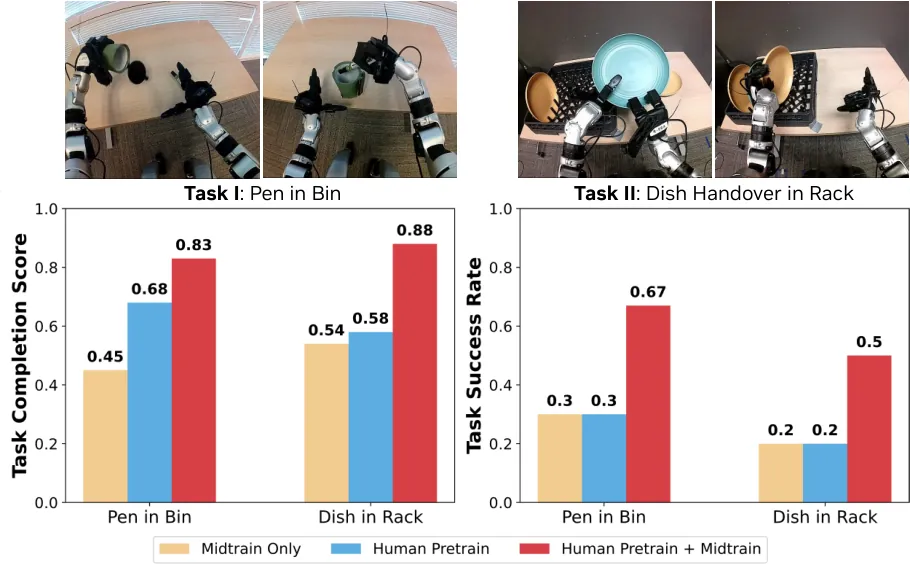
图 8:人类预训练加 G1 中间训练显著优于同等 G1 数据量下的人类预训练或中间训练。
这里不能把提升简单归因于“多看了 G1 数据”。同等 G1 数据量下,没有人类预训练的策略明显更差;有预训练的策略在两个任务上分别获得 37 和 30 个百分点的成功率提升。人类预训练学到的是抓取、开合、交接和协调的手指结构,G1 中间训练负责把这些结构适配到三指手的运动学上。作者也观察到行为更平滑,这与其说是额外指标,不如说是可复用运动先验的定性证据。
结果五:手指动作表示的选择
作者比较三种人类预训练表示。腕部-only 删除全部手指监督,在 Tongs 与 Card 这类接触时序敏感任务上最弱:手可能抓得太松、高度不稳,或过早闭合。基于指尖的表示预测手腕与指尖的 $\mathbb{SE}(3)$ 轨迹,再经 MLP 映射到关节;它比腕部-only 更有几何信息,但指尖小误差经映射后可能变成不合理的关节构型,在 Card 和 Bottle 上仍不稳定。重定向到 22 自由度关节空间最稳,因此成为默认方案。
这个消融回答了一个容易误解的问题:人类视频的价值不是“有一段人手视频”这么抽象,而在于监督信号是否落在机器人能执行的动作空间里。指尖位姿是观测语言,关节角是控制语言;当规模扩大时,控制语言中的结构性误差更容易被模型吸收为一致策略。
局限性
作者自述数据估计存在噪声:非约束采集依赖现成 SLAM 和手姿估计,遮挡与漂移会污染标签。他们也明确不把缩放律外推到 1k 到 20k 小时之外;虽然当前没有饱和,但更大数据、模型容量与数据多样性的耦合仍未验证。结论部分还指出,未来需要联合扩展人类数据与模型容量,并探索弱监督或无标签视频。
从工程角度看还有几个边界。第一,官方没有公开代码与数据管道,复现需要重建 SLAM、手姿估计、CasADi/IPOPT 重定向、流匹配 VLA 与 256 块 GB200 训练栈。第二,缩放律测量的是人类动作预测验证损失,它与机器人表现的强相关建立在本批任务上,还不是一个跨所有具身和任务族的因果定律。第三,one-shot 仍需要目标机器人示教,跨具身实验只在 G1 两个任务上进行,并在中间训练混入了该具身数据,因此不能宣称零样本跨具身。第四,评估使用图像叠加初始化来减少初始摆放差异,这提高了实验一致性,但也说明真实部署仍要处理更宽的初始分布。
总结与展望
EgoScale 的贡献不是发明一个单独的重定向算法,而是把三个通常分开讨论的问题连成一条可执行的路径:大规模第一视角人类视频能否提供控制监督?数据规模是否有可测趋势?少量对齐机器人数据能否把先验落到真实手?答案分别是有、有对数线性趋势、能。最终策略在 22 自由度灵巧手上相对无预训练基线提高 54% 平均成功率,one-shot Fold Shirt 达到 88% 成功率,并能在 G1 三指手上保持收益。
对机器人开发者,这篇论文给出的工程判断很清楚:不要把人类视频只用于视觉表征预训练,要尽量转换成相对腕部位姿和手指关节动作;也不要让少量机器人数据承担所有泛化。更合理的分工是,人类数据提供动作结构与多样性,机器人数据提供感知、本体状态与控制对齐,具身适配器处理硬件差异。
下一步最有价值的验证是把缩放曲线扩展到更多模型规模、更多机器人任务和更少后训练数据;同时公开可复现的数据处理与重定向工具。只有后者落地,大规模人类视频才会从论文里的规模化证据,变成社区能反复调用的训练资产。
金句
“人类数据的价值不在于它像人,而在于它能被翻译成机器人可执行的运动语言。”
“EgoScale 把少而准的机器人数据放在桥的位置,而不是让它独自撑起全部泛化。”