PAPER DEEP DIVE
MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差
移动操作策略大多照着一个站位采的示范学出来,部署时底座偏几厘米,第一视角画面和末端轨迹就一起偏,成功率断崖式下滑。MobileVISTA 不重采数据,而是把已有示范「搬」到新站位。视觉侧先按 (r,θ)~(√u·15cm, 2πv) 采样盘面偏移与 ±5° 偏航,用天空盒掩码(仿真里 GR-1 标红、Franka 标黄;真机走 URDF 深度阈值 0.995 再膨胀 5px)把机器人抠掉,Open3D 反投影成点云、按相机外参升到世界系平移 Δp,再用重定向动作正运动学算出的新外参重投影,被遮挡的洞交给 E2FGVI 补,最后把机器人渲到新位置合成回去(仿真 512×512,真机 6× 上采样)。动作侧是闭式变换:p'_t=T⁻¹[p_t;1]、R'_t=R_inv_yaw·R(r_t)、夹爪原样透传,双臂绕中点偏航,再用 mink IK(FrameTask 1.0/1.0、PostureTask 1e-5、≤20 步)解回关节。数据量仿真 1:1(200→200)、真机 1:10(50→500)。GR-1 的 Can Sort 在 r=15cm 从微调 π0.5 的 0.320 提到 0.527,Pouring 0.460 对 0.013;双臂 Franka 的 Box 从基线最高的 0.087(DP3)提到 0.247,Drawer 0.413 反而高过仿真 oracle 的 0.393。真机 Book Stacking 随机站位抓到 17/25、放上书堆 13/25,三个基线只有 1-2/25。消融指向关键在「机器人几何随站位变」:只做动作变换几乎无增益(0.00-0.11),固定机器人几何会丢掉 Pouring +0.47、Can Sort +0.28、Box +0.24。补图质量 PSNR 也压过 GEN3C(Can Sort 25.02 对 16.29 dB),单帧耗时 2.39-4.31 分钟(L40S)对 GEN3C 的 13.65-16.85 分钟(H200)。
论文信息
MobileVISTA: Generative Data Augmentation for Pose Generalization in Mobile Manipulation(MobileVISTA:面向移动操作位姿泛化的生成式数据增强)
作者:Suzannah Wistreich、Stephen Tian、Isabella Huang、Vitor Campagnolo Guizilini、Sergey Zakharov、Katherine Liu、Jiajun Wu。机构:斯坦福大学与丰田研究院(TRI)。arXiv 编号 2610.07511,v1 提交于 2026 年 10 月 5 日,全文 HTML 版见 arxiv.org/html/2610.07511v1。
项目页:sdwistreich.github.io/mobilevista,上面有方法动画、真机部署视频和与 GEN3C 的对比。
代码状态:截至 v1,作者只放出了项目页,GitHub 上能搜到的同名仓库 mobileVISTA/mobileVISTA.github.io 就是这个页面的托管仓库,没有方法实现。但流水线的每一块积木都是开源的:掩码渲染依赖 robosuite 与 MuJoCo,点云反投影与重投影用 Open3D,补洞用 E2FGVI 官方权重 E2FGVI-HQ-CVPR22.pth,全身 IK 用 mink(基于 MuJoCo 的 Python 求解器),策略侧对比用的是 real-stanford/diffusion_policy、YanjieZe/3D-Diffusion-Policy 和 Physical-Intelligence/openpi 的官方实现。想复现,缺的是把这些串起来的胶水代码、机器人 URDF 与相机标定。
一句话总结
只用一个固定基座姿态采到的演示,MobileVISTA 靠「几何重投影 + 现成视频补洞模型 + 逆扰动动作重定向」同时造出扰动后的自中心画面和配套动作,让同一套 Diffusion Policy 在真机 Galaxea R1 Pro 上从 15 cm 圆盘内任意站位都能干活;三个强基线(含微调过的 π0.5)在同样的随机站位下几乎全灭。整套方法不训练任何生成模型,也不需要多采一条演示。
为什么「机器人站歪了 15 厘米」是个真问题
移动操作的常规分工是:底盘负责导航到目标附近,机械臂负责干活。问题在于导航是有误差的——轮子打滑、地面不平、定位漂移,几厘米的偏差是常态而不是意外。而模仿学习的演示数据通常只在「那一个站位」上采集,策略学到的其实是一个以站位为条件的条件分布,只是这个条件从来没被写进训练目标里。
论文把设定收窄得很具体,也正是这份具体让它和之前的增强工作区分开:策略的输入是自中心(egocentric)的 RGB-D,相机装在运动链上(人形机器人的头部,会跟着腰关节一起动),而且机器人自己的手臂在画面里占了相当大一块。基座一平移,画面里同时变了两样东西——场景的视角变了,机器人自身几何在画面里的位置也变了。
作者用一张对照表(论文 Table I)说明现有工作最多只满足这两条性质中的一条:VISTA、RoVi-Aug、ROPA、RoboSplat 都不带移动基座;EgoDemoGen 带移动基座,但它的自中心相机是刚性装在头上、而头固定在基座上,合成靠的是每个域都要微调的视频生成模型,投稿时没有公开实现;1001 Demos 的相机在运动链上,但机器人本体不出镜;R2RGen 有移动基座却干脆不合成图像。MobileVISTA 是表里唯一三项全勾的一行,也是唯一在人形机器人上验证过的。
「那为什么不直接多采几个站位的演示?」——仿真里论文确实做了这个上界,叫 Simulator (Oracle):把基座挪到扰动位姿、按同样规则重定向动作、再录一遍观测。但这个上界在真机上没有对应物,给每个站位重录专家演示在规模上不可行。所以增强数据必须能从一份演示里「生」出来,这也是标题里 generative 的含义:生成的是数据,不是模型。
「那为什么不直接上学习型新视角合成(NVS)?」——因为 NVS 把机器人当成静态场景的一部分来外推,而自中心视角下相机运动和机器人关节运动是耦合的。论文没有停留在论证上,而是拿 GEN3C(一个主流的、支持相机控制的 3D 一致视频生成模型)做了同条件对照,既比 PSNR,也比用它合成出来的数据训出来的策略,后面实验部分详述。
预备知识
四个对比方法各代表一种「不改数据、只改表示或先验」的思路:Canonical-2D 是直接用单站位的 2D 图像训 Diffusion Policy;DP3 把输入换成点云这类显式 3D 表示,测试几何感知输入是否自带位姿鲁棒性;Fine-tuned π0.5 从 pi05_base 检查点出发做 LoRA 微调,测试大规模预训练先验是否够用;Simulator (Oracle) 提供完美合成的上界。关键一点是:MobileVISTA 是一个数据生成框架而不是策略架构——MobileVISTA、Canonical-2D 和所有消融变体用的是完全相同的 Diffusion Policy 架构、超参与训练流水线,唯一差别是喂进去的数据。
基座扰动写成 $\Delta p=(\Delta b,\ \Delta\theta)$,其中平移 $\Delta b\in\mathbb{R}^{2}$、偏航 $\Delta\theta$。为了让采样在圆盘内面积均匀(而不是集中在圆心),论文用标准写法:
$$ (r,\theta)\sim\left(\sqrt{u}\cdot r_{\text{train}},\ 2\pi v\right),\qquad u,v\sim\mathcal{U}(0,1),\qquad \Delta b=(r\cos\theta,\ r\sin\theta,\ 0) $$
不加竖直方向偏移;开启偏航抖动时再采 $\Delta\theta\sim\mathcal{U}(-5^{\circ},\ 5^{\circ})$。全文的训练半径与评测半径取同一个值 $r_{\text{train}}=r_{\text{eval}}=15\ \text{cm}$,作者的理由是这个范围能覆盖导航之后的真实基座误差。评测时再沿半径扫一遍 $r_{eval}\in\{0,1,3,5,7,10,15\}\ \text{cm}$,看策略在越来越离谱的站位上怎么退化。
方法详解
一条演示包含时间对齐的自中心与腕部 RGB-D 图像、本体感知状态、以及含夹爪/手指的关节空间动作。MobileVISTA 对每条演示采样一个 $\Delta p$,然后同时改两件事:把自中心观测合成到扰动后的站位,把动作重定向以补偿这个站位变化。腕部视角保持原样。
视觉分支第一步:把机器人从画面里抠掉
整条流水线假设你手上有机器人的仿真模型(URDF 或 MuJoCo 模型),它在三个地方被用到:分割出原图里的机器人、按重定向后的关节角重新渲染机器人、以及沿「基座到相机」这条运动链恢复自中心相机的轨迹。
仿真里的分割手法很工程化:把场景天空盒改成一种醒目的颜色(GR-1 人形用红色,双臂 Franka 用黄色,选黄色是为了不和场景里的红色物体撞色),隐藏所有非机器人几何体后渲染一遍,再按背景色阈值化得到二值掩码。真机上换成另一条路:从 URDF 在 MuJoCo 里渲染 R1 Pro 模型,直接取深度缓冲做轮廓(阈值 0.995 排除背景),再把掩码膨胀 5 个像素吃掉边缘毛刺。仿真渲染分辨率 512x512,真机按数据集原生分辨率渲染,并在点云重投影时上采样 6 倍。
视觉分支第二步:反投影、抬升到世界系、再重投影
把掩码作用到深度图上,得到一张「没有机器人的深度图」,再用针孔模型把 RGB-D 反投影成带颜色的点云:$[X,Y,Z]^{\top}=Z\,K^{-1}[u,v,1]^{\top}$。仿真的内参由 MuJoCo 的垂直视场角 cam_fovy 推出,真机用 ZED2 的标定内参 $f_x=58.4,\ f_y=58.5,\ c_x=74.7,\ c_y=42.9$(随图像尺寸等比缩放)。点云用 Open3D 的 RGBDImage.create_from_color_and_depth 构造,深度尺度 1000 mm,深度截断仿真 5 m、真机 10 m。
接下来这一步是整篇论文最容易被忽略、也最关键的设计:点云不是在相机系里平移的,而是先用原始每一帧的相机外参(MuJoCo 的 cam_xpos / cam_xmat)抬升到世界系,在世界系里施加基座扰动 $\Delta p$,再从新的自中心相机外参重投影下去。而新外参不是随便挑的——它是把重定向后的动作送进机器人模型、沿运动链算出来的。论文原话的意思可以写成一条变换链:
$$ P_w = T^{\text{orig}}_{c\to w}\,P_c,\qquad P'_w = T_{\Delta p}\,P_w,\qquad \hat{p} = \pi\!\left(K,\ T^{\text{new}}_{w\to c}\,P'_w\right) $$
也就是说,相机位姿和动作不是两个独立的自由度。同一个扰动基座下,如果中间关节不受约束,理论上可以有很多种相机位姿;MobileVISTA 只取由重定向动作经 IK 解出的那一种。这条约束是它和「随便换个视角渲染一张图」的增强方法在本质上的区别,也是自中心设定能成立的前提。
视觉分支第三步:用 E2FGVI 补洞
重投影出来的画面必然有洞:一块是刚才被分割掉的机器人留下的,一块是视角变化新暴露出来的遮挡区域,还有深度本身不完整造成的缺失。作者选视频补洞而不是最近邻填充,理由是这些 disocclusion 暴露的是边界附近从没被观测过的内容,不是可以复制粘贴的重复纹理。具体做法是把一条轨迹的所有帧和对应的逐帧空洞掩码当成一个时序批次喂给 E2FGVI 的官方流水线;补洞前先对空洞掩码做 3x3 形态学闭运算(3 次迭代),把点云稀疏造成的小缝隙合上;权重是 E2FGVI-HQ-CVPR22.pth。
视觉分支第四步:按重定向后的关节角重渲机器人并合成
补完洞得到的是「干净的背景」,但画面里还缺机器人自己。于是在 MuJoCo 里按重定向后的关节角再渲染一遍机器人(同样隐藏非机器人几何体),把它合成到背景上。仿真用颜色掩码(排除天空盒颜色像素)来处理背景透色,真机用重渲时的深度缓冲来判定机器人像素,同样膨胀 5 像素。真机的输出最后再降采样回数据集原生分辨率。整条链路全自动,任何一步都没有人工筛选。
动作分支:在末端执行器空间做逆扰动
动作重定向的目标只有一句:让末端执行器在世界里走的那条轨迹尽量不变,因为那条轨迹是已知能完成任务的。源动作如果是关节空间的,先用正运动学转成基座系下的末端位姿目标,然后对每一帧施加扰动的逆变换。位置部分是一个 4x4 齐次矩阵(逆偏航旋转加平移):
$$ \mathbf{p}'_t = T^{-1}_{\Delta p}\cdot[\mathbf{p}_t;\ 1] $$
姿态部分以旋转向量表示,与逆偏航旋转复合后再转回旋转向量:
$$ R'_t = R_{\text{inv yaw}}\cdot R(\mathbf{r}_t) $$
夹爪与手指指令原样透传。双臂 Franka 的 rig 会把两个基座位姿和共享相机位姿都缓存下来,偏航旋转绕两个基座位置的中点施加,以保持它们的相对构型,因此每条手臂的补偿同时含一份旋转和一份由该臂基座位姿变化导出的平移。
动作分支:真机上的全身 IK
仿真演示本身就录的是末端位姿,所以重定向是闭式的;真机的 JoyLo 遥操作录的是关节空间指令,必须解 IK。作者用 mink 做全身逆运动学,配置写得很细,值得照抄:左右末端站点(left_ee_center / right_ee_center)各挂一个 FrameTask,位置代价与姿态代价都是 1.0;一个 PostureTask 向上一帧构型正则化,代价 $10^{-5}$;关节位置有 ConfigurationLimit;手臂关节的每步速度上界 1.0,躯干关节限位在 Book Stacking 上取 0.02、在 Laundry Sort 上取 0.04——这个差别是有意的,倾向于让手臂多动、躯干少动以稳住视角,而长时域的 Laundry Sort 允许躯干多动一点;末端与躯干之间挂 CollisionAvoidanceLimit,最小碰撞距离 0.04 m、检测距离 0.18 m。每帧最多迭代 20 步,$\Delta t=0.01$,底层求解器 quadprog,阻尼 $10^{-3}$,收敛的位置容差 0.01 m。写成优化问题大致是:
$$ \min_{q_t}\ \sum_{i\in\{L,R\}}\Big(\lVert \mathrm{FK}_i(q_t)-\mathbf{p}'_{t,i}\rVert^{2}+\lVert \mathrm{orient}_i(q_t)-R'_{t,i}\rVert^{2}\Big)+10^{-5}\lVert q_t-q_{t-1}\rVert^{2} $$
受限于关节限位、每步速度上界与末端-躯干碰撞距离。第 0 帧的 IK 目标由原始末端位姿绕 rig 支点按 $\Delta p$ 变换得到;之后的帧直接让 IK 去追原始的末端轨迹,允许手臂从新基座出发用不同的弯折方式够到同一个世界系目标。
作者对 IK 失败的处理态度很务实:在采样的 15 cm 范围内所有轨迹都收敛了,所以不做任何过滤;而一旦扰动大到 IK 解不出来,那种情况基本等价于「这个站位本来就够不着任务」,属于该重新走位的问题,不是数据增强该管的问题。
腕部相机为什么不动
论文只增强自中心相机,腕部视角原样保留。两个理由:腕部视野太局部、近距离交互的深度又稀疏,几何重投影在这类视角上不可靠;而重定向的目标本来就是保持末端轨迹不变,所以腕部相机看到的东西在基座扰动下大体是自洽的。这个取舍同时也是作者自己列出的局限之一。
数据配比
仿真里每条源演示生成 1 条增强轨迹,200 条源演示得到 200 条增强轨迹(1:1);真机里每条源演示生成 10 条,50 条源演示得到 500 条增强轨迹(1:10)。真机每个任务采 50 条专家演示(Book Stacking 每条约 150 个时间步),用 JoyLo 遥操作框架(来自 BEHAVIOR Robot Suite)在 ROS 2 下以 10 Hz 录制同步的 RGB-D、本体感知与关节动作。
下面这张流程图按论文 Section III 与 Appendix A 的真实实现绘制,注意视觉分支的新相机外参来自动作分支的解,两个分支在这一点上交汇:
flowchart TD
  D["单 canonical 站位的演示
RGB-D + 本体感知 + 关节动作"] --> S["采样扰动 delta_p
圆盘 r_train = 15 cm, yaw +/-5 deg"]
  S --> V1["MuJoCo / robosuite 渲染机器人
得到 2D 掩码"]
  V1 --> V2["掩码去掉深度图中的机器人
真机走 URDF 深度缓冲 阈值 0.995 膨胀 5 px"]
  V2 --> V3["针孔模型反投影成彩色点云
Open3D 深度截断 5 m 仿真 / 10 m 真机"]
  V3 --> V4["用原始相机外参抬升到世界系
cam_xpos / cam_xmat"]
  V4 --> V5["在世界系施加 delta_p"]
  S --> A1["关节动作 -> 正运动学 -> 基座系末端目标"]
  A1 --> A2["施加逆扰动 T_delta_p 的逆
位置与旋转向量分别补偿 夹爪透传"]
  A2 --> A3{"动作来自哪里"}
  A3 -->|"仿真 演示本身是末端位姿"| A4["闭式重定向"]
  A3 -->|"真机 JoyLo 关节空间"| A5["mink 全身 IK
最多 20 步每帧 dt 0.01 容差 0.01 m
躯干限位 0.02 / 0.04 碰撞距离 0.04 m"]
  A4 --> V6["沿运动链正运动学
得到新的自中心相机外参"]
  A5 --> V6
  V5 --> V7["从新外参重投影
OffscreenRenderer 输出 RGB + 空洞掩码"]
  V6 --> V7
  V7 --> V8["E2FGVI 视频补洞
3x3 闭运算 3 次 权重 E2FGVI-HQ-CVPR22"]
  V8 --> V9["按重定向关节角重渲机器人
合成到补洞后的背景"]
  V9 --> O1["扰动后的自中心观测"]
  A4 --> O2["重定向动作"]
  A5 --> O2
  O1 --> T["增强数据集
仿真 1 比 1 200 到 200 真机 1 比 10 50 到 500"]
  O2 --> T
  T --> P["Diffusion Policy 训练
架构与超参与 Canonical-2D 完全一致"]
  W["腕部相机视角"] -.->|"原样保留 不做重投影"| T
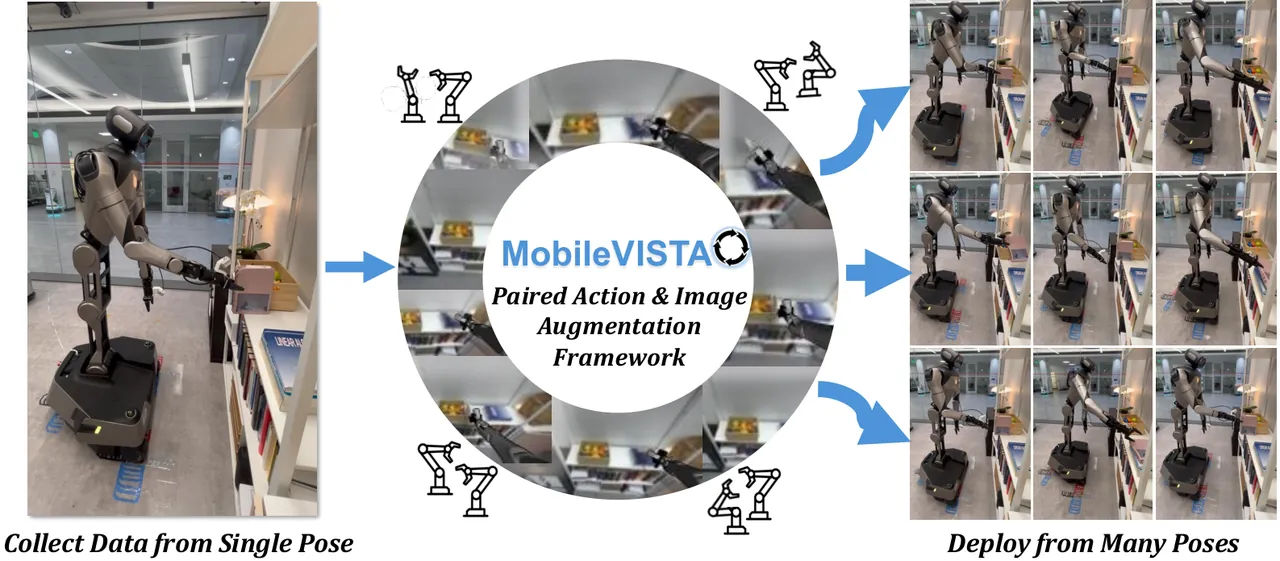
图 1(论文 Fig. 1):左边是在单一 canonical 站位采集的演示,中间是同时合成出来的自中心观测与重定向动作,右边是训练后的策略在一整片没见过的站位上都能完成任务。
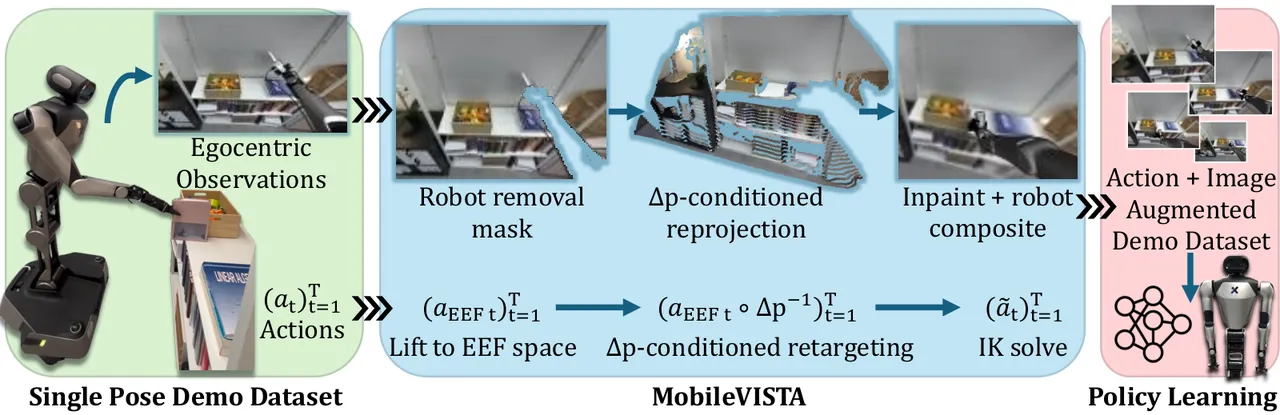
图 2(论文 Fig. 2):框架总览。视觉分支去掉机器人、重投影场景、再按重定向后的构型把机器人渲回去;动作分支在末端执行器空间用逆扰动把动作重定向。两条分支合起来才是一份可用的增强数据。
实验结果
仿真用 robomimic + MuJoCo,任务取自 DexMimicGen 的四个:Can Sort 与 Pouring 在 Fourier GR-1 人形平台上做,Box 与 Drawer 在双臂 Franka 上做。GR-1 的头部相机视场角从 DexMimicGen 默认的 50 度放宽到 90 度,以确保整个操作工作区都在画面里。每个结果都是 3 个随机种子、每种子 50 次 rollout 的均值。Can Sort 按罐头颜色均分训练演示,其余任务用前 200 条演示训练、在 DexMimicGen 的环境变体上评测。
Q1:面对训练分布外的站位,谁还站得住
下面这张表是论文 Appendix Table III 的节选(成功率,均值 ± 标准差,3 种子 x 50 rollout),只列出四个代表性评测半径。斜体是 Simulator (Oracle) 上界。
| 任务 | 方法 | r=0 | r=5 cm | r=10 cm | r=15 cm |
|---|---|---|---|---|---|
| Can Sort (GR-1 人形) | Canonical-2D | 0.480 ± 0.02 | 0.440 ± 0.05 | 0.240 ± 0.00 | 0.120 ± 0.06 |
| DP3 | 0.733 ± 0.08 | 0.407 ± 0.05 | 0.153 ± 0.04 | 0.060 ± 0.02 | |
| Fine-tuned π0.5 | 0.926 ± 0.05 | 0.827 ± 0.10 | 0.607 ± 0.09 | 0.320 ± 0.03 | |
| MobileVISTA | 0.953 ± 0.03 | 0.887 ± 0.05 | 0.793 ± 0.06 | 0.527 ± 0.04 | |
| Simulator (Oracle) | 0.913 ± 0.02 | 0.927 ± 0.03 | 0.727 ± 0.01 | 0.527 ± 0.08 | |
| Pouring (GR-1 人形) | Canonical-2D | 0.547 ± 0.03 | 0.353 ± 0.03 | 0.080 ± 0.02 | 0.073 ± 0.06 |
| DP3 | 0.287 ± 0.08 | 0.173 ± 0.06 | 0.080 ± 0.06 | 0.013 ± 0.01 | |
| Fine-tuned π0.5 | 0.467 ± 0.03 | 0.333 ± 0.05 | 0.093 ± 0.03 | 0.013 ± 0.01 | |
| MobileVISTA | 0.673 ± 0.02 | 0.613 ± 0.04 | 0.547 ± 0.12 | 0.460 ± 0.02 | |
| Simulator (Oracle) | 0.773 ± 0.03 | 0.727 ± 0.03 | 0.700 ± 0.07 | 0.560 ± 0.11 | |
| Box (双臂 Franka) | Canonical-2D | 0.307 ± 0.11 | 0.147 ± 0.10 | 0.047 ± 0.02 | 0.000 ± 0.00 |
| DP3 | 0.407 ± 0.01 | 0.333 ± 0.02 | 0.213 ± 0.03 | 0.087 ± 0.05 | |
| Fine-tuned π0.5 | 0.187 ± 0.10 | 0.147 ± 0.01 | 0.060 ± 0.03 | 0.020 ± 0.00 | |
| MobileVISTA | 0.520 ± 0.14 | 0.440 ± 0.07 | 0.393 ± 0.07 | 0.247 ± 0.05 | |
| Simulator (Oracle) | 0.313 ± 0.09 | 0.407 ± 0.06 | 0.373 ± 0.06 | 0.333 ± 0.01 | |
| Drawer (双臂 Franka) | Canonical-2D | 0.287 ± 0.10 | 0.100 ± 0.04 | 0.040 ± 0.02 | 0.013 ± 0.01 |
| DP3 | 0.260 ± 0.00 | 0.180 ± 0.03 | 0.067 ± 0.06 | 0.040 ± 0.02 | |
| Fine-tuned π0.5 | 0.580 ± 0.09 | 0.373 ± 0.11 | 0.167 ± 0.08 | 0.060 ± 0.02 | |
| MobileVISTA | 0.653 ± 0.04 | 0.593 ± 0.06 | 0.487 ± 0.09 | 0.413 ± 0.01 | |
| Simulator (Oracle) | 0.720 ± 0.03 | 0.713 ± 0.07 | 0.640 ± 0.09 | 0.393 ± 0.03 |
三个读法。第一,退化速度:Canonical-2D 随半径增大迅速崩掉,在 r=15 cm 时四个任务平均不到 45%;DP3 和微调 π0.5 在多数任务上能追平或略超 Canonical-2D,但随扰动增大同样泛化不动。第二,例外:在 Can Sort 上,微调 π0.5 在 $r_{eval}$ 小于 5 cm 的区间里已经接近 MobileVISTA 与 Oracle,说明大预训练先验在小扰动上确实能补一点,但补不到 15 cm。第三,也是最有意思的一点:Oracle 并不是一个严格的上界。Box 任务 r=0 时 Oracle 只有 0.313,MobileVISTA 是 0.520;Drawer 任务 r=15 cm 时 MobileVISTA 的 0.413 反超 Oracle 的 0.393。合成数据带来的分布多样性,在某些格子上比「完美但单一来源」的观测更有用。
Q2:两个模态必须一起增强,机器人必须重渲
消融设计得很干净:Aug. Actions Only 用原始 canonical 观测配重定向后的动作,Aug. Images Only 用增强观测配原始动作,两者都严格保持演示顺序,因此相对源演示恰好只有一个模态被增强。Fixed Robot Geom. 则是把视觉分支里的机器人分割与重渲合成整段拿掉——整个场景连机器人一起从深度重投影到目标视角,把机器人当成环境里的静物。
结果是:单独增强任何一个模态都会一致地掉点,其中 Aug. Actions Only 掉得最狠(Pouring 上几乎是 0.00 ± 0.00,Can Sort 上只有 0.07 到 0.11),因为画面和动作对不上号等于在教策略看错的东西做错的事。去掉机器人重渲的代价则明显依赖任务:按半径平均,MobileVISTA 相对 Fixed Robot Geom. 的领先在 Pouring 上是 +0.47,在 Can Sort 与 Box 上分别是 +0.28 与 +0.24,在 Drawer 上约等于 0.00。作者给出的假设是两条性质决定重渲值不值:机器人几何在自中心画面里占多大,以及相机是不是长在运动链上。Pouring 用的是带主动腰关节的 GR-1,两条都占,所以差距最大;Franka 那两个任务相机装在固定支架上、看到的机器人本体少,效果就弱。作者很坦白地说这只是假设——四个任务无法把这两条性质拆开,也解释不了 Box 与 Drawer 之间的差别。
Q3:和学习型新视角合成比,几何重投影赢在保真和速度
论文在每个任务的 15 cm 圆盘内采 200 个扰动构型,用仿真器渲出 oracle 视角当真值,再分别用 MobileVISTA 与 GEN3C 在同一相机扰动下合成,算 PSNR。下面是论文 Appendix Table V 的完整数字(单位 dB)。
| 方法 | Can Sort 0-5 / 5-10 / 10-15 cm | Pouring 0-5 / 5-10 / 10-15 cm | Box 0-5 / 5-10 / 10-15 cm | Drawer 0-5 / 5-10 / 10-15 cm |
|---|---|---|---|---|
| GEN3C | 16.29 / 14.42 / 13.08 | 17.74 / 15.09 / 13.28 | 16.37 / 13.75 / 11.78 | 16.32 / 15.76 / 14.35 |
| MobileVISTA | 25.02 / 24.05 / 23.28 | 23.71 / 23.25 / 22.18 | 16.47 / 16.01 / 14.72 | 18.67 / 18.93 / 18.29 |
| 差值 | +8.73 / +9.63 / +10.20 | +5.97 / +8.16 / +8.90 | +0.10 / +2.26 / +2.94 | +2.35 / +3.17 / +3.94 |
差距在不同本体上并不均匀:在 10 到 15 cm 这一段,MobileVISTA 在两个 GR-1 人形任务上分别高出 10.2 dB 与 8.9 dB,而在两个 Franka 任务上只高出 2.9 dB 与 3.9 dB。人形任务上机器人本体占画面更多、相机还跟着腰动,正是几何重投影相对学习型 NVS 优势最大的地方。速度上,合成一条轨迹的平均耗时 GEN3C 是 14.93 / 13.65 / 14.93 / 16.85 分钟(Can Sort / Pouring / Box / Drawer),MobileVISTA 是 3.81 / 4.31 / 2.39 / 2.99 分钟,快 4 到 7 倍;而且 MobileVISTA 的计时是在单张 L40S 上测的,GEN3C 是在单张 H200 上测的,H200 更强,所以这个倍数是保守估计。作者把差距归因于 GEN3C 每帧都要做迭代扩散采样,而 MobileVISTA 是一次几何重投影前向加一次补洞。
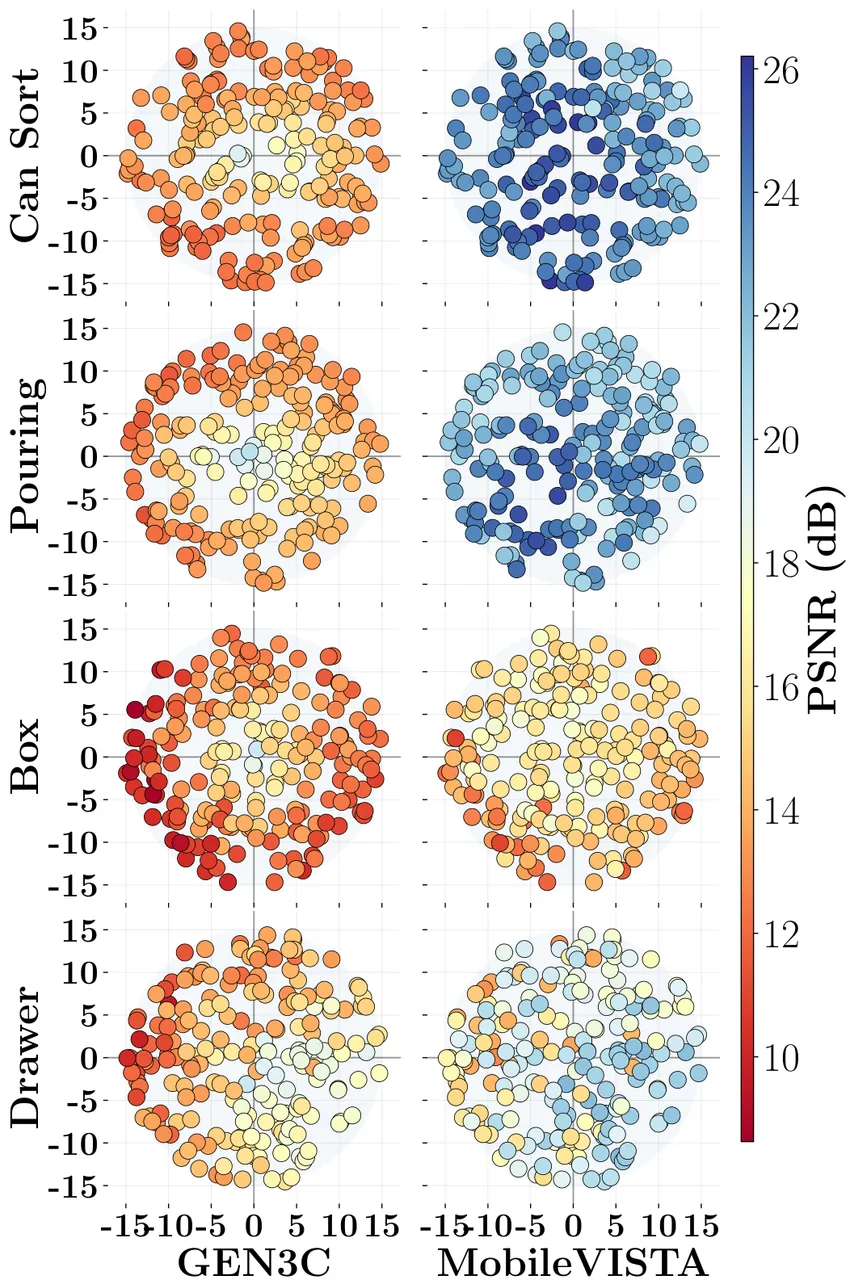
图 3(论文 Fig. 6):每个点是一条合成轨迹的 PSNR 与它采样到的基座偏移(俯视图,单位 cm)。MobileVISTA 整体更高,人形任务上分离得最开;两种方法 PSNR 接近的任务,下游策略成功率的差距也更小。
更关键的是下游:作者把 GEN3C 合成的观测配上同一套动作重定向、同一套 Diffusion Policy 配置去训策略,结果四个任务、全部评测半径上都不如用 MobileVISTA 数据训出来的策略,而且差距大小与 PSNR 差距同向。换句话说,PSNR 在这里不是一个装饰性指标,它确实预测了策略能不能学会。
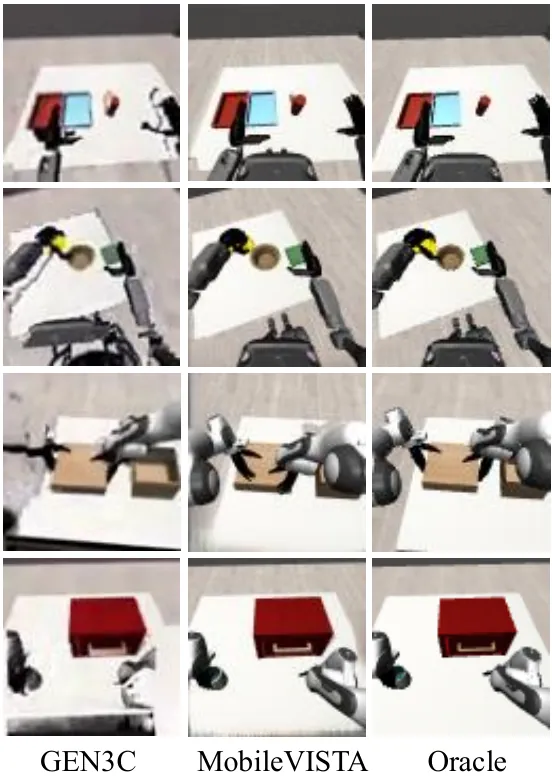
图 4(论文 Fig. 8):同一扰动基座位姿下的定性对比,每个任务给出仿真 oracle 视角、MobileVISTA 合成视角与 GEN3C 合成视角。MobileVISTA 保住了清晰的物体边界与一致的场景几何,GEN3C 在视角变化更大时倾向于把物体边缘糊掉、把表面扭曲。
Q4:真机 Galaxea R1 Pro 上的结果
真机是一台 Galaxea R1 Pro 人形机器人,头部一台 ZED2 RGB-D 提供所有策略共用的自中心视角,两只手腕各一台 Intel RealSense RGB。评测方法值得单独说一句,因为它把「靠运气」这件事排除得很彻底:地上手工贴出一张以 canonical 站位为中心、向各方向延伸 15 cm 的网格,每次试验在圆盘内均匀采一个偏移,人工把机器人开到那个位置;偏航不单独控制,因为策略训练时就覆盖了整个偏航范围;从同一个偏移出发,四个策略(MobileVISTA、Canonical-2D、DP3、Fine-tuned π0.5)在不重新摆位的情况下依次跑完,且评测顺序是随机的、打分的人不知道顺序。推理在单张 RTX 4090 上跑。每个任务 25 次 canonical 站位试验加 25 次随机站位试验。
下面是论文 Table II 的完整数字(每格是 25 次试验中的成功次数,随机站位半径 15 cm)。
| 任务 / 站位 | 方法 | 指标 | 成功次数 |
|---|---|---|---|
| Book Stacking 随机站位 | Canonical-2D | 抓到 | 1/25 |
| 放上书堆 | 1/25 | ||
| DP3 | 抓到 | 2/25 | |
| 放上书堆 | 1/25 | ||
| Fine-tuned π0.5 | 抓到 | 2/25 | |
| 放上书堆 | 2/25 | ||
| MobileVISTA | 抓到 | 17/25 | |
| 放上书堆 | 13/25 | ||
| Book Stacking canonical 站位 | Canonical-2D | 抓到 | 25/25 |
| 放上书堆 | 24/25 | ||
| DP3 | 抓到 | 20/25 | |
| 放上书堆 | 8/25 | ||
| Fine-tuned π0.5 | 抓到 | 25/25 | |
| 放上书堆 | 25/25 | ||
| MobileVISTA | 抓到 | 19/25 | |
| 放上书堆 | 18/25 | ||
| Laundry Sort 随机站位 | Canonical-2D | 至少分对 1 / 2 / 3 / 4 件 | 6 / 3 / 2 / 1(各 /25) |
| DP3 | 至少分对 1 / 2 / 3 / 4 件 | 3 / 2 / 2 / 2(各 /25) | |
| Fine-tuned π0.5 | 至少分对 1 / 2 / 3 / 4 件 | 14 / 2 / 1 / 1(各 /25) | |
| MobileVISTA | 至少分对 1 / 2 / 3 / 4 件 | 18 / 12 / 6 / 2(各 /25) | |
| Laundry Sort canonical 站位 | Canonical-2D | 至少分对 1 / 2 / 3 / 4 件 | 21 / 15 / 5 / 3(各 /25) |
| DP3 | 至少分对 1 / 2 / 3 / 4 件 | 19 / 11 / 8 / 3(各 /25) | |
| Fine-tuned π0.5 | 至少分对 1 / 2 / 3 / 4 件 | 21 / 8 / 7 / 5(各 /25) | |
| MobileVISTA | 至少分对 1 / 2 / 3 / 4 件 | 24 / 15 / 9 / 4(各 /25) |
随机站位下的对比是压倒性的:Book Stacking 上 MobileVISTA 抓到 17/25、放上去 13/25,而三个基线在两个阶段上都不超过 2/25。Laundry Sort 上 MobileVISTA 至少分对一件的有 18/25、至少两件 12/25,最强基线是微调 π0.5 的 14/25(但它至少两件的只有 2/25),Canonical-2D 只有 6/25 与 3/25。代价也摆在明面上:在 canonical 站位的 Book Stacking 上,MobileVISTA 抓到 19/25、放上 18/25,而 Canonical-2D 是 25/25 与 24/25、微调 π0.5 是 25/25 与 25/25——增强换来了鲁棒性,也削掉了一点峰值精度。有意思的是这份精度代价没有出现在 Laundry Sort 上,那里 MobileVISTA 在四个阈值中的三个上都是最好或并列最好。
失败模式的分析比成功率更能说明问题。MobileVISTA 对向左和向前的偏移泛化得尤其好,剩下的失败主要是够书时的关节限位违例,作者推测是重定向后的轨迹要求手臂跨过躯干。基线则是在原样重放演示轨迹:向前的偏移会撞到书架,向后的偏移让夹爪够不到书;微调 π0.5 还经常输出超出关节限位的动作,尽管它的定性失败模式和 Canonical-2D、DP3 差不多。Laundry Sort 上,Canonical-2D 与 DP3 不会补偿向后移动,抓取时提前停住;Canonical-2D 还会在抓空之后照样做双手交接动作;这两种模式在任何一次 MobileVISTA 的 rollout 里都没出现过。MobileVISTA 自己也会碰到桌子和篮子,但发生在向后偏移时,表现为冲过了物品而不是够不着。
局限性
作者自述的三条:一,合成质量依赖相机视场角,视场越窄可见上下文越少,生成视图的一致性和策略性能都可能退化——这一点在他们的设置里其实已经被动过手脚,GR-1 的头部相机视场角被从默认的 50 度放宽到 90 度才让整个工作区可见。二,只增强了自中心相机,腕部相机没有增强,多视角增强可能带来的鲁棒性收益尚未探索。三,所有结论都被采样范围框住(15 cm 平移、±5 度偏航),范围之外的行为没有测过。
我的补充判断,四条:
第一,整套流水线对「你手上有准确的机器人模型和相机标定」这件事是硬依赖。真机链路要 URDF、要 ZED2 的标定内参、要在 MuJoCo 里能渲出深度缓冲。很多真实部署场景恰恰缺这个,尤其缺能对上真机的 URDF 与手眼标定。
第二,场景被当成静态点云处理,物体本身没有模型。作者明确写了「和一般行为克隆一样,假设任务相关的接触与物体动力学在采样扰动下大致不变」。对刚体罐头、书、抽屉这是合理的,对可形变的衣物(Laundry Sort 的袜子和毛巾)就未必;而且 E2FGVI 补的是没被观测过的内容,它补错了策略就会被教错,论文没有量化补洞区域的语义正确率,只用整帧 PSNR 来代理。
第三,统计功效有限。真机每格只有 25 次试验,17/25 与 14/25 这种差距在二项分布下并不显著,论文也没有做显著性检验。真正无可争议的是 17/25 对 ≤2/25 那一档。
第四,与学习型 NVS 的对比只用了 GEN3C 一个模型,且没有针对机器人场景做微调。作者自己在 Table I 的讨论里也提到 EgoDemoGen 这类方法用的是「每个域都要微调的视频生成模型」,也就是说这场对比里对手并没有拿到它最好的配置。
总结与展望
MobileVISTA 的贡献不在于提出了新的生成模型,而在于把「自中心 + 相机在运动链上 + 机器人本体在画面里」这个此前没人同时处理过的设定,用一条纯几何的流水线解掉了,而且解得比学习型 NVS 更保真、更快。三个可迁移的结论值得记住:动作与视觉必须耦合增强,只增强一边会比不增强更糟;机器人本体必须按重定向后的构型重渲,否则在相机随链运动的平台上会掉一大截;相机外参必须由动作解出来,不能独立采样。这三条对任何要做具身数据增强的团队都直接适用,与用不用扩散模型无关。
它没有解决的部分同样清楚:真机上 canonical 站位的精度损失、腕部视角的缺失、以及对机器人模型与标定的依赖。作者点出的两个方向——把 MobileVISTA 与大规模预训练策略结合、把增强扩展到腕部相机——前者尤其值得关注:表里微调 π0.5 在小扰动上已经接近 MobileVISTA,如果把 MobileVISTA 生成的数据拿去微调 π0.5 而不是训一个从头开始的 Diffusion Policy,两条路线的长处理论上可以叠加。
金句
「在采样的 15 cm 范围内所有轨迹都收敛了,所以我们不做任何过滤。而在显著更大的扰动下,IK 失败基本会与『这个站位本来就够不着任务』同时发生——那是该重新走位的情形,不是数据增强能解决的情形。」
原文:Within the sampled 15 cm range all trajectories converged, so we apply no filtering. Under significant perturbations, IK failure would largely coincide with the task being unreachable from that base pose — a case for repositioning rather than augmentation.
「自中心相机的位姿不是独立于动作挑出来的:扰动后的基座也许允许多种合法的相机位姿,但相机外参是从重定向动作经 IK 解出的那个关节构型里继承下来的。」
原文:egocentric camera poses are not chosen independently of actions ... camera extrinsics are inherited from the joint configuration resolved by the retargeted actions via IK.