PAPER DEEP DIVE
UniLM-Nav:面向零样本最后一米导航的统一框架
移动操作中,物体导航只把机器人送到目标附近,真正决定成败的是其后把基座调整到可操作位姿的最后一米。UniLM-Nav 用同一个 MLLM 后端把这一段显式分解为三个阶段:从短期观测记忆中按可见性与可接近性选出参考视角;把任务指令接地为归一化交互点,并用深度反投影提升为 3D affordance;再条件于该 3D 点、机器人构型与任务指令推理基座位置,朝向则由几何闭式解给出而非模型预测。框架完全零样本,在 HomeRobot OVMM 验证集上以 23.77% 的总体成功率超过此前最强的 MoTo 3.13 个百分点,13 个 MLLM 后端的对照显示具身空间数据微调的 4B 模型可胜过 235B 通用模型,真机在宇树 B2 四足加 Z1 机械臂平台上以 52.5% 的成功率完成闭环验证。
论文元信息
论文标题:UniLM-Nav: A Unified Framework for Zero-Shot Last-Mile Navigation(UniLM-Nav:面向零样本最后一米导航的统一框架)
作者与机构:Zhuofan Zhang、Tianxu Wang、Guoxi Zhang、Yixiong Lin、Xilin Wang、Hongming Xu、Qing Li、Song-Chun Zhu、Lifeng Fan(清华大学、北京通用人工智能研究院 BIGAI、哈尔滨工业大学、北京大学)
链接:arXiv:2607.06537(v2,2026-07-11)· 项目页 unilm-nav.github.io
代码状态:截至 2026-10-08 精读时,项目页的 Code 按钮仍为占位(aria-disabled),代码待发布;GitHub 上仅有项目页仓库,暂无第三方复现。
一句话总结
UniLM-Nav 把移动操作里最容易被忽视的"最后一米"拆成选视角、定交互点、算站姿三个 MLLM 子问题,用深度反投影与几何朝向把度量计算留在模型之外,以完全零样本的方式在 OVMM 基准上超过此前最强方法 MoTo 3.13 个百分点,并在宇树 B2 四足加 Z1 机械臂的真机平台上完成验证。
研究背景与动机
移动操作要求机器人先导航到目标物体或容器附近,再完成抓取或放置。导航与操作之间的交接点决定了整条链路的成败:物体导航系统通常只保证把机器人送到目标 1 到 2 米的邻域内,这个粒度对"看见目标"足够,对"操作目标"却远远不够。机器人可能停在一个手臂够不到桌面的角度,也可能正对着一把挡住去路的椅子。
论文用图 1 的场景把这个问题说得很具体:任务是把水瓶放在显示器前方的桌面上。物体导航结束后,机器人确实到了桌子附近,但终止位姿要么离桌面太远、超出臂展,要么被椅子夹在中间,放置动作根本无法执行。作者把"物体导航结束之后、把基座调整到可操作位姿"这一段称为最后一米导航(last-mile navigation),它要求机器人同时回答两个问题:场景里哪里是与本任务相关的交互区域,以及在这个区域约束下基座应该站在哪里、朝向哪里。
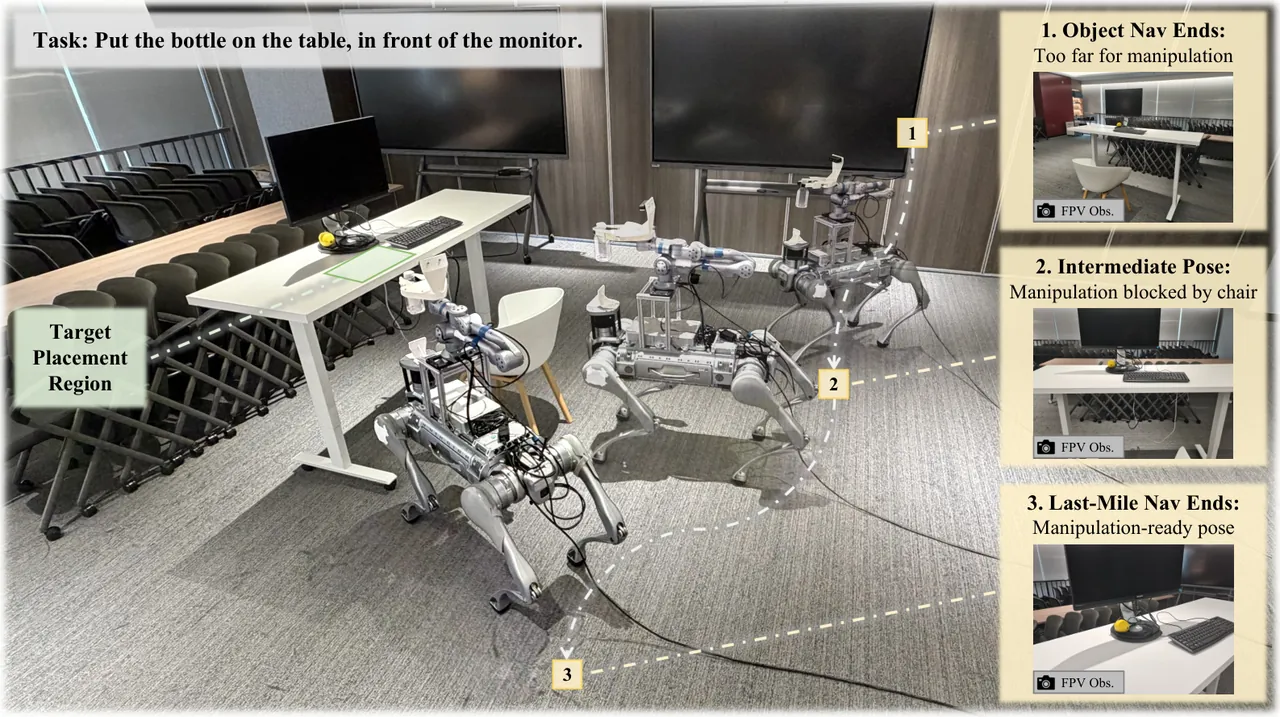
图 1:真机 teaser。任务是把水瓶放在显示器前方的桌面上;位姿 1 是物体导航的终止位姿,离桌面太远、超出臂展;位姿 2 的接近路径被椅子挡住;位姿 3 是最后一米导航结束后的可操作位姿。右侧三张小图为对应位姿的第一视角观测。
已有路线各自带着硬伤。一类方法依赖人工标注的任务特定基座位姿,换任务换环境就要重标;一类方法用模仿学习或强化学习端到端地隐式处理交接,或者显式学习"操作条件化的位姿偏好",但都吃数据,且难以扩展到开放词汇指令;还有一类零样本方法(如 MoTo)借助视觉基础模型与 MLLM 做物体级推理,可物体级线索回答不了细粒度空间关系——"放在显示器前面"需要的不是定位显示器,而是找到满足特定空间关系的容器区域。
与此同时,视觉基础模型把开放词汇感知变成了即插即用的能力,MLLM 则在空间推理基准上持续进步。把这两股能力接进移动操作的交接环节,让一个现成的 MLLM 在零样本条件下推理出可操作基座位姿,成为自然但未被解决好的问题:三类子决策(选哪帧图、点哪个像素、站哪个位置)异构程度很高,直接塞进一次调用里,模型往往顾此失彼。
UniLM-Nav 的回答是"统一框架、显式分解":三个阶段共用同一个 MLLM 后端,每个阶段只要求模型做一件与其能力匹配的判断题或填空题,度量几何(深度反投影、朝向计算)交给确定性代码。这个设计既保留了零样本与开放词汇的灵活性,又把 MLLM 不擅长的度量估计从推理回路里移了出去。
预备知识:任务设定与输入输出
论文在开放词汇移动操作(OVMM)设定下研究问题:机器人收到一条自然语言指令,需要找物体、抓取、找容器、放置,全程室内开放词汇场景。评测沿用 HomeRobot 的 OVMM 基准,报告条件化的阶段成功率 FindObj、Pick、FindRec,以及总体成功率 Overall SR 与阶段均值 Average SR。
系统假设物体导航策略与预建场景地图已把机器人带到目标邻域(目标出现在近期观测中、距离约 1 到 2 米)。最后一米阶段可用的输入包括:自我中心 RGB-D 观测、本体感知状态、里程计估计、任务指令,以及由机载传感器估计的障碍物地图。这些都是现成移动操作栈的标准配置,不需要额外标注。
输出是一个可操作基座位姿 $\mathbf{b}=(x,y,\theta)\in\mathbb{R}^{3}$,其中 $(x,y)$ 是目标基座位置,$\theta$ 是期望朝向,要求无碰撞、可到达、且适合后续操作。论文研究的核心问题是:如何零样本地用一个现成 MLLM 推理出这个位姿。
方法详解
UniLM-Nav 把最后一米导航分解为三个阶段:视角选择、任务条件化的 affordance 接地、几何感知的基座位姿推理,三个阶段共用一个 MLLM 后端(图 2 的方法总览)。下面按数据流顺序展开。
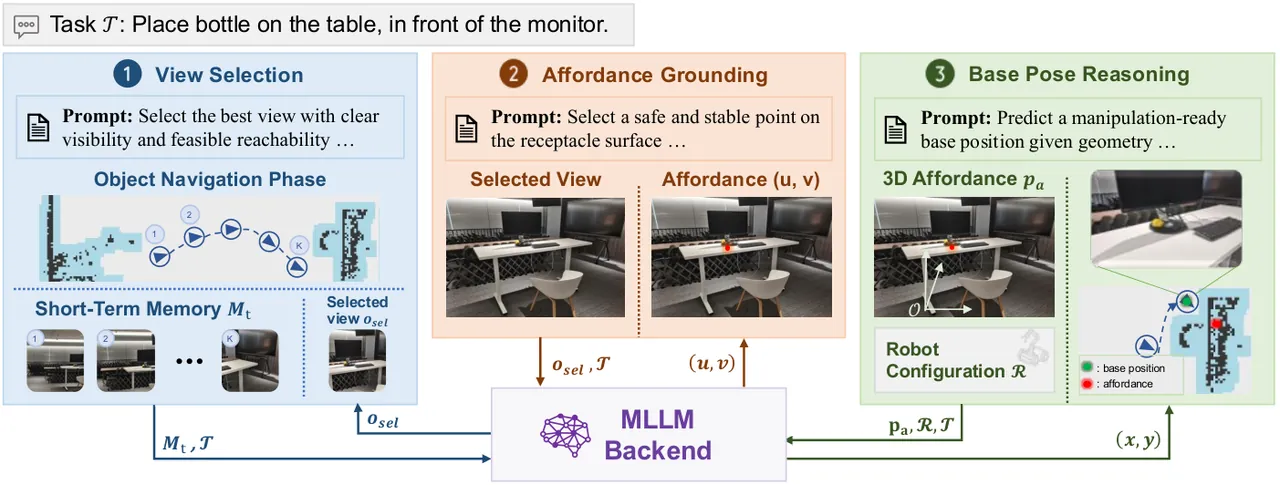
图 2:UniLM-Nav 方法总览。MLLM 先从近期观测中选出参考视角,再在选中视角里接地任务相关的 affordance 并用深度提升到 3D,最后条件于 3D affordance、机器人构型与任务指令预测可操作基座位姿。
阶段一:短期观测记忆与视角选择。物体导航终止时刻 $t$ 的那一帧观测,只是轨迹末端的一个偶然视角,目标表面可能被遮挡,周围布局也可能缺乏足够空间上下文。为此 UniLM-Nav 在物体导航结束前维护一个短期记忆缓冲,保存最近 $K$ 步的观测与对应机器人状态:
$$\mathcal{M}_{t}=\{(o_{t-k},s_{t-k})\}_{k=0}^{K-1}$$
其中每条记录包含自我中心观测 $o_{t-k}$ 与给出机器人和相机位姿的状态 $s_{t-k}$,默认 $K=5$。为了让模型能明确指认候选帧,系统在每帧右下角叠加 0 到 4 的 ID 编号,再要求 MLLM 按两条准则选出唯一参考视角 $o_{\mathrm{sel}}$:目标物体或容器表面是否清晰可见;机器人是否存在可行的接近路径能走到足够近完成操作。模型以 JSON 形式返回一个 ID。附录的定性案例(图 3)展示了这一设计的价值:终止帧的接近路径被椅子挡住,而记忆里 $t-4$ 时刻的帧露出桌子左下方的空域,被选为参考视角。
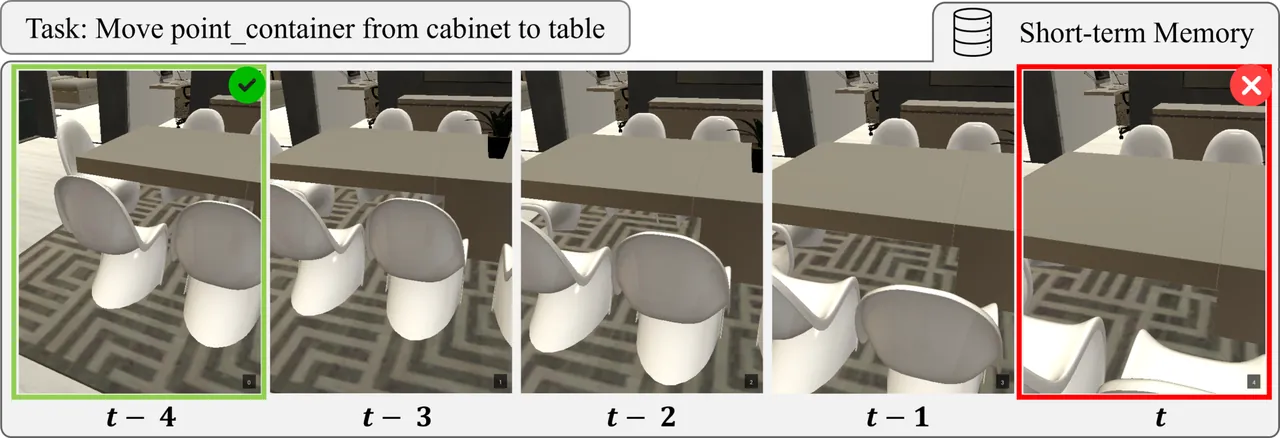
图 3:视角选择的定性案例。短期记忆 $\mathcal{M}_{t}$ 保存最近五帧;红框是物体导航终止帧(接近路径被椅子阻挡),绿框是 MLLM 选中的 $t-4$ 帧,为放置提供了更可靠的参考。
阶段二:任务条件化的 affordance 接地。选定参考视角后,系统要求 MLLM 把任务指令接地为图像空间的一个交互点,而不是物体框或物体中心:
$$(u,v)=\mathrm{MLLM}(o_{\mathrm{sel}},\mathcal{T})$$
抓取任务中,这个点应落在目标物体可抓握的区域;放置任务中,它应是容器表面上安全、空闲、远离边缘的放置位置。提示词对放置点给了三条硬约束:表面平整稳定、避开容器边缘以防跌落、周围有清晰空域保证基座与手臂可达。为了让输出与分辨率解耦,模型预测归一化坐标(严格落在开区间 0 到 1),再按图像宽高映射回像素;对 Qwen3-VL、RoboBrain-2.5 这类自带接地坐标约定的模型,则改用其原生 0 到 1000 坐标空间再缩放。这一步要求模型同时推理任务语义、物体语义、局部空间布局与操作约束,是"任务感知"而非"物体感知"的关键。
从 2D 到 3D:深度反投影。拿到 $(u,v)$ 后,系统用对齐的深度图与相机内参把该点提升为选中机器人位姿坐标系下的 3D affordance 点 $\mathbf{p}_{a}$,即标准针孔反投影 $\mathbf{p}_{a}=D(u,v)\,\mathbf{K}^{-1}(u,v,1)^{\top}$,其中 $D(u,v)$ 是该像素的深度、$\mathbf{K}$ 是内参矩阵。同时在选中观测上把该点标成红点,得到视觉提示后的观测 $\tilde{o}_{\mathrm{sel}}$。这一步是全文的设计枢纽:它把"视觉证据"转换成"显式度量",让下一阶段模型不必再从 2D 图像里隐式猜测距离与可达性。
阶段三:几何感知的基座位姿推理。最直接的做法是让 MLLM 在图像里直接点一个地板点作为基座位置,但那要求模型从单张 2D 图像推断度量距离、臂展可达性与局部可行性,正是当前 MLLM 的短板。UniLM-Nav 改为把显式几何量喂给模型:
$$(x,y)=\mathrm{MLLM}(\tilde{o}_{\mathrm{sel}},\mathbf{p}_{a},\mathcal{R},\mathcal{T})$$
输入包括带红点标记的观测、机器人构型 $\mathcal{R}$、任务指令与 3D 目标坐标,输出是以选中观测对应机器人位姿为原点的局部坐标系下的目标基座位置 $(x,y)$。提示词还写明了工程约束:基座应使目标落在最大臂展的 70% 到 80% 区间;机器人应面向目标;位姿与手臂设置必须避障。除位置外,模型还预测手臂伸展量 arm_reach 与抬升高度 arm_lift,二者构成 UniLM-Nav 的简易操作策略;抓取时提示词给出抬升高度的计算口径:目标高度加物体高度的一半,再加 0.2 米的夹爪余量。
朝向不给模型算。论文没有让 MLLM 预测航向角 $\theta$,而是用几何方式计算:让基座朝向提升后的 affordance 点,即 $\theta=\mathrm{atan2}(y_{a},x_{a})$ 形式的朝向闭合解(在选中位姿的局部系中)。对照实验(表 5)证明这个决定的分量:几何朝向在 20% 子集上 Overall SR 为 25.42%,而让 MLLM 直接预测朝向只有 17.08%,FindRec 相近的情况下总体成功率差了 8 个百分点以上——朝向是可以用几何锁死的自由度,没必要消耗模型的推理预算。
执行闭环。局部基座位姿经选中观测的机器人位姿变换到全局系,交给低层导航策略避障执行;真机部署用 ROS 2 的 Navigation2 栈。真机上还加了一步 affordance 精修:到达预测位姿后,由于里程计残差、深度噪声与标定误差,投影点可能在最终操作视角里错位,系统再查询一次 MLLM,用腕部相机当前图像修订操作目标(抓取点或放置点)。
为什么必须显式分解。附录的合并消融给出了答案:把视角选择与 affordance 接地合并成一次调用(五张图同时输入、同时输出 ID 与坐标),在 Gemini-3-Flash-Preview、Qwen3-VL-8B、Qwen3-VL-32B 三个后端上 Overall SR 分别下降 3.95、2.91、3.33 个百分点。两步对人类而言似乎可以一眼完成,但当前 MLLM 还无法在一次推理里同时做好"选图"与"精确定点"。去掉基座位姿推理、让模型直接点地板点的变体同样显著掉点(图 4 右侧的失败案例显示模型点出的位置常常贴着障碍或偏离正面)。分解不是工程洁癖,而是按模型能力切分责任边界。
flowchart TD
  A["物体导航结束: 目标进入 1-2 m 邻域"] --> B["短期记忆 M_t: 最近 K=5 帧观测 + 机器人状态"]
  B --> C["阶段1 视角选择: MLLM 按可见性+可接近性返回参考视角 ID"]
  C --> D["阶段2 affordance 接地: MLLM 输出归一化交互点 (u,v)"]
  D --> E["深度反投影: (u,v) 提升为机器人系 3D 点 p_a 并在图上标红点"]
  E --> F["阶段3 基座位姿推理: MLLM 条件于 p_a, R, T 给出 (x,y) 与 arm_reach, arm_lift"]
  F --> G["几何朝向: 基座面向 p_a, theta 由几何计算而非模型预测"]
  G --> H["变换到全局系: 低层导航避障驱动到目标位姿"]
  H --> I["执行操作: 按预测伸展与抬升完成抓取或放置"]
实验结果
OVMM 主结果。在 HomeRobot OVMM 验证集上,以 Gemini-3-Flash-Preview 为后端的 UniLM-Nav 取得 23.77% 的 Overall SR,比此前最强的零样本方法 MoTo(20.64%)高 3.13 个百分点,也超过需要训练的 MoManipVLA(15.80%)与 HomeRobot 的 RL(14.80%)、启发式(7.30%)版本;Average SR 53.50% 同样是全场最高。值得注意的是 FindObj 一列:UniLM-Nav 的 69.47% 高于所有基线,说明最后一米策略反过来让"接近目标"这件事更可靠——选视角与站位推理改善了导航终止后的态势。换成 4B 量级的 RoboBrain-2.5-4B 后端仍有 19.19% 的 Overall SR,高于除 MoTo 外的全部基线,给出了部署性与性能的实用折中。
| 方法 | FindObj | Pick | FindRec | Overall SR | Average SR |
|---|---|---|---|---|---|
| HomeRobot (RL) | 66.60% | 61.10% | 50.90% | 14.80% | 48.30% |
| HomeRobot (Heuristic) | 65.40% | 54.80% | 43.70% | 7.30% | 42.80% |
| MoManipVLA | 66.10% | 62.60% | 53.10% | 15.80% | 49.40% |
| UniTeam | 66.13% | 62.65% | 54.69% | 17.96% | 50.36% |
| MoTo | 66.67% | 60.95% | 49.87% | 20.64% | 49.53% |
| UniLM-Nav (Gemini-3-Flash-Preview) | 69.47% | 66.22% | 54.55% | 23.77% | 53.50% |
| UniLM-Nav (RoboBrain-2.5-4B) | 68.97% | 63.05% | 52.38% | 19.19% | 50.90% |
后端选择: embodied 数据比参数规模更值钱。在 20% 场景分层子集上横向比较 13 个后端,差异几乎全部集中在 FindRec 之后的放置阶段:各后端 FindObj 都在 66% 到 69% 之间,而 Overall SR 从 Qwen3-VL-4B 的 3.75% 一路 spread 到 Gemini-3-Flash-Preview 的 25.42%。Qwen3-VL 家族内部呈现清晰的规模效应(4B 3.75%、8B 9.58%、32B 15.83%),但同架构的 RoboBrain-2.5-4B 用机器人导向的具身空间推理数据微调后达到 20.50%,不仅远超同尺寸基座,还压过了大两个数量级的 Qwen3-VL-235B-A22B-Instruct(17.50%)。对机器人栈来说,这是一条比"换更大的模型"更便宜的升级路径。
| MLLM 后端(20% 子集) | FindObj | Pick | FindRec | Overall SR | Average SR |
|---|---|---|---|---|---|
| GPT-5.4 | 68.33% | 66.25% | 55.00% | 19.17% | 52.19% |
| Gemini-3-Flash-Preview | 67.91% | 65.83% | 54.58% | 25.42% | 53.43% |
| Qwen3-VL-4B-Instruct | 68.33% | 61.25% | 50.42% | 3.75% | 45.93% |
| Qwen3-VL-32B-Instruct | 67.92% | 62.08% | 52.08% | 15.83% | 49.48% |
| Qwen3-VL-235B-A22B-Instruct | 67.92% | 59.58% | 48.33% | 17.50% | 48.33% |
| RoboBrain-2.5-4B | 67.36% | 60.67% | 51.05% | 20.50% | 49.90% |
组件消融:每个阶段都在还债。去掉最后一米导航(只转向面对 affordance 点就直接操作),Overall SR 跌到 5% 以下——即使目标可见,"站对位置"也绝不是可有可无的修饰;去掉视角选择,从 25.42% 降到 20.42%;去掉基座位姿推理改为直接点地板点,Pick 与 Overall 显著下滑。思考模型消融进一步揭示了阶段异构性:只在基座位推理一处把 Qwen3-VL-8B-Instruct 换成 Thinking 变体,Overall SR 从 9.58% 跳到 20.83%;而在 affordance 接地处换思考模型反而降到 5.83%,给 instruct 模型加显式 CoT 提示也只有 9.17%。推理预算该花在需要空间推演的阶段,感知型阶段加了反而干扰。
| 朝向策略(20% 子集,Gemini 后端) | FindObj | Pick | FindRec | Overall SR | Average SR |
|---|---|---|---|---|---|
| 几何计算朝向(面向提升后的 affordance) | 67.91% | 65.83% | 54.58% | 25.42% | 53.43% |
| MLLM 直接预测朝向 | 67.50% | 63.33% | 52.92% | 17.08% | 50.21% |
| 三组件模型配置(view / grounding / pose) | FindObj | Pick | FindRec | Overall SR | Average SR |
|---|---|---|---|---|---|
| Instruct / Instruct / Instruct | 68.75% | 60.00% | 47.92% | 9.58% | 46.56% |
| Thinking / Instruct / Instruct | 67.92% | 61.67% | 50.00% | 10.00% | 47.40% |
| Instruct / Thinking / Instruct | 67.92% | 55.83% | 45.83% | 5.83% | 43.85% |
| Instruct / Instruct / Thinking | 69.17% | 62.92% | 52.50% | 20.83% | 51.35% |
| Instruct / Instruct / Instruct + CoT 提示 | 69.17% | 60.00% | 50.00% | 9.17% | 47.08% |
错误分析:瓶颈在最后一米之外,也在最后一米之内。对 20% 子集失败回合的人工归类显示,导航错误占 61.0%(找不到物体、找不到容器、或导航到语义正确但物理上够不着的容器),操作错误占 18.1%(释放高度过高、或放置后残余运动不满足基准的稳定阈值),最后一米导航占 20.9%。后者内部又以 affordance 接地错误最多(点落在容器边缘导致放置不稳),其次是视角选择错误(选中视角的接近路径被椅子挡住)与基座位姿错误(位姿贴侧墙、手臂工作空间受限)。这组数字既说明物体导航仍是 OVMM 的最大瓶颈,也说明三阶段各自的可靠性都有独立改进空间。
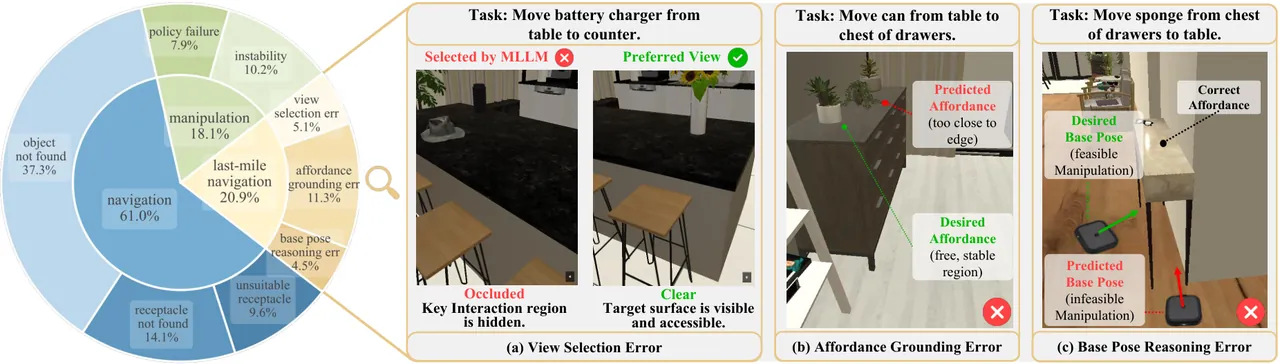
图 4:左为失败回合的人工归类(导航 61.0%、最后一米 20.9%、操作 18.1%);右为三类最后一米失败案例,绿色为期望的视角/区域/位姿,红色为模型的错误预测。
真机实验:四足加六自由度臂上的闭环验证。作者把 UniLM-Nav 部署到宇树 B2 四足机器人加 6-DoF 宇树 Z1 机械臂的平台上:官方两指夹爪被替换为集成 Orbbec Gemini 335 RGB-D 相机的自研 3D 打印平行夹爪(eye-in-hand),机载激光雷达跑 LIO-SAM 做占用地图与里程计,Navigation2 执行最后一米位移。四个任务各重复 10 次:从桌上取杯 7/10、把蛋糕放到盘里 6/10、把水瓶放到显示器前 4/10、"想象面对显示器,把蛋糕放在桌子左下角" 4/10,总成功率 52.5%。前两个任务验证交接链路在真实场景可用,后两个需要解析"显示器前面""桌子左下角"这类细粒度空间关系的任务成功率明显更低,与仿真里"放置阶段是模型短板"的观察一致。
| 从桌上取杯 | 蛋糕放盘里 | 水瓶放显示器前 | 蛋糕放桌子左下角 | 总成功率 |
|---|---|---|---|---|
| 7/10 | 6/10 | 4/10 | 4/10 | 52.5% |
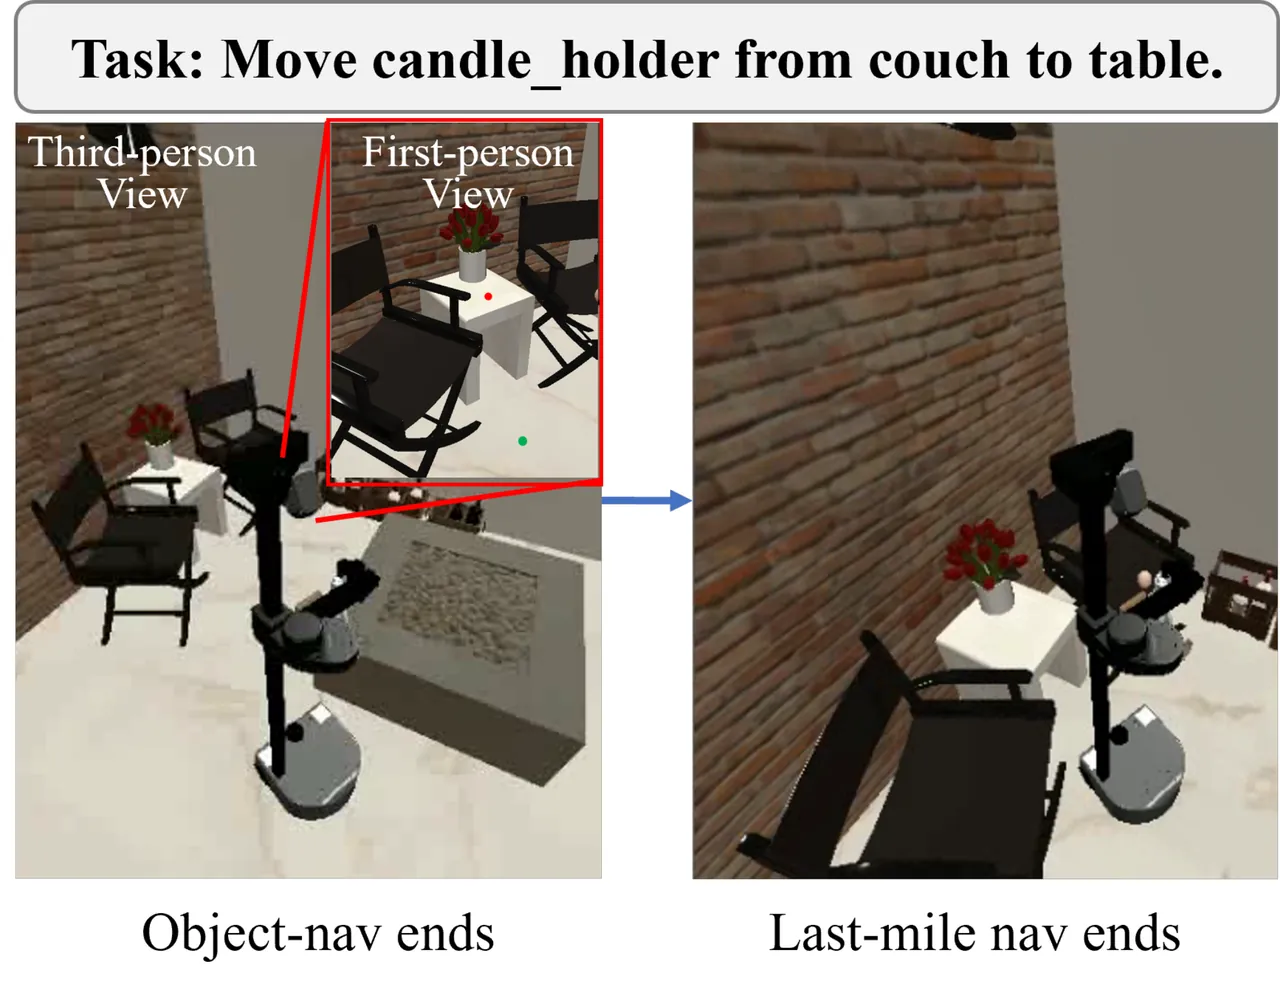
图 5:OVMM 成功案例。物体导航结束时(中)机器人被椅子与沙发夹住,最后一米导航结束后(右)基座调整到面向桌面的可操作位姿,红点为接地 affordance、绿点为预测基座位置。
局限性
作者自述的局限有三:其一,框架假设物体导航能把机器人带到目标出现在近期观测的近目标状态,不具备主动局部探索能力,作者计划在未来工作中放松这一假设;其二,视角选择、affordance 接地与基座位姿推理仍存在决策错误(图 4 的失败案例),计划用更强的提示与复核机制改进;其三,评测目前集中在 OVMM 与一个办公环境,泛化性需要更多基准验证。
我们的补充判断:第一,23.77% 的 Overall SR 虽是 SOTA,但绝对值仍然很低,放置阶段的可靠性是整条链路的天花板,最后一米导航改善的是交接而非操作本身;第二,每个回合至少三次 MLLM 调用(真机再加一次腕视精修),在闭环控制里意味着秒级延迟与按 token 计的成本,论文未报告端到端时延,部署者需要自行评估;第三,3D 提升的精度继承深度噪声与标定误差,真机靠额外精修回合补救,说明该环节对传感器质量敏感;第四,arm_reach 与 arm_lift 两个标量构成的操作策略只覆盖"伸多远、抬多高",对需要姿态规划的复杂操作并不够用,框架的受益边界止于基座交接。
总结与展望
UniLM-Nav 的贡献不在某个新模型,而在一份清晰的分工蓝图:语义与空间关系交给 MLLM,度量几何交给确定性代码,每个子决策都被切成模型擅长回答的形式。视角选择解决了"用哪只眼睛看",任务条件化接地解决了"看哪里",深度反投影加几何朝向解决了"哪些量不该让模型猜"。OVMM 上的零样本 SOTA、13 个后端的横向对照、以及四足真机上的闭环验证,共同支撑了"MLLM 可以作为最后一米的视觉空间推理器"这一命题;RoboBrain-2.5-4B 超过 235B 通用模型的结果,则把下一步的方向指向具身空间数据的微调而非单纯的模型扩容。
展望层面,主动探索接入最后一米之前、三阶段决策的复核与自纠错、更多基准与更长程任务的评测,是作者列出的路线;从系统角度看,把本框架的显式几何接口(3D affordance、朝向闭合解)沉淀为移动操作栈的标准中间表示,让不同 MLLM 后端即插即用,可能是比论文本身更长久的遗产。
金句
走到目标附近只是操作的入场券,真正决定成败的最后一米,藏在基座位姿里。