PAPER DEEP DIVE
智能体元推理:把运行控制做成独立推理过程
Meta 提出智能体元推理运行框架:控制器按评估、提议、估值、派发四个阶段决定下一步计算,只保留紧凑状态并按需读取持久记忆。ProgramBench 上搭配 GPT-5.5 达到 71.5%,同模型的 Codex 为 58.0%。
论文信息:Paras Dahal、Anton Bakhtin、Taco Cohen、Zhengxing Chen、Carole-Jean Wu、Rob Fergus、Scott Yih、Gabriel Synnaeve、Ruslan Salakhutdinov、Sanjeev Arora、Jason Weston、Anirudh Goyal,全部来自 Meta Superintelligence Labs。论文于 2026 年 9 月 29 日发布,arXiv 地址为 https://arxiv.org/abs/2609.38147。代码状态:本文未提供公开代码,但附录完整给出了四个控制阶段、对照智能体与工作者的提示词以及全部工具定义,足以按图复现运行框架的骨架。
一句话总结:本文提出智能体元推理,一种推理期运行框架,让控制器以“评估、提议、估值、派发”四个独立的智能体阶段决定下一步计算,只在轮次之间保留一份紧凑状态,完整工作产物放进可按需读取的持久记忆;在同模型、同调用预算下,它在全部 12 组配对比较中胜过直接控制,在 ProgramBench 上搭配 GPT-5.5 达到 71.5%,同模型的 Codex 为 58.0%。
研究背景与动机
语言模型智能体在单个问题上消耗的模型调用越来越多,其中相当一部分调用并不是在推进任务本身,而是在决定接下来做什么。论文用一个证明题的例子说明这一点:智能体手里有一份主干论证看似成立、但核心引理尚未验证的候选证明。它可以去证这个引理,可以派第二个工作者复核现有论证,也可以放弃这条路线另起炉灶。每个选项都要花计算,选错的那部分计算可能全部浪费。对一个自主朝目标推进的智能体而言,这个选择本身就是解题的一部分,而且是一种与“写出证明的下一步”不同的能力。
作者把这个问题归入元认知控制:评估自身进展,并据此决定下一步行动。在单次模型调用里,被控制的对象是思维链;在智能体里,被控制的对象是这次运行已经产出的全部工作,智能体必须决定信任哪些结果、在什么基础上继续、何时停止。控制判断出错的代价不止是它消耗的那部分计算:一个错误判断可能让失败的路线在后续运行中一直存活,也可能把已经找到的正确答案丢掉。
现有智能体通常把这类控制决策与任务层面的工作交织在一起,在不断增长的历史记录上一步完成每个控制决策。ReAct、Reflexion、HuggingGPT、MemGPT 以及递归语言模型都属于这种范式。当任务产生的中间工件越来越多,智能体决策所依据的上下文也越来越嘈杂,而控制决策恰恰最依赖于对全局进展的准确把握。
论文的核心主张是:这些控制决策应当拥有一个属于自己的智能体推理过程。智能体在落子之前可以先审议、先调查,例如回读一份早先的结果,或者派一个工作者去核验。这种审议本身有结构:整合这次运行已经确立的事实,探索接下来可以做什么,评估每个选项在剩余预算下值多少。作者称之为智能体元推理,即智能体对自身推理过程进行推理并采取行动。
与这条路线相邻的工作有三类。第一类是固定结构的推理期计算,如思维链、自洽采样、自我修正、思维树与思维图,它们在问题揭示出需要什么样的工作之前,就预先固定了采样数、分支数或修正轮数。第二类是学习或优化编排系统本身,如 GPTSwarm、Meta-Harness、Conductor 以及自动合成运行框架的工作。本文不训练新的编排模型,也不在任务专属的运行框架空间里搜索,而是把控制机制单独拎出来,组织成一个独立的智能体过程。第三类是元认知控制与记忆管理研究,本文与它们的区别在于被控制的对象:不是单条推理链、某个工具触发器或停止规则,而是一个不断增长、建立在持久工件之上的外部计算。
预备概念:工件、记忆与工作者接口
工件是工作者或控制器产出并被存储下来的一份输出,一次尝试、一份批评、控制器自己写的一条笔记都算工件。每个工件带有稳定标识符,格式是“轮次_序号”,例如 2_1 表示第三轮的第二个工作者。对任务 $x$,记第 $t$ 个控制周期可用的工件集合为 $M_t$。
工作者接收三样东西:任务本身、控制器写的指令 $g$,以及控制器认为本次指派必需的一组工件作为上下文 $C\subseteq M_t$。记工作者执行为 $W$、返回的工件为 $y$:
$$y=W(x,g,C)$$
论文特别说明这是一个接口而非纯函数。编码工作者可能读取 $C$ 之外的文件、修改环境,输出也带有随机性。工作者看不到控制器的私有状态和审议过程,只看到给它的指令和工件。附录里的工件记忆设计也呼应了这一点:控制器每个阶段看到的记忆只是“标识符 + 标题”组成的索引,正文需要调用 read_memory 才能取回;而工作者收到的工件默认不带标识符,无法按名字反向引用。
方法详解
一、控制器能做的四类动作
控制器可以检查已存工作、记录自己的笔记、启动工作者,或者带着答案停止。前两类是读与写:对标识符集合 $I$,$\mathrm{Read}(I)$ 取回对应工件;对新内容 $u$,$\mathrm{Write}(u)$ 以新标识符存入。论文借用 Kirsh 与 Maglio 的术语称之为认识性动作:控制器给自己留笔记,在对任务动手之前先整理自己知道什么。例如一条笔记可以提醒“之前某份证明用了一个不成立的假设”。
第三类是启动一批 $k$ 个并行工作者,每个工作者各有指令 $g_i$ 与上下文 $C_i$,对同一任务 $x$ 重复应用工作者接口:
$$\mathrm{RunWorkers}\left(\{(g_i,C_i)\}_{i=1}^{k}\right)=\left\{W(x,g_i,C_i)\right\}_{i=1}^{k}$$
返回的工件连同其输入工件的标识符一起写入记忆。同一个接口既能发起全新尝试,也能做定向修补,或者综合多份早期结果;工作者没有固定角色,工作的性质完全由指令与上下文决定。第四类动作是 $\mathrm{Stop}(y^{\star})$,其中 $y^{\star}$ 必须是记忆中已经存在的工件。它不必是最新输出,但不能是新写的:要提交一个新答案,控制器必须先让工作者把它生产出来。这一约束在工具定义里体现得很直接,元推理智能体的 finish 只接受 memory_id,而对照组的 finish 直接接受答案文本。
二、控制周期的四个阶段
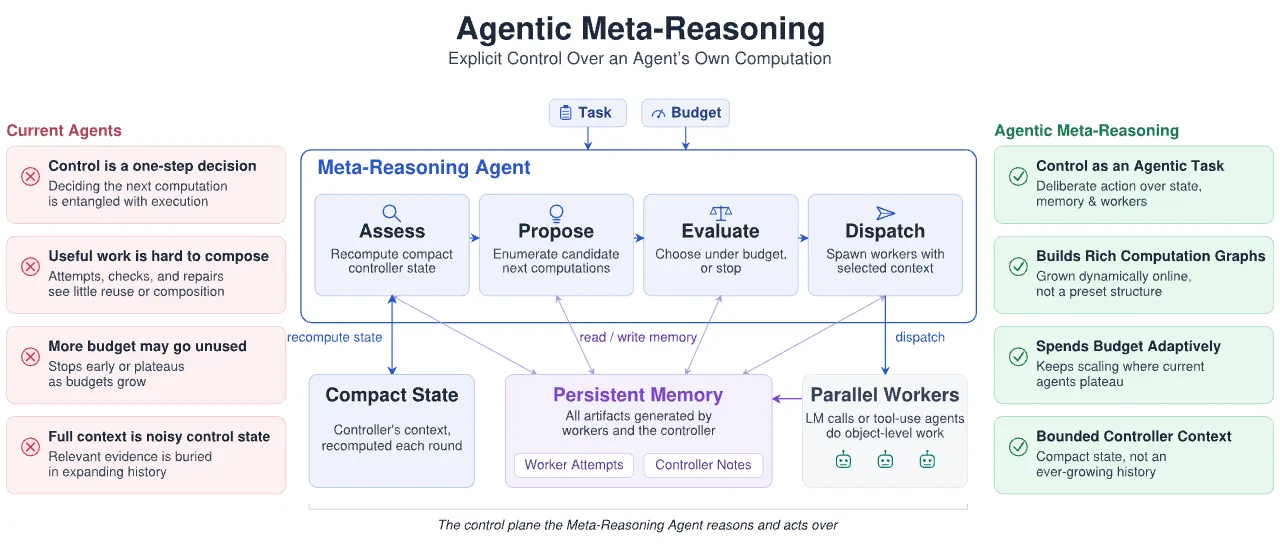
每个控制周期依次运行评估(Assess)、提议(Propose)、估值(Evaluate)、派发(Dispatch)四个阶段。每个阶段都是一个完整的智能体循环,有自己的系统提示、上下文和允许使用的记忆操作,单个阶段内部可以进行多次调查和审议,因此可能消耗多次模型调用。周期之间只持久化一份紧凑状态,各阶段需要时再去记忆里取回早期工件。
评估:我们学到了什么。工作者返回后,控制器更新对这次运行的描述。记上一轮评估为 $s_{t-1}$、上一批工作者新产生的工件为 $\Delta M_t$:
$$s_t=\mathrm{Assess}(x,s_{t-1},\Delta M_t;M_t)$$
分号表示可以访问持久记忆,而不是把记忆全部塞进提示。附录给出的文本任务提示要求对每个新候选给出三选一判定:可能正确、存在缺口、根本错误,并输出“停止或继续”的建议,且明确要求默认继续,理由是工作者常对含有细微错误的候选自评为高置信。编程任务的评估阶段则完全不同:它维护一份带引用的事实快照,分为已实现、已损坏、未验证、未探索、死路五个栏目,每条事实必须引用记忆标识符或提交哈希,“工作者的文字声明不等于事实”。
提议:接下来可以做什么。提议阶段基于当前评估列出候选计算:
$$\mathcal{A}_t=\mathrm{Propose}(x,s_t;M_t)$$
这里有一个刻意的设计:提议阶段拿不到剩余预算。把“生成备选”与“判断是否负担得起”分开,昂贵但可能有价值的选项才不会在生成阶段就被自我过滤掉。提示词也直接要求“广泛思考,不要只列少数稳妥选项”。
估值:哪个选项值得它的成本。估值阶段是四个阶段中唯一能看到预算的。记估值开始时(已扣除此前调用)的剩余预算为 $b_t^{\mathrm{eval}}$,被选中的提议为:
$$\tilde{a}_t=\mathrm{Evaluate}(x,s_t,b_t^{\mathrm{eval}},\mathcal{A}_t;M_t)$$
作者强调这是一种提示驱动的定性计算价值评估,而不是精确优化或学习得到的计算价值估计器。提示要求对每个动作给出高、中、低三档价值,并用 YAML 输出推荐动作、要传给工作者的记忆标识符和并行工作者数量;同时提醒“每轮审议本身固定消耗 4 次调用”。停止的门槛很高:必须同时满足存在被评估阶段判为可能正确且无未决问题的候选、所有提议动作都是低价值、并且“愿意拿整次运行押注这个候选”。
派发:工作者应该收到什么。派发阶段把选中的提议变成可执行动作:
$$a_t=\mathrm{Dispatch}(x,s_t,\tilde{a}_t;M_t)$$
对引理核验,它写出核验指令,并从记忆中挑出证明本身和相关批评一起交给工作者;对全新尝试,可能一个工件都不给。论文把“工作者看到哪些工件”视为选择计算的一部分。编程任务的派发提示里有一段很实用的经验:工作者看不到审议输出,只能看到自己的指令字符串,所以指令必须自洽、可执行,至少 200 到 500 字符,写明文件、参数和成功标准;只传一个动作标识符是“派发阶段最大的单一失败模式”。
flowchart TD
    T[任务 x 与调用预算 B] --> AS[评估 Assess 重写紧凑状态 s_t]
    AS --> PR[提议 Propose 列出候选计算 A_t 不看预算]
    PR --> EV[估值 Evaluate 按剩余预算定级 唯一看到预算的阶段]
    EV --> DI[派发 Dispatch 写指令并挑选工件上下文]
    DI -->|启动并行工作者| W[工作者 单次调用或编码智能体]
    DI -->|停止并选定已有工件| OUT[提交记忆中的最终答案]
    W -->|新工件 delta M_t| MEM[持久工件记忆 M_t 索引只含标识符与标题]
    MEM -->|read_memory 按需取回| PR
    MEM -->|read_memory 按需取回| EV
    AS -->|write_memory 记笔记| MEM
    W -->|新工件全文进入下一轮| AS
图 1:智能体元推理的控制周期。四个阶段各自是独立的智能体循环,周期之间只传递紧凑状态,完整工作产物留在持久记忆中。根据论文第 3 节与附录 B、E 绘制。
图 2:现有智能体把控制与任务层工作交织在一起;智能体元推理把控制做成一个基于紧凑状态、持久记忆和工作者的独立推理过程。图源:论文 Figure 1。
三、工件图:把一次运行变成可诊断的对象
派发阶段为每个工作者选定的上下文工件,天然记录了后续工作如何建立在早期工作之上。工作者拿到一份证明、返回一份批评,图中就有一条从证明指向批评的边;一次同时拿到两者的修补,就有两条入边。记工件图为 $G=(V,E)$,工件 $y_j$ 的上下文为 $C_j$,则:
$$E=\{(y_i,y_j)\in V\times V:\ y_i\in C_j\}$$
由于输入工件在工作者启动前已经存在,这些边构成有向无环图。根节点是不依赖任何工件的工作,分支表示多个后续,多条入边表示一个工作者综合了多个来源。作者也承认,这张图只记录控制器生成的依赖,并不一定捕获所有信息通道,例如编码工作者可以直接读到共享文件系统里别人写的代码。
四、直接控制对照与预算记账
为了隔离控制设计本身的作用,论文构造了直接控制智能体:使用同样的工作者,以及同样的委派、上下文选择、写工件和停止接口,但没有显式的控制分离,每个动作在一次调用中、基于不断累积的完整历史做出。两者拿到同样的名义调用预算 $B$。记第 $t$ 周期开始时剩余预算为 $b_t$,本周期消耗 $c_t$ 次控制器调用与 $w_t$ 次工作者调用:
$$b_{t+1}=b_t-c_t-w_t,\qquad b_0=B$$
工作者成本包括编码智能体内部的每次调用,并行工作者的调用逐个累加;控制器成本包括四个阶段内的每一次调用。预算在控制周期之间强制执行,因此周期开始时仍在预算内派出的工作者会跑完,总调用可能略超名义预算。作者明确提醒:相同调用数不等于相同令牌数、延迟或浮点运算量,花得多也不天然更好。
五、诊断指标:覆盖、监控与选择
最终得分无法区分两种失败:一种是运行中从来没有出现正确答案,另一种是正确答案已经躺在记忆里,控制器却提交了一份有缺陷的修订版。论文用中间工件的正确性标签把它们拆开。记 $\mathcal{C}$ 为运行中包含正确解,$\mathcal{S}$ 为提交正确,由于正确的提交必然来自运行中的解,有 $\mathcal{S}\subseteq\mathcal{C}$,于是:
$$\Pr(\mathcal{S})=\Pr(\mathcal{C})\,\Pr(\mathcal{S}\mid\mathcal{C})$$
前一项称为覆盖,后一项称为选择。覆盖可以沿运行过程追踪:记 $V_{\mathrm{sol},\leq k}$ 为前 $k$ 次调用内可用的解工件,$\mathrm{Coverage}(k)=\Pr\left(\exists y\in V_{\mathrm{sol},\leq k}:\ell(y)=1\right)$,它就是一个完美选择器在已有答案上能达到的成功率。监控能力用二型 AUC 衡量:从评估过的工件中各抽一个正确候选 $Y^{+}$ 与错误候选 $Y^{-}$,看置信信号 $r$ 能否把它们排对,平局记半分:
$$\mathrm{AUC}_2(r)=\Pr\left(r(Y^{+})>r(Y^{-})\right)+\tfrac{1}{2}\Pr\left(r(Y^{+})=r(Y^{-})\right)$$
它只衡量区分度,不衡量校准。最后是选择是否优于结构基线。论文定义收敛前沿 $F(G)$ 为终端节点中深度最大的那些工件,前沿上均匀随机选一个的正确率为 $q_F(G)$,前沿选择增益为:
$$\mathrm{FSG}=\mathbb{E}\left[\ell(y^{\star})-q_F(G)\mid\mathcal{C}\right]$$
正增益说明智能体的最终选择好于从自己的前沿里随机挑。这套拆解的实际价值在于指向不同的改进方向:覆盖受限的失败需要改进探索或任务层解题能力,选择受限的失败需要改进评估、核验与提交决策。
实验设置
论文在两种设定下评测。三个推理基准中,工作者是一次不带工具、返回文本工件的模型调用:IMO ProofBench-Advanced 有 30 道高难证明题,按 0、1、6、7 分制评分后折算成百分比;ARC-AGI-2 有 120 个抽象视觉推理任务,输出网格精确匹配才算对;LongCoT-mini 是 507 道长程推理题,横跨逻辑、计算机、化学、国际象棋和数学,难点在于跨很多步追踪状态而不丢约束。编程基准 ProgramBench 有 200 个长程程序重建任务:给定文档和一个只能执行的参考程序,智能体必须从零写出一个代码库,使编译出的可执行文件在隐藏测试上与参考程序行为一致,得分是每题测试通过率的平均值。
三个底层模型是 Gemini 3.1 Pro、GPT-5.5 与 Opus 4.8。推理基准的名义预算为 25、50、100 次调用,ProgramBench 为 400、800、1200 次,主比较取最大预算。外部基线包括递归语言模型(推理基准)以及 mini-SWE Agent、Claude Code、Codex 三个完整编码智能体(ProgramBench)。所有系统都被告知已用与剩余预算,都可以提前停止;外部基线本身没有调用预算概念,作者为它们补上了同样的记账与提示。
实验结果
主结果:12 组配对比较全部领先
| 模型 | 系统 | IMO ProofBench-Adv | ARC-AGI-2 | LongCoT-mini | ProgramBench |
|---|---|---|---|---|---|
| Gemini 3.1 Pro | 递归语言模型 | 73.3 | 76.7 | 46.5 | – |
| mini-SWE Agent | – | – | – | 42.0 | |
| 直接控制 | 82.7 | 77.5 | 53.5 | 46.9 | |
| 元推理 | 91.3 | 84.2 | 62.7 | 48.7 | |
| GPT-5.5 | 递归语言模型 | 86.2 | 73.3 | 63.3 | – |
| mini-SWE Agent | – | – | – | 57.6 | |
| Codex | – | – | – | 58.0 | |
| 直接控制 | 93.3 | 75.8 | 64.7 | 63.7 | |
| 元推理 | 94.6 | 79.2 | 65.1 | 71.5 | |
| Opus 4.8 | 递归语言模型 | 68.1 | 66.7 | 64.3* | – |
| mini-SWE Agent | – | – | – | 64.7 | |
| Claude Code | – | – | – | 65.5 | |
| 直接控制 | 78.0 | 77.5 | 65.3 | 65.3 | |
| 元推理 | 80.2 | 80.0 | 66.5 | 67.2 |
表 1:主预算下的性能(%),推理基准 100 次调用、ProgramBench 1200 次调用,均含控制器调用。星号表示该格递归语言模型使用完整 Python 工作区。数据来源:论文 Table 1。
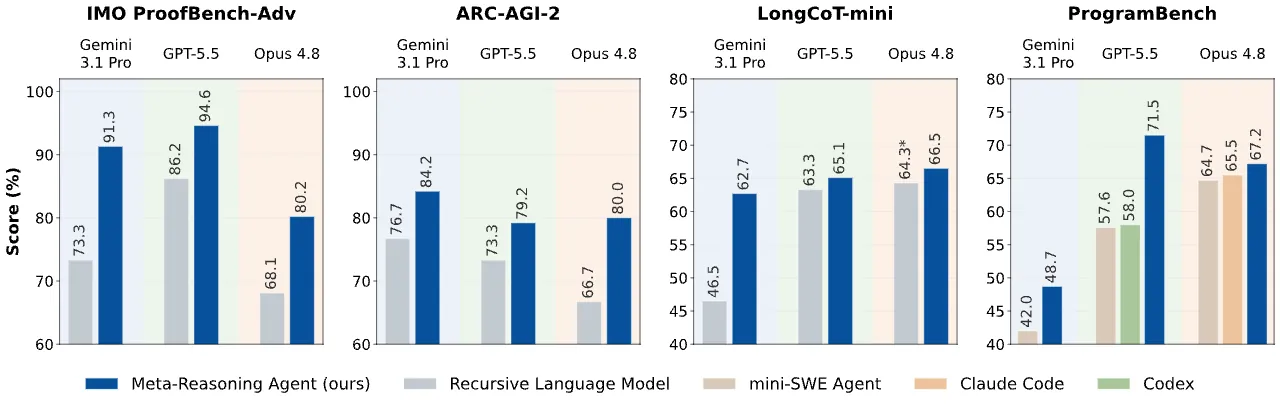
主结果最有说服力的部分是与直接控制的配对比较:模型、工作者、接口和预算全部相同,只有控制方式不同,元推理在全部 12 组组合里点估计都更高。把表 1 逐格相减,可以得到每个基准上的提升幅度及其在模型间的分布:
| 基准 | Gemini 3.1 Pro | GPT-5.5 | Opus 4.8 | 三模型平均 |
|---|---|---|---|---|
| IMO ProofBench-Adv | +8.6 | +1.3 | +2.2 | +4.0 |
| ARC-AGI-2 | +6.7 | +3.4 | +2.5 | +4.2 |
| LongCoT-mini | +9.2 | +0.4 | +1.2 | +3.6 |
| ProgramBench | +1.8 | +7.8 | +1.9 | +3.8 |
表 2:元推理相对直接控制的提升(百分点),由表 1 逐格计算,三个推理基准的平均值与论文正文一致。
表 2 揭示了两个规律。第一,增益高度依赖模型:Gemini 3.1 Pro 在推理基准上收益最大(LongCoT-mini 上 9.2 分是全文最大的单格提升),GPT-5.5 主要在 ProgramBench 上受益,Opus 4.8 的增益较小但在所有任务上一致为正。第二,ARC-AGI-2 是最稳定的基准,三个模型的提升都在 2.5 到 6.7 分之间;LongCoT-mini 方差最大,从 0.4 分到 9.2 分。
与生产级编码智能体的比较是读者最关心的数字。ProgramBench 上,元推理搭配 GPT-5.5 达到 71.5%,同模型的 Codex 为 58.0%,差距 13.5 分;搭配 Opus 4.8 达到 67.2%,同模型的 Claude Code 为 65.5%。它在三个模型上都超过 mini-SWE Agent,幅度 2.5 到 13.9 分。论文自己也提醒,这些外部比较只是端到端参照点,真正检验控制方式作用的是与直接控制的配对比较。
图 3:四个基准、三个模型上元推理与外部研究型运行框架、生产级编码智能体的对比。图源:论文 Figure 2。
预算放大后继续提升,直接控制则趋于平台
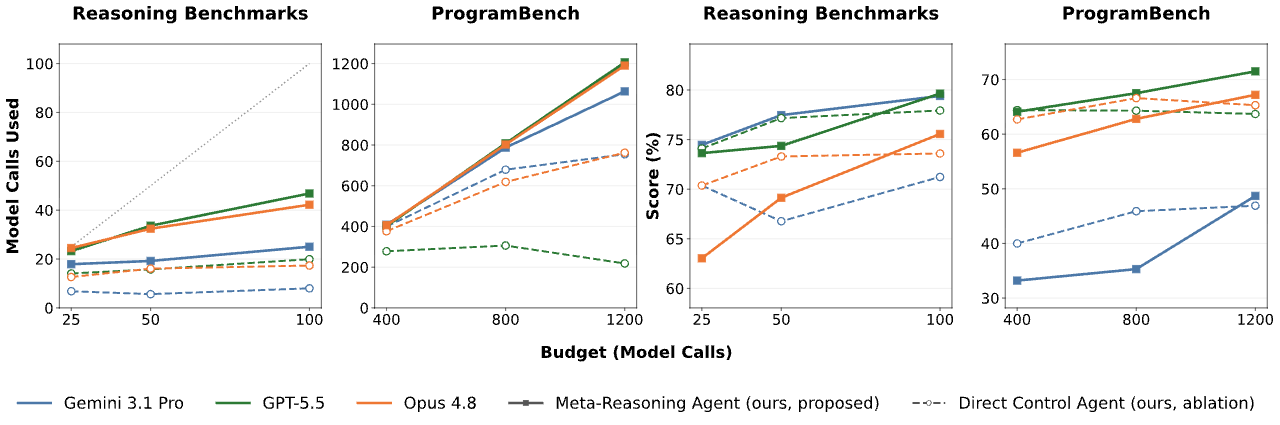
更大的预算只有在智能体找到有用的花法时才有意义。图 4 左侧是实际消耗的调用数,右侧是最终得分。元推理会随预算增长而花更多调用:ProgramBench 上 1200 次预算时,三个模型的实际使用率在 89% 到 101% 之间;直接控制则常常提前停止,GPT-5.5 只用了约 18%。
花得多也确实换来了更好的答案。ProgramBench 预算从 400 增至 1200 次时,元推理搭配 GPT-5.5 从 64.1% 升到 71.5%,直接控制一直在 64% 附近。提前停止并不是全部解释:Opus 4.8 上的直接控制在扫描范围内把实际调用从 376 次翻倍到 768 次,得分却只从 62.7% 升到 65.3%,而且峰值出现在中间预算。继续干活还不够,接下来干什么同样重要。
元推理也不是在每个预算下都赢。Opus 4.8 在 400 次预算时落后于直接控制,56.6% 对 62.7%,到 1200 次时反超,67.2% 对 65.3%;GPT-5.5 在最小预算下同样略微落后。作者的解释是分阶段控制有固定开销,需要足够的预算才能回本,这与每轮审议固定消耗 4 次调用的设计一致。
图 4:名义预算增长时的实际调用消耗(左,对角线表示用满预算)与最终得分(右)。推理基准为三个基准的汇总,ProgramBench 单列。图源:论文 Figure 3。
额外预算产出了什么样的计算
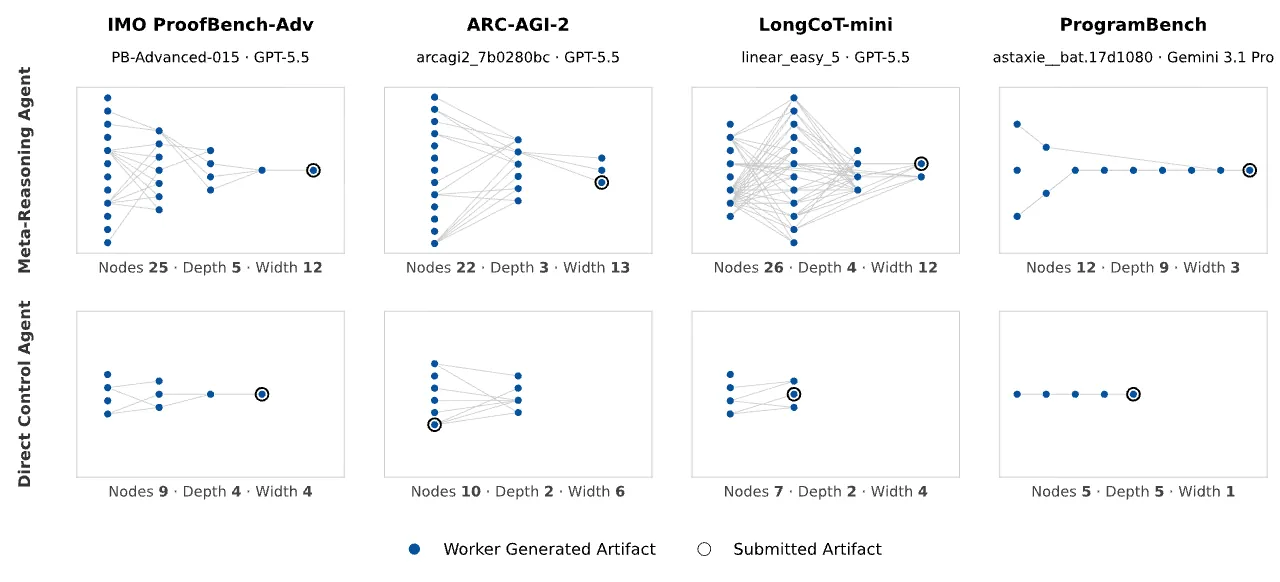
在主预算下,元推理在三个推理基准上都产出更多工作者工件,而工件之间的复用增长得更快。以 Gemini 3.1 Pro 的 IMO ProofBench-Advanced 为例,工作者工件大约翻倍,记录到的依赖边却增加了一个数量级。两个智能体通过同一个接口选择上下文工件,直接控制完全可以搭出同样的图,但它基本没有这样做。
图规模也随预算增长。ProgramBench 上 GPT-5.5 的预算从 400 增至 1200 次,节点数增加到 2.5 倍以上,边数接近 4 倍;直接控制的图没有类似增长。图 6 的配对示例更直观:在一个 ARC-AGI-2 问题上,直接控制生成了 6 个独立尝试和 4 个一跳后续,元推理则探索了更多独立尝试,把后续工作连到早期结果上,最终收敛到 3 个候选组成的前沿,在同一次运行中兼顾了探索与复用。
图 5:ProgramBench 上不同预算下的工作者工件拓扑,包括节点数、边数、深度与宽度。图源:论文 Figure 4。
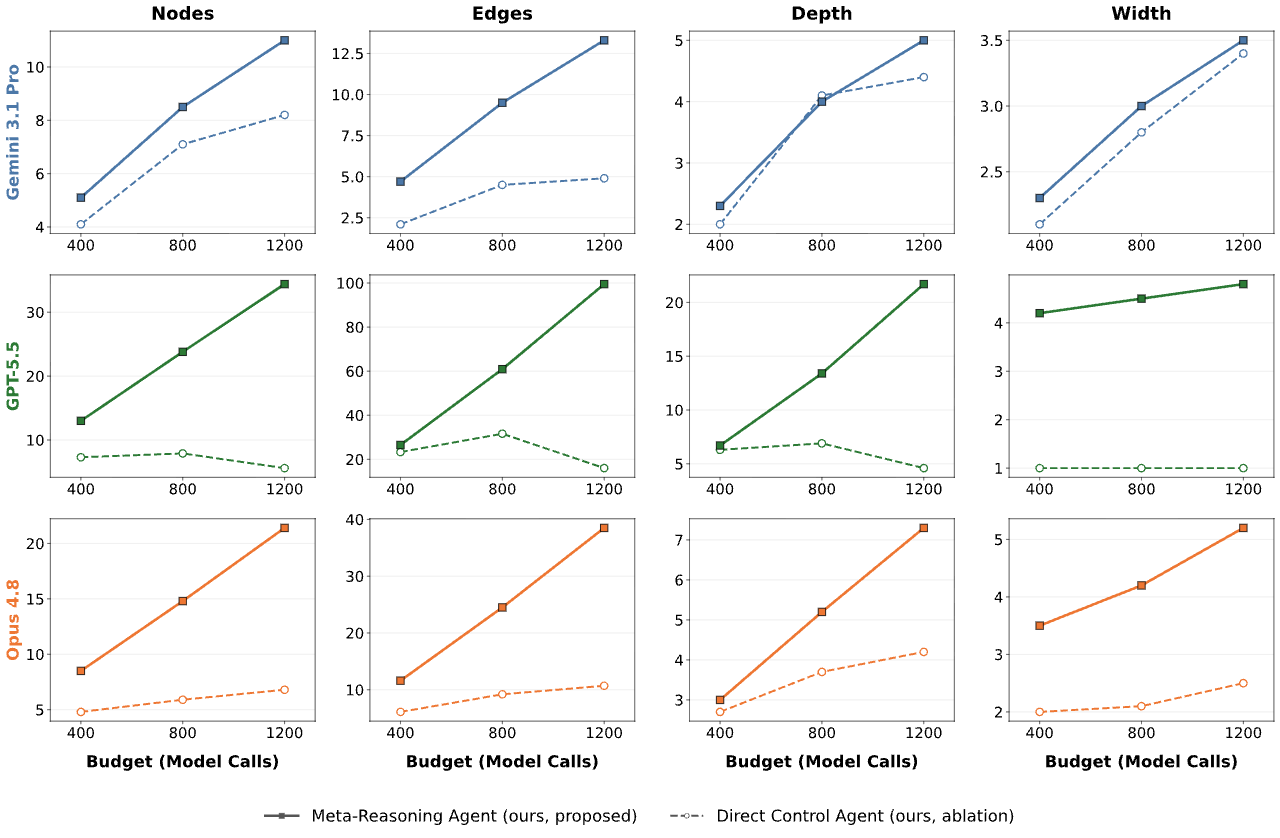
图 6:配对问题上元推理与直接控制的工件图示例,环形节点为最终提交的工件。图源:论文 Figure 5。
找到正确答案只是问题的一半
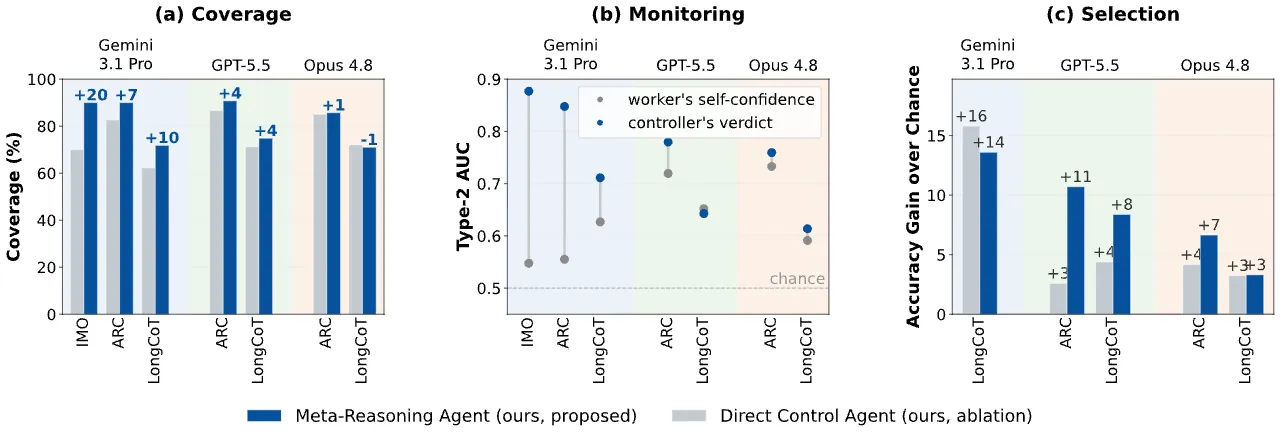
在推理基准上,论文对中间解工件逐个打正确性标签,计算覆盖、监控与选择三项诊断。下表汇总论文图 6 中标注的数值与正文给出的关键数字:
| 模型 | 基准 | 覆盖提升(百分点) | 前沿选择增益:直接控制 | 前沿选择增益:元推理 |
|---|---|---|---|---|
| Gemini 3.1 Pro | IMO ProofBench-Adv | +20 | – | – |
| Gemini 3.1 Pro | ARC-AGI-2 | +7 | – | – |
| Gemini 3.1 Pro | LongCoT-mini | +10 | +16 | +14 |
| GPT-5.5 | ARC-AGI-2 | +4 | +3 | +11 |
| GPT-5.5 | LongCoT-mini | +4 | +4 | +8 |
| Opus 4.8 | ARC-AGI-2 | +1 | +4 | +7 |
| Opus 4.8 | LongCoT-mini | −1 | +3 | +3 |
表 3:覆盖与前沿选择诊断。覆盖提升为元推理减直接控制;前沿选择增益为最终提交相对前沿均匀随机选择的正确率增益。数据来源:论文 Figure 6 标注与第 6.4 节。
覆盖方面,元推理在大多数设定下让更多运行至少包含一个正确候选,Gemini 3.1 Pro 在 IMO ProofBench-Advanced 上提升 20 个百分点,在 LongCoT-mini 上提升 10 个百分点;Opus 4.8 的 LongCoT-mini 基本持平。监控方面,工作者的自评置信可能是很弱的正确性信号:Gemini 3.1 Pro 在 IMO ProofBench-Advanced 上,工作者自评的二型 AUC 只有 0.55,接近随机;控制器评估阶段给出的判定达到 0.88。GPT-5.5 与 Opus 4.8 上差距较小,GPT-5.5 的 LongCoT-mini 几乎没有差距。
选择方面的结论更克制。ARC-AGI-2 与 LongCoT-mini 的运行中,83% 最终从收敛前沿提交答案,但约四分之三的这类运行在前沿上有多个候选,智能体仍要从中挑一个。GPT-5.5 在 ARC-AGI-2 上,元推理的前沿选择增益为 11 个百分点,直接控制为 3;但在 Gemini 3.1 Pro 的 LongCoT-mini 上,直接控制略占上风。控制器的判定排序能力更强,并不保证这种能力每次都传导到最终答案。
图 7:(a)正确候选覆盖;(b)工作者自评置信与评估阶段判定的二型 AUC;(c)相对前沿均匀选择的前沿选择增益。图源:论文 Figure 6。
不重放全部历史,也能保留有用信息
工件记忆把工作者输出和控制器自己的笔记放在一起。一个有意思的观察是,控制器重读自己笔记的强度远高于重读工作者输出:在至少被取回一次的工件中,笔记在 ARC-AGI-2 与 LongCoT-mini 上平均被读 4.4 到 9.8 次,工作者工件只有 1.9 到 3.3 次。多数工件此后再也没被读过,但控制器会反复回看一小部分自己的笔记,把它们当作反复使用的组织性参考。
记忆操作集中在评估和提议两个阶段,每个模型都是写多于读。评估阶段持续写入却几乎不读,因为新工件已经直接进入它的提示,显式读取意味着去翻更老的工作;提议和估值阶段承担了几乎所有读取。三个模型的记忆使用强度差异明显:Gemini 3.1 Pro 用得很少,GPT-5.5 更频繁,Opus 4.8 写了大量此后从未被回看的笔记。
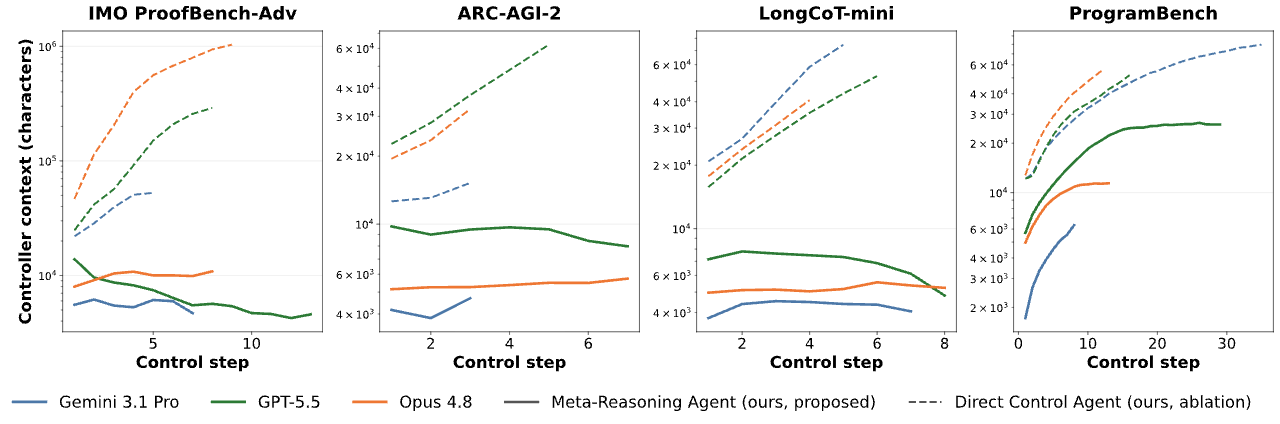
持久工件存储最大的好处是让控制器只维护一份紧凑状态。直接控制的历史在 Opus 4.8 最长的 IMO ProofBench-Advanced 运行中超过一百万字符;元推理的状态保持在数千到数万字符量级,在推理基准上常常随运行推进而缩小。ProgramBench 上差距缩小到几倍,元推理状态会随运行增长,因为控制器读到的大量内容是仓库代码,必须持续记账。作者推测,直接控制的历史达到了模型难以定位相关信息的长度,这可能是它在大预算下停止提升的原因之一,但论文没有直接验证这一点。
图 8:ARC-AGI-2 与 LongCoT-mini 上元推理智能体的记忆使用,按阶段分组,读取按对象分为工作者输出与控制器笔记。图源:论文 Figure 7。
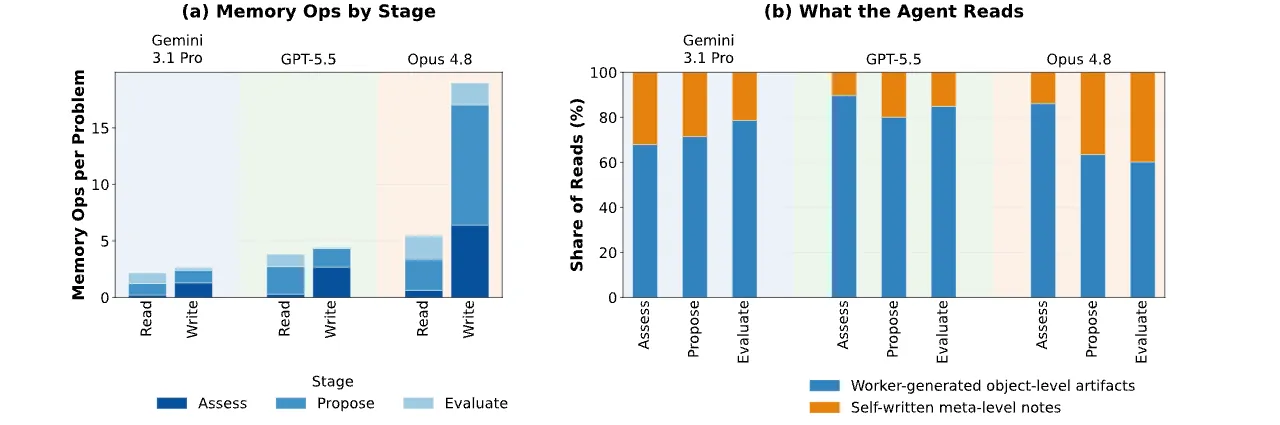
图 9:控制决策之间持久化表示的规模(对数坐标)。直接控制为累积消息历史,元推理为评估阶段维护的紧凑状态。图源:论文 Figure 8。
代码与可复现性
本文未提供公开代码,GitHub 上也搜索不到官方或第三方实现。可复现性主要依赖附录:四个阶段在文本任务与编程任务上的完整系统提示、对照智能体提示、工作者提示、工件记忆的渲染格式,以及 run_workers、finish、read_memory、write_memory 四个工具的 JSON 定义。其中两个细节对复现影响最大。第一,编程任务中并行工作者共享同一文件系统、没有分支隔离,估值提示因此强制要求写代码的动作只能用 1 个工作者,只读动作才允许扇出。第二,元推理与直接控制在 ProgramBench 上都额外获得一个只读 git 工具,只接受 log、show、diff、blame、cat-file 等子命令,输出截断在 8000 字符,用来让控制器读到工作者真实提交的代码,而不是只看工作者的文字总结。
可以对照阅读的公开代码有两处。一是 ProgramBench 官方仓库 facebookresearch/ProgramBench,论文报告的“每题测试通过率的平均值”对应其批量评测汇总中的平均通过率:
# src/programbench/eval/eval_batch.py
@property
def average_pass_rate(self) -> float:
    if not self.summaries:
        return 0.0
    return sum(s.score for s in self.summaries) / len(self.summaries)
二是递归语言模型基线的参考实现 alexzhang13/rlm。它的入口在到达最大递归深度后退化为普通模型调用,这正是论文所说“上下文是一个用代码编辑的变量,而不是一份转录稿”的实现形态:
# rlm/core/rlm.py, RLM.completion
# If we're at max depth, the RLM is an LM, so we fallback to the regular LM.
if self.depth >= self.max_depth:
    return self._fallback_answer(prompt)
论文为公平起见对递归语言模型做了两处改动:把完整 Python 交互环境替换成基于语法树白名单的受限工作区,禁止循环、算术、函数定义与导入,使所有实际计算都必须经过子模型调用;并加入与其他系统相同的预算记账,每消耗十分之一预算插入一条提示,到 90% 时要求提交。
局限性
第一,分阶段控制本身有开销(作者自述)。图 4 中的低预算交叉点说明这一设计并非总优于直接控制,Opus 4.8 在 400 次预算下落后 6.1 分。错误的控制器评估还可能传播误导性状态,或丢掉它此后再也没回读的好的部分工作;紧凑状态是有损的,只能依赖之后的记忆读取把后来才变得重要的信息捞回来。
第二,无法归因到具体组件(作者自述)。与直接控制的配对比较同时改变了紧凑状态、分阶段智能体过程和控制器记忆访问三件事,只能证明整体设计有效,不能说明每个阶段是否必要。要回答这个问题,需要去掉单个阶段、只保留状态压缩、只改记忆接口等消融实验,论文没有做。
第三,资源匹配只到调用次数(作者自述)。调用次数便于解释,但不同调用的输入输出令牌数和耗时差异很大,论文因此不对令牌成本、延迟或同等成本下的效率作任何结论。对实际部署而言,这恰恰是最需要的数字:四阶段控制器每轮固定 4 次调用,每次调用还要读状态与记忆索引,真实账单可能与调用数的比例不同。
第四,评测广度与不确定性(作者自述)。三个前沿模型、四个基准,其中证明集只有 30 题;点估计全部为正不等于每个差异都显著,也不能推出对较弱模型、其他任务或更长时程同样成立。LongCoT-mini 的国际象棋子集是一个反例:元推理在这里输给直接控制,初步轨迹分析指向“无效的重新考虑”,即额外的核验与展开反而动摇了已经正确的答案。
第五,与生产级编码智能体的比较条件值得仔细看(本文判断)。Claude Code 与 Codex 以无头模式运行,原生工具被禁用,所有动作都经由同一个 container_bash 工具执行,文件编辑只能用 heredoc 与 shell 命令完成;同时它们没有元推理和直接控制所拥有的只读 git 工具。这种设置保证了动作通道一致,但也意味着两个生产智能体并不处在各自的原生最佳配置下,71.5% 对 58.0% 应理解为“同一受限容器接口下”的比较,而不是对产品形态的直接排名。
总结与展望
本文的贡献可以归结为三点。概念上,它把“决定接下来算什么”从任务层工作中剥离出来,主张元层认知本身就是一种需要多步、专用工具和子任务的工作。系统上,它给出了一个具体的推理期运行框架:评估、提议、估值、派发四个独立阶段,紧凑状态加持久工件记忆,以及“只能提交已存在工件”的停止约束。方法论上,它提出工件图与覆盖、监控、选择、前沿选择增益这套诊断,把一个最终分数拆成“做了什么计算、有没有产出正确工作、正确工作有没有走到最终答案”三个可分别改进的问题。
对正在构建编码智能体和长程智能体运行框架的工程师,这篇论文有几条可以直接借鉴的做法:让生成备选的阶段看不到预算,避免昂贵但有价值的选项被过早过滤;把控制器状态写成带引用的事实快照,区分已实现、已损坏、未验证、未探索和死路;把工作者自评当作弱信号,由独立的评估阶段给出判定;派发给工作者的指令必须自洽可执行,不能只传一个内部标识符;只读地查看工作者的真实提交,而不是相信它的文字总结。
后续值得关注的方向包括:逐组件消融以确认哪些阶段在哪些情形下不可或缺;在令牌与时延层面报告真实成本;在更弱的模型和更长时程的任务上检验结论;以及针对国际象棋子集暴露的“过度复核”问题设计停止与承诺机制。论文结论中的一句话概括了它的立场:随着运行变长,决定什么工作值得做,本身就成了一项工作。
智能体的上限不只取决于它能把活干得多好,也取决于它能否在动手之前,想清楚哪件活值得干。