PAPER DEEP DIVE
DiscoveryRSI:递归学习发现有价值假说
科学发现的难点不在生成想法,而在把值得做的假说发展成可执行的调查,并从这一过程中学习。本文先给出「有价值且可检验的研究假说」的操作性定义:有据可依的主张 + 可行的调查计划 + 明确的判定标准 + 替代解释。DiscoveryRSI 用多智能体进化搜索生长假说树,把选中的调查编译成可执行的 Harbor 任务,并通过三条互相咬合的机制递归自改进:假说信用优化把科学评估按文档化贡献归因成有界监督信号,harness 回放在冻结模型权重的前提下改进研究工作流,rediscovery 把被接受的更新放回新问题继续积累经验。配套的 DFM-Bench 在假说、修订、发展路径、研究轮与跨提案贡献五个层次评估质量与累积进展。四个生命科学域上,假说质量从基座模型的 4.86 升至两轮自改进后的 5.39,增益集中在可证伪性与数据可解性;专家盲评中 DiscoveryRSI-27B 在重要性与「主张可信且有证据边界」两项上高于 GPT-6 Luna;与模型 cutoff 之后发表研究的对应率为 6.3%,高于 GPT-6 的 2.5% 与 Claude Opus 5 的 2.3%。代码、27B 模型与基准均已开源。
论文元信息
标题:DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
作者:Jianyuan Zhong、Chenwei Wu、Zhaochen Yu(共同一作)、Xixian Jiang、Xuewei Li、Hao Xiao、Xilin Dai、Junyang Wang、Jiaru Zou、Zhiqing Cui、Boyuan Zheng、Jing Xiong、Zhen Zhang、Qiang Gao、Michael Morley、Luis Nakayama、Qiang Xu、Liyue Shen、Tao Gui、Leo Anthony Celi、James Zou、Zhenfei Yin、Yingcheng Wu、Ling Yang(Gen-Verse 团队联合 MIT、哈佛、斯坦福等机构)
链接:arXiv:2610.23839(v1,2026-10-16)· arXiv HTML 全文 · 模型 Gen-Verse/DiscoveryRSI-27B · 基准 DFM-Bench · 在线演示 DiscoveryRSI Arena
代码状态:✅ 已发布。github.com/Gen-Verse/DiscoveryRSI(Apache-2.0)放出可移植 agentic 内核:候选假说数据结构、propose–critique–select–retain 循环、append-only 回放存储、研究清单、五个角色提示词(Lead / Generation / Evolution / Critique / Compiler)、公开评分准则与工具注册表,并可用 vLLM 起的 OpenAI 兼容端点接 DiscoveryRSI-27B。需要说明的是,仓库是 433 行的最小可运行 harness,生产级多智能体编排、假说信用优化的训练管线与 DFM-Bench 打分器并不在这个仓库里(DFM-Bench 是独立仓库),因此公开代码复现的是协议骨架而非论文全部数字。
一句话总结:DiscoveryRSI 把「提出假说—发展假说—执行调查」的整条研究过程记录成带谱系的链接记录,再用三条互相咬合的回路从中学习:假说信用优化把科学评估按文档化贡献归因到有界权重的监督信号上训出 DiscoveryRSI-27B,harness 回放冻结模型权重只改研究工作流,rediscovery 把被接受的更新放回新问题继续攒经验;四个生命科学域上假说质量从基座 4.86 升到两轮后的 5.39,与 cutoff 之后发表研究的对应率 6.3%,高于 GPT 的 2.5% 与 Claude 的 2.3%。
研究背景与动机
科学研究 agent 这两年走完了从「生成想法」到「执行实验」的路。Co-Scientist 用多智能体进化式精炼发展假说,AI Scientist-v2 用 agentic 树搜索把想法生成与实验执行接起来,Biomni 整合生物医学工具与数据,ScienceIDE 从科学代码库构造学习环境,ScienceBuddy 把研究者的交互转成可执行任务与反馈。这些系统已经能产出像样的提案,却共同留下一个没有被认真回答的问题:研究过程本身产生的经验,为什么没有变成改进 agent 的训练信号?人类科学家做完一项研究会记住「哪种对照有用、哪次修订救了这个项目」,并据此设计下一项研究;而现有研究 agent 的经验在 episode 结束时就消散了。
作者把障碍拆成两层。第一层在执行侧:把一个提案翻译成可执行调查,需要解析它的数据需求与验证标准,同时不能丢掉研究问题本身——很多提案写出来漂亮,却没有说明用什么数据、跟谁比、什么结果算支持、什么结果算推翻。第二层在学习侧,也是更本质的一层:一个假说的最终评分并不指明该强化哪些贡献。一个 agent 提出解释、另一个补上有用的对照、第三个根据新证据修订调查计划,如果只保留最终提案,这三个贡献就被抹平了。评估是对「提案」的,而训练目标属于「产生提案的历史」,两者之间存在一个归因缺口。
这个归因缺口正是本文的切口。要补上它,必须让研究历史可追溯:每个假说版本保留前驱链接与支撑证据,每次评估保留它依据的记录,每次执行保留它的失败与交付事件。只有当「评估—贡献—动作」三者被同一套记录串起来,评估才能变成对具体 agent 动作的监督,而不是一句悬空的分数。
于是论文提出 DiscoveryRSI:一个把假说驱动研究变成递归学习过程的通用框架。它用多智能体进化搜索发展可检验假说的研究树,把选中的计算调查编译成可执行的 Harbor 任务,并保留支撑每个提案与修订的证据和决策。积累的研究历史驱动三条耦合的改进机制——假说信用优化、harness 回放、rediscovery——分别更新模型权重、更新研究工作流、以及把被接受的更新放回新问题产生下一轮经验。
配套的 DFM-Bench 则回答「怎么评」。它不只看最终假说好不好,而是分五层评估:单个假说是否值得做且可检验、一次修订贡献了什么、一条发展路径是否积累了有用证据、一整轮研究如何分配精力、以及跨提案涌现出什么独立科学贡献。这套分层让「一个好提案」与「一个高产的研究过程」第一次被分开度量。
预备知识
递归自我改进(RSI)的谱系。Reflexion、GEPA、ACE 用语言记忆、提示进化与上下文 playbook 保留经验;harness 优化把适应扩展到 agent 工作流与实现;Darwin Gödel Machine 与 Hyperagents 研究程序级的持久改进;ScienceBuddy 把 harness 精炼与模型学习耦合;RSI-Anything 用预测性世界模型引导交互与系统更新。DiscoveryRSI 把这条线搬到以假说为中心的研究上:演化的主张、证据与调查决策提供一份共享记录,同时供贡献归因的模型学习、harness 回放与后续 rediscovery 使用。
TrueSkill 成对偏好推断。假说信用优化的第一步需要一个能汇总「谁比谁好、好多少、有多确定」的模型。TrueSkill 原本给棋手_rating:每个实体持一个高斯信念 $\mathcal{N}(\mu,\sigma^2)$,一次对局结果通过带平局边际的似然更新双方信念。本文把「实体」从棋手换成版本化假说,把「对局」换成盲评 Critique 的成对偏好,于是 $\mu$ 表示在统一评分准则下的相对偏好强度,$\sigma$ 表示证据的稀薄程度——被比较得越多的假说,信念越集中。
Harbor 任务。Harbor 是容器化可复现任务的执行框架。把调查计划编译成 Harbor 任务,意味着给它具体的输入、运行环境、必需输出与验证检查,使「这个调查在计算上能否跑通」成为一个可判定的契约问题。论文刻意把执行就绪性与科学价值分开:一个任务可以通过全部执行检查而科学上毫无价值,反之一个科学上重要的提案可能依赖尚不可得的数据而暂时无法编译。
方法详解
定义 1:把假说写成四元组
全文的地基是一个操作性定义。相对文档化的证据基 $\mathcal{E}$ 与声明的数据、实验、资源约束 $\mathcal{B}$,一个研究假说被表示为
$$\mathcal{H}=(c,\pi,d,a) \tag{1}$$其中 $c$ 是有证据支撑的主张,$\pi$ 是调查计划,$d$ 是决策准则,$a$ 是相关的替代解释。「有价值」指解决 $c$ 中的不确定性可能对当前理解做出实质性补充、或改变一个相对 $\mathcal{E}$ 有依据的研究决策;「可检验」指 $\pi$ 在 $\mathcal{B}$ 下可行,且其可观测结果经 $d$ 与 $a$ 解读后能支持、削弱或限定 $c$,未解决的区别被显式声明。四个组件各有明确职责:主张要写明系统或人群、范围、可观测量与科学不确定性;调查计划要写明数据或测量、比较、对照、分析与依赖;决策准则要在看到结果之前写明哪些结果支持或削弱主张、哪些仍属不确定;替代解释要写明竞争解释、混杂与测量局限,以及能区分它们的比较和这些比较的边界。注意这个定义评估的是「研究机会」,并不主张 $c$ 为真——一个被支持的「无额外信息」结论同样有价值,因为它能终止对更复杂模型的无谓投入。
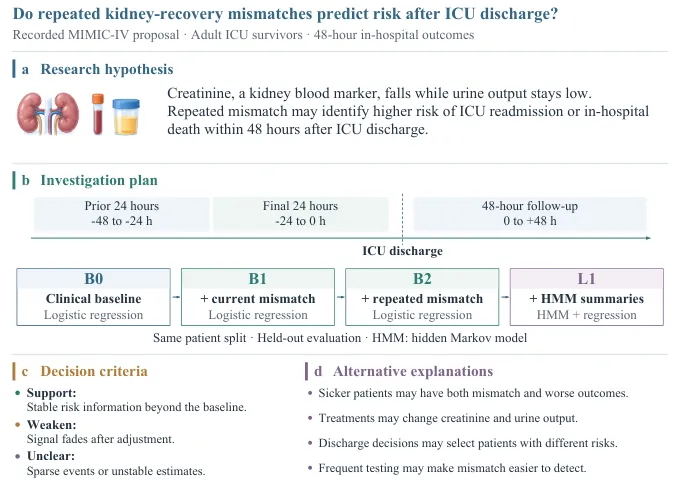
图2:定义 1 的一个实例。这条 MIMIC-IV 提案针对首次 ICU 住院至少 48 小时且存活的成人,(a) 问反复的肌酐—尿量失配是否对 ICU 出院后 48 小时内的再入院或院内死亡提供额外信息;(b) B0–B2 比较临床基线、当前失配、反复失配三个 logistic 模型,L1 再加入隐马尔可夫摘要并受数据支撑与稳定性检查约束,模型共享患者级训练/调参/测试划分;(c)(d) 决策准则与替代解释限定解读边界,全文不主张任何临床结论。
研究树与链接记录:让经验可追溯
每个节点是一个版本化假说,携带调查计划、决策准则、替代解释与证据。父链接记录科学发展关系:修订有一个前驱,crossover 可以有多个父节点,因此谱系实际上是一个有向无环图,「研究树」只是直观说法。这棵树跨 episode 存在,且与产生每个节点的 agent 动作序列是两回事——后者是训练单元,前者是评估单元,论文在附录 A 里反复强调两者不可混用。
研究树又嵌在更大的记录网络里:假说链接到来源与数据、草稿与支撑 artifact、科学评估、agent 贡献、执行记录。文件保留研究材料,注册表条目、标识符、路径与内容哈希保留它们的关系。一个共享 artifact 可以支撑多个假说而不让它们互为科学后代——这条语义很重要,它保证证据复用不会被误读成谱系继承。正是这些链接让「一次被评估的贡献」能回溯到产生它的历史,也让「一个反复出现的失败」能回溯到背后的决策与执行事件。
进化操作与角色分工
沿用算子式搜索(如 Frontis-MA1),系统提供四种操作:evolution 发展一个假说,repair 修复已识别的缺陷,crossover 合并多个父节点的贡献,scientific restart 不指定父节点地开启新问题(先前工作可留作上下文)。Lead 选择方向、父节点与操作;Generation 与 Evolution 调查证据并发布提案或修订;Blinded Critique 在兼容的数据与评审条件下比较科学价值,给出偏好、平局或弃权;ancestor-aware 的 Progress 评估相对真实前驱的实质进展、必要修复、重复或证据不足。所有评估都写回链接记录,成为后续学习的原料。
从假说到可执行调查
被选中的计算计划编译成 Harbor 任务,带具体输入、环境、必需输出与验证检查。编译保留假说的科学承诺:人群或生物系统、提议的比较、判别性结果、解读准则。不可得的数据与物理实验保留为显式依赖,而不是被悄悄删掉。执行检查判定任务是否满足计算契约,科学评估判定调查能确立什么——两者分离意味着假说发展可以在调查完整执行之前就供给学习经验,这是整个递归回路能转起来的前提。
假说信用优化:从评估到有界监督
这条链路有三环:科学评估决定假说信用;贡献记录把信用分配给文档化的研究历史;历史中被支撑的动作成为训练目标。
第一环,评估。Blinded Critique 给出偏好、平局或弃权,TrueSkill 汇总相对偏好强度与不确定性:
$$z_{h}\sim\mathcal{N}(\mu_{h,0},\sigma_{h,0}^{2}),\quad t_{h,e}\mid z_{h}\sim\mathcal{N}(z_{h},\beta^{2}),\quad P(a\succ b\mid z_{a},z_{b})=\Phi\!\left(\frac{z_{a}-z_{b}-\varepsilon}{\sqrt{2}\,\beta}\right) \tag{2}$$其中 $z_h$ 是准则条件下的偏好强度,$t_{h,e}$ 是带噪的比较表现,$\beta$ 是噪声尺度,$\varepsilon$ 是平局边际,$\Phi$ 是标准正态 CDF。证据不足时弃权,不产生任何偏好更新——这条看似保守的规则防止了稀疏比较被过度解读。更新后的 $(\mu_h,\sigma_h)$ 描述的是比较性评估,不是假说为真的概率;相对真实前驱的进展判断由独立的 Progress 提供。
第二环,假说权重。先取保守排序统计与同层内的平局感知秩:
$$s_{h}=\mu_{h}-\kappa\sigma_{h},\qquad r_{h}=\frac{\sum_{k\in\mathcal{S}}\mathbf{1}[s_{k}<s_{h}]+\tfrac{1}{2}\sum_{k\in\mathcal{S}}\mathbf{1}[s_{k}=s_{h}]}{|\mathcal{S}|} \tag{3}$$在高斯边际近似下 $s_h$ 是 $\Phi(-\kappa)$ 后验分位数;取 $\kappa=2$ 时约 2.3% 的建模偏好质量落在它之下,即「即使运气差也大概率不差」的下界。再用两个可靠性因子压制稀疏或不确定评分:
$$\rho_{h}^{\mathrm{cov}}=\frac{n_{h}}{n_{h}+\nu},\qquad \rho_{h}^{\mathrm{unc}}=\frac{1}{1+\sigma_{h}/\sigma_{\mathrm{ref}}} \tag{4}$$其中 $n_h$ 是有效比较次数。最终的有界结果变换为
$$q_{h}=v_{h}\min\!\left\{q_{\max},\;q_{\min}+(q_{\max}-q_{\min})\,r_{h}\,\rho_{h}^{\mathrm{cov}}\,\rho_{h}^{\mathrm{unc}}+\lambda_{p}p_{h}\right\} \tag{5}$$$v_h$ 指示记录在案的有效评估与至少一次有效比较、且无边际重复判断;$p_h$ 指示实质进展或必要修复判断。实现参数为 $\kappa=2$、$\nu=2$、$\sigma_{\mathrm{ref}}=8.3333$、$[q_{\min},q_{\max}]=[0.5,2]$、$\lambda_p=0.25$。论文特别澄清:式 (5) 是作者对偏好后验的有界变换,不是 TrueSkill 推断出的量;缺失评分保持未知,零 loss 不是负面科学标签——一个被支持的零结果假说仍然有资格进入训练。
第三环,贡献份额与家族上限。贡献图只承认有证据的边:直接发布要求 publisher、episode 与创建时间谱系匹配;文档化的生产或支撑可由原始提案文本、精确的草稿修订提升记录、或哈希与路径匹配的支持文件字节恢复;Lead 协调要求有贡献的工作指派或发布/提升记录。仅共享 episode、出现在谱系图里、或完成过一次 worker 调用都不产生信用边。对假说 $h$,设 $L_h$ 为已验证的协调轨迹、$P_h$ 为直接生产或文档化支撑轨迹,协调比例 $\gamma$ 下
$$\alpha_{ih}=\begin{cases}\gamma/|L_{h}|, & i\in L_{h},\\ (1-\gamma)/|P_{h}|, & i\in P_{h},\\ 0, & \text{otherwise},\end{cases}\qquad \sum_{i}\alpha_{ih}\leq 1 \tag{6}$$实现的 $\gamma=0.2$:一个协调 Lead、一个 Generation 发布者、一条有文档支撑的 Evolution 轨迹分别拿 0.2、0.4、0.4。缺失的贡献池份额保持未分配,绝不转移给「方便的接收者」——Lead 单独发布而作者身份未决时,只拿协调份额。随后局部谱系家族与全局科学家族各设预算 $C_{\mathrm{loc}}=C_{\mathrm{glob}}=2$ 抑制重复注册与同族重复版本的信用膨胀,轨迹权重为
$$w_{i}=\min\!\left(W_{\max},\sum_{h}b_{ih}\right),\qquad W_{\max}=2 \tag{7}$$其中 $b_{ih}$ 是经过贡献共享、重复抑制与家族预算后的分配。附录 B.7 的命题 1 证明这套缩放满足归一化前的信用守恒:每个假说的分配不超过 $\widetilde{q}_h$,每个全局家族不超过 $C_{\mathrm{glob}}$,每条轨迹权重落在 $[0,W_{\max}]$。作者同时坦白:$\alpha$ 是固定的责任先验,不是对演员的贝叶斯后验,也不是反事实的边际贡献估计;Critique 的投票不能独立证明它自己输出的正确性。
训练目标。信用控制一条历史对训练的贡献强度;历史内部,目标集只选被记录贡献支撑的 assistant 响应与工具调用参数,工具观测与已知失败动作保留为上下文但不计 loss:
$$\mathcal{L}(\theta)=-\sum_{i}\frac{\omega_{i}}{|U_{i}|}\sum_{u\in U_{i}}\log\pi_{\theta}(a_{iu}\mid x_{iu}) \tag{8}$$$U_i$ 是合格的 assistant token 位置,$\omega_i$ 把贡献信用与域、共享记忆组平衡结合起来:
$$\omega_{i}=\frac{\eta_{d_{i}}}{|\mathcal{G}_{d_{i}}|}\cdot\frac{w_{i}}{\sum_{k:\,d_{k}=d_{i},\,g_{k}=g_{i}}w_{k}},\qquad \sum_{d}\eta_{d}=1 \tag{9}$$系数与分母从冻结的训练发布中固定,不在 minibatch 内重归一化——否则长 transcript 会凭长度决定自己的 loss 权重。实现上域平衡给生命科学 90%、电池研究 10%。于是历史的权重被摊到它被支撑的目标上,而不是摊到它说过的每一句话上;没有合格目标的历史直接退出训练。
Harness 回放:冻结权重改工作流
与模型更新并行的是另一条不动权重的回路。agent 从成熟的 Codex 或 Claude Code harness 起步,其会话、上下文、文件系统与工具执行机制是复杂调查的基底;研究协调、证据访问、评审时机与工作分配是在基底之上的适配。短诊断跑(包括新训模型候选的跑)先暴露工作在哪里断掉:把 agent 贡献与决策记录同执行、交付记录 join 起来,定位重复探索、工具调用失败、artifact 丢失或过早收束。对用固定模型 $\theta_k$ 与 harness $\psi_k$ 收集的历史 $\mathcal{H}_k$:
$$\Psi_{k}^{\mathrm{cand}}=\operatorname{Propose}(\psi_{k};\mathcal{H}_{k}),\qquad \psi_{k}^{+}=\operatorname{Select}_{\mathrm{dev}}\!\left(\{\psi_{k}\}\cup\Psi_{k}^{\mathrm{cand}}\;\middle|\;\theta_{k},B\right) \tag{10}$$$B$ 是匹配的资源上限。快速跑与受支撑的回放负责诊断与初筛,匹配的开发集评估负责接受,综合考虑科学质量、探索广度、可靠性与成本;现任 harness 始终在候选集里,改不动就不改。回放使用记录在案的观测与续写;一个未被记录的替代方案需要从兼容的恢复状态真正执行一遍。
Rediscovery:把被接受的更新放回新问题
设 $\theta_k^+$ 为信用优化产出的模型候选、$\psi_k^+$ 为回放选出的 harness 候选,下一轮为
$$\begin{aligned}(\theta_{k+1},\psi_{k+1})&=\operatorname{Accept}_{\mathrm{dev}}\!\left(\{\theta_{k},\theta_{k}^{+}\}\times\{\psi_{k},\psi_{k}^{+}\}\right),\\ \mathcal{H}_{k+1}&\sim\operatorname{Research}\!\left(\theta_{k+1},\psi_{k+1};\mathcal{Q}_{k+1}^{\mathrm{fresh}},B\right).\end{aligned} \tag{11}$$接受程序分别且联合地评估合格更新,因此模型、harness、两者都、或两者都不变都是合法结果。被接受的系统回到新问题,收集新的假说、证据、评估与贡献历史。论文区分了两个容易混淆的概念:scientific restart 在一轮研究内部换方向,rediscovery 换的是下一轮所用的系统。版本化记录把相邻轮次串起来,同时保持开发族与最终评估族分离。
flowchart TB
    subgraph EP["Episode k - hypothesis development"]
        L["Lead: pick direction, parents, operation"] --> G["Generation: propose hypothesis"]
        L --> E["Evolution: evolve / repair / crossover"]
        G --> C["Blinded Critique: pairwise preference"]
        E --> C
        E --> P["Progress: ancestor-aware judgment"]
        C --> S["Select hypothesis versions"]
        S --> K["Compiler: Harbor task with checks"]
    end
    K --> R["Linked records: evidence, drafts, assessments, contributions, execution"]
    R --> A["Hypothesis credit optimization: TrueSkill posterior, bounded weight, contributor shares"]
    A --> T["theta_k+ : weighted SFT on supported tokens only"]
    R --> H["Harness replay: diagnose failures, propose edits, dev-select with incumbent"]
    H --> W["psi_k+ : accepted workflow edit"]
    T --> D["Accept_dev on development set"]
    W --> D
    D --> N["Round k+1: rediscovery on fresh questions"]
    N --> EP
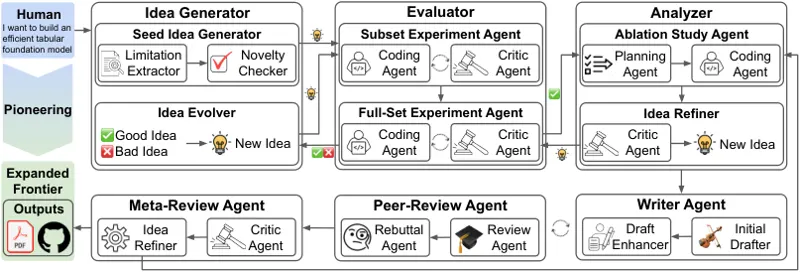
图1:DiscoveryRSI 的递归结构(对应论文 Figure 1 与 Algorithm 1)。episode 内 Lead 协调 Generation 与 Evolution,候选版本经盲评与进展判断后由 Compiler 编译为 Harbor 任务;同一批链接记录同时喂给两条更新支路——信用优化产出 $\theta_k^+$、harness 回放产出 $\psi_k^+$——两者在开发集上接受后进入下一轮 rediscovery。
DFM-Bench:五层评估对象
DFM-Bench 问五个互相衔接的问题:单个假说是否值得做且可检验(产出重要性、新颖性、证据支撑、可证伪性、数据可解性、可行性、替代解释、可操作性八维画像与加权总分);一次修订相对真实前驱贡献了什么(实质进展 / 必要修复 / 重复 / 证据不足);一条按真实谱系排序的发展路径是否积累了有用证据;一整轮研究的探索广度、分支综合与预算分配是否高效(直接评估整图,而非路径分数平均);以及跨相关提案涌现的独立科学贡献(新区别、有信息的零结果、被支撑的发现、不确定性的缩减),并区分「提议的想法」与「被完成调查和独立检查支撑的贡献」。与既有基准的覆盖对比见下表:只记录中间动作不构成覆盖,AgentIdeaBench、DiscoveryBench、BLADE、ScienceAgentBench 都只在个别列上有显式或部分的评估,OEB 在证据使用与修订上显式、在路径与整轮上部分,而 DFM-Bench 六列全为显式。
| 基准 | 假说价值 | 贡献成熟度 | 证据使用 | 修订 | 发展路径 | 整轮分配 |
|---|---|---|---|---|---|---|
| AgentIdeaBench | ✓ | ✗ | ◐ | ✗ | ✗ | ✗ |
| DiscoveryBench | ◐ | ✗ | ◐ | ✗ | ✗ | ✗ |
| BLADE | ✗ | ✗ | ◐ | ✗ | ✗ | ✗ |
| ScienceAgentBench | ✗ | ✗ | ◐ | ✗ | ✗ | ✗ |
| OEB | ✗ | ✗ | ✓ | ✓ | ◐ | ◐ |
| DFM-Bench(本文) | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
表1:科学发现基准的评估覆盖对比(✓ 显式评估,◐ 相关或部分,✗ 无显式评估)。作者强调这比较的是显式评估构造,而非「恰好能跑在某基准上的 agent 能力」。
实验结果
设置
主实验覆盖四个生命科学域:临床与人群健康、治疗靶点优先级、疾病机制、人群多组学;输入包括 HCC 临床队列、MIMIC-IV、eICU、UK Biobank 与 GEO/ArrayExpress 的分子研究。为检验迁移性另设电池域:电诊断、健康预测、退化机制、使用历史与老化四个子域,沿用同一套 Lead–Generation–Evolution–Critique–Compiler 循环,只替换域特定的检查(工况、传感、物理合理性、竞争解释)。训练侧对 DiscoveryRSI-27B 做 256K 上下文的全参数微调:从 15,792 条收集的研究轨迹中,经归因、过滤与 tokenize 保留 2,397 条(634 Lead、861 Generation、902 Evolution),训练序列共 291.12M token,其中 6.18M(2.12%)接受直接监督;Adam、学习率 $5\times10^{-6}$、全局 batch 16、BF16,64 卡(TP4 × CP8 × DP2)跑 150 步一个 epoch。自动化质量评估覆盖 241 个研究问题,评判者为 GPT-5.6 Sol;行为分析每模型变体六个 campaign、每 campaign 20 个 episode;人类评估由 27 名有生物医学或临床研究背景的医生、医学生与生物科学博士生在三名资深督导下评审 292 份匿名提案。
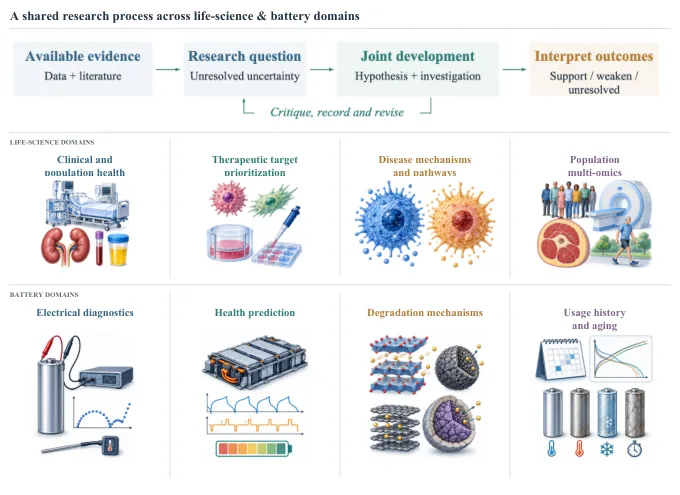
图3:跨域共享的研究过程。上排四步为「可用证据 → 研究问题 → 假说与调查的联合发展 → 支持/削弱/未解决的解读」,中间是批评、记录与修订回路;下两排分别是四个生命科学域与四个电池域的实验设定。
RQ1:研究历史的学习是否提升假说质量
自动化假说质量从基座的 4.86 升到第一轮后的 5.18、第二轮后的 5.39;第二轮模型在四个域上全部超过基座,增益从疾病机制的 0.28 到人群多组学的 0.94 不等,而边际增益从第一轮的 0.32 降到第二轮的 0.21。更有信息量的是轴级分解:可证伪性从 4.00 升到 6.20,替代解释从 4.44 升到 5.98,数据可解性从 3.73 升到 4.99,可行性从 4.79 升到 5.87;与此同时重要性从 6.48 降到 6.04、新颖性从 4.87 降到 4.58。
| 评估轴(权重) | 基座 R0 | 第一轮 R1 | 第二轮 R2 |
|---|---|---|---|
| 总分 Q | 4.86 | 5.18* | 5.39* |
| 重要性(20) | 6.48 | 6.21 | 6.04 |
| 新颖性(20) | 4.87 | 4.58 | 4.58 |
| 证据支撑(15) | 4.24 | 4.97* | 4.50* |
| 可证伪性(10) | 4.00 | 5.24* | 6.20* |
| 数据可解性(10) | 3.73 | 4.33* | 4.99* |
| 可行性(10) | 4.79 | 4.21 | 5.87* |
| 替代解释(10) | 4.44 | 5.64* | 5.98* |
| 可操作性(5) | 5.20 | 5.30 | 5.47* |
表2:八轴假说质量随自我改进轮次的变化(1–10 分,* 表示相对 R0 经 FDR 校正 q<0.05 显著更好)。改进集中在「如何检验」而非「问题有多重要」。
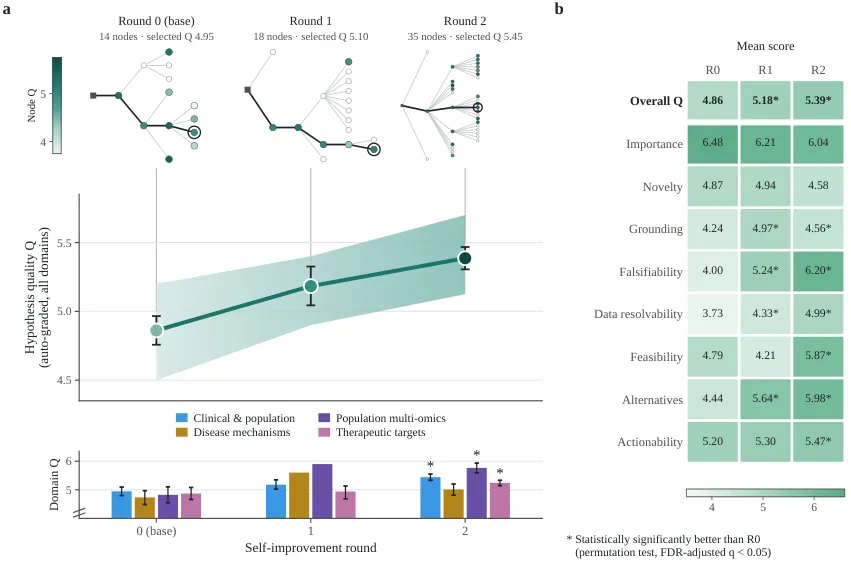
图4:自动化假说质量随轮次上升。(a) 上排为每轮示例研究树(节点色为八轴加权质量),中排为轮次均值与 95% 置信区间、阴影为四分位距,下排为分域均值;(b) 为均值与轴级分数表。这组数字的读法是:学习改善的是调查设计的严谨度,而不是选题的眼界。
RQ2:研究行为如何变化
evolve 与 repair 操作占比从基座的 77.5% 升到第一轮的 90.0%、第二轮的 91.7%;restart 从 21.7% 降到 5.8% 与 5.0%,在 episode 11–20 段尤其明显(约 32% 降到 3%)。发展路径分数上涨最多的是证据与推断纪律(+1.25),其次是技术与知识探索(+0.34)与科学连续性与综合(+0.24);累积进展、停止决策与预算效率的变化都小于 0.1,学科联系反而下降 0.28。行为画像的解读应当克制:操作频率描述研究策略,其价值取决于由此产生的修订质量——模型学会了「深耕一个假说」而不是「不断换题」,但并没有学会更好地分配预算或做跨学科连接。
| 指标 | 基座 | 第一轮 | 第二轮 |
|---|---|---|---|
| evolve + repair 占比 | 77.5% | 90.0% | 91.7% |
| restart 占比 | 21.7% | 5.8% | 5.0% |
| L4 证据与推断纪律 Δ(R2−基座) | +1.25 | ||
| L2 技术与知识探索 Δ | +0.34 | ||
| L5 科学连续性与综合 Δ | +0.24 | ||
| L1 学科联系 Δ | −0.28 | ||
表3:研究行为与七维发展路径分数的轮间变化(路径权重 L1–L7 为 5/30/20/20/10/10/5)。
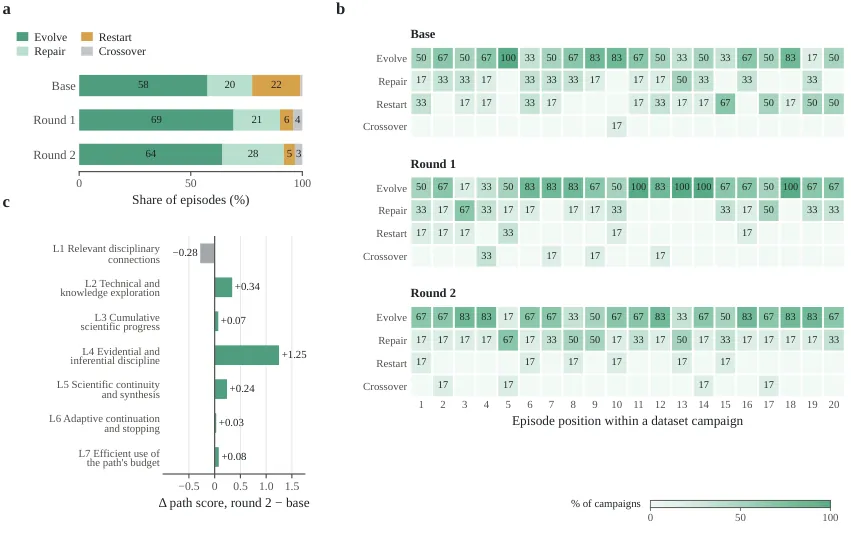
图5:行为变化。(a) 每轮各操作份额;(b) 每轮六个 campaign 在各 episode 位置上的操作热图;(c) 基座到第二轮的七维路径分数变化,L4 的 +1.25 是最突出的一条。
RQ3:人类评审是否认可这些改进
在被评估的研究树内,DiscoveryRSI-27B 的修订有 41% 提升人类均分、47% 持平、12% 变差;GPT-5.6 Sol 为 31%/37%/32%,GPT-6 Luna 为 25%/44%/31%。每次修订的平均分变化为 +0.07(DiscoveryRSI-27B)、+0.03(Sol)、−0.01(Luna)。绝对评分则是一幅混合图景:DiscoveryRSI-27B 在重要性(3.10 对 2.94)与「主张可信且有证据边界」(3.37 对 3.16)上高于 Luna,两者在「相对已知工作的推进」上同为 2.31,而 Luna 在数据契合、替代解释与信息量三项上更高——更强的修订结果与个体提案上残留的弱点并存。一条 MIMIC-IV 发展路径给出了具体图景:后续版本澄清了时间原点与 48 小时界标、把变量绑定到可用数据字段、写明急性肾损伤阈值,六项人类准则均值从 2.83 升到 3.50,其中数据契合与信息量各升两分;但同树中仍有带致命缺陷的分支(两个深度四的兄弟节点未写明 AKI 阈值),说明必须逐提案评估而不能按树平均。
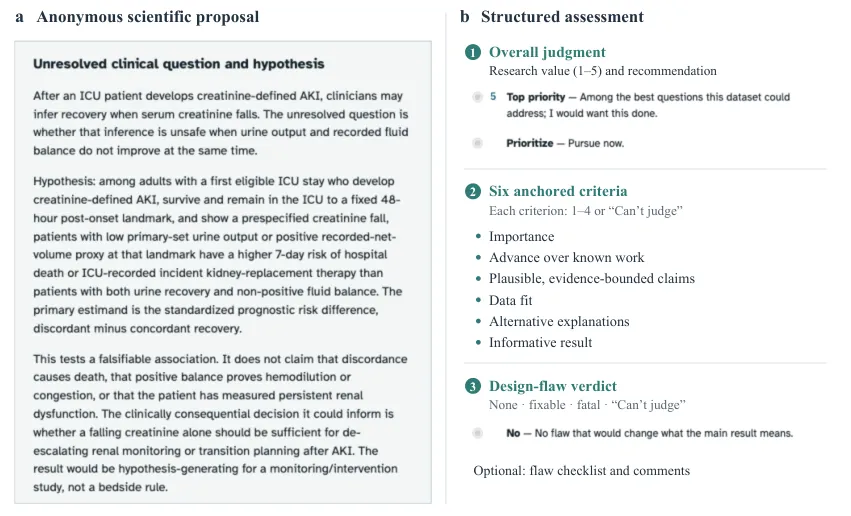
图6:专家督导评估流程。(a) 匿名 MIMIC-IV 提案呈现科学问题、计划比较与主张边界;(b) 评审先记总体判断与推荐,再评六项锚定准则并判定设计缺陷(无/可修/致命),可选项包括缺陷清单与评论。模型身份、执行谱系与自动评分全部隐藏。
RQ4:假说是否启发后续研究
「启发」被定义为生成假说与后续文献之间的具体连接: cutoff 之后的发表工作提供了与该假说的发展或检验相关的实验设计、对照、测量或可检验的证据缺口。在两次合并的生产运行中,1,176 个假说版本里 74 个满足条件,启发率 6.3%;对照组为 DeepSeek 5.4%(14/257)、GLM 2.8%(1/36)、GPT 2.5%(59/2,341)、Claude 2.3%(3/131)。分域看 DiscoveryRSI 在治疗靶点上达 16.9%、人群多组学 7.4%、疾病机制 6.8%、临床与人群健康 2.3%。形式化为
$$R_{\mathrm{insp}}=\frac{\sum_{h}a_{h}}{|\mathcal{H}|} \tag{12}$$其中 $a_h$ 指示正面判断,$\mathcal{H}$ 为该组全部生成版本。参考语料由 420 次反向与正向引用遍历构造,得 17,790 条引用边与 16,440 篇解析文献,并按各组记录的 cutoff 过滤。作者对 Claude 的低分做了诚实的归因分析:只有 15/131(11.5%)的 Claude 提案通过检索门,而 DiscoveryRSI 为 355/1,176(30.2%);但在通过检索的提案中正面判断比例相近(20.0% 对 20.8%)。Claude 提案中位长度 41,134 字符,而检索只用前 6,000 字符、语义审计只看前 2,500,谱系与修订说明可能把科学内容挤出被评估的片段;用标题作查询的诊断把 Claude 的检索数从 15 提到 95。这说明测到的差距部分来自表示与检索覆盖,而非纯粹的科学质量。
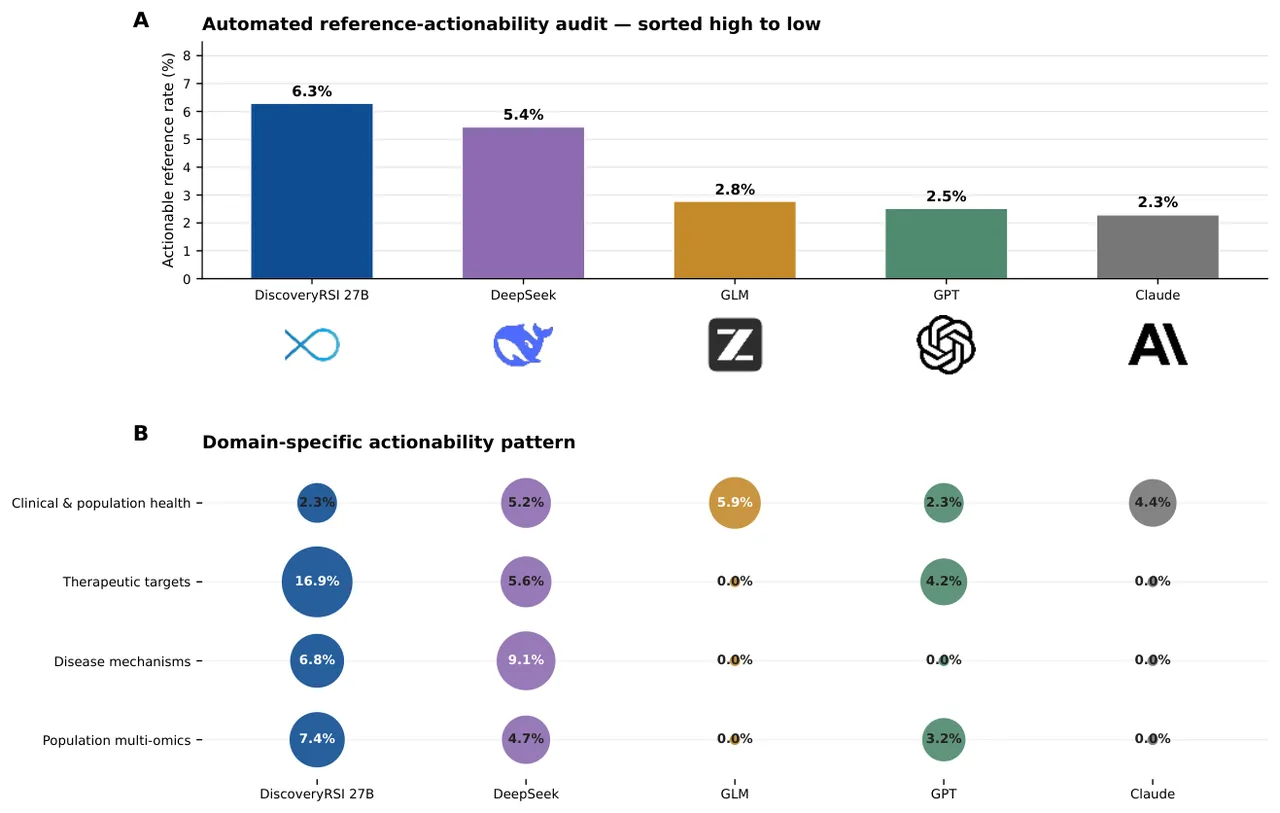
图7:(a) 各模型组的启发率排序,DiscoveryRSI-27B 6.3% 居首;(b) 分域模式,治疗靶点优先级是 DiscoveryRSI 与 DeepSeek 共同的高命中域。
电池域与训练记账
电池域把五层 DFM-Bench 评估应用到 200 个 episode 与 351 个生成假说(每假说三次 AI 评审):165 个完整分数上的平均假说质量 5.61,366 个转移中 214 个(58.47%)为实质进展,152 条路径的完整轨迹均分 81.52,研究轮分数 71.25,识别出 20 个贡献家族、其中 7 个带诊断或研究证据。训练侧的记账同样值得看:Critique(4,988 条)、Compiler(2,056 条)、Progress(513 条)记录保留为上下文或来源,但不接受直接监督——归因政策认为它们不能自我证明正确性。
| 角色 | 收集轨迹 | 进入训练 | 序列 token | 受监督 token |
|---|---|---|---|---|
| Lead | 3,423 | 634 | 98,357,399 | 977,931 |
| Generation | 2,502 | 861 | 96,414,270 | 2,437,985 |
| Evolution | 2,310 | 902 | 96,349,331 | 2,761,689 |
| Critique | 4,988 | 0 | — | 0 |
| Compiler | 2,056 | 0 | — | 0 |
| Progress | 513 | 0 | — | 0 |
| 合计 | 15,792 | 2,397 | 291,121,000 | 6,177,605 |
表4:假说信用训练的轨迹与 token 记账。2.12% 的受监督比例说明这套方法本质上是「在海量研究上下文里只学被证据支撑的那几句」。
局限性
作者自述之一:改进偏科。质量增益集中在可证伪性、替代解释、数据可解性与可行性,而重要性与新颖性不升反降(6.48→6.04、4.87→4.58),学科联系下降 0.28,累积进展、停止决策与预算效率的变化不足 0.1。作者据此把结论限定为「学习改善调查设计」,并不声称改善选题眼光或资源分配。
作者自述之二:评估者不是独立专家。自动化画像由同一模型家族的三个提示角色(rubric judge、domain scientist、methods reviewer)独立打分,度量的是相关 AI 视角而非三个独立专家意见;人类校准(独立专家判断、仲裁、未见接受用例)仍待完成。人类评审本身也只有 27 名评审、292 份提案,且共享谱系使修订观测相互依赖,论文因此只报描述性百分比、不做显著性检验。
作者自述之三:启发率是回顾性对应而非采用。6.3% 度量的是 cutoff 后文献与假说的具体连接,不意味着发表者见过、采纳或因果上受该假说影响;检索门与提案格式会系统性地影响测得的比率(Claude 的例子即为明证)。前瞻性评估需要在研究者看到之前冻结假说并跟踪后续研究计划。
我的判断:公开代码与论文数字之间存在复现距离。仓库是 433 行的可移植 harness:Candidate 数据类承载 claim/plan/alternatives/evidence/parents,DiscoveryLoop 实现 propose–critique–select–retain 并写 append-only JSONL,ResearchHarness 用提示词实现 Lead 与 Critique,ToolRegistry 提供 record_evidence/compare/falsify 三个工具。它忠实反映了定义 1 与第 3.1 节的协议骨架,但 TrueSkill 信用管线、家族预算、256K 全参微调与 DFM-Bench 打分器都不在其中(DFM-Bench 为独立仓库),因此论文的主要数字无法仅凭公开仓库复现;此外 Candidate 并未把决策准则 $d$ 设为独立字段,而是靠评分提示与评分准则文本承载,公开 harness 与定义 1 之间存在一处轻微的字段缺口。
总结与展望
DiscoveryRSI 的贡献可以压缩成一句话:把研究过程而非研究结果当作训练数据。定义 1 让假说成为可修订的四元组对象;研究树与链接记录让评估能回溯到贡献;假说信用优化把回溯变成有界、守恒、只监督被支撑 token 的训练信号;harness 回放与 rediscovery 让工作流与系统本身也进入学习回路;DFM-Bench 则把「好提案」与「好过程」分开度量。实验给出的证据是自洽的:自动化质量两轮升 0.53 分且增益落在可检验性轴上,行为上从换题转向深耕,人类评审看到更高的修订净增益,文献对应率领先对照组两倍以上。作者把下一步说得很清楚:用 RSI-Anything 之类的求解器执行并精炼被选中的提案,补上湿实验验证,把支持、否定与不确定的结果都转成更好的研究决策,并把假说发现与 DFM-Bench 推广到更多科学域。对做科研 agent 的团队而言,这篇论文真正可复用的不是某个分数,而是那套记录语义:父链接、贡献边、执行事件与评估版本,缺一样,递归学习就无从谈起。