PAPER DEEP DIVE
GaussLite:用自然语言任务驱动的实时 3DGS 机器人建图
MIT 提出 GaussLite,首个接受自然语言任务输入并按任务相关性在线分配表征容量的 3DGS 建图系统:LLM 一次性解析目标物与锚定物,Grounding DINO + FastSAM 逐帧接地生成相关性掩膜,据此分配高斯播种密度、梯度流与初始尺度。相同高斯预算与实时 4Hz 建图下,ROI PSNR 在 Replica 上 +2.72dB、真实校园场景 +2.23dB;多智能体按活跃优化计数逐体素投票融合,比朴素拼接 +3.42dB 而只共享 7.08% 地图。
一句话总结
现有 3DGS 系统把表征容量均匀铺满整个场景,但下游机器人任务往往只用到重建几何的一小部分——宝贵的机载算力被浪费在无关区域。GaussLite 提出「任务驱动建图」:给一句自然语言任务(如"准备抓起桌上的物体"),它用 LLM 一次性解析出目标物与锚定物,再经开放词汇检测与分割生成逐像素相关性掩膜,据此分配高斯播种密度、梯度流与初始尺度。在相同高斯预算与实时 4 Hz 建图约束下,ROI PSNR 在 Replica 上平均 +2.72 dB、真实校园场景 +2.23 dB;两个任务特化智能体的地图还能通过「活跃优化计数」逐体素投票融合,比朴素拼接 +3.42 dB,而只交换 7.08% 的地图。
研究背景:算力花错了地方
3D 高斯泼溅(3DGS)已成为照片级真实渲染的主流场景表征,越来越多在线高斯建图系统把它集成进机器人 SLAM。但在机器人硬件上,逐帧建图循环必须实时、内存有界、算力预算通常紧到无法以统一保真度精修整个场景。问题在于:现有在线 GS-SLAM 系统仍然把表征均匀分配在整个可见场景上,把机载算力浪费在与当前任务无关的区域。这个约束在机器人团队中还会叠加——智能体之间的通信链路本身就是受限资源,传不动一整份重建。
此前的降本工作有三条路线,但分配准则全是几何的:事后压缩与剪枝(全局显著性、二阶敏感度、局部区分度)、多细节层次 LOD(按相机距离选高斯子集)、以及在线建图系统(按演化几何与跟踪不确定性调整稠密化)。准则不外乎全局显著性、相机距离、局部冗余、光度误差——没有一条考虑机器人任务需要什么。结果就是:被要求"给墙边的植物浇水"的机器人,可能把大量表征容量分配给了天花板,而不是任务真正发生的地方。
生物视觉天生是非均匀的:中央凹编码一小块高敏区,周边提供粗糙脚手架,而观察者的任务决定眼睛看向哪里。GaussLite 主张把这一原则迁移到在线 3DGS——表征容量跟随任务,而不是跟随几何。作者指出这是首个接受自然语言任务输入、在线进行空间分配的 3DGS 系统,也是首个把该原则扩展到机器人团队的工作。
方法:三个组件
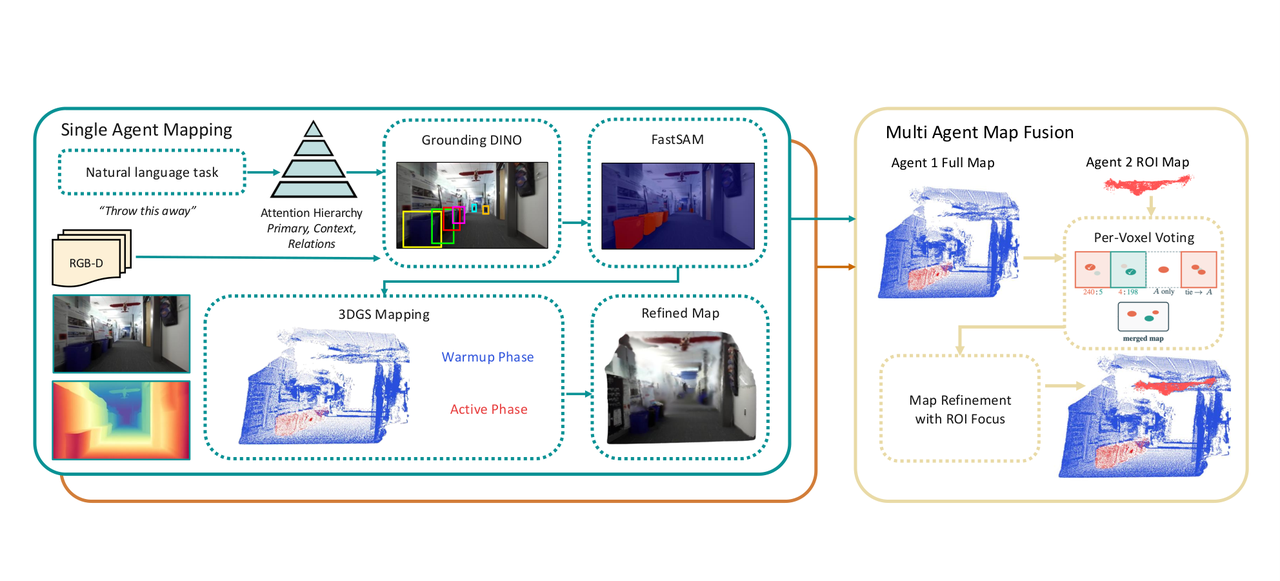
图 2:系统总览。任务描述被一次性解析为结构化的「物体—关系」图;逐帧由开放词汇检测器与分割器产生注意力掩膜,在建图循环内调制高斯的播种、初始化与优化。
场景表征:给每个高斯加两个任务变量
沿用标准 3DGS,场景表示为 $N$ 个各向异性三维高斯 $\mathcal{G}=\{G_i\}_{i=1}^N$,每个由均值 $\mu_i\in\mathbb{R}^3$、协方差 $\Sigma_i = R_i S_i S_i^{\top} R_i^{\top}$(分解为旋转 $R_i$ 与对角尺度 $S_i$)、不透明度 $\alpha_i\in[0,1]$ 与颜色 $c_i\in[0,1]^3$ 参数化。渲染使用可微光栅化器输出彩色图 $\hat{I}$、深度图 $\hat{D}$ 与 alpha 累积图 $\hat{\alpha}$。
在此之上,每个 $G_i$ 额外携带两个不可微的任务相关变量:
- 活跃标志 $a_i\in\{0,1\}$:在播种时由二值相关性掩膜设定,决定 $G_i$ 在活跃优化阶段是否接收梯度;
- 活跃优化计数器 $\kappa_i\in\mathbb{N}$:$G_i$ 每处于活跃集一次迭代就加一,用作多智能体融合时的权重。
组件一:任务条件注意力前端
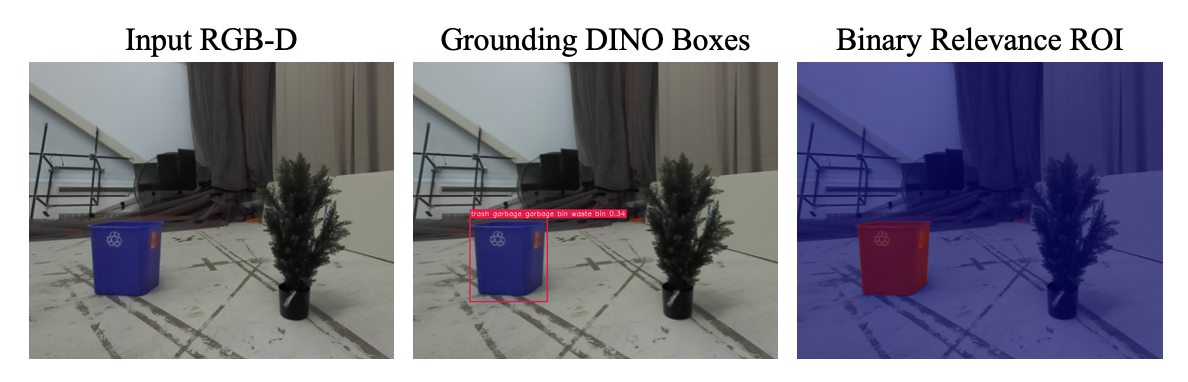
图 3:Replica 上的任务到注意力前端。Grounding DINO 检测任务相关物体,FastSAM 产生像素级掩膜,空间滤波剔除与 3D 地图不一致的检测。
1) 结构化任务解析。给定自由格式任务描述 $\mathcal{T}$,用轻量指令微调 LLM(Phi-3-mini,38 亿参数)配 few-shot schema 一次性解析出结构化任务图:
$$\mathcal{G}_{\text{task}} = \{\mathcal{O}_{\text{target}},\ \mathcal{O}_{\text{anchor}},\ \mathcal{R}\}$$
其中 $\mathcal{O}_{\text{target}}$ 是目标名词短语,$\mathcal{O}_{\text{anchor}}$ 是空间参照物,$\mathcal{R}$ 是形如 $r(t,a)$ 的二元空间谓词。论文实现两个谓词:NEAR(欧氏距离低于阈值)与 ON(目标质心高于锚定物质心且 $xy$ 投影重叠)。作者限定为基于质心的谓词,因为它们在部分观测下仍然良定义;INSIDE、BEHIND 等更丰富的谓词需要更完整的物体几何,留待未来工作。解析每个任务只跑一次(<4 秒),产出查询集 $Q=\mathcal{O}_{\text{target}}\cup\mathcal{O}_{\text{anchor}}$。
2) 开放词汇接地点与分割。在每个由运动触发的关键帧上,用 Grounding DINO 结合查询集 $Q$ 产生 2D 包围盒,滤掉占图像比例过大的检测;再由 FastSAM 把盒子精化为像素级掩膜并按 IoU 匹配。在两次检测帧之间,先前的盒子通过 3D 视锥角点重投影、再由 FastSAM 重新分割,避免每帧都跑完整的 Grounding DINO 前向。
3) 3D 空间滤波。空间谓词是关系性的,需要目标与锚定物的 3D 位置。对每个检测 $i$,把 2D 掩膜质心通过当前高斯地图渲染出的深度提升到世界坐标,得到 3D 质心 $c_i$,再对锚定物质心评估谓词:
$$\text{keep}(i) = \bigwedge_{r\in\mathcal{R}} \text{pred}_r\big(c_i,\ \{c_j : j \in \text{anchors}(r)\}\big)$$
4) 逐像素相关性图。掩膜合并为二值的逐像素相关性图 $w(u,v)\in\{0,1\}$。每个新高斯在其播种像素处继承活跃标志 $a_i$:活跃高斯($a_i=1$)获得集中的优化资源,背景高斯($a_i=0$)则充当粗糙脚手架。
组件二:相关性驱动的播种
系统构建在 Gaussian-SLAM 建图器之上,把相机位姿视为外部输入(Replica 用仿真真值位姿,校园数据集用 DLIO 的激光惯性里程计),从而把建图贡献与位姿估计解耦。每帧通过反投影采样的深度像素贡献 $N$ 个新高斯。三个组件决定种子预算及其空间布局:
1) ROI 种子预算(SB)。按 ROI 分配比例 $\rho\in[0,1]$ 把种子预算在 ROI 与背景像素间切分:
$$N_{\text{ROI}} = \lfloor \rho N \rfloor,\qquad N_{\text{bg}} = N - N_{\text{ROI}}$$
既把高斯集中到任务相关几何上,又保留粗糙背景脚手架用于几何锚定与自由空间覆盖。
2) 分层初始尺度(SIS)。两个耦合细节:其一,背景像素通过分层采样抽取——把非 ROI 图像区域切成 $\sqrt{N_{\text{bg}}}\times\sqrt{N_{\text{bg}}}$ 网格、每格一个抖动样本,消除固定预算下均匀随机采样的结块伪影;其二,每个新高斯以单位旋转、观测 RGB 颜色、不透明度 $\alpha_0=0.5$ 初始化,初始尺度正比于局部最近邻中位距离 $s_0$,并按分层乘以系数:
$$s_{\text{init}} = \log(s_0 \cdot m_{\tau}), \qquad m_{\tau} = \begin{cases} 0.5 & \text{ROI seed} \\ 0.7 & \text{background seed} \end{cases}$$
ROI 侧更小的尺度允许更精细的细节;背景侧减小的尺度防止 alpha 渗染到相邻 ROI 像素。在有限的逐帧迭代预算下,优化器无法把过大的高斯收缩回去,所以「从小开始」是关键。
3) 梯度聚焦稠密化(GFD)。在 SB 分配的预算与 SIS 施加的格子里,格内像素选择偏向高频图像内容:对亮度通道做 Sobel 滤波得到边缘幅值图 $E(u,v)=\lVert\nabla I(u,v)\rVert$,转成格内采样分布——每个分层格内的播种像素以正比于 $E(u,v)+\epsilon$ 的概率被采样。效果是把高斯放到物体轮廓与纹理表面——那里光度残差最高,增加密度带来的保真度收益最大。
组件三:相关性驱动的优化
1) ROI 优化(ROI)。每帧先在全图上跑一次短暂的 warmup 优化,随后在剩余迭代中把渲染与梯度更新都限制在活跃高斯($a_i=1$)。把背景高斯排除在活跃阶段之外,既把优化预算集中到任务相关几何,又因为光栅化器只处理 ROI 子集而把每迭代渲染成本大致砍半。每个活跃高斯的计数器 $\kappa_i$ 在活跃阶段的每次迭代中递增。逐迭代损失为绝对误差颜色项、深度项与 SSIM 项的组合:
$$\mathcal{L} = \mathcal{L}_{\text{color}} + \lambda_d \mathcal{L}_{\text{depth}} + \lambda_s\big(1 - \text{SSIM}(\hat{I}, I)\big)$$
颜色与 SSIM 项在 warmup 阶段于全图评估,在活跃阶段则限制在 ROI 像素与渲染足迹的交集上。
2) 多视图优化(MVO)。每次迭代从最近关键帧窗口中均匀随机采样训练视图,防止被当前视点过度监督,迫使 ROI 高斯在最近的多次观测间保持一致。优化用 Adam 配分组学习率,并套用标准 3DGS 的克隆/分裂/剪枝方案——克隆与分裂出的子代继承父代的 $a_i$。
多智能体融合:只交换「投过资的那一小块」
当多个智能体带着不同任务规格建同一环境的地图时,它们的高斯地图可以无需重新优化就融合。计数器 $\kappa_i$ 作为融合权重:在融合时对逐体素的活跃优化计数投票,选出每个区域训练得更好的来源。于是智能体只需交换各自地图中承载了有效信息的小块任务特化子集。
实验结果
Replica(8 个场景,24 个场景-任务对)
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| MonoGS | 26.10 | 0.815 | 0.287 |
| Gaussian-SLAM | 26.62 | 0.823 | 0.303 |
| SplaTAM | 28.56 | 0.821 | 0.230 |
| GaussLite | 29.81 | 0.835 | 0.230 |
GaussLite 在 8 个场景中的 7 个上 PSNR 领先,平均 ROI PSNR 分别超过 SplaTAM +1.25 dB、Gaussian-SLAM +3.19 dB、MonoGS +3.71 dB。所有基线都在匹配的高斯预算(Replica 上限 1M)与实时逐帧预算(RTX 4070 Laptop GPU,≤0.5 s/帧)下运行,因此增益完全来自「预算花在哪里」。
Campus 真实数据集(3 场景,9 个场景-任务对)
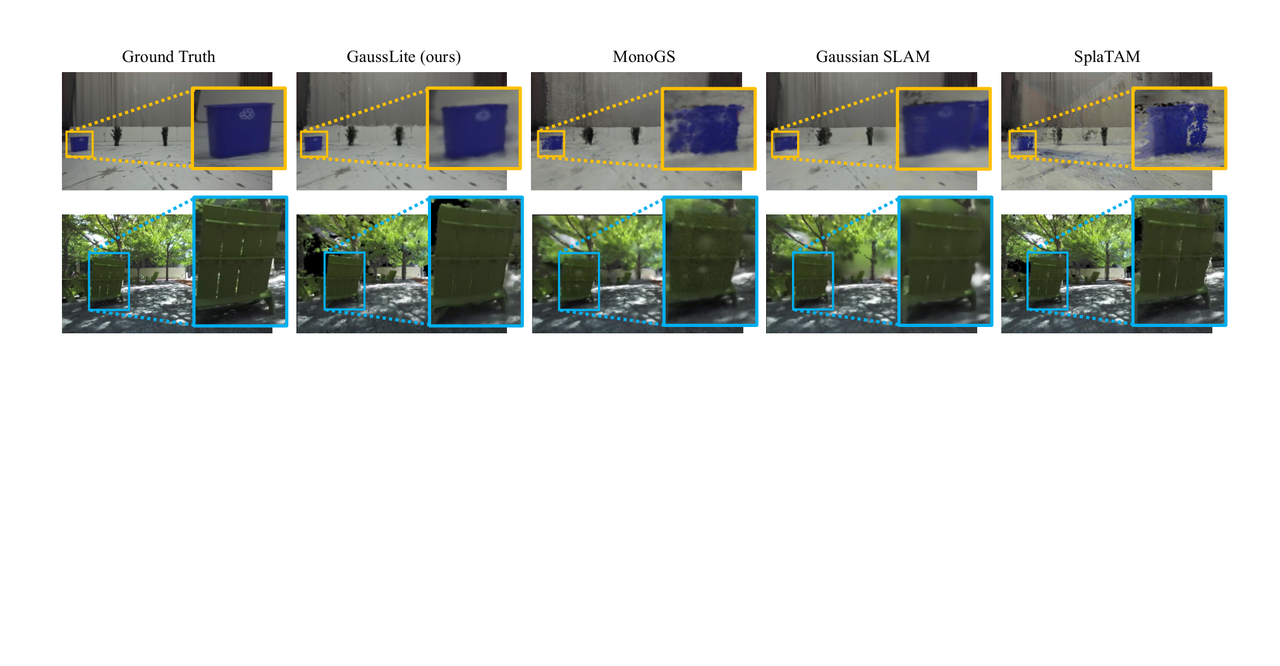
图 4:Campus 数据集定性对比。插图为任务相关区域裁剪。GaussLite 在任务相关区域保留了精细细节(接近真值),基线则在均匀分配后丢失前景细节,或边缘更锐但 ROI 内像素保真度更低。
| 方法 | 单智能体 PSNR ↑ | 多智能体融合 PSNR ↑ |
|---|---|---|
| Gaussian-SLAM | 18.06 | 17.41 |
| SplaTAM | 19.35 | 18.19 |
| MonoGS | 19.06 | 18.27 |
| GaussLite | 21.05 | 21.38 |
校园数据集用 Clearpath Husky 移动机器人配 ZED 2i 双目相机采集,在 RTX 4070 Laptop GPU 上处理,位姿由 DLIO 在线提供——展示的是真实机载感知下的性能。单智能体平均 ROI PSNR 分别超过 SplaTAM +1.70 dB、Gaussian-SLAM +2.99 dB、MonoGS +1.99 dB。作为参照:ROI PSNR 每 +1 dB,约等于任务相关区域内均方误差下降 21%;本文观测到的改善从这一档位起,最高相当于约 74% 的 MSE 下降。
多智能体融合
在 Campus Highbay 与 Campus Outdoor 两段真实序列上对比三种策略:朴素拼接(Combine Maps)、逐体素投票(Voxel Voting,按 $\kappa_i$ 加权选择)、以及投票后加一轮短联合优化的 Refinement。在高bay序列上,仅逐体素投票就达到接近专家特化的质量,再加精炼可推到更高水平;整体相对朴素拼接平均 +3.42 dB,而只共享平均 7.08% 的地图。
组件消融
| SB | MVO | ROI | SIS | GFD | Replica | Campus |
|---|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | ✗ | ✗ | 34.57 | 21.50 |
| ✓ | ✗ | ✗ | ✗ | ✗ | 35.95 | 21.61 |
| ✓ | ✓ | ✗ | ✗ | ✗ | 35.96 | 22.55 |
| ✓ | ✓ | ✓ | ✗ | ✗ | 36.87 | 22.15 |
| ✓ | ✓ | ✓ | ✓ | ✗ | 38.05 | 25.14 |
| ✓ | ✓ | ✓ | ✓ | ✓ | 38.23 | 25.25 |
消融用真值 ROI 掩膜运行,以隔离各预算分配组件的贡献、排除上游检测误差。每个组件都带来正的 ROI PSNR 增益。最大的两次跃升来自 ROI 种子预算(Replica +1.38 dB)与分层初始尺度(Replica +1.18 dB,Campus +2.99 dB)——后者说明在真实世界的深度与曝光噪声下,小初始尺度尤为关键。GFD 在两个数据集上都贡献较小但一致的改善。完整流水线把 ROI PSNR 从 34.57 提到 38.23 dB(Replica)、21.50 提到 25.25 dB(Campus)。与此同时全图 PSNR 会随预算被移出背景而适度下降——这正是任务条件建图刻意要做的取舍。
意义与局限
「把这个扔掉」"] --> B["① 一次性 LLM 解析
Phi-3-mini 提取
目标物 / 锚定物 / 空间谓词"] B --> C["② 逐帧接地
Grounding DINO 检测
FastSAM 分割"] C --> D["③ 3D 空间滤波
NEAR / ON 谓词筛选"] D --> E["④ 逐像素相关性掩膜 w(u,v)"] E --> F["⑤ 相关性驱动播种
SB 预算切分 · SIS 分层小尺度
GFD 边缘加权"] F --> G["⑥ 相关性驱动优化
warmup 全图 → 仅活跃高斯
MVO 多视图随机采样"] G --> H["任务特化地图
每高斯带 a_i 与 κ_i"] H --> I["⑦ 多智能体融合
逐体素 κ_i 投票
仅共享 7.08% 地图"]
核心思想值得记住的一句话是:场景表征不该是被动的重建,而应是「任务条件化的认知地图」——保真度跟随机器人的目的。这在资源受限的机载平台上格外实用:同样的算力与内存,花在任务真正发生的地方。
三个可迁移的工程要点。其一,「语言解析一次、接地逐帧」的分层把昂贵的 LLM 调用摊薄到整个序列(<4 s/任务),同时用检测帧间的 3D 视锥重投影 + 重分割避免每帧跑检测器——这是在线系统里很典型的成本优化手法。其二,初始尺度要小:在有限的逐帧迭代预算下,优化器无法把过大的高斯收缩回去,所以「从小开始」比事后剪枝更有效,这一点在真实噪声下(Campus +2.99 dB)比在干净仿真(Replica +1.18 dB)中重要得多。其三,用「活跃优化计数」当融合权重是一个很轻量的多智能体地图合并方案——每个高斯自带一个计数器,投票即可选出每个区域训练得更好的来源,无需全局重优化,通信量还只有 7.08%。
局限方面,论文明确指出:系统不会在任务中途改变时重新分配预算——此前被低精度重建的区域,若不重新观测或离线精修,就无法追溯性地提升。此外从设计上也能看到边界:空间谓词目前只实现 NEAR 与 ON 两个基于质心的谓词,INSIDE、BEHIND 等需要更完整几何的谓词被推迟;前端依赖 Grounding DINO 与 FastSAM 的开放词汇能力,检测误差会直接传导到相关性掩膜(消融中特意用真值掩膜来隔离这一影响);任务相关性的提升以全图 PSNR 的适度下降为代价,若下游同时需要全局保真度则需权衡。