
拆解 vLLM:高吞吐大模型推理系统的解剖学——从引擎循环、Paged Attention 到多节点分布式服务
vLLM 核心贡献者的系统拆解:从离线单进程引擎讲起,逐层覆盖调度器、Paged Attention 的 KV cache 分块、continuous batching、prefix caching、投机解码、P/D 分离,再到多卡执行器、两节点四副本分布式服务栈,以及 TTFT/ITL/goodput 与 roofline 模型下延迟与吞吐的取舍。
拆解 vLLM:高吞吐大模型推理系统的解剖学
来源:Aleksa Gordíc,2025 年 8 月 29 日
本文逐步拆解构成现代高吞吐大模型推理系统的核心组件与高级特性,并以 vLLM 作为具体的参考实现。
这是一个系列的第一篇。它先铺全局,再逐层加细节(倒金字塔式展开),让你在不被细枝末节淹没的前提下,对整个系统形成准确的高层心智模型。后续文章会深入各个子系统。
全文分为五个部分:
- LLM Engine 与 Engine Core:vLLM 的基本盘——调度、paged attention、continuous batching。
- 高级特性:chunked prefill、prefix caching、guided decoding 与 speculative decoding、prefill/decode 分离(P/D 分离)。
- 向上扩展:从单卡执行到多卡执行。
- 服务层:分布式、并发化的 Web 骨架。
- 基准测试与自动调参:如何度量延迟与吞吐。
关于范围的说明。本文分析基于 commit 42172ad(2025 年 8 月 9 日),聚焦 V1 引擎;V0 现已废弃,不过研究 V0 对理解项目的演进仍很有价值,很多概念也延续了下来。由于类名和函数签名可能变动,本文强调核心思想而不是精确的 API。目标读者:所有好奇前沿大模型引擎如何工作的人,以及有兴趣给 vLLM、SGLang 等项目贡献代码的人。
LLM Engine 与 Engine Core
LLM engine 是 vLLM 最基本的构建块。它本身就已经能支撑高吞吐推理,但只在离线场景下成立:还不能把它作为 Web 服务对外提供给客户。
贯穿全文的示例是下面这段离线推理代码,改编自 basic.py:
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
两个环境变量把配置钉死:
VLLM_USE_V1="1"                    # 使用 V1 引擎
VLLM_ENABLE_V1_MULTIPROCESSING="0" # 单进程运行在这套设置下,引擎是离线的(没有 Web 或分布式骨架)、同步的(全部执行都发生在一个阻塞进程里)、单卡的(没有数据并行、张量并行、流水线并行或专家并行,DP/TP/PP/EP 都等于 1),并且跑的是标准 transformer。Jamba 这类混合模型需要更复杂的混合 KV cache 内存分配器。接下来本文会以这个基线为起点,逐步搭建出一个在线、异步、多卡、多节点的推理系统,但服务的仍然是标准 transformer。
这个示例只做两件事:实例化一个引擎,然后在它上面调用 generate 从给定 prompt 中采样。先看构造函数。
LLM Engine 构造函数
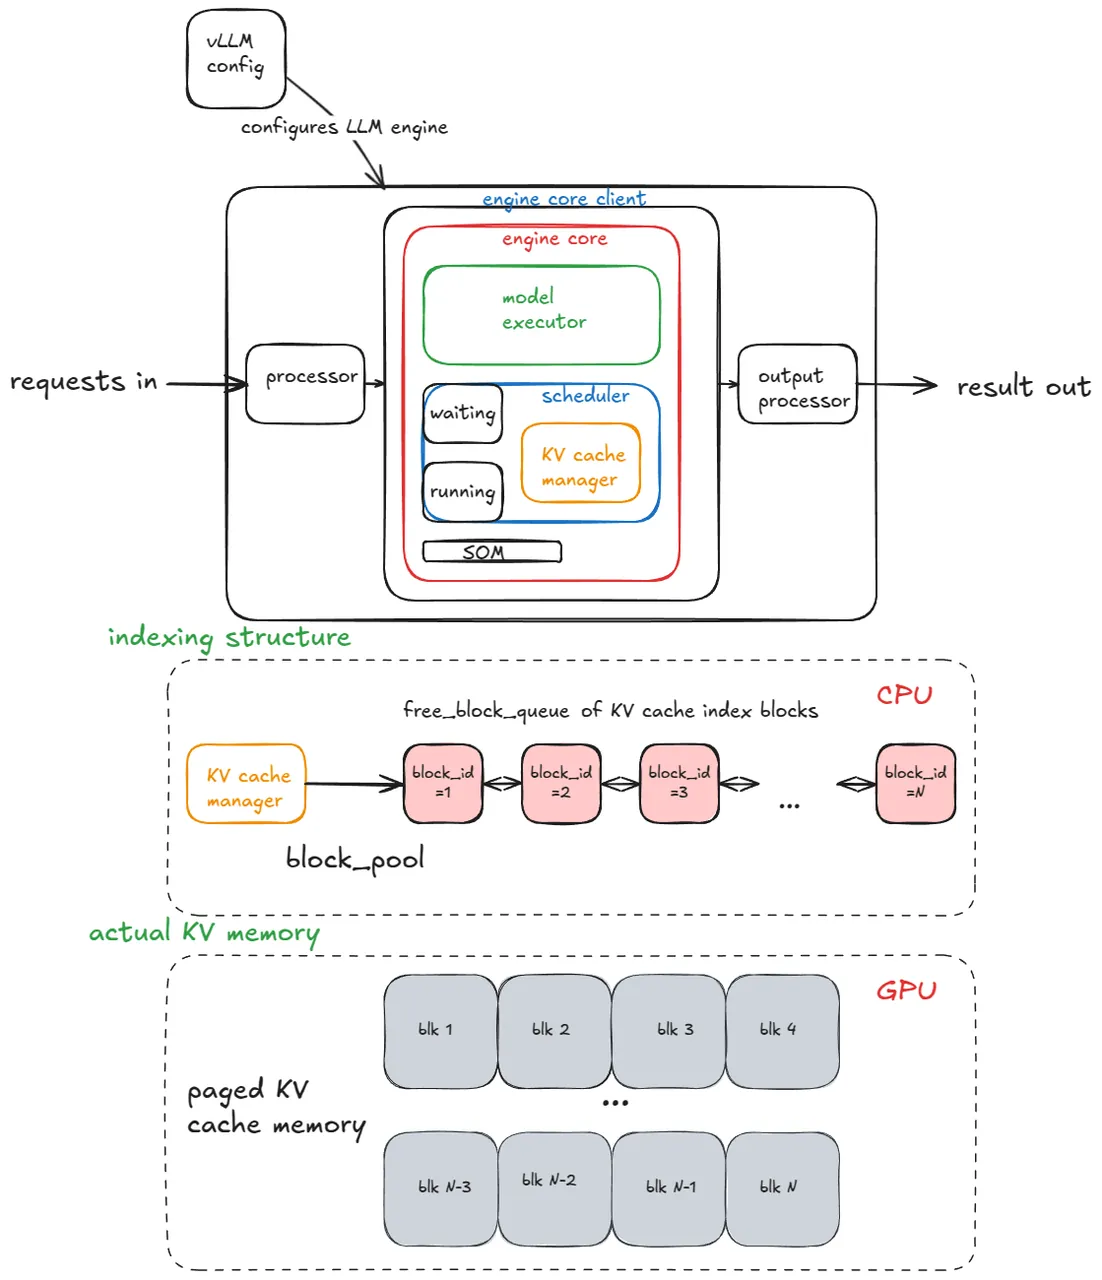
引擎的主要组件有:
- vLLM config:所有用于配置模型、缓存、并行度等的旋钮。
- Processor(处理器):通过校验、分词与处理,把原始输入变成
EngineCoreRequest对象。 - Engine core client:本例中是
InprocClient,它基本上等同于EngineCore;后面它会成长为DPLBAsyncMPClient,也就是支撑大规模服务的客户端。 - Output processor(输出处理器):把原始的
EngineCoreOutputs转换成用户看到的RequestOutput。
Engine core 自身又由若干子组件构成:
- Model executor(模型执行器):驱动模型的前向计算。这里是
UniProcExecutor,单卡上只有一个 worker 进程;后面它会成长为支持多卡的MultiProcExecutor。 - Structured output manager(结构化输出管理器):用于 guided decoding,下文详述。
- Scheduler(调度器):决定哪些请求进入下一个 engine step。它进一步包含策略设置(FCFS 先到先服务,或 priority 高优先级请求先服务)、waiting 与 running 两个队列,以及 KV cache manager——paged attention 的核心。
KV cache manager 维护一个 free_block_queue:可用 KV cache block 的池子,根据显存大小与 block size 不同,量级常常在数十万个 block。在 paged attention 中,这些 block 充当把 token 映射到其已计算 KV cache block 的索引结构。
对于标准 transformer 层(非 MLA),每个 block 的 KV cache 字节开销计算方式如下:
2 (key/value) * block_size (default=16) * num_kv_heads * head_size * dtype_num_bytes (e.g. 2 for bf16)在 model executor 构造期间会创建一个 Worker 对象,并执行三个关键过程。后面换成 MultiProcExecutor 时,同样这三个过程会在不同 GPU 上的每个 worker 进程里独立执行。
1. Init device(初始化设备)。给 worker 分配一个 CUDA 设备(例如 cuda:0),并检查模型 dtype 是否被支持(例如 bf16)。根据请求的 gpu_memory_utilization(0.8 表示总显存的 80%)校验显存是否足够。设置分布式相关配置(DP / TP / PP / EP)。实例化 model_runner,它持有 sampler、KV cache,以及 input_ids、positions 等前向计算缓冲区。实例化 InputBatch 对象,它持有 CPU 侧的前向计算缓冲区、用于 KV cache 索引的 block table,以及采样元数据。
2. Load model(加载模型)。实例化模型结构,加载权重,调用 model.eval()(PyTorch 的推理模式),并可选地对模型调用 torch.compile()。
3. Initialize KV cache(初始化 KV cache)。取得每层的 KV cache spec。历史上对于同构 transformer 这永远是 FullAttentionSpec,但混合模型(滑动窗口、transformer/SSM 混合如 Jamba)让它变复杂了,参见 Jenga。接着跑一次 dummy 的 profiling 前向,并对 GPU 内存做快照,算出可用显存里能放下多少 KV cache block;分配、reshape 并把 KV cache 张量绑定到各注意力层;准备好注意力元数据(例如把后端设为 FlashAttention),供前向计算时 kernel 消费。除非传了 --enforce-eager,引擎会为每个 warmup batch size 跑一次 dummy run 并捕获 CUDA graph。CUDA graph 把整串 GPU 工作记录成一个 DAG,之后的前向计算直接重放这些预先烘焙好的图,从而削减 kernel launch 开销、改善延迟。
这里抽象掉了许多底层细节,但这些正是后文会反复引用的核心部件。
generate 函数
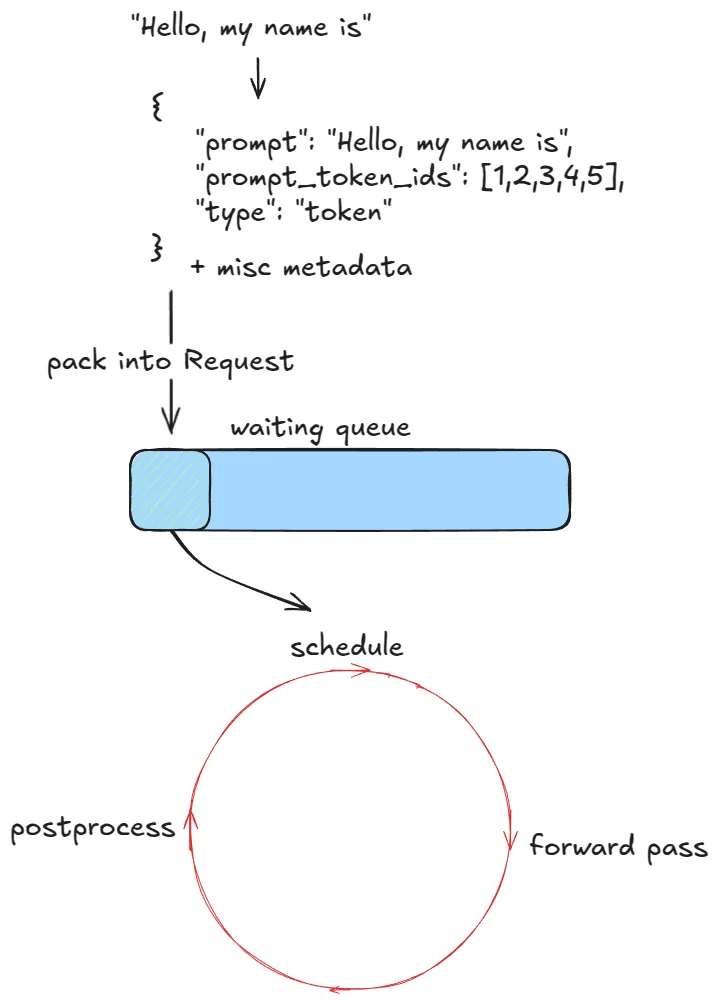
第一步是校验请求并把它们喂进引擎。对每个 prompt,vLLM 会:
- 创建唯一的 request ID,并记录它的到达时间。
- 调用输入预处理器对 prompt 分词,返回一个包含
prompt、prompt_token_ids和类型(text、tokens、embeds 等)的字典。 - 把这些信息打包成
EngineCoreRequest,加上优先级、采样参数和其他元数据。 - 把请求传进 engine core,后者把它包装成
Request对象、将状态置为WAITING,并加入调度器的 waiting 队列(FCFS 用 append,priority 用 heap-push)。
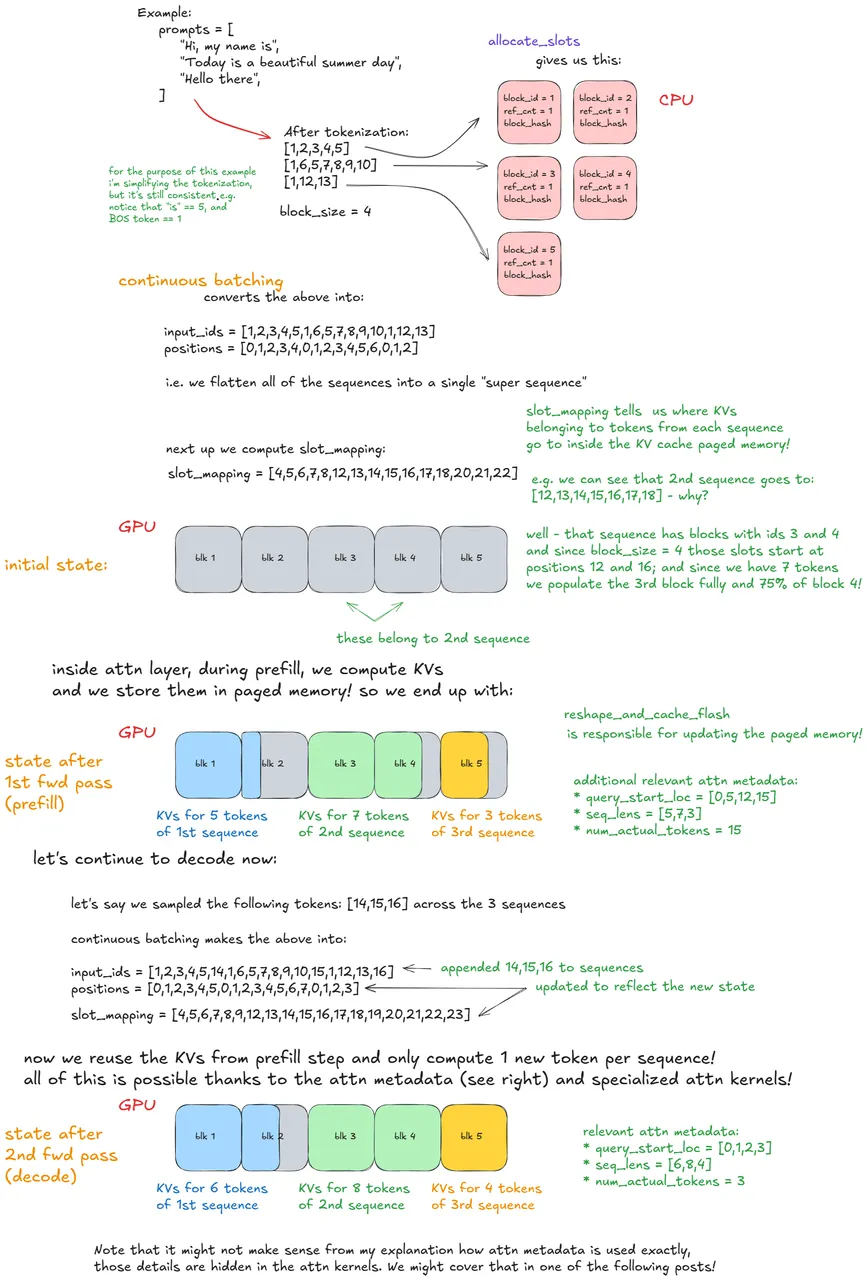
到这里引擎已经被喂好,执行可以开始了。在同步示例中,这批初始 prompt 就是要处理的全部请求:没有机制在运行中途注入新请求。异步引擎则支持这一点,这正是 continuous batching(连续批处理)的含义——每个 step 之后,新旧请求都会被一起考虑。由于前向计算会把整个 batch 拉平成一个长序列,且自定义 kernel 能高效处理它,因此即便是同步引擎,continuous batching 在根本上也是被支持的。
接下来,只要还有请求要处理,引擎就反复调用它的 step() 函数。每个 step 有三个阶段:
- Schedule(调度):选出本 step 要跑哪些请求(decode,和/或(分块的)prefill)。
- Forward pass(前向计算):跑模型并采样 token。
- Postprocess(后处理):把采样到的 token ID 追加到每个
Request,做 detokenize,并检查停止条件。如果请求已结束,就清理(例如把它的 KV cache block 归还给free_block_queue)并提前返回输出。
停止条件。请求在以下情况停止:超过长度上限(
max_model_length或它自己的max_tokens);采样到的 token 是 EOS ID(除非启用了ignore_eos,这在基准测试中很有用——你想强制生成固定数量的输出 token);采样到的 token 命中采样参数里stop_token_ids中的任意一个;或输出里出现了 stop string,此时输出会在第一个 stop string 处被截断,请求在引擎内被 abort。注意stop_token_ids会保留在输出里,而 stop string 不会。
在流式模式下,中间 token 会在生成时即刻发出;这一点暂时略过。
调度器
推理引擎处理两类主要负载:
- Prefill 请求:对所有 prompt token 做一次前向计算。这类通常是算力受限(compute-bound)的(阈值取决于硬件与 prompt 长度)。结束时,从最后一个 token 位置的概率分布里采样出一个 token。
- Decode 请求:只对最新的一个 token 做前向计算,因为更早的 KV 向量都已经缓存好了。这类是显存带宽受限(memory-bandwidth-bound)的,因为要算出一个 token,仍然需要加载全部 LLM 权重(以及 KV cache)。
下文的基准测试一节会分析 GPU 性能的 roofline 模型,它能更细致地解释 prefill 与 decode 的这两种性能画像。得益于更聪明的设计选择,V1 调度器可以在同一个 step 里混合两类请求;V0 引擎则一次只能处理 prefill 或 decode 中的一种。
调度器优先处理 decode 请求,也就是已经在 running 队列里的那些。对每个这样的请求,它计算要生成的新 token 数(不总是 1,因为有 speculative decoding 和 async scheduling),调用 KV cache manager 的 allocate_slots 函数,并从 token 预算里减掉这个数量。之后它处理 waiting 队列里的 prefill 请求:取得已计算 block 的数量(如果 prefix caching 关闭则为 0),调用 allocate_slots,把请求从 waiting 弹出并移入 running、状态置为 RUNNING,再更新 token 预算。
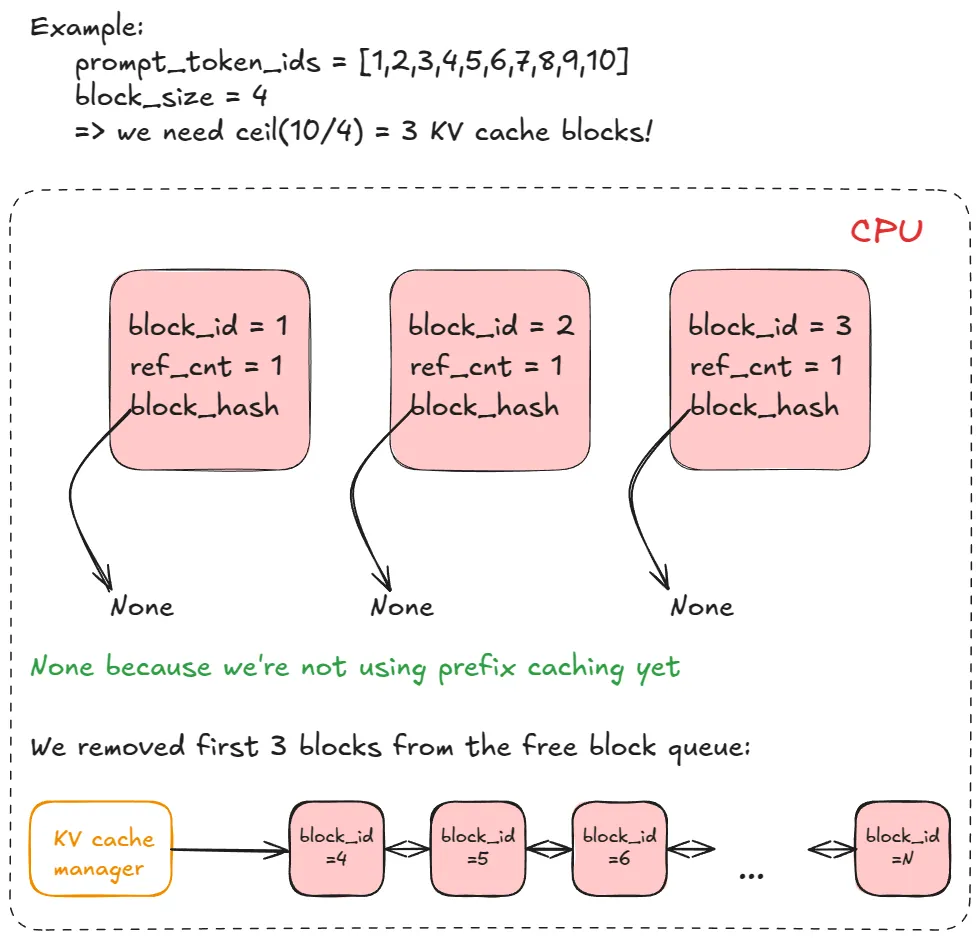
allocate_slots 自己做三件事:
- 计算 block 数量:确定需要新分配多少个 KV cache block(n)。默认每个 block 存 16 个 token,所以一个有 17 个新 token 的 prefill 请求需要
ceil(17/16) = 2个 block。 - 检查可用性:如果 manager 的池子里 block 不够,就提前退出。根据请求是 decode 还是 prefill,引擎可能尝试 recompute 抢占(swap 抢占在 V0 里支持),通过驱逐低优先级请求、调用
kv_cache_manager.free把它们的 block 归还池子;也可能跳过本次调度、继续执行。 - 分配 block:通过 KV cache manager 的 coordinator,从池子里取出前 n 个 block(即前面提到的
free_block_queue双向链表),并存入req_to_blocks——把每个request_id映射到其 KV cache block 列表的字典。
执行前向计算
引擎调用 model executor 的 execute_model,它委派给 Worker,后者再委派给 model runner。主要步骤是:
- 更新状态:从
input_batch中剔除已结束的请求,更新与前向计算相关的元数据,例如每个请求用于索引 paged KV cache 内存的 KV cache block。 - 准备输入:把缓冲区从 CPU 拷到 GPU,计算 position,构建
slot_mapping,构造注意力元数据。 - 前向计算:用自定义的 paged attention kernel 跑模型。所有序列被拉平并拼接成一条很长的「超级序列」。位置索引和注意力掩码保证每个序列只关注自己的 token,这正是无需右侧 padding 就能实现 continuous batching 的原因。
- 收集末位 token 状态:取出每个序列最后一个位置的 hidden state 并计算 logits。
- 采样:按采样配置(greedy、temperature、top-p、top-k 等)从算出的 logits 中采样 token。
前向计算这一步有两种执行模式:eager 模式,在启用 eager 执行时跑标准的 PyTorch 前向;「captured」模式,在没有强制 eager 时重放预先捕获的 CUDA graph(这些图是在引擎构造期的 initialize KV cache 过程中捕获的)。
高级特性:扩展核心引擎逻辑
基本引擎流程就位之后,高级特性就容易对号入座了。抢占(preemption)、paged attention 和 continuous batching 前面已经讲过,接下来依次是 chunked prefill、prefix caching、基于文法约束有限状态机的 guided decoding、speculative decoding,以及 prefill/decode 分离。
Chunked prefill(分块预填充)
chunked prefill 通过把长 prompt 的 prefill 步骤切成更小的块来处理长 prompt。没有它,一个超长请求可能独占一个 engine step,让其他 prefill 请求无法运行,从而推迟所有其他请求、抬高它们的延迟。
举个具体例子:设每个块包含 n(=8)个 token,用小写字母标注、以连字符分隔。一个长 prompt P 可能形如 x-y-z,其中 z 是不完整的块(比如 2 个 token)。那么为 P 执行完整的 prefill 至少需要 3 个 engine step(如果它在某个 step 里没有被调度执行,还可能更多),而且只有在最后一个分块 prefill step 里才会采样出一个新 token。
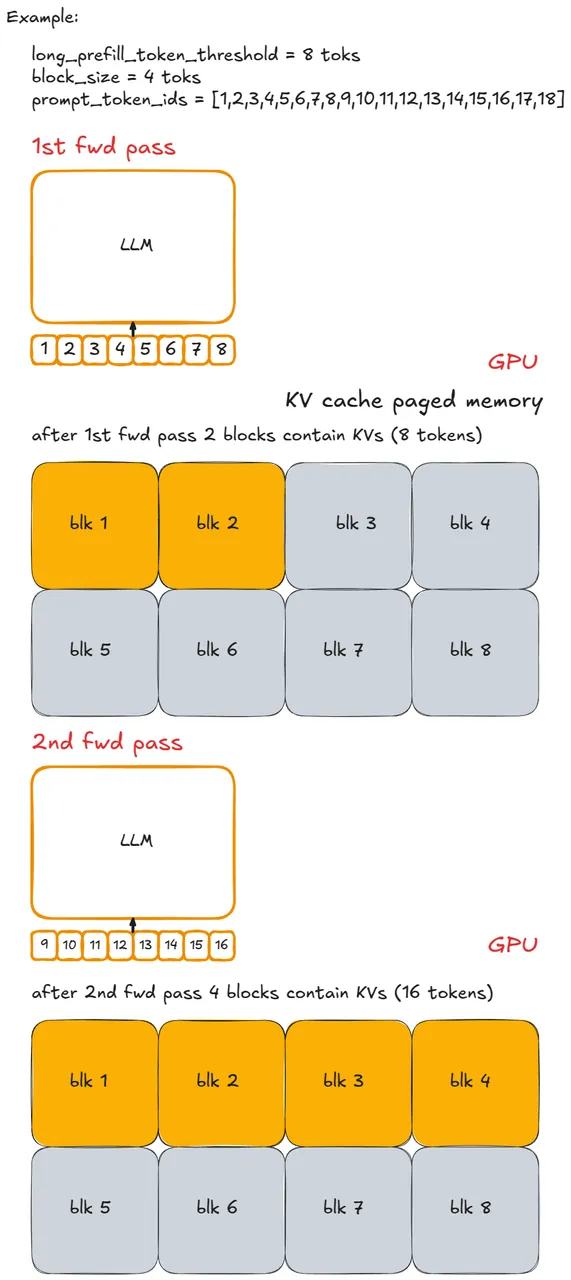
实现非常直接:给每个 step 的新 token 数设上限。如果请求的数量超过 long_prefill_token_threshold,就把它重置为恰好这个值,剩下的交给前面描述过的索引逻辑。在 vLLM V1 中,把 long_prefill_token_threshold 设为正整数即可启用 chunked prefill。严格来说,即使不设它也可能发生:如果 prompt 长度超过 token 预算,引擎会截断它并跑一次分块 prefill。
Prefix caching(前缀缓存)
为了解释 prefix caching 的工作原理,把最初的代码示例稍作改动:
from vllm import LLM, SamplingParams

long_prefix = "<a piece of text that is encoded into more than block_size tokens>"

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(long_prefix + prompts[0], sampling_params)
    outputs = llm.generate(long_prefix + prompts[1], sampling_params)

if __name__ == "__main__":
    main()
prefix caching 避免重复计算多个 prompt 在开头共享的那些 token——所以叫前缀。关键在 long_prefix:它被定义为任何长于一个 KV cache block(默认 16 个 token)的前缀。为简化,假设 long_prefix 的长度恰好是 n x block_size(n ≥ 1),也就是与 block 边界完美对齐;否则就得重算 long_prefix_len % block_size 个 token,因为不完整的 block 无法被缓存。
没有 prefix caching 时,每来一个携带相同 long_prefix 的新请求,都要重算全部 n x block_size 个 token。有了 prefix caching,这些 token 只算一次,它们的 KV 存进 paged KV cache 内存后被复用,于是只有新的 prompt token 需要处理。这能加速 prefill 请求(对 decode 没有帮助)。
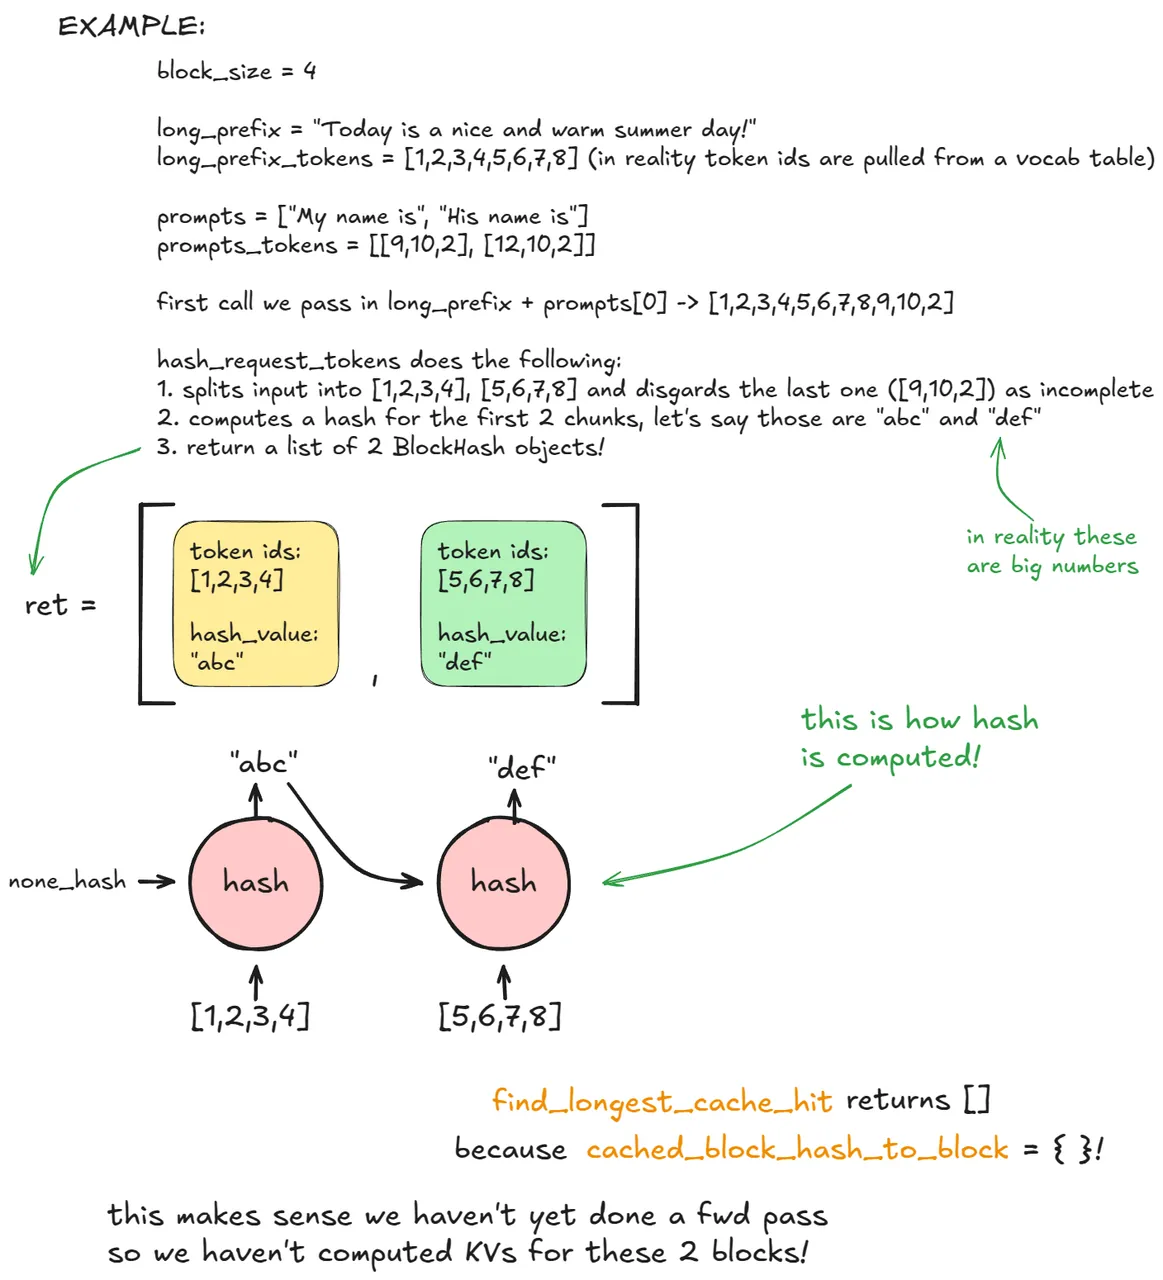
这在 vLLM 里是怎么发生的?在第一次 generate 调用的调度阶段,kv_cache_manager.get_computed_blocks 会调用 hash_request_tokens:
- 该函数把
long_prefix + prompts[0]切成 16 个 token 一块。 - 对每个完整的块计算一个哈希,用内置 hash 或者 SHA-256(后者更慢但碰撞更少)。哈希把前一个 block 的哈希、当前 token 以及可选元数据组合在一起。
- 可选元数据包括多模态哈希、LoRA ID 和 cache salt。注入到第一个 block 哈希里的 cache salt 能保证只有携带同一个 salt 的请求才能复用这些 block。
- 每个结果都存成一个
BlockHash对象,同时包含哈希和它的 token ID;函数返回一个 block 哈希列表,并保存在self.req_to_block_hashes[request_id]中。
接着引擎调用 find_longest_cache_hit,检查这些哈希里有没有已经存在于 cached_block_hash_to_block 中的。第一个请求不会有任何命中。
然后引擎调用 allocate_slots,它再调用 coordinator.cache_blocks,把新的 BlockHash 条目与已分配的 KV block 关联起来,并记录进 cached_block_hash_to_block。之后前向计算会把上面分配的那些 block 对应的 KV 填进 paged KV cache 内存。
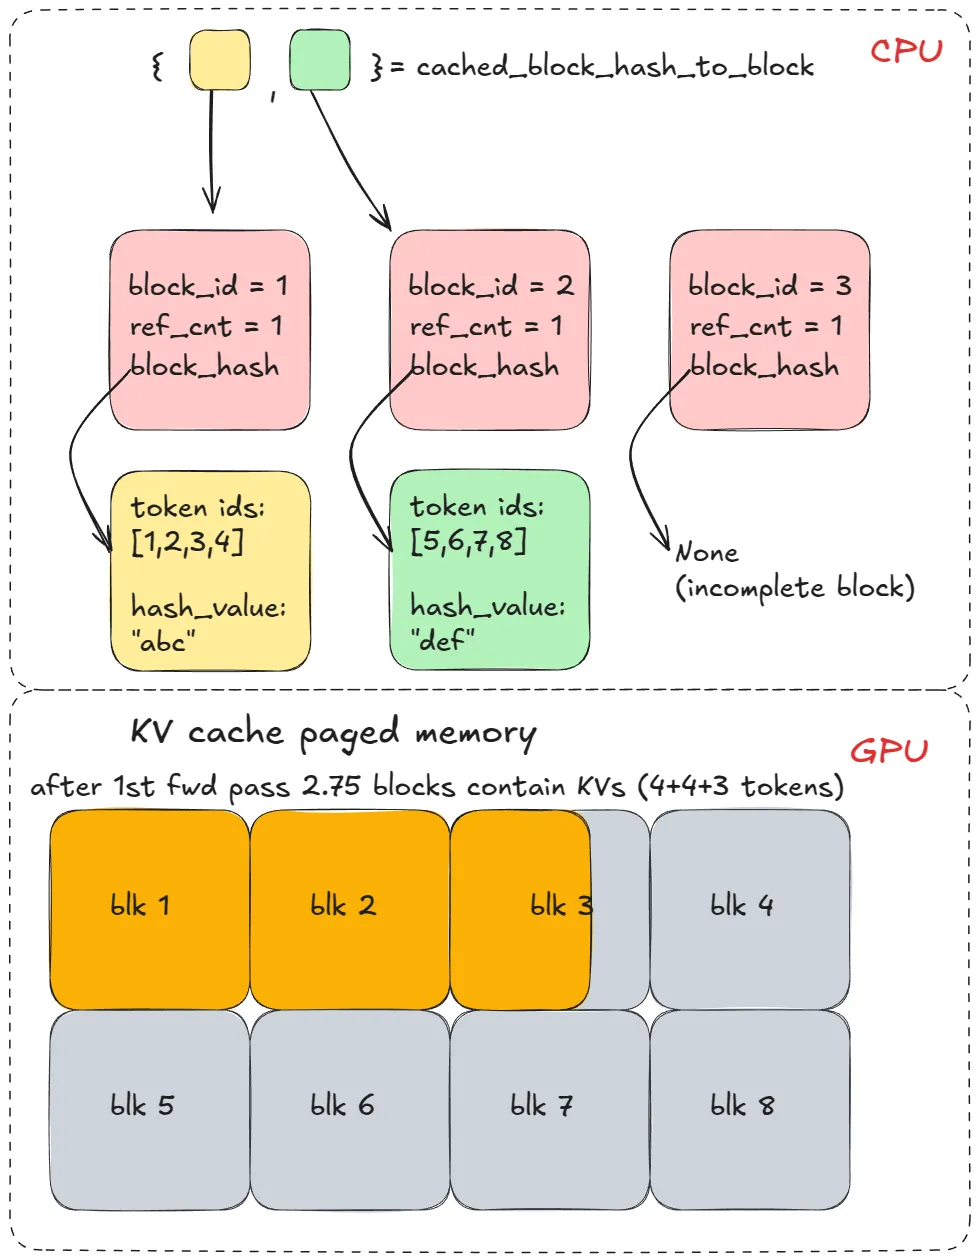
经过许多 engine step 之后,请求还会分配更多 KV cache block,但这对本例无关紧要,因为前缀在 long_prefix 之后立刻就分叉了。
第二次用相同前缀调用 generate 时,上述步骤重复,但这一次 find_longest_cache_hit 会为全部 n 个 block 找到匹配(通过线性搜索),引擎于是直接复用这些 KV block。
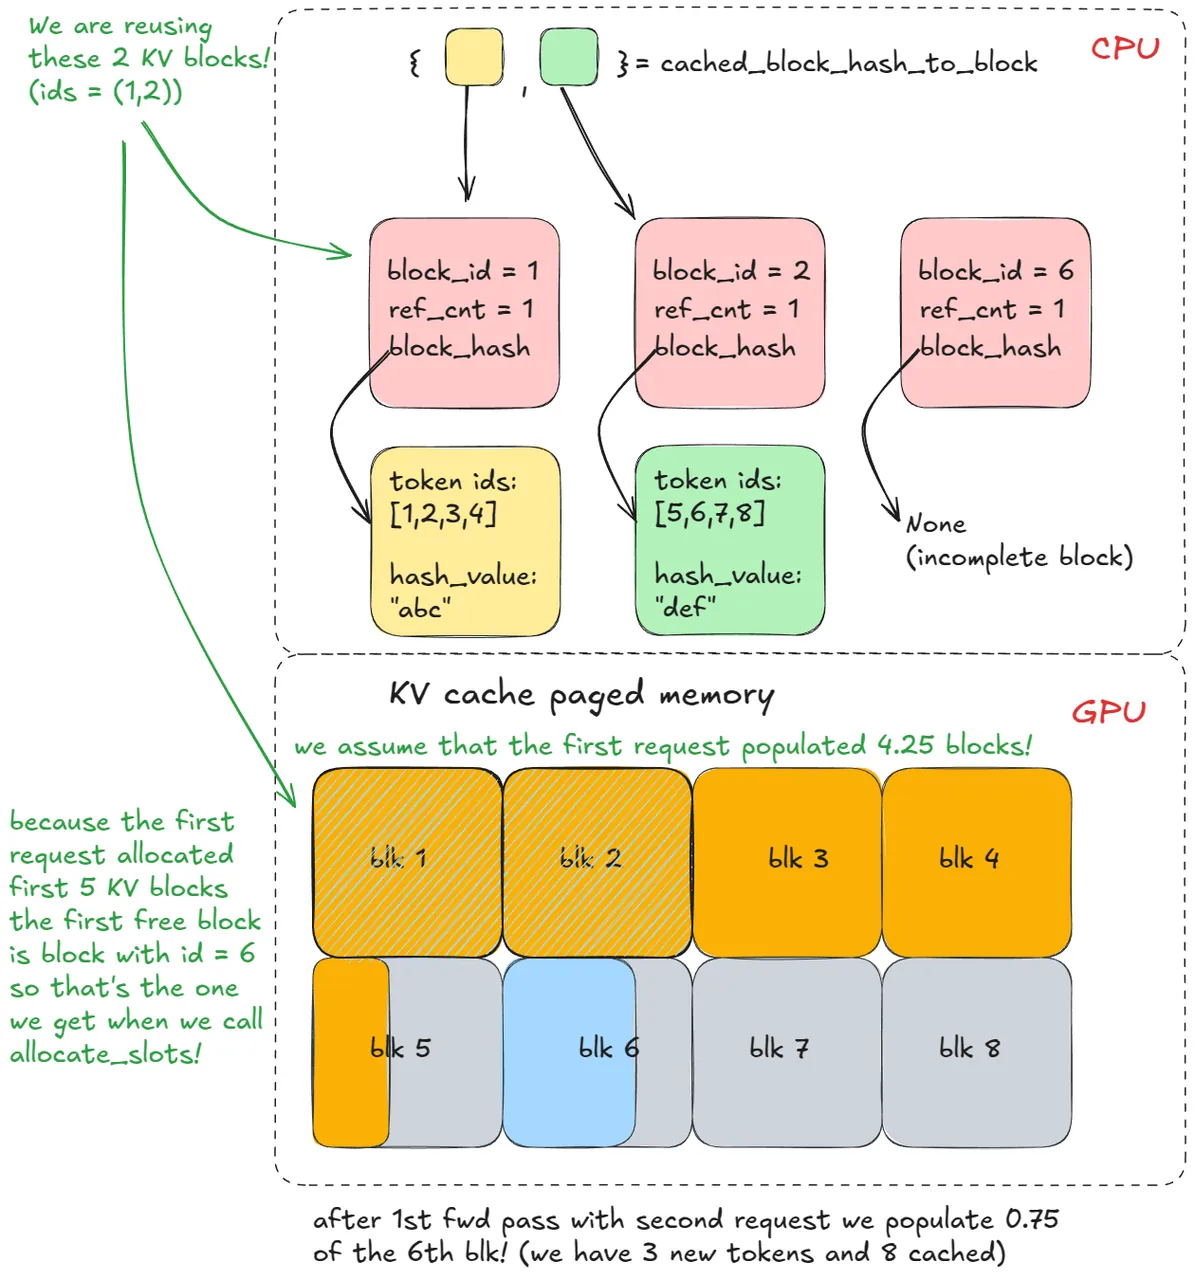
如果原请求还活着,这些 block 的引用计数会递增(比如到 2)。在本例中原请求已经完成,所以 block 已被归还池子、引用计数重置为 0。由于它们仍能从 cached_block_hash_to_block 里取到,KV cache manager 知道它们是有效的(其逻辑就是这样设计的),于是只需把它们从 free_block_queue 里再摘出来。
进阶说明。KV cache block 只在一种情况下失效:当它即将从
free_block_queue(从左端弹出)被重新分配,而引擎发现这个 block 仍带有关联哈希、且存在于cached_block_hash_to_block中时。此刻引擎会清掉该 block 的哈希,并从cached_block_hash_to_block中移除对应条目,确保它不能再通过 prefix caching 被复用(至少对那个旧前缀而言)。
这就是 prefix caching 的要义:已经见过的前缀不要重算,直接复用它的 KV cache。而且如果你理解了这个例子,也就理解了 paged attention 是怎么工作的。prefix caching 默认开启,关闭方式是 enable_prefix_caching = False。
Guided decoding(受限解码,FSM)
guided decoding 是一种在每个解码步骤用基于文法的有限状态机约束 logits 的技术,从而保证只有文法允许的 token 才可能被采样。它的威力很大:从正则文法(乔姆斯基 3 型,例如任意 regex 模式)一直到上下文无关文法(2 型,覆盖大多数编程语言),都可以强制约束。
为了不那么抽象,从最简单的例子开始,它建立在之前的代码之上:
from vllm import LLM, SamplingParams
from vllm.sampling_params import GuidedDecodingParams

prompts = [
    "This sucks",
    "The weather is beautiful",
]

guided_decoding_params = GuidedDecodingParams(choice=["Positive", "Negative"])
sampling_params = SamplingParams(guided_decoding=guided_decoding_params)

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0")

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
在这个玩具示例里(假设按字符级分词):prefill 阶段 FSM 掩掉 logits,使只有 "P" 或 "N" 可行。如果采样到 "P",FSM 就走向 "Positive" 分支;下一步只允许 "o",依此类推。
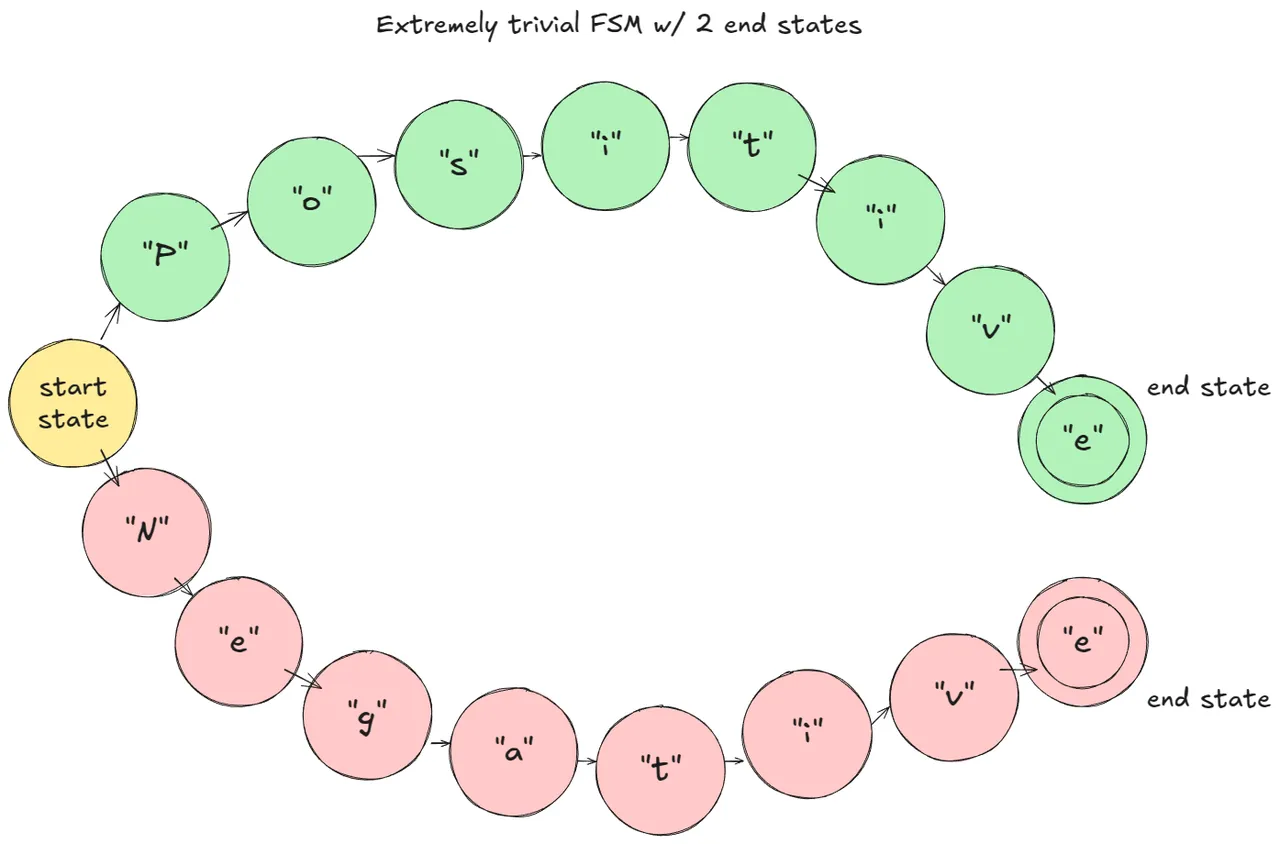
在 vLLM 内部,流程是这样的:
- LLM engine 构造时会创建一个
StructuredOutputManager;它能访问 tokenizer,并维护一个_grammar_bitmask张量。 - 添加请求时,其状态被置为
WAITING_FOR_FSM,grammar_init选择后端编译器,例如 xgrammar(注意这些后端是第三方代码)。 - 该请求的文法被异步编译。
- 调度期间,如果异步编译已完成,状态切换为
WAITING,request_id被加入structured_output_request_ids;否则它被放进skipped_waiting_requests,等下一个 engine step 重试。 - 调度循环之后(仍在调度内部),如果存在 FSM 请求,
StructuredOutputManager会请后端准备/更新_grammar_bitmask。 - 前向计算产出 logits 之后,xgrammar 的 torch-compile 函数把 bitmask 展开到词表大小(32 倍展开率,因为用的是 32 位整数),并把不允许的 logits 掩成 –∞。
- 采样出下一个 token 之后,通过
accept_tokens推进该请求的 FSM。从图上看,就是移动到 FSM 图中的下一个状态。
第 6 步值得再解释清楚。如果 vocab_size = 32,_grammar_bitmask 就是一个整数;它的二进制表示编码了哪些 token 被允许("1")、哪些被禁止("0")。例如 "101…001" 展开成长度 32 的数组 [1, 0, 1, …, 0, 0, 1],值为 0 的位置其 logits 被设为 –∞。词表更大时会使用多个 32 位字,并相应地展开、拼接。后端(例如 xgrammar)负责依据当前 FSM 状态产出这些位模式。
说明。这里的大部分复杂度都藏在 xgrammar 这样的第三方库里。
下面是一个更简单的例子,vocab_size = 8、用 8 位整数:
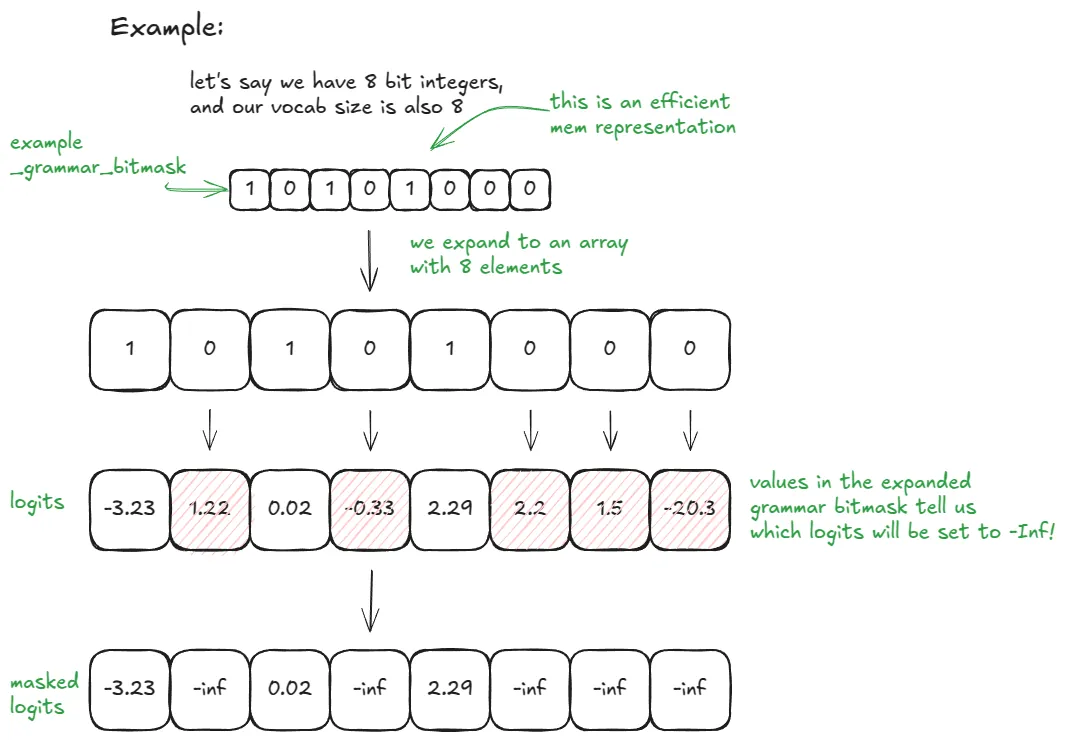
在 vLLM 中,传入所需的 guided_decoding 配置即可启用这一切。
Speculative decoding(投机解码)
在自回归生成中,每个新 token 都需要大模型做一次前向计算。这很昂贵——每一步都要重新加载并应用全部模型权重,只为了算出一个 token(假设 batch size 为 1,一般情况下是 B)。
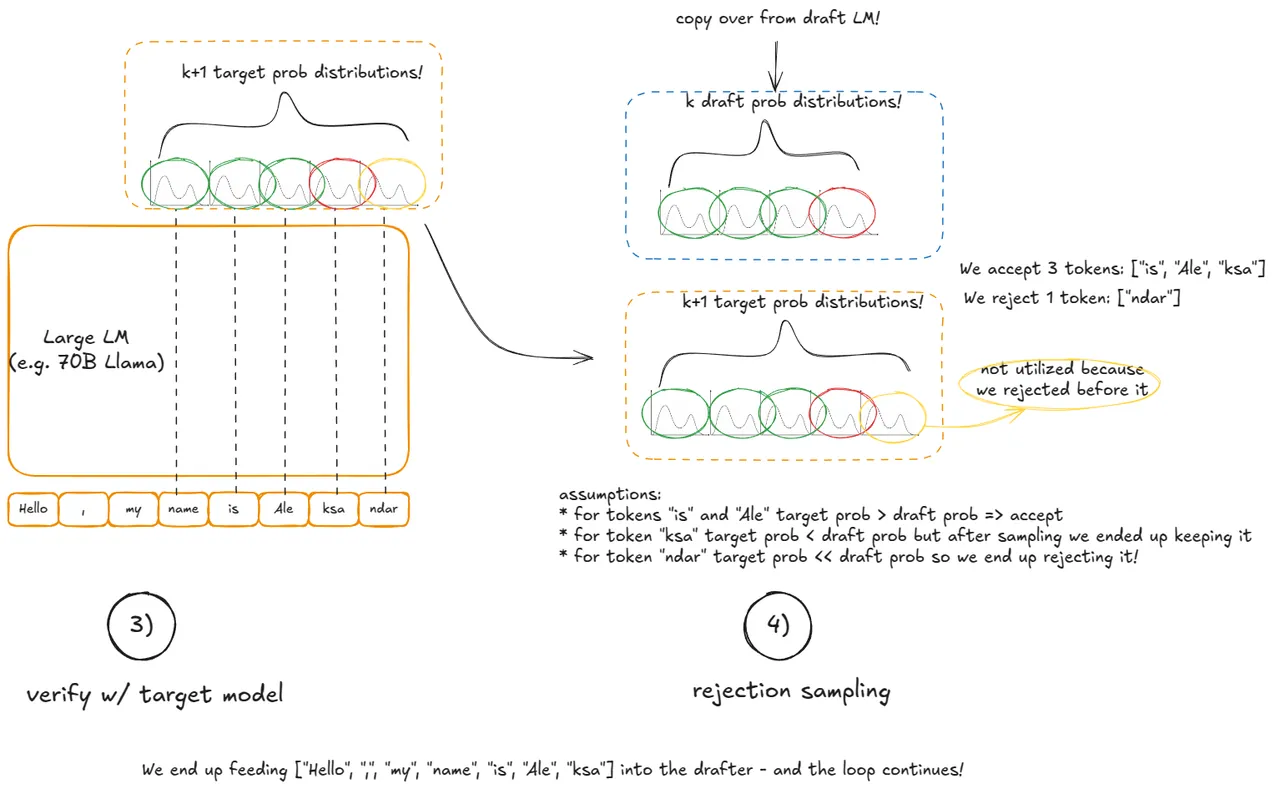
speculative decoding 通过引入一个更小的草稿模型(draft LM)来加速。草稿模型廉价地提出 k 个 token。我们的目的从来不是从小模型里采样——它只负责猜测候选续写,真正决定什么有效的仍然是大模型。步骤如下:
- 起草(Draft):在当前上下文上跑小模型,提出 k 个 token。
- 验证(Verify):在「上下文 + k 个草稿 token」上跑一次大模型。这会产出这 k 个位置外加一个额外位置的概率,于是得到 k+1 个候选。
- 接受/拒绝:从左到右遍历 k 个草稿 token——如果大模型给该草稿 token 的概率 ≥ 草稿模型给它的概率,就接受;否则以
p_large(token)/p_draft(token)的概率接受它。遇到第一次拒绝就停止,或者接受全部 k 个草稿 token。 - 如果 k 个草稿 token 全部被接受,还可以「免费」从大模型采样出第 (k+1) 个 token,因为那个分布已经算出来了。
- 如果发生了拒绝,就在该位置构造一个重新平衡的分布(
p_large - p_draft,最小值截断到 0,归一化到和为 1),并从中采样最后一个 token。
为什么这样有效。虽然用小模型来提候选,但接受/拒绝规则保证了在期望意义上,序列的分布与「逐 token 从大模型采样」完全一致。也就是说 speculative decoding 在统计上等价于标准自回归解码,但可能快得多——因为一次大模型前向最多可以产出 k+1 个 token。
vLLM V1 不支持「LLM 草稿模型」这种方法,而是实现了更快但精度更低的提议方案:n-gram、EAGLE 和 Medusa。每种一句话概括:
- n-gram:取最后
prompt_lookup_max个 token,在序列中查找此前是否出现过匹配;如果找到,就提议该匹配之后跟着的 k 个 token;否则缩小窗口重试,直到prompt_lookup_min。当前实现返回第一个匹配之后的 k 个 token。引入近因偏好、把搜索方向反过来(即用最后一个匹配)似乎更自然? - EAGLE:对大模型做「模型手术」——保留 embedding 和 LM head,把 transformer 主体换成一个轻量 MLP,再把它微调成一个廉价草稿模型。
- Medusa:在大模型之上(LM head 之前的 embedding 上)训练若干辅助线性头,并行预测接下来 k 个 token,用这些头提议 token,比单独跑一个小 LM 更高效。
下面是在 vLLM 中用 ngram 作为草稿方法调用 speculative decoding 的方式:
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

sampling_params = SamplingParams(temperature=0.8, top_p=0.95)

speculative_config={
    "method": "ngram",
    "prompt_lookup_max": 5,
    "prompt_lookup_min": 3,
    "num_speculative_tokens": 3,
}

def main():
    llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", speculative_config=speculative_config)

    outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
    main()
在 vLLM 里,setup 发生在引擎构造期:init device 创建一个 drafter(草稿模型,例如 NgramProposer)和一个 rejection_sampler(其中一部分用 Triton 写成);load model 加载草稿模型权重(对 n-gram 而言是空操作)。
之后在 generate 函数里(假设来了一个全新请求):
- 用大模型跑常规的 prefill 步骤。
- 前向计算与标准采样之后,调用
propose_draft_token_ids(k),从草稿模型采样出 k 个草稿 token。 - 把它们存进
request.spec_token_ids(更新请求元数据)。 - 下一个 engine step,当该请求处于 running 队列时,把
len(request.spec_token_ids)加到「新 token」计数上,这样allocate_slots会为前向计算预留足够的 KV block。 - 把
spec_token_ids拷进input_batch.token_ids_cpu,组成「上下文 + 草稿」token。 - 通过
_calc_spec_decode_metadata计算元数据(它会从input_batch.token_ids_cpu拷贝 token、准备 logits 等),然后在草稿 token 上跑一次大模型前向。 - 不再从 logits 做常规采样,而是用
rejection_sampler从左到右接受/拒绝,产出output_token_ids。 - 重复第 2 到第 7 步,直到满足停止条件。
内化这套流程最好的方式是打开调试器、在代码库里单步走一遍,不过本节加上下面两张图应该能让你有个大致感觉。
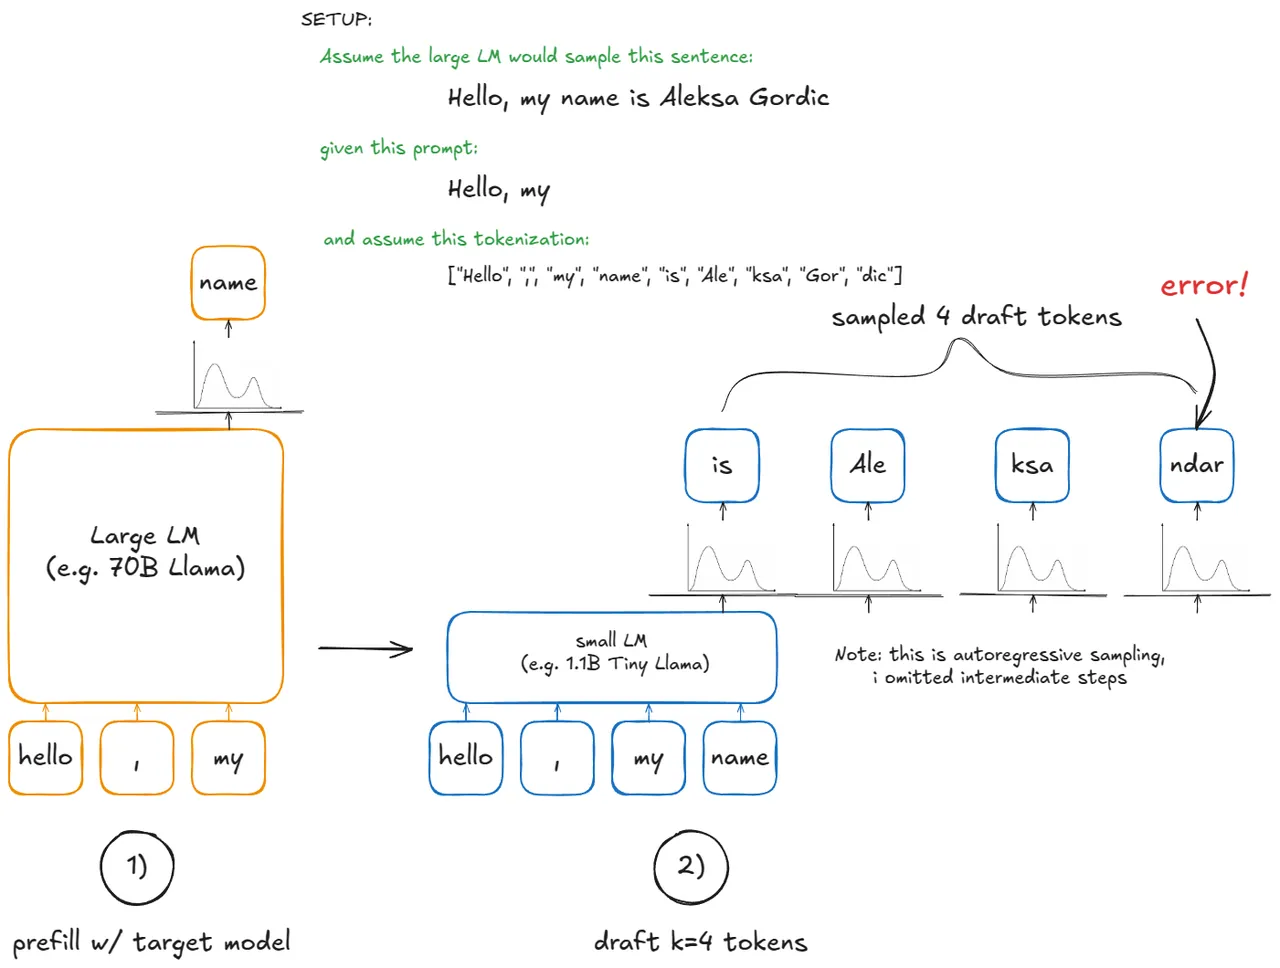
Prefill/Decode 分离(Disaggregated P/D)
P/D 分离的动机前面已经暗示过了。prefill 和 decode 的性能画像非常不同(算力受限 vs 显存带宽受限),所以把它们的执行分开是合理的设计。它能更精细地控制延迟——包括 TTFT(首 token 时间)和 ITL(token 间延迟),下文基准测试一节还会再谈。
实践中会运行 N 个 vLLM prefill 实例和 M 个 vLLM decode 实例,并根据实时请求构成对它们做自动扩缩容。prefill worker 把 KV 写入一个专用的 KV cache 服务,decode worker 从中读取。这就把「长而突发」的 prefill 与「平稳且对延迟敏感」的 decode 隔离开了。
为清晰起见,下面的示例依赖 SharedStorageConnector,这是一个用于说明机制的调试用 connector 实现。connector 是 vLLM 处理实例之间 KV 交换的抽象;connector 接口尚不稳定,近期已有一些改进计划,其中部分可能带来破坏性变更。
我们启动 2 个 vLLM 实例(GPU 0 做 prefill,GPU 1 做 decode),然后在它们之间传输 KV cache:
import os
import time
from multiprocessing import Event, Process
import multiprocessing as mp

from vllm import LLM, SamplingParams
from vllm.config import KVTransferConfig

prompts = [
    "Hello, my name is",
    "The president of the United States is",
]

def run_prefill(prefill_done):
  os.environ["CUDA_VISIBLE_DEVICES"] = "0"

  sampling_params = SamplingParams(temperature=0, top_p=0.95, max_tokens=1)

  ktc=KVTransferConfig(
      kv_connector="SharedStorageConnector",
      kv_role="kv_both",
      kv_connector_extra_config={"shared_storage_path": "local_storage"},
  )

  llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)
  llm.generate(prompts, sampling_params)

  prefill_done.set()  # 通知 decode 实例:KV cache 已就绪

  # 让 prefill 节点保持运行,以防 decode 节点还没结束;
  # 否则脚本可能提前退出,导致解码不完整。
  try:
      while True:
          time.sleep(1)
  except KeyboardInterrupt:
      print("Script stopped by user.")

def run_decode(prefill_done):
  os.environ["CUDA_VISIBLE_DEVICES"] = "1"

  sampling_params = SamplingParams(temperature=0, top_p=0.95)

  ktc=KVTransferConfig(
      kv_connector="SharedStorageConnector",
      kv_role="kv_both",
      kv_connector_extra_config={"shared_storage_path": "local_storage"},
  )

  llm = LLM(model="TinyLlama/TinyLlama-1.1B-Chat-v1.0", kv_transfer_config=ktc)

  prefill_done.wait()  # 阻塞等待来自 prefill 实例的 KV cache

  # 内部会先取 KV cache,再开始解码循环
  outputs = llm.generate(prompts, sampling_params)

if __name__ == "__main__":
  prefill_done = Event()
  prefill_process = Process(target=run_prefill, args=(prefill_done,))
  decode_process = Process(target=run_decode, args=(prefill_done,))

  prefill_process.start()
  decode_process.start()

  decode_process.join()
prefill_process.terminate()说明。我也试过 LMCache——最快的生产级 connector(底层用 NVIDIA 的 NIXL),但它仍在前沿阶段,我遇到了一些 bug。由于它的大部分复杂度都在外部仓库里,用
SharedStorageConnector来做讲解更合适。
vLLM 内部的步骤是:
- 实例化:引擎构造期间,connector 在两处被创建——一处在 worker 的 init device 过程中(在 init worker distributed environment 函数下),角色为 "worker";另一处在 scheduler 构造函数里,角色为 "scheduler"。
- 缓存查询:当调度器处理 waiting 队列里的 prefill 请求时(在本地 prefix cache 检查之后),会调用 connector 的
get_num_new_matched_tokens,检查 KV cache 服务器里是否有外部缓存的 token。prefill 在这里总是看到 0;decode 则可能命中缓存。该结果会加到本地计数上,再调用allocate_slots。 - 状态更新:调度器接着调用
connector.update_state_after_alloc,记录哪些请求命中了缓存(对 prefill 是空操作)。 - 构建 meta:调度结束时,调度器调用
meta = connector.build_connector_meta。prefill 把所有请求以is_store=True加入(用于上传 KV);decode 把请求以is_store=False加入(用于拉取 KV)。 - 上下文管理器:前向计算之前,引擎进入一个 KV connector 上下文管理器。进入时调用
kv_connector.start_load_kv:对 decode,它从外部服务器加载 KV 并注入 paged 内存;对 prefill 是空操作。退出时调用kv_connector.wait_for_save:对 prefill,它阻塞直到 KV 上传到外部服务器;对 decode 是空操作。
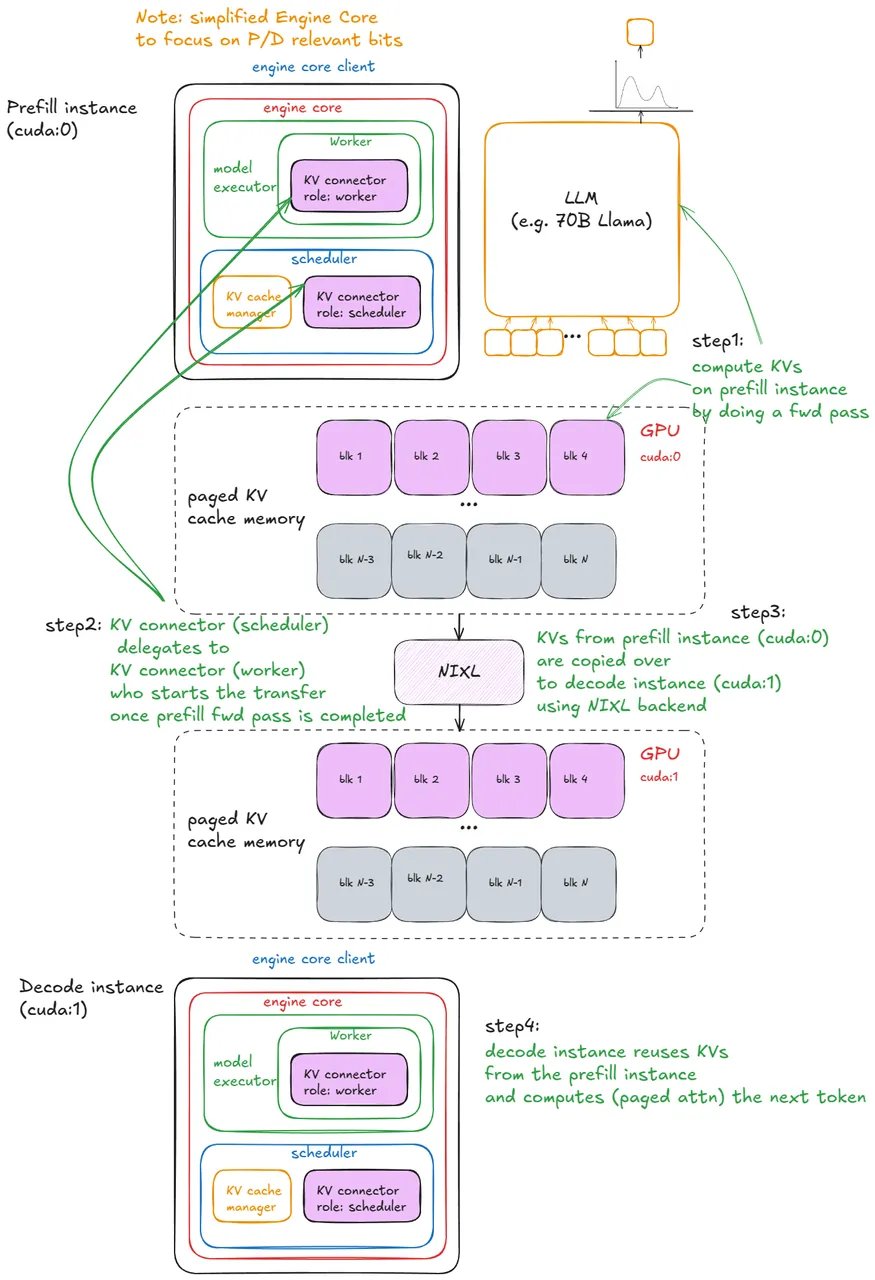
补充说明。对
SharedStorageConnector而言,「外部服务器」其实就是本地文件系统。根据配置不同,KV 传输也可以逐层进行(在每个注意力层之前/之后)。decode 只在其请求的第一步加载一次外部 KV,之后就本地计算并本地存储。
从 UniProcExecutor 到 MultiProcExecutor
核心技术就位后,就可以谈向上扩展了。假设模型权重已经放不进单卡显存。第一个选择是用张量并行把模型切分到同一节点的多个 GPU 上(例如 TP=8)。如果还放不下,下一步就是跨节点的流水线并行。
说明。节点内带宽显著高于节点间带宽,这也是张量并行(TP)通常优先于流水线并行(PP)的原因(PP 通信的数据量确实比 TP 少,这一点也成立)。这里不覆盖专家并行(EP),因为我们聚焦标准 transformer 而非 MoE;也不覆盖序列并行,因为实践中最常用的是 TP 和 PP。
到这一步,需要多个 GPU 进程(worker)以及一个协调它们的编排层。这正是 MultiProcExecutor 提供的东西。
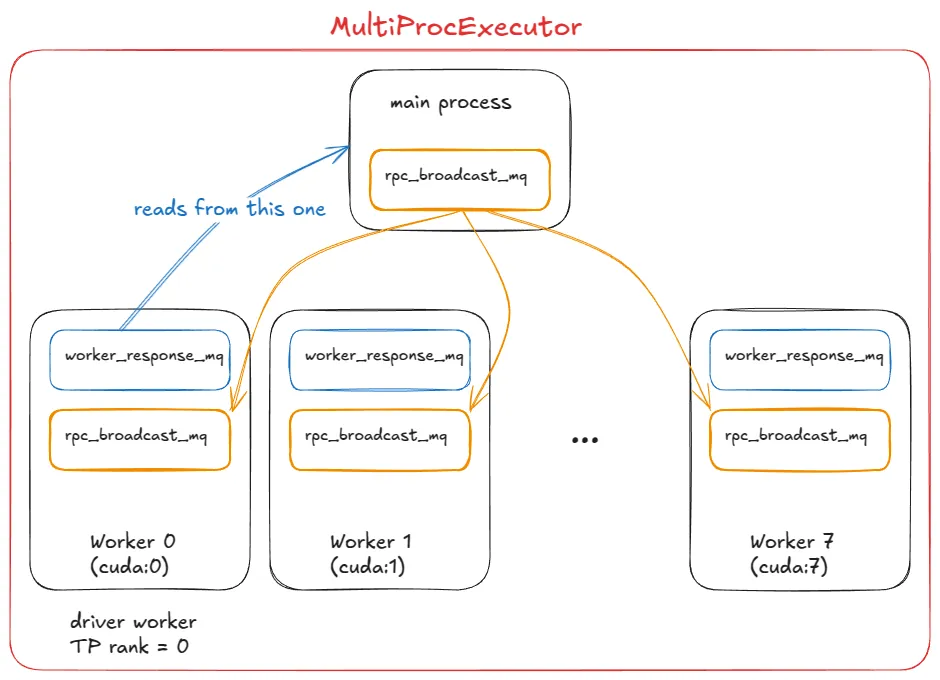
MultiProcExecutor,driver worker 为 rank 0。图:Aleksa Gordíc。在 vLLM 中它是这样工作的:
MultiProcExecutor初始化一个rpc_broadcast_mq消息队列(底层用共享内存实现)。- 构造函数遍历
world_size(例如 TP=8 ⇒world_size=8),通过WorkerProc.make_worker_process为每个 rank 派生一个守护进程。 - 对每个 worker,父进程先创建一个读管道和一个写管道。
- 新进程运行
WorkerProc.worker_main,它实例化一个 worker(经历与UniProcExecutor中相同的 "init device"、"load model" 等过程)。 - 每个 worker 判断自己是 driver(TP 组里的 rank 0)还是普通 worker。每个 worker 都建立两个队列:与父进程共享、用于接收工作的
rpc_broadcast_mq,以及用于回送响应的worker_response_mq。 - 初始化期间,每个子进程通过管道把自己的
worker_response_mq句柄发给父进程。全部收到后父进程解除阻塞——协调到此完成。 - 随后 worker 进入忙循环,阻塞在
rpc_broadcast_mq.dequeue上。有工作项到达时就执行它(与UniProcExecutor中一样,只是现在带着 TP/PP 特定的切分工作),结果通过worker_response_mq.enqueue送回。 - 运行时,请求到达后
MultiProcExecutor把它(非阻塞地)入队到rpc_broadcast_mq,广播给所有子 worker,然后等待指定输出 rank 的worker_response_mq.dequeue来收集最终结果。
从引擎的视角看,什么都没有变——所有这些多进程复杂度都被抽象在一次对 model executor execute_model 的调用之后。UniProcExecutor 的情形下,execute_model 直接导致在 worker 上调用 execute_model;MultiProcExecutor 的情形下,它通过 rpc_broadcast_mq 间接导致在每个 worker 上调用 execute_model。到此,用同一套引擎接口就能跑资源允许的最大模型。
下一步是向外扩展:启用数据并行(DP > 1)把模型复制到多个节点上,加一层轻量的 DP 协调层,在副本之间引入负载均衡,并在前面放一个或多个 API server 来处理进入的流量。
服务 vLLM 的分布式系统
搭建服务基础设施的方式有很多种。为了具体,取一个例子:两个 H100 节点,想在它们之上跑四个 vLLM 引擎。如果模型需要 TP=4,节点可以这样配置。
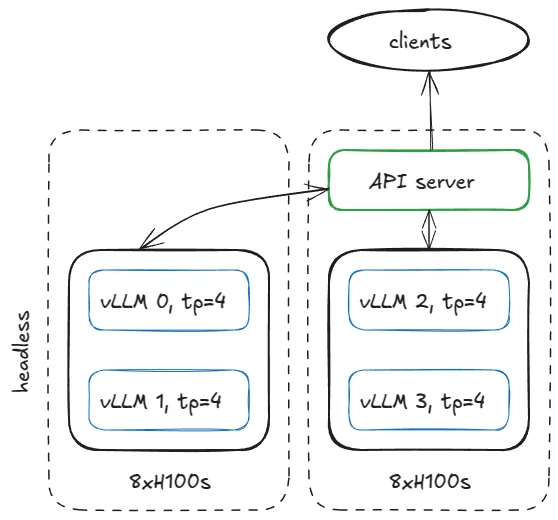
在第一个节点上,以 headless 模式(不带 API server)运行引擎:
vllm serve <model-name>
  --tensor-parallel-size 4
  --data-parallel-size 4
  --data-parallel-size-local 2
  --data-parallel-start-rank 0
  --data-parallel-address <master-ip>
  --data-parallel-rpc-port 13345
  --headless
然后在另一个节点上跑同一条命令,做两处改动:去掉 --headless,并修改 DP 起始 rank。
vllm serve <model-name>
  --tensor-parallel-size 4
  --data-parallel-size 4
  --data-parallel-size-local 2
  --data-parallel-start-rank 2
  --data-parallel-address <master-ip>
--data-parallel-rpc-port 13345说明。这里假设网络已配置好,使所有节点都能访问指定的 IP 和端口。
在 headless 服务节点上
在 headless 节点上,一个 CoreEngineProcManager 会启动 2 个进程(按 --data-parallel-size-local 的数量),每个都运行 EngineCoreProc.run_engine_core。这些函数各自创建一个 DPEngineCoreProc(engine core),然后进入它的忙循环。
DPEngineCoreProc 初始化其父类 EngineCoreProc(EngineCore 的子类),后者会:
- 创建一个
input_queue和一个output_queue(queue.Queue)。 - 用一个 DEALER ZMQ socket(异步消息库)与另一节点上的前端做初始握手,并收到协调地址信息。
- 初始化 DP 组(例如使用 NCCL 后端)。
- 用
MultiProcExecutor初始化EngineCore(TP=4、4 张 GPU,如前所述)。 - 创建一个
ready_event(threading.Event)。 - 启动一个输入守护线程(
threading.Thread)运行process_input_sockets(..., ready_event),同样再启动一个输出线程。 - 仍在主线程中,等待
ready_event,直到横跨两个节点的全部 4 个进程的输入线程都完成协调握手、并最终执行ready_event.set()。 - 解除阻塞后,向前端发送一条 "ready" 消息,附带元数据(例如 paged KV cache 内存中可用的
num_gpu_blocks)。 - 随后主线程、输入线程、输出线程各自进入它们的忙循环。
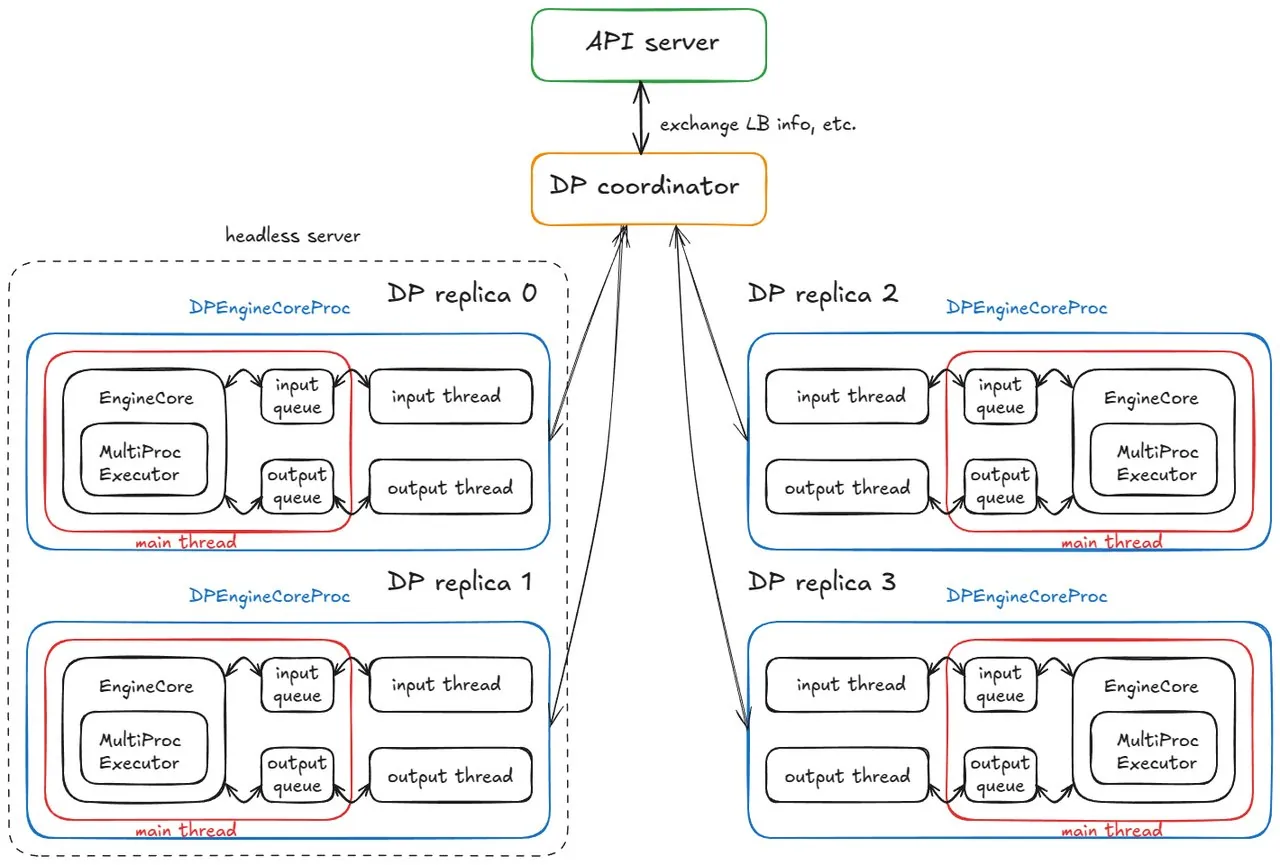
简而言之:最终得到 4 个子进程(每个 DP 副本一个),每个都跑一个主线程、一个输入线程、一个输出线程。它们与 DP coordinator 和前端完成协调握手,然后每个进程的这三个线程在稳态忙循环中运行。
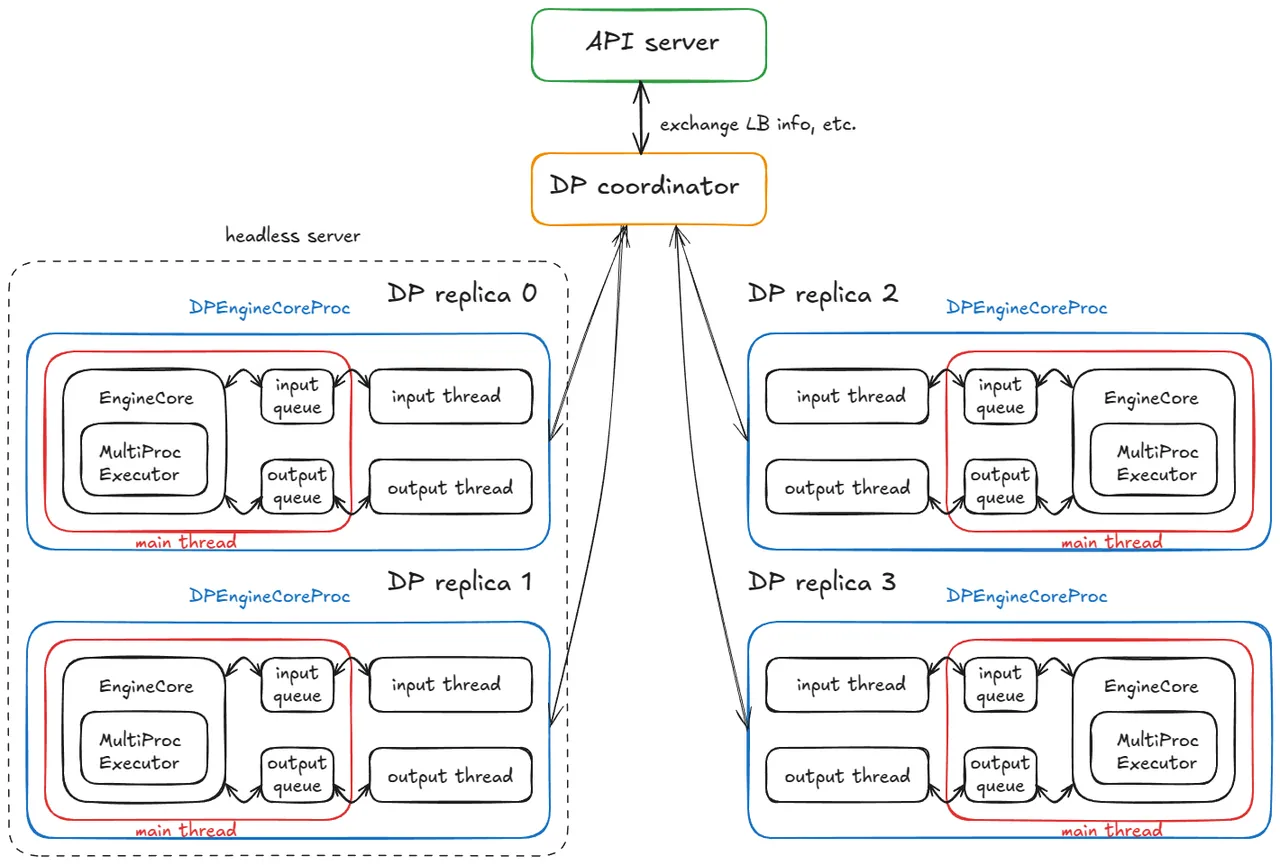
DPEngineCoreProc 的分布式系统。图:Aleksa Gordíc。当前稳态:
- 输入线程:阻塞在输入 socket 上,直到 API server 路由来一个请求;收到后解码 payload,通过
input_queue.put_nowait(...)入队一个工作项,然后回到对 socket 的阻塞。 - 主线程:在
input_queue.get(...)上被唤醒,把请求喂给引擎;MultiProcExecutor跑前向计算,并把结果入队到output_queue。 - 输出线程:在
output_queue.get(...)上被唤醒,把结果回送给 API server,然后恢复阻塞。
另外的机制:
- DP wave 计数器:系统跟踪「wave(波次)」;当所有引擎都空闲时它们进入静止状态,有新工作到达时计数器递增(用于协调与指标统计)。
- 控制消息:API server 能发送的不只是推理请求(例如 abort 以及各类 utility/控制 RPC)。
- 为 lockstep 而做的 dummy step:只要任一 DP 副本有工作,所有副本都会执行一次前向 step;没有请求的副本执行一个 dummy step 以参与必要的同步点(避免阻塞那个活跃副本)。
关于 lockstep 的澄清。lockstep 实际上只对 MoE 模型才是必需的——那时专家层构成一个 EP 或 TP 组,而注意力层仍是 DP。目前它对所有 DP 都总是执行,这主要是因为「内置的非 MoE DP」用途有限:你完全可以跑多个独立的 vLLM,再用常规方式在它们之间做负载均衡。
在 API server 节点上
我们实例化一个 AsyncLLM 对象(围绕 LLM 引擎的 asyncio 封装)。它内部会创建一个 DPLBAsyncMPClient:数据并行、负载均衡、异步、多进程的客户端。
在 MPClient 的父类内部,launch_core_engines 函数会运行,并:创建用于启动握手的 ZMQ 地址(如 headless 节点上所见);派生一个 DPCoordinator 进程;创建一个 CoreEngineProcManager(与 headless 节点上的相同)。
在 AsyncMPClient(MPClient 的子类)内部,我们:创建一个 outputs_queue(asyncio.Queue);创建一个 asyncio 任务 process_outputs_socket,它通过输出 socket 与全部 4 个 DPEngineCoreProc 的输出线程通信,并写入 outputs_queue;随后再创建一个 asyncio 任务 output_handler(来自 AsyncLLM),它从这个队列读取,并最终把信息发送给 create_completion 函数。在 DPAsyncMPClient 内部,我们还创建一个 asyncio 任务 run_engine_stats_update_task,它与 DP coordinator 通信。
DP coordinator 在前端(API server)与后端(engine core)之间居中协调。它会:周期性地把负载均衡信息(队列大小、waiting/running 请求数)发送给前端的 run_engine_stats_update_task;处理来自前端的 SCALE_ELASTIC_EP 命令,动态改变引擎数量(仅在使用 Ray 后端时有效);在被前端触发时向后端发送 START_DP_WAVE 事件,并把 wave 状态更新回报回去。
回顾一下,前端(AsyncLLM)运行若干 asyncio 任务(记住:是并发,不是并行):一类任务通过 generate 路径处理输入请求(每个新客户端请求都派生一个新的 asyncio 任务);两个任务(process_outputs_socket、output_handler)处理来自底层引擎的输出消息;一个任务(run_engine_stats_update_task)维护与 DP coordinator 的通信:发送 wave 触发、轮询负载均衡状态、处理动态扩缩容请求。
最后,主服务进程创建一个 FastAPI 应用,并挂载诸如 OpenAIServingCompletion 和 OpenAIServingChat 之类的端点,它们暴露 /completion、/chat/completion 等接口。整个栈通过 Uvicorn 对外服务。
完整的请求生命周期
把以上全部串起来,你在终端里发出:
curl -X POST http://localhost:8000/v1/completions -H "Content-Type: application/json" -d '{
  "model": "TinyLlama/TinyLlama-1.1B-Chat-v1.0",
  "prompt": "The capital of France is",
  "max_tokens": 50,
  "temperature": 0.7
}'
接下来发生的事:
- 请求打到 API server 上
OpenAIServingCompletion的create_completion路由。 - 该函数异步地对 prompt 分词,并准备元数据(request ID、采样参数、时间戳等)。
- 然后调用
AsyncLLM.generate,它走与同步引擎相同的流程,最终调用DPAsyncMPClient.add_request_async。 - 后者又调用
get_core_engine_for_request,根据 DP coordinator 的状态在各引擎之间做负载均衡,选出分数最小(负载最低)的那个:score = len(waiting) * 4 + len(running)。 - ADD 请求被发送到所选引擎的
input_socket。
在那个引擎上:
- 输入线程:解除阻塞,从输入 socket 解码数据,把一个工作项放上
input_queue交给主线程。 - 主线程:在
input_queue上解除阻塞,把请求加入引擎,并反复调用engine_core.step(),把中间结果入队到output_queue,直到满足停止条件。提醒:step()会调用调度器、model executor(它自己可能就是MultiProcExecutor!)等——这些前面都已经见过了。 - 输出线程:在
output_queue上解除阻塞,通过输出 socket 把结果送回。 - 这些结果触发
AsyncLLM的输出 asyncio 任务(process_outputs_socket和output_handler),把 token 传回 FastAPI 的create_completion路由。 - FastAPI 附加元数据(finish reason、logprobs、usage 信息等),并通过 Uvicorn 把一个
JSONResponse返回到你的终端。
就这样,你的补全回来了——整套分布式机器都藏在一条简单的 curl 命令背后。
补充说明。增加更多 API server 时,负载均衡在操作系统/socket 层处理;从应用视角看没有实质性变化,因为复杂度被隐藏了。以 Ray 作为 DP 后端时,你可以暴露一个 URL 端点(
/scale_elastic_ep),用于自动增减引擎副本的数量。
基准测试与自动调参:延迟 vs 吞吐
到目前为止,我们分析的都是「气体分子」——请求如何在引擎/系统内部流动的细节。现在该拉远镜头、把系统当作整体来看,并问:如何度量一个推理系统的性能?
在最高层面上有两个相互竞争的指标。延迟(Latency)是从请求提交到 token 返回的时间。吞吐(Throughput)是系统每秒能生成/处理的 token 数或请求数。延迟对交互式应用最重要,因为用户在等响应。吞吐对离线负载最重要,例如为预训练/后训练生成合成数据、数据清洗与处理,以及一般而言任何离线批量推理任务。
在解释延迟与吞吐为何相互竞争之前,先定义几个常见的推理指标:
| 指标 | 定义 |
|---|---|
| TTFT(首 token 时间) | 从请求提交到收到第一个输出 token 的时间。 |
| ITL(token 间延迟) | 两个相邻 token 之间的时间(例如从 token i-1 到 token i)。 |
| TPOT(每输出 token 时间) | 一个请求中所有输出 token 的平均 ITL。 |
| Latency / E2E(端到端延迟) | 处理一个请求的总时间,即 TTFT 加上所有 ITL 之和,等价于从提交请求到收到最后一个输出 token 的时间。 |
| Throughput(吞吐) | 每秒处理的 token 总数(输入、输出或两者),或者每秒请求数。 |
| Goodput(有效吞吐) | 满足服务级目标(SLO,如最大 TTFT、TPOT 或 E2E 延迟)的吞吐。例如只统计满足这些 SLO 的请求所产生的 token。 |
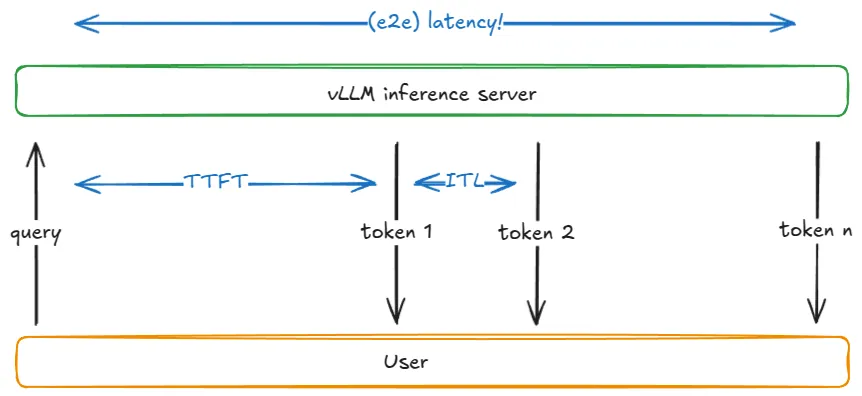
下面是一个解释这两个指标为何相互竞争的简化模型。假设是:权重 I/O(而非 KV cache I/O)占主导,也就是我们在处理短序列。看 batch size B 如何影响单个 decode step,这个权衡就很清楚了。当 B 降向 1 时,ITL 下降:每个 step 的工作更少,token 也不与其他 token「竞争」。当 B 升向无穷大时,ITL 上升,因为每个 step 做的 FLOPs 更多——但吞吐会改善(直到触及峰值性能),因为权重 I/O 被摊薄到更多 token 上。
roofline 模型在这里很有帮助。在饱和 batch B_sat 以下,step 时间由 HBM 带宽主导(把权重逐层流式送进片上内存),所以 step 延迟几乎持平——算 1 个 token 与算 10 个 token 可能花差不多的时间。超过 B_sat 后,kernel 变成算力受限,step 时间大致随 B 增长;每多一个 token 都会加到 ITL 上。
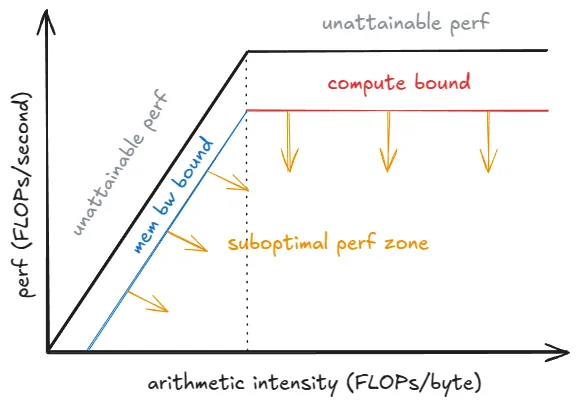
说明。更严格的处理必须考虑 kernel 自动调优:随着 B 增长,运行时可能切换到对该 shape 更高效的 kernel,从而改变实际达成的性能
P_kernel。step 延迟为t = FLOPs_step / P_kernel,其中FLOPs_step是该 step 的工作量。可以看到,当P_kernel逼近P_peak时,每个 step 更多的计算会直接导致延迟上升。
如何在 vLLM 中做基准测试
vLLM 提供 vllm bench {serve,latency,throughput} CLI,它封装了 vllm/benchmarks/{server,latency,throughput}.py。各脚本的作用:
- latency:使用较短输入(默认 32 token),以小 batch(默认 8)采样 128 个输出 token。它跑若干次迭代,并报告该 batch 的端到端延迟。
- throughput:一次性提交一组固定的 prompt(默认 1000 条 ShareGPT 样本),也称 QPS=Inf 模式,并报告整个运行过程中的输入/输出/总 token 数与每秒请求数。
- serve:启动一个 vLLM server,并通过从泊松(或更一般地,伽马)分布采样请求到达间隔来模拟真实负载。它在一个时间窗内发送请求,度量上面讨论过的所有指标,并可选地通过信号量强制服务端最大并发(例如把 server 限制到 64 个并发请求)。
下面是运行 latency 脚本的一个例子:
vllm bench latency
  --model <model-name>
  --input-tokens 32
  --output-tokens 128
  --batch-size 8
CI 中使用的基准测试配置位于 .buildkite/nightly-benchmarks/tests 下。还有一个 auto-tune 脚本,它驱动 serve 基准测试来寻找满足目标 SLO 的参数设置(例如「在保持 p99 E2E < 500 ms 的同时最大化吞吐」),并返回一个推荐配置。
结语
我们从基本的 engine core(UniProcExecutor)出发,加上 speculative decoding、prefix caching 等高级特性,向上扩展到 MultiProcExecutor(TP/PP > 1),最后向外扩展,把一切包进异步引擎与分布式服务栈,并以「如何度量系统性能」收尾。
vLLM 还包含本文跳过的专门处理,例如:
- 多样的硬件后端:TPU、AWS Neuron(Trainium/Inferentia)等。
- 架构/技术:MLA、MoE、encoder-decoder(例如 Whisper)、pooling/embedding 模型、EPLB、m-RoPE、LoRA、ALiBi、无注意力变体、滑动窗口注意力、多模态 LM,以及状态空间模型(例如 Mamba/Mamba-2、Jamba)。
- TP/PP/SP 各种并行变体。
- 混合 KV cache 逻辑(Jenga)、更复杂的采样方法如 beam sampling,等等。
- 实验性:async scheduling(异步调度)。
好在这些大多与上面描述的主流程正交——你几乎可以把它们当作「插件」来对待(实践中当然存在一些耦合)。在这个高度上,分辨率确实有所牺牲;后续文章会放大到具体子系统、深入细节。
原文由 Aleksa Gordíc 撰写,实验所用 H100 由 Hyperstack 提供,预发布版本由 Nick Hill(vLLM 核心贡献者,Red Hat)、Mark Saroufim(PyTorch)、Kyle Krannen(NVIDIA,Dynamo)与 Ashish Vaswani 审阅并给出反馈。
参考文献
- vLLM
- Attention Is All You Need
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- Jenga: Effective Memory Management for Serving LLM with Heterogeneity
- Orca: A Distributed Serving System for Transformer-Based Generative Models
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models
- Accelerating Large Language Model Decoding with Speculative Sampling
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads
- LMCache
来源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System,Aleksa Gordíc,2025 年 8 月 29 日。
原文来源:Aleksa Gordićhttps://www.aleksagordic.com/blog/vllm