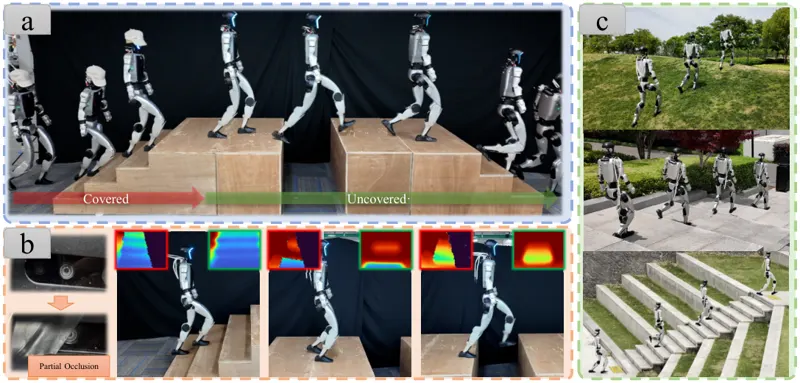
CAP 用去噪世界模型把受污染深度重建为干净深度,与 50Hz 本体感受 VAE 双通路融合,让 G1 单策略在感知退化中稳定行走,脏深度成功率 97.9%。
把第一视角深度图直接变成开放世界里的稳健步伐,是人形机器人落地人类环境的关键一步。SSR 用单阶段端到端强化学习联合习得安全落脚、双侧协调与类人全身动作:想象落脚点引导在摆动期预测未来接触分布并评估其支撑度,把只在触地时刻才出现的稀疏安全信号变成落地前的密集纠正;等变潜空间镜像增强把对称增广从高分辨率深度图移到 48 维潜向量上,训练显存从 28.8 GB 降到 23.7 GB;地形特定多判别器 AMP 让不同地形各自保持自然的动作风格。AgiBot X2 真机零样本跨越 90 cm 沟壑、登上 45 cm 高台,并在户外公园完成 1.3 km、40 分钟无复位长时程通行;同一训练与部署管线迁移到 1.8 m、70 kg 的 DR02 全尺寸人形机器人同样有效。
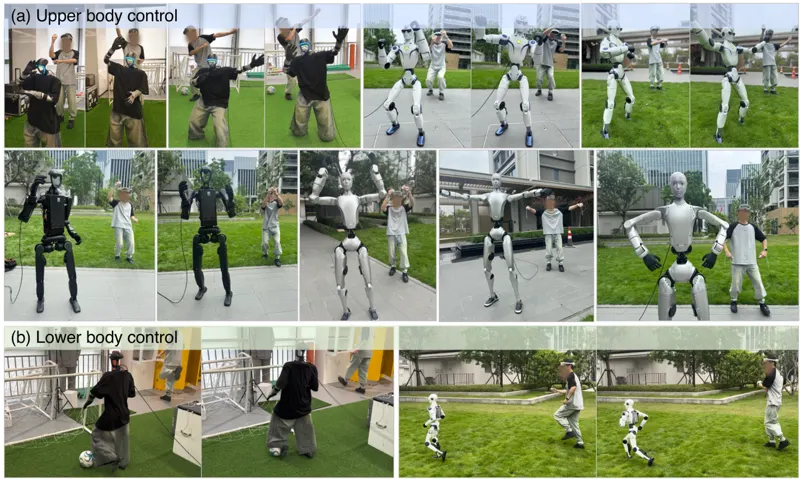
X-WBC 把人形全身控制重构为跨本体联合训练:以人为中心的命令 token 对齐全身人体动作、机器人参考动作与稀疏 VR 观测,共享因果 Transformer 学习可复用时序结构,轻量本体专属模块负责各机器人的状态与动作映射。九个仿真本体、外部动作与四台真机的实验表明联合训练提升跟踪精度,对齐表示支持跨命令源一致控制。
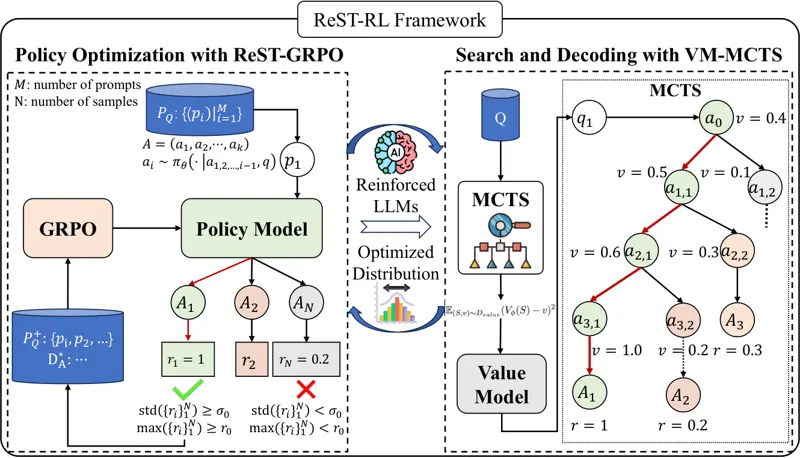
GRPO 是当前提升大模型推理能力的代表性强化学习方法,但它只在整条轨迹末端拿到一个稀疏奖励:一旦同组采样得到的奖励彼此接近,组内相对优势就退化成噪声,策略几乎学不到东西。ReST-RL 把策略优化与价值引导搜索重新接回同一条自训练流水线。第一阶段 ReST-GRPO 先按奖励标准差过滤掉信息量低的提示词,再从每个提示词的最高奖励轨迹中按离散指数分布抽取若干前缀,把它们当作在线 GRPO 的新起点——前缀只作为上下文,后缀一律重新采样并优化,而不是拿来模仿。第二阶段 VM-MCTS 在这个已静态化的策略下用 MCTS 自采价值目标,训练一个预测期望终端奖励的价值模型,推理时同一个模型既用于 UCT 搜索分配,也用于最终 Best-of-N 排序,搜索与验证共享同一套状态价值尺度。在 APPS、BigCodeBench、HumanEval 等代码基准上,Qwen3-8B 的平均分从 0.503 提升到 0.689;在匹配策略与价值模型的对照实验里,ReST-GRPO + VM-MCTS 在 APPS-500 上得到 0.642,而 GRPO + VM-MCTS 只有 0.538,说明第一阶段带来的轨迹分布改善确实穿过了价值学习环节存活下来。端到端算力核算上,ReST-GRPO 用 1752 GPU 小时对 GRPO 的 2080 小时,在 71 小时而非 207 小时达到 9% 的提升。仅用代码轨迹训练出的价值模型,在不做目标域微调的情况下迁移到 MATH、Omni-MATH 与 GPQA-Diamond 同样带来增益。
WM-LOCO 将循环世界模型与 PPO 联合训练,仅凭本体感知与单路深度图产出预测性循环特征,在落脚受限地形大幅超越基线,真机成功率 93.3%。
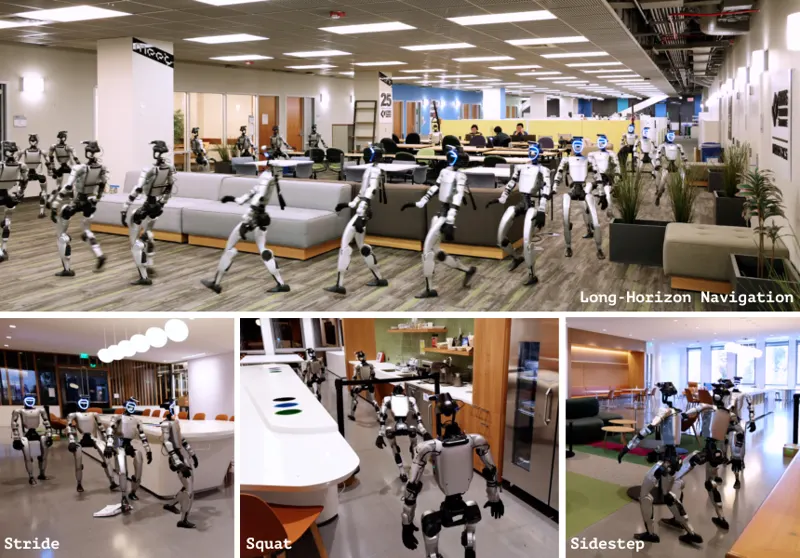
人形机器人在杂乱室内的导航不是 2D 路径规划问题:身体的几何形状在运动中持续变化,穿过狭窄通道需要手臂摆放、躯干调整与步态调制的连续协同。TANGO 是首个面向杂乱环境语言条件通行的全身视觉-语言-动作框架,输入自然语言指令与第一视角 RGB 观测,直接预测 29 自由度关节空间动作块交给下游全身控制执行。训练数据全部在仿真中合成:Plan-Edit-Track(PET)管线用全局路径规划、运动学全身动作生成、障碍感知动作编辑与强化学习跟踪自动产出 64,633 条动力学可行的无碰撞通行轨迹,仅耗 211 GPU 小时。TANGO 在 VLNVerse 上取得 54.69 / 52.89 的 seen / unseen 成功率,是对比方法中唯一具备真实物理控制能力的,并把杂乱场景碰撞率压到 9.90%(最强基线 15.81%,且对方额外使用了 LiDAR)。零样本部署到 Unitree G1 后,可在真实杂乱场景中完成语言引导通行,无需任何真实导航数据。已被 CoRL 2026 接收。
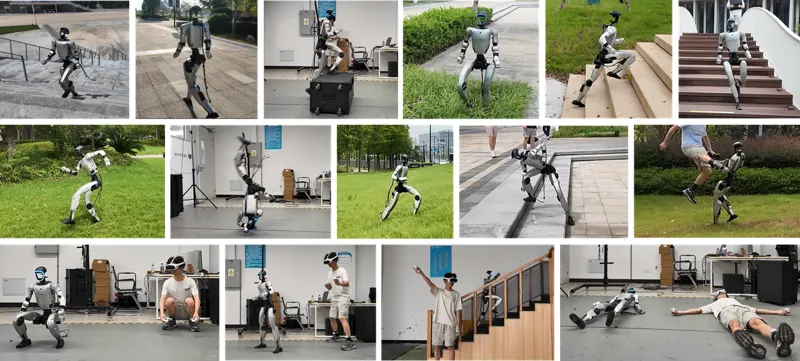
人形动作跟踪器已能复现多样的全身动作,但一旦地形复杂起来,地形无关的参考动作常常物理不可行——参考要求右脚落在某处,而那里恰好是台阶棱或石块。PGMT 把地形适应做成跟踪策略自身的能力,而不是上游参考动作生成器的负担:第一阶段在平地上用 LAFAN1 人体动作学出通用的跟踪与跌倒恢复先验;第二阶段通过「动作条件化的地形一瞥」把高程图中与当前动作真正相关的区域稀疏注入意图融合模块,并用地形感知的跟踪松弛允许必要偏离、同时保住参考动作的意图。整套流程不需要任何「动作—地形」配对数据,任务完成率从 40.02% 提升到 87.81%(最难的 L9 档从 35.31% 提升到 83.33%)。在 29 自由度 Unitree G1 上零样本部署,可跨越 37 cm 高障碍箱、在楼梯上慢跑与冲刺、完成侧手翻并自主起身,同时支持遥操作与动态动作跟踪。
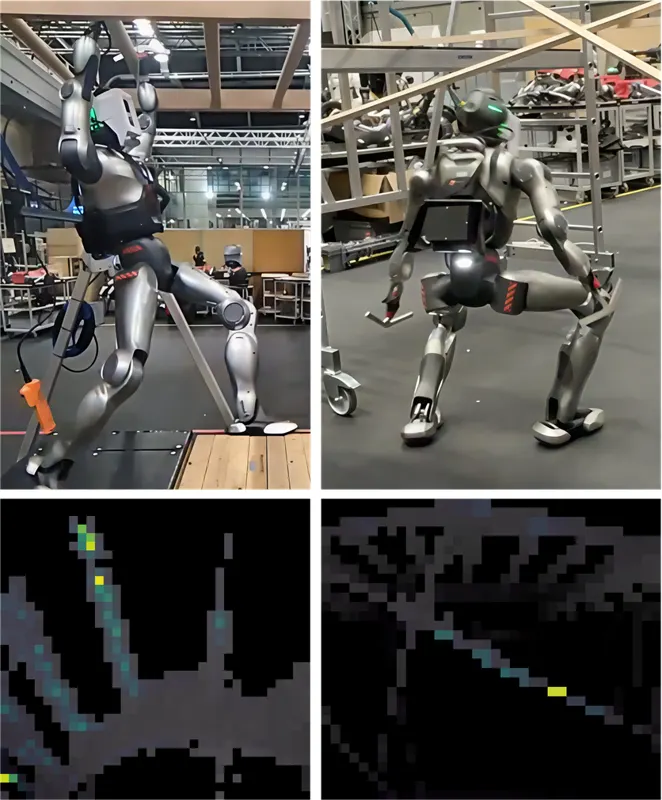
ETH RSL 让人形机器人只靠头部固态激光雷达原始回波完成跳上云梯、臂行横越、跳下落地的完整序列:三个特权教师经相位调度蒸馏为一个注意力感知学生,配合电池压降、电机热极限与雷达噪声建模,硬件 15 次成功 14 次,臂行速度 0.5 m/s。
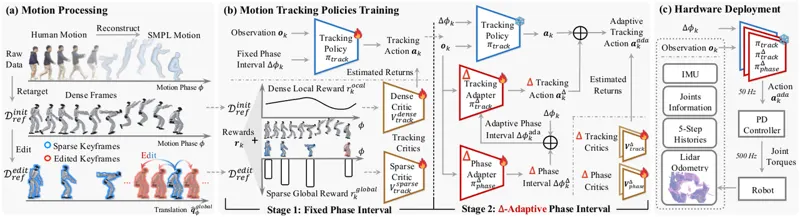
AdaMimic 把单条参考动作稀疏成关键帧并轻量编辑,先训跟踪策略,再冻结策略学相位与跟踪适配器,实现时间扭曲式可适配人形控制,已部署 Unitree G1。
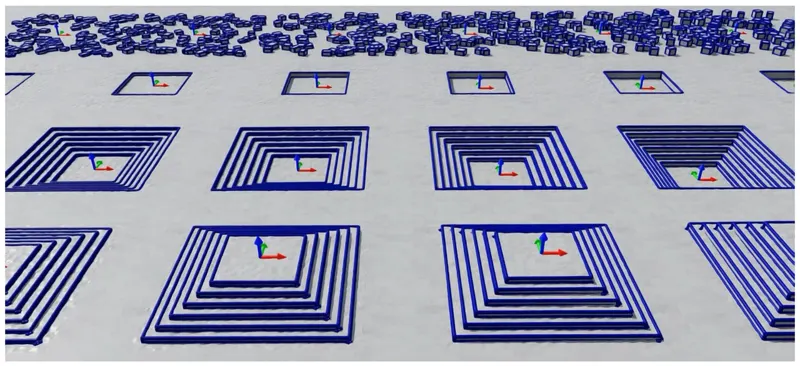
提出端到端感知跑酷框架,将原始深度图与本体感受直接映射为关节动作,结合地形边缘检测、足部体积点防边缘滑落机制与平坦区域采样抑制奖励作弊,全尺寸人形机器人实测最高 2.5 m/s 穿越复杂非结构化地形。
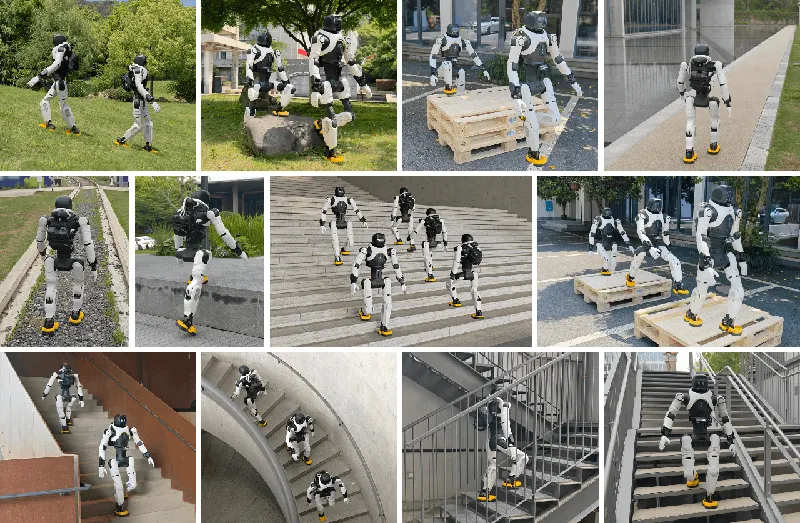
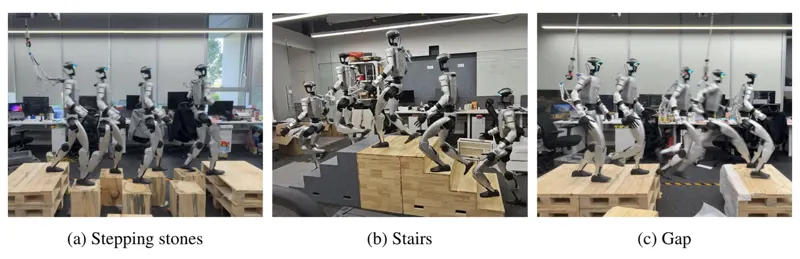
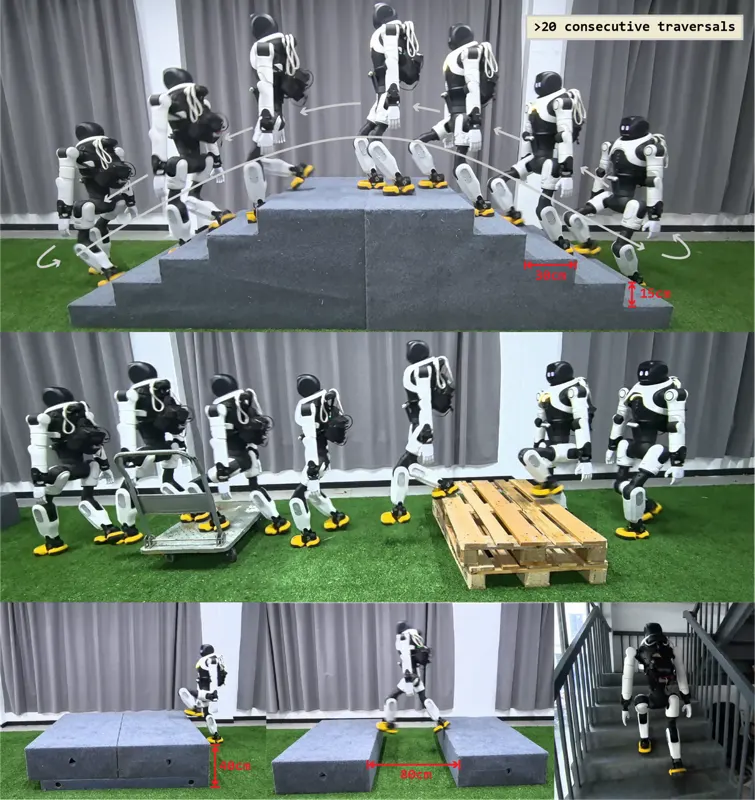
CReF 提出单阶段、直接以深度图+本体感知映射到关节目标的视觉人形运动框架:本体感知查询的跨模态注意力、门控残差融合与 GRU 高速公路门控循环融合从原始前向深度提取运动相关特征,并引入基于足端点云可支撑候选的地形感知落脚奖励。仿真中在楼梯/间隙/平台三类地形全部难度档取得领先,零样本部署到 AGIBOT X2 Ultra,在带扶手楼梯、镂空托盘、强反光与杂乱户外场景中稳定行走。
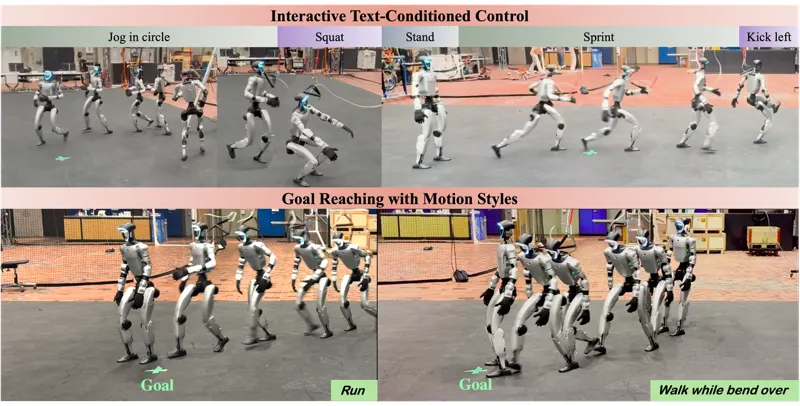
苏黎世联邦理工提出 ADAPT:文本条件扩散技能先验加约束残差强化学习,在 Unitree G1 上实现实时指令切换的端到端全身控制,并可通过噪声引导复用冻结先验完成风格保持的目标到达。