PAPER DEEP DIVE
OpenVLHarness:真实世界视觉智能体工具调用与多模态记忆
多模态大语言模型(MLLM)在视觉推理上进步迅速,但许多任务所需的证据无法仅靠内部推理获得:作者在 22 个基准上的对照实验显示,单纯提高基础模型的推理预算只能带来有限提升。这类任务需要接地感知、外部知识与数值测量,且来自异构工具的输出必须被模型读懂、并在多轮推理之间保留。本文提出 OpenVLHarness,一个围绕「能力层」与「持久多模态记忆」组织起来的多模态推理 harness。能力层把任务级工具接口与证据渲染结合在一起,为异构后端提供一致的访问方式,并把它们的输出转换成模型可读的观察;持久多模态记忆在整条查询过程中,把相应的图像、结构化数据与网页引用保存为可寻址工件;编码接口则在已存数据上执行生成的程序,实现跨工具结果的组合计算。三者共同支撑「获取—检视—组合」多模态证据的迭代过程。在 22 个基准、8 个开源与闭源骨干上的评测中,OpenVLHarness 相对同配置无工具基线平均提升 9.7–12.6 分,其中 Qwen3-VL-8B 提升 11.2 分、Kimi K3 提升 9.7 分、GPT-6 Astra 提升 9.9 分;GPT-6 Luna 在中等推理预算下,OpenVLHarness 比最大推理预算下的基础模型、Codex 与 Visual Sketchpad 高 7.7–8.5 分,而模型 token 开销最多只有它们的 37%。
论文元信息
标题:OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory(OpenVLHarness:真实世界视觉智能体工具调用与多模态记忆)
作者:Yu Zhou, Cheng-Fu Yang, Rui Sun, Di Wu, Sibo Peng, Mingyang Zhang, Zhen Yang, Ruiyi Zhang, Nanyun Peng, Zhe Gan, Kai-Wei Chang(UCLA NLP 与业界合作团队)
链接:arXiv:2610.26860v1(2026 年 10 月 19 日提交);代码与评测套件已开源:github.com/uclanlp/OpenVLHarness,模型与评测数据托管于 Hugging Face uclanlp/OpenVLHarness。
代码状态:已发布。仓库包含能力层实现 openvlharness/capabilities/、记忆模块 openvlharness/memory/、评测套件 evaluation_kit/ 与基准入口 run_benchmark.py,与论文第 2 节描述一一对应。
一句话总结
OpenVLHarness 把多模态推理的瓶颈从「模型会不会想」改写为「模型拿不拿得到证据」:用能力层统一九类工具的调用与证据渲染,用持久多模态记忆把中间产物变成可寻址工件,在 22 个真实视觉基准上相对无工具基线平均提升 9.7 至 12.6 分。
研究背景与动机
多模态大语言模型在图表理解、视觉问答等任务上的进步有目共睹,但真实世界的视觉问题往往不是「看懂」就能回答的。窗子和柜子中心相距多少米,需要相机位姿、逐视图深度与物体定位三类证据再经过一次坐标换算;某款背包拿过哪些奖,需要把包身上的微小标志放大、识别、再去网页上核实。这类证据不在模型参数里,也不在一次前向传播里,只能由外部工具逐步取得。
作者先用一组对照实验否定了「加大思考预算即可」的直觉。在 22 个基准的全量评测上,GPT-6 Luna 单独作答时从低推理档到最高推理档只把平均分从 44.3 提到 48.0,Visual Sketchpad 从 44.7 提到 48.8,而每千题的模型 token 成本从 0.58 美元涨到 3.17 美元。换言之,纯靠内部推理的边际收益很快见顶,证据缺口不会因思考更久而自动闭合。
已有的工具使用框架并没有补上这个缺口。OctoTools、PixelReasoner 一类工作围绕人工设计的工具接口与执行策略展开,工具输出往往以原始形态塞回上下文:一屏上百个坐标框、一张未加标注的掩码图、一段没有句柄的中间结果。模型既要自己解读异构格式,又要在多轮之间记住上一步看到了什么,两件事都容易出错。
论文由此提出三个设计问题。其一,异构后端(分割模型、OCR 模型、深度估计模型、搜索引擎)如何共享同一种调用约定;其二,工具输出如何被渲染成模型可读、可引用的观察;其三,一次查询过程中产生的图像、结构化数据与网页引用如何跨轮留存,而不是用完即弃。
OpenVLHarness 的答案是两层结构加一条记忆总线:能力层负责「调用与渲染」,持久多模态记忆负责「留存与寻址」,编码接口负责「在留存的数据上计算」。三者组合成一个迭代式的证据工作流:获取、检视、组合,直到证据足以支撑答案。
预备知识
推理 harness。harness 指模型之外的那圈脚手架:工具接口、执行器、上下文管理与评测协议。论文的关键立场是,harness 本身是一等公民——同样的骨干模型换一套 harness,分数可以差出十几个点,因此 harness 应当被系统地设计与优化,而不是随手拼装。
能力(capability)。论文把能力定义为三元组:它提供什么操作、接受什么类型化输入、暴露什么证据与可复用数据。以视觉定位为例,输入是一个图像引用加一段文本查询,暴露的是物体位置、元数据与一张可视化图,后端若支持还会附带分割掩码。定义落在接口层面,后端可以替换:定位可用 SAM 3 或 Grounding DINO,OCR 可用 PaddleOCR-VL 或 DeepSeek-OCR,深度估计可用 Depth Anything 3 或 VGGT,而编排器的调用约定保持不变。
证据渲染。与「把工具 stdout 原样回传」不同,证据渲染把后端输出改写成模型友好的观察:定位结果给出 0 到 1000 标度的边界框坐标,同时生成一张带编号掩码的图像,正文里的 object 编号与图上的色块一一对应。模型因此可以「指着图说话」,而不是在几百个浮点数里找规律。
方法详解
总体架构:编排器、能力层与记忆
OpenVLHarness 的运行单元是一个 MLLM 编排器加一圈能力。编排器只负责决定调用哪个能力、传什么参数、何时收束出答案;能力层把每次调用翻译成后端请求,再把后端输出渲染成模型可读证据;记忆层则在整条查询期间保存所有工件。图 1 给出这条链路:用户问题与输入图像进入编排器,工具调用下穿能力层到达模型与服务,渲染后的证据与 Environment Update 一起回流,右侧的记忆注册表始终可寻址。
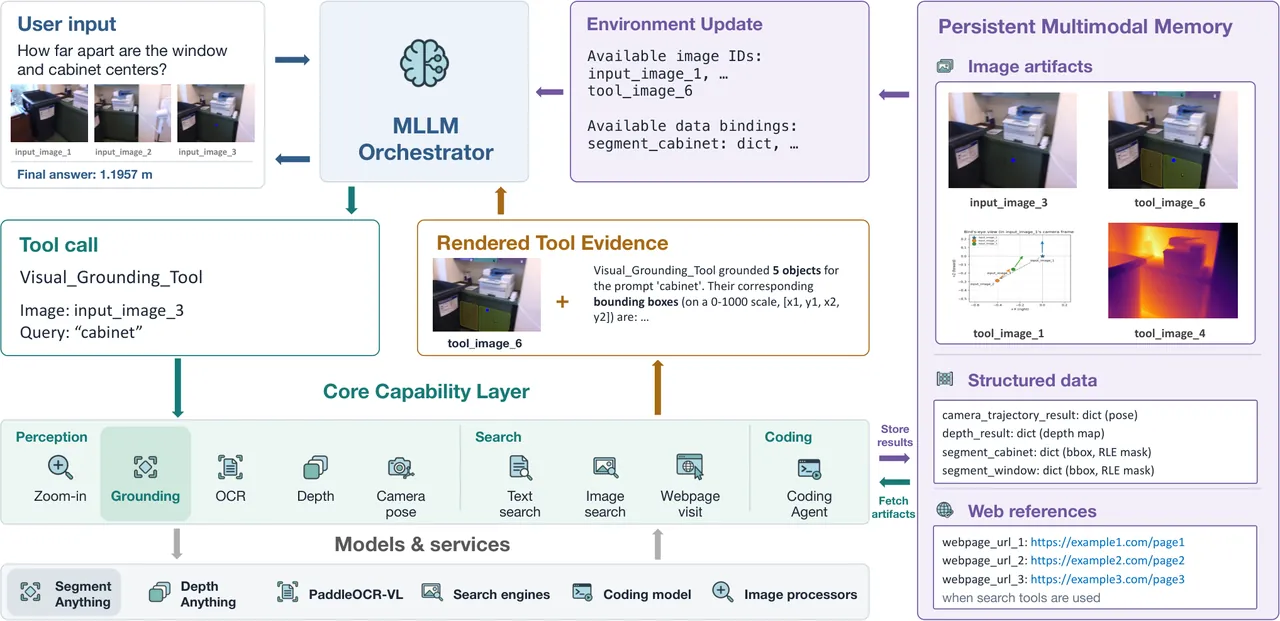
图 1:OpenVLHarness 总览。编排器通过类型化接口调用能力,能力层连接后端模型与服务,并把输出渲染为模型可读证据(带编号掩码的可视化与结构化绑定);持久多模态记忆保存图像工件、结构化数据与网页引用。
基础实例化包含九项能力:感知侧五项——Zoom-in、Visual Grounding、OCR、Depth Estimation、Camera Trajectory;信息检索侧三项——Text Search、Image Search、Webpage Visit;再加一个 Python Coding Agent,用于在中间结果之上做计算。九项能力共享同一套调用约定,新增能力只需实现同一接口。
能力层:类型化接口与证据渲染
能力层的职责在开源实现 openvlharness/capabilities/_base.py 的 BaseCapability 中写得很直白:校验任务调用、解析工件引用、执行工具、渲染模型证据。调用参数里的图像必须以记忆中的句柄给出(如 input_image_3),能力层先把它解析成真实文件再交给后端,从接口上杜绝模型凭空捏造路径。
渲染环节决定模型「看到什么」。以定位为例,返回文本会写明 grounded 了几个对象、边界框在 0 到 1000 标度下的坐标,并附上一张编号掩码图;被选中的结构化结果还会通过 store_selected_binding 写入记忆,供后续轮次按名字取用。OCR 返回带置信度的文本块,深度估计返回可索引的深度图句柄,相机位姿返回内参与外姿矩阵——每一种都以「简短观察 + 可寻址工件」的形态进入上下文。
持久多模态记忆:三类可寻址工件
记忆注册表保存三类工件。第一类是图像工件:用户输入记为 input_image_n,工具生成记为 tool_generated_image_n,包括裁剪放大图、掩码可视化、深度图等;第二类是结构化数据绑定:定位的框与掩码、深度图、相机轨迹等以字典形式挂名字(如 segment_cabinet、depth_result);第三类是网页引用:检索链路访问过的页面记为 webpage_url_n,便于复核与再访问。对应实现分散在 memory/store.py、memory/images.py、memory/bindings.py、memory/urls.py。
记忆不是被动仓库。每个工具轮结束后,EnvironmentUpdateBuilder(memory/environment_update.py)会生成一段环境更新消息,前缀固定为 "Environment Update (not a new question):",内容列出当前可用图像 ID 与数据绑定,并明确告诫模型「Do NOT invent image file names or paths.」。这段更新以系统消息而非新用户问题的形态注入,模型因此始终知道手里有哪些工件,也不会把环境更新误读为新任务。
编码接口:在记忆上做计算
许多答案不是某一次工具输出的直接复读,而是多个工具结果的组合。Coding Agent 在记忆绑定之上执行生成的 Python 程序:它可以读取 camera_trajectory_result 的内参外参、depth_result 的度量深度、segment_window 的边界框,把像素坐标反投影到世界坐标再求距离。图 2 的第一个例子正是这条链:相机轨迹给出共享坐标系,深度估计给出度量尺度,定位给出窗与柜的掩码,最后一段代码算出 1.1957 米。
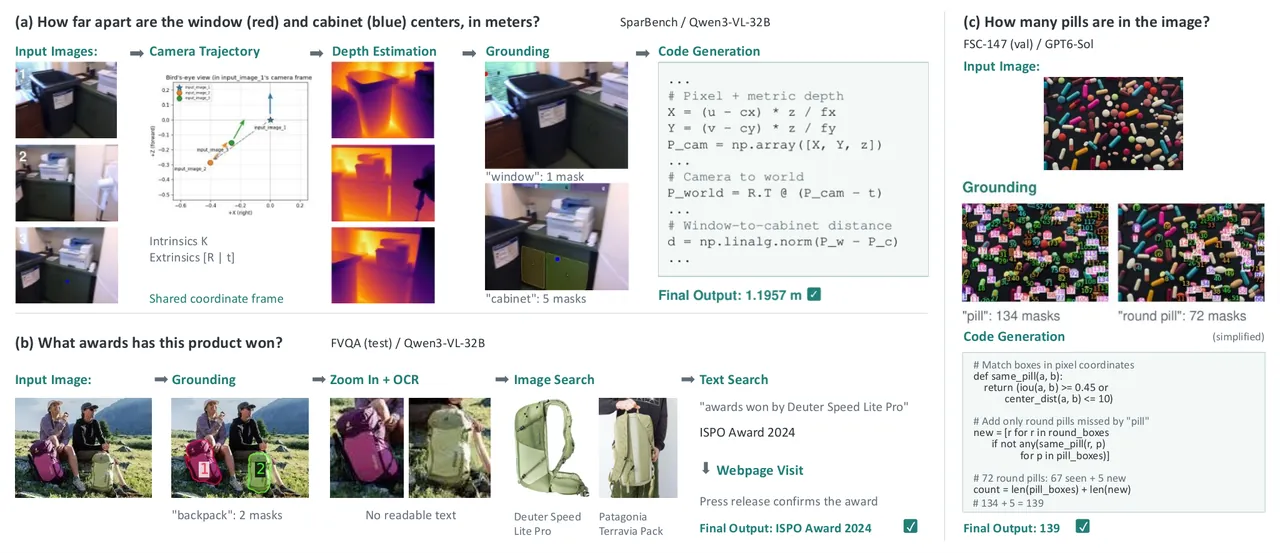
图 2:三条真实任务链。(a) 用相机轨迹、深度与定位加代码测量窗与柜中心的三维距离;(b) 用定位、放大、OCR、图像检索、文本检索与网页访问核实背包获奖信息;(c) 用两次定位加代码完成药丸计数。
把图 2(a) 的计算写成公式即:像素点经内参 $K$ 与外姿 $(R, t)$ 反投影为 $P_{\mathrm{world}} = R^{\top}(P_{\mathrm{cam}} - t)$,其中 $P_{\mathrm{cam}}$ 由像素坐标与度量深度合成;两物体中心的世界坐标之差取二范数 $d = \|P_{\mathrm{world}}^{(w)} - P_{\mathrm{world}}^{(c)}\|_2$ 即为答案。计数例子则是集合运算:先取 "pill" 的 134 个掩码,再补上 "round pill" 中未被覆盖的 5 个,$N = |\mathcal{B}_{\mathrm{pill}}| + |\mathcal{B}_{\mathrm{round}} \setminus \mathcal{B}_{\mathrm{pill}}| = 134 + 5 = 139$。工具负责取证,代码负责算术,模型负责把两者串起来。
迭代证据工作流
把上述部件串起来,一次查询就是一个循环:编排器提出工具调用,能力层执行并渲染,记忆登记工件并广播环境更新,编排器基于更新后的上下文决定下一步——继续取证、写代码计算,或给出最终答案。下面的流程图按论文第 2 节与开源实现绘制,反映的正是这条「获取—检视—组合」的闭环。
flowchart TD
  Q["用户问题与输入图像
input_image_1 到 input_image_n"] --> O["MLLM 编排器"]
  O -->|"类型化工具调用"| C["能力层 九项能力
Zoom-in Grounding OCR Depth CameraPose
TextSearch ImageSearch WebVisit CodingAgent"]
  C --> B["后端模型与服务
SAM 3 Grounding DINO PaddleOCR-VL
Depth Anything 3 VGGT 搜索引擎"]
  B --> E["证据渲染
编号掩码图 坐标 置信度 结构化绑定"]
  E --> M["持久多模态记忆
图像工件 数据绑定 网页引用"]
  M --> U["Environment Update
广播可用图像 ID 与绑定名称"]
  U --> O
  M --> K["Coding Agent
在绑定数据上执行程序"]
  K --> O
  O --> A["最终答案"]
harness 自优化:搜索与工具生成
论文不止步于手工 harness,还给出两条自动优化路径。第一条是 harness 搜索(算法 1):维护一个候选 harness 种群 $\mathcal{P}$,初始只含手工基线 $h_0$,其分数为 $\mathrm{score}(h_0) \leftarrow \mathrm{Eval}(h_0, \mathcal{D}, S)$;每轮先分析失败轨迹 $a \leftarrow \textsc{Analyze}(p, \mathcal{F}, \mathcal{D})$,再提出修改提案 $\{\delta_1, \dots, \delta_M\} \leftarrow \textsc{Propose}(p, a)$,组合成新候选 $c \leftarrow p \oplus \{\delta_i\}_{i \in I}$ 且 $|I| \leq K$,最后保留前 N 名 $\mathcal{P} \leftarrow \mathrm{Top}_N(\mathcal{P} \cup \mathcal{C}, \mathrm{score})$。实验配置为 $N=4$、$M=4$、$K=4$、采样 $S=3$、共三轮。
第二条是工具生成(算法 2):把失败聚类成域与子集 $\{(d_j, \mathcal{S}_j)\}_{j \leq D} \leftarrow \textsc{Analyze}(\mathcal{F})$($D \leq 5$),对候选工具 $\tau$ 先在调参子集上跑通 $\rho \leftarrow \mathrm{Run}(h \cup \{\tau\}, \mathcal{S}_j^{\mathrm{tune}})$,再做提升检验 $(\mathrm{fix}, \mathrm{broke}) \leftarrow \mathrm{Lift}(h \cup \{\tau\}, \mathcal{S}_j)$;只有满足 $\mathrm{fix} \geq 2$ 且 $\mathrm{fix} > \mathrm{broke}$,并在留出子集上 $\mathrm{fix}' \geq 1$ 且 $\mathrm{fix}' > \mathrm{broke}'$ 时,工具才被接纳(每个域最多试 $T=5$ 个候选)。两道门控把「修好两个样本却弄坏另外三个」的伪改进挡在门外。
flowchart LR
  P["种群 P 只含手工基线 h0"] --> EV["Eval 打分"]
  EV --> AN["Analyze 失败轨迹"]
  AN --> PR["Propose 四个修改提案"]
  PR --> CO["组合候选 至多 K 个提案"]
  CO --> TP["Top-N 保留种群"]
  TP --> AN
  AN --> CL["失败聚类为域与子集"]
  CL --> RU["候选工具在调参子集 Run"]
  RU --> LF["Lift 检验 fix 与 broke"]
  LF --> GT["门控 fix 不小于 2 且 fix 大于 broke
留出集同样通过才接纳"]
  GT --> NH["新工具进入 harness"]
两条路径的分工由失败画像决定。在 ERQA 与 RealWorldQA 上,失败多属证据解读类(分别占 71% 与 56%),harness 搜索带来 +4.1 与 +3.7 分,而工具生成只有 +0.2 与 +0.1;在 SparBench 与 FREAK-VQA 上,失败多属缺工具类(A 至 C 类合计占 75% 与 62%),工具生成带来 +8.2 与 +4.5 分,搜索反而略降。优化器先看失败长什么样,再决定改指令还是造工具。
实验结果
主结果:22 个基准、八个骨干
表 1 汇总 22 个基准的平均分。两个信号最值得注意。其一,增益是系统性的:Qwen3-VL-8B 从 34.24 升到 45.41(+11.2),Qwen3-VL-32B 从 38.30 升到 50.92(+12.6),GPT-5、GPT-6 Sol、Kimi K3 分别 +11.3、+11.6、+9.7,中等推理档的 GPT-6 Astra 从 60.27 升到 70.17。其二,仅有工具接口并不够:OctoTools 与 Visual Sketchpad 在 8B 上只有 31.80 与 30.49,低于无工具基线,说明没有证据渲染与记忆的工具接入反而拖累模型。
| 骨干模型 | 无工具基线 | OctoTools | Visual Sketchpad | OpenVLHarness |
|---|---|---|---|---|
| Qwen3-VL-8B | 34.24 | 31.80 | 30.49 | 45.41 |
| Qwen3-VL-32B | 38.30 | - | - | 50.92 |
| Qwen2.5-VL-7B | 25.29(AdaReasoner)/ 28.02(PixelReasoner)/ 25.02(DeepEyesV2) | - | - | 33.45 |
| GPT-5 | 44.4 | - | - | 55.7 |
| GPT-6 Sol | 52.7 | - | - | 64.3 |
| Kimi K3 | 56.4 | - | - | 66.1 |
| GPT-6 Luna(中档推理) | 45.8 | 43.8 | 45.5 | 56.5 |
| GPT-6 Astra(中档推理) | 60.27 | - | - | 70.17 |
表 1:22 个基准平均分(论文表 1、表 2 摘要)。Qwen2.5-VL-7B 行的基线列为训练式方法 AdaReasoner、PixelReasoner、DeepEyesV2 的成绩。
推理预算买不到的部分
表 2 把「加思考」与「加 harness」放在同一张账单上。中等推理档下 OpenVLHarness 的平均分 56.5 已超过其他方法最高档的 48.0(Base)、48.6(Codex)、48.8(Visual Sketchpad),领先 7.7 至 8.5 分;而每千题成本为 0.92 美元,只有 Base 最高档 3.17 美元的约 29%、Visual Sketchpad 最高档 5.15 美元的约 18%,即不超过对照最高档的 37%。更极端的是低档:OpenVLHarness 低档 49.92 分、0.64 美元,已经高于所有对照的最高档平均分。
| 方法(GPT-6 Luna) | 低档平均分 | 中档平均分 | 最高档平均分 | 中档成本(美元/千题) | 最高档成本(美元/千题) |
|---|---|---|---|---|---|
| Base(裸模型) | 44.3 | 45.8 | 48.0 | 0.58 | 3.17 |
| + Codex | 36.9 | 43.8 | 48.6 | 1.29 | 2.52 |
| + Visual Sketchpad | 44.7 | 45.5 | 48.8 | 1.89 | 5.15 |
| + OpenVLHarness | 49.92 | 56.5 | 60.1 | 0.92 | 2.99 |
表 2:推理档位与 harness 的性价比(论文表 2 摘要,22 基准全量评测)。
消融:每一层各自值多少分
表 3 按论文 3.4 节的表述逐级累加。原始工具访问在 8B 与 32B 上分别 +3.8 与 +4.3,增益集中在接地感知;能力层(恢复完整工具 schema 并渲染证据)再 +3.4 与 +3.2;文本记忆(数据绑定、网页引用、Environment Update,但工具图像只以描述存在)+0.7 与 +0.3;补上视觉附件与可复用图像句柄的完整多模态记忆再 +3.1 与 +4.5,把整体推到 47.1 与 52.5。最后一步在视觉检索与深度研究域增益最大——那些任务恰恰需要回头查看之前生成的图。
| 累加变体(相对上一行) | Qwen3-VL-8B | Qwen3-VL-32B | 主要受益域 |
|---|---|---|---|
| 无工具基线(整体平均) | 37.06 | 41.29 | - |
| + 原始工具访问 | +3.8 | +4.3 | 接地感知 |
| + 能力层(接口 + 证据渲染) | +3.4 | +3.2 | 接地感知、空间推理 |
| + 文本记忆(绑定、网页引用、环境更新) | +0.7 | +0.3 | 视觉检索与深度研究 |
| + 完整多模态记忆(视觉附件 + 图像句柄) | +3.1 | +4.5 | 视觉检索与深度研究 |
| 完整 harness(整体平均) | 47.14 | 52.51 | - |
表 3:消融研究(论文表 3 与 3.4 节文字,三次运行平均)。
失败分析:九千余条批评轨迹告诉我们的事
作者用 Kimi K3 对 Qwen3-VL-8B 的 9,893 条失败轨迹做结构化批评,标签与人工标注在 100 条抽样上的一致率为 92%。失败画像按域分化:接地感知域的失败中 75% 属「工具输出错误」,且多发生在超过 25 个对象的拥挤场景,超出穷举式检测的能力边界;视觉检索与深度研究域 49% 的失败是「该调的工具没调」;而「工具输出正确但被忽略或不可用」只占 3% 至 8%,说明能力层的渲染总体上把证据送到了模型眼前——瓶颈在取证与调用策略,不在呈现。
图 3 给出计数例子的原始工件:输入图、"pill" 的 134 个编号掩码、"round pill" 的 72 个编号掩码。代码阶段发现 72 个圆药丸中 67 个已被 "pill" 覆盖、5 个是新目标,于是总数 139。这个例子同时展示了记忆的价值(两次定位结果都要留着)与渲染的价值(编号掩码让代码可以按编号核对覆盖关系)。
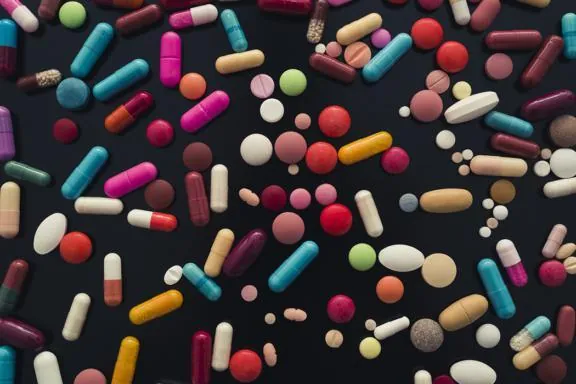
图 3:FSC-147 计数例子的输入图(论文附录 F)。
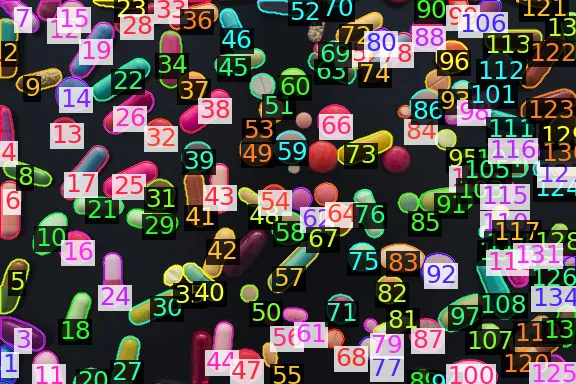
图 4:Visual Grounding 对 "pill" 的 134 个编号掩码,编号即模型可引用的对象句柄。
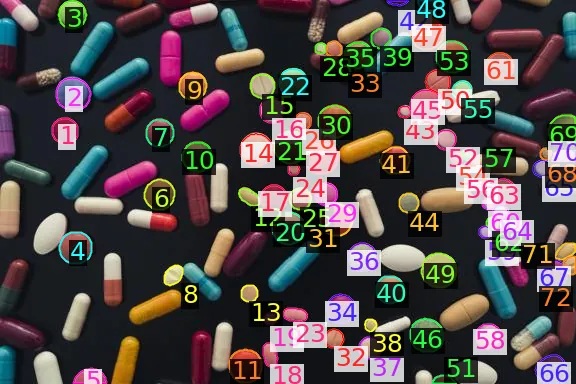
图 5:同一张图上 "round pill" 的 72 个编号掩码,与图 4 的编号体系对齐后供代码做集合运算。
局限性
作者自述其一:拥挤场景仍是硬边界。超过 25 个对象时穷举式定位失效,接地感知域的主要失败正源于此;论文承认当前能力层没有给出分层或区域化的检测策略。
作者自述其二:增益依赖骨干熟练度。在通用 VQA 与空间推理域,harness 能把证据送到模型面前,但读不懂证据的骨干依旧答不对;批评分析也显示这些域的失败更多是推理错误而非取证错误。
作者自述其三:批评只覆盖失败轨迹。9,893 条批评给出的是失败诊断与修复方向,并不能预测某项修复在可恢复样本上的准确率上限;闭源骨干因 API 成本只跑单次,缺少方差估计。
笔者判断:延迟与运维成本未被讨论。一次查询包含多次模型调用与多个后端服务的推理,论文给出 token 账单却没有端到端延迟;九项能力背后的模型族(分割、OCR、深度、位姿、搜索、编码)在生产环境中的部署与版本管理成本,同样不在评测口径内。
总结与展望
OpenVLHarness 的贡献可以压缩成一句话:把工具输出变成模型可读的观察,把中间产物变成可寻址的记忆,把 harness 变成可搜索的对象。22 个基准、八个骨干上的 9.7 至 12.6 分平均增益,以及「中档 harness 打赢别人最高档且只花三成 token」的性价比曲线,说明多模态推理的下一档提升很可能来自模型外围的工程结构,而非更大的推理预算。
对机器人研究者而言,这篇论文的另一层意义在于接口形态:类型化能力、命名工件、环境更新广播,正是具身智能体管理多传感器中间产物所需要的原语。若把深度图与位姿换成点云与关节状态,把网页检索换成手册检索,同一套记忆总线几乎可以原样搬进机器人栈。拥挤场景的分层感知、失败驱动的自动工具生成、以及 harness 与推理预算的联合调度,是这条路线上看得见的下一步。
金句
「证据不会因思考更久而自动出现:把工具输出渲染成模型可读的观察、把中间产物留存为可寻址的记忆,才是多模态智能体与裸模型之间真正的差距。」