PAPER DEEP DIVE
nanoMuse:面向个人设备的开源智能体
nanoMuse 将完整智能体放入每台个人设备,以 Sentinel 审查每次动作,支持可选同步中继、可读记忆、模型自选与 GPL-3.0 自托管。
论文:nanoMuse: An Open-Source Personal Agent for Every Device You Own
作者:Guangyi Liu、Yong Liu、Jiangning Zhang
版本与日期:arXiv 2610.08699v1,2026 年 10 月 6 日,cs.AI
论文链接:https://arxiv.org/abs/2610.08699
项目与演示:https://nanomuse.cn、Web 演示
代码状态:已开源,GPL-3.0;分析对应提交 b3bf3e9。
一句话总结
nanoMuse 没有训练新的基础模型,而是把“设备端智能体、可操作的手机与电脑、统一动作闸门、可选同步中继和可读记忆”拼成一套可自托管的个人智能体参考实现。
研究背景:从回答问题到代管一段生活
语音助手可以回答问题,任务型智能体可以完成一次搜索或一次工具调用,但它们通常没有持续数周的身份、跨设备的上下文,也不会在多个账户与真实界面之间承担连续责任。论文把“个人智能体”看作一种软件形态,而不是某个更强模型的别名:它必须长期记得同一个人,能在用户离开时继续行动,还要让每次外部操作都有边界、有记录、有撤回路径。
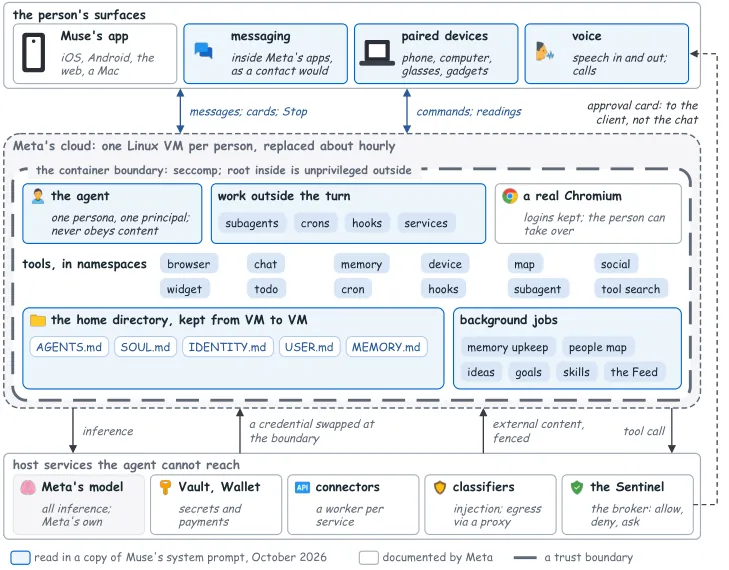
报告以 Meta 在 2026 年 9 月公开的 Muse 为参照。根据论文整理,Muse 把账户、设备、文件和记忆放进厂商云中的专属虚拟机,由外部 Sentinel 掌握连接器与网络出口的权限,浏览器看到的是页面的无障碍树,而不是完整桌面。这个结构提供了较强的隔离,但代价是每人一台虚拟机的运行成本、供应商锁定,以及模型与数据路径不可替换。论文还把一份生产提示词副本作为证据来源,不过作者明确承认无法独立验证这份副本的来源,阅读时应把相关判断视为受限证据。
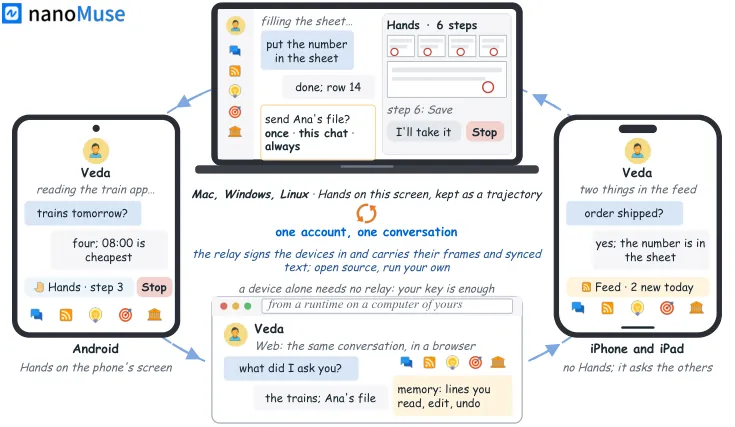
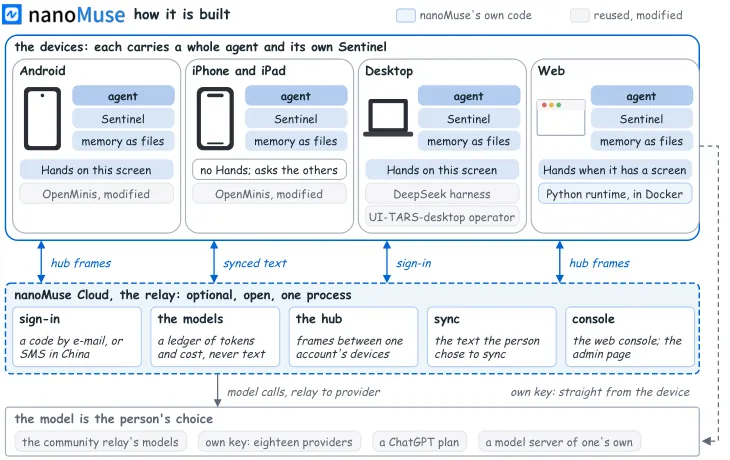
nanoMuse 选择的路线相反:每个 Android、iOS、桌面或 Web 客户端都带有完整智能体,Android 与桌面设备还能直接操作本机屏幕;设备之间通过一个可以自行部署的中继交换会话。它放弃了厂商模型中台和专属沙箱,换来了本地优先、模型可替换和代码可审计。论文因此更像一份系统设计报告与工程说明书,而不是用统一基准证明“效果更好”的实验论文。
这种取舍也解释了它为什么与具身智能相关。手机和电脑是个人每天使用时间最长、传感器与账户最密集的“外部身体”;把智能体放在设备上,使它不必把桌面画面搬到云端才能执行动作,也让停止按钮、人工接管和本地权限判断有可能靠近真实动作发生的位置。论文进一步把摄像头、家电和机器人手臂列入路线图,视作同一中继上的新“手”。
预备知识:代理、运行时与动作边界
这里的“代理”不是单一推理请求,而是能规划、调用工具、读取结果并继续决策的循环。“运行时”负责模型接口、工具注册、记忆、任务调度、沙箱和跨设备通信。“手”则是把计划落到图形界面上的执行器:在电脑上可能是点击、按键和滚动,在手机上可能是点按、滑动、输入或系统按钮。
最容易被忽略的是“边界”。生成式模型可以提出动作,却不能天然获得账户、文件或支付权限。nanoMuse 将这些动作统一交给 Sentinel 检查,把“模型想做什么”和“系统实际允许什么”分开。论文没有提出新的对齐算法,它的贡献在于把一个个人智能体所需的设备拓扑、授权语法、界面操作和同步数据面组合成可运行系统。
flowchart LR
  U[用户目标] --> A1[发起设备上的 Agent]
  A1 --> L{选择最低可行操作层}
  L -->|技能或工具| S[Sentinel 动作闸门]
  L -->|登录态网页| S
  L -->|浏览器| S
  L -->|屏幕 Hands| H[一次截图到一次动作]
  H --> S
  S -->|允许| X[本机执行或调用另一设备]
  S -->|拒绝| R[返回拒绝原因]
  S -->|需要批准| P[用户一次性或限定范围授权]
  P --> X
  X --> T[轨迹与审计记录]
  T --> A1
  A1 <-->|可选同步文本| Y[nanoMuse Relay]
  Y <-->|拉取与推送| A2[其他设备上的 Agent]
理解这套系统时,需要区分“会话文本同步”和“设备能力共享”。中继让同一账户在不同设备上看到主会话,但远端设备仍然使用自己的 Sentinel;发起任务的设备不能把自己的权限借给另一台设备。这个设计比“云端一个代理控制所有终端”更复杂,却更接近多人拥有多台设备、每台设备权限不同的现实。
方法详解:一台设备一个代理,一次动作一道闸
1. 系统拓扑:设备是代理,不是云端的显示器
nanoMuse 的 Android 客户端基于 OpenMinis 修改,应用内有沙箱化 Alpine Linux、shell、浏览器、MCP 服务、技能和计划任务;桌面端是 Electron 外壳包住 DeepSeek harness 与 nanoMuse 插件;Web 端由用户自己的电脑运行同一套 Python 运行时。中继不是推理必经之路,单设备使用自己的模型密钥时,设备可直接连接模型提供方。
这让系统有三种运行形态:一台设备加自带密钥,不需要账户与服务器;多台设备使用社区中继;用户用 Docker 在最小云主机上自建中继。第一种形态保护了离线与本地优先,第二种降低了跨设备试用门槛,第三种把账户与账单控制权交还给用户。三者共用同一套客户端协议,因此不是三个互不相关的产品。
2. 操作阶梯:能用工具就不动用屏幕
面对一个任务,代理先尝试最低成本、最容易审计的路径:已有技能、命令行工具或 MCP 服务;其次是用用户登录态读取网页;再次是浏览器;最后才操作设备自己的图形界面。这个顺序与 MAS-Bench 对手机代理“快捷工具与屏幕操作混合”的观察一致。屏幕操作能力很强,但每多一步视觉判断,就多一份延迟、误点和不可解释风险,因此它被放在最后且默认关闭。
这种阶梯还有一个工程意义:结构化接口能直接声明参数、风险和出口目标,而视觉点击只能从模型生成的句子和界面元素标签推断意图。系统把后者视为高成本兜底,而不是所有任务的统一入口。
3. Hands:一张截图只换一个动作
Hands 的核心循环见 nanomuse/phone/operator.py。每一步,操作模型收到任务目标、当前截图、每步一句话的简短历史,以及设备能提供的无障碍节点;它输出一段“准备做什么”的想法和一个工具调用。坐标统一放在 999×999 的归一化空间,再由真实屏幕尺寸映射回像素。把长任务拆成一次截图、一次动作、再截图,能及时吸收界面变化,也避免模型一次生成很长且无法逐步核验的动作序列。
若把第 $t$ 步的可观察状态记为 $s_t$,目标记为 $g$,历史压缩为 $h_{<t}$,用户语言信息记为 $u_t$,则这条交互链可以概括为 $a_t=H(s_t,g,h_{<t},u_t)$。这不是论文给出的训练公式,而是对其单步闭环的符号化表示:观察、目标和历史共同决定一个可执行动作。
Mobile 与桌面使用不同工具方言,但都保留“想法 + 一个函数调用”的格式。移动端动作包括点击、长按、滑动、输入、打开应用、系统按钮、等待、询问、交接和终止;桌面端则扩展为鼠标组合、键盘组合、拖动与滚动。模型给出的人类可读句子并非装饰,Sentinel 会检查这句话中是否出现付款、转账、下单、发送、删除等承诺性词,从而把一个纯视觉问题转换为可执行策略能够审查的文本问题。
执行层在提交点击前还会读取落点附近的无障碍文本,并采取“模型措辞”和“界面标签”中更严格的判断。密码框获得焦点时,系统要求用户自己完成敏感输入。运行期间,手机显示带停止按钮的悬浮胶囊和下一次点击落点环,电脑显示屏幕边缘提示;完整轨迹保存在聊天中,用户可以选择“我来接手”。这些交互把可停止性和可追踪性直接放进动作发生处。
4. Sentinel:先定顺序,再谈同意
源码中的 Sentinel.guard() 是所有工具调用的事实入口。它先让工具评估参数、目标与网络出口,再按固定优先级做策略判断;需要批准时向客户端发起请求,只有获得允许后才解析凭据并执行。执行后,它更新会话污染状态、对结果中可能出现的秘密做脱敏,并写入审计日志。论文强调“代理从不直接执行工具”,在代码路径上可以找到对应。
决策顺序依次是:禁用工具;用户自定义规则;永久允许与永久询问列表;会话污染;工具风险相对当前模式;最后是警告。若把类别写作 $D,R,L,T,M,W$,可用 $S(c)=\operatorname{first}(D,R,L,T,M,W)$ 表示“第一个命中的规则决定结果”。这里的函数同样是对论文文字顺序的压缩记法,不是说作者给出了形式化策略语言。
| 顺序 | 检查层 | 作用 | 可否被“总是允许”绕过 |
|---|---|---|---|
| 1 | 禁用工具 | 硬性移除不允许出现的能力 | 否 |
| 2 | 个人规则 | 用户对工具、目标或路径的明确限制 | 否 |
| 3 | 允许/询问列表 | 把常见安全动作或敏感动作归入固定策略 | 部分 |
| 4 | 污染状态 | 读过隐私数据后,外发动作至少需要批准 | 不可反向清除 |
| 5 | 风险与模式 | 比较动作风险与用户选择的保守程度 | 是 |
| 6 | 警告 | 危险 shell、立即执行下载、承诺性标签等 | 否,只能本次批准 |
5. 授权不是一个“是”,而是有范围的凭证
用户批准一次动作时,系统保存的是工具与目标共同决定的授权,而不是永久的全局布尔值。授权可以只生效一次、只在当前会话生效、在有限时间生效,或者在可命名目标上长期生效。可长期保存的授权会出现在权限页,并能被撤销。带警告的动作没有长期选项,因此付款、密码相关动作或危险命令不会因为用户说过一次“总是允许”就永久放行。
污染规则是这套设计的另一根轴。当某段会话读取了用户隐私数据,后续任何发送到允许列表之外的调用都会提升为询问;这个状态不会被普通操作反向清除。它不能代替内核级隔离,但能阻止“先读私人文件、再悄悄上传”的最常见组合。
6. 跨设备:同步会话,不同步一张万能通行证
中继协议把设备视为对等代理。任何设备的代理都能把其他设备当作工具,例如在手机上找订单号,再把结果写入电脑上的表格。接收动作的设备先收到请求,再由本机 Sentinel 和本机用户决定是否允许;发起设备不能把自己拥有的授权转交给远端。这个约束使跨设备任务仍然遵循“动作在哪里发生,边界就在哪里生效”。
同步引擎的实现细节比论文正文更具体。用户消息发送时立即推送,助手最终消息延迟 2 秒合并推送;拉取在启动、登录、中继通知时发生,并每 60 秒轮询一次。完整历史每页 200 条,新设备首次拉取只取最新 300 条消息及会话,以便快速显示主会话。默认只同步主会话,侧会话需要用户开启;附件只同步文件名和大小,不传输文件内容。系统用消息标识去重,避免设备把自身推送回显再次插入。
| 参数 | 实现值 | 目的 |
|---|---|---|
| 用户消息推送 | 发送时立即 | 让其他设备尽快看到正在发生的事情 |
| 助手消息合并 | 2 秒 | 避免流式结束前产生多次无效推送 |
| 常规拉取间隔 | 60 秒 | 用低频轮询保持最终一致 |
| 历史分页 | 200 条/页 | 限制单次请求大小 |
| 新设备首次尾部 | 300 条消息 | 先恢复最近上下文,再按需补旧历史 |
| Hands 坐标空间 | 999×999 | 跨不同分辨率稳定表达点击位置 |
7. 中继知道什么,不知道什么
论文对中继数据面给出了明确清单。它保存账户的散列标识、签发密钥及设备归属,保存模型调用账本中的模型、词元数量与成本,保存代理配置、设备在场状态,以及用户选择同步的会话文本。它不保存文件、图片或工具原始结果。关闭同步会删除已存会话;删除账户会清除账户数据,吊销密钥的散列只保留 90 天,用于让离线设备得知账户已不存在。
但隐私判断不能只看字段清单。主会话默认同步,意味着聊天文本会存在共享社区中继;社区中继还默认开启“帮助改进模型”的聊天文本留存,用户可以一键关闭,自建中继则可自定义默认值。论文自己也把这组默认值列为最没有把握的选择。因此,nanoMuse 的“开放”降低了平台锁定,却不自动等于匿名或本地-only;涉及敏感内容时仍应使用单设备模式或自建中继。
8. 记忆:可编辑文件与可撤销变更
手机上的长期记忆首先是 Markdown 文件:代理身份在 SOUL.md,用户画像在 USER.md,跨会话稳定事实在 GLOBAL.md,另有按日期记录的日记和代理例程 HEARTBEAT.md。这使记忆不再被锁在一个不可见的向量库中,用户可以打开、修改、迁移和删除。
桌面实现则用 SQLite 保存事实条目。检索先按词元稀有度计算重叠,再在配置了嵌入端点时融合语义排序;中文文本会按字符二元组处理,而不是只依赖空格分词。每次合并、改写和删除都进入变更日志,保留改动前后的内容并能撤销。源码中的 nanomuse/memory/store.py 还说明,遗忘操作本身也会被记录,避免清理动作消失在系统里。
不过,可编辑与可追溯并不等于可信。当前记忆项没有完整记录是哪一个模型、何时、以多大置信度写入,也没有强制执行“新证据覆盖旧事实”的复核规则。一个能力较弱的模型曾经写下的猜测,可能被后续更强的模型当成稳定事实继续读取。这是论文作者主动承认的缺口,也是个人代理长期运行时最危险的隐性错误之一。
9. 模型选择与设备成本
nanoMuse 自带十八个模型提供方的共享目录,覆盖聊天、视觉、图像与视频能力;用户可填自己的密钥,也可通过 OpenAI 的 Codex 授权流程使用订阅计划,或者在本地运行模型服务器。单设备直连时,中继不参与推理,只有模型请求会离开设备。
论文中的数字来自发布文件、一次安装和项目文档,不是规模实验。Android arm64 安装包为 38 MB;桌面下载包从 Linux 的 256 MB、Windows 的 266 MB 到 macOS 的 498 MB,Linux 安装后约 928 MB,全进程空闲内存约 0.5 GB;中继是一个 Python 进程和一个 SQLite 文件,空数据库空闲约 85 MB,最小规格为 1 vCPU、1 GB 内存。
| 部件或资源 | 论文报告值 | 测量口径 |
|---|---|---|
| Android 客户端 | 38 MB | arm64 发布文件下载大小 |
| Linux 桌面客户端 | 256 MB | 发布文件下载大小 |
| Windows 桌面客户端 | 266 MB | 发布文件下载大小 |
| macOS 桌面客户端 | 498 MB | 发布文件下载大小 |
| Linux 安装占用 | 约 928 MB | 一次实际安装 |
| 桌面空闲内存 | 约 0.5 GB | 所有相关进程合计的比例驻留集 |
| 中继空载内存 | 约 85 MB | 全新数据库、单个 Python 进程 |
成本方面,论文给出自建中继在中国大陆约每月 30 至 60 元人民币,境外约每月 4 至 6 美元。若记月度中继成本为 $C_{\mathrm{relay}}^{\mathrm{CN}}\in[30,60]$ 与 $C_{\mathrm{relay}}^{\mathrm{US}}\in[4,6]$,它们只是最小服务器档位的估算,不含模型调用。这个价格说明了为什么“每用户一台云虚拟机”与“每用户一个小型同步节点”是两种不同的产品经济。
模型价格以阿里百炼 2026 年 10 月繁忙时段列表为例。聊天模型每百万词元输入 2 元、输出 8 元,可写作 $C_{\mathrm{chat}}=2t_{\mathrm{in}}+8t_{\mathrm{out}}$;Hands 模型每百万词元输入 3 元、输出 12 元,可写作 $C_{\mathrm{hands}}=3t_{\mathrm{in}}+12t_{\mathrm{out}}$。这些是解释性成本记号,不表示论文提出了新的计费公式。视觉操作每步都要截图和模型推理,因此即便单次聊天价格很低,长轨迹的实际成本仍取决于步数、图像编码与失败重试。
| 费用项 | 论文估算 | 是否包含模型 |
|---|---|---|
| 自建中继,中国大陆 | 每月 30–60 元 | 否 |
| 自建中继,境外 | 每月 4–6 美元 | 否 |
| 聊天模型输入 | 2 元/百万词元 | 繁忙时段示例价 |
| 聊天模型输出 | 8 元/百万词元 | 繁忙时段示例价 |
| Hands 模型输入 | 3 元/百万词元 | 繁忙时段示例价 |
| Hands 模型输出 | 12 元/百万词元 | 繁忙时段示例价 |
10. 源码与论文的对应关系
把源码与正文连接起来后,这套报告的可信度比只看截图高得多。Sentinel.guard() 确实承担完整准入流程,PhoneOperator._steps() 确实使用截图、历史和归一化坐标生成单步动作,PhoneOperator._act() 又确实把该动作交给 Sentinel,而不是绕过它直接执行。同步参数的证据则来自同步引擎顶部常量与后续推拉逻辑,与论文中的设备连续性描述相互印证。
代码还暴露了产品报告容易省略的复杂度:一次操作要经过模型方言解析、坐标映射、界面状态检查、敏感字段判断、授权请求、设备链接和轨迹记录;跨设备同步还要处理账户所有权、主会话归属、侧会话开关、消息去重和设备在场过期。这些都不是一个提示词能替代的运行时工程。
结果与评估:它证明了可运行性,还没有证明代理可靠性
论文最有说服力的结果不是某个成功率,而是端到端可构造性:Android、iOS、桌面和 Web 客户端与开源中继已经形成完整数据路径;Android 与桌面屏幕可以执行动作;同步、记忆、模型选择和权限撤销都能在同一套系统里工作。对一个此前主要由闭源产品定义的“个人智能体”类别,这本身具有工程价值。
报告用五问三阶段框架评价这类系统:它知道什么、在哪里行动、向谁负责、如何学习、如何付费与治理。nanoMuse 在“可读记忆”“多设备行动”“可撤销审批”“模型与中继可替换”上给出了完整起点,但记忆缺少来源与置信度,主动学习主要停留在路线图,动作成功率也没有测量。论文把它定位为“最小但完整”,并未把它说成已达到 Muse 的产品成熟度。
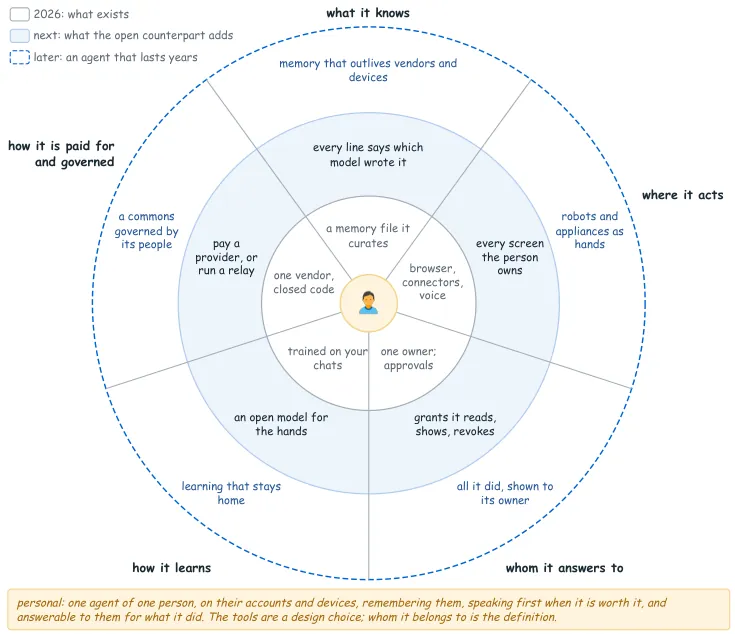
若与 Muse 对比,nanoMuse 的优势是本机 Hands、全栈开源、模型可替换和无服务器单设备模式;不足是没有专属虚拟机、内核级污染跟踪、代币替换、钱包、工件空间与大团队打磨。与 OpenMinis 相比,它补上身份、记忆、跨设备与安全边界;与 CopilotKit 的 OpenMuse 相比,它把代理放在设备上,因此获得本机界面访问,但也继承了客户端资源与设备安全风险。
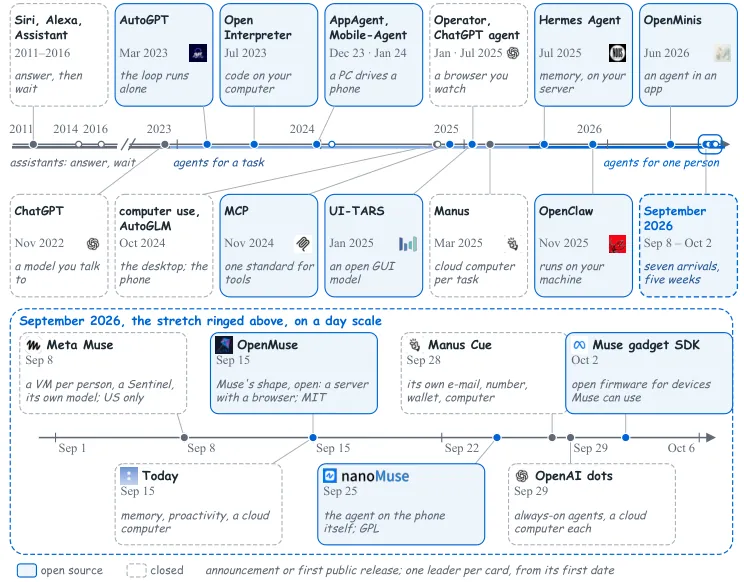
论文的时间线也提醒读者,这是一份快速演进的工程快照。nanoMuse 首个版本在 2026 年 9 月 25 日发布,报告对应 0.1.40;Muse 的公开能力、提示词和安全结构在几周内连续变化。所有“当前实现”都可能被下一版覆盖,版本号与提交哈希因此比产品宣传语更有用。
缺少标准化实验并不妨碍这篇报告提出一个关键判断:个人代理的难点不是把聊天模型接进应用,而是让它在许多真实界面、许多设备、许多权限目标上持续工作且不越界。这个判断需要后续用 AndroidWorld、OSWorld、MemGUI-Bench 与 OS-Harm 一类测试验证;目前只能确认系统有可被测量的骨架,不能确认其动作层已经稳健。
局限性
策略边界不等于特权边界。这是作者最明确的自述限制。单设备中,Sentinel 与代理处于同一信任域;模型被诱导时规则能拦截动作,但如果宿主设备或代理进程本身失陷,真正凭据与策略引擎仍可能一起暴露。Muse 那种代理触达不到的外部宿主权限,在 nanoMuse 中尚不存在。
Hands 尚未给出成功率与接管次数。论文明确承认当前没有可报告的数字。界面只有图标、没有语义标签时,模型措辞和可访问文本都难以判断下一步是否敏感;密集专业界面中,连定位按钮都没有完全解决。人工观察点击环仍是一条实际安全防线,但这说明自动化成熟度仍低。
平台覆盖有限。Linux Hands 只支持 X11 会话;iOS 不能操作其他应用,因此必须把任务交给其他设备或用户。手机与桌面虽然共用操作思路,但输入方式、权限模型和异常恢复差异很大,当前证据不足以证明一套策略可无成本迁移。
记忆没有来源语义。变更日志记录“改了什么”,却没有稳定记录“谁写的、何时写的、为何相信、是否复核”。长期使用后,模棱两可的旧判断会与新证据并存;如果没有人物写入优先、时间衰减与周期复核,代理可能越来越自信地重复早期错误。
共享中继与训练默认值需要审慎使用。社区中继由项目方在单机上运营并保存会话文本,新账户默认开启用于改进模型的聊天文本留存。项目提供了删除、关闭与自托管能力,但默认路径仍不是最保守配置;这会直接影响用户的隐私决策。
对 Muse 的证据存在边界。报告依赖公开文档、已发布客户端和一份无法验证来源的生产提示词副本。“提示词记录”不等于系统完整实现,论文用四类证据标记区分观察、提示词、推断与公开文档,方法上诚实,但读者不能把所有推断当成已被厂商确认的事实。
总结与展望
nanoMuse 是一套把个人代理产品拆开供人检查的工程方案。它用设备端代理解决云窗口距离真实界面的距离,用可选中继解决跨设备连续性,用 Sentinel 解决“模型可以提议但不能自行授权”的问题,用可编辑记忆解决用户对长期上下文的所有权。它的不足同样清楚:没有成熟基准,没有可证明的 Hand 成功率,也不是独立特权边界。
下一步最值得观察的不是再增加多少应用连接器,而是路线图中的失败轨迹评测、Hands 专用开源模型与记忆来源机制。如果这三项落地,nanoMuse 才能从“可运行的开放替代品”走向“可以长期托付的个人代理”。在此之前,它更适合作为研究者、开发者和高阶用户的可审计基线,而不是无人监督的支付或账户管家。
“个人智能体首先是一种长期承担责任的软件形态,而不是一个更会聊天的模型。”