PAPER DEEP DIVE
WildAWM:为计算机使用智能体合成可执行世界与长程任务
WildAWM 针对的痛点很具体:计算机使用智能体不缺模型,缺的是能让它反复试错的环境。在真实系统上直接做交互式学习既慢又有副作用,而现有合成环境的状态规模只有千级 token、任务也偏短。这篇工作把环境合成拆成两段:先由人格与日程驱动,生成 640 个可执行状态、中位 52.4K token 的世界(对照 CUA-Gym 的 1.1K),并配 83 个技能与 17.16 万条数据库记录;再用五道门禁(裁判一致性、初始未满足、可解性、难度、反事实探针)筛出 341 个长程任务,其中 273 个困难、68 个中等,平均 4.2 个子任务、3.1 次界面切换,74.5% 的任务需要重访同一界面。训练侧用 18 个模型-框架组合跑出每题 6 条轨迹,SFT 预热后接带自适应 rollout 与清单式奖励的 GRPO:4B 平均提升 8.21 分、35B 提升 10.58 分,而 GPT-6-Astra 在这套题上也只有约 60% 通过率。代价同样写得很清楚:单题合成约 6980 万输入 token(p90 1.309 亿),而按题目难度分箱后,最难的那四分之一(多为 OS-2 / ALE 上的超长任务)对所有变体都几乎没有增益,说明这套流水线抬高了中位难度,天花板还没顶开。
论文元信息
标题:Agent World Model in the Wild: Computer-Use Agent Environment Synthesis(野外的智能体世界模型:计算机使用智能体环境合成,简称 WildAWM)
作者:Zhaoyang Wang、Qianhui Wu、Haorui Wang、Simon Yu、Baolin Peng、Canwen Xu、Hao Cheng、Wenlin Yao、Boyi Liu、Yite Wang、Jianfeng Gao、Huaxiu Yao;单位:UNC-Chapel Hill、Microsoft Research、Georgia Tech、Northeastern University 与独立研究者(通讯邮箱 zhaoyang@cs.unc.edu、qianhuiwu@microsoft.com)
链接:arXiv:2610.26828(v1,2026-10-19,cs.AI,arXiv 永久非独占许可)· arXiv HTML 全文 · 项目主页
代码状态:✅ 已完整开源(2026-10-19 同日放出论文、代码、环境与任务、训练权重)。github.com/MSR-Orchard/WildAWM 约 35 MB,分成 synthesis/(世界与任务合成流水线,含 5 个 Dockerfile、dashboard、worldctl 服务)、evaluation/(8 个域外基准的统一评测器 awmeval)、wildawm_cli/ 与 wildawm_common/ 四个包。数据与模型在 Hugging Face:ChilleD/WildAWM(341 组环境-任务对)、WildAWM-35B-A3B、WildAWM-4B。
一句话定位:这不是又一个 GUI 基准,而是一条「用开源模型造世界、在造出来的世界里做在线强化学习」的完整流水线,并且把「造出来的题到底可不可信」这件事拆成了五道可执行门禁。
一句话总结:WildAWM 用开源编码智能体从「人格 + 多日日程」出发,逐日物化出 640 个可确定性重放的个人电脑世界状态(中位 52.4K token,而 CUA-Gym 的任务注入状态中位只有 1.1K),再在这些世界上生成必须同时用到 GUI、MCP、CLI 三种界面的长程任务;每道题都要经过 18 组异构模型-框架的 6 条 rollout、三级判定与五道质量门禁(裁判一致性、初始未满足、可解性、难度、反事实探针)才被接受,最终得到 341 道题(273 难 / 68 中)。仅在这些合成世界里训练,Qwen3.6-35B-A3B 与 Qwen3.5-4B 在 8 个域外基准上平均分别提升 +10.58 与 +8.21 分,而 GPT-6-Astra 在这套题上也只有约 60% 的 pass@1、八次尝试后仍有 27.3% 做不出来。
研究背景与动机
论文的出发点是一句被反复引用但很少被兑现的判断:智能体的学习正在从「向人类学」转向「向世界学」。向人类学受两件事限制——示范数据贵,而且能力上限就是示范者本身;向世界学则要求有可执行的环境供智能体试错,于是环境供给本身变成了瓶颈。作者没有停留在口号上,而是直接指出在真实计算机系统里做在线 RL 的三个硬伤:状态难以复位(把一台真机恢复到某个精确的历史状态几乎不可能)、在线服务会随时间变化(今天的网站和下周的网站不是同一个环境)、探索性动作会产生不可撤销的后果——脚注里甚至直接引了 OpenAI 关于真实世界 RL 的事故报告。手工搭建的环境能恢复可控性与可验证性,但贵且难扩展。
第二个动机来自「计算机使用」这件事本身的定义。作者刻意采用了一个比主流更宽的口径:一个真实的电脑任务由能完成什么定义,而不是由某一种交互模态定义。同一件事可能要走图形界面点几下、在终端里写个脚本、再调一次 MCP 服务,因此界面选择与界面之间的协调本身就是核心能力。而现有合成流水线基本各自只盯一种模态:浏览器使用、工具调用、终端工作流;即使是计算机使用智能体(CUA)方向的工作,也主要围绕 GUI 展开。论文表 1 把这条谱系摆得很清楚——AWM、WebArena-Infinity、Gym-Anything、CUA-Gym 只做 GUI,TMax 与 Synthetic Computers 只做 CLI,CUA-Universe 覆盖 GUI+CLI,而 WildAWM 是同时覆盖 GUI、MCP、CLI 三者、且作用域是整台个人电脑(PC)而非单个应用的那一个。
第三个动机最容易被忽略,却是这篇工作与同族工作最实的差别:合成用的模型全部是开源的。表 1 里其余七条流水线的合成模型分别是 GPT-5、Opus 4.6、Opus 4.5/4.6、Gemini-3-Pro、Sonnet 4.6、GPT-5.6,而 WildAWM 一栏写的是 OpenSource(生成器与裁判都用 GLM-5.2,rollout 集成用 GLM-5.2、DeepSeek-V4-Flash、MiniMax-M3)。作者把这一点当作可复现性、透明度与可及性的论证:如果造环境必须买前沿闭源模型的 API,那么这条路线的规模上限就由别人的定价和限流决定。
第四点是任务合成的三重困难,论文把它们明确写成三条:任务必须在合成出来的世界状态下可解;必须足够难以提供有用的学习信号;必须配一个可靠的验证器来区分「真的做完了」和「看起来做完了」。作者对第三条的态度尤其强硬——不能依赖「前沿模型说对就算对」这种简化假设。这直接催生了后面那套基于执行证据的多智能体质量门禁,以及一个很聪明的设计:利用大模型的谄媚性(sycophancy)反过来做验证器压力测试。
最后一条动机是「真实感」的粒度。现有方法常合成视觉上被简化的应用,并且把每个应用做成孤立环境;而真实的电脑使用发生在一个连通的数字工作空间里——网站、应用、MCP 服务、本地文件共存于同一台可执行的个人电脑中,并且状态是随时间累积的。WildAWM 因此选择从「一个人过了很多天日子」这个角度造世界:今天能做的任务,依赖的是过去十天攒下来的聊天记录、库存表、凭证文件和退货工单。这一点在后文的案例研究里体现得非常具体。
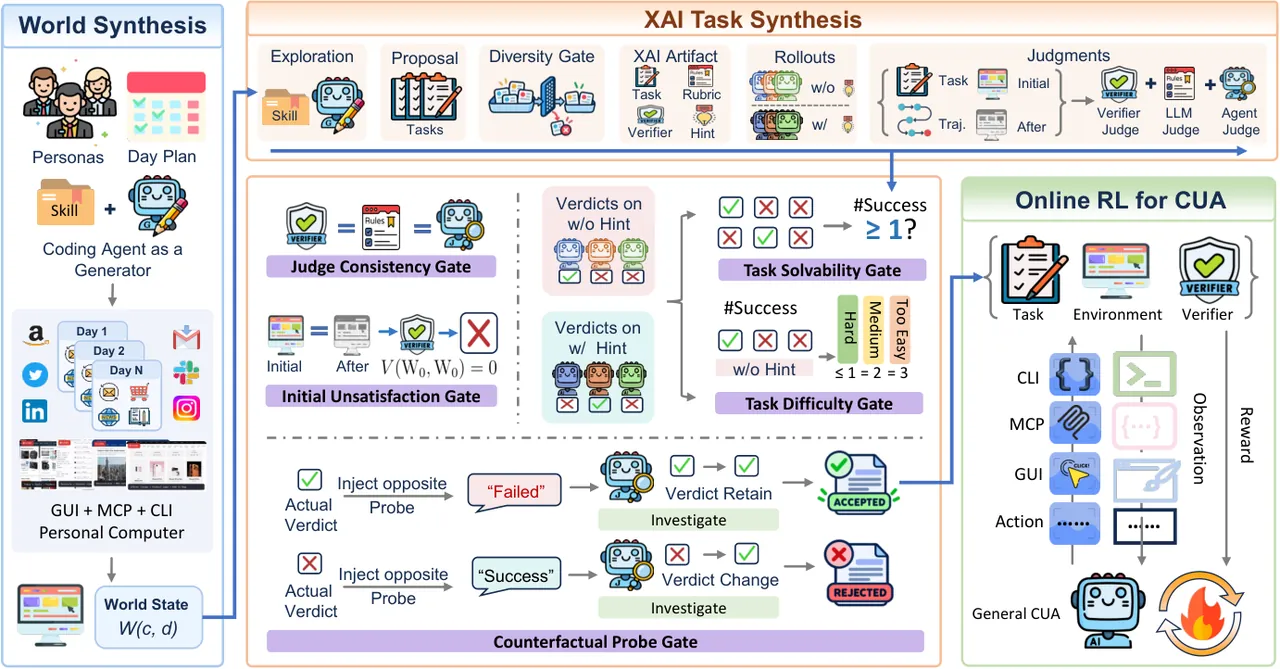
图 1:WildAWM 总览(论文 Figure 1)。第一阶段 World Synthesis 用编码智能体构造人格驱动、跨多日的世界状态,环境同时暴露 GUI、MCP、CLI 三类界面;第二阶段 XAI Task Synthesis 通过五道质量门禁生成跨界面任务,考察可解性、难度与验证器可靠性。产物是 {task, environment, verifier} 三元组,直接用来训练通用 CUA。
预备知识:世界、任务与验证器
论文用三个符号把整套流水线钉住。世界被定义为一台个人电脑的累积状态,包含网页应用、可经 MCP 访问的服务,以及记录某人日常活动的本地文件;人格 $c$ 在第 $d$ 天之后的累积状态记作 $W(c,d)$,它既是环境的初始化来源,也是复位点。为了让多模态 GUI 交互有足够的视觉底料,作者把 WebHarbor 的 15 个镜像网站整合进来(AllRecipes、Amazon、Apple、arXiv、BBC News、Booking、Cambridge Dictionary、Coursera、ESPN、GitHub、Google Search、Google Flights、Google Map、HuggingFace、WolframAlpha),这也是表 1 里 WildAWM 的合成来源被标为「From-Scratch + Seed-Grounded」的原因:GUI 底座与图像内容来自种子,其余状态从零合成。
任务记作 $\tau$,被要求同时使用三种界面,论文称之为 XAI(cross-agent interface)任务。验证器 $V$ 是一段可执行程序,输入是初始世界状态 $W_{0}$、最终世界状态 $W$ 与智能体的最终回答 $a$,输出是一个由 $N$ 条二值判据组成的清单:
$$v_{i}(W_{0},W,a)\in\{0,1\},\qquad V(W_{0},W,a)=\prod_{i=1}^{N}v_{i}(W_{0},W,a)$$
乘积形式意味着「全部判据都通过才算成功」,而单条判据的得分本身可以作为细粒度反馈与长程 RL 的价值估计——这一点在后文的奖励设计(式 1)里被直接用上。生成器除了 $\tau$ 与 $V$,还要产出评分细则 $R$、提示 $h$,以及一份把 $\tau$ 分解成有序子任务的文档。这些产物在合成期用于门禁判定,在训练期则只有程序化验证器 $V$ 会被拿来当奖励函数。
方法详解
整条流水线可以概括成三句话:先造世界,再造任务,最后在世界里做在线 RL;而任务能不能进池子,由执行证据说了算。下面这张图按论文真实结构(§3.1–§3.3 与附录 A.3–A.6)画出了数据流与失败回路。
flowchart TB
    subgraph SG1["阶段一 世界合成 GLM-5.2 加 OpenCode 框架"]
        P1["人格圣经
职业 至少 3 位具名联系人
2 到 5 条多日故事线 其中至少一条图像决定性"]
        P2["日程规划
读取 W c d-1 保持连续性
按应用与站点使用直方图施加覆盖压力"]
        P3["技能增强实现
匹配 83 个可复用事件技能
缺服务则实现 schema 后端与 MCP server"]
        P4["delta.sh 确定性重放
时间戳写成冻结字面量
主键由 MAX id 加 1 派生 插入幂等"]
        P5["五层世界校验
静态 lint 两次重放哈希一致 声明核对
实机健康检查 容器外独立评审 agent"]
    end
    subgraph SG2["阶段二 XAI 任务合成"]
        T1["任务生成
探索已启动的真实环境
提案必须同时用到 GUI MCP CLI"]
        T2["多样性门
与已接受及并发在研任务比相似度
挑最不相似的那批"]
        T3["产出四件套
任务规范 可执行验证器 V
评分细则 R 提示 h 与子任务分解"]
        T4["异构集成 rollout
每题 6 条 半数带提示
3 个开源模型 乘 6 个框架 共 18 组"]
        T5["三级判定 视为验证的测试时扩展
程序化验证器 V 加 LLM 裁判
加多轮实地查环境的 agent 裁判"]
    end
    subgraph SG3["五道质量门禁"]
        G1["裁判一致性
V 等于 V_LLM 等于 V_agent 全部 6 条"]
        G2["初始未满足
V W0 W0 空集 等于 0"]
        G3["可解性
至少 1 条成功 且用满声明的每种界面"]
        G4["难度
3 条无提示 rollout 的 k 不超过 1 判 hard
k 等于 2 判 medium k 等于 3 打回"]
        G5["反事实探针
把相反结论摆给 agent 裁判要求重查
改验证器脚本即判 cave"]
    end
    subgraph SG4["阶段三 通用 CUA 训练"]
        R1["SFT 预热
100 条 GLM-5.2 轨迹 3 个 epoch"]
        R2["GRPO 在线 RL
清单式部分得分权重 0.1 除以 N
格式失败直接给 减 1"]
        R3["自适应 rollout
乘子上限 3 按 8 条一块追加
成组时必须出现两种不同奖励"]
        R4["分段式训练
在上下文压缩处切段 保留段内因果
前向次数由 T 降到 M"]
    end
    P1 --> P2 --> P3 --> P4 --> P5
    P5 -->|640 个世界状态 W c d| T1
    T1 --> T2 --> T3 --> T4 --> T5 --> G1 --> G2 --> G3 --> G4 --> G5
    G5 -->|全部通过 341 题| POOL["任务池
100 条 SFT 208 条 RL 33 条域内评测"]
    G5 -->|任一门禁失败 附诊断证据| FIX["最多两轮修订
修订后必须重过全部门禁"]
    FIX --> T3
    POOL --> R1 --> R2
    R3 --> R2
    R2 --> R4
    R4 --> OUT["WildAWM-4B 与 WildAWM-35B-A3B
8 个域外基准全面提升"]
图 2:WildAWM 全链路(依据论文 §3.1–§3.3、附录 A.3–A.6 的真实结构绘制)。两个回路是关键:门禁失败带着诊断证据回到生成器、最多两轮修订;被拒的题不会白跑,其教训会被吸收进生成器不断演化的技能库。
1. 世界合成:从一个人格到 640 个可重放状态
世界合成的第一步不是写代码,而是造人。人格创建 agent 拿到一份「宪法」(constitution,即约束交付物与质量标准的系统提示),要求它为一个具体、真实的人产出一份 persona bible。关键在于「grounding」:agent 必须先去看 15 个 WebHarbor 种子数据库和当前的共享 MCP 应用索引,确保这个人的数字活动引用的是目录里真实存在的实体——真实的商品、课程、酒店。全新开局时没有任何 MCP 服务,因此每个人格要给出 4 到 8 个服务的地面化路线图,绑定到具体故事弧;缺失的服务由专门的 application-creator 阶段在首次使用时实现,并发布到共享库供后续日期与其他人格复用。交付物还包括结构化档案(人口统计、至少 3 位具名联系人、工具与服务、多日故事弧且至少一条是图像决定性的)、带确定性口令哈希的网页账号凭证,以及一个供多样性门使用的紧凑签名。
多样性由一个 LLM 裁判强制执行:候选人格要与所有已接受人格比对,若与任一既有人格共享同一职业与生活领域、同一核心工具或站点使用模式、或同一叙事弧线,直接拒绝;被拒的候选会收到诊断反馈,最多修订两次。日程规划同样是顺序的:day planner 拿到 persona bible、此前所有日程,以及对截至第 $N{-}1$ 天累积世界状态的读权限,输出一份 markdown 计划,覆盖电脑使用活动、带连续性的 MCP 服务事件(例如消息串的回复、日历更新)与引用真实目录实体的网页 GUI 动作。计划里还塞了一个「覆盖压力」项——前几日各应用与各站点的使用直方图,用来推着规划器在不同日子分散界面使用。
物化阶段由一个「god-mode」编码智能体完成:它跑在一个已启动的活世界实例里,对 MCP 服务、WebHarbor 数据库与文件系统有完整访问权,交付物是一个 delta.sh(配确定性的 Python 子脚本),在第 $N{-}1$ 天状态上封闭重放即可每次都一模一样地复现第 $N$ 天。确定性不是靠约定,而是靠几条硬约束:时间戳必须写成冻结字面量(绝不允许 datetime.now())、主键必须派生(MAX(id)+1)、插入必须幂等、口令必须用来自人格 accounts.json 的固定盐哈希。计划要求的能力不存在时,实现者可以产出一个 overlay,包含新的 MCP server 或 WebHarbor 代码补丁。所有世界实例共用同一套应用层,但各自持有可变状态的隔离副本(服务数据库、网站历史、本地文件)。
这套流程的产物规模值得单独看一眼,因为它解释了后面「环境中位 52.4K token」是怎么来的:
| 维度 | 数值 | 维度 | 数值 |
|---|---|---|---|
| 人格数 | 36 | 网站 / MCP 服务 | 15 / 8 |
| 世界状态数 | 640 | 可复用事件技能 | 83 |
| 每人格状态数 | 17.8 | 每人格站点 / MCP | 5.25 / 5.44 |
| 日均触碰站点 / MCP | 3.97 / 5.31 | 数据库记录总数 | 171.6K |
| 日均触碰表 / 文件 | 15.38 / 4.97 | 本地文件数(末日均值) | 50.1 |
| 每日世界体积增量 | 30.9 KiB | 单个世界状态体积 | 59.3 MiB |
表 1:世界合成统计(论文 Table 2)。「触碰」指当天合成过程中被修改的服务或数据库。每个人格被物化成 8 到 30 个世界状态,36 个人格共 640 个;其中 246 个状态至少承载了一道被接受的任务,每个状态最多开三个任务槽位。
2. 确定性是被设计出来的:delta.sh 与五层世界校验
合成世界最容易翻车的地方不是「生成不出来」,而是「生成出来的东西每次都不一样」。作者用五层门禁把这一天固化下来:① 确定性静态检查——delta 脚本要过 lint,其中包含一个跨人格身份检查,拒绝使用已被其他人格预留的名字;② 重放确定性——delta.sh 从同一个第 $N{-}1$ 天状态重放两次,两个世界的内容哈希必须完全相同;③ 声明核对——produces.json 里声明的每一次数据库写入、网页写入、账号、文件与交叉引用都要在物化后的世界里核实,声明了却缺失或未变更即判当天失败;④ 实机健康——世界被真正启动,每个声明的网页账号都要能用该人格的凭证登录、其历史页面能渲染,所有活跃 MCP 服务能加载,同时还要验证该人格的网页凭证在工作空间里是可发现的(否则后续解题者根本无法以这个人的身份登录);⑤ 评审 agent——一个独立的编码智能体,运行在实现者的容器之外的宿主机上,对照日程计划检查物化快照里的 MCP 事件、网页 GUI 状态、文件与确定性。
第 ④ 层里那条「凭证必须可发现」尤其能说明这套流水线的设计取向:它不是在检查世界是否自洽,而是在检查世界是否对未来的解题者可玩。同理,第 ⑤ 层把评审者放在容器外,是为了让判定者与被判定者不共享上下文——这与后面反事实探针的思路一脉相承。
技能库是另一条隐性的质量机制。每个事件技能规定了涉及的界面、要产生的状态变更,以及跨记录与文件的一致性约束;论文举的例子是「学生报名 Coursera 课程并完成作业」这一技能,会编码对应工作流与所需的数据库、文件更新。日程引入现有技能未覆盖的活动时,生成器会合成一个新技能;这些技能与服务实现都进共享库,供后续日期和人格复用。83 个技能与 8 个 MCP 服务,就是 36 个人格能共享 640 个状态而不互相抄袭的原因。
3. XAI 任务生成与多样性门
给定初始世界状态 $W_{0}=W(c,d)$,技能增强过的生成器会实地探索这个已启动的环境,基于可用的应用数据、服务记录与本地文件提出 XAI 任务,每道题都要求智能体使用全部三种界面。多样性门负责挑选:与已接受任务、以及其他并发 worker 正在开发的候选相比最不相似的那批提案才会被放行——注意这里连「正在开发中」都算进去了,说明合成是多进程并行的,去重必须在写盘之前发生。
被选中的提案随后被展开成完整交付物:任务规范 $\tau$、可执行验证器 $V$、评分细则 $R$、提示 $h$,以及子任务分解文档。这个组合的用意很直接——$V$ 用来做客观判定,$R$ 用来给 LLM 裁判语义判定的依据,$h$ 用来制造「有提示 / 无提示」两组难度不同的 rollout,子任务分解则用来核对「声明的界面是否真的被用到」。
合成漏斗的形态也值得记一笔:论文图 2 把候选的推进分成 Direct(首次尝试即通过)与 After feedback(在合成任一阶段经过至少一次反馈驱动修订后通过),并强调这个漏斗是单调的。配合表 4 的修订统计可以看出,最难过的两道门是可解性(平均 1.16 次修订)与裁判一致性(平均 1.09 次),而初始未满足门几乎不触发(0.05 次)——也就是说「任务在初始状态就已经算完成」这种低级错误已经被世界合成阶段的确定性约束挡掉了大半。
4. 18 组异构集成 rollout 与三级判定
任务与验证器生成后,作者用异构 agent 去实际尝试:成功的 rollout 提供可解性证据,成功率刻画经验难度,轨迹与结果则用来验证验证器本身。每题收集 6 条 rollout,其中一半带提示,来自 18 个模型-框架组合——3 个开源模型(GLM-5.2、DeepSeek-V4-Flash、MiniMax-M3)乘 6 个框架,框架又分三类编码智能体(OpenCode、Codex、Claude Code)与三类 claw 智能体(Nanobot、OpenClaw、Hermes Agent)。用「模型 × 框架」的笛卡尔积而不是单一强模型,是为了让判定证据不依赖某一个模型的行为习惯。
每条 rollout 要过三级判定,作者把它称作验证的测试时扩展:第一级是刚合成出来的程序化验证器 $V$;第二级是 LLM 裁判,对任务、评分细则、轨迹与验证器结果做语义评估;第三级是 agent 裁判,用 OpenCode 多轮主动检查初始与最终环境。agent 裁判很贵,因此只在合成期用来交叉核对判定、找出需要修订验证器的情形;RL 训练时的奖励函数始终是那个程序化验证器。这个分工很重要:贵的判定负责生产可信的奖励函数,便宜的奖励函数负责规模化的训练。
5. 五道质量门禁:把「题好不好」变成可执行判据
有了执行证据还不等于任务有效。论文提出五道门禁,全部通过才接受候选。
门禁一 · 裁判一致性。对第 $j$ 条 rollout,记其最终状态与回答为 $W_{j}$、$a_{j}$,LLM 裁判与 agent 裁判的判决为 $V_{\text{LLM}}^{(j)}$、$V_{\text{agent}}^{(j)}$,要求
$$V(W_{0},W_{j},a_{j})=V_{\text{LLM}}^{(j)}=V_{\text{agent}}^{(j)},\qquad \forall j\in\{1,\ldots,6\}$$
任何分歧连同相关证据都会退回生成器,用来修订评分细则 $R$ 与验证器脚本 $V$。这条门实际上是在用「三方独立判定必须重合」来给验证器做一致性检验。
门禁二 · 初始未满足。要求 $V(W_{0},W_{0},\emptyset)=0$,其中 $\emptyset$ 表示智能体没有采取任何动作。也就是说,把初始状态当成最终状态、把空回答当成答案,验证器必须判失败——否则这道题在世界生成的那一刻就已经「完成」了,任何智能体不动也能拿满分。
门禁三 · 可解性。裁判一致并不能证明可解,因为所有 rollout 可能全失败。这条门要求至少一条成功:$\sum_{j=1}^{6}V(W_{0},W_{j},a_{j})\geq 1$;此外每条成功轨迹还必须用到任务生成时声明的每一种界面,以此提供「跨界面工作流确实被执行过」的证据,而不是靠某个单界面捷径蒙对。
门禁四 · 难度。用无提示的三条 rollout 估计经验难度,令 $\mathcal{U}$ 为这三条的索引集:
$$k=\sum_{j\in\mathcal{U}}V(W_{0},W_{j},a_{j})$$
$k\leq 1$ 标记为 hard,$k=2$ 标记为 medium,$k=3$ 视为「太容易」,退回生成器要求加难。开源代码里这条门被实现成绝对成功数区间:hard 是 $[0,1]$、medium 是 $[2,2]$,并且在启动时校验两个区间必须连续且不重叠(bare_hard_max_completed + 1 == bare_medium_min_completed),区间上界还不得超过 live_test_n=3——配置写错会直接抛异常,而不是静默放行。
门禁五 · 反事实探针。前四道门部分依赖模型判定,包括 agent 裁判为修订验证器给出的反馈。既然 LLM 有谄媚性,作者就反过来利用它:给定某条 rollout 的判决 $V(W_{0},W,a)$,向 agent 裁判呈现相反的断言 $1-V(W_{0},W,a)$,要求它重新调查执行证据,得到 $V_{\text{probe}}\in\{0,1\}$;仅当 $V_{\text{probe}}=V(W_{0},W,a)$ 时候选通过,否则失败。换句话说,一个会被「你确定吗?我看它是失败的」这类反问就改口的裁判,其判定不被采信。
任一门禁失败的候选会带着诊断证据退回生成器,最多两轮修订,之后必须重新通过全部门禁;被接受的题进入多样性池,被拒的题则把教训吸收进生成器不断演化的技能库。最终统计是:341 道题里 273 道 hard、68 道 medium,平均 4.2 个子任务、3.1 次界面切换,74.5% 的任务需要重访此前用过的界面——这意味着智能体必须跨界面保持状态,而不能在一个界面里一路做完。合成期 rollout 的平均成功率只有 21.3%(带提示 45.6%),GLM-5.2 有时也要 100 步以上才能完成;与可解性和难度门一致,每道被接受的题都至少被一个 agent 解出,也没有任何一道被所有 agent 解出。
6. 一道被接受的长程任务长什么样
论文表 3 给的案例值得逐句读,因为它把前面所有抽象约束落到了一个具体场景上。任务委托人是一位自由职业音视频技师(附录 C 的人格档案:Lars Petersen,41 岁,明尼阿波利斯,为一家体育酒吧、一间教堂和一个社区剧场安装显示墙、音响与投影),他要为一面显示墙锁定机柜用的生产级防浪涌单元。委托人的批准躺在世界历史中更早某一天的聊天串里;工作空间里有从 day 0 起累积的机柜库存表、物料清单和产品规格书。因此这道题的解依赖世界随历史累积出来的状态,而不是某一刻的快照。
界面流是 MCP → CLI → GUI → CLI → MCP,五个子任务,两次回到 CLI 与 MCP:先在私信 MCP 服务里确认「Go, order it today」这条批准;再在终端里写并运行一个脚本,把三个异构本地来源(CSV 库存、markdown 物料清单、PDF 规格书)联接起来,按规格匹配度对候选防浪涌单元排序,输出短名单 CSV;然后到店面 GUI 上完成关键一步——两个候选在所有列出的规格上完全相同,只有可见外观不同,智能体必须去看商品图片才能挑出「白色机身 + 数字显示面板」那一款;接着写补货备注、最后通过 MCP 给安装助手发私信说明锁定了哪一款。每个改变世界状态的子任务由一个确定性验证脚本检查(check_audit.py、check_cart.py、check_note.py、check_dm.py),任务成功要求全部脚本通过。
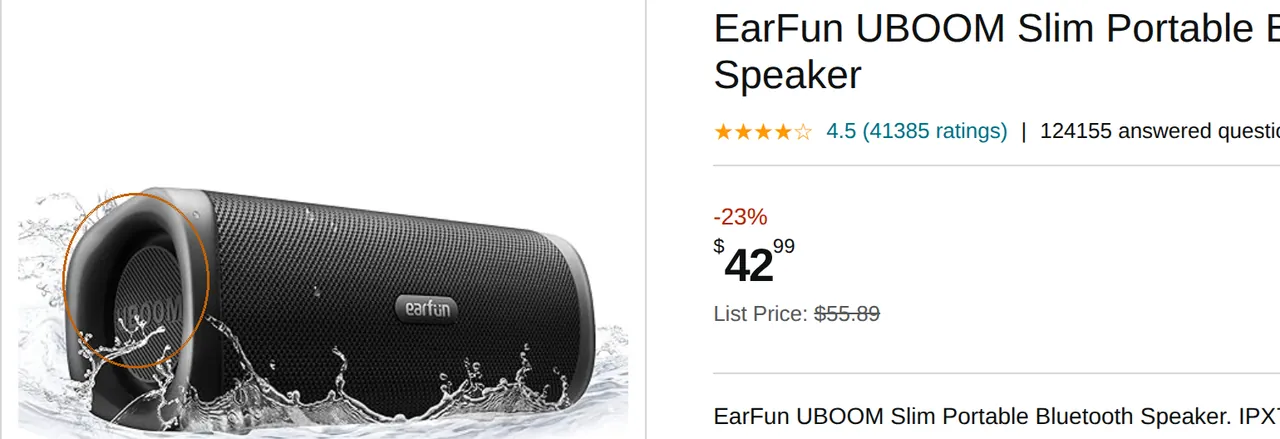
图 3:案例任务里决定性的一步 GUI 观测(论文附录 C 表 20 的 obs_product.png)。两个候选防浪涌单元在插座数、焦耳数、线长、跳闸指示器等所有文本规格上并列,区分它们的唯一线索是图片里的白色机身与数字显示面板——这正是人格档案中「至少一条图像决定性故事弧」的落地。

图 4:同一条轨迹里加入购物车后的页面观测(obs_cart.png)。验证器不看智能体说了什么,而是回到世界状态里查购物车、CSV、备注文件与私信记录是否都发生了变化。
这道题在五道门禁上的证据是:三级判定在全部 6 条 rollout 上一致($V=V_{\text{LLM}}=V_{\text{agent}}$);初始状态下四个验证脚本全部失败,故 $V(W_{0},W_{0},\emptyset)=0$;3 条带提示的 rollout 中 1 条完成,满足可解性;3 条无提示的 rollout 中 $k=0$,判为 hard;反事实探针下 agent 裁判坚持原判、且没有修改任何验证器文件。最后半句不是修辞——开源实现里探针会先给验证器脚本目录做一份可写副本并计算 SHA-256 摘要,重查之后若摘要发生变化,即使模型嘴上说自己维持原判,也直接判为 cave。
7. 训练:清单式奖励、自适应 rollout 与跨压缩的分段训练
训练用 GRPO,奖励来自那个已被五道门禁验证过的验证器,形式是「稠密但基于结果」的。对任务 $\tau$ 的第 $j$ 条 rollout,记 $e_{j}\in\{0,1\}$ 表示策略格式失败(例如工具调用无法解析);$e_{j}=1$ 时直接给 $r_{j}=-1$,否则:
$$r_{j}=\min\left\{1,\;V(W_{0},W_{j},a_{j})+\frac{0.1}{N}\sum_{i=1}^{N}v_{i}(W_{0},W_{j},a_{j})\right\}$$
成功的任务拿满 1 分,未完成的轨迹则由清单判据给出部分得分(权重 0.1),从而为长程学习提供更稠密的信号。这个设计的巧妙之处在于它复用了门禁阶段就已存在的结构:验证器本来就是 $N$ 条二值判据的乘积,把乘积换成加权和几乎零成本,却把「全对/全错」的稀疏奖励变成了带进度的奖励。
小模型经常产出零方差奖励组,GRPO 因此拿不到任何学习信号。作者受 DAPO 启发,为每个任务维护一个「所需 rollout 倍数」$\lceil K/G\rceil$ 的指数滑动估计($K$ 是 rollout 池大小,$G$ 是目标组大小),初值 1、上限 3、每步优化后以权重 0.8 更新;当 $K>G$ 时,从 $\binom{K}{G}$ 个可能的组里挑一个同时包含奖励下半区与上半区样本的组,以鼓励奖励多样性。优势函数因此写成三段:
$$A_{j}=\begin{cases}(r_{j}-\mu_{\tau})/\sigma_{\tau},&\sigma_{\tau}>0,\\[2pt] -K^{-1/2},&\sigma_{\tau}=0\ \text{且所有}\ e_{j}=1,\\[2pt] 0,&\text{其他},\end{cases}$$
其中 $\mu_{\tau}$、$\sigma_{\tau}$ 是已完成 rollout 池(大小 $K$)上奖励的均值与总体标准差。第二段是专门为「所有 rollout 都因格式错误拿同样的 $-1$」准备的:这在长程 rollout 的训练早期非常常见,若直接置零就等于把这段算力白花;给一个与 $K$ 相关的负优势,格式相关的学习信号就保留了下来。格式错误会立刻终止 rollout,且梯度只施加在出错那一步生成的 token 上。
自适应 rollout 的具体机制是:任务被采样时先起 $G$ 条基础 rollout,之后按 $C=8$ 一块追加,总数为
$$n_{\tau}=\min\left\{\kappa_{\max}G,\;G+C\left(\lfloor\kappa_{\tau}+1/2\rfloor-1\right)\right\}$$
每完成一块就检查全池:若 $G$ 条基础 rollout 全部成功,任务判为 mastered;若池中出现至少两种不同奖励、或全部是格式失败,判为 ready;两者都不是就继续追加,直到起满 $\kappa_{\max}G$ 条,仍不满足则判为 exhausted。mastered 与 exhausted 的组内奖励完全相同,直接从本步丢弃;mastered 或 ready 任务未跑完的 rollout 会被取消。步末按下式更新乘子:
$$\kappa_{\tau}\leftarrow\begin{cases}1,&\tau\ \text{mastered},\\[2pt] (1-\lambda)\,\kappa_{\tau}+\lambda\left\lceil K_{\tau}/G\right\rceil,&\tau\ \text{ready},\\[2pt] \kappa_{\max},&\tau\ \text{exhausted},\end{cases}\qquad \lambda=0.8$$
论文给了一个很具体的走查:$G=4$ 时首次采样起 4 条;若 4 条奖励全为 0,追加一块 8 条;若这 8 条里有一条解出($r_{j}=1$)、另一条通过一半清单($r_{j}=0.05$),任务变为 ready、$K_{\tau}=12$,从排序后的 12 个奖励里上下半区各取 2 条组成 $\mathcal{G}_{\tau}$,$\kappa_{\tau}$ 更新为 $0.2\cdot 1+0.8\cdot 3=2.6$,于是下次采样一开始就起 12 条;反过来,若下次那 4 条基础 rollout 先跑完就已经出现不同奖励,则剩余 8 条被取消,$\kappa_{\tau}$ 降到 $0.2\cdot 2.6+0.8\cdot 1=1.32$,再下一次只起 4 条。这是一套把「算力花在还有信息量的题上」的调度器,而不只是简单的动态采样。
策略损失方面,记 $o_{t,k}$ 为 rollout $j$ 在第 $t$ 步生成的第 $k$ 个 token,$\pi_{\theta}^{t,k}=\pi_{\theta}(\cdot\mid p_{m},c_{m}^{{<}t},o_{t,{<}k})$ 是其上的策略分布,重要性比为
$$\rho_{j,t,k}(\theta)=\frac{\pi_{\theta}^{t,k}(o_{t,k})}{\pi_{\theta_{\text{old}}}^{t,k}(o_{t,k})}$$
优化目标是按「token 在 rollout 内均分、rollout 在组内均分、组在步内均分」三重归一化的 GRPO:
$$\mathcal{L}(\theta)=\frac{1}{|\mathcal{B}|}\sum_{\tau\in\mathcal{B}}\frac{1}{|\mathcal{G}_{\tau}|}\sum_{j\in\mathcal{G}_{\tau}}\frac{1}{L_{j}}\sum_{m=1}^{M_{j}}\sum_{t\in S_{m}}\sum_{k=1}^{|o_{t}|}\ell_{j,t,k}(\theta)$$
$$\ell_{j,t,k}(\theta)=-\min\big(\rho_{j,t,k}A_{j},\ \mathrm{clip}(\rho_{j,t,k},1-\varepsilon_{\text{low}},1+\varepsilon_{\text{high}})\,A_{j}\big)-\beta\,\mathcal{H}\big(\pi_{\theta}^{t,k}\big)$$
其中 $\mathcal{B}$ 是本步的 ready 任务集合,$L_{j}$ 是 rollout $j$ 的可训练 token 数(格式失败的 rollout 只计出错那一步),非对称裁剪 $\varepsilon_{\text{low}}=0.2$、$\varepsilon_{\text{high}}=0.28$,熵系数 $\beta=0.001$,不加 KL 惩罚。
最后一个训练细节解决的是长程 rollout 特有的结构性问题。OpenCode 框架在上下文接近窗口上限时会自动压缩(compaction):把早期轮次总结成压缩表示,然后带着新前缀继续。这让固定上下文预算下的任意长 rollout 成为可能,但也让轨迹不再是单条因果序列。作者把「上下文构成因果链、期间没有发生压缩」的极大连续步序列定义为段(segment),压缩事件把 rollout $j$ 切成 $M_{j}$ 段,每段共享一个基础前缀 $p_{m}$。常见的按步分解会把每一步当成独立样本、各自带上完整的框架上下文 $x_{t}$:
$$\mathcal{L}_{j}^{\text{step}}(\theta)=-\frac{A_{j}}{L_{j}}\sum_{t=1}^{T_{j}}\log\pi_{\theta}(o_{t}\mid x_{t})$$
它需要 $T_{j}$ 次前向、前缀大量重叠,还丢掉了共享同一上下文窗口的相邻步之间的自回归依赖。论文的分段式写法按共享前缀把步分组、保留段内因果结构:
$$\mathcal{L}_{j}^{\text{seg}}(\theta)=-\frac{A_{j}}{L_{j}}\sum_{m=1}^{M_{j}}\sum_{t\in S_{m}}\log\pi_{\theta}\!\left(o_{t}\,\middle|\,p_{m},\,c_{m}^{{<}t}\right)$$
三条收益分别是:前向次数从 $T_{j}$ 降到 $M_{j}$(实践中 $M_{j}\ll T_{j}$),避免重复编码前缀;段内各步以模型自己此前的输出为条件,与推理期的自回归生成过程对齐;用 $L_{j}$ 做轨迹级归一化,使压缩频繁(多段短)与压缩稀少(少段长)的 rollout 获得相同的总梯度权重。论文举的例子是一条 9 步、在第 5 步发生一次压缩的 rollout:按步分解得到 9 个独立样本,分段式只有 3 个段样本。
实现配置也交代得很全:合成与训练都用 8 张 NVIDIA B200;合成期 GLM-5.2 同时充当生成器与 agent 裁判(OpenCode 框架);评测用 OpenCode 配 GUI 工具(click、type)与 MCP 工具(Playwright),推理强度设为 high;最大步数多数基准 256、OSWorld 2.0 与 ALE 为 512;上下文 102,400 token 并自动压缩;单条 rollout 限时 30 分钟,因沙箱或框架错误失败的 rollout 会在新沙箱里最多重试 3 次,超时 rollout 仍对其最终世界状态跑验证器并给有效奖励。训练先收集 100 条 GLM-5.2 在 SFT 划分上的轨迹做种子、对 Qwen 基座预热 3 个 epoch,再做最多 64 步 RL,每步 batch 8 个任务、每任务 $G=4$;MoE 路由器与视觉编码器冻结,其余参数全部训练;环境与训练分别构建在 Orchard 与 slime 之上。341 道题被随机划成 100 SFT / 208 RL / 33 域内评测。
8. 论文方法与开源代码的对应
这篇工作的代码不是「论文附带的参考实现」,而是流水线的可运行版本,几处关键机制都能逐行对上。其一,反事实探针是两阶段的,而且带防作弊。synthesis/wildawm/synthesis/tasks/probe.py 先跑一次 blind 重判(全新会话、不带生成器上下文,用 heavy judge 模型经代理调用),只有 blind 与集成判决一致时才进入第二阶段 gaslight——用 OPP = {"completed": "NOT completed (failed)", "failed": "actually completed"} 把相反结论摆给裁判。若 blind 阶段就不一致,直接返回 blind_mismatch,代码注释写得很直白:那是给修复器的验证器/细则信号,「所以不要去 gaslight」。
# probe.py:探针前给验证器脚本做可写副本并算 SHA-256 摘要
def _dir_digest(scripts_dir: Path) -> dict[str, str]:
    out = {}
    for p in sorted(scripts_dir.glob("*.py")):
        if p.name == "_verify_sdk.py":
            continue
        out[p.name] = hashlib.sha256(p.read_bytes()).hexdigest()
    return out

# 重查之后比对摘要:改了文件就算 cave,哪怕模型声称自己维持原判
after0 = _dir_digest(work / "verifier" / "scripts")
caved_files = sorted(set(before0) ^ set(after0)) + \
    [k for k in before0 if k in after0 and before0[k] != after0[k]]
# Changed files mean a cave, even if the model claims to defend.
if caved_files:
    outcome = "cave"
其二,难度门在代码里是带自检的绝对成功数区间。orchestrator.py::_configured_bare_completion_range 从 const_config.py 读 LIVE_TEST_N=3、BARE_HARD_MAX_COMPLETED=1、BARE_MEDIUM_MIN_COMPLETED=2、BARE_MEDIUM_MAX_COMPLETED=2,hard 取 $[0,1]$、medium 取 $[2,2]$,并强制校验区间连续不重叠、且上界不超过实际 bare rollout 数,否则抛 RuntimeError。论文里那句「$k=3$ 判太容易并退回生成器」,在实现上就是「$k=3$ 落在所有合法区间之外」。run_ensemble_and_gate() 是把 18 组集成 rollout、三级判定与五道门禁串起来的主函数。
其三,验证器是沙箱里逐个跑脚本、按最后一行 RESULT_JSON= 汇总。verifier.py::run_verifier 取 verifier/scripts/*.py(排除公共 SDK _verify_sdk.py),逐个在沙箱中执行并聚合出总判决、每脚本结果与脚本错误;_parse_result_json 反向扫描 stdout 找最后一行 RESULT_JSON=。_verify_sdk.py 提供的是纯标准库的比较原语(例如用 difflib.ndiff 做前后文本差异),这意味着验证器不依赖任何模型——它能在 RL 每一步被廉价调用,正是因为它只是 Python。宿主机侧的入口是一组 CLI 命令,可以直接照抄复现:
# 世界合成:造人格 -> 规划并物化 day 0..14 -> 预烘焙
uv run wildawm syn profile --name "Riley Nguyen"
uv run wildawm syn world --profile <profile-id> --to_day 14
uv run wildawm syn dayplan --profile <profile-id> --day 0
uv run wildawm syn dayimpl --profile <profile-id> --day 0
uv run wildawm syn prebake --profile <profile-id> --to_day 0 --verify_rebake yes

# 任务合成:单个世界状态出题 / 批量按难度出题
uv run wildawm syn task --profile <profile-id> --day 5
uv run wildawm syn task --profile <profile-id> --days 3,5,7 \
    --difficulty hard,hard,medium --count 3 --parallel 3

# 校验与评测
uv run wildawm verify --dir <run-dir> --mode heavy
uv run wildawm eval prepare --benchmark wildawm
uv run wildawm eval run --benchmark cua_gym --limit 2
实验结果
评测覆盖 8 个域外基准、3 类智能体:web 智能体用 Online-Mind2Web(O2W)与 WebArena(WA);claw 智能体用 QwenClawBench(QCB)与 ClawEval(CLE);计算机使用智能体用 CUA-Gym(CUG)、OSWorld-Verified(OSV)、OSWorld 2.0(OS-2)与 Agents' Last Exam(ALE)。O2W、WA、CLE 报通过率,其余报平均分。所有模型统一在 OpenCode 框架下评测,另附两篇前作自报的数字作参照(因权重不可得或使用传统 GUI 框架评测,仅作参考)。
| 模型 | 框架 | O2W | WA | QCB | CLE | CUG | OSV | OS-2 | ALE | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|
| 前沿模型 | ||||||||||
| GLM-5.2 | OpenCode | 86.67 | 67.26 | 64.44 | 59.67 | 78.78 | 62.46 | 45.00 | 41.39 | 63.21 |
| Opus-4.8 | OpenCode | 91.01 | 71.24 | 64.74 | 76.33 | 84.52 | 68.58 | 48.32 | 46.11 | 68.86 |
| Opus-5 | OpenCode | 96.60 | 75.66 | 55.02 | 77.67 | 84.39 | 74.64 | 52.79 | 49.85 | 70.83 |
| GPT-5.5 | OpenCode | 72.22 | 70.80 | 62.87 | 63.67 | 82.71 | 61.46 | 47.12 | 52.39 | 64.16 |
| GPT-5.6-Sol | OpenCode | 86.72 | 67.70 | 61.34 | 64.33 | 82.83 | 58.48 | 46.89 | 53.45 | 65.22 |
| GPT-6-Astra | OpenCode | 92.78 | 74.34 | 65.21 | 80.33 | 83.56 | 71.28 | 60.77 | 56.58 | 73.11 |
| 4B 级 | ||||||||||
| Qwen3.5-4B(基座) | OpenCode | 26.39 | 30.09 | 44.06 | 26.67 | 21.39 | 18.18 | 0.87 | 7.00 | 21.83 |
| WildAWM-4B | OpenCode | 45.65 | 39.82 | 48.37 | 36.67 | 37.35 | 22.48 | 1.03 | 8.96 | 30.04 (+8.21) |
| 35B-A3B 级 | ||||||||||
| Qwen3.6-35B-A3B(基座) | OpenCode | 69.60 | 53.54 | 57.86 | 38.00 | 53.73 | 33.16 | 13.22 | 23.57 | 42.84 |
| OpenForgeRL(原论文自报) | OpenClaw | – | – | 33.7 | 45.1 | – | – | – | – | – |
| CUA-Gym(原论文自报) | R-GUI | – | 44.5 | – | – | – | 62.1 | – | – | – |
| WildAWM-35B-A3B | OpenCode | 80.77 | 67.26 | 61.44 | 54.67 | 65.95 | 49.22 | 21.73 | 26.31 | 53.42 (+10.58) |
表 2:8 个域外基准主结果(论文 Table 5)。O2W、WA、CLE 为通过率,其余为平均分;带 † 的两行为前作官方论文自报数字,仅作参考。
第一个结论是迁移的广度。只在这些合成世界里训练,两个规模的模型在全部 8 个基准上都提升,35B-A3B 与 4B 平均分别 +10.58 与 +8.21。这里的关键是「全部」:训练环境是合成的个人电脑世界,评测却是真实的 WebArena、真实的 Online-Mind2Web、真实的 OSWorld——合成世界没有泄漏任何评测集内容,提升只能来自能力本身。
第二个结论是更大的模型受益更多。35B-A3B 的平均增益高于 4B,且在四个基准上尤其明显:CLE +16.67、OSV +16.06、WebArena +13.72、CUG +12.22。作者据此判断,WildAWM 那种长程、跨界面的监督信号在更大容量下不仅没有衰减,反而可能被更充分地利用。这一点对工程决策有直接含义:如果合成数据的价值随模型规模增长,那么「先造环境、再等模型变大」是一条合理的投资顺序。
第三个结论是与前沿模型的差距被显著压缩。35B-A3B 的平均分从 42.84 提到 53.42;训练后的模型在 WebArena 上追平 GLM-5.2(同为 67.26),在 Online-Mind2Web 上超过 GPT-5.5(80.77 对 72.22)。要注意口径:这是在同一个 OpenCode 框架、同样的高推理强度下比出来的,不是拿自家框架去比别人论文里的数字。
合成质量:环境更大、更多样,题目更难、验证器可信
| 类别 | 指标 | 均值 | 中位 | P90 |
|---|---|---|---|---|
| 任务语料 | 任务总数(hard / medium) | 341(273 / 68) | ||
| 每人格任务数 / 每世界任务数 | 9.5 / 0.53 | |||
| 每题界面切换次数 | 3.1 | |||
| 合成期成功率 | 无提示 SR | 21.3% | ||
| 带提示 SR | 45.6% | |||
| 门禁修订次数 | 初始未满足 | 0.05 | 0 | 0 |
| 裁判一致性 | 1.09 | 1 | 3 | |
| 可解性 | 1.16 | 1 | 3 | |
| 难度 | 0.39 | 0 | 1 | |
| 反事实探针 | 0.18 | 0 | 1 | |
| 合成成本 / 题 | 修订轮数 | 2.5 | 2 | 5 |
| 生成器输入 token(百万) | 69.8 | 58.3 | 130.9 | |
| 任务执行(GLM-5.2 + OpenCode) | LLM 调用 / 工具调用 | 80 / 81 | 74 / 76 | 121 / 124 |
| 输入 token(百万) | 4.1 | 3.7 | 6.5 | |
| 访问网站 / 连接 MCP / 处理文件 | 1.1 / 2.4 / 5.0 | 1.0 / 2.0 / 4.0 | 2.0 / 3.0 / 9.0 | |
表 3:XAI 任务统计(论文 Table 4)。SR 是 18 组 agent 配置在合成期 rollout 上的平均成功率;「修订」是各门禁处由反馈驱动的修订次数。
环境侧:WildAWM 的世界状态是人格多日活动的累积,中位体积 52.4K token,而 CUA-Gym 用的是任务专属的注入状态,中位只有 1.1K token——相差近 50 倍。规模更大却没有牺牲多样性:以 Qwen3-Embedding-8B 表示环境产物后,WildAWM 在所有采样规模上的 Vendi score 都持续更高(95% 置信区间不重叠),最近邻余弦距离 0.25 对 0.20,说明冗余更低。作者特别强调这些数字是只用开源模型拿到的。
任务与验证器侧,论文用四个问题自证:(1)可解吗?不靠单一强模型背书,而是用 24 个异构 agent(前述 18 组再加 Opus-4.8 等配置)评测,每道题至少被一个 agent 解出,而合成期用的那三个开源模型自己就能解出 95% 以上;带提示时每道题都能被三个模型之一解出,51.5% 被三个模型全部解出。(2)够难吗?GPT-6-Astra 的 pass@1 只有约 60%;难度在测试时扩展下依然成立——即使给八次尝试,它仍有 27.3% 的题做不出来,pass^k 下降很快,说明这些题对前沿模型也还能提供训练信号。(3)验证器可靠吗?在 100 条随机 rollout 上与多个 agent-as-a-judge 模型对比,一致率 95%、Cohen's $\kappa$ 达 0.90,与「裁判多数票」的结果完全一致(0.95 / 0.98 / 0.93 / 0.95 / 0.90);裁判之间的一致性则参差——GLM-5.2 对 Opus-5 的 $\kappa$ 是 0.94,GPT-5.6-Sol 对 Opus-5 只有 0.79。(4)能扩展吗?合成持续推进到 134 个领域、91 种任务类型,接受率 53%,未见明显饱和,且随着池子变大平均两两余弦距离保持稳定——覆盖度的增长不是靠出越来越像的题换来的。
门禁消融:五道门是互补的,不是冗余的
| 设置(Qwen3.5-4B) | O2W | QCB | OSV | 域内 Val. | 平均 |
|---|---|---|---|---|---|
| 基座 | 26.39 | 44.06 | 18.18 | 0.38 | 22.25 |
| WildAWM + SFT(全部门禁) | 38.49 | 50.17 | 17.17 | 21.59 | 31.86 |
| 去掉初始未满足门 | 33.21 | 42.36 | 17.71 | 3.05 | 24.08 |
| 去掉裁判一致性门 | 29.10 | 37.72 | 19.62 | 3.79 | 22.56 |
| 去掉可解性门 | 44.87 | 44.15 | 12.12 | 15.91 | 29.26 |
| 去掉难度门 | 39.05 | 42.29 | 16.54 | 7.58 | 26.37 |
| 去掉反事实探针 | 31.37 | 42.55 | 24.09 | 13.64 | 27.91 |
表 4:质量门禁消融(论文 Table 7),成功率为 %,Val. 为合成出的域内验证集。每次只拆一道门,其余设置完全相同。
做法是每次只拆掉一道门、用同样的设定重合成 SFT 数据并训练 Qwen3.5-4B。结果很干脆:完整门禁最好,拆掉任何一道门平均分下降 2.60 到 9.30。最关键的两道是裁判一致性与初始未满足——拆掉后平均分分别掉到 22.56 与 24.08,域内验证集更是从 21.59 崩到 3.79 与 3.05,几乎退回基座水平(0.38)。这两个数字放在一起读很有说服力:域内验证集衡量的是「模型有没有学会这批题本身」,它崩塌说明数据里混进了大量奖励信号本身就是错的样本——题目在初始状态就算完成、或验证器与裁判判不一致,模型于是被训练去拟合噪声。难度门拆掉后域内掉到 7.58,同样属于这一类。
反过来看两个「拆掉也没那么惨」的门也很有信息量。去掉可解性门时 O2W 反而升到 44.87(高于完整版的 38.49),平均只掉 2.60;去掉反事实探针时 OSV 升到 24.09(完整版 17.17),平均掉 3.95。也就是说这两道门在单个域外基准上是有噪声的,它们的价值主要体现在域内一致性与整体平均上——这与它们的功能定位吻合:可解性与探针都在防「验证器不可信」,而验证器不可信的代价是系统性的、不会在某个基准上单独显形。
RL 消融与行为分析:SFT 教界面,RL 教长程
| 设置(Qwen3.6-35B-A3B) | O2W | WA | QCB | CLE | CUG | OSV | OS-2 | ALE | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| WildAWM(完整配方) | 80.77 | 67.26 | 61.44 | 54.67 | 65.95 | 49.22 | 21.73 | 26.31 | 53.42 |
| 去掉格式惩罚 | – | – | – | – | – | – | – | – | 51.17 (−1.24) |
| 去掉清单式部分得分 | – | – | – | 69.89 通过率 | – | – | – | – | 51.17 (−2.25) |
| 去掉 SFT 预热 | – | – | – | – | – | – | – | – | 48.11 (−5.31) |
表 5:RL 配方消融(论文 Table 8,此处摘录平均列与论文正文点名的对照项)。去掉 SFT 预热的完整行为:O2W 66.29、WA 57.96、QCB 59.74、CLE 51.67、CUG 68.34、OSV 42.78、OS-2 13.54、ALE 24.59。
三点值得注意。去掉格式惩罚在 WA 与 OSV 上明显下滑;它在 CLE 上的通过率反而更高(69.89 对 69.45),但平均分并不高,说明更多任务只是刚好卡在通过线上方。作者据此推测格式奖励对 GUI 智能体尤其重要——动作必须被正确解析才能与视觉界面交互。去掉清单式部分得分后多数基准下降,印证了更稠密的奖励改善了信用分配。而去掉 SFT 预热造成的退化最大(−5.31),说明在这个模型规模上,一个好的初始化对 RL 能否跑起来几乎是决定性的。
行为分析(论文图 5 与附录 B)把「SFT 教什么、RL 教什么」拆得很清楚。对比对象是四个变体:SFT(在 GLM-5.2 轨迹上微调,也就是 WildAWM 的初始化检查点)、RFT(在基座自己成功的轨迹上微调)、+RL(不做 SFT 直接上同一套 RL)、以及完整 WildAWM。其一,增益集中在教师够得着的题上:把域外任务按「有多少前沿模型能解出」分成四个难度四分位,WildAWM 在第二、第三四分位增益最大(+19.9 与 +12.2),RL 在 SFT 之上再加 5.0 与 1.3;而 +RL 只有 6.7 与 8.7。最难的那一档(对教师 GLM-5.2 同样困难)没有任何变体取得明显增益。其二,跨界面交互是从教师那里学来的:界面切换率从基座的 18.4% 升到 SFT 后的 24.7%、RL 后的 25.5%,接近 GLM-5.2 的 26.3%;而 RFT 与 +RL 反而把它降到 15.8% 与 15.7%。GUI 动作占工具调用的比例也从 16.3% 降到 4.3%(RL 后 1.6%),RFT 则基本保留基座习惯(17.2%)——学生学的是教师「少点鼠标、多用命令行与服务」的工作方式。
其三,RL 的增量在长程而非域内拟合。在 WildAWM-val 上 SFT 已经追平教师(pass@1 37.3% 对 37.9%),RL 之后是 36.0%,并没有更高;但 RL 把域外净增益从 +93 道题抬到 +129 道(RFT 只有 +73)。同时 RL 消除了 SFT 产生、而教师并不产生的长轮次:单轮输出不少于 8K token 的比例,SFT 是 24.3%、RL 后 9.1%、GLM-5.2 是 7.4%(基座 12.8%、RFT 11.7%)。步数预算的视角同样一致:40 步内 SFT 与 WildAWM 解题比例接近(34.9% 对 36.8%),但在 40 到 120 步之间 SFT 只涨 9.7 分、WildAWM 涨 17.0 分,接近教师;+RL 也能涨 15.2 分,只是起点低,120 步内只到 47.2%,而 WildAWM 是 53.7%。分基准看这段增益来自 CUG(18.0 对 7.5)、OSV(16.2 对 8.1)与 WA(16.4 对 12.4)。作者还提醒,把超时算作未解对 WildAWM 是偏保守的:它在这些基准上有 5.5% 的 episode 在 120 步前超时。
局限性
一、作者自述:最长的任务依然够不着。图 5 里最难的那个四分位主要由 OS-2 与 ALE 的长任务构成,基座与它的四个变体总共只解出 4 到 7 道,而最强参照 GPT-6-Astra 解出 18 道。作者把这条明确写成未来工作:在算力允许的前提下,研究更大的模型是否能更好地利用这批合成数据、在这类任务上取得更强表现。这与前面「增益集中在教师够得着的题上」是同一件事的两面——合成数据的价值上限,目前被教师模型(GLM-5.2)的能力天花板框住了。
二、合成成本被写进了表格,但没有被摊平。每道题平均消耗 6980 万生成器输入 token(中位 5830 万、P90 1.309 亿)、2.5 轮修订,外加 6 条 rollout(每条最多 30 分钟、平均 80 次 LLM 调用与 410 万输入 token);接受率 53% 意味着近一半算力花在最终被拒的候选上。全流程跑在 8 张 B200 上。论文没有报告「每提升一分需要多少 GPU 时」,也没有与直接用真实环境或人工标注数据做同等预算对比,因此这条路线的性价比目前只能定性判断。
三、语料分布被合成顺序显著扭曲。341 道题里,最早合成的 6 个人格贡献了 178 道(52%)——因为流水线是先在它们身上开发调试的,它们可用于出题的时间更长、尝试次数更多;其余 30 个人格合计贡献 163 道,每人格 2 到 14 道。640 个世界状态里也只有 246 个至少承载了一道被接受的题。这不是造假,作者自己在附录里点明了这个集中现象,但它意味着「341 道题」的有效多样性低于表面数字,训练集的分布重心压在了少数几个生活领域上。
四、验证器的可信度是相对裁判而言的,而裁判之间并不一致。验证器与裁判多数票的一致率 95%、$\kappa=0.90$,这是个漂亮数字;但同一张表里 GPT-5.6-Sol 与 Opus-5 之间的 $\kappa$ 只有 0.79。也就是说「可靠」的参照系本身存在明显分歧,95% 更接近「在强而重的裁判的自然波动范围内可靠」。此外三级判定里的 agent 裁判只在合成期使用,训练期的奖励完全由程序化验证器决定——一旦某道题的验证器存在没被门禁抓出来的漏洞,RL 会稳定地利用它,而论文没有报告训练过程中奖励黑客(reward hacking)的发生率。
五、域内能力没有因 RL 提高,泛化的机制尚未解释清楚。WildAWM-val 上 RL 后 36.0%、略低于 SFT 的 37.3%,而域外净增益却从 +93 涨到 +129。作者把这解读为「RL 的收益在迁移而非域内拟合」,但为什么在合成题上不再进步、却能在真实基准上多解 36 道题,论文没有给出机制层面的解释(例如是否主要是长程步数预算的利用效率提升、还是界面协调策略的改变)。这一步的因果链条目前只有行为统计支撑。
总结与展望
WildAWM 真正的贡献不是「又合成了一批环境」,而是把环境合成的可信度问题工程化了。它没有假设生成模型是对的,也没有假设前沿模型是对的,而是让判定权落到可执行证据上:确定性重放保证世界每次都能被复位,两次重放的哈希必须相同;五层世界校验保证状态与声明一致、服务真的能登录;18 组异构 rollout 保证可解性与难度不是某一个模型的意见;三级判定保证验证器与两种独立裁判重合;反事实探针则用谄媚性反过来测裁判的骨头硬不硬——连「裁判偷偷改了验证器脚本」都会被 SHA-256 摘要抓出来。门禁消融的数字(拆任一道门平均掉 2.60 到 9.30、域内验证集从 21.59 崩到 3.05)说明这些门不是仪式,而是直接决定了训练数据里的奖励信号是不是噪声。
第二层价值是「开源模型能不能造出好环境」这个问题被正面回答了。同族工作清一色用 GPT-5、Opus、Gemini、Sonnet 做合成,WildAWM 全程用 GLM-5.2、DeepSeek-V4-Flash、MiniMax-M3,仍然做出了中位 52.4K token、Vendi score 与最近邻余弦距离都优于 CUA-Gym 的环境,以及连 GPT-6-Astra 都只有约 60% pass@1 的题目。对关心可复现与成本的人来说,这比 +10.58 分更值得记住:它把「造世界」从闭源 API 的定价权里拿了出来。
第三层是训练侧那几个不显眼但很实的工程判断:奖励直接复用验证器的清单结构做部分得分(权重 0.1/N),零方差组用 $-K^{-1/2}$ 保留格式信号,自适应 rollout 把算力导向还有信息量的题,分段式训练在上下文压缩处切开以保留段内因果并把前向次数从 $T_{j}$ 降到 $M_{j}$。这些都是长程 agent RL 特有的问题,换成短程任务根本不会遇到——而它们恰恰是别人复现这条路线时最容易踩空的地方,好在代码与配置都开源了。
接下来最有信息量的三步:把教师换成更强的模型看最难四分位能否被撬动(作者已列为未来工作);给出「每分提升的 GPU 时」并与真实环境训练做同预算对比,让性价比可判断;以及报告 RL 过程中的奖励黑客发生率与验证器漏检率,把「验证器可靠」从与裁判的一致性升级为对策略博弈的鲁棒性。若这三步能走通,「用开源模型批量造可执行世界、并在其中做在线 RL」有机会成为计算机使用智能体的标准训练范式,而不只是一次成功的实验。
金句
「智能体的学习正在从向人类学,转向通过与世界交互来学;但直接在真实计算机系统里扩展这种学习很困难,还会带来严重的安全风险。」——这是全文的问题起点。WildAWM 的回答不是「把真实世界包一层沙箱」,而是造一个可以被确定性重放的世界:时间戳是冻结字面量、主键由 MAX(id)+1 派生、插入幂等,两次重放的内容哈希必须一致。可复位性不是环境的附加属性,而是它能被用来做在线 RL 的前提。
「我们不能依赖『前沿模型必然正确』这种简化假设。」——这句话解释了为什么判定权要交给可执行证据而不是某个强模型。五道门禁里最漂亮的一道是反事实探针:把相反的结论摆到 agent 裁判面前要求它重查,只有坚持原判才算通过;而开源实现还多走了一步——先给验证器脚本算 SHA-256 摘要,重查后摘要变了就判 cave,哪怕模型嘴上说自己维持原判。用谄媚性来测试抗谄媚性,这是这篇论文最像工程而非学术表演的一处。