PAPER DEEP DIVE
RSI-Anything:用世界模型驱动递归自我改进
RSI-Anything 把世界模型接进递归自我改进的闭环:预测决定哪些候选动作值得花掉稀缺的外部反馈,反馈再回头驱动策略学习或工作流改写,并在可靠性检查判定预测器已经漂移时触发有条件的世界模型自适应,最后由组件门与配对门决定哪一版策略-模型对被保留下来指导下一轮。底座是 JEPA-Anything 的正交预测分解。固定 coder 时,200 道 CodeContests 的隐藏测试通过率从静态验证器的 26.3% 升到固定世界模型的 29.2%、自适应后的 31.2%,在线测试用量几乎不变;GUI 评测里平均动作数降 39.4%;实验室规划的五个连续策略版本把 LabHorizon F200 从 21.80% 抬到 46.01%;同样的 40 次实验预算下,Suzuki 流动筛选的最佳观测产率 96.15%,贝叶斯优化 82.16%。
论文:RSI-Anything: Unlocking Recursive Self-Improvement with World Models(arXiv:2610.13912,arxiv.org/abs/2610.13912,v1 于 2026-10-09 提交,主分类 cs.CL)
作者:Taoyong Cui、Pinxian Zeng、Wanghan Xu、Hao Xiao、Shuhan Xue、Qiang Gao、Wanli Ouyang、Pheng Ann Heng、Zhenfei Yin、Yingcheng Wu、Ling Yang(PhAI Labs、香港中文大学、澳门大学、上海交通大学、复旦大学、牛津大学、斯坦福大学、北京大学;Pheng Ann Heng、Zhenfei Yin、Yingcheng Wu、Ling Yang 为通讯作者)
代码状态:已开源。Gen-Verse/RSI-Anything(Apache-2.0,298 stars,最近推送 2026-10-12,707 个文件),模型与数据资源在 Hugging Face Gen-Verse/RSI-Anything。其中代码修复与 GUI 两条链路是能用 rsi run --config configs/code_repair/default.json 这类命令跑完的完整 workflow;实验室规划与反应优化只放了推理侧适配器与已封存的评测记录;免疫科学目前只有说明文档。下文的「方法↔源码」对照基于该仓库 main 分支实读。
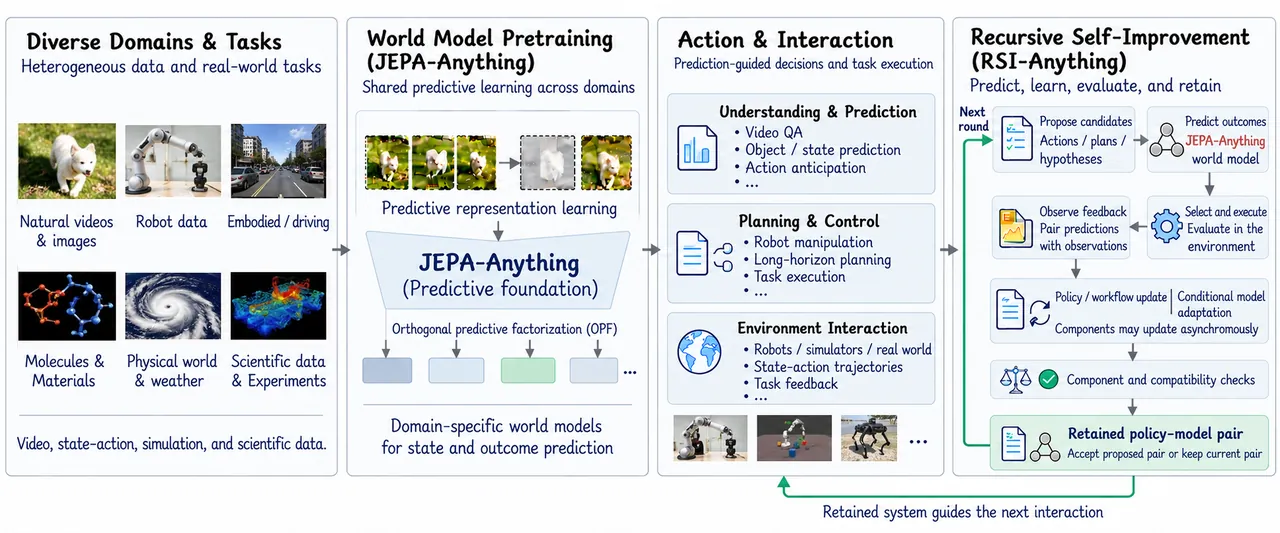
图 1:RSI-Anything 总览(论文图 1)。底座是 JEPA-Anything 的跨域预测能力,世界模型的预测被用来支撑理解、规划与动作选择;交互反馈驱动策略或工作流更新,并有条件地触发世界模型自适应;组件检查与兼容性检查决定哪一对策略-模型被保留,去指导下一轮交互与学习,递归闭环由此合上。
一句话总结
RSI-Anything 把世界模型放进递归自我改进的闭环里当调度器:预测先给每个候选动作打分,决定谁值得花掉一次昂贵的外部反馈;反馈回来兵分两路,一路改策略(或改智能体工作流),一路在可靠性检查判定预测器已经跟不上的时候改预测器;最后由组件门与配对门决定这一版「策略-模型」对要不要被保留。被保留的那一对决定下一轮的候选池与经验分布,递归因此才成立。固定 coder 的代码修复把隐藏测试通过率从静态验证器的 26.3% 推到自适应世界模型的 31.2%,实验室规划的五个连续策略版本把 LabHorizon F200 从 21.80% 抬到 46.01%。
研究背景与动机
递归自我改进(RSI)说的是把交互经验变成系统「行动能力」与「学习能力」的持久提升。论文把这件事拆成两个时间尺度:任务之内,反馈用来修正当前解或引导下一步动作,验证器、Reflexion 这类工作属于此;跨轮次,自训练与偏好优化把经验沉淀成持久的策略或流程更新。作者强调,「递归」这个词的分量落在第二个尺度上——更新必须被保留下来,并且真的改变后续的交互与学习。于是全文要回答的问题被写得很直白:一轮的经验,如何提升系统在下一轮里行动和学习的能力。
第一个障碍是反馈的价格。要从外部反馈里学到东西,就得先执行或评估候选,才能看到后果;在交互预算受限时,这直接压缩了探索空间。代码修复里每次执行是一轮沙箱测试,化学反应里每次评估是一次真实的实验台操作,免疫科学里是一次湿实验。世界模型的价值正在这里:它预测候选动作对后续状态或结果的影响,使「先想后做」成为可能,从而把稀缺的外部反馈优先花在最有信息量或最有收益的候选上。作者因此把世界模型定位成「有限外部反馈下改进的预测基础」。
底座来自同组的前作 JEPA-Anything。它在联合嵌入预测架构(JEPA)的路线上——从观测上下文预测目标表示,而不是重建每个像素——加了一层正交预测分解(OPF):把潜在目标拆成互补因子,为每个因子学专用预测器,再把各因子的输出重新组合成完整的潜在状态。这套设计让它能在异质领域(图像、控制、分子动力学等)共用同一个建模骨架。但作者自己点明了前作的边界:预测本身不构成递归改进。预测出来的结果必须去引导交互,外部反馈必须产出能跨轮存活的更新,这两步都不在 JEPA-Anything 的职责里。
把这两步接上,就撞上论文称之为「耦合更新」的难题,这也是全文最有价值的一段问题陈述。策略一更新,候选动作的分布和经验的分布就变了,而世界模型是在旧分布上被评估、被训练的,它的预测可靠性因此可能失效;反过来,世界模型一更新,候选排序、想象轨迹、以及喂给策略改进的学习信号全都变了。结论是:单独把任何一个部件改好,都不保证两者装配起来更好。所以可靠的 RSI 需要三件事——判断何时该更新哪一个部件、在策略变化的条件下评估预测可靠性、以及保证被保留下来的「策略-模型」对确实改善了后续的交互与学习。
RSI-Anything 的回答是把「保留」提升为一等公民。它允许策略与世界模型异步演化:组件级检查各自评判单个更新,兼容性检查评判装配后的那一对;只有过了这两道门,新版本才进入下一轮。三条贡献由此展开:其一,把预测世界模型接进 RSI,并把持久改进的形式化层次从「一个策略」抬到「策略-世界模型系统」,让「演化策略下的预测可靠性」成为设计要求而非事后检查;其二,给出一套更新与保留机制,把预测引导的选择、反馈驱动的改进、有条件的模型自适应、以及组件与配对接受串成一条协议;其三,跨域实证——代码修复、GUI、实验室规划、反应优化,外加一个免疫科学的端到端应用。
预备知识:一次递归运行里什么在变、什么不许变
论文先给每个领域 $d$ 定义一个八元组任务规格:
$$\mathcal{T}_{d}=\left(\mathcal{X}_{d},\ \mathcal{S}_{d},\ \mathcal{A}_{d},\ \mathcal{W}_{d},\ \mathcal{V}_{d},\ \mathcal{M}_{d},\ \mathcal{C}_{d},\ \mathcal{B}_{d}\right). \tag{1}$$
$\mathcal{X}_{d}$ 是观测与上下文,$\mathcal{S}_{d}$ 是任务状态,$\mathcal{A}_{d}$ 是可用动作或干预,$\mathcal{W}_{d}$ 是世界模型适配器,$\mathcal{V}_{d}$ 是负责候选有效性与预测效用的验证器,剩下三项分别是评测指标、运行与安全约束、以及计算/仿真/外部交互的预算。适配器 $\mathcal{W}_{d}$ 的角色值得单说:它把一次外部反馈与当初存下的那条预测、产生它的动作与上下文、以及证据来源绑在一起,这条绑定关系是后面所有可靠性判断的前提。
论文用了两个独立的时间轴:$t$ 是任务内部的动作步,$k$ 是「更新与接受」周期。第 $k$ 周期里被接受的系统是 $(\theta_{k},\phi_{d,k})$,其中 $\theta_{k}$ 是策略配置——它可以是可训练参数,也可以是一份持久的智能体工作流;$\phi_{d,k}$ 是当前的预测器。一个周期可以聚合多个动作步、多条轨迹甚至多个任务的反馈,它在更新决策与接受检查做完之后结束,即使两个部件都保持原版本也算走完一个周期。所以 $k$ 数的是更新周期数,不是成功修订数——这个区分在读后面「五个连续策略版本」时很重要。
Table 1 把一次运行里的对象分成四类,并给出各自的变化规则。这张表看着像形式化铺垫,其实是这篇论文用来防止「把记忆变长说成自我改进」的闸门:只有 $\theta$ 或 $\phi_{d}$ 的被接受变更才算系统修订,单纯把反馈历史加长不算。
| 对象 | 变化规则 | 携带到下一轮的东西 |
|---|---|---|
| 任务与评测规格 | 整轮运行固定 | 任务目标与定义、接口、评测准则、约束、预算上限、接受与停止规则 |
| 任务状态与经验 | 动作与观测改写状态,并把「预测-观测」记录追加进历史 | 后续动作看到的当前状态;用于选择与学习的累积记录 |
| 策略配置 $\theta$ | 反馈驱动的策略学习或工作流改写提出候选版本,组件门与配对门决定接受 | 被接受的策略配置,否则沿用当前版本 |
| 世界模型 $\phi_{d}$ | 预测不可靠 + 数据充分 + 预算足够才触发一次自适应尝试,同样过两道门 | 被接受的预测器,否则沿用当前版本 |
表 1:一次递归运行中的固定项、更新规则与被保留状态(论文表 1)。运行内预算只减不增,任务状态、候选池、反馈记录与已接受的组件版本可以演化。
预测底座:编码、预测、读出
JEPA-Anything 提供「上下文-目标」的预测设计,OPF 负责组织潜在目标;它的学习目标把因子预测与正交性、表示正则化揉在一起。RSI-Anything 继承这个建模底座,但后续的自适应阶段会另外声明自己的目标函数与可训练参数子集。第 $k$ 周期的编码与动作条件潜在预测写作
$$z_{t}=E_{\phi_{d,k}}\left(s_{t},c_{d}\right), \tag{2}$$
$$\widehat{z}_{t+1}=F_{\phi_{d,k}}\left(z_{t},a_{t},c_{d}\right), \tag{3}$$
其中 $s_{t}$ 是任务状态,$a_{t}$ 是候选动作,$c_{d}$ 是领域上下文。当 OPF 被实例化时,$F$ 代表的就是「因子预测 + 因子合成」两步。读出 $R$ 把预测出的潜在目标 $\widehat{z}_{t+1}$ 变成可用于选择与反馈比对的结果预测,论文特意说明这些符号指的是功能角色,动作编码由适配器决定,可以并进预测器输入,也可以并进上下文:
$$\widehat{o}_{t+1}=R_{\phi_{d,k}}\left(\widehat{z}_{t+1},c_{d}\right)\quad\text{(点读出)}, \tag{4}$$
$$p_{\phi_{d,k}}\left(o_{t+1}\mid s_{t},a_{t},c_{d}\right)=R_{\phi_{d,k}}\left(\widehat{z}_{t+1},c_{d}\right)\quad\text{(概率读出)}. \tag{5}$$
点读出配结果误差来评估,概率读出还可以用分布敏感的分数或校准指标。任何用于选择或训练准入的不确定性估计器都要单独声明——这句限定在后面「可靠性」一节会再次出现,是这篇论文一以贯之的写法:凡是能影响决策的量,都必须有名字、有出处。
单步选择只需要结果读出;多步规划还额外需要一个能推进规划状态的适配器。当这个转移接口存在时,目标 $g$ 下、视野 $H$ 的 rollout 是
$$p_{\theta_{k},\phi_{d,k}}\left(\widehat{\tau}\mid s_{0},g,c_{d}\right)=\prod_{t=0}^{H-1}\pi_{\theta_{k}}\left(a_{t}\mid s_{t},g\right)\,p_{\phi_{d,k}}\left(s_{t+1},o_{t+1}\mid s_{t},a_{t},c_{d}\right). \tag{6}$$
论文对这条公式加了一句容易被略过但很关键的限定:被推进出来的 $s_{t+1}$ 在外部校验之前一直只是「预测出来的规划状态」。联合转移读出只有做 rollout 的应用才需要,代码修复这类单步选择不需要它。
方法详解
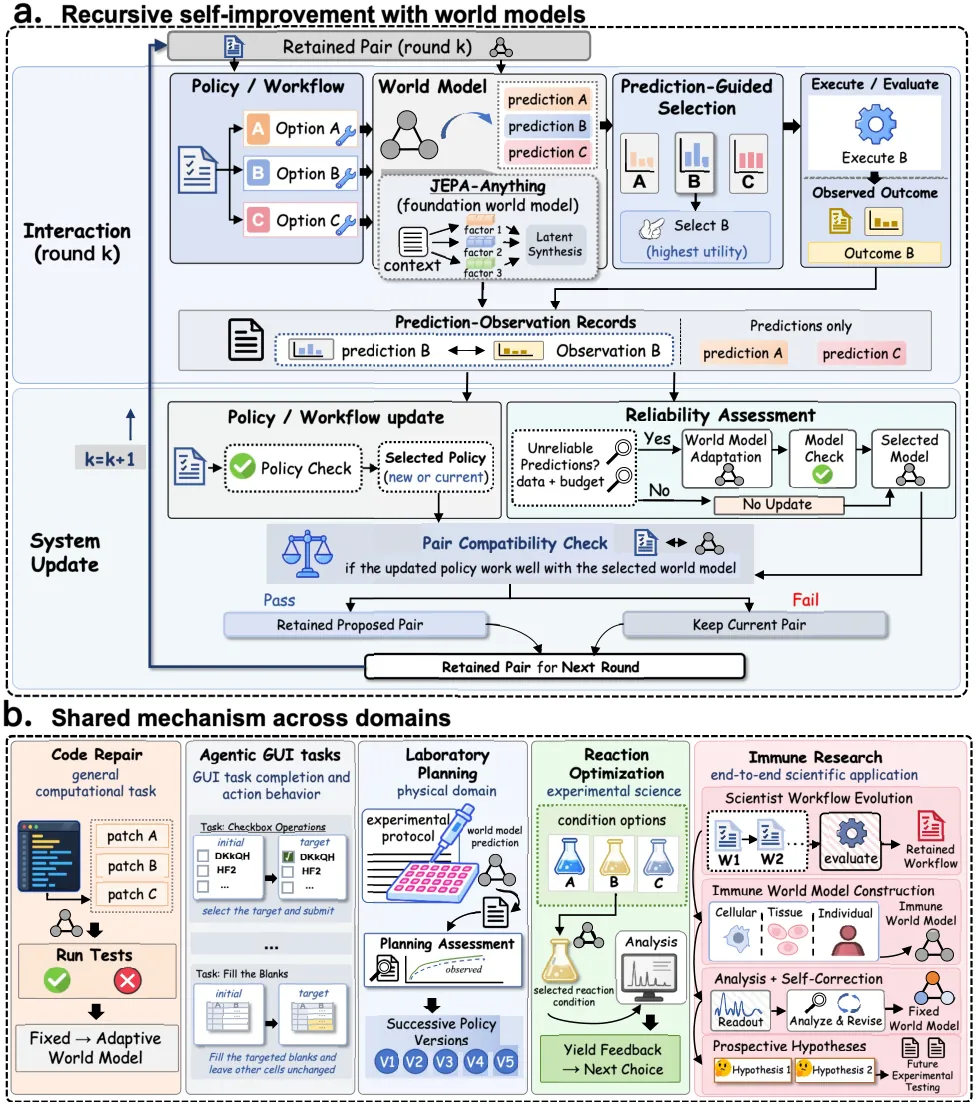
图 2:框架全景(论文图 2)。a,在 JEPA-Anything 之上,世界模型的预测引导候选选择,只有真正被执行的那个候选 B 才会产出一对「预测-观测」反馈;反馈支撑策略或工作流修订与可靠性评估,世界模型的自适应取决于预测可靠性、可用数据与预算;组件检查与兼容性检查决定被保留的策略-模型对,它塑造下一轮的候选与学习经验。b,同一套机制在代码修复、GUI 交互、实验室规划与反应优化上分别实例化,免疫科学则把保留的工作流与预测器串成端到端应用。
第一步到第三步:提议、预测、按效用选择
在状态 $s_{t}$ 与目标 $g$ 下,当前策略提议候选集 $\mathcal{K}_{t}=\operatorname{Propose}_{\theta_{k}}\left(s_{t},g\right)$。每个候选拿到一个结果预测,或在支持时拿到一段有界 rollout $\widehat{\tau}$。验证器随后记录有效性 $v_{\tau}$、效用分量 $\mathbf{r}_{\tau}$、证据出处,以及可得的模型或验证器不确定性。这里有一个分工:有效性与运行约束决定「哪些候选允许被执行」,选择规则决定「哪些可行候选真的去拿反馈」。基于效用的排序打分是
$$R_{d}\left(\widehat{\tau}\right)=\sum_{j}w_{d,j}\,r_{\tau,j}-\Delta_{d}\left(\widehat{\tau}\right), \tag{7}$$
其中启用不确定性惩罚时 $\Delta_{d}\left(\widehat{\tau}\right)=\lambda_{d}\,U\left(\mathbf{u}_{\tau}\right)$,否则 $\Delta_{d}\left(\widehat{\tau}\right)=0$。无效候选在排序之前就被剔除。领域配置负责给出效用权重、实际采用的排序或采集规则、批大小与估计的反馈成本;选择返回一个可行候选或一批候选,其评估成本必须塞得进剩余的反馈预算。在代码修复里,这条规则的实例形态是:把预测出的执行类别概率聚合起来,对提议的四个修订排序,然后只执行其中一个。
论文还留了一条岔路:如果显式启用信息获取型的采集规则,系统会反过来优先评估不确定的候选。作者要求它的定义与使用情况与效用排序分开报告——这两者的优化目标不同,混在一起报会让「预测有用」这个结论失去可解释性。拿到反馈之后,观测结果与当初用于选择该候选的那条预测分开存储。
证据分级与想象数据的准入
RSI-Anything 把证据分成四级:确定性规则检查(E0)、学习到的模型预测与 rollout(E1)、专用仿真器或更高保真的计算(E2)、外部测量或实验(E3)。预测字段与观测字段各自保留出处;证据类别记录的是来源与预期保真度,而「够不够格进训练」由另一套准入判据决定。对使用想象轨迹做学习的应用,准入与「外部评估选择」分开治理:
$$e_{\tau}=\mathbf{1}\left\{v_{\tau}=1\right\}\ \mathbf{1}\left\{R_{d}\left(\widehat{\tau}\right)\geq r_{d}^{\min}\right\}\ C_{d}^{U}\left(\widehat{\tau}\right)\ \mathbf{1}\left\{\ell_{\tau}\in\mathcal{E}_{d}^{\mathrm{train}}\right\},$$
$$\mathcal{D}_{\mathrm{sim},k}=\operatorname{Curate}\left\{\widehat{\tau}:e_{\tau}=1\right\}. \tag{8}$$
$\ell_{\tau}$ 记录支撑这次训练准入的证据。不确定性检查 $C_{d}^{U}$ 在启用时检验 $U\left(\mathbf{u}_{\tau}\right)\leq u_{d}^{\max}$,未启用时恒返回 1;允许的证据来源与阈值按应用声明。若关闭想象学习,$\mathcal{D}_{\mathrm{sim},k}$ 为空。作者特别补了一句:这个训练过滤器不阻止系统去外部评估一个不确定的候选。换句话说,「不敢拿去训练」和「不敢拿去实验」是两件事,前者保守、后者恰恰可能值得花钱。
第四步到第五步:反馈驱动的两条改进路
外部反馈把「预测-观测」对追加进历史 $\mathcal{H}_{k}$,每条都绑定产生它的系统版本。被选去改进策略的记录构成 $\mathcal{D}_{\mathrm{policy},k}$,被选去做预测器自适应的记录构成 $\mathcal{D}_{\mathrm{adapt},k}$;两个集合服务不同目标,不必包含相同的记录。策略改进改变候选如何被生成或选择,预测器自适应改变候选的后果如何被预报。
反馈要先转换成与「更新对象」匹配的信号:示范式学习把选中的动作或轨迹当目标,偏好学习用评估结果比较候选优劣,工作流搜索用评估反馈给持久的智能体工作流配置排序。每个应用按自己的策略表示选路。合格的历史想象轨迹在该路线启用时可以补充策略数据。设 $u_{k}^{\pi}$ 表示在声明的调度或反馈触发点上、带着所需学习证据与足够预算的一次策略更新尝试,固定策略的设置就是 $u_{k}^{\pi}=0$:
$$\theta^{\prime}_{k+1}=\begin{cases}\operatorname{Update}\left(\theta_{k},\mathcal{D}_{\mathrm{policy},k},\mathcal{D}_{\mathrm{sim},k}\right),&u_{k}^{\pi}=1,\\ \theta_{k},&u_{k}^{\pi}=0.\end{cases} \tag{9}$$
实例化的路线要说清三件事:反馈如何构造训练目标或工作流分数、哪些参数或配置字段允许改变、什么时候尝试更新。代码修复的主实验刻意把 $u_{k}^{\pi}$ 钉死为 0(coder 固定),这样观察到的增益只能来自选择与预测器;实验室规划则反过来,只跟随策略版本序列。
有条件的世界模型自适应:可靠性必须可归因到当前版本
自适应用观测到的目标去改善对应的预测。这里有个常被忽略的约束:结果标签可以监督结果读出,但潜在预测目标需要一个「领域目标编码器能表示」的观测;一个标量结果只能提供结果目标,而不是完整观测到的目标状态,尽管它的损失可以回传更新上游可训练参数。自适应声明要写清可用的目标、它的预测损失、以及可训练参数子集,这些选择可以与初始建模阶段不同。
可靠性协议要求预测必须可归因到当前模型版本:对纳入评估的每条历史观测,要么使用由该版本生成并存下的预测,要么把当前模型重新作用在记录的输入上得到一条新预测。早期版本的预测仍可用于分析过去的决策,但不能直接混进当前的误差估计。设 $\mathcal{K}_{k}$ 为第 $k$ 周期考虑的候选范围,$B_{\mathrm{update},k}$ 为剩余预算,$\widehat{c}_{\mathrm{adapt},k}$ 为同单位下的估计成本,则评估与触发器是
$$\rho_{k}^{W}=\operatorname{Reliability}\left(W_{\phi_{d,k}};\mathcal{H}_{k},\mathcal{K}_{k}\right)\in\left\{\mathrm{reliable},\ \mathrm{unreliable},\ \mathrm{insufficient}\right\}, \tag{10}$$
$$u_{k}^{W}=\mathbf{1}\left\{\rho_{k}^{W}=\mathrm{unreliable}\right\}\ \mathbf{1}\left\{\mathcal{D}_{\mathrm{adapt},k}\ \mathrm{is\ sufficient}\right\}\ \mathbf{1}\left\{B_{\mathrm{update},k}\geq\widehat{c}_{\mathrm{adapt},k}\right\}, \tag{11}$$
$$\phi^{\prime}_{d,k+1}=\begin{cases}\operatorname{Adapt}\left(\phi_{d,k},\mathcal{D}_{\mathrm{adapt},k}\right),&u_{k}^{W}=1,\\ \phi_{d,k},&u_{k}^{W}=0.\end{cases} \tag{12}$$
三态设计里最关键的是 insufficient:因为反馈只来自被选中的候选,任何结论都只在观测到的、被覆盖的候选范围内成立,所以覆盖不足必须判为「证据不足」,而不是「看起来可靠」,并且不触发自适应。这条规则把选择偏差写进了协议本身。触发器还要求数据充分与预算足够同时成立,被关掉的路径恒有 $u_{k}^{W}=0$。预算声明要指明被约束的资源,并把自适应、历史重评与接受检查都算进去;策略与模型共用预算时,每次尝试用的是前序分配之后的余额。外部反馈的用量与更新/评估的计算量分开报告。
第六步:递归保留,以及为什么还需要一道配对门
保留协议拿提议的部件、以及它们装配出来的那一对,与当前版本在预先声明的接受准则下比较。组件检查管两件事:策略的任务效用与约束,或预测器在相关目标上的质量。配对检查管的是两者之间的依赖——一个策略可能生成出「本来更好的预测器」在其上并不可靠的候选,而一个预测器会改变哪些候选被选中。所以配对接受关心的是装配后系统的决策行为,以及预测器在「被选中策略所提议的候选」上的适配度,超出任一部件的孤立质量。形式上,先定义两个组件决策,注意比较基线是当前版本,被明确写进了参数表:
$$G_{k}^{\pi}=Q_{\pi}\left(\theta^{\prime}_{k+1};\ \theta_{k},\ \mathcal{D}^{\pi}_{\mathrm{gate},k}\right), \tag{13}$$
$$G_{k}^{W}=Q_{W}\left(\phi^{\prime}_{d,k+1};\ \phi_{d,k},\ \mathcal{D}^{W}_{\mathrm{gate},k}\right), \tag{14}$$
每个检查只在满足其声明准则时返回 1。送入配对评估的版本是
$$\bar{\theta}_{k+1}=\begin{cases}\theta^{\prime}_{k+1},&u_{k}^{\pi}=1\ \wedge\ G_{k}^{\pi}=1,\\ \theta_{k},&\text{otherwise},\end{cases}\qquad \bar{\phi}_{d,k+1}=\begin{cases}\phi^{\prime}_{d,k+1},&u_{k}^{W}=1\ \wedge\ G_{k}^{W}=1,\\ \phi_{d,k},&\text{otherwise}.\end{cases} \tag{15,16}$$
只要至少一个部件变了,配对决策就在同一套规定的评测条件下,把装配后的候选对与当前对作比较;若两个部件都没变,则 $G_{k}^{\mathrm{pair}}=1$ 且不做新评估:
$$G_{k}^{\mathrm{pair}}=Q_{\mathrm{pair}}\left(\left(\bar{\theta}_{k+1},\bar{\phi}_{d,k+1}\right);\ \left(\theta_{k},\phi_{d,k}\right),\ \mathcal{D}_{\mathrm{compat},k}\right), \tag{17}$$
$$(\theta_{k+1},\phi_{d,k+1})=\begin{cases}\left(\bar{\theta}_{k+1},\bar{\phi}_{d,k+1}\right),&G_{k}^{\mathrm{pair}}=1,\\ \left(\theta_{k},\phi_{d,k}\right),&\text{otherwise}.\end{cases} \tag{18}$$
失败的处理是不对称的:组件检查不过就保留该部件的当前版本,配对检查不过就整对回退。数据也分三份用途——更新数据构造候选版本,门数据决定哪个版本被保留,指定的留出审计集只用于最终报告。评测规格固定任务指标、预测检查、约束、反馈额度与接受阈值;即便两个策略生成的候选不同,任务条件也可以被匹配。被保留的那一对与累积的反馈历史一起进入下一周期:策略变了会改变哪些候选被提议,预测器变了会改变排序与学习信号,两者共同决定哪些动作拿到反馈、以及后续更新能看到什么经验。这种「后续交互与学习依赖于已被保留的修订」的关系,就是论文所说的递归机制。
flowchart TD
  S[任务状态 s_t 与目标 g] --> P[Propose 策略 theta_k 提议候选集 K_t]
  P --> W[Predict 世界模型 phi_d_k 编码 z_t 并预测 z_t_next]
  W --> RO[Readout 点预测或概率分布]
  RO --> U[效用打分 加权和减去不确定性惩罚]
  U --> V[Verifier 有效性 v_tau 与运行约束]
  V -->|不可行| DROP[剔除 不进入排序]
  V -->|可行| SEL[Select 在剩余反馈预算内挑一个或一批]
  SEL --> EXE[Evaluate 外部执行 沙箱 GUI 环境 实验台]
  EXE --> H[反馈历史 H_k 预测观测对 带生成它的版本号]
  H --> DP[D_policy_k 策略改进数据]
  H --> DA[D_adapt_k 预测器自适应数据]
  DP --> UP[Update theta 策略学习或工作流改写]
  DA --> REL[Reliability 三态 reliable unreliable insufficient]
  REL -->|不可靠且数据充分且预算足够| ADP[Adapt phi_d 预测器自适应]
  REL -->|可靠或证据不足| KEEPW[预测器保持当前版本]
  UP --> G1[组件门 G_k_pi 与当前 theta_k 比]
  ADP --> G2[组件门 G_k_W 与当前 phi_d_k 比]
  KEEPW --> G2
  G1 --> PAIR[配对门 G_k_pair 匹配条件下比装配后的对]
  G2 --> PAIR
  PAIR -->|通过| RET[Retain 新的策略模型对进入 k+1]
  PAIR -->|不通过| ROLL[整对回退到当前版本]
  RET --> S
  ROLL --> S
图 3:按论文 2.1–2.5 节与公式 7–18 复原的六步闭环。虚线回路不存在——保留下来的策略-模型对直接变成下一轮的起点,这正是「递归」与「多跑几轮」的区别。
五个领域怎么绑定这套协议
论文表 4 把每个领域的状态、动作、世界模型、预测目标、策略/工作流与反馈来源逐一对齐,并标注了各处「实际报告的更新范围」。这张表也是读实验时最该放在手边的一张:它明确说明每个实验只实例化了完整协议的一部分。
| 领域 | 状态与动作 | 世界模型与预测目标 | 策略/工作流与反馈驱动的变更 | 反馈与评测 |
|---|---|---|---|---|
| 代码修复 | 程序、测试与反馈;候选修订 | 基于 JEPA-Anything 的 W1,由 Qwen2.5-Coder-3B-Instruct 加 LoRA 改造;输出五类执行结果概率 | 固定的 ReasonFlux-Coder-7B;W1 固定或用反馈自适应 | 执行测试反馈;最终测试套件通过率与在线测试用量 |
| GUI 交互 | 界面状态与任务;GUI 动作 | GUI 结果预测器;候选界面动作的后果 | 动作策略与世界模型都由交互反馈更新 | 任务结果;完成率与动作级诊断 |
| 实验室规划 | 协议上下文;候选动作序列 | 基于 JEPA-Anything 的协议模型;候选序列的预测后果 | 4B 规划策略;同一次自我改进过程里的五个连续版本 | 开发反馈;L1 下一步动作准确率与 F200 的 L2 Final Score |
| 化学反应 | 反应;条件向量 | ReactionT5–JEPA-Anything;产率分布 | 测得的产率引导后续条件选择 | GC 与 LC–MS 实测产率;匹配实验次数下的最佳观测产率 |
| 免疫科学 | 细胞、组织与个体上下文;干预 | 免疫世界模型;多尺度转移与生物学读出 | 工作流演化与世界模型构建;下游分析阶段预测器冻结 | 实测扰动支撑建模;留出的干预与上下文评估预测 |
表 2:领域绑定与各自报告的更新范围(论文表 4)。世界模型负责预测后果,策略负责提议或选择动作。
代码对照:论文里的符号在仓库里是哪几行
仓库把「共享 workflow」与「领域任务」分开:src/rsi_anything/ 是只依赖标准库的 runner(plan/run/status/report),领域实现住在 tasks/<domain>/ 下,各自带自己的解释器与钉住的依赖,JEPA 核心以 vendor/jepa-anything-core 的形式被 vendored 进来。README 把整个框架概括成六个词:Propose → Predict → Select → Evaluate → Learn → Retain,与论文图 2 的六个操作一一对应。下面四处对照都能在 main 分支上逐行核对。
对照一:W1 就是 tasks/code_repair/src/world.py::ExecutionWorld。论文说 W1 是「3B 执行结果世界模型,用 JEPA-Anything 的预测设计、由 Qwen2.5-Coder-3B-Instruct 加 LoRA 改造,对每个候选-测试对返回各执行结果类别的概率」。源码里这句话展开成:DomainEncoder 用 LoraConfig(r=16, lora_alpha=32, lora_dropout=0.0, target_modules=['q_proj','k_proj','v_proj','o_proj']) 挂在 bfloat16 骨干上,token 级输出做掩码均值池化后接 Linear(hidden, 256) + LayerNorm,输入长度上限 16384,超限直接抛 Overlength 而不是静默截断;mode='opf' 时组合 OrthogonalFactorProjection(D=256, K=4, R=64, learnable=True, orthogonality_mode='soft_gram') 与 UnconstrainedMultiHeadPredictor,正是公式 3 里那个 $F$ 的「因子预测 + 合成」;读出头是 LayerNorm(256) → Linear(256,64) → GELU → Linear(64,6)——6 个 logit 里前 5 个对应五类执行状态(AC/WA/TLE/RE/CE),第 6 个经 softplus 变成预测运行秒数,也就是公式 4 的概率读出再加一路资源预测。训练目标是
loss = representation + ce + 0.1 * resource + 0.2 * ranking
# ce      = cross_entropy(output[:, :5], labels)
# resource= smooth_l1(softplus(output[:, 5]), seconds)
# ranking = mean relu(0.1 - p_good + p_bad)  # 同 group_id 且 AC 与否不同的候选对
# representation = jepa_anything_objective(...).total  # prediction + orthogonality
#                                       + factor_activity + encoder_variance
其中 representation 直接调 vendored 的 jepa_anything_objective,目标侧用 EMA 衰减 0.996 的 target 编码器并在 torch.no_grad() 下编码——公式 2/3 里的 stop-gradient 在代码里是显式的 .detach() 加一次「target 参数梯度必须为 None」的断言。推理时的打分带一个可学温度:softmax(readout(z)[:, :5] / log_temperature.exp().clamp(0.2, 5.0)),而优化器把参数分成三组不同学习率(LoRA 5e-6、读出头 1e-4、OPF 1e-5,AdamW weight_decay 0.01),温度本身不进任何一组。这套「按角色分组、给不同速率」的写法,对应的正是论文那句「自适应声明自己的可训练参数子集,可以与初始建模阶段不同」。
对照二:公式 7 的效用与公式 8 的准入,落在 semantic_world.py 里,而且带泄漏断言。该文件把 W1 扩出一个「整套训练套件」的头:suite_readout 深拷贝原读出头,把最后一层 Linear(64, 6) 换成 Linear(64, 7),前 6 行权重原样复制、第 7 行清零,于是扩展是「原头 + 一个新通道」而不是重训一个头。第 7 个通道经 sigmoid 预测通过率,效用被硬编码成
utility = P(full training suite passed) + 0.25 * predicted pass fraction
predicted_utility = softmax(suite[:, :5])[:, 0] + 0.25 * sigmoid(suite[:, 6])
这就是公式 7 在代码修复领域的具体权重($w_{d,1}=1$、$w_{d,2}=0.25$、不启用不确定性惩罚)。validate_scope() 则把公式 8 的准入判据写成了运行期断言:每条转移必须显式声明 prediction_scope(per_public_test 或 whole_training_suite),聚合态的行必须带 g6-whole-training-suite-transition-v1 schema,观测通过率必须落在 0 与 1 之间,status==0、allpass、partial==1 三者必须互相一致,效用必须与 allpass + 0.25 * partial 在 1e-8 内相等;最后四个出处标记必须全为 False——context_contains_private_case_inputs、context_contains_private_expected_outputs、target_contains_candidate_code、gate_or_final_labels_used。翻译成人话:上下文里不许出现私有测试的输入或期望输出,目标里不许含候选代码本身,门数据与最终评测标签不许进训练。论文里那句「预测字段与观测字段各自保留出处」在代码里是四个布尔断言。listwise 损失用温度 0.1 的 softmax 目标做 KL 散度,并强制每个池必须是完整的四个不同候选、必须对应同一次执行转移,效用相同的池被跳过、只有 keep_initial 的单例也被跳过(跳过的数量还会被计数报告出来)。
对照三:「匹配评测条件」不是修辞,是 incumbent.py::state_signature 的字符串切分。论文说配对评估「即便两个策略生成的候选不同,任务条件也可以被匹配」。代码里的实现是:把每条记录的 context 先按 '\nCandidate action:\n' 切出前置状态,再按 '\nOfficial public test suite:\n' 切出测试套件,断言两个分隔符都存在,返回 (before, tests) 作为状态签名。make_units() 随后断言:初始单元必须是 step_id == -1、candidate_id == 'keep_initial' 且组内只有一条;第一轮单元必须是 step_id == 0 且恰好 4 个候选;并且四个候选与在位者的状态签名必须完全相同(assert all(state_signature(rows[i]) == state_signature(rows[current_id]) ...))。这 5 条一起构成一个「比较单元」:4 个候选 + 1 个在位者,正是公式 13–18 里组件门与配对门需要的、在相同条件下的对照。单元还带一个 contrast 标记(组内最大效用是否大于最小效用),batches_for() 组批时让第 0 位优先放有对比度的单元,每批四个不同任务,凑不满时复用已消耗的单元并把它们的下标记进 padding_indices;最后断言所有下标的计数恰好等于 Counter(range(len(rows))),即每行被用且只用一次。
对照四:外部评估(E3 之下的 E0)是 cure_wm.py 的沙箱,五个状态码就是读出头的前 5 个 logit。execute() 先用 compile() 做语法检查,语法错或空程序直接给全部测试记 CE;随后每个测试在 runuser -u nobody -- unshare -Urn -- python -I candidate.py 下运行,sandbox='required' 时若宿主缺 runuser 或 unshare 直接抛错而不是降级;子进程带 RLIMIT_CPU=(10,11)、RLIMIT_AS=1GiB、RLIMIT_FSIZE=1MiB、RLIMIT_NOFILE=64,环境变量只留 PATH=/usr/bin:/bin;默认 3 秒超时后 killpg(SIGKILL) 杀整个进程组记 TLE,非零返回码记 RE,stdout.strip() == expected.strip() 记 AC 否则 WA。这五个状态码与 world.py 读出头的 5 个分类 logit 严格对齐,也就是说 W1 学的不是抽象的「好坏」,而是这个沙箱会吐出的那五种结局加一路运行时间。另外 execute() 对空测试套件抛 ValueError——「没有测试就没有反馈」在代码里是硬错误。
训练编排与 GUI 编排。tasks/code_repair/src/training.py 把预测器的构造与自适应拆成四个阶段 initial → semantic → expanded → incumbent,每阶段吃上一阶段的 checkpoint(对应 workflow.md 里的「verify assets → update initial world → update semantic world → update expanded world → update incumbent world → evaluate」)。里面有几处断言值得单独点出:assert len(rows) == config['rows'] 与 verify_training_hash() 锁死训练集内容与哈希;assert not train_ids & dev_ids and not train_ids & set(experiment()['evaluation']['tasks']) 强制训练题、开发题与评测题三者不相交;semantic 阶段先只训读出头(set_update_stage('heads'))再联合训练('joint'),且 log_temperature 在两个阶段都被排除在可训练集之外;每步之后 update_ema(),梯度裁剪到范数 1 且 error_if_nonfinite=True;存盘后重新加载并对同样 4 条上下文比对打分,assert torch.allclose(..., rtol=2e-5, atol=2e-6),把「checkpoint 写坏了」这类静默故障挡在阶段之间。元数据里还写着 final200_labels_used=False,与论文「留出集只用于最终报告」对得上。GUI 侧的 src/rsi_anything/tasks/gui.py 把论文那句「保留的策略-模型对用于后续交互」翻译成一条固定 stage 序列:prepare-models → doctor --gpu → freeze → preflight browser → preflight world → adapt-and-evaluate,产物包括 protocol.json、base_manifest.json、两份 *_contracts.json、outputs/results.json 与 outputs/completion_audit.json。先「冻结协议」再跑,意味着三档控制器是在同一份被冻结的评测协议下比较的;adapt-and-evaluate 内部按 workflow.md 的说法包含两次策略/世界更新、一次条件确认、审计与聚合。
实验结果
代码修复:固定 coder,只换选择与预测器
这是全文最干净的一组对照,因为它把策略钉死了。ReasonFlux-Coder-7B 提出四个修订,最多三轮反馈;四种选择方法共用同一个 coder 与同一份候选预算;评测覆盖 200 道 CodeContests 题、3 个随机种子,共 600 次「题-种子」评测,在线测试提供选择期间的反馈,隐藏测试提供最终成功度量。结果与在线用量一起看才有意义:把随机选择换成世界模型引导的选择,隐藏测试全通过率从 26.0% 到 29.2%(175/600),再让预测器用执行反馈自适应,涨到 31.2%;而在线测试调用次数四者都在 3.71–3.72 之间,几乎完全一致。
| 选择方法 | 隐藏测试全通过率 | 在线测试调用/任务 |
|---|---|---|
| Random-K(随机选一个候选) | 26.0% | 3.72 |
| 容量匹配的静态验证器 | 26.3% | 3.72 |
| RSI-Anything + 固定世界模型(CURE-WM-Lite) | 29.2% | 3.71 |
| RSI-Anything + 世界模型自适应 | 31.2% | 3.72 |
表 3:共享 coder 与候选预算下的三轮修复(论文表 2,200 道 CodeContests × 3 seeds = 600 次评测)。两种 RSI-Anything 配置都用世界模型引导候选选择,区别只在于是否用反馈更新世界模型。
预测质量的两项指标解释了增益的来源:候选排序准确率从静态验证器的 66.5% 升到 72.8%,五类 Brier 分数从 0.488 降到 0.358。排序更准意味着同样四次执行机会里挑到好候选的概率更高,Brier 更低意味着概率本身可用——这一点很重要,因为公式 7 的效用是概率的加权和,概率不校准时排序规则会退化。相对静态验证器的配对增益是 +2.83 个百分点,95% 区间 [+0.17, +5.50];注意这个数与两个四舍五入后比率之差(29.2 − 26.3 = 2.9)并不完全相同,因为它是逐「题-种子」配对后、以任务为聚类重采样单位算出来的。区间下界只有 +0.17,说明这组增益在统计上刚好越过零,读的时候不宜放大。另外在 APPS Introductory(1000 题,3000 次题-种子评测)与 LiveCodeBench v6(1055 题,3165 次)上,JEPA-Anything 引导的候选选择取得 46.37% 与 33.05% 的最终全套测试通过率,超过随机选择与静态验证器,报告的是三个种子的算术平均;所有方法共享每题每种的初始程序,公开测试引导修复,全部公开测试通过即停,最终成功要求通过完整官方测试套件。
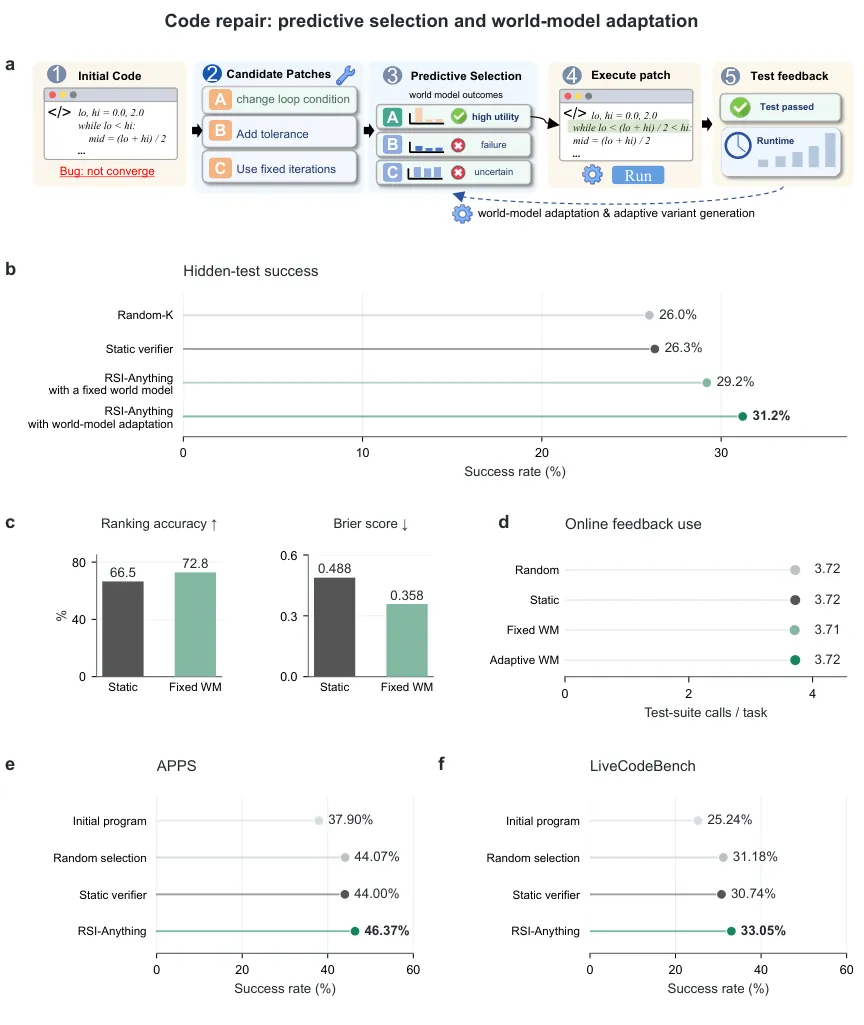
图 4:代码修复(论文图 3)。a 是一个不收敛循环的修复示例:从候选补丁与预测结果,到执行与测试反馈,A–C 为示例补丁,基准本身用固定 coder 与每轮四个候选。b–d 为 200 道 CodeContests、三个种子、最多三轮反馈的结果:b 最终隐藏测试全通过率,c 候选排序准确率与五类 Brier 分数,d 每任务平均在线测试调用次数。e、f 分别是 APPS Introductory 与 LiveCodeBench v6 上三种子的最终全套测试成功率。绿色为世界模型方法,灰色为基线。
GUI:成功率与动作经济性要一起读
MiniWoB++ 的 click-checkboxes 要求勾选指令点名的复选框并提交表单,评测在同样的 100 个测试实例上进行,每回合上限 120 秒与 8 个动作,成功要求所有复选框状态与指令一致且表单已提交。RSI-Anything 用交互反馈同时更新策略与世界模型,保留下来的对用于后续交互。三档保留版本的成功率是 51% → 79% → 99%,World-based 对照组是 49% → 96% → 98%。
| 指标 | 初始 | 中间(自适应档) | 最终档 |
|---|---|---|---|
| 任务成功率 | 51% | 79% | 99% |
| 每回合平均动作数 | 5.30 | 2.93 | 3.21 |
| 出现错误提交的回合数 | 9 | 21 | 1 |
| 记录到的重复点击次数 | 237 | — | 0 |
表 4:click-checkboxes 三档保留版本的行为对照(论文图 4c、4e–4g 与仓库 docs/benchmarks.md)。相对基线动作数下降 39.4%(5.30 → 3.21)。
这组数据里最值得停下来看的是中间档:它动作最少(2.93),成功率也有 79%,但错误提交的回合数是三档里最高的 21 个,比初始档的 9 个还多一倍以上。也就是说,光看「动作更省」会把一个更爱乱提交的控制器误判成更好。最终档动作数比中间档略升(3.21),却把错误提交压到 1、成功率推到 99%,重复点击从 237 归零。论文因此明确写:动作数必须与任务成功率、提交错误放在一起解释。OSWorld 把评测扩到桌面任务,报的是相对增益(定义为 $100\,(s_{\mathrm{method}}/s_{\mathrm{reference}}-1)\%$):相对初始 agent 提升 18.4%,相对 RLAnything 提升 5.5%,而 RLAnything 相对初始 agent 提升 12.3%。用 1.184 除以 1.123 反推得到 +5.4%,与论文报的 +5.5% 只差一次四舍五入,三个数字彼此自洽。
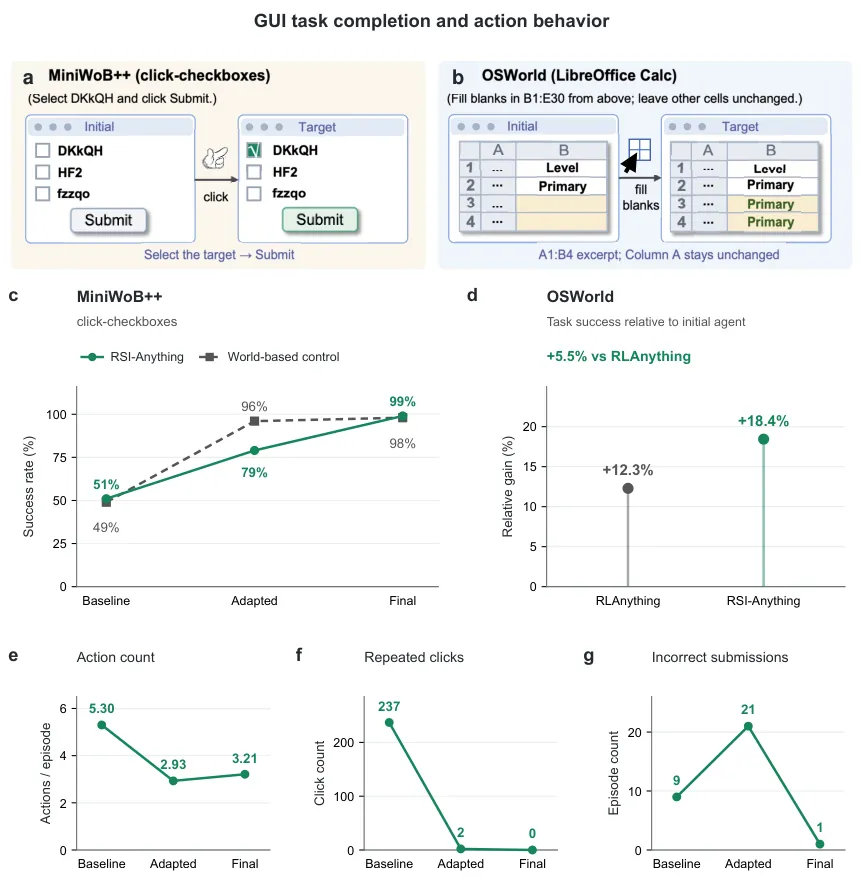
图 5:GUI 评测(论文图 4)。a、b 是 MiniWoB++ 复选框与 OSWorld 表格任务的初始与目标状态;c 为 RSI-Anything 与 World-based 对照在三档配置下的 click-checkboxes 成功率;d 为 OSWorld 相对初始 agent 的成功率增益,标注给出 RSI-Anything 相对 RLAnything 的额外增益;e–g 分别是 c 中各档的每回合平均动作数、重复点击次数与错误提交回合数,折线只连接被评测过的配置。
实验室规划:4B 策略的五个连续版本
LabHorizon 评测受试剂、仪器与顺序约束的实验室动作,Level-1 是视觉接地的下一步动作选择,Level-2 是与协议对齐的动作序列生成,F200 是它的 200 任务设置,Final Score 综合了动作序列相似度与参数准确率。作者跟随同一次自我改进过程里的五个连续 4B 策略版本,按开发顺序在同一个 F200 Level-2 基准上评测:21.80% → 38.03% → 41.99% → 44.56% → 46.01%,末版比初版高 24.21 个百分点。这里的「按开发顺序评测」与前面 $k$ 的定义相呼应:版本序列本身就是被保留下来的那几对。
| 系统 | L1 准确率 | L2 Final |
|---|---|---|
| Grok 4.3 | 0.555 | 0.3244 |
| Gemini 3.1 Pro | 0.465 | 0.3263 |
| GPT-5.5 | 0.535 | 0.2276 |
| Kimi K2.6 | 0.550 | 0.3150 |
| Qwen3.6-35B-A3B,直接提示 | 0.475 | 0.2534 |
| Qwen3.6-35B-A3B,训练后 | 0.635 | 0.4100 |
| Actor–Simulator–Selector 参考系统 | 0.665 | 0.4532 |
| RSI-Anything(4B) | 0.700 | 0.4601 |
表 5:LabHorizon 基准上的参考系统与 RSI-Anything(论文表 3)。参考系统用训练过的 Qwen3.6-35B-A3B 当 Actor、Gemini 3.1 Pro 当 Simulator 与 Selector,其 Level-2 报告值为 0.4532。
两点值得强调。其一,参考系统是三模型编排(35B Actor 加 Gemini 3.1 Pro 做 Simulator 与 Selector),RSI-Anything 用的是单个 4B 策略加一个协议世界模型,最终以 0.4601 对 0.4532 领先 0.69 个百分点,L1 上以 0.700 对 0.665 领先。在这个基准上,小模型加一个会预测后果的世界模型,打赢了大模型编排。其二,四个前沿通用模型直接提示的 L2 分数都在 0.23–0.33 之间,训练后的 Qwen3.6-35B-A3B 能到 0.4100,仍低于 4B 的 RSI-Anything——差距不在参数规模,而在「是否有一个针对该协议训练的预测器来筛选候选序列」。
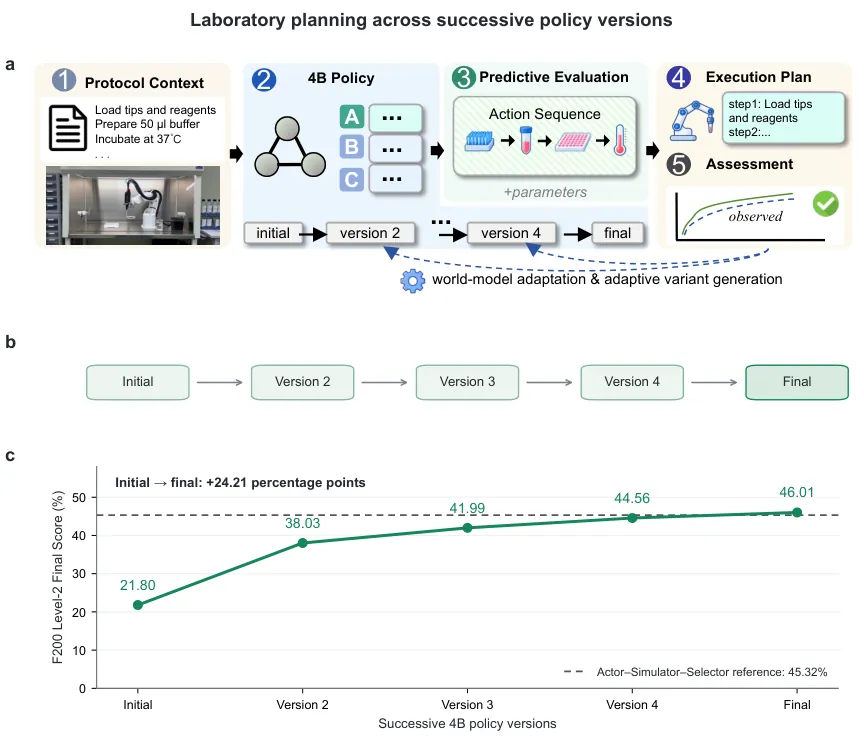
图 6:实验室规划(论文图 5)。a 为规划工作流示意:协议上下文 → 4B 策略 → 对动作序列与参数的预测评估 → 执行计划 → 评估,虚线反馈路径表示框架里的更新路线,下方的定量比较跟随被保留的策略版本。b 为同一次自我改进过程里五个连续的 4B 版本,c 为各版本 Final Score,虚线标出 Actor–Simulator–Selector 参考值 45.32%;版本按开发顺序排列,间距为示意。
反应优化:同样实验次数下比贝叶斯优化更高产率
化学部分比较的是「匹配实验次数」下的条件搜索。适配器叫 ReactionT5–JEPA-Anything:把 ReactionT5 这个反应预训练骨干与 JEPA-Anything 的预测设计合起来,输入序列化反应 $r$ 与候选条件向量 $c$,输出预测产率分布 $p_{\phi}\left(y\mid r,c\right)$。两个 Suzuki–Miyaura 筛选各自与贝叶斯优化对照:GC 分析的那一筛改变 Pd–NHC–DMS 预催化剂、碱与溶剂,底物是 4-氯苯甲醚与 4-(三氟甲基)苯硼酸的偶联;流动 LC–MS 的那一筛用 Pd(OAc)₂ 加配体、碱与溶剂,底物是 1c 与 2b。20 次实验时 GC 筛的最佳观测产率是 93.0% 对 87.5%,高 5.5 个百分点;40 次实验时流动筛的平均最佳观测产率是 96.15% 对 82.16%,高 13.99 个百分点。每一次实测产率都会扩充观测历史,去引导下一次条件选择,这正是公式 7 的选择规则在实验台上的形态。
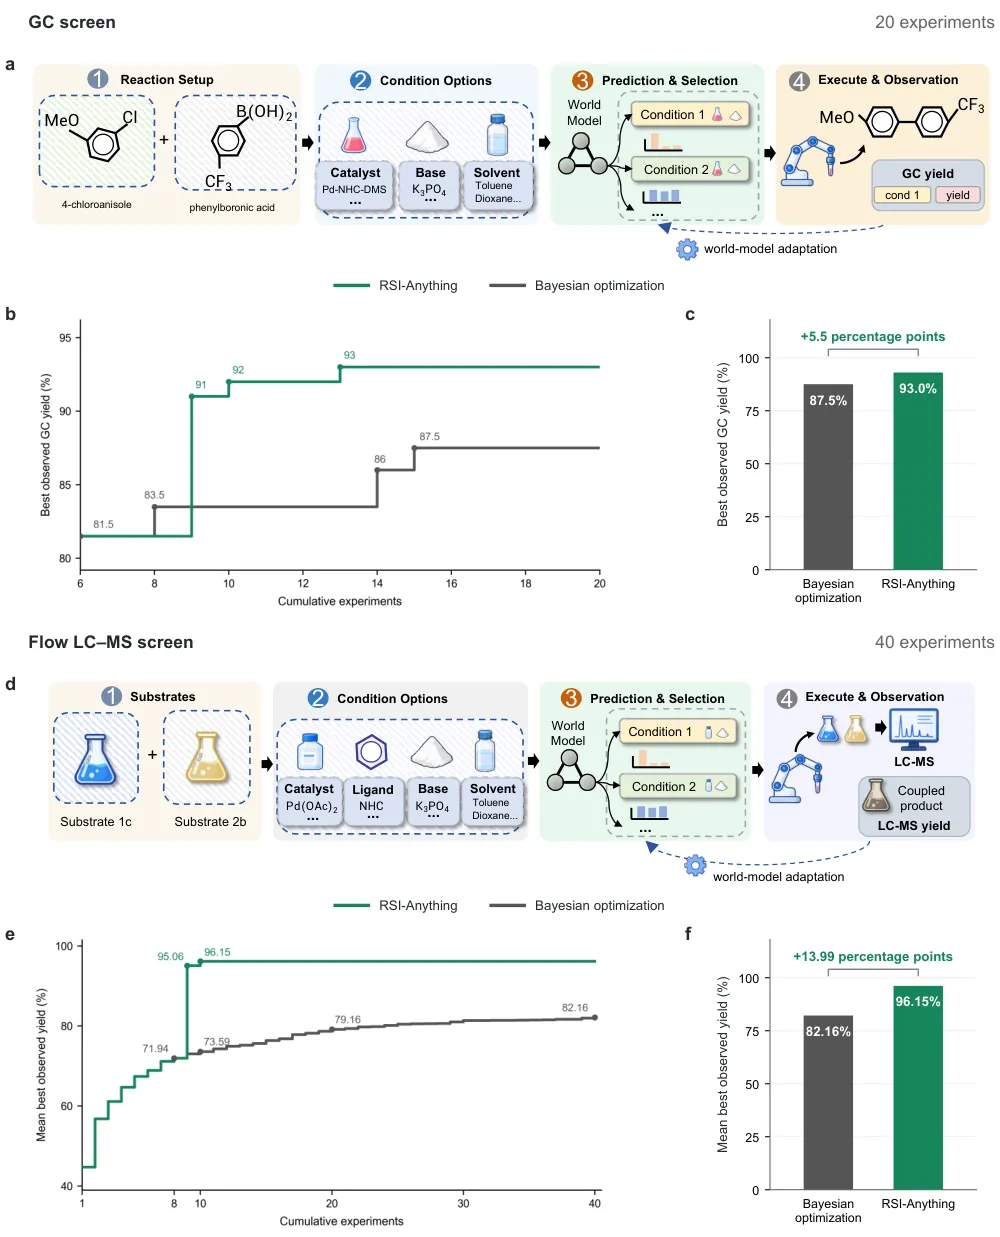
图 7:反应条件优化(论文图 6,绿为 RSI-Anything,灰为贝叶斯优化)。a 为 GC 筛工作流:反应装置 → 催化剂/碱/溶剂选项 → 预测引导的条件选择 → 实测产率;b、c 为 GC 产率随累积实验数的曲线与 20 次时的终点对比;d 为底物 1c 与 2b 的流动筛工作流,Pd(OAc)₂ 加配体、碱、溶剂后经 LC–MS 分析;e、f 为流动筛的平均最佳观测产率曲线与 40 次时的终点,括号标出 5.5 与 13.99 个百分点的增益。
仓库里的 tasks/reaction_optimization/results/evaluation.json 补了正文没细说的评测形态:这是「对实测筛选产率的离线顺序重放」,候选池 321 个条件,100 次运行(种子 4001–4100),起始观测 8 次、总预算 40 次;池内最佳产率本身就是 96.15%,而 100 次运行的平均最终最佳观测产率也是 96.15%,即每一次运行都摸到了池内天花板。按预算看,第 8 次观测时是 71.94%,第 9 次 80.14%,第 10 次就锁定 96.15% 并保持到第 40 次;首次命中最优的观测序号均值 9.94、中位数与最大值都是 10。配套的 validation.json 记录了 9 个本地推理单测通过、3200 条推荐被重放、4000 个观测产率在评测环境内被校验、预测数组与封存先验逐位一致、所有报告指标被重算——同时 target_measurements_exported: false,也就是原始测量值本身没有随仓库发布。
免疫科学:把同一套保留协议搬到科研流程上
最后一个应用是端到端的免疫科学流程,串起三件事:持久的科研智能体工作流开发、预测式世界模型构建、以及证据引导的科学分析。构建阶段由 Agent Genesis 搜索科研智能体工作流与模型配置,选出一个「建模智能体工作流」——它就是这一阶段被保留的策略配置——并产出一个动作条件的免疫世界模型,把细胞因子、基因扰动或候选疗法当作显式动作,表示细胞、组织与个体三个尺度的免疫状态。下游分析阶段,世界模型参数被冻结,演化的是分析状态、候选干预与假设排序,靠模型推理与自我纠正推进;实测扰动证据支撑建模,留出的干预与生物学上下文用来评估预测与动作组合。
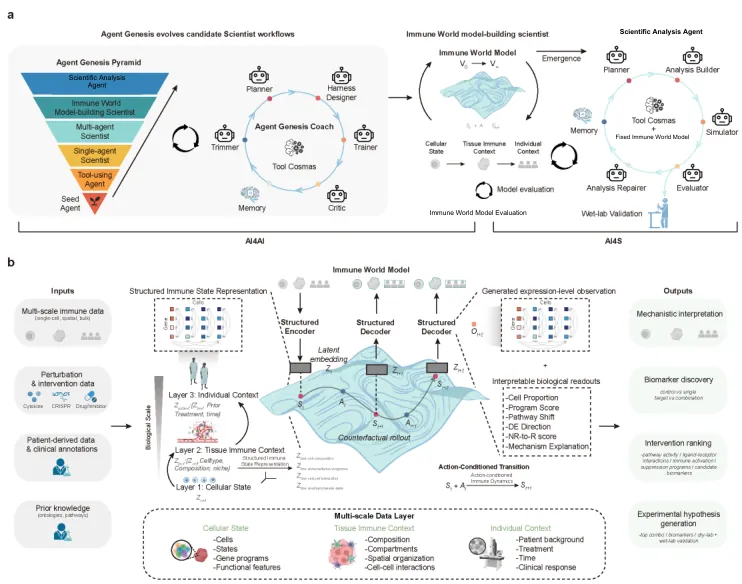
图 8:免疫科学端到端应用(论文图 7)。A 为科研智能体工作流的演化、免疫世界模型的构建与模型引导的分析;B 为在结构化细胞、组织与个体免疫状态上的动作条件转移,以及用于解释、排序与假设生成的读出。A、B 改编自 Cui et al. (2026a) 的图 1。
结果部分有一个反直觉的细节:在治疗假设生成阶段,自我纠正把已经筛过的细胞因子对候选全部剔除,最终由整合证据给出一个前瞻性提名——SIRPα 抑制与 IL-36γ 轴调节的组合,等待实验验证。换句话说,这一轮系统改进的产出不是「把原假设调得更好」,而是换掉了一整类假设。这与框架的语义是一致的:保留下来的工作流改变了后续候选的生成方式,而不只是它们的排序。论文的评测设置细节指向 Cui et al. (2026a),本文没有重复报告。
局限性
作者在讨论节里自己列了四条。第一,联合多轮评测还没做:原话是「需要联合的多轮评测,才能在单一任务内确立策略与世界模型的持续相互改进」——目前的证据是「预测选择 + 预测器自适应」在代码修复里的两段增益、以及实验室规划里的策略版本序列,但没有一个实验在同一任务内同时跑满策略与模型的相互改进并逐周期报告接受/拒绝。第二,实验室结果评的是「与协议对齐的规划」,可靠的物理执行还需要在相应设备与工作流上评测。第三,化学只覆盖两个 Suzuki–Miyaura 筛选,且只在报告的实验预算内成立。第四,免疫科学应用给出的治疗假设仍待实验检验。
从评审视角再补几条。其一,五个实验各自只实例化了协议的一部分,这是论文表 4 自己写明的:代码修复固定策略、实验室规划只跟随策略版本、GUI 同时更新两者但只在一个任务上给了动作级诊断、化学只测反馈引导的搜索、免疫科学把构建与分析分开。因此「递归」这个主张的证据是跨实验拼起来的,而不是在单个实验内被证成的;配对门(公式 17)在哪些实验里真的被执行、执行了几次、拒绝率多少,正文没有给。其二,代码修复那 +2.83 个百分点的 95% 区间下界只有 +0.17,统计上刚过零;容量匹配的静态验证器是作者自建的对照,其调参充分程度无法从正文判断。其三,实验室规划的五个版本是「按开发顺序」在 F200 上评的,而 F200 同时是它们的开发反馈来源;论文声明应保留独立的审计集用于最终报告,但没有披露这五个版本的门数据与 F200 是否严格分离,因此版本序列的单调上升里有多少是对该基准的适配、多少是真实规划能力提升,从现有信息无法拆分。其四,可靠性三态(公式 10)的具体判据——误差、校准、漂移与覆盖各自的阈值——在各领域都没有给数值,复现者无法判断 $u_{k}^{W}$ 何时会被置 1;代码里 semantic_world.py 的 manifest 甚至显式写着 calibration_verified: false 与 semantic_correctness_guaranteed: false,即那套五类概率的校准并未被验证过。其五,GUI 的成功率来自 100 个测试实例、没有报种子或区间,OSWorld 只给相对增益而不给绝对成功率与置信区间,读者无法判断 18.4% 对应多少个任务。其六,化学的 96.15% 恰好等于 321 个候选的池内最优,指标在池顶饱和,因此「比贝叶斯优化高 13.99 个百分点」实际衡量的是搜索效率而非发现能力;且该结果是离线顺序重放,原始测量值未随仓库发布。其七,可复现性是分层的:代码修复与 GUI 有完整可跑的 workflow 与配置,实验室规划与反应优化只有推理侧适配器加封存结果,免疫科学只有文档。
总结与展望
这篇论文真正的贡献不在某个模型,而在一份协议:它把「预测」与「保留」写成同一套形式化的两端。预测决定谁去花外部反馈(公式 7、8),反馈决定谁被更新(公式 9、12),可靠性决定何时允许更新预测器(公式 10、11),组件门与配对门决定哪一对被保留(公式 13–18)。四个设计选择值得单独记住:可靠性判为三态、覆盖不足不等于可靠;预测必须可归因到当前模型版本,旧版本预测不得混入当前误差估计;训练准入与外部评估选择分开治理,不敢训练不等于不敢实验;配对失败整对回退,而不是只回退其中一个部件。这几条合起来,正是在处理「策略一变、预测器的评估分布就变」这个耦合难题时最容易被省略的部分。
证据的分布也很清楚:预测引导选择与预测器自适应在代码修复里给出连续的两段增益且在线用量几乎不变,说明增益不是靠多花测试预算换来的;GUI 里三档保留版本的成功率与动作经济性同时改善,中间档的反例还顺带示范了单看一个指标会怎么被骗;实验室规划里 4B 策略加协议世界模型赢过三模型大编排;化学里同样的实验次数拿到更高产率。接下来该做的是作者自己点出的那件事——在单一任务内跑满策略与模型的联合多轮改进,并逐周期报告门决策与接受率;其次是把可靠性判据的阈值与校准结果公开,否则「有条件的自适应」在别人的实验里无法被复现;第三是把物理执行与真实设备纳入实验室评测,让 46.01% 的规划分数与台面上的成功率之间建立联系。对做智能体运行时的人来说,这篇论文可以直接抄的不是模型结构,而是那份「更新数据 / 门数据 / 留出审计集」三分的数据纪律,以及把状态签名对齐当作配对比较前提的做法。
金句
「策略一更新,世界模型赖以工作的那套候选与经验分布就跟着变了;反过来,模型一更新,排序、想象轨迹与学习信号也全变了。所以改进任何一个部件,都不保证装配起来的系统更好——这正是保留必须被当作一等公民的原因。」