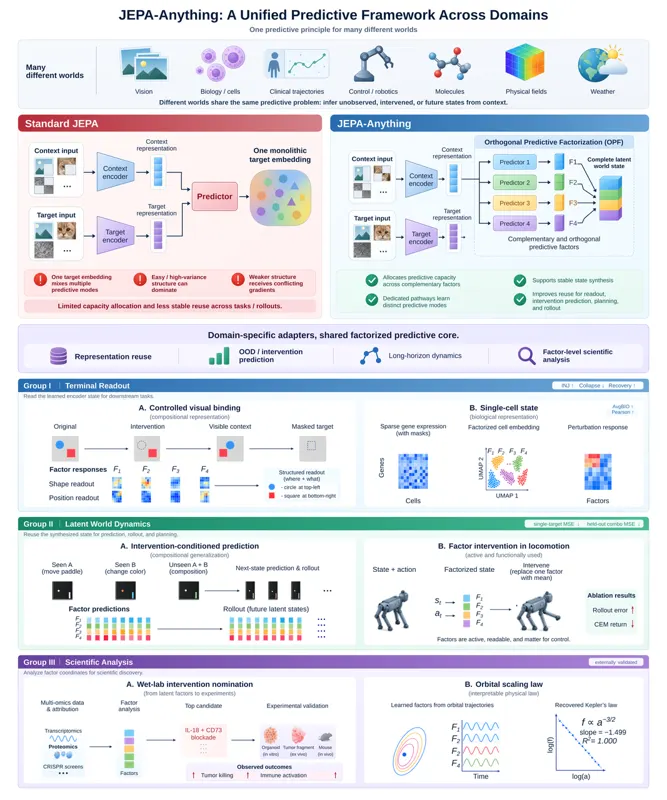
JEPA-Anything:跨域正交预测世界模型JEPA-Anything 用正交预测分解把世界模型的潜变量拆成互补因子,以独立路径预测并在七个异质领域验证,在控制与分子动力学等任务上改善长时预测和干预误差。Cui, Taoyong, Wang, Zhongyao, Xu, Xinyue·2026年9月17日世界模型联合嵌入预测架构Predictive Representation Learning2026年9月17日
LeVJEPA:无需启发式技巧的高效可扩展视频预训练LeVJEPA 用单个编码器、单个损失函数和一个固定超参数(λ=0.02)完成视频自监督预训练:不变性损失加 SIGReg 正则从数学上排除表征坍缩,无需目标编码器、预测器、stop-gradient 或像素重建;训练计算量比 V-JEPA 2 少 5.6–20.8 倍,FLOP 对齐下 ImageNet-1K 领先 7.6 个百分点,并免费获得块因果注意力,为流式感知与自回归世界模型铺路。Lukas Kuhn, Lucas Maes, Giuseppe Serra·2026年8月27日联合嵌入预测架构SIGRegvideo-SSL2026年8月27日
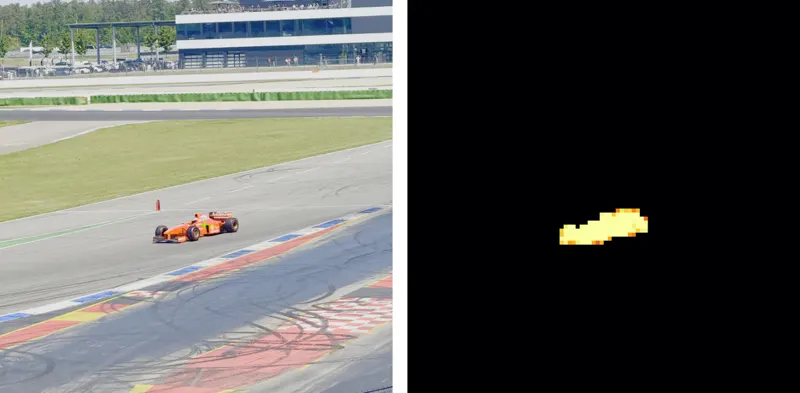
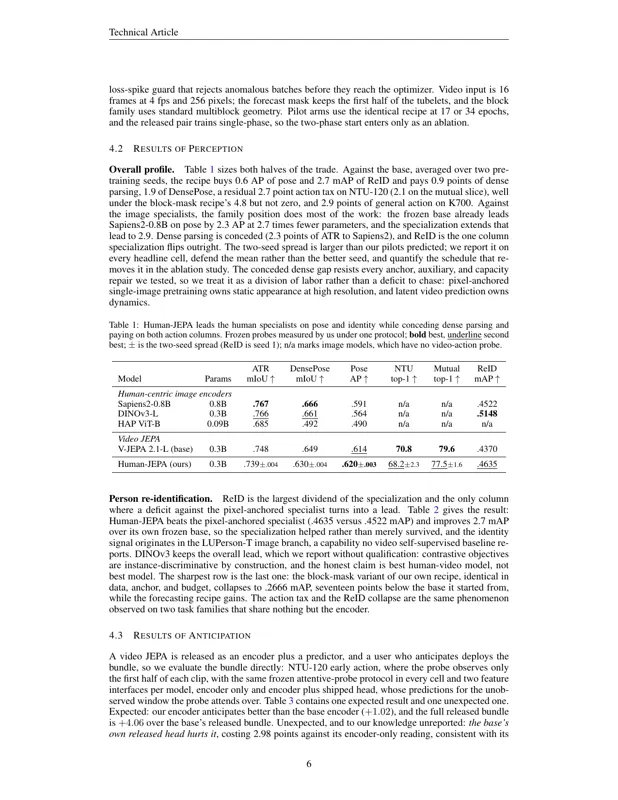
Human-JEPA:能够感知与预测的人类中心视觉模型理解人类的机器应当能够感知当下并预测未来。现有的人类中心视觉模型在静态图像上预训练,在静态密集感知上达到 SOTA,但无法处理运动与预测。本文提出 Human-JEPA,一个在视频上通过锚定预测训练的人类中心视觉模型:密集目标被钉在初始化的冻结副本上,防止密集感知的静默坍缩;块掩码被纯过去到未来的分割取代,避免了 5 个点的动作税和 17 个点的重识别坍缩。在冻结探针下,Human-JEPA 以 2.7 倍更少的参数在姿态估计和行人重识别上领先像素锚定专家模型,同时其预测头是首个不降低预测性能的预测头。单一安全适配的模型因此同时服务于理解人类的两个方面。Hui Wei, Licai Sun, Guoying Zhao·2026年8月21日human-centric visionvideo forecasting姿态估计2026年8月21日
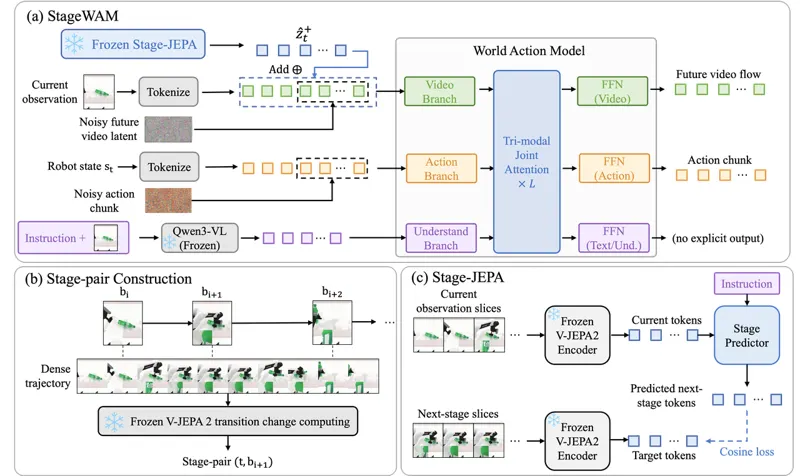
StageWAM:面向机器人操作世界-动作模型的阶段联合嵌入预测通用机器人策略旨在将多模态观测和语言任务指令映射为跨任务的动作。现有方法通常将未来表示为固定的短视频-动作块。本文区分了两种互补的未来:捕获局部场景演化的短期物理未来,以及表示任务进度的阶段级语义未来。提出StageWAM,在基于Motus的世界动作模型(WAM)上增加Stage-JEPA——一种目标条件联合嵌入预测架构。Stage-JEPA使用冻结的V-JEPA2编码器提取当前状态表示,预测下一推断阶段的潜在目标。在50个RoboTwin 2.0任务中,StageWAM实现90.25%总体成功率,成功回合平均执行步数较最强基线减少5.97%。Xiao Liu, Yuguang Yang, Xi Wang·2026年8月11日联合嵌入预测架构WAM视觉语言动作模型2026年8月11日
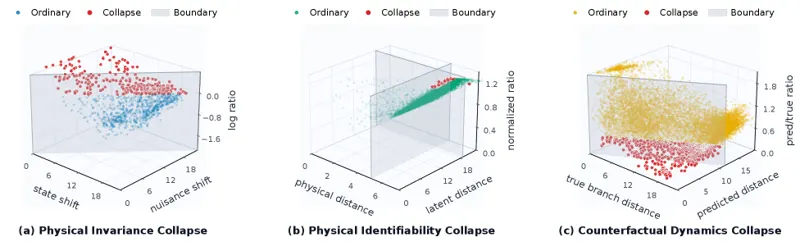
PhyLatent:JEPA世界模型的动力学相关表征本文提出PhyLatent,用SVIC、PSG、FRA、CASC和LD约束JEPA潜空间,解决物理不变性、可辨识性与反事实动力学塌缩;Cube MPC成功率从70.0%升至78.1%。Xi Zeng, Haojie Ren, Ziying Song·2026年8月6日联合嵌入预测架构世界模型模型预测控制2026年8月6日
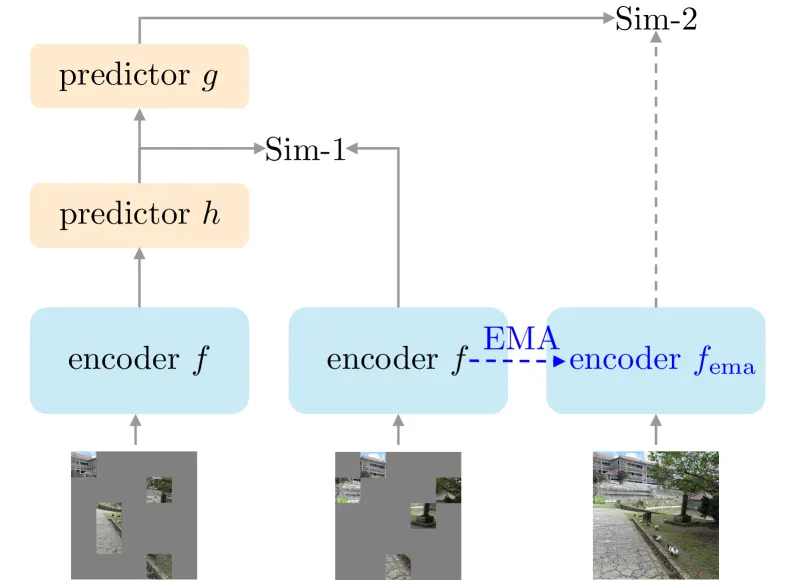
SiamJEPA:Siamese 学生编码器在 JEPA 中的作用研究 Siamese 学生编码器在 JEPA 自监督表征学习中的作用。SiamJEPA 采用掩码 Siamese 学生编码器与 EMA 教师网络,作为有效的正则化手段提升表征可分性并加速早期训练,在有限训练预算下优于单编码器 JEPA 变体。Makoto Yamada·2026年7月4日联合嵌入预测架构SiameseEMA2026年7月4日
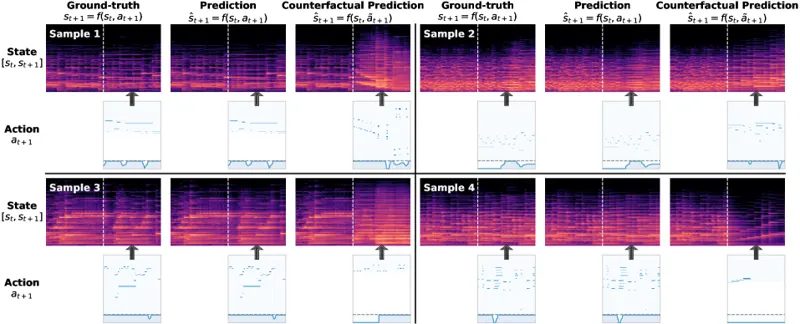
Music-JEPA:从动作学习声音世界模型联合嵌入预测架构(JEPA)近期兴起,本文将其扩展为从动作学习声音的世界模型。Ziyu Wang, Kun Fang, Yann LeCun·2026年7月24日世界模型Sound联合嵌入预测架构2026年7月24日