OPEN SOURCE DEEP DIVE
Midscene.js:视觉界面智能体与端到端测试框架
字节跳动 Web Infra 团队开源的视觉界面智能体与端到端测试框架。它用截图而非选择器定位元素,同一套接口覆盖 Web、安卓、iOS、鸿蒙与桌面,并提供 YAML 用例、TypeScript 节点、可回放报告与面向编程智能体的命令行技能。定位为智能体运行时层,而非 AI 编程工具。
一句话定位
Midscene.js 是字节跳动 Web Infra 团队开源的视觉界面智能体与端到端测试框架,仓库为 web-infra-dev/midscene,采用 MIT 许可,主语言是 TypeScript。它的口号是「像人一样看懂界面,用自然语言完成端到端测试」,操作与断言都模仿真人使用软件的方式:看屏幕、根据看到的内容动手、再检查界面最终呈现出来的样子。
与多数自动化工具不同,它不读取页面结构、不依赖选择器、也不要求额外标注——截图直接交给多模态模型,由模型判断该点哪里、该输入什么、结果对不对。采集时仓库约 1.52 万星标、1187 个复刻、70 名观察者,2024 年 7 月建仓,仍在每日更新。它服务的一端不是物理机器人,而是替人操作网页、手机与桌面软件的软件智能体,解决的是这类智能体「怎么看见界面、怎么把动作跑稳、怎么把过程沉淀成可维护的测试资产」。
数据面
| 项 | 值 |
|---|---|
| 仓库 | web-infra-dev/midscene(MIT,TypeScript) |
| Stars / Forks / Watchers(采集时快照) | 15,208 / 1,187 / 70 |
| 建仓 / 最近更新 | 2024-07-23 / 2026-10-14 |
| 采集时主干版本 | v1.15.3 |
| 官网 | midscenejs.com |
| 覆盖平台 | Web、安卓、iOS、鸿蒙、桌面(macOS / Windows / Linux)、自定义界面 |
| 核心接口 | aiAct、aiTap、aiInput、aiAssert、aiQuery |
| 仓库话题 | browser-use、computer-use、e2e-testing、gpt-operator、gui-agent、javascript、phone-use、testing |
它解决什么问题:把可见界面当作唯一事实来源
传统界面自动化的脆弱点几乎是共识:脚本读的是文档对象模型,绑的是选择器或语义标注。页面层级一改、类名一换,整条用例就碎;更麻烦的是,很多真实控件根本拿不到稳定的选择器——纯图标按钮、自绘画布、跨域内嵌框架、原生移动应用界面,一个都躲不过。
Midscene 的选择很干脆:既然用户只看得见界面,就只让智能体依赖界面。截图是唯一输入,元素的位置由外观与相对位置推断,再据此点击、输入、滚动。官方把这条路线的好处逐条列了出来。
| 维度 | 纯视觉路线的收益 |
|---|---|
| 跨平台一致性 | 浏览器画布、安卓、iOS、桌面应用共用同一种做法,任务描述与交互模式可以平移 |
| 验证用户所见 | 能直接检查颜色、选中高亮、布局与视觉反馈,也能覆盖画布与原生界面 |
| 与渲染栈解耦 | 不需要选择器,也不需要给界面补语义标注 |
| 成本可控 | 令牌消耗只随页面分辨率与任务复杂度变化,不随文档元素数量膨胀 |
这条路线也有代价,官方自己写在文档里:纯视觉定位必须用具备视觉定位能力的模型,不是任意大模型都能顶。换言之,它用「更高的模型门槛」换了「跨平台一致性与更低的界面维护成本」。需要抽取结构化数据、理解页面内容时,仍可以按需把文档对象模型一起交给模型,属于可选项,不是默认路径。
为什么它属于智能体运行时,而不是 AI 编程
先把两个能力域摆清楚。AI 编程收的是代码生成、修复、重构与仓库级软件工程任务的编程智能体与模型;智能体运行时收的是智能体跑在什么上面——插件与工具接口、技能系统、执行编排、长程记忆与自我改进。Midscene 不生成代码、不改代码、不做仓库级工程,它让智能体在图形界面里把动作执行下去、把结果断言出来。
它提供的恰好是「运行时」这一层的东西:统一的任务执行器(观察、规划、定位、动作、重规划的循环)、明确的模型角色分工、成套的动作与查询接口、贯穿每一步的执行记录与报告,以及把能力开放给外部编程智能体的命令行技能接口。这些正是智能体运行时的职责,而不是编程智能体的职责。
因此它的主能力域落在智能体运行时,次能力域落在智能体本身。与同板块的项目对照会更清楚:无头浏览器内核解决的是「智能体伸手去拿网页时这一支怎么又便宜又可控」,Midscene 解决的是「智能体怎么看见并操作任意图形界面,并把这件事变成可维护的测试」。两者都站在工具接口层,因此同归运行时。
纯视觉定位与模型的三种角色
行业里做界面智能体,元素定位主要有两条路线:把文档数据与标注截图一起喂给模型,或者只用截图做纯视觉定位。Midscene 选后者,让模型直接看界面截图,自己找到目标元素。这个选择同时也决定了它对模型的挑剔程度——例如「深度定位」(deepThink)只在支持视觉定位的模型上可用,官方明确点名 Qwen2.5-VL 这一类,而 gpt-4o 这类不支持视觉定位的模型用不了。
默认情况下,一个多模态模型同时负责规划、定位与页面理解,覆盖大部分场景,配置也最省事。任务变复杂时,可以在这个默认模型之外再挂两个专用模型。
| 角色 | 职责 |
|---|---|
| 默认模型 | 打底:负责元素定位,以及没有指派给规划或洞察模型的工作 |
| 规划模型 | 增强复杂目标、多步任务与分支场景下的规划 |
| 洞察模型 | 增强数据抽取、断言与页面理解 |
官方给的建议很克制:先用默认模型,只有在出现明确的能力瓶颈时才引入专用模型,因为每多挂一个模型,任务延迟与令牌消耗都会上升。支持的多模态模型包括 Qwen3.x、豆包 Seed 2.1、DeepSeek V4 Flash、GLM-4.6V、gemini-3.5-flash 与 UI-TARS,也提供可自托管的开源选项。
执行架构:规划、定位、洞察、动作与重规划
读完源码后能画出一条清晰的骨架。核心包是 @midscene/core,入口 agent/agent.ts 持有一个任务执行器、模型配置、报告生成器与执行记录;真正的循环写在 agent/tasks.ts 的 TaskExecutor 里,task-builder.ts 负责把规划产出的动作翻译成可执行任务,execution-session.ts 负责会话生命周期。模型工作流按职责分成四组目录:定位(grounding)、洞察(insight)、规划(planning)与录制生成(recorder-generation)。
一次 aiAct 的展开就是观察、规划、定位、动作执行、再规划的循环:模型先基于当前截图规划出下一步,执行器把「定位」与「动作」拆成两类任务分别执行——定位结果可缓存,也可以用深度定位策略提高精度——执行完再拍一张新截图,判断目标是否达成,没达成就进入下一轮规划。循环有明确的次数上限,防止任务卡死:默认 20 轮,UI-TARS 模型 40 轮,AutoGLM 模型 100 轮,也可以通过参数或环境变量覆盖。超限会抛出显式错误,而不是静默跳过。
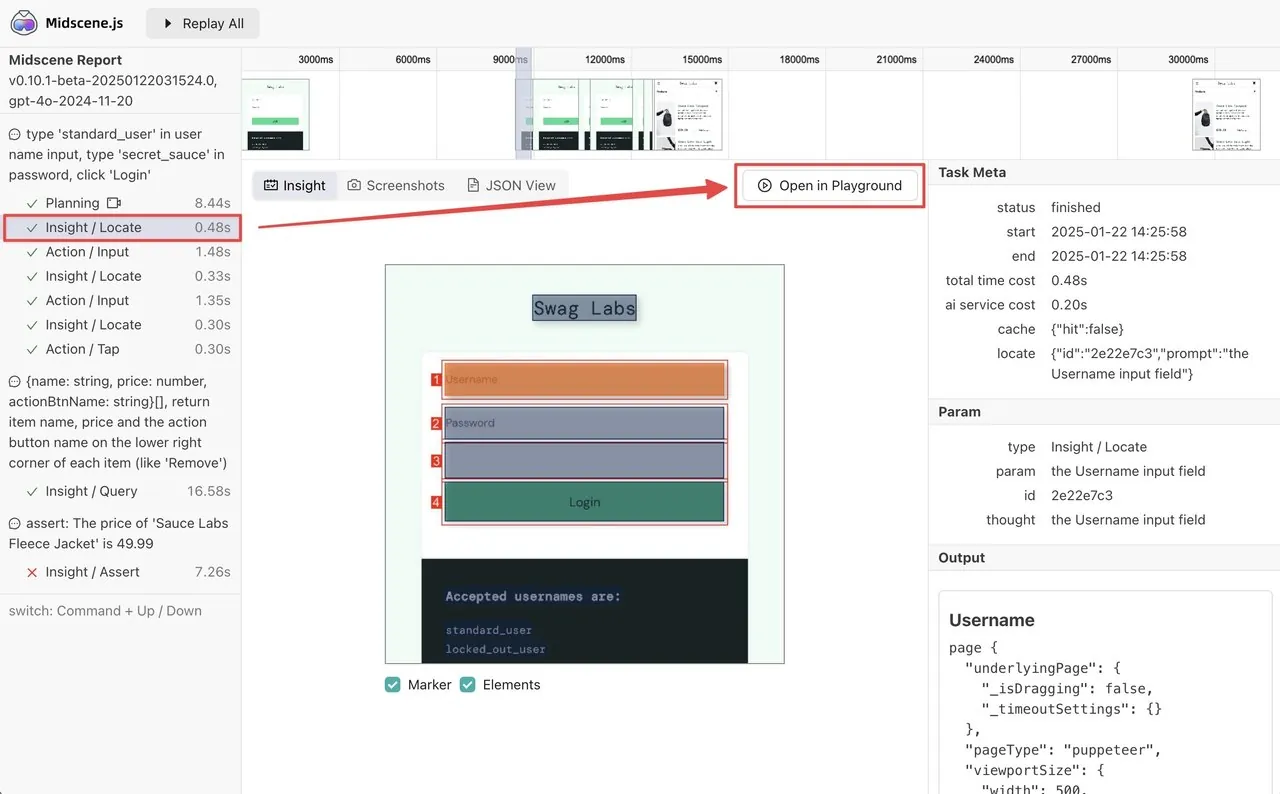
除了这种「自主规划」接口,它还提供即时动作:aiTap、aiInput、aiKeyboardPress、aiScroll 等直接执行指定动作,模型只负责比较容易的定位工作,因此更快也更可预测。深度定位则是一个两段式策略:先找到包含目标的区域,再聚焦这个区域重新定位,从而把坐标压得更准。而 aiAssert 与 aiQuery 走的是洞察流程,负责断言与结构化抽取。每一步都会进入报告——截图、元素定位、模型决策过程、动作与断言结果都能回放。
Midscene Test:YAML 声明用例,TypeScript 扩展能力
@midscene/test 是它面向 AI 时代的测试框架,目前标注为 Beta。它的设计哲学是平衡「声明式语义」与「确定性工程」:把测试意图写成声明式的 YAML,把 API 调用、数据准备与清理写进可复用的 TypeScript 节点。官方给的原型是一条退款用例——先通过接口把订单准备好,再通过界面申请退款并验证结果——两条腿各司其职。
这套框架里,人写 YAML 描述业务意图,节点负责确定性的工程动作;midscene-test nodes 会把当前项目注册的官方节点与自定义节点,连同它们的参数校验规则(Zod 模式)一起导出成 Markdown 的节点说明书,让人和编程智能体拿到同一份准确的能力视图,共同维护用例。框架还带项目脚手架、平台预设、生命周期钩子、重试与执行环境隔离。旧的 tasks/flow 声明式路径已经进入维护模式,只保留兼容与必要修复,新项目与新用例走 Midscene Test。
一套接口覆盖 Web、移动端、桌面与自定义界面
同一套智能体接口,在不同平台上换的是接入方式,不是用法。
| 平台 | 接入方式 |
|---|---|
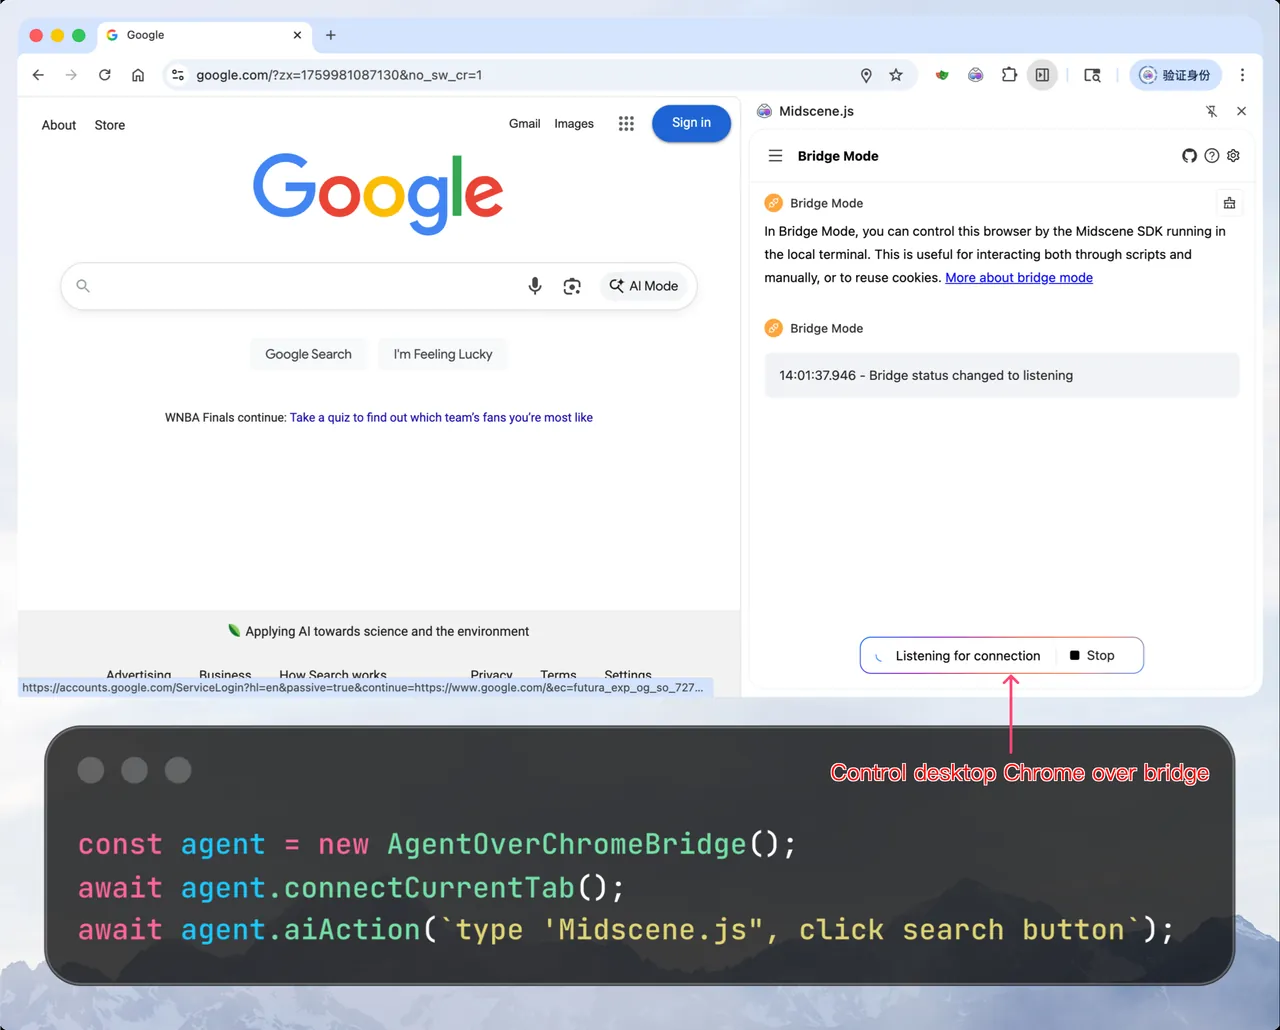
| Web | Playwright、Puppeteer,或通过浏览器桥接控制桌面 Chrome |
| 安卓 | 通过 ADB 连接真机或模拟器 |
| iOS | 通过 WebDriverAgent 连接真机或模拟器 |
| 鸿蒙 | 通过 HDC 连接鸿蒙 NEXT |
| 桌面 | macOS、Windows、Linux,支持远程桌面协议 |
| 自定义界面 | 只要能提供截图与操作能力即可接入 |
它还把能力打包成技能,让 Claude Code、Cline 这类编程智能体通过命令行直接操作界面:浏览器、桌面、安卓、iOS、鸿蒙各一个技能包,智能体自己截图、看界面、决定下一步动作。官方举的例子很能说明定位——让编程智能体写完一个待办应用后,用桌面技能把它启动起来,加上三条待办、勾选一条、删掉一条,再截图确认最终状态正确;开发者在整条链路里只描述意图,技能给了智能体「看见屏幕、移动鼠标」的能力,让它像人一样验证自己的代码。
官方基准与成本
官方给了三组基准,均来自它自己的适配与评测,我们没有复现,这一档记为待复现。
| 基准 | 结果 | 评测配置 |
|---|---|---|
| 安卓世界 | Pass@1 93.10%、Pass@2 95.69%、Pass@3 97.41% | Midscene 1.9.5,gemini-3.5-flash |
| 移动世界 | Pass@1 78.63%(92 / 117) | Midscene 1.10.3,gemini-3.6-flash |
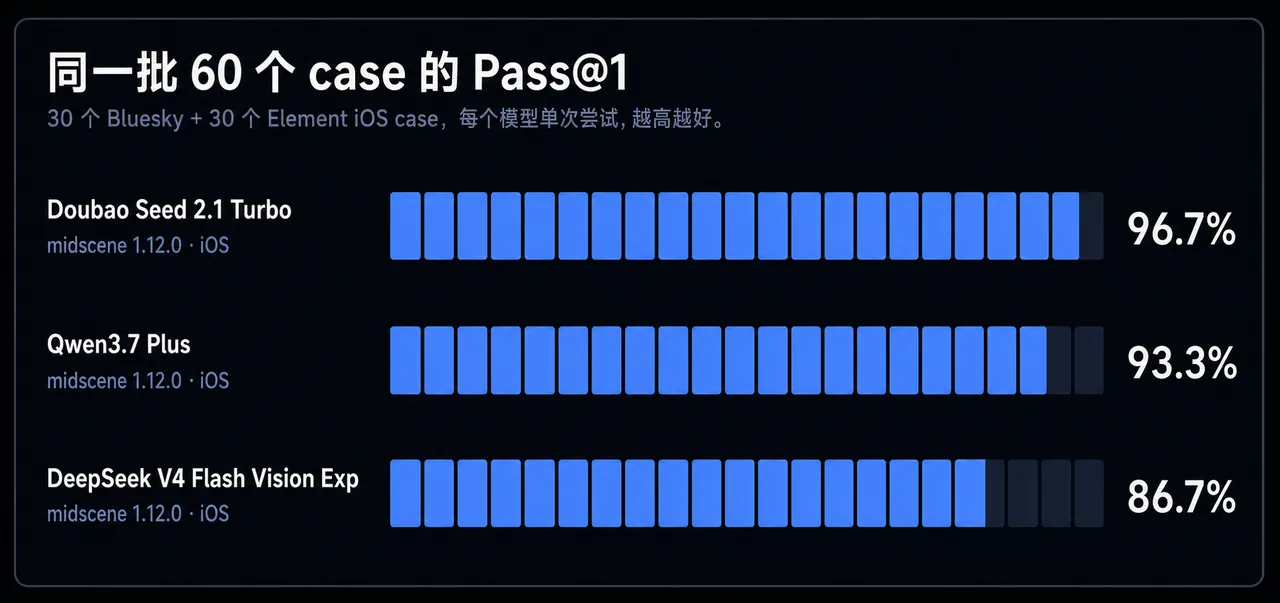
| 应用控制基准 | Pass@1 96.7%(58 / 60) | Midscene 1.12.0,豆包 Seed 2.1 Turbo |
最值得细看的是应用控制基准。它让同一批 60 个真实 iOS 应用任务分别交给多个模型跑,Midscene 搭配豆包 Seed 2.1 Turbo 通过 58 项,模型调用总费用只有 0.59 美元;同批任务里 Qwen3.7 Plus 通过 93.3%,DeepSeek V4 Flash 通过 86.7%。这份报告还诚实交代了对 1 个用例的动作路径做了校准——只去掉一个已经过时的界面入口描述,最终目标状态与判分规则不变。
更关键的一张是成本效率。把「每 1 美元能完成多少用例」折算出来,Midscene 搭配 DeepSeek V4 Flash 约 198.6、Qwen3.7 Plus 约 100、豆包 Seed 2.1 Turbo 约 99,而同批任务下对照的基线方案只有 26.1 与 18.0。差距的来源不是模型更聪明,而是成本结构:纯视觉方案不把臃肿的文档树发给模型,令牌只随截图分辨率与任务复杂度变化,页面元素再多也不会把账单顶上去。
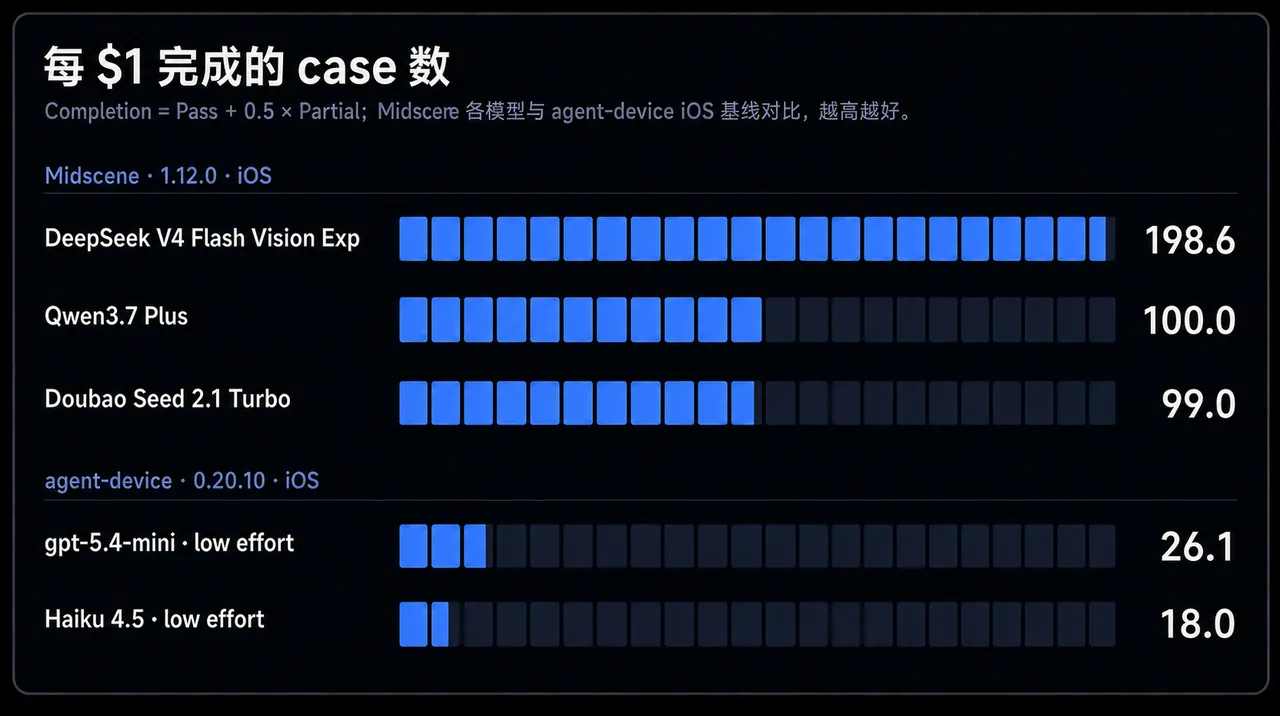
读这些数字要带着两层前提:全是官方自己适配与发布的评测,且报告中明确存在环境与校验器的调整。把它们当作「这条路线的成本结构有多划算」的证据是成立的,当作「绝对能力已经到位」的结论则不足——真正的能力水位,仍以实际业务场景的复现为准。
它诚实划出的边界
官方没有回避这套路线的软肋。第一,纯视觉定位对模型有硬门槛,必须用稳定的界面视觉定位模型,不能用任意大模型,选型余地因此被压缩。第二,复杂任务本身就更慢、更贵,而每叠加一个规划或洞察模型,延迟与令牌消耗都会进一步上涨。第三,Midscene Test 仍是 Beta,协议与接口还会变,旧路径只保留兼容。
更实用的一段经验写在「把应用知识交给智能体」那篇文档里:纯靠截图,模型会卡在那些「看不见的知识」上——某个功能的入口藏在哪一层菜单、某个滑块支持点刻度而不只是拖动、调整完价格还得再点一次才生效。它的解法不是把固定坐标写死,而是把导航路径、交互规则与业务含义作为上下文喂给智能体。文档同时列出三条反模式:别只给一句模糊的目标,别用固定坐标和像素距离描述动作,也别把整个知识库塞进每个用例——不该出现在提示里的信息越多,真正需要的信息越容易被淹没。
它在本板块里的位置
把 Midscene 放回智能体运行时这条线上,它补的是「智能体与图形界面之间」那一层:统一的任务执行与重规划、明确的模型角色分工、跨平台的动作与查询接口、以及可回放、可交给智能体自己排查的执行记录。它不是编程智能体,不生成也不修改代码;它让智能体看得见界面、动得了手,并把这件容易变成一次性脚本的事,沉淀成可以长期维护的测试资产。
待复现
我们未对 Midscene 做过任何基准或复现测试,上述性能与成本数字全部引自官方仓库、官网文档与官方基准报告。仓库的活跃度、跨平台覆盖面与文档完整度,说明它是界面智能体这条工具链上值得收录的一层;能力水位仍记为待复现,应以实际业务场景的端到端验证为准。