PAPER DEEP DIVE
Terminal-RSI:递归自改进终端智能体
递归自重写验证轨迹并继承评论家做策略精炼,配 TB-GAE 与成功优先奖励,27B 模型 Terminal-Bench 4.0 达 19.84%。
原文标题:Terminal-RSI: Recursive Self-Improving Terminal Agents via Recursive Self-Rewrite and Policy-Refine
作者:Junyao Yang、Zongxia Li、Yucheng Shi、Zhongzhi Li、Ruhan Wang、Ruiwen Zhou、Haitao Mi、Shuicheng Yan、Leowei Liang
论文链接:https://arxiv.org/abs/2610.22192(arXiv:2610.22192v1 [cs.AI],2026 年 10 月 15 日)
项目主页:https://jyyang26.github.io/terminal-rsi/
代码状态:已宣布、尚未公开。论文页挂出 GitHub 与 Hugging Face 图标,但仓库 jyyang26/Terminal-RSI 在本文撰写时返回 404,项目主页目前只链接回 arXiv 论文;因此本解读的方法—源码对应以论文正文与附录为准。
一句话总结
本文让终端智能体递归地改写自己:交替执行只更新 actor 的递归自重写(RSR)与继承评论家权重的递归策略精炼(RPR),配回合边界信用分配 TB-GAE 与成功优先奖励 SPR,使 27B 模型在四个 Terminal-Bench 套件上的等权平均成功率从 20.68% 升到 50.58%。
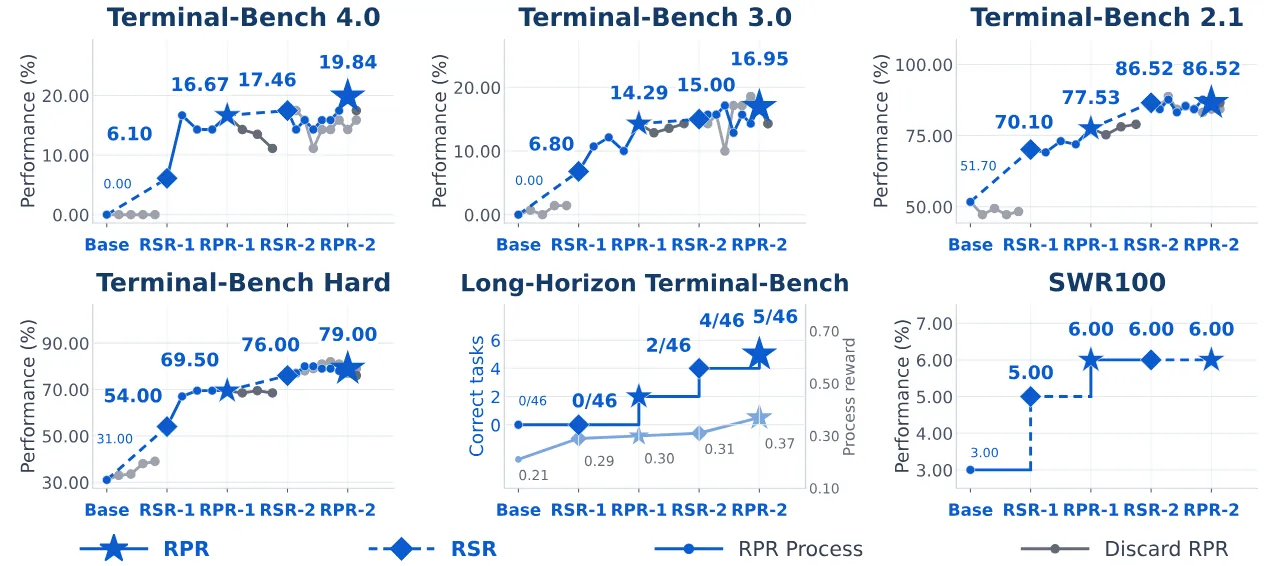
图 1:论文 Figure 1 的总览图。递归循环把评论家权重带过监督迁移:蓝色块区分只更新 actor 的 RSR 与联合更新 actor-critic 的 RPR,旁路保留评论家,反馈把保留策略送回下一周期。
研究背景与动机
终端智能体与聊天型智能体的根本差别在于评测对象:它被评判的依据是对可执行环境造成的持久改变,而不是回答是否听起来合理。SWE-bench、Terminal-Bench 一类基准要求仓库检查、依赖修复与恢复动作最终汇聚成一个能通过受保护验证器的状态;Long-Horizon-Terminal-Bench(LHTB)进一步把挑战拉长到长依赖链,使得大量局部进展未必能产出任何一个完整解。于是学习必须同时完成两件事:把成功的探索连接到可复现的执行,把延迟到来的验证信号连接到使它成为可能的决策。论文开篇的判断很冷:流利的计划、或者不断累加的局部检查通过数,单独都闭不上这个循环。
第一个障碍是时间尺度的错配。token 生成的时钟与环境变化的时钟不是同一个:几百个 token 可能只表达一条 shell 动作,而上千个观测 token 不引入任何新的策略决策。当 GAE 沿交错 token 链回溯时,重复的折扣与迹因子会按文本长度而非因果交互衰减远处信用;把观测从策略损失里 mask 掉并不能移除它们在递归里的节点位置。后果是两条决策相同、终端结果相同的执行,可能因为其中一条日志更冗长而拿到不同信用。长上下文还促使人们做 chunking 与摘要,但论文强调这两者性质不同:切分一条未改变的链允许精确的边界传输,摘要却改变了条件历史,可能删掉后续决策需要的细节。
第二个障碍是递归监督下的价值漂移。仓库锚定轨迹、环境反演与任务合成都在扩大可执行监督的来源;Recursive Self-Rewrite(RSR)通过 runbook 规划、泄漏审查与全新的公开执行,把跨 harness 的发现迁移进来。但改写会改变 actor 偏好哪些动作,从而改变它的评论家会遇到哪些历史;随后的强化学习再次改变这些分布;奖励再校准还改变了被预测的回报本身。重置评论家会丢弃已学到的结果结构,不校准就直接迁移则可能保留系统性预测误差。这些误差会进入 token 优势与价值自举,因此一个更强的 actor 并不会自动为它的新历史、新奖励与新执行 horizon 提供可靠的值。
第三个障碍来自奖励对齐。终端任务族暴露的语义检查数量各不相同,而一条失败轨迹可以在不满足完整执行契约的情况下累积大量通过的检查。单一全局尺度会过度强调验证器庞大的族;纯比例的进度奖励则在策略已经有能力取得严格成功之后,继续奖励不完整行为。论文的固定轨迹分析把这一区分量化了:在旧奖励下,失败轨迹拿到总奖励质量的 50.09%,其中 48 条失败通过了所有已执行的场景检查、却错过了终端门。目标不是消灭部分信用(它支撑探索),而是让部分信用随着训练推进从属于已验证的完成。
针对这三条,论文给出 Terminal-RSI:交替执行只更新 actor 的 RSR 与继承评论家的 Recursive Policy-Refine(RPR)。从 RSR-1 的 actor 与一个 Warm-up Critic Model 出发,RPR 把阶段内价值校准、奖励演化与第二周期 actor 学习率五倍下调协调在一起。作者明确不宣称独立发明 T1 终端基础设施、PPO、GAE 或价值预热这些原语,研究的焦点是它们的递归耦合:监督迁移保留评论家权重,每个新的策略精炼阶段在联合优化之前先适配继承来的值。
预备知识:交互契约、验证重写与信用分配记号
设 $x\sim\mathcal{D}$ 指定任务、沙箱与受保护验证器,公开指令为 $x_{\rm pub}$。给定历史 $h_{t}=(x_{\rm pub},o_{0},a_{0},\ldots,o_{t})$,actor 采样 $a_{t}\sim\pi_{\theta}(\cdot\mid h_{t})$,环境返回 $o_{t+1}$。$T$ 个回合的轨迹分布分解为 actor 决策与环境转移两部分:
$$P_{\theta}(\tau\mid x)=P(o_{0}\mid x)\prod_{t=0}^{T-1}\pi_{\theta}(a_{t}\mid h_{t})P(o_{t+1}\mid h_{t},a_{t}) \qquad (1)$$
严格成功 $S\in\{0,1\}$ 要求完整的受保护验证器通过,而不是智能体的自我声明、也不是部分检查的通过集合。论文沿用 T1 的 Token-In、Token-Out 契约以保留采样输出 token 的身份,并把观测从直接策略损失中 mask;但重建的历史在条件上仍可能不同。验证重写环节只保留满足 $\mathcal{V}_{x}(\tau)=1$ 的发现 $(x,\tau,H)$:规划器接收 $p_{\rm plan}=I_{\rm plan}\oplus x_{\rm pub}\oplus\mathcal{C}(\tau)$,其中 $\mathcal{C}$ 去除 harness 控制消息;只看公开任务与 runbook 的审查器施加 schema、产物与兼容性门 $q(x,b)$;新执行 $E_{k}(x,b)$ 由保留 actor 在目标 harness 下完成,接受判据 $a_{x}(\tau)=\mathcal{V}_{x}(\tau)q_{\rm leak}(\tau)$ 同时含验证与泄漏筛查。被接受的重放集合与只更新 actor 的监督损失为
$$Q_{k}^{\rm clean}=\operatorname{Unif}\{\mathcal{P}(\widetilde{\tau}_{\ell m}):a_{x}(\widetilde{\tau}_{\ell m})=1\},\quad \mathcal{L}_{\rm RSR}(\theta)=-\mathbb{E}_{Q_{k}^{\rm clean}}\sum_{j}m_{j}\log\pi_{\theta}(y_{j}\mid h_{j}) \qquad (2,3)$$
其中 $\mathcal{P}$ 去除私有 runbook 与审查对话,均匀采样保留被接受多重集的重复度,$m_{j}\in\{0,1\}$ 只选中公开前缀上的生成决策,评论家权重保持不动。参考 RSR 分析使用 $K=M=4$,并不必然等于本文每次运行的取值。信用分配一侧,标准 GAE 写作 $\delta_{i}=r_{i}+\gamma(1-d_{i})V_{i+1}-V_{i}$ 与 $A_{i}=\delta_{i}+\gamma\lambda(1-d_{i})A_{i+1}$;观测节点即使损失被 mask,仍会引入没有策略决策的衰减,这正是 Skip-Observation 与本文 TB-GAE 要处理的对象。
方法详解
参数交接:评论家权重在 RSR 期间一个字节都不动
递归循环的参数交接是全文最硬的一条设计约束。保留参数 $(\theta_{k}^{+},\phi_{k}^{+})$ 初始化下一轮重写与评论家校准,且在价值更新期间保持 actor 冻结:
$$(\theta_{k+1}^{0},\phi_{k+1}^{0})=(\operatorname{RSR}(\theta_{k}^{+},Q_{k}^{\rm clean}),\ \phi_{k}^{+}),\quad \phi_{k+1}^{\rm warm}=\operatorname{Warmup}_{4}(\phi_{k+1}^{0};\ \theta_{k+1}^{0}\ \text{fixed}) \qquad (4)$$
于是 $\Delta\phi|_{\rm RSR}=0$:RSR 阶段评论家完全不更新。Warm-up Critic Model $\phi_{\rm seed}$ 由一个 SWR epoch、RSR-1 actor 冻结训练得到,为 RPR-1 做准备;RPR-2 则经由只更新 actor 的 RSR-2 继承保留的 RPR-1 评论家。每个 RPR 阶段在联合更新之前,用冻结的 actor 对评论家做四次 critic-only 校准更新;这四次更新与初始的整轮 epoch 职责不同:前者是阶段内的再校准,后者是初始值网络的准备。权重迁移保留已学到的回报结构,但不假设它在策略与奖励改变之后仍然校准。
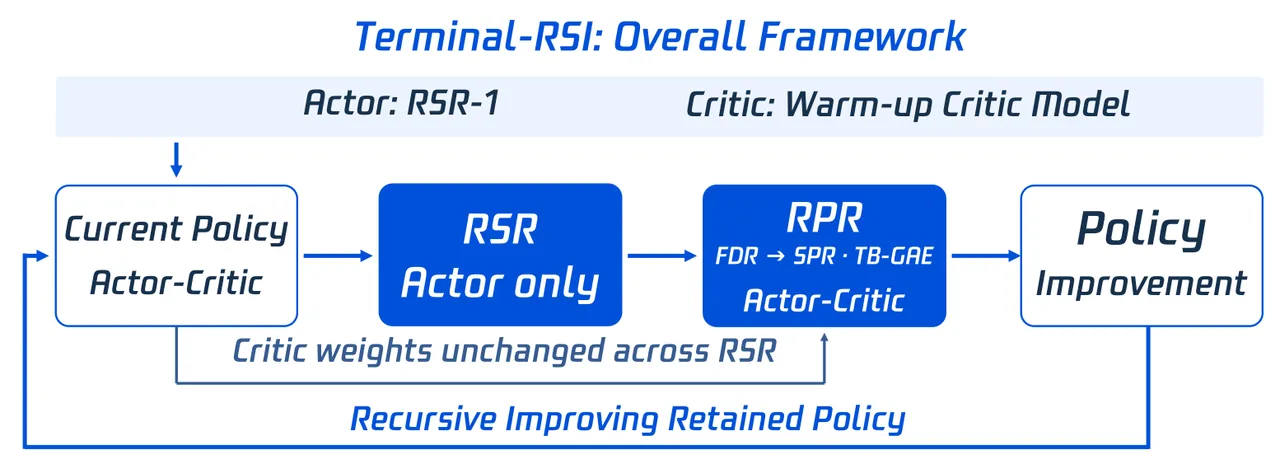
图 2:论文 Figure 2 的递归总框架。起点是 RSR-1 的 actor 与 Warm-up Critic Model;RSR 只更新 actor,RPR 联合更新 actor-critic 并使用 FDR 到 SPR 的奖励演化与 TB-GAE;评论家权重在 RSR 期间不变,保留策略反馈回下一周期。
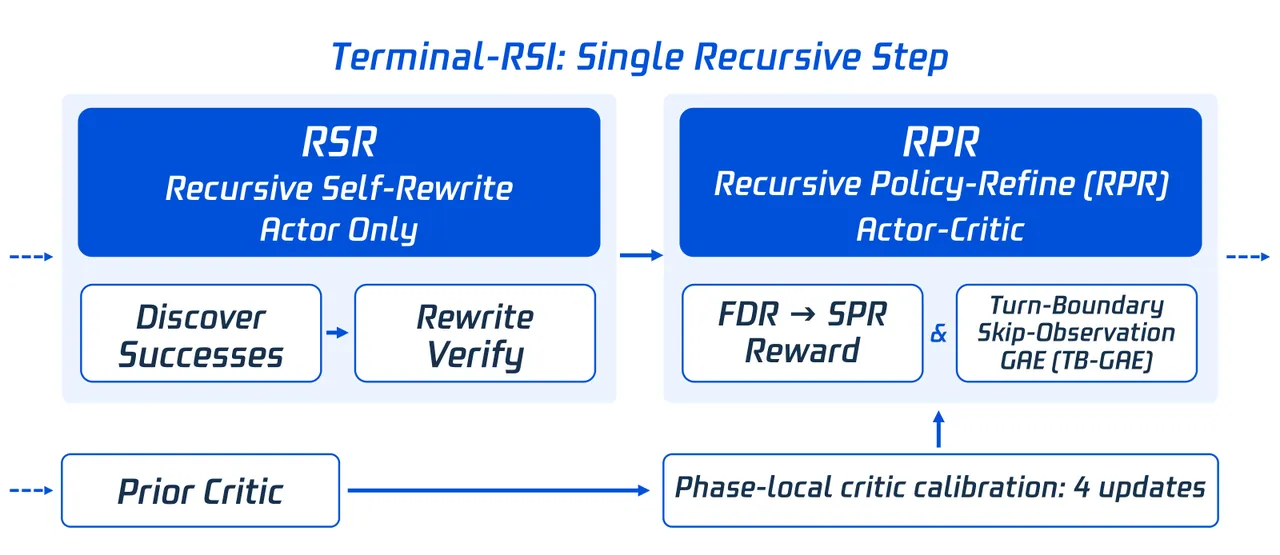
图 3:论文 Figure 3 的单步递归。左支发现成功、重写并验证 actor 演示;右支 RPR 组合继承值、奖励校准与 TB-GAE;阶段内评论家校准是联合训练前的四次 critic-only 更新,而不是每个 PPO minibatch 之前都做。
阶段值函数:回报依赖当前 actor 与当前奖励
对阶段 $k$ 的生成位置 $u_{j}$,论文定义依赖 actor 与奖励的值函数
$$V_{k}^{\pi}(h_{u_{j}})=\mathbb{E}_{\pi_{\theta_{k}}}\!\left[\sum_{q=j}^{L-1}\left(\prod_{i=j}^{q-1}\Gamma_{i}(1-d_{i})\right)\widetilde{r}_{q}^{(k)}\ \middle|\ h_{u_{j}}\right] \qquad (5)$$
其中 $L$ 统计生成 token 数,与交互回合数 $T$、执行重复数 $M$ 是三个不同的量;$\Gamma_{i}$、终止指示 $d_{i}$ 与回合映射 $t(j)$ 由 TB-GAE 给出,奖励模块提供 $\widetilde{r}^{(k)}$,TB-GAE 为联合 PPO 更新提供优势与目标。把值函数显式写成阶段上标,是为了承认一个事实:每次 actor 迁移与每次奖励再校准都重新定义了被预测的对象。
奖励演化:从族校准到成功优先
记 $P\geq 0$ 为通过的非 hygiene 检查数,$S\in\{0,1\}$ 为严格终端成功,$f$ 为任务族。Family Dense Reward 用族内历史分位数归一化进度,$D_{f}=q_{0.90}(N\mid f)>0$ 为总非 hygiene 校准检查数 $N$ 的 0.90 分位数,未覆盖族的回退值为 82:
$$R_{\rm FDR}=\begin{cases}\max\!\left(P/D_{f},\ 0.00\right) & \text{验证报告有效}\\ S & \text{否则}\end{cases} \qquad (6)$$
除数在阶段内冻结。对有效评分,下界在 $P\geq 0$ 下是冗余的;FDR 的边际信用恒为 $1/D_{f}$,没有单独的完成奖励,也没有跨检查数的统一上界。附录 B 给出 FDR 除数从 1 到 795 的分布与七类被排除的 hygiene 检查。
Success-Prioritized Reward 的动机来自 4,352 条被审计轨迹:失败拿到 FDR 奖励质量的 50.09%,158 条失败得分至少为 1,48 条通过所有已执行场景检查却在终端门失败。SPR 把严格成功与有界部分信用分开:
$$R_{\rm SPR}=\begin{cases}S+\dfrac{P}{P+D^{\prime}_{f}} & \text{验证报告有效}\\ S & \text{否则}\end{cases},\quad D^{\prime}_{f}>0 \qquad (7)$$
离线再校准对高失败奖励族把除数加倍、对长而低回报的族把除数减为四分之一,且失败抑制优先于部分信用的保留;得到的查表在阶段内冻结,不引入按 batch 的归一化,也不奖励当前轨迹长度。进度项 $g_{f}(P)=P/(P+D^{\prime}_{f})$ 满足 $g^{\prime}_{f}(P)=D^{\prime}_{f}/(P+D^{\prime}_{f})^{2}>0$ 与 $g^{\prime\prime}_{f}(P)=-2D^{\prime}_{f}/(P+D^{\prime}_{f})^{3}<0$:每条失败得分低于 1、每条成功至少 1,在计数、族与报告有效性匹配时成功恰好比失败多一个单位。论文同时划清边界:不存在统一正边际,也不等价于最大化成功概率或潜在基策略不变性;$0\leq R_{\rm SPR}<2$ 只意味着奖励方差至多为 1,不意味着梯度方差更低或收敛。
TB-GAE:把折扣时钟从 token 换到回合
TB-GAE 把生成位置 $u_{j}$ 与 pre-token 值 $v_{j}=V(h_{u_{j}})$、回合编号 $t(j)$、因果分配的奖励 $\tilde{r}_{j}$ 连接起来;观测条件化值函数,但不再是递归节点。回合边界时钟定义为
$$(\Gamma_{j},\Lambda_{j})=\begin{cases}(1,1) & t(j+1)=t(j)\\ (\gamma_{\rm turn},\lambda_{\rm turn}) & t(j+1)\neq t(j)\end{cases} \qquad (8)$$
其中 $0\leq\gamma_{\rm turn},\lambda_{\rm turn}\leq 1$,$d_{j}$ 标记真实终止,$w_{j}=\Gamma_{j}\Lambda_{j}(1-d_{j})$。终止时使用零后继值与零迹,且不再查询不存在的回合。递归式为
$$\delta_{j}^{\rm TB}=\tilde{r}_{j}+\Gamma_{j}(1-d_{j})v_{j+1}-v_{j},\quad A_{j}^{\rm TB}=\delta_{j}^{\rm TB}+w_{j}A_{j+1}^{\rm TB} \qquad (9)$$
取目标 $\widehat{G}_{j}=A_{j}^{\rm TB}+v_{j}$、权重 $W_{j,k}=\prod_{i=j}^{k-1}w_{i}$(空积为 1)、终端 $v_{L}=A_{L}=0$,可展开为
$$A_{j}^{\rm TB}=\sum_{k=j}^{L-1}W_{j,k}\,\delta_{k}^{\rm TB} \qquad (10)$$
跨过 $B$ 个回合边界时,固定保留输入下的衰减为 $(\gamma_{\rm turn}\lambda_{\rm turn})^{B}$,与观测长度或回合内 token 数无关。换时钟移除了由文本长度驱动的衰减,但同时也改变了被优化的折扣目标,论文没有把这一步说成无代价。
稀疏反馈下的前缀敏感性被单独刻画:若回合 $t$ 的奖励 $r_{t}$ 只落在该回合最后一个生成 token 上,$n$ 为下一回合起点,$d_{t}$ 标记当前回合终止,则回合内 telescoping 给出
$$U_{t}=r_{t}+\gamma_{\rm turn}(1-d_{t})(v_{n}+\lambda_{\rm turn}A_{n}),\quad A_{j}=U_{t}-v_{j},\quad \widehat{G}_{j}=U_{t} \qquad (11)$$
共享同一个回报,但不同的 $v_{j}$ 仍给出前缀特定的优势;终端后继项消失,每个奖励只出现一次。当所有时钟为 1 时,完整 episode 上 $A_{j}=\sum_{q=j}^{L-1}\tilde{r}_{q}-v_{j}$,与标准 GAE 的一致需要输入、值、奖励位置与端点全部对齐。跨 chunk 的精确续传也有明确代价:保留价值自举但在 $b$ 处重置迹,会丢掉 $A_{j}^{\rm full}-A_{j}^{\rm cut}=W_{j,b+1}A_{b+1}^{\rm full}$;精确续传需要同时携带 $v_{b+1}$ 与 $A_{b+1}$,或做一次不分割的反向扫描。任务定义的终端预算才设 $d=1$,采样截断与计算分区不自动终止任务;摘要改变条件历史,因此单靠状态传输不能建立跨摘要的固定输入等价。
评论家误差如何进入优势也被显式推导。对完整终端 episode,记 $e_{j}=v_{j}-v_{j}^{\pi}$、$B_{j,k}=W_{j,k-1}\Gamma_{k-1}(1-d_{k-1})$,则
$$\Delta A_{j}=-e_{j}+\sum_{k=j+1}^{L-1}B_{j,k}(1-\Lambda_{k-1})e_{k} \qquad (13)$$
观测自举项不存在,回合内的中间误差相互抵消,而 $-e_{j}$ 保留;在固定保留链权重下 $\operatorname{Var}(A_{j})=\bm{W}_{j}^{\top}\Sigma_{\delta}\bm{W}_{j}$。边界校准与残差协方差共同排除了无条件方差排序的结论;只有当所有 $\Lambda_{i}=1$ 时,剩下的才只是局部评论家误差。这条推导直接支撑了「准备 + 再校准」的评论家协议:误差不是噪声,而是会按结构注入优势的偏置。
RPR 联合优化与两处诚实的范围声明
RPR-1 用训练侧旧 actor 重算 $\pi_{\rm old}$;论文提醒 pipeline 滞后并不能识别 rollout 的行为策略版本,策略漂移与训练—推理实现差异是两回事。记 $y_{j}$ 为保留位置 $u_{j}$ 上的 token,$v_{j}$、$A_{j}$、$\widehat{G}_{j}$ 为更新前 detach 的量,$\rho_{j}=\pi_{\theta}(y_{j}\mid h_{u_{j}})/\pi_{\rm old}(y_{j}\mid h_{u_{j}})$,batch 内按样本等权(而非按 token 等权)聚合,则
$$\mathcal{L}_{\pi}=-\mathbb{E}_{j}\min\{\rho_{j}A_{j},\ \operatorname{clip}(\rho_{j},1-\epsilon_{\ell},1+\epsilon_{h})A_{j}\},\quad \mathcal{L}_{V}=\mathbb{E}_{j}\max\{(V_{\phi}(h_{u_{j}})-\widehat{G}_{j})^{2},\ (\bar{V}_{j}-\widehat{G}_{j})^{2}\} \qquad (14)$$
其中 $\bar{V}_{j}=v_{j}+\operatorname{clip}(V_{\phi}(h_{u_{j}})-v_{j},-\epsilon_{V},\epsilon_{V})$,两个阶段均取 $\epsilon_{V}=4.00$;策略裁剪取 $\epsilon_{\ell}=0.30$、$\epsilon_{h}=5.00$,对应代理阈值 0.70 与 6.00;不使用 KL 与熵项,两个系数都是 0.00。作者同样指出:裁剪与小学习率都不能给每个实际出现的比率加上界。
范围声明有两处值得单独记住。其一,记录在案的第一阶段使用标准 GAE($\gamma=\lambda=1$);unit-clock 等价性既不证明 TB-GAE 已被部署,也不构成隔离的在线增益。其二,Long-Reward 分支使用 SPR,而固定轨迹重打分隔离的是奖励的分配方式,不是奖励、评论家或优化器改变带来的训练效应。这两条声明让论文的贡献边界比多数同类工作清楚得多。
flowchart TD
  BASE["Base Qwen3.8-27B actor-critic"] --> RSR1["RSR-1 verified rewrite
actor only, critic frozen"]
  RSR1 --> WARM["Warm-up Critic Model
1 SWR epoch, actor frozen"]
  WARM --> CAL1["RPR-1 phase-local calibration
4 critic-only updates, actor frozen"]
  CAL1 --> RPR1["RPR-1 joint PPO
FDR reward + TB-GAE advantages"]
  RPR1 --> RSR2["RSR-2 verified rewrite
actor only, critic inherited unchanged"]
  RSR2 --> CAL2["RPR-2 phase-local calibration
4 critic-only updates, actor frozen"]
  CAL2 --> RPR2["RPR-2 joint PPO, actor LR cut 5x
SPR Long-Reward branch + TB-GAE"]
  RPR2 --> FINAL["Terminal-RSI-27B retained checkpoint"]
  RSR1 -. "critic weights bypass RSR" .-> CAL1
  RPR1 -. "retained RPR-1 critic" .-> CAL2
  FINAL -. "retained policy feeds next cycle" .-> RSR1
图 4:按论文 Section 2 与 Table 1 绘制的五阶段递归流程。虚线表示评论家权重的旁路继承:RSR 不碰评论家,RPR 先做四次 critic-only 校准再联合优化。
实验结果
训练与评测配置
Terminal-RSI 实例化在 Qwen3.8-27B 上,模型上下文容量 262,144 token,采用 T1 的 slime 协调、Megatron 优化、SGLang 采样与 Harbor 执行;rollout 与优化以「提前一个 rollout batch」的流水线重叠,对应 step-wise off-policy 程度为 1。训练池为 3,000 个任务(2,400 个语义验证器任务加 600 个补充终端任务),SWR100 与该池无任务重叠。两个优化阶段的全局 batch 为 256、过采样到 288 个请求、每任务采样一条响应;为容纳 256k 序列容量,使用 Megatron 3D 并行加 degree 4 的上下文并行,每 GPU token 预算 8,192、log-prob chunk 1,024。评测协议为每个保留阶段检查点在每套基准上独立跑三次取算术平均(Mean@3),采样温度 0.60、top-p 0.95,每回合至多 8,192 输出 token、每次调用 96,000 输入 token,累计 32,000 token 触发主动摘要;LHTB 报告平均过程奖励与严格 1.00 分下的完成数,而非 0.95 的接近完成阈值。
| 配置项 | RPR-1 | RPR-2 |
|---|---|---|
| 初始 actor | RSR-1 | RSR-2 |
| 初始评论家 | Warm-up Critic Model | 保留的 RPR-1 评论家 |
| 奖励 | FDR | SPR(Long-Reward 分支;普通分支用 FDR) |
| actor 学习率 | 5e-7 | 1e-7(五倍下调) |
| 评论家学习率 | 1.5e-5 | 1.5e-5 |
| critic-only 校准 | 4 次更新 | 4 次更新 |
| 值裁剪 / 评论家梯度裁剪 | 4.00 / 100.00 | 4.00 / 100.00 |
| 保留的局部优化步数 | 20 | 18 |
表 1:论文 Table 1 的阶段自适应配置。精炼阶段调整策略更新尺度,但保持评论家学习尺度不变;第二周期把 actor 学习率下调五倍,让继承的评论家在校准时不被 actor 的剧烈变化打扰。
主结果:五个保留阶段、六套基准
Table 2 的每个保留阶段在 Terminal-Bench 4.0、2.1、3.0 与 Hard 四套基准上共用同一个检查点。RPR-1 相对 RSR-1 在四套上分别提升 10.57、7.43、7.49、15.50 个百分点;RSR-2 再加 0.79、8.99、0.71、6.50 个百分点;最终检查点 Terminal-RSI-27B 取得 19.84%、86.52%、16.95%、79.00%。四套件等权平均成功率沿五个阶段走 20.68%、34.25%、44.50%、48.75%、50.58%,失败补集从 Base 的 79.33% 降到 49.42%(按未舍入分数计算,相对初始失败下降 37.70% 与 24.83%)。与历史 Direct PPO 对照相比,RPR-1 在局部第 20 步于 Terminal-Bench 2.1、3.0、4.0、Hard 上高出 29.22、12.86、16.67、30.50 个百分点,而 Direct PPO 在第 5、10、15、20 步的 Terminal-Bench 4.0 上没有任何成功;作者同时声明重写带来发现与监督成本,局部步数对齐不等于算力对齐。
| 检查点 | TB 4.0 | TB 2.1 | TB 3.0 | TB Hard | LHTB 过程奖励 | SWR100 |
|---|---|---|---|---|---|---|
| Base | 0.00 | 51.70 | 0.00 | 31.00 | 0.21 | 3.00 |
| PPO(历史协议) | 0.00 | 48.31 | 1.43 | 39.00 | – | – |
| RSR-1 | 6.10 | 70.10 | 6.80 | 54.00 | 0.29 | 5.00 |
| RPR-1 | 16.67 | 77.53 | 14.29 | 69.50 | 0.30 | 6.00 |
| RSR-2 | 17.46 | 86.52 | 15.00 | 76.00 | 0.31 | 6.00 |
| Terminal-RSI-27B | 19.84 | 86.52 | 16.95 | 79.00 | 0.37 | 6.00 |
表 2:论文 Table 2 的保留阶段成绩(Mean@3,%;LHTB 为平均过程奖励)。PPO 行是按附录 E 历史协议得到的独立聚合,不与保留阶段共用检查点协议。
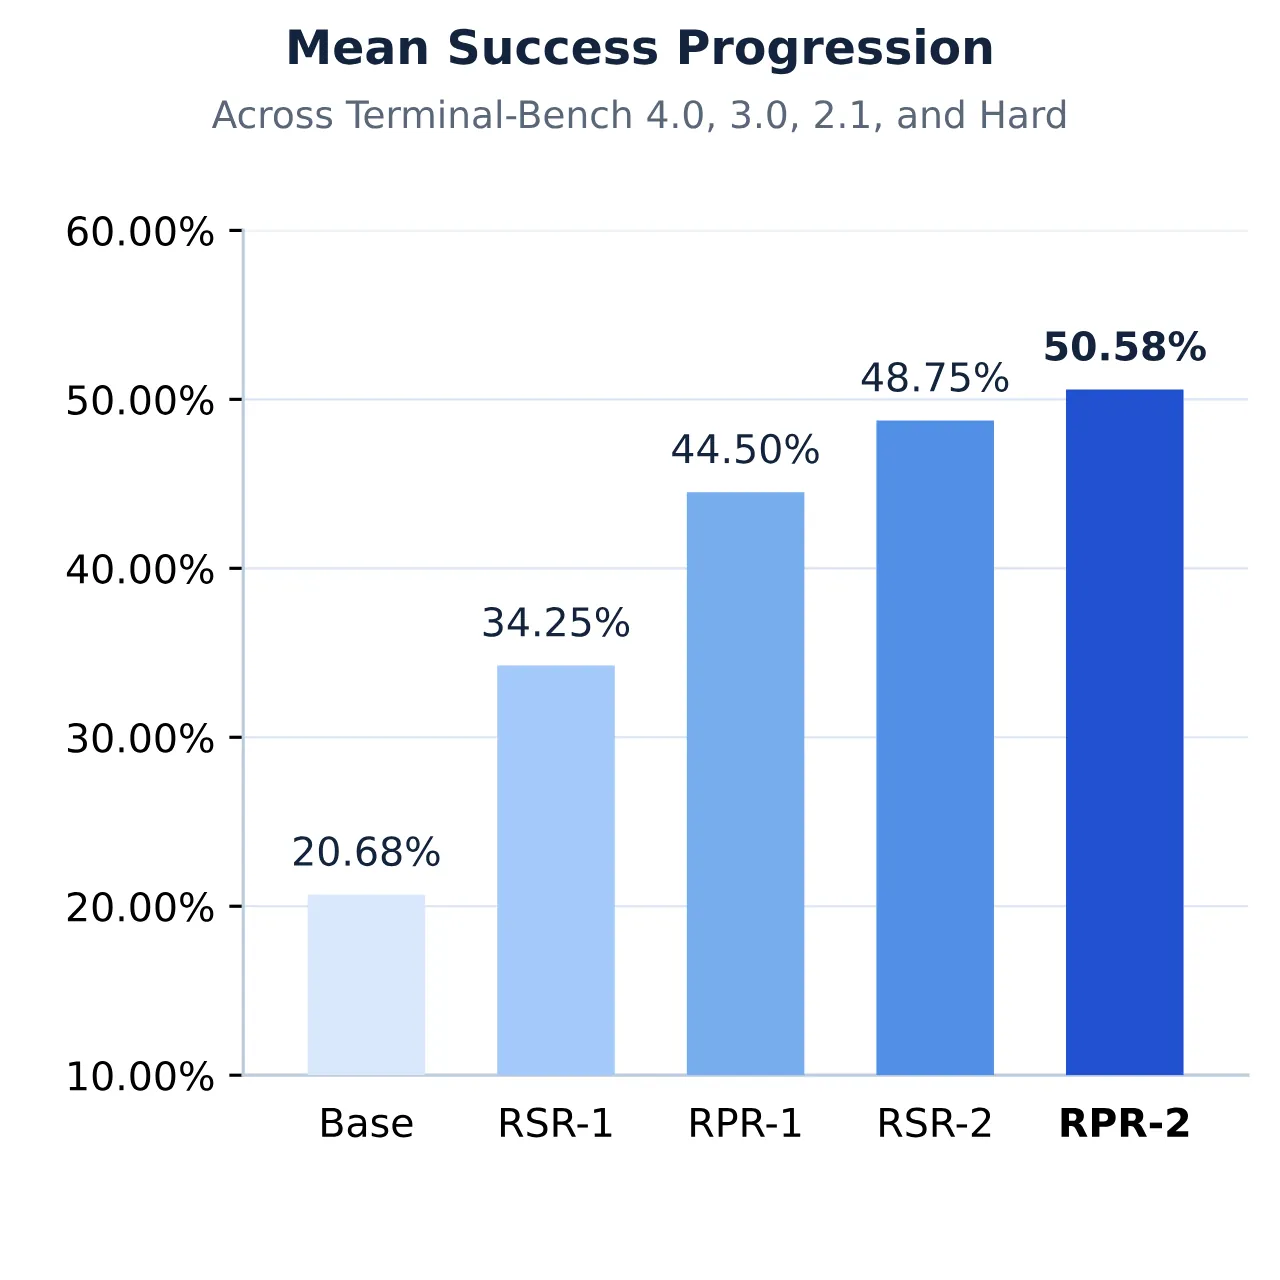
图 5:论文 Figure 5 的四套件等权平均成功率推进,从 20.68% 到 50.58%,纵轴范围 10.00%–60.00%。
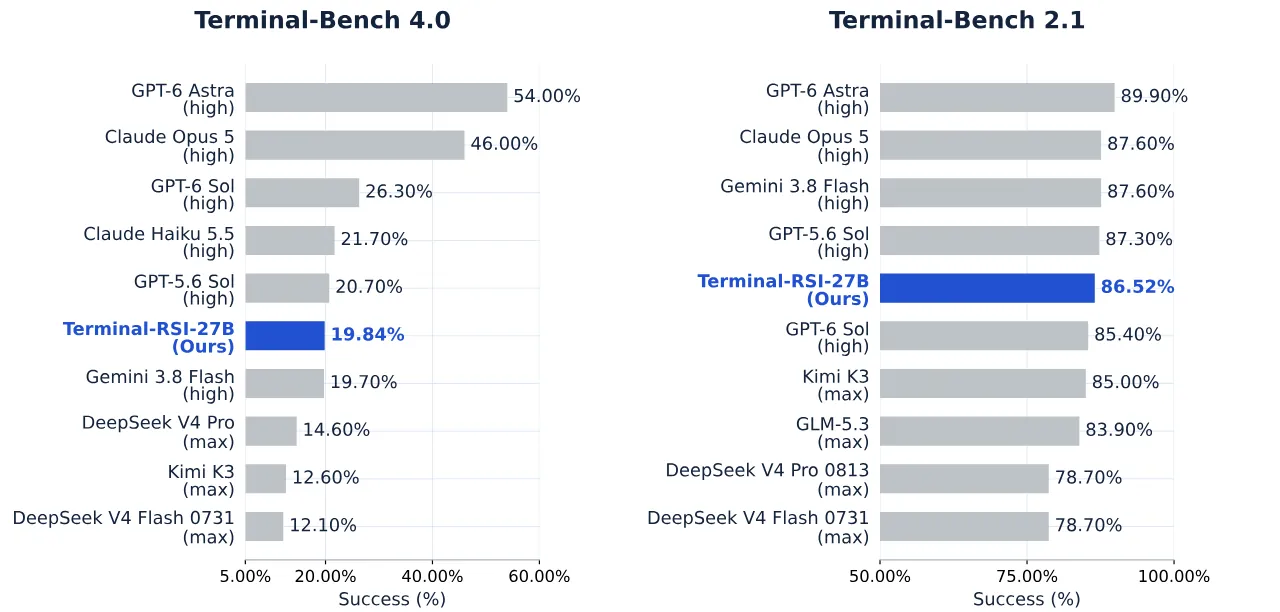
图 6:论文 Figure 4 的前沿模型对比。Terminal-Bench 4.0 上 Terminal-RSI-27B 的 19.84% 对 Gemini 3.8 Flash 的 19.70% 与 DeepSeek V4 Pro 的 14.60%;Terminal-Bench 2.1 上 86.52% 对 GPT-6 Sol 的 85.40% 与 Kimi K3 的 85.00%。论文自己标注:该对比是基准特定的,GPT-6 Sol 在 4.0 上更高、Gemini 3.8 Flash 在 2.1 上更高,且外部分数的一手来源与协议对齐尚未完成。
训练动态:评论家解释方差与分支的非单调性
解释方差定义为 $\mathrm{EV}=1-\operatorname{Var}(G-V_{\phi})/\operatorname{Var}(G)$,与平方相关系数不是一回事。Figure 9 含 18 个 Warm-Up、17 个 RPR-1、16 个 RPR-2 观测:Warm-Up 从 −1.15 升到 0.01;RPR-1 从 0.03 起步、峰值 0.33、终点 0.27,中间有一次 −0.04 的瞬态;RPR-2 的全部 16 个观测保持为正(0.01–0.52),说明继承的评论家在第二阶段持续提供正向校准。记录到的 step-19 端点与保留的 step-18 评测检查点是两回事。分支层面则并不单调:保留 RPR-1 在第 20 步之后,Terminal-Bench 4.0 从 16.67% 掉到第 35 步的 11.11%,而 2.1 升到 78.95%;普通 FDR 的 RPR-2 从第 6 步的 17.46% 掉到第 10 步的 11.11%;保留的 SPR Long-Reward 检查点反而到 19.84%,比它自己的第 6 步高 5.55 个百分点,但继续训到第 20 步又在 3.0、4.0、Hard 上丢 2.66、2.38、3.00 个百分点。论文据此主张跨套件严格成功监控优先于只看奖励曲线。
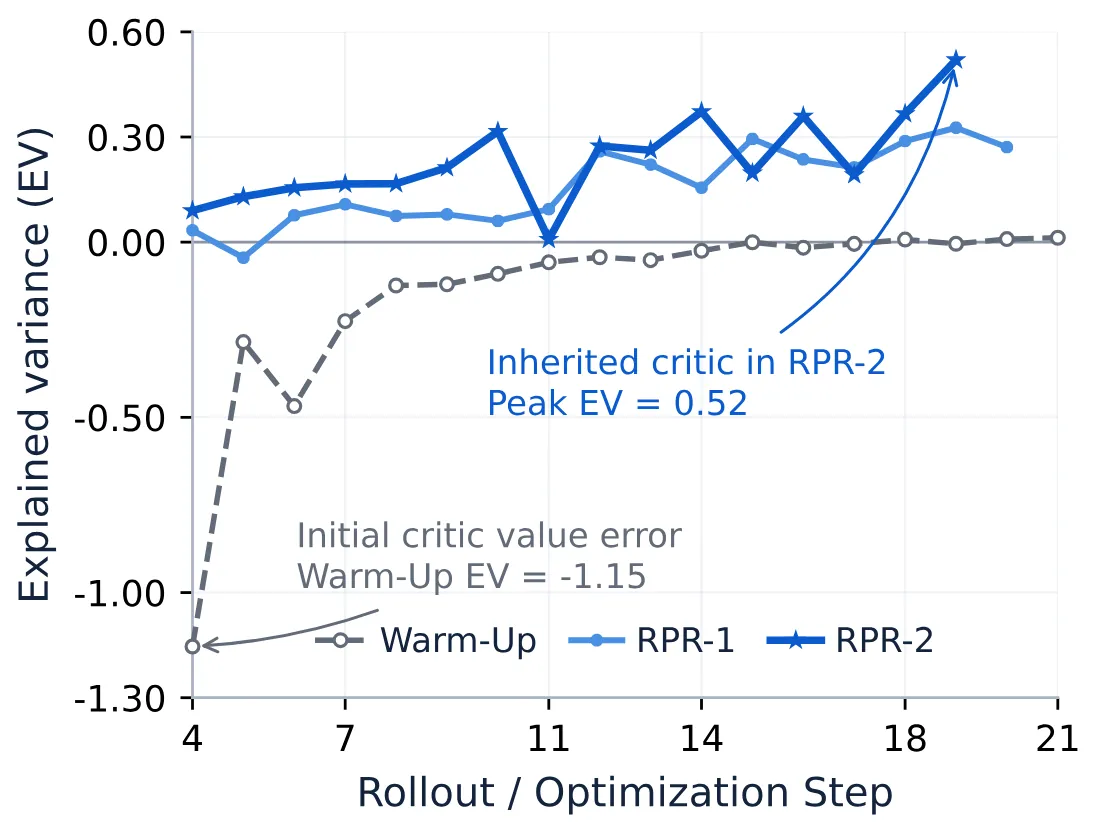
图 7:论文 Figure 9 的评论家解释方差。Warm-Up 起点为负,RPR-1 短暂穿越零点,RPR-2 记录窗口内 16 个观测全部为正,无平滑、无插补。
长 horizon、难度分层与奖励再打分
LHTB 的加权终态子任务评分把细粒度进展与隐藏压力测试下的完整解决分开:过程奖励沿五个阶段为 0.21、0.29、0.30、0.31、0.37(相对 Base 提升 76.19%),严格 1.00 标准下的平均完成任务数为 0/46、0/46、2/46、4/46、5/46。RSR-1 只改善部分进展而不产生严格完成,RPR-2 则同时推进两个信号。SWR100 上成功率走 3.00%、5.00%、6.00%、6.00%、6.00%:相对 Base 翻倍,但自 RPR-1 之后进入平台期,说明第二周期的增益没有迁移到这套训练不相交的科学工作流重建任务上。
难度分层在观测模型结果之前冻结:468 个基准—任务对按检查器规模、文件足迹与指令长度的平均经验百分位排名划分四分位,四套件子集含 322 对(Easy 118、Medium 106、Hard 57、Extreme 41)。Easy 从 31.78% 升到 72.88%,Medium 从 23.58% 升到 58.96%,Hard 从 14.91% 升到 49.12%(RPR-1 与 RSR-2 同为 48.25%),Extreme 则从 RPR-1 的 10.98% 掉到 RSR-2 的 6.10% 再回到 10.98%,呈非单调。固定轨迹重打分在同一批 4,352 条轨迹、结果标签不变的条件下进行:成功/失败的平均奖励从 FDR 的 1.01/0.41 变为 SPR 的 1.50/0.24,失败占奖励质量的份额从 50.09% 降到 28.72%,得分至少为 1 的失败从 158 条降到 0 条。但奖励离散度并没有下降:族均值标准差从 0.34 升到 0.47,轨迹级标准差从 0.50 升到 0.59——给失败奖励设界不等于降低全局方差,论文把这一点写进了正文。
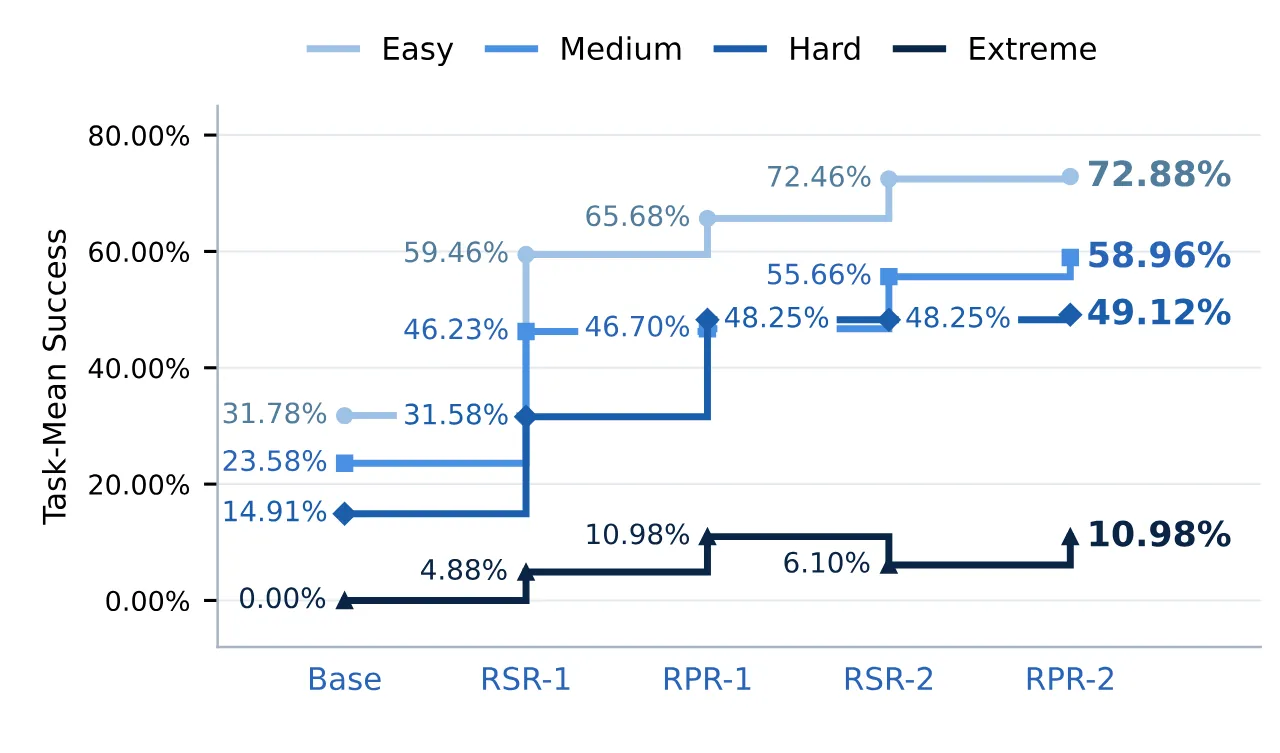
图 8:论文 Figure 10 的固定结构分层推进。颜色越深表示越难的固定组;Easy 到 72.88%,Extreme 先跌后回,说明增益在结构难度上分布不均。
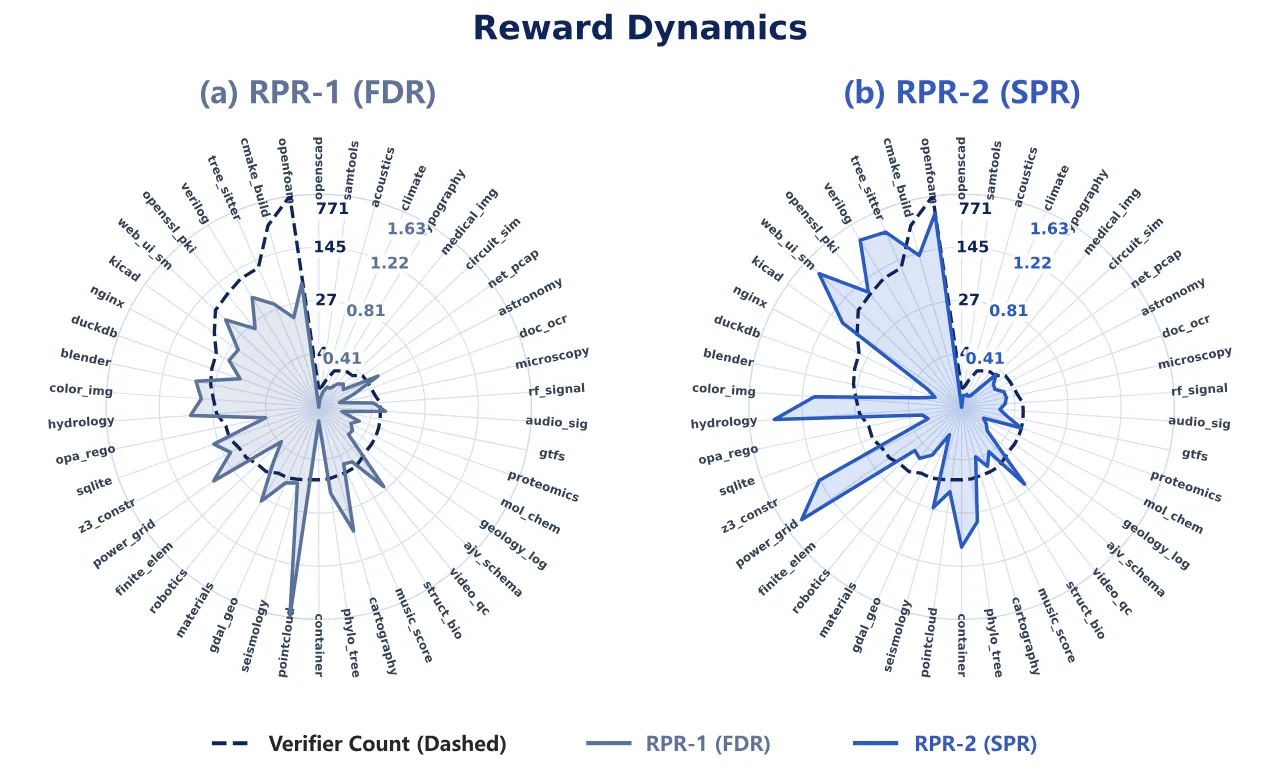
图 9:论文 Figure 11 的 46 族奖励剖面雷达图。实线为 FDR 与 SPR 下的平均奖励,虚线为池化验证器数量(另一尺度);多边形面积与平滑度都不是方差度量。
检查器级案例:修复统计量与满足输出契约是两件事
两个任务级案例把聚合分数背后的执行契约摊开。嵌入漂移监控含 11 条语义断言:Base 的计分重复通过 9 条;RSR-1 的三次重复中有一次在余弦修复后仍错过最大均值差异(MMD)门,且其代表性重复把无偏平方 MMD 估计裁剪到非负——而有限样本的无偏平方 MMD 估计本可以为负,裁剪改变的是估计器的统计契约;RPR-1、RSR-2、RPR-2 在各自两次重复中通过全部断言,检查器完成率沿五阶段为 81.82%、96.97%、100.00%、100.00%、100.00%,但 RSR-2 与最终模型走的是不同程序:前者探针式检查告警状态与带符号 MMD,后者修复六个模块并保留参考隔离、带符号 MMD、零范数处理与半分校准。Rust–C 表达式求值器有两个终端门:Base 与 RSR-1 停在 50.00%(wrapper 通过、精确输出 fuzz 失败,差异是整数商的十进制后缀格式);RPR-1 到 75.00%(一次重复通过双门,另一次在十进制与科学计数法之间失败);RSR-2 与 Terminal-RSI-27B 各以两次重复到 100.00%。但最终模型的第一次试验只用 C 接口做链接冒烟测试,把表达式求值委托给 Python 以保住数值格式——fuzz 通过确立的是被测输出等价,不是一条原生 Rust–C AST 执行路径。
局限性
第一处是作者自述的因果归因缺口:算力匹配的交替实验、隔离的 TB-GAE、匹配的在线奖励、继承对重置评论家的对照都仍然必要;阶段特定的学习率、奖励与初始化是同时变化的,估计器恒等式与离线重打分并不能隔离它们的训练效应。第二处同样是作者自述:三次评测重复不能替代独立训练种子,也不构成统计优越性;检查点选择需要受保护验证集,而不是向最终基准适配。第三处作者自述关于验证覆盖:测试只认证被强制的要求,Rust–C 案例暴露的正是原生架构缺口;奖励校准可能保留捷径,重放过滤也可能丢弃有用行为。第四处作者自述关于范围:SWR100 与训练池不相交,但更广的仓库与预训练重叠仍未完整审计;单一 27B 骨干上的五个阶段既不建立缩放律,也不保证普适单调性。
在此之外有三点补充判断。其一,TB-GAE 的部署状态比标题暗示的更弱:记录在案的第一阶段使用标准 GAE,unit-clock 等价性只是数学对齐,论文自己也说它不证明 TB-GAE 部署或隔离在线增益,因此「回合边界信用分配带来收益」目前仍是设计论证而非实验结论。其二,前沿模型对比的一手来源与协议对齐尚未完成,且论文承认对比是基准特定的(GPT-6 Sol 在 4.0 上更高、Gemini 3.8 Flash 在 2.1 上更高),把 19.84% 与 86.52% 读成「超过前沿」会超出证据范围。其三,Mean@3 的三次重复只刻画推理波动而非训练波动,叠加检查点选择未用受保护验证集,阶段间的个别小幅差异(例如 SWR100 后三阶段同为 6.00%)应读作平台期证据而非精确测量。
总结与展望
Terminal-RSI 的贡献不在某个更强的原语,而在原语之间的递归耦合方式:验证重写负责把跨 harness 的发现变成只更新 actor 的监督,评论家权重在这一步被完整旁路保留;策略精炼负责在联合优化之前,用冻结 actor 的四次 critic-only 更新把继承值适配到新的历史、奖励与 horizon 上;TB-GAE 把折扣时钟从 token 换到回合,使信用衰减跟随因果交互而非日志长度;FDR 到 SPR 的奖励演化则把部分信用逐步压到严格成功之下。五阶段保留序列给出四套件等权平均 50.58%、Terminal-Bench 4.0 19.84%、2.1 86.52%、3.0 16.95%、Hard 79.00%,LHTB 过程奖励 0.21 到 0.37 且严格完成 5/46,SWR100 翻倍到 6.00% 后进入平台。
作者给出的后续方向集中在受控研究:匹配任务暴露、匹配推理预算与受保护检查点选择,以分离评论家迁移与奖励演化各自的贡献;计算匹配的交替、隔离的 TB-GAE 与继承对重置评论家的对照是补齐因果链条的最小集合。对做终端智能体或机器人技能学习的工程团队,这篇论文更直接的启示是方法论层面的:把「测量到的任务完成」「被塑形的奖励」「检查器覆盖率」当作三个不可互换的信号分别报告,并在案例级回放里承认验证器没有认证的东西——例如那条仍依赖 Python 运行时的 static-pie Rust 二进制。
金句
流利的计划、或者不断累加的局部检查通过数,单独都闭不上这个循环——把探索变成可复现的执行、把延迟的验证拴回使它成为可能的决策,才是递归自改进要解决的两件事。