PAPER DEEP DIVE
QwenGyre:训练 xLong 长程智能体的弹性强化学习框架
单次执行数小时、数百次模型与环境交互、生命周期近 100 万 token 的 xLong 长程智能体任务,把在线强化学习推到两个极限:rollout 长尾让 GPU 大量空转,黑盒 harness 的分叉历史又让轨迹严重冗余。QwenGyre 的回答是解耦三种生命周期——harness 执行、GPU 角色、训练样本。弹性调度器以水位 w(t)=d(t)-f(t) 为准绳在 rollout 与训练之间迁移 GPU 角色,RDMA KV-cache 迁移与 Mooncake 权重拉取把角色切换压到平均 8.52 秒与 3.46 秒,且全程不打断在途执行;轨迹处理器用 TITO 记录与轨迹树保住每个输出的原始条件上下文,为超时执行已完成的部分打分,并按 main、main-summary、sub-agent、sub-agent-summary 的角色优先级每执行至多准入 5 条轨迹,共享前缀只训一次。在旗舰 Qwen 3.8 2.4T、每条 rollout 70 万 token 的规模上,48 步把 NL2RepoBench 通过率从 52.5% 提到 58.5%,相对 Colocate 与 Async 分别取得最高 1.85× 与 1.78× 的端到端加速。
论文:QwenGyre: An Elastic Reinforcement Learning Framework for Training xLong-Horizon Agents(arXiv:2609.33848,arxiv.org/abs/2609.33848,2026-09-27 提交,cs.LG / cs.DC)
作者:Weiqi Wang*、Yuxin Zhou*、Mouxiang Chen*、Siyuan Zhang、Yi Zhang、Yuyan Luo、Zhiyu Yin、Chencan Wu、Jiemin Jiang、Wentao Yao、Chujie Zheng、JianWei Zhang†(Alibaba Token Hub, Alibaba Group;中国科学技术大学;清华大学;* 同等贡献,† 通讯作者)
代码:本文未提供公开代码(截至检索时 GitHub 上以 QwenGyre 为名的仓库数为 0);训练与 rollout 后端分别为 Megatron 与 SGLang,权重搬运复用 Mooncake Transfer Engine,harness 为未修改的 Claude Code 2.1.220。
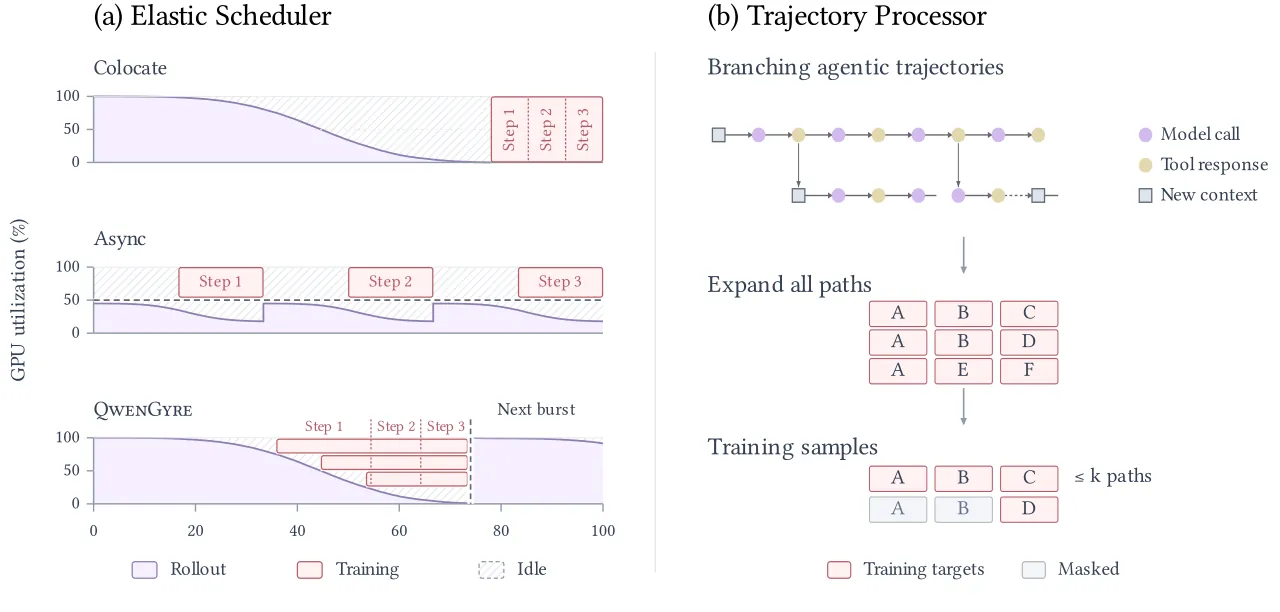
图 1:QwenGyre 要解决的两类挑战。(a) 弹性调度器在继续服务在途执行的同时,把空闲的 rollout 算力转给训练;(b) 轨迹处理器把分叉的执行重建成有界的训练样本,并在共享前缀上把重复目标只计一次。
一句话总结
QwenGyre 把「harness 执行的生命周期、GPU 角色的生命周期、训练样本的生命周期」三者解耦:弹性调度器按未完成 rollout 工作量在 rollout 与训练之间搬 GPU 而不打断在途执行,轨迹处理器把黑盒 harness 产生的分叉历史重建成轨迹树、为超时后的部分进展打分、按角色优先级抽取有界轨迹,从而在 700K token 级 rollout 上把 Qwen 3.8 2.4T 的 NL2RepoBench 通过率从 52.5% 训到 58.5%,并相对 Colocate 与 Async 取得最高 1.85× 与 1.78× 的端到端加速。
研究背景与动机
LLM agent 正在接手越来越长的软件工程任务。issue resolution 一类工作(SWE-bench 及其后继)只需在既有仓库里定位一处修复,跨度是几十次交互;而仓库生成、系统重写、整库重构这类端到端自主开发,把单次执行推到了「数小时、数百次模型—环境交互、整个生命周期处理约 1M token」的量级。作者把这个区间称为 xLong-horizon:生命周期 token 量按每次请求的重复上下文累加,甚至可以超过单个请求的上下文上限。
在线强化学习在这个量级上首先撞上的问题是调度。Colocate 设计让同一组 GPU 在 rollout 与训练之间整体切换;xLong 下 rollout 呈严重长尾,训练必须等所有在途执行结束才能开始,于是 GPU 陪着几条拖尾任务空转。Async 设计把 GPU 静态切成两个池子让两阶段重叠;但 xLong 下等待一个 ready batch 的时间可以远超一个训练步,训练 GPU 在等数据时空转,而刚性分区又让任何一方都用不了对方的闲置算力。问题因此变成:如何在需求变化时动态重分配 GPU,用闲置算力做训练,同时保住对在途 rollout 的推理服务。
第二个问题出在轨迹上。简单 agent 的线性循环在 xLong 下活不下来:要撑住数小时执行,必须依赖黑盒 harness,而 harness 会压缩饱和的历史、把子任务委派给带独立上下文的子智能体、重试失败的路径。一次任务执行不再是一条顺序轨迹,而是一张分叉的上下文路径图。把所有路径展开成独立训练样本,会在共享前缀上产生严重冗余,训练开销不可接受。问题因此变成:如何从这样的分叉执行中重建有效的训练表示,同时不让路径与 token 的体量压垮训练管线。
黑盒接口是这两个问题的共同前提。harness 通过 RL 框架提供的 proxy 访问模型,框架记录模型调用、接收任务级评测结果,但不改动 harness 的执行逻辑——因为这些 harness(Claude Code、Codex 等)与部署时用的是同一套,闭源且迭代极快,在框架内重实现其控制流既不可行,也会让策略在一个与部署不同的 harness 下被训练。该接口不提供对在途执行的 checkpoint/resume:一旦某次模型调用得不到服务,harness 可能卡住或超时,任务结果就会因与策略决策无关的原因改变。所以调度必须在全程保住推理访问,请求可以在 harness 继续运行时被路由到别的 rollout 实例。
由此得到本文的设计原则:分离三种生命周期。harness 状态跨 GPU 角色切换而存活;记录下来的模型调用按需物化成训练样本;GPU 角色随需求在 rollout 与训练之间迁移。QwenGyre 的两个部件——弹性调度器与轨迹处理器——分别承担前两者与后两者的解耦。
预备知识
组相对 RL 管线与 burst。每个 query 采样 $N$ 条独立 rollout 组成一个 rollout group,advantage 由组内标量奖励算出,不学价值函数。一个训练步消费 $B$ 个不同 group 并把策略版本推进 1;为摊薄权重发布开销,框架可以在两次发布之间连续做 $\mu$ 个训练步,这个区间称为 burst,一个 burst 消费 $\mu B$ 个 group 并在最后一步发布权重。
调度陈旧度与边界派发。组的调度陈旧度定义为 $d=v_t-v_d$:$v_d$ 是该组被接收时最近一次发布的策略版本,$v_t$ 是消费它的那一步之前的训练版本。边界派发下,组被接收后占住派发槽位直到被训练消费,队列在启动时填到目标深度、每个 burst 发布后补 $\mu B$ 个新组;目标深度与稳态平均陈旧度满足 $Q_{\mathrm{b}}=(\varphi+\mu)B$ 与 $\mathbb{E}[d]=\varphi+\frac{\mu-1}{2}$,其中 $\varphi$ 是以 $B$ 为单位的额外派发量。附录 A 给出该恒等式的严格证明(Theorem A.1),并推出两个特例:Colocate 不能额外派发($\varphi=0$)故 $\mathbb{E}[d]=\frac{\mu-1}{2}$;Async 取 $\mu=1$ 故 $\mathbb{E}[d]=\varphi$。三种方法在同一 $\mathbb{E}[d]$ 目标下比较:例如 $\mathbb{E}[d]=1.5$ 时 Async 用 $(\varphi,\mu)=(1.5,1)$、Colocate 用 $(0,4)$、QwenGyre 用 $(0.5,3)$。
TITO 与轨迹树。token-in, token-out(TITO)记录每次模型调用的精确输入输出 token 与输出 token 的行为对数概率,使每个输出保留它生成时的原始条件上下文,即使该上下文后来被 harness 压缩掉。轨迹树以请求记录为节点、按共享前缀组织:新请求的序列化上下文与已有路径匹配后复用已存 token,只编码新增内容;分叉的上下文产生分支,匹配不上任何前缀的请求挂到根上。候选轨迹在选择之前一直保持在这份共享表示里,避免为每条路径展开完整历史。
方法详解
拓扑感知的 cell 组织
QwenGyre 用 Megatron 做训练、SGLang 做 rollout。全部 GPU 被组织成 $K$ 个弹性 cell,共享同一套训练并行布局;张量、流水线、专家、上下文并行组都留在 cell 内部,放置上优先高带宽互联。cell 之外可以另设一个常驻 rollout 的独立池。cell 按固定顺序编号,core cell 居首:它持有权威权重,也是唯一的 optimizer 拥有者;satellite cell 拉取 core 的参数快照参与训练。作者倾向小 cell 以换取细粒度重分配,代价是每个 cell 必须装得下模型的显存与训练并行需求。
设每个弹性 cell 在 rollout 模式下的并发执行容量为 $C_e$,独立池容量为 $C_s$(无独立池时 $C_s=0$),$k(t)$ 为当前处于训练角色的 cell 数,则可用的 rollout 容量为
$$C_R(t)=C_s+\bigl(K-k(t)\bigr)C_e. \tag{1}$$
这条式子是整张调度平面的账本:水位判断、角色切换、burst 末 core 去留,全部以它为分母。
边界派发与水位控制
调度器维护三个累计计数:$d(t)$ 在组被派入 rollout 队列时加一,$p(t)$ 在执行真正启动时加一,$f(t)$ 在执行终止(完成、失败、超时、取消,含过采样下的多余执行)时加一;模型请求级重试留在同一执行内,不动任何计数。于是 $d-p$ 是排队数、$p-f$ 是在跑数。burst 内初始派发为 $d(0)=(\varphi+\mu)NB$,每次权重发布后再派 $\mu NB$ 条执行;只要还有空闲 rollout 容量且引擎就绪,调度器立即启动 $\min\{d(t)-p(t),\ C_R(t)-(p(t)-f(t))\}$ 条排队执行,burst 内 $d(t)$ 保持不变。
水位定义为 $w(t)=d(t)-f(t)$,burst 内单调不增。下一个 cell 想加入训练,必须满足剩余 rollout 容量盖得住这些未完成执行:
$$w(t)\leq C_R(t)-C_e. \tag{2}$$
式 (2) 还配一个供给侧检查:ready 且未被占用的组数(以当前 batch 仍需要的组数封顶)必须连续 $\tau$ 时间不低于 batch 的 $\rho_{\min}B$,才允许开始切换;计时器在每次切换后与每个 batch 开始时重置。cell 串行切换,core 先、satellite 按序号后,且在整个 burst 内留在训练角色,形成一个不断增长的前缀。burst 末所有 satellite 回到 rollout 并恢复 SGLang 引擎,core 把更新后的权重发布给全部 rollout 引擎;随后 core 只有在「下一 batch 已有 $\rho_{\min}B$ 个 ready 组」且剩余容量盖得住未完成工作加上待派的 $\mu NB$ 条执行时才留在训练:
$$w(t)+\mu NB\leq C_s+(K-1)C_e. \tag{3}$$
供给侧检查或式 (3) 任一不满足,core 就回到 rollout,把参数重新分片进本地 SGLang。图 2 的时间线展示了这一过程:core 完成两次 optimizer 更新,satellite 在拉取当前参数后中途加入在途步,n6–n7 整个 burst 留在 rollout。
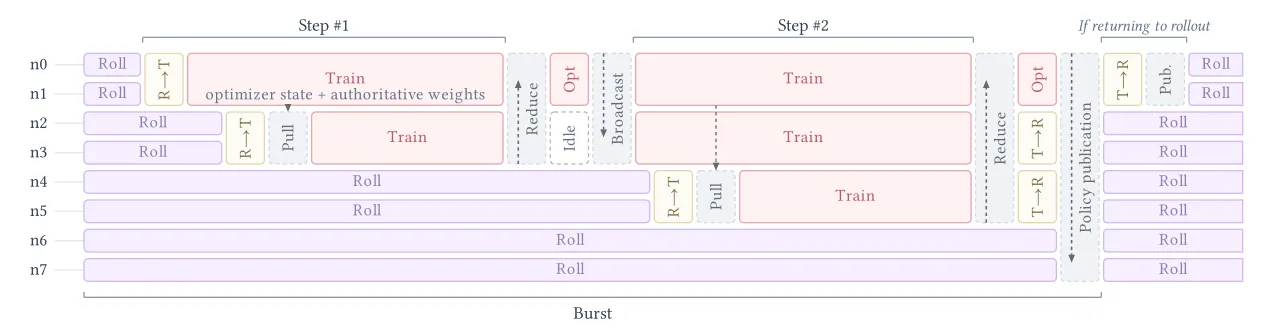
图 2:一个两步 burst 的示意时间线(对应论文 Figure 4)。core(n0–n1)完成两次更新;satellite 拉取当前参数后加入在途步;梯度归约在每次更新之前,非末次更新后广播参数,末次更新后发布 rollout 策略;core 的最终角色切换与本地发布只在它回到 rollout 时发生。
保住 harness 的角色切换
角色切换期间,harness、workspace 与工具执行状态原地不动,proxy 负责改道模型调用:源 cell 先停止接收新请求;调度器为受影响执行预留目的容量并更新路由,然后取消源引擎上未完成的请求;proxy 把这些请求透明地重试到目的引擎。目的选择优先独立池引擎,其次按 cell 序号倒序的 rollout cell——优先选择预计能停留更久的目的地,减少同一执行在一个 burst 内被反复改道。
KV-cache 迁移用来减少改道带来的前缀重算:请求在源引擎被取消前,源端先 pin 住对应 cache 块;取消完成、cache 写停止后,目的端通过 RDMA 读取这些块;源端在收到目的端确认接管后才释放。切换完成后,cell 卸载 rollout 参数、释放 KV cache 与临时缓冲以回收显存,再恢复训练参数与缓冲;后端进程与通信组在整个角色变化期间保持存活,切换开销因此只有秒级——实测 rollout 转训练平均 8.52 s、训练转 rollout 平均 3.46 s,相对数小时的执行可以忽略。
动态成员的流式训练
为了让 satellite 能加入在途 batch,core 在从 rollout 转入训练时、以及后续每一步之前,通过 Mooncake Transfer Engine 暴露持有权威权重的缓冲;satellite 向调度器注册、经 RDMA 拉取 core 权重后直接开始训练,不打断 core。梯度累积期间权重固定,所以加入者读到的是自洽快照;控制器在 optimizer 更新前关闭加入窗口。对 $K$ 个有序 cell,系统预建 $K-1$ 套通信组,每套对应 $2,\ldots,K$ 的一个前缀,集合通信按参与前缀选套。batch 处理完后 core 汇总并归一化所有训练 cell 的梯度,做梯度裁剪与单次 optimizer 更新;非末次更新后把新参数广播给当前 satellite。
流式训练靠两个缓冲。轨迹缓冲按 rollout group 存执行记录与奖励;流打包缓冲在自身轨迹不足时从轨迹缓冲取一个 ready 组(优先最旧策略版本),把选中轨迹物化成 token 行并重排以便高效打包,再以 micro-step 为单位吐出训练输入。各 cell 在算力空出时从共享队列原子地认领 micro-step,拿到互不相交的工作;更早或更快的 cell 消费更多 micro-step,使参与 cell 大致同时完成同一 batch。打包缓冲增量地选满 batch 的 $B$ 个组,直到把它们的全部 micro-step 入队才关闭流。每个 cell 用连续的 one-forward-one-backward 流水线处理 micro-step;数据暂缺时各 stage 完成在途通信后停在一致的调度点,保留流水线状态;流关闭且队列排空后流水线排空剩余工作,因此每个 cell 每 batch 只付一次启动与一次排空。
flowchart TD
  HB[Harness in sandbox
unmodified black-box agent] -->|model calls| PX[Black-box proxy
records TITO tokens and behavior log-probs]
  PX --> RT[Rollout engines
SGLang cells in rollout role]
  RT -->|responses| PX
  PX ==> TT[Trajectory trees
shared prefixes keep original contexts]
  EV[Evaluator
scores preserved workspace
valid partial progress after timeout] ==> BF[Trajectory buffer
records and rewards by rollout group]
  TT ==> BF
  BF ==> PK[Stream packing buffer
admits at most Jmax paths per execution
shared targets counted once]
  WL[Rollout waterlevel
dispatched minus finished] -->|falls below remaining capacity| SC[Elastic scheduler
serial transitions core first
supply check rho_min and tau]
  SC -->|train role| TR[Training cells
satellites pull core weights via RDMA
claim micro-steps atomically]
  PK ==>|micro-steps| TR
  TR ==>|gradients| CORE[Core cell
single optimizer update per batch]
  CORE -->|publish weights at burst end| RT
图 3:QwenGyre 的控制流与数据流(对应论文 Figure 3)。细线控制边是 burst 边界动作,水位反馈驱动角色切换;粗线路径是数据流,两级缓冲分别承担轨迹存储与流打包。
轨迹处理器:从执行记录到轨迹树
proxy 在 TITO 下为每次模型调用保存精确的输入输出 token id、输出 token 的行为对数概率与元数据。为了跨 harness 的消息处理维持这些记录,proxy 还按 call id 缓存原始 tool-call payload,在匹配后续请求历史前先恢复这些 payload,同时保留传入 id 用于 tool-response 关联,避免 tool-call 重格式化造成的伪历史不匹配。harness 继续用它原有的消息接口,训练则消费记录下来的 token 与元数据;即使某段上下文后来被压缩移除,每个输出仍保留它生成时的条件上下文。
请求记录被组织成每执行一棵的轨迹树:节点保存增量输入、记录输出与元数据;恢复 tool-call 后,框架把进入请求的序列化上下文与已有路径匹配并复用已存 token,只编码新增内容,新记录作为节点追加;分叉上下文产生分支,匹配不到前缀的请求挂到根。附录 C 的真实案例(执行 f3ad38e5:636 次 proxy 请求、1,347 个唯一消息节点、10 条候选轨迹)显示,主 agent 与 catalog 子智能体各自压缩历史后,共享前缀分别为 168 与 193 个消息节点;10 条完整路径各含 53–293 个节点,若独立展开会产生 1,716 次节点出现,比共享表示多 369 次重复。
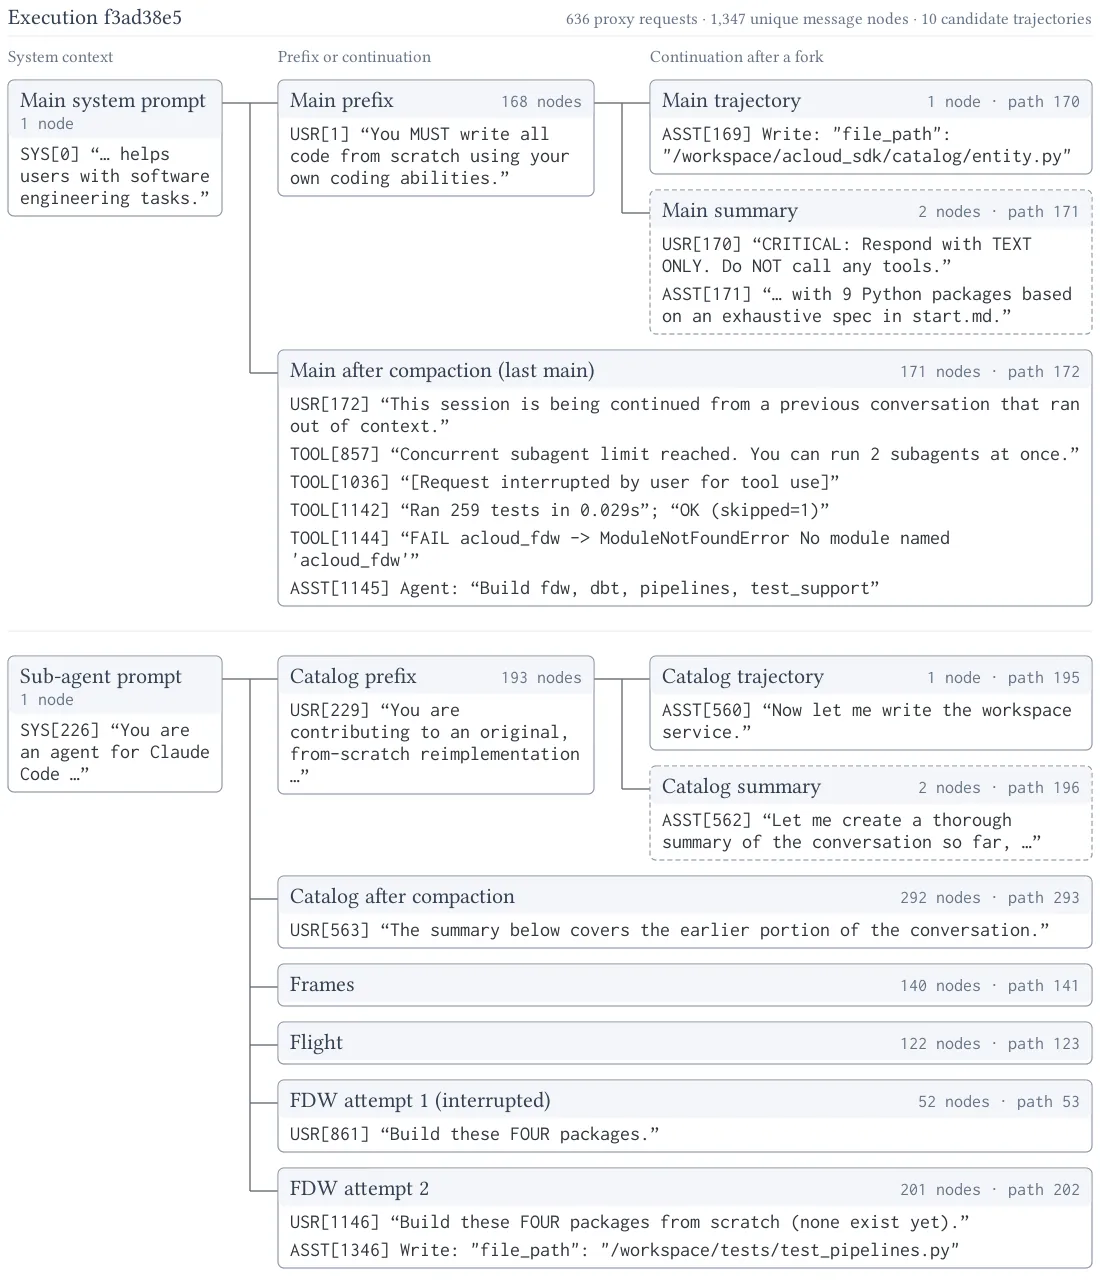
图 4:执行 f3ad38e5 的前缀图与真实消息摘录(对应论文 Figure 12)。直角边编码前缀共享,虚线框是 summary 叶子;TOOL[1036] 处的中断留在它被接收的主上下文里。主 agent 与子智能体因 system prompt 不同而各有根,因果父子关系与上下文前缀共享并不相同。
部分评分:超时不等于零分,也不等于无效
执行关闭时,QwenGyre 固定已提交的策略生成请求记录,识别可用的 artifact 状态,并在任务评分规则下评估被保留的工作——包括超时之后。未完成执行只要其已完成部分可评估,就能拿到有效分数;对这些被评估的结果,数据平面不从耗时、轨迹长度或终止状态推导奖励。评估器返回分数、有效性状态与被评估状态的引用。xLong 执行可能评估中间 artifact、修订它、放弃分支,因此每次评估都与其执行、artifact 版本、可用分支引用绑定,后续评估不覆盖这些关联;被后续策略请求当作输入使用的 critique,其评估器来源使它被排除在策略训练目标之外。
失败被分成三类处理。评估器失败使评估悬而未决,可在执行总时间预算内对同一保留状态重试;预算耗尽仍无有效奖励时,记录下的轨迹被排除出训练——未决评估不同于有效的零分,后者仍可用于训练。极少数完全失败(如镜像拉取失败)不留任何可评估工作,QwenGyre 插入一条零奖励的 dummy 轨迹作为失败占位,保证组内计数完整。这条区分直接对应组相对优势的需求:一个组只有在全部执行关闭且指定结果有效后,才具备 $N$ 个有效样本奖励。
轨迹采样:按角色优先级抽取有界路径
可训练 token 由来源决定:只有策略在 rollout 中生成的 token 才是目标。TITO 记录每个 token 是由 SGLang 引擎吐出还是外部供给;system prompt、用户 prompt、工具结果、以及 harness 注入而非采样的 assistant 内容一律被掩码,只作为条件上下文保留。候选轨迹对应轨迹树的叶子:叶子加上根到叶的前缀路径定义一条轨迹。xLong 下一次执行可能产生大量候选且数量在执行间差异巨大,全部保留会拖垮训练效率,因此 QwenGyre 每执行至多保留 $J_{\max}$ 条(默认 5),按期望重要性排序填充。对 Claude Code harness,叶子按请求序列的角色分为四类,优先级为
$$\text{main} > \text{main-summary} > \text{sub-agent} > \text{sub-agent-summary}. \tag{4}$$
该顺序依据两条原则:主 agent 的回合是任务级奖励最直接记功的对象,子智能体轨迹只通过被委派的子任务间接贡献;同一 agent 内,推进任务的回合排在管理上下文的 summary 轨迹之前。准入从来源掩码出发逐条抽取:每步取仍有未掩码可训练 token 的最高优先级类,按未掩码 token 数成比例抽一个叶子;被抽中轨迹的目标固定为此刻仍未掩码的 token,随后把它根到叶的整条路径在树上掩码——共享前缀因此不会被训练第二次,已固定的目标不受影响,下降后的计数又为下一次抽取重新加权。准入重复到没有未掩码可训练 token 或达到 $J_{\max}$,得到 $J_i\leq J_{\max}$ 条轨迹,各自继承该执行的组相对优势。
flowchart LR
  T1[main task-driving leaves] -->|priority 1| AD[Admission loop
draw one leaf proportional to unmasked tokens]
  T2[main summary leaves] -->|priority 2| AD
  T3[sub-agent leaves] -->|priority 3| AD
  T4[sub-agent summary leaves] -->|priority 4| AD
  AD -->|fix targets then mask root-to-leaf path| MS[Shared prefix targets counted once]
  AD -->|stop at Jmax or no unmasked token| TRJ[Bounded trajectories
each inherits the execution advantage]
图 5:树上准入规则。每次抽取后整条根到叶路径被掩码,使共享前缀只贡献一次训练信号,剩余叶子的抽取概率随之重加权。
执行级目标函数:多一条轨迹不增加一个执行的权重
对执行 $i$,记准入轨迹集合为 $\mathcal{R}_i$,轨迹 $r$ 的目标集 $\mathcal{T}_r$ 固定为它被抽出时仍未掩码的可训练 token;树上掩码保证这些集合互不相交。记 $\mathcal{T}_i=\bigcup_{r\in\mathcal{R}_i}\mathcal{T}_r$、$L_r=|\mathcal{T}_r|$、$L_i=|\mathcal{T}_i|=\sum_{r}L_r$。token 重要性比与去梯度的执行级序列比为
$$\rho_u(\theta)=\frac{\pi_\theta(y_u\mid c_u)}{p_u^{\mathrm{roll}}},\qquad s_i(\theta)=\operatorname{sg}\!\left[\exp\!\left(\frac{1}{L_i}\sum_{u\in\mathcal{T}_i}\log\rho_u(\theta)\right)\right]. \tag{5}$$
其中 $p_u^{\mathrm{roll}}$ 是记录的行为概率,直接复用不重算。$s_i(\theta)$ 只用于监控,并按组相对优势 $\hat{A}_i$ 的符号决定一个共享裁剪掩码 $m_i(\theta)$:$\hat{A}_i>0$ 且 $s_i(\theta)>1.005$ 时置 0,$\hat{A}_i<0$ 且 $s_i(\theta)<0.995$ 时置 0,其余为 1。token 级重要性权重取 $\bar{\rho}_u(\theta)=\operatorname{sg}(\min\{\rho_u(\theta),5\})$,同一执行内可以各不相同;token 损失上限为 100:$\ell_u(\theta)=\min\{100,\,-m_i(\theta)\bar{\rho}_u(\theta)\hat{A}_i\log\pi_\theta(y_u\mid c_u)\}$。
归一化是这套设计的关键。按每条轨迹的目标占比 $L_r/L_i$ 加权、再在其目标上平均,得到
$$\mathcal{L}_i(\theta)=\sum_{r\in\mathcal{R}_i}\frac{L_r}{L_i}\cdot\frac{1}{L_r}\sum_{u\in\mathcal{T}_r}\ell_u(\theta)=\frac{1}{L_i}\sum_{u\in\mathcal{T}_i}\ell_u(\theta), \tag{6}$$
即每个准入目标拿到同一个系数 $1/L_i$,重要性加权与裁剪都不改变这个分母;$L_i=0$ 的执行贡献零损失。batch 级再对全部 $B$ 个 query 的 $N$ 条原始执行平均:$\mathcal{L}(\theta)=\frac{1}{BN}\sum_{q=1}^{B}\sum_{k=1}^{N}\mathcal{L}_{i(q,k)}(\theta)$。于是一个执行的聚合归一化权重与它贡献几条轨迹无关:对固定的准入目标集 $\mathcal{T}_i$,换哪条选中路径承载某个共享目标,该执行的序列比、裁剪决定与损失都不变。采样可以改变 $\mathcal{T}_i$ 本身,但不变性针对的是固定目标集的分配与顺序;打包过程保留这些按执行的权重。
实验结果
评测覆盖三个 agentic 工作负载:NL2RepoBench(从自然语言规格构建软件仓库,训练时用独立的 Qwen 3.7-Max 评估器按独立编写的测试给生成代码打分)、DeepSWE(既有仓库内的软件工程,用仓库测试评测)、TerminalBench(多轮终端任务,用任务专用验证器评测);三者都用 Claude Code 2.1.220 在容器化环境里执行 shell 与文件操作。模型为 Qwen 3.6 122B 与旗舰 Qwen 3.8 2.4T:122B 的 NL2RepoBench 用 32 节点、默认 8 个 4 节点 cell、每 cell 并发 144;DeepSWE 与 TerminalBench 用 24 节点、6 个 cell、每 cell 并发 192;2.4T 用 4 个 48 节点 cell、总并发 384。RL 算法为带 token 级重要性校正的 GSPO 变体:每组 $N=16$ 条执行,NL2RepoBench 每步 $B=32$ 组、其余 $B=48$ 组,token 重要性比上限 5、序列级裁剪区间 $[0.995,1.005]$、$J_{\max}=5$、Adam 常学习率 $10^{-6}$。基线为同 GPU 预算、同目标陈旧度下的 Colocate 与 Async,且都用边界派发。
xLong 的执行画像解释了调度设计的必要性。Qwen 3.6 122B 上 NL2RepoBench 的单条 rollout 执行平均 1.93 小时、单 query 平均 2.96 小时,9.51% 的 query 超过 4 小时;harness 超时率 6.25%(结果仍被评分并用于训练)、overall 超时率 0.87%(预算耗尽、无有效奖励,被丢弃)。换到 Qwen 3.8 2.4T,即使放宽超时上限,超时率反而更高:61.1% 的 query 超过 4 小时,其中 38.2% 的最长 rollout 执行以 overall 超时终止。长尾与成簇终止同时存在,正是水位控制要吃的形态。
端到端性能上,122B 的 NL2RepoBench 在两个陈旧度目标下、48 步后 QwenGyre 相对 Async 加速 1.42–1.53×、相对 Colocate 加速 1.36–1.47×,且训练分数曲线与基线相当——更快不是靠牺牲任务性能换来的。角色时间线显示 cell 在不同时刻进入训练、其余 cell 继续 rollout,训练从子集起步再扩张;固定 Async 分区留给 rollout 的算力、以及 Colocate 必须整池切换的等待,都被这部分重叠吃掉。2.4T 上差异更明显:48 步 QwenGyre 用 75.42 小时,Async 用 134.55 小时、Colocate 用 91.47 小时,即 1.78× 与 1.21×;评测通过率从 52.48% 升到 58.54%。对 Colocate 的增益较小也有解释:query 时长集中在超时上限附近,QwenGyre 提前回收 cell 的机会变少,而 Colocate 本就与训练共享资源池;Async 的固定分区则在训练空闲时仍把算力锁在训练侧,QwenGyre 把这部分动态还给 rollout,增益因此更大。
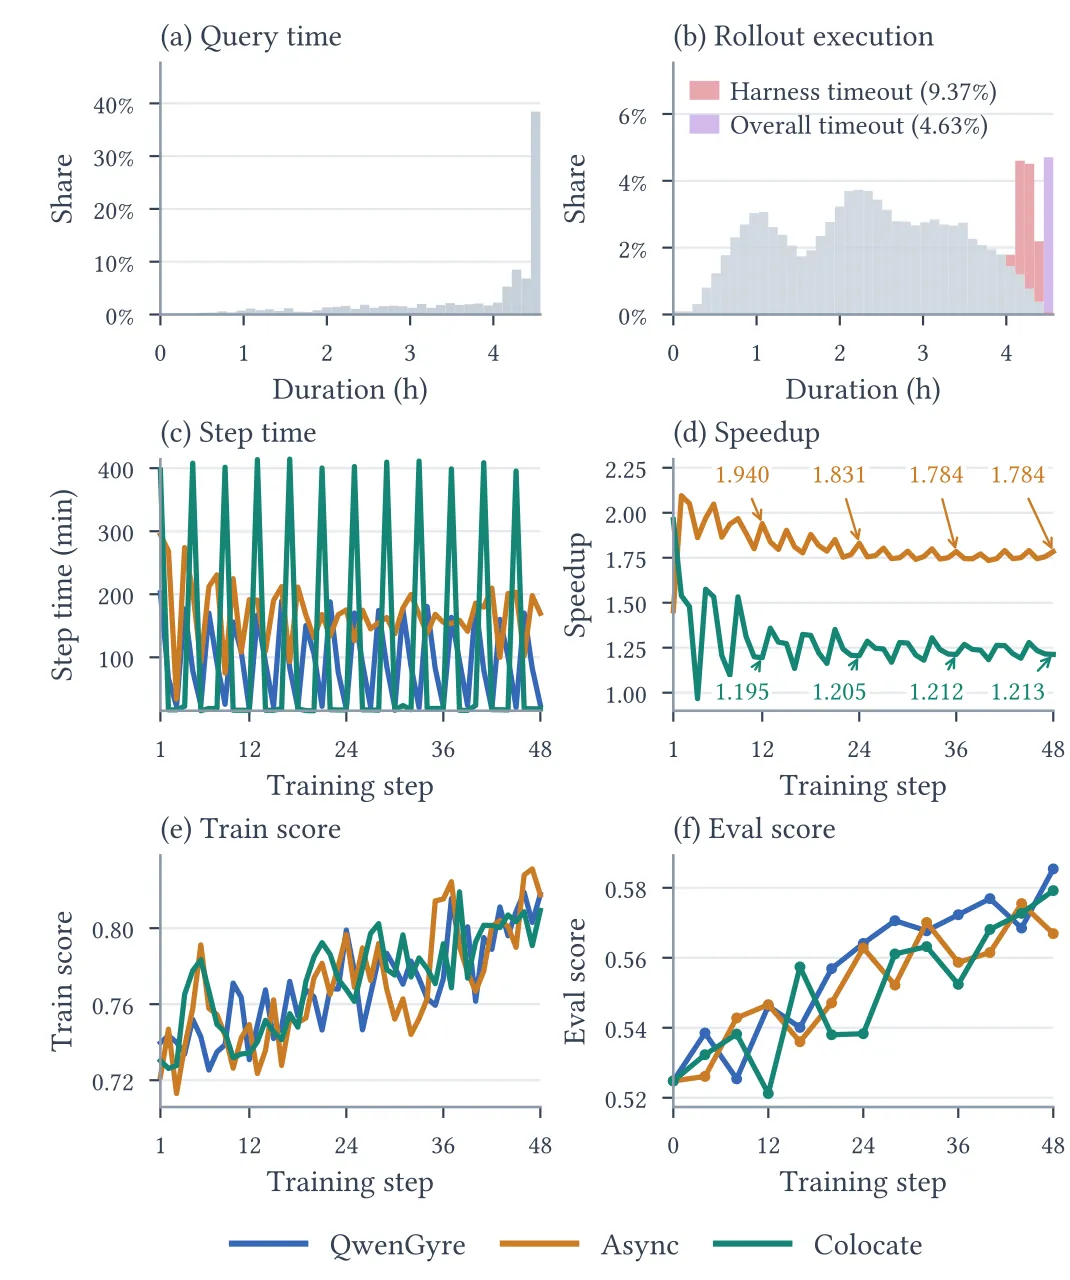
图 6:Qwen 3.8 2.4T 的 NL2RepoBench 结果(对应论文 Figure 8)。(a)(b) query 与 rollout 执行时长分布,末 bin 收 ≥4.45 h;(c)(d) 步时长与累计加速(Async 1.940→1.784、Colocate 1.195→1.213);(e)(f) 训练分与评测分,评测通过率 48 步内 52.48%→58.54%。
| 工作负载 | 目标 𝔼[d] | QwenGyre (φ,μ) | 相对 Async 加速 | 相对 Colocate 加速 |
|---|---|---|---|---|
| DeepSWE(24 步) | 1 | (0.5, 2) | 1.569 | 1.610 |
| DeepSWE(24 步) | 1.5 | (0.5, 3) | 1.572 | 1.824 |
| TerminalBench(24 步) | 1 | (0.5, 2) | 1.383 | 1.809 |
| TerminalBench(24 步) | 1.5 | (0.5, 3) | 1.430 | 1.849 |
| NL2RepoBench,2.4T(48 步) | — | — | 1.78 | 1.21 |
表 1:跨工作负载的 24/48 步累计加速(论文 Table 2 与 Figure 8)。Async 用 $(\varphi,\mu)=(\mathbb{E}[d],1)$、Colocate 用 $(0,2\mathbb{E}[d]+1)$,均按式 $\mathbb{E}[d]=\varphi+\frac{\mu-1}{2}$ 配平。
消融把 QwenGyre 拆成两条演化路径:给 Async 加流式训练、给 Colocate 加独立 rollout 节点,最后汇到细粒度弹性分配。把节点从训练挪给 rollout(A0→A1)反而慢 7.7%:执行成簇完成,变小的训练池消化得更慢,拖慢权重发布与补派。拉长 burst(A2)慢 29.9%,因为固定 rollout 池供不上。流式训练(A3)快 11.6%,但只拿到部分收益——固定分区仍不能在需求变化时搬 GPU。Colocate 侧,加独立节点(C1)只比 C0 快 2.9%;再加流式(C2)快 14.8%,但 28 个 colocate 节点仍必须一起切换,流式训练只能在 burst 后段开始;扩大独立池(C3)又让训练节点变少、训练阶段变长,比 C2 慢 7.6%。E0 用 8 个可独立切换的 4 节点 cell 替换 C2 的固定切分,比 C2 快 1.19×;E1 把 burst 缩到一步($\varphi$ 从 0.5 提到 1.5 保持陈旧度)比 E0 慢 10.9%,但仍比同样单步+流式的 A3 快 1.24×、比 C2 快 1.08×,说明细粒度分配即使没有多步 burst 也成立;E2 把同样 32 节点重组成 4 个 8 节点 cell,只比 E0 慢 2.2%——E0 里 rollout 完全遮住训练且还剩 20.85% 余量,粗 cell 只把少量训练暴露在关键路径上。
| ID | 演化 | 流式 | 切换粒度 | (φ,μ) | 分配 | 12 步总时长 (h) | 相对 E0 |
|---|---|---|---|---|---|---|---|
| A0 | 原始 Async | 关 | — | (1.5,1) | 16 T / 16 R | 25.08 | 1.556 |
| A1 | A0 调整分区 | 关 | — | (1.5,1) | 8 T / 24 R | 27.01 | 1.676 |
| A2 | A0 + 多步 burst | 关 | — | (0.5,3) | 16 T / 16 R | 32.58 | 2.021 |
| A3 | A0 + 流式 | 开 | — | (1.5,1) | 16 T / 16 R | 22.18 | 1.376 |
| C0 | 原始 Colocate | 关 | Global | (0,4) | 32 C / 0 S | 23.23 | 1.442 |
| C1 | C0 + 独立 rollout 节点 | 关 | Coarse | (0.5,3) | 28 C / 4 S | 22.56 | 1.400 |
| C2 | C1 + 流式 | 开 | Coarse | (0.5,3) | 28 C / 4 S | 19.23 | 1.193 |
| C3 | C2 调整分配 | 开 | Coarse | (0.5,3) | 16 C / 16 S | 20.69 | 1.284 |
| E0 | C2 + 细粒度弹性 cell | 开 | Fine | (0.5,3) | 8 cells × 4 | 16.12 | 1.000 |
| E1 | E0 单步 burst | 开 | Fine | (1.5,1) | 8 cells × 4 | 17.87 | 1.109 |
| E2 | E0 四个 8 节点 cell | 开 | Fine | (0.5,3) | 4 cells × 8 | 16.47 | 1.022 |
表 2:前 12 个 NL2RepoBench 训练步的调度消融(论文 Table 1,Qwen 3.6 122B,𝔼[d]=1.5)。T/R 为训练/rollout 节点数,C/S 为 colocate/独立节点数;越低越好。
轨迹预算消融回答「每条执行训几条轨迹」。只训主轨迹不够:前 42 步训练分更低、梯度范数更大;把预算提到 5 条后与取全部叶子轨迹的分数相当,梯度范数同样小。同一窗口内,cap=1 与 cap=5 的平均每步前反时间分别为不封顶基线的 41.4% 与 74.8%,即 cap=5 在保住分数的同时把前反时间砍掉 25.2%。这与式 (6) 的归一化互为表里:多出来的轨迹不增加执行的权重,但补上了被压缩与委派切碎的学习信号。
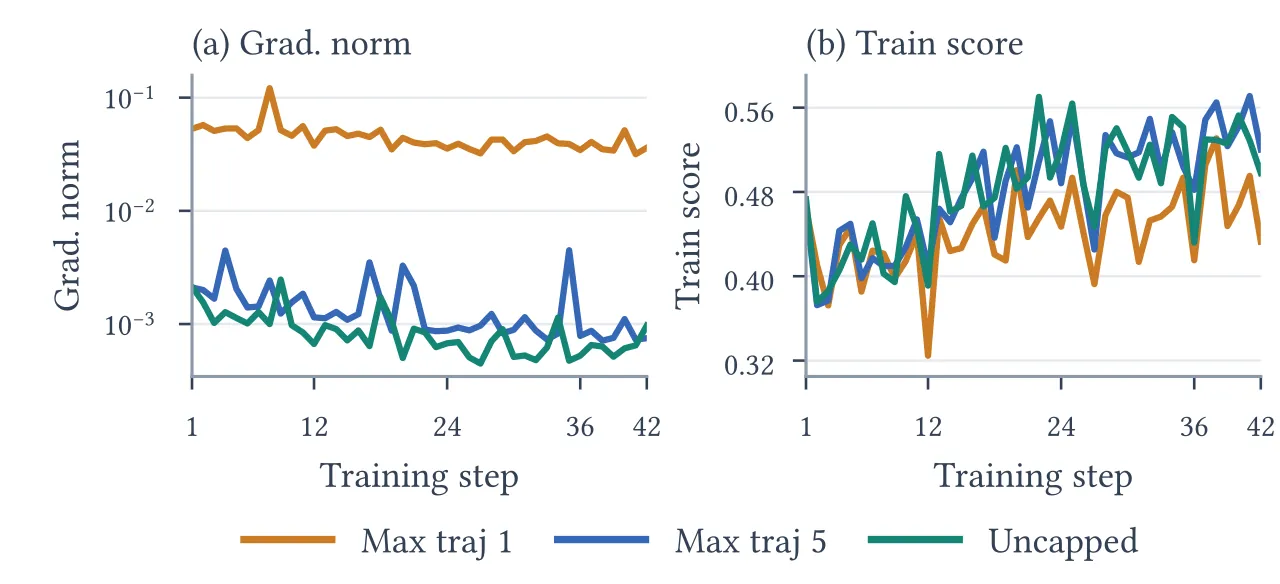
图 7:轨迹预算消融(对应论文 Figure 9,训练步 1–42)。(a) 梯度范数(对数轴);(b) 平均训练分。Max traj 1 只取主轨迹,Max traj 5 至多准入 5 条,Uncapped 取全部叶子。
局限性
作者自述的第一条局限是 GPU 预算与 cell 粒度:弹性调度需要多个可独立切换的 cell,同时保留足够 rollout 容量服务未完成执行;每个 cell 都要装下模型显存与训练并行需求,过小的 GPU 预算撑不起这种组织,而这类部署对 xLong 工作负载本就不现实。在已评测区间内少量 cell 已够(同 32 节点下 E2 只比 E0 慢 2.2%),但「总预算显著更小时的效率」未被评估。
作者自述的第二条局限是流式训练与全局 shuffle 的冲突:$\mu>1$ 时流式训练把 ready 组增量地分给 successive updates,无法在 burst 开始前跨全部 minibatch 做全局 shuffle;要支持就得等齐整个 burst 的数据再开始第一步更新,牺牲与 rollout 的重叠。依赖全局随机 minibatch 分配的训练过程因此受限;单步 burst($\mu=1$)可避开跨 minibatch 切分并保留弹性与流式(E1 比 E0 慢 10.9%,仍比 A3 快 1.24×)。作者也承认这些消融只量化执行时间,样本顺序对学习质量的影响没有被分离出来。
我的判断之一:实验面较窄且与单一 harness 绑定。三个工作负载都是软件工程/终端类,harness 全部是 Claude Code 2.1.220;式 (4) 的四类角色优先级是按 Claude Code 的主/子 agent 与 summary 结构定制的,换一套 harness(不同的压缩策略、委派语义、重试行为)需要重新定义优先级类与来源掩码,论文没有给出跨 harness 的敏感性分析。其二是比较口径:所有加速都在边界派发、同目标平均陈旧度下测得,附录 A 自己指出计数恒等式只覆盖组加权平均陈旧度,worst-case 与 token 加权保证、以及资源饱和与并发相关延迟都在假设之外;连续派发的分析(式 $\mathbb{E}_c[d]-\mathbb{E}_b[d]=1+R/B$)说明两种派发各有代价,但框架本身承诺边界派发,这一选择的适用边界留给后续工作。
总结与展望
QwenGyre 的贡献可以归成三层:调度层用水位与供给检查把 GPU 角色变成随需求迁移的资源,用 RDMA 权重拉取与预建通信组让 satellite 中途加入在途 batch;数据层用 TITO 与轨迹树保住每个输出的原始条件上下文,用部分评分把超时执行的可用进展变成有效奖励,用树上准入把分叉执行压成有界、去重、权重平衡的训练样本;验证层在旗舰 2.4T 模型、700K token 级 rollout 上给出 48 步 52.5%→58.5% 的通过率提升与跨三个工作负载最高 1.85×/1.78× 的端到端加速。
对做 agent 后训练的团队,这篇论文给出的可复用结论是:harness 的黑盒化不是障碍而是接口设计——只要 proxy 保住 token 级记录与推理可用性,调度与轨迹处理都能在外面做;而「执行、角色、样本三种生命周期解耦」是把小时级 rollout 塞进在线 RL 的前提。未决的问题同样清楚:更小预算下的弹性组织、全局 shuffle 与流式的兼容、跨 harness 的优先级与来源规则、以及样本顺序对学习质量的影响,都还是开放的。
把 harness 的执行、GPU 的角色、训练样本三者解耦:执行状态跨角色切换而存活,记录下来的模型调用按需物化成训练样本——xLong 的在线 RL 才装得进同一套集群。