QwenGyre:训练 xLong 长程智能体的弹性强化学习框架
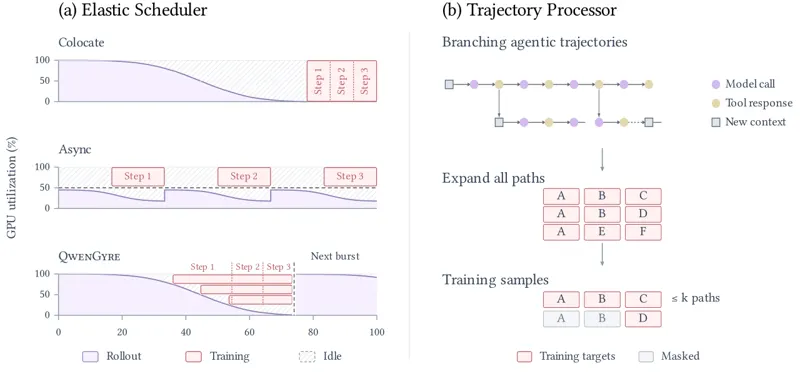
单次执行数小时、数百次模型与环境交互、生命周期近 100 万 token 的 xLong 长程智能体任务,把在线强化学习推到两个极限:rollout 长尾让 GPU 大量空转,黑盒 harness 的分叉历史又让轨迹严重冗余。QwenGyre 的回答是解耦三种生命周期——harness 执行、GPU 角色、训练样本。弹性调度器以水位 w(t)=d(t)-f(t) 为准绳在 rollout 与训练之间迁移 GPU 角色,RDMA KV-cache 迁移与 Mooncake 权重拉取把角色切换压到平均 8.52 秒与 3.46 秒,且全程不打断在途执行;轨迹处理器用 TITO 记录与轨迹树保住每个输出的原始条件上下文,为超时执行已完成的部分打分,并按 main、main-summary、sub-agent、sub-agent-summary 的角色优先级每执行至多准入 5 条轨迹,共享前缀只训一次。在旗舰 Qwen 3.8 2.4T、每条 rollout 70 万 token 的规模上,48 步把 NL2RepoBench 通过率从 52.5% 提到 58.5%,相对 Colocate 与 Async 分别取得最高 1.85× 与 1.78× 的端到端加速。
Weiqi Wang, Yuxin Zhou, Mouxiang Chen2026年9月27日
强化学习LLM智能体智能体运行时2026年9月27日