PAPER DEEP DIVE
HuMBLE:把人体步态蒸馏成能听命令的行走策略
HuMBLE 把「像人」与「听命令」拆成两阶段:先用能看到全身参考的特权教师策略在强化学习里学出物理可行的动作,再蒸馏成只看本体感受与一个 SE(2) 速度命令的学生先验;随后用短时程参考模仿环境与长时程目标命令环境各占一半的多任务强化学习微调这个先验,把命令覆盖扩到数据分布之外而不丢风格。最终策略是一个 MLP(1024,1024,1024),在 Unitree G1 的 Jetson AGX Orin CPU 上单次推理 1.1 ms,在 Atlas R1 上主方向抗推可达 1400 N;数据保真度相对教师只退化 20.83%(线速度)到 130.31%(角速度),而单阶段直接训命令条件策略在侧移上退化 240.87% 并干脆放弃响应命令。训练数据为 528,214 帧(约 3 小时)Vicon 动捕,逐帧标注 SE(2) 命令,并为小型人形提供 0.8 倍空间缩放加时间扭曲的变体。三平台硬件验证:Boston Dynamics Atlas R1、Atlas D1 与 Unitree G1。
HuMBLE: Human Motion-Driven Behavior Learning for Embodied Locomotion
Mike Zhang、Dongho Kang、Kevin Bergamin、Nicola Burger、Robin Deits、Jonathan Foster、Bilal Hammoud、Katie Hughes、Francesco Iacobelli、Twan Koolen、M. Eva Mungai、Zach Nobles、Shane Rozen-Levy、Jean Pierre Sleiman、Fangzhou Yu、Yunbo Zhang、Alfred Rizzi、Jessica Hodgins、Scott Kuindersma、Yeuhi Abe、Sylvain Bertrand、Farbod Farshidian(RAI Institute / Boston Dynamics / Carnegie Mellon University,通讯作者 Dongho Kang,dkang@rai-inst.com)
arXiv:2610.10489v1 [cs.RO],提交于 2026-10-07 · arXiv:2610.10489 · 许可 CC BY 4.0
代码状态:本文未提供公开代码仓库,也没有项目页。作者声明随文发布本研究采集的人体运动数据集(约 3 小时运动捕捉,含面向小型人形的 0.8× 预缩放变体),发布时点未在正文给出。三台验证平台中 Boston Dynamics Atlas R1 / D1 的关节级 PD 参数因保密协议未披露,Unitree G1 的完整参数在补充材料 Table S7。
一句话总结
HuMBLE 把「像人」和「听命令」拆成两阶段:先用带全身参考的特权教师策略在 RL 里学出物理可行的动作,再蒸馏成只看本体感受加一个 SE(2) 速度命令的学生先验;然后用一组短时程参考模仿环境和一组长时程目标命令环境同时微调这个先验,把命令覆盖撑到数据分布之外而不丢风格。最终策略是一个 MLP(1024,1024,1024),在 Unitree G1 的 Jetson AGX Orin CPU 上单次推理 1.1 ms,在 Atlas R1 上主方向抗推可达 1400 N,数据保真度相对教师只退化 20.83%(线速度)到 130.31%(角速度),而单阶段直接训命令条件策略在侧移动作上会退化 240.87% 并直接放弃响应命令。
一、问题:风格与命令覆盖是一对互相拉扯的目标
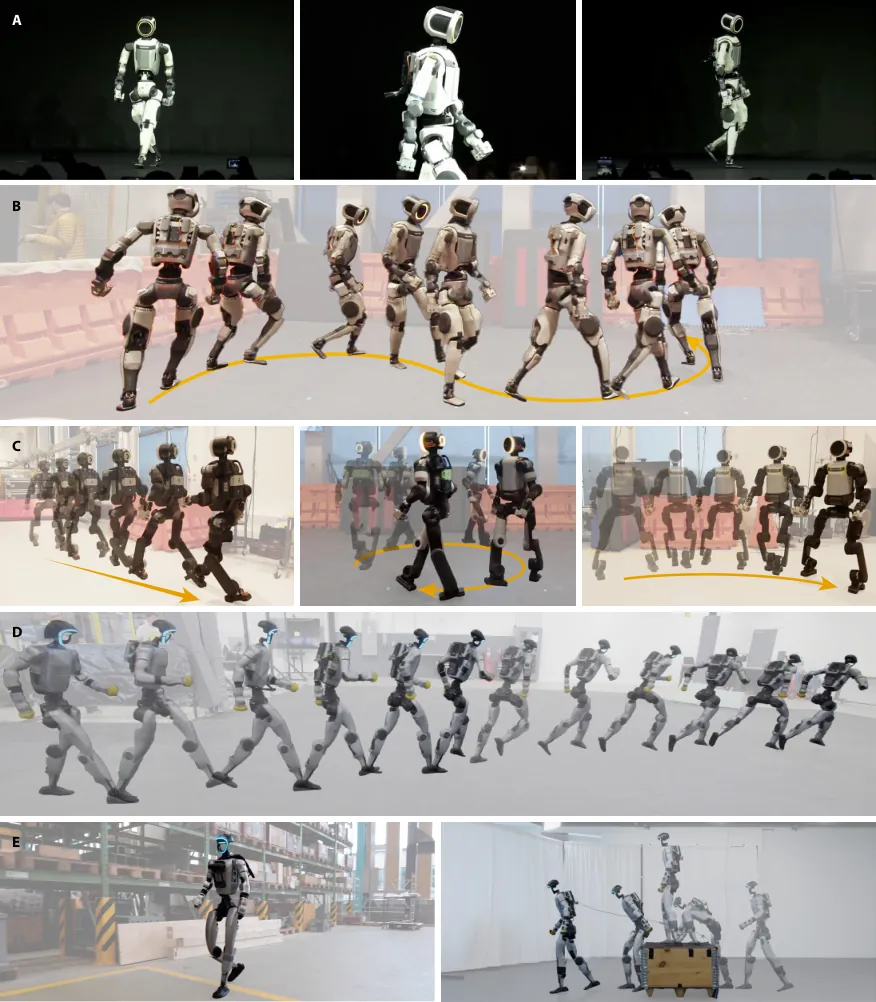
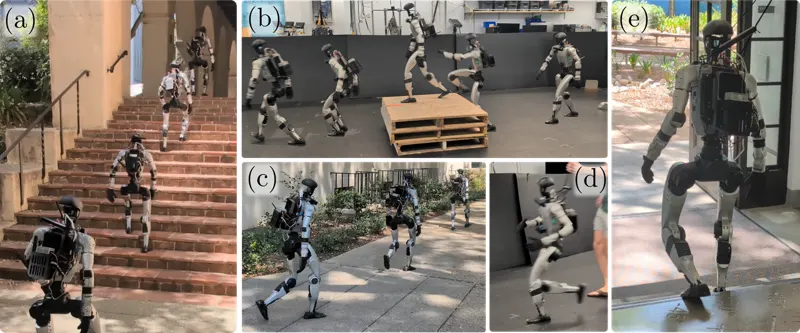
图1(论文 Figure 1):三平台的硬件结果汇总。(A) Atlas R1 在舞台上做的公开演示;(B) Atlas R1 跟随连续变化的实时转向命令;(C) Atlas D1 的后退、绕圈与侧移,展示对 SE(2) 命令空间的覆盖;(D) Unitree G1 在命令速度升高时自发从走切换到冲刺;(E) 把 HuMBLE 当作低层运动模块接进自主导航(左)与箱子 parkour(右)的分层控制栈。
类人机器人走路之所以被当成核心基准,不只因为它难,还因为它是别人一眼就能读懂的行为。论文开篇把这条线索讲得很直白:从 2000 年代初 ASIMO 谨慎的脚步到 2010 年代 PETMAN 有力量的步态,类人步态一直承担着传递社会性线索的功能——落脚时机、身体摆动、速度切换,人可以借自己在人际互动里的先验去预判机器人下一步要干什么,于是可读性、信任和可用性都跟着上来。
麻烦在于,要「像人」的同时还要「能被实时命令驱动、能可靠落到硬件上」,这三件事在已有路线里往往只能满足两件。论文把一个可部署控制器必须同时满足的条件列成三条:保住人类步态的风格质量与跨速度、跨方向的自然过渡;对大范围用户速度命令给出准确稳定的响应;延迟、内存和算力要低到能板载运行。
第一条路线是第一性原理的控制与运动生成:启发式动作生成、高层运动特征、生物力学导出的控制目标,再到今天的模型预测控制与奖励工程 RL。这条路在命令跟踪、平衡和扰动恢复上确实强,但人类步态依赖高度耦合的全身协调、接触时机的细微差别、手臂与腿的摆动轨迹、姿态以及随速度和方向变化的步态切换,用手工目标去编码这些变量太难。结果是跟踪和恢复都很好,风格却机械。
第二条路线直接把人体动作数据当监督源。角色动画里从 motion graph、交互式动作合成到 Motion Matching 都是这一脉,近年转向 VAE、GAN、扩散与 flow matching:动作数据被当成某个参考分布的样本,目标从「复现某段轨迹」变成「让合成分布对齐参考分布」。VAE 尤其常被用来把高维动作嵌进结构化隐空间供上层策略探索,也有人把它和腿式机器人的 RL 跟踪器耦合,或者用学到的步态嵌入去条件化策略。代价是这类方法难以复现示范动作的运动学结构和接触一致性,滑步和不自然关节构型这类 artifact 会直接破坏物理可行性。
第三条路线是对抗模仿学习(AIL)。它跳过「先生成运动学动作再单独跟踪」的两段式,直接用判别器奖励评价执行出来的行为与示范有多接近,一直优化到分不出来为止。AMP 是代表:RL 策略同时吃命令跟踪的任务奖励和来自动作数据的判别器风格奖励,已经在四足和人形上做出可风格化、可转向的步态;ASE 与 CALM 再引入技能嵌入和分层控制来缓解模式塌缩、保住行为多样性。问题也明确:min-max 训练对奖励缩放、判别器设计和超参都敏感,而且学到的风格奖励只能间接影响行为,用户想对涌现出来的动作做细粒度控制会很别扭。
最近扩散与 flow matching 被推到物理控制上,直接从机器人状态和命令映射到动作,省掉单独的跟踪层。表达力够,但迭代采样或数值积分这套流程和板载实时控制的延迟、算力、功耗约束很难调和。
把这些路线摆在一起,论文的取舍就清楚了:对抗式和生成式公式带来的训练不稳定、间接的行为控制、运行期推理开销,对低延迟板载人形控制都是硬伤。HuMBLE 于是把问题写成一个部分可观测马尔可夫决策过程(POMDP)——全身参考状态在训练期作为特权信息存在,但最终部署策略拿不到它。部署策略不在运行期跟踪任何全身参考轨迹,而是学会从本体感受和用户的 SE(2) 速度命令里重建出协调的全身行为,直接输出关节级动作。
只靠教师—学生蒸馏还有一个遗留问题:策略严格在参考数据的支撑集内训练,命令覆盖就被数据框死了。部署时一旦给出数据里缺失或稀疏的命令,就会出分布外失效——「快速斜向走」加上「大转向率」这种组合,摇杆能轻松打出来,人类走路却很少这么走。论文的对策借用了基础模型里预训练加后训练那套范式,但后训练不是单纯的目标条件微调,而是一个结构化的多任务 RL:短时程参考引导模仿把策略锚在人体动作流形上,长时程目标条件命令跟踪把响应性和鲁棒性推到数据支撑之外,再加一个目标条件的状态初始化方案稳住整个过程。
整篇文章的核心主张可以压成一句:把风格习得与命令空间扩张分开做。风格由显式的参考跟踪奖励守住,而不是由某个学出来的隐空间风格目标守住,于是这两者之间的平衡是直接可解释的——第二阶段那个环境分配比例就是一个能拧的旋钮。
二、预备知识:把全身参考当特权信息
理解这套流程需要四个已有构件。第一是教师—学生架构:在腿式机器人里它常被用来处理部分可观测问题,尤其是崎岖地形行走——地形几何在仿真里完全可见,在硬件上却只能部分甚至完全观测不到,于是让看得见地形的教师先学会,再蒸馏给看不见的学生。与本文最接近的用法是在物理仿真角色里,从人体动作数据学出由高层用户命令条件化的多样类人行为。
第二是 ZEST 提出的动作模仿框架。本文教师策略的训练直接沿用它的设定:相似的观测空间、奖励结构、终止条件,以及一套辅助力矩课程;关节级 PD 增益也按 ZEST 的流程,依据每个关节的投影电机电枢值来设计。
第三是参考状态初始化(RSI):环境终止时(跑完整段参考,或因偏离参考过大被提前终止),从参考数据里采一个状态、在其附近扰动机器人状态,作为新 episode 的初值。第四是 DAgger:用学生自己 rollout 出来的状态去问教师「你在这里会怎么做」,把回答当标签做监督学习,这样训练分布跟着学生自己的状态分布走,而不是跟着教师的。
三、数据集:528,214 帧与逐帧的 SE(2) 命令标注
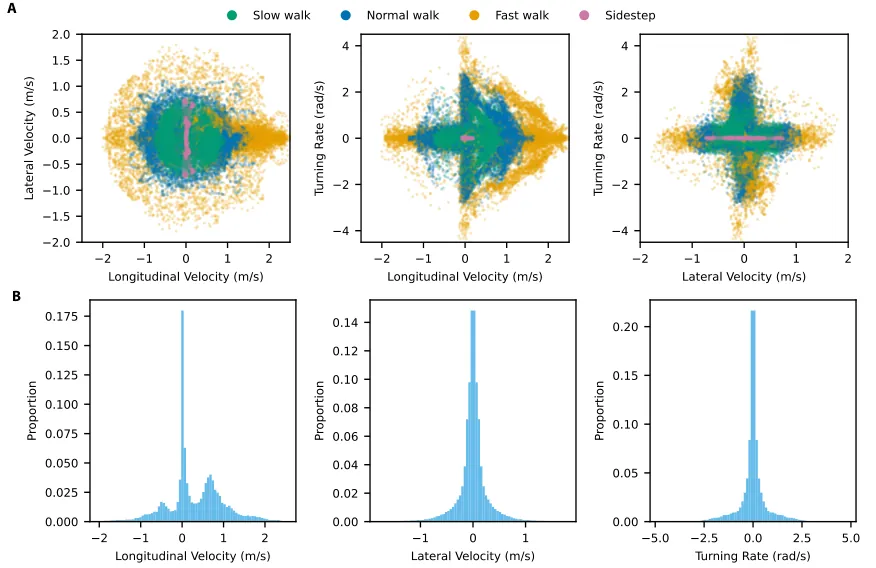
图2(论文 Figure 7):重定向到 Atlas R1 之后,数据集里标注命令的分布。为了看清最密集的区域,这张图只画标准 walking 区间(高速冲刺另有数据)。(A) 快走、常速走、慢走、侧移四种模式的命令散点(为可读性做了 10 倍抽稀);(B) 纵向速度、横向速度、转向率三个边缘分布直方图,纵轴是相对数据集规模 N=528,214 的帧占比。后面第 7 节要处理的「横向速度叠转向率」稀疏区,就是这张图上颜色最淡的角落。
数据用 Vicon 光学运动捕捉采集,帧率 120 Hz,标记点集与角色骨架按演员本人的体型和关节活动范围标定。原始标记轨迹先做后处理:缺失标记用插值和骨架运动学约束补上,再滤波去掉高频噪声;随后把角色骨架拟合到干净后的标记数据,导出成 BVH。
编舞是照着 SE(2) 躯干速度空间的覆盖来设计的,分五个速度档(慢走、常速走、快走、慢跑、冲刺),每档里复用同一批「dance card」,保证跨速度的 SE(2) 轨迹覆盖一致。结构化脚本包括四类:八方位星形(0°、±45°、±90°、±135°、180°)的离散转向;螺旋样条的连续跟踪,用来扫过一段连续的曲率半径;直线机动(起步、急停、方向反转、横向平移);零线速度的原地转,起止都落在同样的八个方位上。除结构化 take 之外还有非结构化数据,专门捕捉速度、转向、停止、起步之间的自然过渡——做法是按随机间隔向演员口头喊随机口令(开始、停、转、快走、慢走等),用高熵的指令序列压掉演员自己的下意识偏好。开发过程中还会针对观察到的能力缺口迭代补数据,比如侧移表现不佳就再采一批侧移。
BVH 到机器人轨迹要过两阶段重定向。第一阶段把动画映射到一个运动学代理骨架:关节拓扑是人类式的球关节,但连杆比例换成目标机器人的;在头、躯干、大小臂、手、骨盆、膝、脚上定义对齐帧,把重定向写成一个时空优化问题,同时求解所有时刻的代理关节姿态,最小化对齐帧之间的跟踪误差与约束违反。第二阶段再把代理动作做运动学重定向到目标机器人本体:跨所有时刻最小化约束违反与正则代价,在机器人和环境上布置碰撞基元并施加非穿透约束以防自碰撞和穿地,同时对欠约束的关节和连杆加小惩罚来抑制关节速度、维持中性姿态。
这里有一个容易被忽略但对小型人形很关键的细节。演员平均身高 178 cm,Atlas 大体对得上,但 Unitree G1 这类商用人形大约是 0.8× 的几何尺度。只做空间缩放会改掉系统动力学里的有效重力加速度,在冲刺这种带频繁腾空相的动作上跟踪精度会明显掉。作者的处理是同时做时间扭曲,把帧率乘上 $1/\sqrt{0.8}$。推导很干净:自由落体下 $z=\tfrac{1}{2}gt^{2}$,空间缩放后 $(0.8)z=\tfrac{1}{2}gt'^{2}$,代入原式得 $(0.8)gt^{2}=gt'^{2}$,于是
$$t'=\sqrt{0.8}\,t \tag{S2-1}$$
也就是时间轴压缩到原来的 $\sqrt{0.8}$,缩放后的运动学里 $g$ 的名义值保持不变。数据集因此同时提供原始序列和预缩放变体两个版本。
命令标注是逐帧做的,代表演员的移动意图,由纵向(前后)、横向(左右)线速度和转向率三个量组成。做法是对躯干线速度和角速度做有限差分、表达到躯干坐标系、再过一遍低通滤波;然后按躯干加速度把速度信号沿时间向后平移——假设是「未来的躯干速度」才是当前移动意图的合理代理。纵向和横向命令取处理后线速度的 $x$、$y$ 分量,转向率取处理后角速度的 yaw 分量。最后把所有轨迹沿矢状面镜像,既把数据量翻倍、覆盖做各向同性,也在学到的步态里强制了左右对称,保证左转向和右转向行为一致。
最终规模是 N = 528,214 帧,约相当于 3 小时人体运动数据。补充材料还提到采集范围其实更宽:踩上不同尺寸的箱子、箱子操作、限定在小支撑面内的伸手够目标、推倒恢复、夸张的走姿变体都在里面,只是这些没被 HuMBLE 使用,作者计划一并发布以支持更多样的行为研究。
四、部署策略:只有本体感受和一个平面速度命令
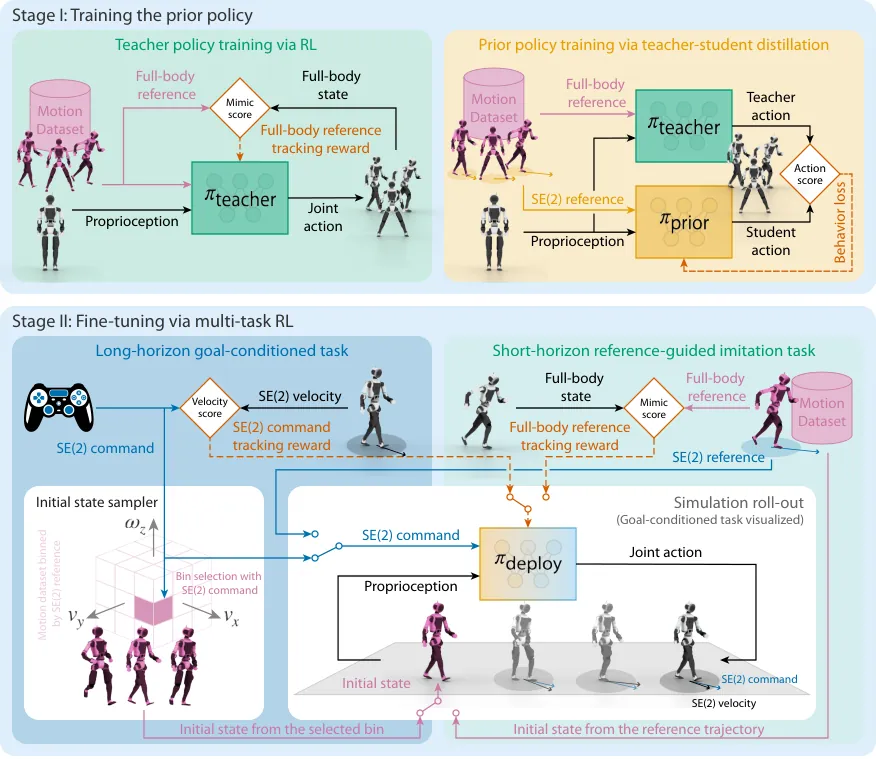
图3(论文 Figure 6):HuMBLE 的训练流水线。整条链路有三个策略实例、两个训练阶段。Stage I 里,跟踪全身参考的教师策略 $\pi_{\text{teacher}}$ 被蒸馏成只看本体感受与 SE(2) 命令的先验策略 $\pi_{\text{prior}}$;Stage II 用多任务 RL 把先验微调成最终部署策略 $\pi_{\text{deploy}}$,在扩大命令覆盖的同时保住参考数据的风格。
整条流水线的产物是一个策略 $\pi_{\text{deploy}}$,参数化为单个 MLP,把部署观测直接映射到关节动作;所有平台上的推理频率都是 50 Hz。动作 $\bm{a}_t$ 逐元素乘上预定义的缩放系数、再叠加名义关节位置,得到期望关节位置目标,交给关节级 PD 控制器跟踪。部署观测由本体感受与转向命令两部分拼成:
$$\bm{o}_{\text{deploy}}=(\bm{o}_{\text{prop}},\ \bm{o}_{\text{cmd}}) \tag{1}$$
$$\bm{o}_{\text{prop}}=\big({}_{\mathcal{T}}\bm{v}_{\mathcal{IT}},\ {}_{\mathcal{T}}\bm{\omega}_{\mathcal{IT}},\ {}_{\mathcal{T}}\bm{g}_{\mathcal{I}},\ \bm{q}_{j},\ \dot{\bm{q}}_{j},\ \bm{a}_{t-1}\big) \tag{2}$$
式 (2) 里 ${}_{\mathcal{T}}\bm{v}_{\mathcal{IT}}$ 与 ${}_{\mathcal{T}}\bm{\omega}_{\mathcal{IT}}$ 是在 IMU 传感器坐标系 $\{\mathcal{T}\}$ 里测到的线速度与角速度,${}_{\mathcal{T}}\bm{g}_{\mathcal{I}}$ 是同一坐标系下的投影重力向量,$\bm{q}_j$、$\dot{\bm{q}}_j$ 是瞬时关节位置与速度,$\bm{a}_{t-1}$ 是上一步动作。全部六项都限定为板载可测量,这是它能上硬件的前提。命令观测 $\bm{o}_{\text{cmd}}=(\hat{v}_{\text{long}},\ \hat{v}_{\text{lat}},\ \hat{\omega}_{\text{turn}})$ 就是目标纵向速度、横向速度与转向率。
注意式 (2) 里那一项线速度观测:它在部署时依赖机器人的状态估计器。Atlas 两台的状态估计足够稳,室内外都能给出可靠的线速度反馈;G1 拿到非结构化户外环境里,速度估计会有明显噪声和漂移。作者的工程对策是另外训了一个不含线速度观测的策略变体,用跟踪精度换稳定性——这条妥协在论文里没有给出量化数字。
由于 $\pi_{\text{deploy}}$ 是 $\pi_{\text{prior}}$ 微调来的,两者网络结构完全一致、共享同一套观测与动作空间。这个约束贯穿全文:先验必须能在没有全身参考的条件下,仅凭本体感受与 SE(2) 命令重建出与参考数据集一致的全身运动。部分可观测性正是靠教师—学生蒸馏来跨过去的。
五、Stage I(上):教师策略与它的奖励工程
教师策略的观测在部署观测之外再加一份全身参考状态:
$$\bm{o}_{\text{teacher}}=(\bm{o}_{\text{deploy}},\ \bm{o}_{\text{ref}}) \tag{3}$$
其中 $\bm{o}_{\text{ref}}=\big({}_{\mathcal{I}}\hat{\bm{r}}^{z}_{\mathcal{IB}},\ {}_{\mathcal{B}}\hat{\bm{v}}_{\mathcal{IB}},\ {}_{\mathcal{B}}\hat{\bm{\omega}}_{\mathcal{IB}},\ {}_{\mathcal{B}}\hat{\bm{g}}_{\mathcal{I}},\ \hat{\bm{q}}_{j}\big)$ 依次是参考躯干高度、躯干坐标系 $\{\mathcal{B}\}$ 下的参考线速度与角速度、$\{\mathcal{B}\}$ 下的参考投影重力、参考关节位置;带帽子的一律是模仿目标。奖励由三项组成:
$$r_{\text{teacher}}=r_{\text{track}}+r_{\text{reg}}+r_{\text{survival}} \tag{4}$$
$r_{\text{track}}$ 逼策略把机器人状态压到参考上,$r_{\text{reg}}$ 保证行为平滑且物理可行,$r_{\text{survival}}=c_{\text{survival}}$ 是每步都给的一个正常数,用来抵消提前终止的诱惑。终止之后按 RSI 从参考数据里采样并扰动出新的初值。
跟踪项的写法值得单独看一眼,因为它同时解决量纲不一致和准静态动作奖励虚高两个问题。对每个状态变量 $i$(躯干线速度、躯干角速度、躯干朝向、关节位置),子项都是「指数核减二次罚」的组合:
$$r_{\text{track}}=\sum_{i}c_{t,i}\biggl(\kappa_{t}\cdot\exp\Bigl(-\frac{\|\tilde{\bm{e}}_{i}\|}{\lambda_{t}}\Bigr)-\|\tilde{\bm{e}}_{i}\|^{2}\biggr) \tag{9}$$
全数据集统一取 $\kappa_{t}=5.0$、$\lambda_{t}=10.0$,用来调节指数分量相对二次罚的比重。而误差本身是按当前正在跟踪的那条轨迹 $k$ 归一化的:
$$\tilde{\bm{e}}_{i}=\bm{e}_{i}\oslash\bm{\sigma}^{k}_{i} \tag{10}$$
$\bm{e}_i$ 是原始状态误差,$\bm{\sigma}^k_i$ 是状态变量 $i$ 在轨迹 $k$ 上预先算好的标准差,$\oslash$ 是逐元素除。为防止数值不稳、也为了防止准静态动作(比如原地站立)因为标准差趋零而拿到虚高奖励,这些标准差被一个用户设定的下限 $\sigma_{i,\min}$ 裁掉。这样一来奖励尺度在不同物理单位和不同动作风格之间保持一致,整个数据集才能用同一套权重训。
正则项 $r_{\text{reg}}=\sum_i c_{\text{reg},i}\cdot r_{\text{reg},i}$ 里包含动作平滑罚 $\|\bm{a}_t-\bm{a}_{t-1}\|_2$、关节力矩罚 $\|\bm{\tau}_j\|_2$、接触脚的滑移罚、脚部 jerk 罚,以及一个脚部间隙奖励。最后这一项的设计比其余几项精细:先算间隙误差 $e_{\text{clr},k}=\max(0,{}_{\mathcal{I}}\hat{\bm{r}}^{z}_{\text{clr}}-{}_{\mathcal{I}}\bm{r}^{z}_{\mathcal{IE}_k})$,只在摆动高度不足时罚、抬得更高不罚;再用参考脚部水平速度把这个平方误差调制一遍:
$$r_{\text{reg},{\text{clr}}}=\sum_{k\in\text{feet}}\exp\Big(-\tanh\big(\lambda_{\text{clr},v}\cdot\|{}_{\mathcal{I}}\hat{\bm{v}}^{xy}_{\mathcal{IE}_{k}}\|\big)\cdot\frac{e^{2}_{\text{clr},k}}{\lambda_{\text{clr},e}}\Big) \tag{12}$$
$\tanh$ 那一层的作用是:参考脚速高时(摆动轨迹的峰值附近)惩罚被放大,脚速低时(离地与落地的瞬间)影响被压到最小。这条项在第二阶段的目标条件任务里被剔除——那时候没有参考轨迹,也就没有参考脚速可用。
训练用 PPO,配合非对称 actor-critic:critic 拿到特权环境观测和一个二值的「数据支撑指示器」:
$$\bm{o}_{\text{critic}}=(\bm{o}_{\text{deploy}},\ \bm{o}_{\text{ref}},\ \bm{o}_{\text{priv}},\ o_{\text{sup}}) \tag{5}$$
$\bm{o}_{\text{priv}}$ 包括躯干高度、末端执行器相对躯干坐标系的位置与速度、当前辅助力矩档位、广义末端力。$o_{\text{sup}}\in\{0,1\}$ 用来区分任务语境:0 表示转向命令落在数据支撑内(分布内),1 表示分布外命令。整个 Stage I 它恒为 0,因为所有命令都直接来自参考数据;到 Stage II 它才按环境类型动态置位。这是一个很小但很关键的设计——它让同一个 critic 有能力学出一个按任务支撑条件化的双重价值函数。
为了不必给每种技能单独调奖励就能吃下整个动作库,教师训练沿用 ZEST 的辅助力矩课程:给躯干施加一个外力与外力矩,由模型基 PD 控制律加一个补偿名义躯干动力学的前馈项算出:
$$\bm{f}_{\text{assist}}=m\Big({}_{\mathcal{I}}\hat{\dot{\bm{v}}}_{\mathcal{IB}}+k_{p}^{v}({}_{\mathcal{I}}\hat{\bm{r}}_{\mathcal{IB}}-{}_{\mathcal{I}}\bm{r}_{\mathcal{IB}})+k_{d}^{v}({}_{\mathcal{I}}\hat{\bm{v}}_{\mathcal{IB}}-{}_{\mathcal{I}}\bm{v}_{\mathcal{IB}})-{}_{\mathcal{I}}\bm{g}_{\mathcal{I}}\Big) \tag{15a}$$
$$\bm{\tau}_{\text{assist}}={}_{\mathcal{I}}\bm{I}\,{}_{\mathcal{I}}\hat{\dot{\bm{\omega}}}_{\mathcal{IB}}+k_{p}^{\omega}\,{}_{\mathcal{I}}\bm{I}\big({}_{\mathcal{I}}\hat{\bm{\Phi}}_{\mathcal{IB}}\boxminus{}_{\mathcal{I}}\bm{\Phi}_{\mathcal{IB}}\big)+k_{d}^{\omega}\,{}_{\mathcal{I}}\bm{I}({}_{\mathcal{I}}\hat{\bm{\omega}}_{\mathcal{IB}}-{}_{\mathcal{I}}\bm{\omega}_{\mathcal{IB}})+{}_{\mathcal{I}}\bm{\omega}_{\mathcal{IB}}\times({}_{\mathcal{I}}\bm{I}\,{}_{\mathcal{I}}\bm{\omega}_{\mathcal{IB}})-{}_{\mathcal{I}}\bm{r}_{\mathcal{B},\mathrm{com}}\times m\,{}_{\mathcal{I}}\bm{g}_{\mathcal{I}} \tag{15b}$$
系统被近似成总质量 $m$、复合刚体惯量矩阵 ${}_{\mathcal{B}}\bm{I}$(在相对躯干坐标系的名义构型下算出)的单一刚体,${}_{\mathcal{I}}\bm{r}_{\mathcal{B},\mathrm{com}}$ 是质心相对躯干坐标系的位置,$\boxminus$ 是 $SO(3)$ 上的李群差(对四元数取旋转对数映射,得到切空间里的误差向量)。参数取 $(k_p^v,k_d^v)=(0.0,10.0)$、$(k_p^\omega,k_d^\omega)=(200.0,10.0)$。
辅助力度由课程增益 $\beta\in(0,\beta_{\text{max}})$ 缩放,而 $\beta$ 的升降由一个跟踪相似度指标驱动:
$$s=\frac{1}{\bar{L}_{\mathrm{episode}}}\sum_{t=0}^{\bar{L}_{\mathrm{episode}}}\exp\Big(-\frac{\|\tilde{\bm{e}}_{j,t}\|}{\lambda_{s}}\Big) \tag{16}$$
$\tilde{\bm{e}}_{j,t}$ 是式 (10) 定义的归一化关节位置误差,$\lambda_s=10.0$,得到的 $s\in[0,1]$ 就是「这一 episode 贴参考流形贴得多好」的代理量。episode 终止时随机更新增益:以概率 $s$ 增加 $\Delta\beta_{\uparrow}=0.05$,以概率 $1-s$ 减少 $\Delta\beta_{\downarrow}=0.1$。降得比升得快,辅助只在策略持续表现出跟踪能力之后才被抽走;而 $\beta_{\text{max}}=0.75$ 的上限保证辅助始终是部分的,逼策略去探索自持动力学,不至于过拟合到被改写过的那套物理上。
域随机化覆盖观测高斯噪声、躯干随机冲量、地面摩擦、连杆质量、质心偏移、关节摩擦系数与关节零位偏移,各平台略有差异(Atlas R1 踝部并联机构的高静摩擦就专门用关节摩擦随机化去盖)。这里有一条与风格保真直接相关的排程:训练先在平地上开始,让教师策略优先把数据里的风格细节学扎实、不受环境噪声干扰;地形随机化只在教师训练过半之后才引入,并一直保留到训练结束。地形高度图(以机器人为中心、间距 0.1 m 的 $17\times 11$ 网格,展平成向量)只作为特权信息给 critic。至于为什么非加不可:G1 首次上硬件时踝部行为过刚,仿真里没问题,实机上只要落脚角度偏离名义值就频繁绊倒;加入地形粗糙度随机化后 rollout 样本多样性上来了,踝部角度与冲击条件的覆盖面才够。
六、Stage I(下):DAgger 式蒸馏
教师学会之后,先验策略用教师—学生蒸馏来训,具体是 DAgger 的一个变体:rollout 由学生 $\bm{\pi}_{\text{prior}}(\bm{o}_{\text{deploy}})$ 自己产生,每遇到一个状态就让教师 $\bm{\pi}_{\text{teacher}}(\bm{o}_{\text{teacher}})$ 作为专家给出它在同一状态下会采取的动作标签,然后按监督学习最小化两者之差:
$$\bm{\pi}_{\text{prior}}=\arg\min_{\bm{\pi}}E_{\pi}\big\|\bm{\pi}(\bm{o}_{\text{deploy}})-\bm{\pi}_{\text{teacher}}(\bm{o}_{\text{teacher}})\big\| \tag{6}$$
教师吃全身参考,学生被严格限制在部署观测空间里。正是这个信息差逼着先验把原本由教师的特权参考观测引导出来的运动先验和恢复策略内化进自己的权重。学生网络是 MLP(1024,1024,1024) + ELU,比教师的 MLP(1024,512,256) 更宽;学习率固定 1e-6,4096 个并行环境,batch 98,304(4096×24),mini-batch 3,072(切 32 份),最大 episode 长度 150 步即 3 秒。
七、Stage II:多任务 RL 微调
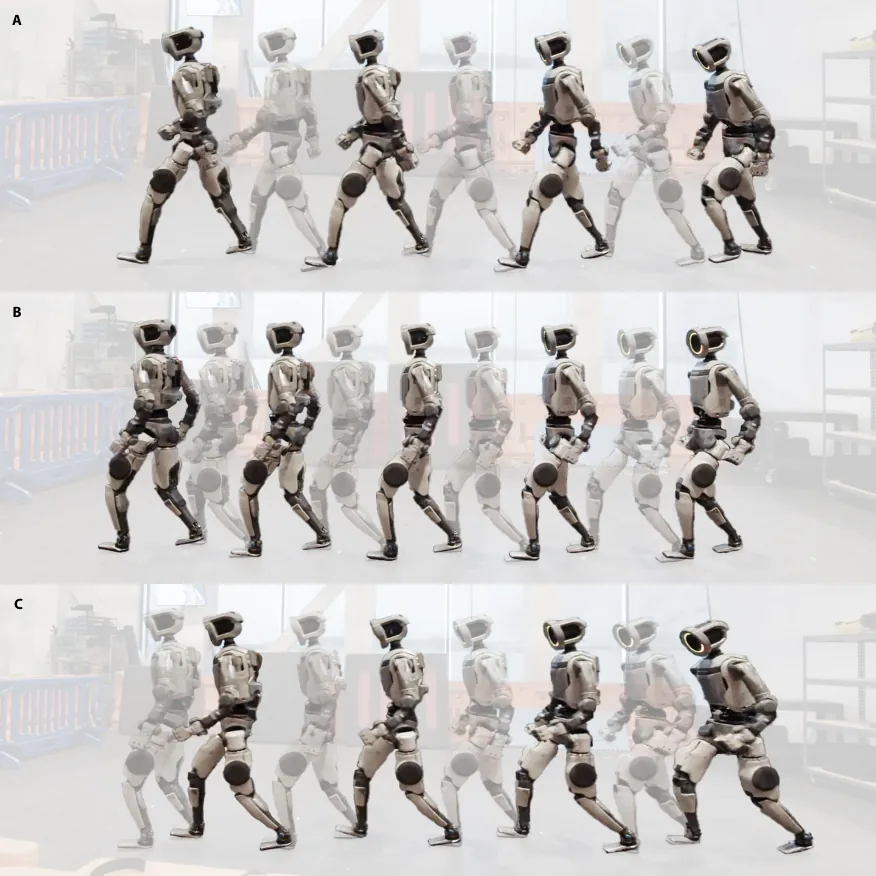
图4(论文 Figure 2):Atlas R1 在恒定前进速度命令下的频闪对比,每帧都抓在摆动相到触地的转换瞬间,用来看手臂摆动、脚跟落地、膝关节锁定这几件事是否同步。(A) HuMBLE 策略,(B) MPC 控制器,(C) Tabula Rasa RL 策略,三者都从站立姿态起步。
Stage I 的先验对数据分布内的命令保真度很高,但碰上分布外的速度命令就吃力——斜向平移叠加快速转向就是典型:摇杆够得到,人类步态里罕见。Stage II 要做的就是把命令覆盖扩到实际关心的操作范围,同时增强鲁棒性。最直接的办法是用一个「跟踪任意速度命令」的奖励去微调,但这通常导致风格塌缩:策略为了把命令跟准,把 Stage I 学到的自然运动模式让了出去。
HuMBLE 的对策是把 Stage II 写成一个多任务 RL 问题,利用并行仿真环境把它们分成两组同时跑:
$$r_{\text{fine-tune}}=\begin{cases}r_{\text{ref}} & \text{if env}\in\mathbb{E}_{\text{ref}}\\ r_{\text{goal}} & \text{if env}\in\mathbb{E}_{\text{goal}}\end{cases} \tag{7}$$
$\mathbb{E}_{\text{ref}}$ 那一组是短时程参考引导模仿任务:继续跟踪参考数据集,充当保住风格的正则器,概念上等于一次「带风格约束的经验回放」。$\mathbb{E}_{\text{goal}}$ 那一组是长时程目标条件任务:只为鲁棒地跟踪随机采样的速度命令而优化,完全不涉及任何参考跟踪目标。名义配置下两组环境各占一半(50:50)。
两组环境的 episode 长度差得很远,这不是随手设的。参考引导组沿用教师的奖励 $r_{\text{ref}}=r_{\text{teacher}}$(式 4)和 RSI 初始化,唯一区别是策略只看得到 $\bm{o}_{\text{deploy}}$、看不到 $\bm{o}_{\text{ref}}$。在这种部分可观测设定下,即使策略已经被蒸馏得会重建参考,小的跟踪误差也不可避免;而因为它观测不到参考,一旦偏离得太远就没法有效产生纠正动作,长 episode 里误差会累积,最终漂到参考跟踪奖励不再提供任何信息的地方。所以这一组刻意设成 150 步(3 秒),把强化信号聚焦在局部风格保持上,不让长期累积漂移带跑优化方向。
目标条件组不用参考轨迹算奖励,而是:
$$r_{\text{goal}}=r_{\text{cmd}}+r_{\text{reg}}+r_{\text{survival}} \tag{8}$$
$$r_{\text{cmd}}=\sum_{i}c_{\text{cmd},i}\cdot\exp\Big(-\frac{\|\bm{e}_{i}\|^{2}}{\lambda_{\text{cmd},i}}\Big) \tag{14}$$
式 (14) 里的误差有两支:线速度命令跟踪 $\bm{e}_v=(\hat{v}_{\text{long}},\hat{v}_{\text{lat}})-(v_{\text{long}},v_{\text{lat}})\in\mathbb{R}^2$,转向率命令跟踪 $\bm{e}_{\text{turn}}=\hat{\omega}_{\text{turn}}-\omega_{\text{turn}}\in\mathbb{R}$;权重 $c_{\text{cmd},i}$ 与指数尺度 $\lambda_{\text{cmd},i}$ 见补充材料 Table S6。正则项与生存项和教师那套完全一致,终止条件也共用(比如接触力过大即终止)。这一组的 episode 长度是 400 步(8 秒),允许在 episode 内重采样命令,从而把命令之间的过渡暴露给策略;除标准终止条件外,机器人跌入不可恢复状态、无法继续跟踪命令时也终止。
目标条件 rollout 的初始化用了一个专门方案,作者命名为目标条件参考状态初始化(GC-RSI):拿目标速度命令去数据集里检索标注命令相近的一帧。为了检索快,事先按标注命令把参考状态分桶建成查找表;给定查询命令,从对应桶里采一帧,再在以该帧为中心的一个时间窗内随机挑一个候选状态,最后施加一个小扰动得到初始状态。
这个机制解决两件事。其一,它把微调锚在仍落在已学行为先验支撑内的状态上:$\bm{\pi}_{\text{prior}}$ 已经会控制来自数据分布的动作,从标注命令接近采样命令的参考状态起步,策略在每个 episode 开头就能依靠自己已有的先验,不会立刻漂进分布外状态、也不会发展出一个与参考动作无关的孤立行为模式,于是命令覆盖是渐进扩出去的,风格与动力学结构都还在。其二,它避免命令与初态严重失配——这在大命令下尤其要命:逼机器人从一个不匹配的姿态猛加速,episode 往往在产生任何有意义的学习信号之前就被终止了。
最后是微调的优化细节,几处都是为了「别把已经学到的风格洗掉」。直接把 PPO 从蒸馏出来的先验上冷启动会出问题:随机初始化的 critic 给出的价值估计又噪又不可靠,actor 跟着这种估计更新,Stage I 学到的风格细节会被迅速侵蚀。所以微调的起点是同时载入 $\bm{\pi}_{\text{prior}}$ 的策略网络和教师训练阶段的 critic $V_{\text{teacher}}$。但 $V_{\text{teacher}}$ 逼近的是教师策略的价值函数而不是先验的,得先适配:在参考引导任务上做 5000 次迭代的纯 critic 预热($V_{\text{teacher}}\rightarrow V_{\text{prior}}$,策略冻结),完成后再进入完整的多任务 RL,联合训练 $\bm{\pi}_{\text{prior}}\rightarrow\bm{\pi}_{\text{deploy}}$ 与 $V_{\text{prior}}\rightarrow V_{\text{deploy}}$。
因为两组任务的奖励函数不同,critic 必须预测各自任务下的回报。这就是式 (5) 里那个 $o_{\text{sup}}$ 派上用场的地方:它只提供给 critic,作为区分当前任务域的上下文信号——短时程参考引导环境里恒为 0,长时程目标条件环境里置 1,于是 critic 学出的是一个按任务支撑条件化的双重价值函数。两组环境的优势估计还分别做归一化(与 RobotKeyframing 同样的处理),以吸收两套奖励函数之间的尺度差。此外学习率降到固定 1e-6、策略熵系数压到 0.001(教师阶段是 0.0015)、初始动作噪声标准差只有 0.16(教师阶段是 1.0)、GAE 的 $\lambda$ 从 0.95 改成 1.0——都是小步更新、护住风格的配置。
flowchart TB
    MOCAP["Vicon 120 Hz capture
actor 178 cm"] --> RET["Two-stage retarget
proxy skeleton then robot"]
    RET --> SCALE["0.8x spatial scale
time warp factor 1/sqrt(0.8)"]
    SCALE --> ANN["Per-frame SE(2) command annotation
finite diff + lowpass + backward shift"]
    ANN --> DS[("Dataset N=528214 frames
about 3 h, sagittal mirrored")]
    DS --> TEA["Stage I teacher RL with PPO
o_teacher = o_deploy + o_ref
r_track + r_reg + r_survival
assistive wrench curriculum"]
    TEA --> DIST["Teacher-student distillation
DAgger variant
student rollouts, teacher labels"]
    DIST --> PRIOR["pi_prior MLP 1024x3
proprioception + SE(2) command only"]
    PRIOR --> WARM["Critic warm start 5000 iters
V_teacher to V_prior, policy frozen"]
    WARM --> MT["Stage II multi-task RL
PPO lr 1e-6, entropy 0.001"]
    DS --> EREF["E_ref short horizon 150 steps
r_ref = r_teacher
style regularizer, o_sup = 0"]
    DS --> GCRSI["GC-RSI init
command-binned lookup table"]
    GCRSI --> EGOAL["E_goal long horizon 400 steps
r_goal = r_cmd + r_reg + r_survival
command resampled in episode, o_sup = 1"]
    EREF -->|50 percent of envs| MT
    EGOAL -->|50 percent of envs| MT
    MT --> DEP["pi_deploy at 50 Hz
1.1 ms on Jetson AGX Orin CPU"]
    DEP --> R1["Atlas R1
push recovery up to 1400 N"]
    DEP --> D1["Atlas D1
backward, circle, sidestep"]
    DEP --> G1["Unitree G1
walk to sprint transition"]
    DEP --> HIGH["Hierarchical stacks
joystick / waypoint nav / box parkour MoE 10 Hz"]
图5:按论文方法绘制的 HuMBLE 全流程。左侧数据链路(采集 → 两阶段重定向 → 缩放与时间扭曲 → 命令标注 → 镜像)产出唯一的数据集,同时喂给 Stage I 的教师 RL、Stage II 的参考引导组与 GC-RSI 查找表;右侧是三个策略实例之间的传递关系,以及最终落到的三台硬件与分层应用。
八、实验一:数据保真度——学生比教师差多少
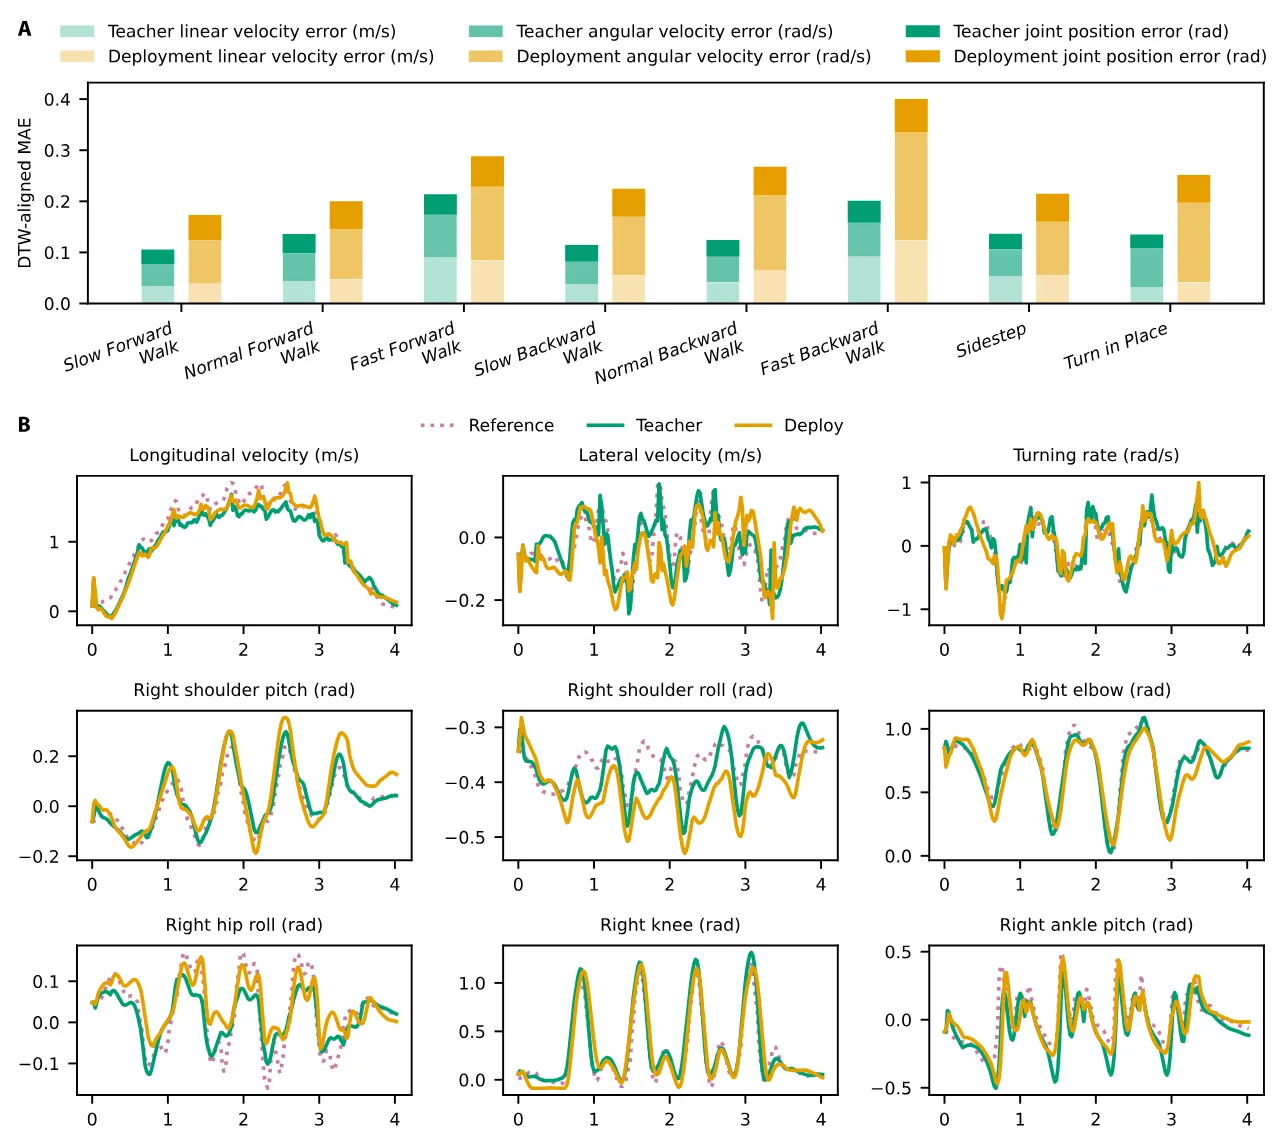
图6(论文 Figure 3):数据保真度分析。(A) 躯干线速度、角速度与关节位置相对参考动作的平均绝对误差(MAE),教师策略与最终部署策略对比,每根柱子把累计跟踪误差按三个量纲分解。(B) Fast Forward Walk 这一段上,参考动作、全身参考条件化的教师策略、命令条件化的部署策略三者对比;这里的曲线是不做 DTW 的原始时间序列,横轴是秒,展示 SE(2) 躯干速度与若干被挑出来体现类人特征的关节角(手臂摆动、髋部侧摆、膝伸展、脚跟到脚尖的滚动)。
风格质量本身是主观的、不好直接量,论文用「对重定向后人体动作数据的保真度」作为量化代理。这个代理是合理的,因为最终部署策略不吃全身参考,它必须只靠本体感受和 SE(2) 速度命令把全身行为重建出来,所以它相对参考轨迹的偏差就直接度量了它保住了数据集里多少运动模式。
对比对象选得也有讲究。除了部署策略,论文还拿教师策略当上界——教师由动作模仿框架训练、条件化在全身参考上,因此给出的是一个「物理可行的参考实现」的上界。这一步很必要:运动学参考本身常带有重定向过程引入的非物理 artifact,直接拿原始参考当上界会冤枉部署策略。
评测在仿真里做,对象是 Unitree G1 的部署策略,覆盖从参考数据里抽出的八段 canonical 动作:前进走三档速度(慢、常、快)、后退走三档速度、原地转、侧移。每段轨迹都把参考数据里标注的 SE(2) 速度命令喂给部署策略当转向命令,收集机器人轨迹。因为参考轨迹与仿真 rollout 之间微小的时序错位会人为抬高跟踪误差,比较之前先用动态时间规整(DTW)对齐:在躯干线速度、角速度、关节位置拼成的向量上算距离,在时间索引严格单调的约束下配对样本点。全套场景上 DTW 引入的平均时间位移只有 68.7 ms,说明对齐吸收了相位差而没有扭曲轨迹形状。
结果是:部署策略的 DTW 对齐 MAE 为躯干线速度 0.058 m/s、躯干角速度 0.127 rad/s、关节位置 0.055 rad;教师策略对应 0.048 m/s、0.055 rad/s、0.033 rad。也就是说部署策略在这三个分量上的跟踪误差分别比教师大 20.83%、130.31%、67.58%。论文对这个差距的解释是两层:教师能直接访问全身参考状态,而部署策略必须从部分观测里重建;此外部署策略还经过了命令条件化的微调阶段,这本身就引入了相对参考的偏离。
单看绝对值不容易判断好坏,所以论文把误差按参考轨迹自身的标准差归一化:$\sigma_{\bm{v}}=0.390\ \mathrm{m/s}$、$\sigma_{\bm{\omega}}=0.491\ \mathrm{rad/s}$、$\sigma_{j}=0.300\ \mathrm{rad}$,部署策略的误差对应 0.149$\sigma_{\bm{v}}$、0.257$\sigma_{\bm{\omega}}$、0.184$\sigma_j$。也就是说在完全看不到全身参考的条件下,它的偏差仍在参考分布自身波动的四分之一以内。补充材料 Table S1 给出了逐动作段的分解:
| 动作段(Unitree G1 仿真) | 线速度 MAE 教师 | 线速度 MAE 部署 | 角速度 MAE 教师 | 角速度 MAE 部署 | 关节位置 MAE 教师 | 关节位置 MAE 部署 |
|---|---|---|---|---|---|---|
| Slow Forward Walk | 0.0341 | 0.0388 | 0.0421 | 0.0852 | 0.0294 | 0.0491 |
| Normal Forward Walk | 0.0441 | 0.0472 | 0.0541 | 0.0979 | 0.0376 | 0.0547 |
| Fast Forward Walk | 0.0895 | 0.0847 | 0.0841 | 0.1438 | 0.0402 | 0.0598 |
| Slow Backward Walk | 0.0383 | 0.0550 | 0.0435 | 0.1149 | 0.0326 | 0.0549 |
| Normal Backward Walk | 0.0418 | 0.0643 | 0.0496 | 0.1478 | 0.0328 | 0.0555 |
| Fast Backward Walk | 0.0916 | 0.1233 | 0.0665 | 0.2112 | 0.0427 | 0.0657 |
| Sidestep | 0.0537 | 0.0546 | 0.0523 | 0.1054 | 0.0304 | 0.0549 |
| Turn in Place | 0.0322 | 0.0418 | 0.0753 | 0.1555 | 0.0275 | 0.0544 |
| 均值 | 0.0480 | 0.0588 | 0.0551 | 0.1269 | 0.0330 | 0.0553 |
表1:论文 Table S1 的完整数值(单位依次为 m/s、rad/s、rad)。DTW 的平均时间规整量教师侧为 10.05 ms、部署侧为 68.73 ms。
这张表里有几处比均值更有信息量。第一,角速度是学生损失最大的分量(0.0551 → 0.1269,翻了一倍多),而且它在八段动作里没有一段接近教师——转向与朝向调节是 SE(2) 命令里最难仅凭命令与本体感受重建的部分。第二,Fast Forward Walk 是唯一一段部署策略的线速度 MAE 反而低于教师的(0.0847 对 0.0895),说明在高速前进这种数据密集区,第二阶段的命令跟踪微调确实能把线速度压得比纯模仿更好。第三,后退走的退化幅度系统性地大于前进走(Slow Backward 线速度 0.0383 → 0.0550,Fast Backward 0.0916 → 0.1233),后退本来就比前进更依赖视觉与外感知,只给本体感受时损失更大。第四,Sidestep 的部署侧线速度与关节位置几乎追平教师(0.0546 对 0.0537、0.0549 对 0.0304 除外),但它的平均时间规整量高达 169.4 ms,是全部动作里最大的——横向动作的相位对齐最难,误差的绝对值小并不代表时间结构对得准。
Figure 3B 补的是时间结构这一维:不做 DTW、直接看原始时间序列,部署策略在线速度、角速度以及肩、肘(手臂摆动)、髋 roll(侧向平衡与躯干调节)、膝(支撑腿伸展)、踝 pitch(落脚与脚跟到脚尖滚动)这些代表关节上,都紧跟教师与参考的相位和幅值趋势。考虑到它只拿到本体感受和一个 SE(2) 命令,这说明它保住的不只是被命令的躯干运动,还有数据里那套上下肢协调模式。
九、实验二:命令覆盖、响应速度与抗推
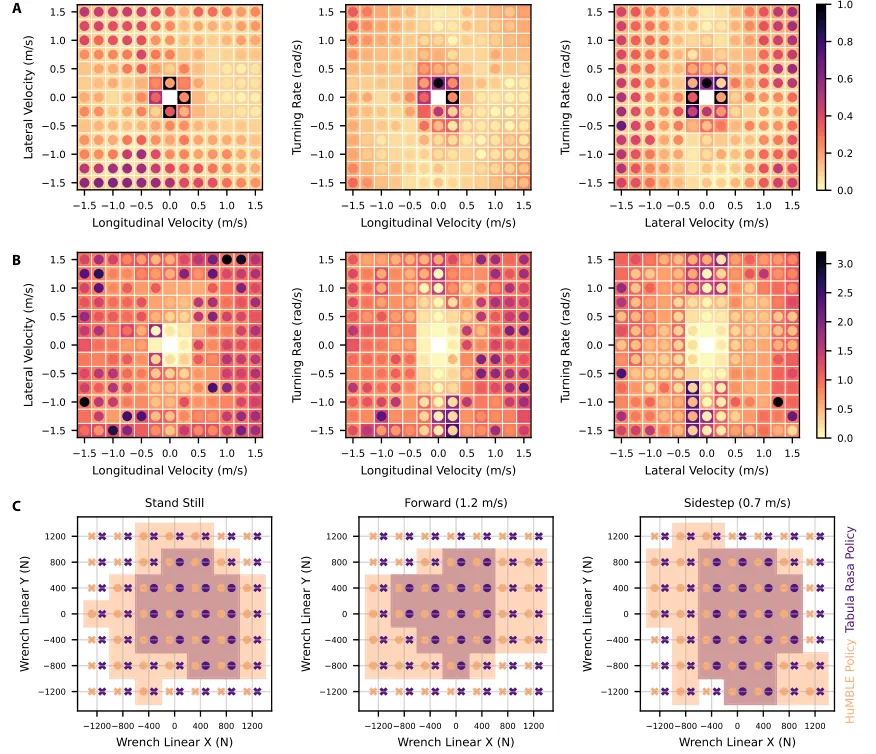
图7(论文 Figure 4):Atlas R1 的量化性能分析,对比 HuMBLE 与 Tabula Rasa 两个策略。(A) 稳态相对命令跟踪误差:SE(2) 命令空间用三张二维切片可视化,从左到右分别把 $\omega_{\text{turn}}$、$v_{\text{lat}}$、$v_{\text{long}}$ 置零;每个格子里外框方块是 Tabula Rasa 基线、内圈圆点是 HuMBLE,颜色越浅表现越好。(B) 上升时间(秒),可视化方式同上。(C) 抗推鲁棒性:三种运动场景下施加平面方向、不同幅值的推力,阴影区近似 HuMBLE(橙)与 Tabula Rasa(紫)的成功恢复包络,圆圈表示恢复成功、叉表示摔倒。
对照组是 Tabula Rasa RL 策略:观测空间与动作空间和最终部署策略完全相同,也是从本体感受加 SE(2) 命令直接映射到关节动作,但完全不用人体动作数据,只靠手工奖励函数塑形出涌现式步态;它的正则项因此比 HuMBLE 复杂得多(躯干竖直/roll/pitch 惩罚、偏离名义构型惩罚、关节软限位、脚部加速度与 jerk 惩罚、滑步惩罚、脚相对躯干的 yaw 限制、贴地项、力矩与关节加速度惩罚,外加鼓励摆动腿滞空时间与最大摆高 0.15 m 的脚部间隙轮廓)。课程也不是辅助力矩——它没有参考轨迹可依——而是一个随跟踪保真度自适应扩张或收缩的速度命令采样范围课程。PPO 超参与 HuMBLE 教师阶段相同,域随机化设置完全一致,终止条件与 HuMBLE 的目标条件任务对齐。作者也明确写了这个基线「可能不代表全局最优的控制设计」,它的定位是在完全相同的观测、动作与域随机化规格下,一个可部署、命令跟踪鲁棒的代表性参照。
评测协议借鉴经典控制的阶跃响应分析:对每个命令施加阶跃输入,稳态取阶跃后 3.0 s 的躯干速度,上升时间定义为从阶跃开始到首次达到稳态躯干速度 90% 的时长;相对命令跟踪误差是稳态误差除以命令幅值。所有策略都在 Isaac Lab 里训练与评测,同时用一套基于 MuJoCo 的仿真管线交叉验证响应性、命令覆盖与鲁棒性——那套管线是经过硬件验证的高保真代理,能反映实际部署约束。
Figure 4A 的结论是:在评测的 SE(2) 命令空间大部分区域,HuMBLE 的相对跟踪误差与 Tabula Rasa 基线相当;最显著的误差出现在动作数据里代表不足或缺失的命令区域,比如快速斜向走。反过来,在接近零速度的命令上 HuMBLE 优于基线,作者把这归因于数据里包含慢速小步挪移(slow shuffling)的参考——对于「很小但非零」的移动命令,任务奖励优化很难自己发现合适的步态,而动作先验直接给了。
响应性上(Figure 4B),两个策略在命令幅值变大时上升时间都变长;Tabula Rasa 基线通常更快达到大命令,HuMBLE 在高速区给出的是更平滑、更渐进的响应。这个模式和人体动作数据里固有的加速度轮廓一致,也正是「自然过渡」与「激进命令跟踪」之间那个取舍的直接体现。
鲁棒性测试用平面力推躯干:力以 0.2 s 连续脉冲施加,时机是策略达到稳态速度之后,测试全程目标命令保持不变;场景有静止站立、前进走、侧移三种。摔倒的判据是躯干俯仰或横滚倾角超过 30°,或躯干高度低于名义站立高度的 40%(Atlas R1 的取值)。结果是 HuMBLE 在 Atlas R1 上主方向能扛住最高 1400 N 的推力。更有意思的是抗推能力呈现出与步态运动学紧密对齐的方向依赖性:前进走时纵向抗推强于横向,主要来自矢状面的腿摆动与前进过程中形成的有效支撑多边形;侧移时站姿更宽,横向稳定性上去、纵向稳定性下来。
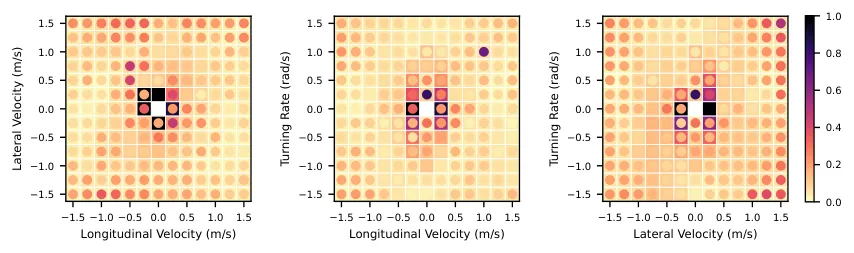
图8(论文 Figure S2 的一部分):Atlas D1 的同一套量化评测——稳态相对命令跟踪误差与上升时间热力图,切片方式与 Figure 4 相同(从左到右 $\omega_{\text{turn}}=0$、$v_{\text{lat}}=0$、$v_{\text{long}}=0$)。补充材料另给 Unitree G1 的 Figure S3,并注明 G1 因重定向时施加了空间与时间缩放,评测所用的命令范围与 Atlas 两台不同。
三台平台的评测指标细节各不相同,但趋势一致:HuMBLE 策略在命令跟踪精度、响应性与扰动鲁棒性上都与 Tabula Rasa 基线相当,代价是高速区上升时间略长——论文把这一点直接归因于从人体参考学来的自然加速度轮廓,而不是能力缺陷。
十、实验三:Sim-to-real 与板载实时性
迁移一致性用阶跃响应在仿真与实机上分别跑同一批代表性命令来比:前进走、后退走、侧移、原地转、前进绕圈各取慢/常/快几档。每段 rollout 都从机器人零命令静止站立开始,然后施加一个矩形脉冲命令、保持一段时间、再回到零。同时报告整段 rollout 的 MAE(捕捉阶跃瞬态的差异)与稳态误差;线误差取纵向与横向跟踪误差的较大者。Atlas R1 的结果如下(摘自论文 Table 1):
| 命令 $(v_{\text{long}},v_{\text{lat}},\omega_{\text{turn}})$ | 稳态误差 Sim | 稳态误差 Real | MAE Sim | MAE Real |
|---|---|---|---|---|
| 前进走 (0.4, 0.0, 0.0) | (0.08, 0.02) | (0.12, 0.03) | (0.10, 0.10) | (0.11, 0.10) |
| 前进走 (1.2, 0.0, 0.0) | (0.03, 0.02) | (0.06, 0.07) | (0.10, 0.15) | (0.10, 0.18) |
| 前进走 (2.0, 0.0, 0.0) | (0.13, 0.11) | (0.20, 0.06) | (0.15, 0.13) | (0.18, 0.16) |
| 后退走 (-0.9, 0.0, 0.0) | (0.10, 0.02) | (0.20, 0.10) | (0.11, 0.12) | (0.14, 0.16) |
| 侧移 (0.0, -1.0, 0.0) | (0.27, 0.04) | (0.25, 0.09) | (0.19, 0.08) | (0.21, 0.11) |
| 原地转 (0.0, 0.0, 2.0) | (0.02, 0.27) | (0.06, 0.34) | (0.10, 0.22) | (0.10, 0.25) |
| 原地转 (0.0, 0.0, -3.0) | (0.07, 0.53) | (0.05, 0.60) | (0.11, 0.34) | (0.13, 0.39) |
| 前进绕圈 (1.0, 0.0, -1.5) | (0.08, 0.25) | (0.11, 0.33) | (0.10, 0.18) | (0.13, 0.24) |
表2:Atlas R1 的 sim-to-real 对比(摘自论文 Table 1)。每格为(线误差 m/s,角误差 rad/s)。论文完整表还包含 (-0.3,0,0)、(-1.5,0,0)、(0,±0.7,0)、(0,±1.0,0)、(0,0,±1.0)、(0,0,±2.0)、(0,0,3.0)、(1.0,0,±1.0)、(1.0,0,1.5) 等行;Atlas D1 与 Unitree G1 的对应结果在 Table S2。
整体读法:仿真与实机的跟踪误差高度吻合,绝大多数命令的差值被限制在线误差 0.05 m/s、角误差 0.10 rad/s 以内。命令越激进误差越大,最极端是 3.0 rad/s 的原地转,稳态角误差在仿真里就到 0.47–0.53 rad/s、实机 0.42–0.60 rad/s。关键在于这个上升趋势在仿真和实机两侧同样出现,所以它不是迁移失败,而是任务本身在命令空间边缘变难;不过论文也承认,正是在最激进的那块区域,sim-to-real 的缝隙会略微张开(前进绕圈 1.5 rad/s 的 MAE 从仿真 0.10/0.18 到实机 0.13/0.24 就是一个例子)。
实时性方面,因为策略只是一个轻量 MLP,它能在全部三个平台上板载实时运行:Unitree G1 上用 ONNX Runtime 在机器人的 NVIDIA Jetson AGX Orin CPU 上测得平均单次推理 1.1 ms(控制频率 50 Hz,即周期预算 20 ms)。Boston Dynamics 两台的推理时延因保密协议未给出。摇杆部署时转向输入还会被处理成有界的变化率,作者的取舍是牺牲一点响应性换更平滑的驾驶手感。
十一、消融:三个设计选择各自的贡献
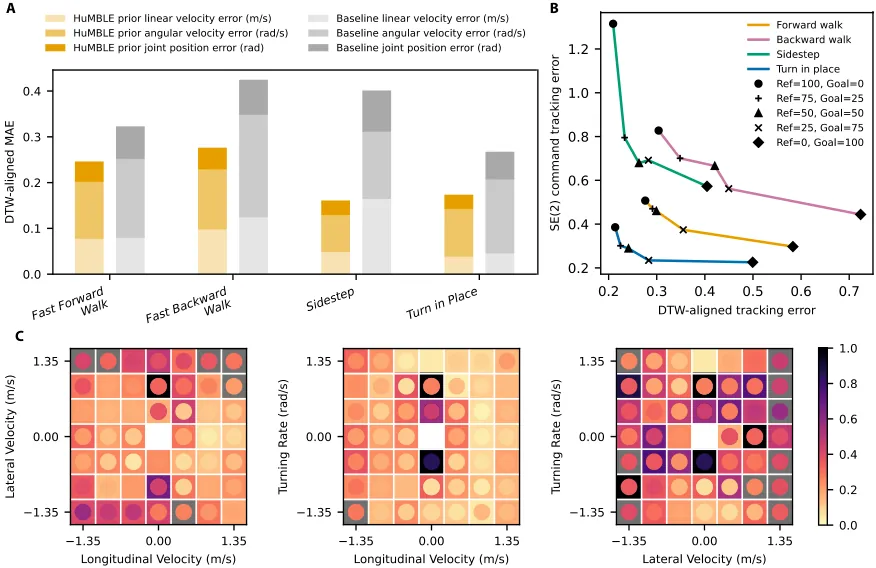
图9(论文 Figure 5):三项消融。(A) 教师—学生蒸馏的作用:Stage I 蒸馏得到的先验策略(橙)对比直接用命令条件策略做单阶段 RL 的基线(灰),堆叠柱状图是 DTW 对齐后的分量 MAE。(B) 多任务 RL 的效力:在四种 canonical 模态上扫描环境分配比例,同时看数据保真度与命令跟踪性能。(C) RL 微调的影响:最终部署策略(内圈)相对其初始化来源、也就是 Stage I 先验(外框方块)的稳态相对命令跟踪误差;灰格表示先验策略在该命令下无法鲁棒跟踪、机器人摔倒。
第一项消融问的是:教师—学生蒸馏到底是不是学出可靠命令条件先验的必要条件,还是可以直接在部署观测空间下用模仿奖励从参考动作训出来?对照的 $\bm{\pi}_{\text{baseline}}(\bm{o}_{\text{deploy}})$ 用的是同一套部署观测空间、同一个跟踪奖励 $r_{\text{teacher}}$,也就是逼它只靠本体感受和转向命令去重建参考轨迹;为了控制变量,它沿用与教师训练阶段完全相同的非对称 critic 结构与超参。评测在 Unitree G1 仿真上做,指标与前面的保真度分析一致。
| 对比对象(相对 HuMBLE 先验策略的 MAE 增幅) | 线速度 | 角速度 | 关节位置 | 定性结果 |
|---|---|---|---|---|
| 单阶段基线,Fast Forward Walk / Fast Backward Walk / Turn in Place 三段合计 | +16.36% | +54.85% | +70.87% | 能复现参考动作,但误差一致偏高 |
| 单阶段基线,Sidestep | +240.87% | +80.54% | +186.34% | 走几步后停在近似站立姿态,不再响应转向命令 |
| Stage II 配比 0:100(纯目标条件) | 保真度迅速丧失 | 前进与后退走出现躯干扭动、手臂摆动与参考不一致 | ||
| Stage II 配比 100:0(纯参考引导) | 命令覆盖不足 | 无法执行侧移命令,摔倒(横向命令在数据里本就稀疏) | ||
表3:论文第 5 节三项消融的关键数值与定性观察。前两个数字组来自 Figure 5A,后两组来自 Figure 5B 的极端配比。
差距在侧移上被放到最大,而侧移恰恰是最吃协调的行为——它需要横向平衡与精确的全身时序。单阶段基线在这里不是「跟得不准」,而是根本没能重建出该行为:迈出几步之后就落到近似站立的姿态,对转向命令不再作反应。作者的结论是,单阶段的部分可观测模仿能恢复一部分运动模态,但在保住数据里全部行为多样性上不可靠;教师—学生蒸馏的价值在于把两种难度拆开:教师先在仿真里学出全身参考的一个动力学可行的实现,学生再把这个行为蒸馏进部署观测空间。
第二项消融扫的是 Stage II 的环境分配比例:从同一个 Stage I 先验出发,分别以 0:100、25:75、50:50、75:25、100:0 五种配比微调(前一个数是参考引导环境占比),然后同时评参考跟踪保真度与命令跟踪。保真度那一侧用从对应参考动作标注出来的时变 SE(2) 命令驱动策略,报告 DTW 对齐的全身跟踪误差,benchmark 段与前面一致(Fast Forward Walk、Fast Backward Walk、Sidestep、Turn in Place);命令跟踪那一侧用各模态的恒定命令驱动——前进走 $(1.35,0,0)$、后退走 $(-1.35,0,0)$、侧移 $(0,1.35,0)$、原地转 $(0,0,1.7)$,报告平均速度跟踪误差。曲线合起来刻画的正是多任务微调目标诱导出的 Pareto 折中:参考引导占比越高越贴数据,目标条件占比越高命令跟得越准。两个极端各自暴露一种失败模式(见表3),而名义的 50:50 是一个可用的中间点。作者把这个比例定位成一个可解释的超参,可以按想要的部署行为去调。
第三项消融直接把 Stage I 先验与最终部署策略摆在同一张命令网格上比稳态相对跟踪误差(Unitree G1,沿用主实验的阶跃响应协议)。先验在数据分布密集的区域保持合理的跟踪水平,但在参考数据稀疏或缺失的区域迅速退化:若干高速命令区里它无法鲁棒响应转向命令,出现动力学失稳与频繁摔倒;最突出的是横向运动叠加偏航——正是 Figure 7 里数据集最稀疏的那块区域,摔倒不可避免。微调后的部署策略在整个操作空间上跟踪误差一致更低、命令覆盖大幅扩张,并且在全部测试用例里没有一次摔倒,也没有塌成不自然的步态。这一项给出的判断很硬:只做教师—学生蒸馏不足以达到真实部署要求的响应性与命令覆盖,Stage II 的多任务 RL 微调是让这套人形运动策略在通用运动任务上鲁棒工作的关键环节。
十二、分层应用:把 HuMBLE 当低层模块
论文用三个场景说明这个策略可以作为低层运动模块被上层驱动:摇杆直接给 SE(2) 速度目标的操作员控制;带障碍与危险区避让的自主导航(在仓库环境里规划路径抵达 waypoint);以及把 HuMBLE 与单独学出来的攀爬行为组合起来的箱子 parkour。摇杆部署时策略在实验室与真实环境里都稳定且响应宽命令范围,并表现出平滑的涌现式步态切换:低速命令下是小步挪移,中速是名义步幅的常速走,高速则是大步幅、带明显腾空相的冲刺。
箱子 parkour 的实现细节在补充材料 S7,它展示了这套分层框架可以怎么搭。高层策略是有感知的,以 10 Hz 输出 SE(2) 速度命令 $(v_{\text{long}},v_{\text{lat}},\omega_{\text{turn}})$ 加上一组门控权重;低层是三个冻结的预训练专家——HuMBLE 策略、上箱策略、下箱策略,各自 50 Hz 输出关节位置目标。速度命令先经低通滤波防止突变,再按每个专家需要的表示分发:HuMBLE 直接收速度命令,两个攀爬专家收的是把速度命令积分得到的 SE(2) 位姿 waypoint。三个专家的输出按归一化后的门控权重做加权平均,得到最终动作。只有高层有感知,低层专家都是非感知的。Unitree G1 在含一个和两个箱子的环境里完成了多种长时程导航任务,硬件上 zero-shot 部署,走、上箱、下箱之间的切换与串联都由高层在线选择和混合专家来完成。
两个攀爬专家的训练方式与 HuMBLE 教师有交集也有差别,值得记一笔:它们同样用 PPO 做参考引导模仿、借鉴 ZEST,但命令定义成 SE(2) 位姿 waypoint 而不是速度(每时刻由参考动作及其镜像在 0.5 s 前瞻时域上定义一个期望未来位姿,表达在机器人躯干朝向坐标系里,并对 waypoint 命令加高斯噪声以吸收高层规划器的误差);而且它们不吃全身参考状态,因此不需要蒸馏就能直接部署,也更能泛化到没见过的条件;critic 的特权信息换成跟踪分数和一个沿参考轨迹从 0 递增到 1 的任务相位变量。高层策略则分两阶段训:先只练走、上箱、下箱三个基元任务且等概率采样,再加入「走接上箱」「上箱接下箱」「下箱接走」三个复合任务,复合任务的采样概率是基元的一半;它观测本体感受、SE(2) 目标位姿命令和局部高度扫描,critic 额外拿到躯干高度、以及攀爬动作专用的躯干高度相对参考的误差。
十三、局限
作者自述了三条。其一,结果只覆盖平地。虽然通过更充分的域随机化立刻就能扩展到轻度地形粗糙度,但楼梯攀爬、全身攀爬、跨越障碍这类更一般的运动场景仍是开放问题:它们既需要一整套新的、能捕捉这些敏捷行为的人体运动参考,也需要训练一个条件化在地形观测上的策略,从而在部署时引入外感知传感。
其二,命令标注只适配 SE(2)。本文的做法是采集之后做后处理,估计演员的移动意图、给每一帧标注一个 SE(2) 速度命令。这对 SE(2) 很直接,因为命令可以从参考轨迹本身算出来;但要扩展到更复杂的转向模态就不成立了,比如引入自然语言这类高层语义标注,可能需要人工标注或更高级的 captioning 技术。
其三,网络容量与可扩展性没做严格分析。作者刻意选了一个参数量不大的简单 MLP 来压低部署时的算力与内存开销,结果证明这个紧凑架构足以内化并从速度命令重建全身行为、装下 N=528,214 帧(约 3 小时)的数据分布。但参数量如何影响性能、这个架构的容量上限在哪、策略在什么边界条件下开始抓不住数据分布,都还是开放问题。
以下是我在读完全文与补充材料后补充的判断。第一,保真度只在 G1 上量化过。八段 canonical 动作的 DTW-MAE 全部来自 Unitree G1 仿真;Atlas R1 与 D1 拿到的是热力图(Figure 4、Figure S2)和 sim-to-real 表(Table 1、Table S2),衡量的是命令跟踪而不是风格保真。也就是说「三平台都保住了人体风格」这句话,在同一把尺子下只对一台机器人成立。
第二,用 MAE 当风格代理是有代价的。论文自己承认风格质量本质主观、难以直接度量,所以用对重定向数据的保真度做代理。但 MAE 低不等于看起来自然:Table S1 里 Sidestep 的部署侧线速度误差(0.0546)几乎追平教师(0.0537),时间规整量却是全表最大的 169.4 ms,说明数值接近的同时时间结构可能差得远。全文没有任何人类主观评价(用户研究、偏好排序),而这篇论文的卖点恰恰是人类能读懂的步态。
第三,「与基线相当」的强度受基线调参水平限制。Tabula Rasa 基线由作者自己实现,论文原话是它「可能不代表全局最优的控制设计,性能会随 RL 公式的不同而变化」。命令跟踪与抗推包络的对比结论因此是一个内部对照,而不是与外部已发表方法的对照。
第四,鲁棒性只报了成功/失败的二值包络。推力测试给出的是「能不能不摔」,没有恢复时间、恢复期间的轨迹偏差或能量消耗;1400 N 这个数字因此只说明包络边界在哪,不说明边界附近的行为质量。另外 G1 户外部署要靠状态估计器给线速度观测,作者为此另训了一个不含线速度的策略变体,明说它会降低速度跟踪精度,但这个精度损失没有量化。
十四、总结与展望
这篇论文的骨架是一次职责划分:风格归第一阶段,覆盖归第二阶段。第一阶段用带全身参考的特权教师把 3 小时人体动作数据里那些难用奖励工程逼出来的东西——同步的手臂摆动、支撑腿的膝锁定、脚跟落地到脚尖滚动的接触过渡、随速度变化的步态切换——学成一个动力学可行的实现,再用 DAgger 式蒸馏压进一个只看本体感受和 SE(2) 命令的 MLP;第二阶段用一组短时程参考引导环境和一组长时程目标条件环境同时微调它,前者当风格正则器、后者扩命令覆盖,靠 GC-RSI 把每次 rollout 的起点锚在先验支撑内、靠 $o_{\text{sup}}$ 让同一个 critic 学出双重价值函数、靠 5000 步纯 critic 预热避开冷启动把风格洗掉的问题。
证据链也是完整的:保真度用 DTW 对齐的 MAE 加标准差归一化给出(0.149$\sigma_v$ / 0.257$\sigma_\omega$ / 0.184$\sigma_j$),命令覆盖与响应性用阶跃响应热力图对着一个同规格的手工奖励基线给出,鲁棒性用 1400 N 的方向依赖推力包络给出,迁移一致性用 Atlas R1 的仿真—实机成对误差给出,实时性用 1.1 ms 的 CPU 推理给出,而三项消融分别钉住了蒸馏、多任务配比、微调这三个设计选择的必要性——尤其是侧移那个例子,单阶段基线不是跟不准,而是走几步就不干了。
往前看,论文自己在讨论部分把这套东西抽象成了一条配方,这条抽象可能比任何一个具体步态更有价值:框架本身对「运动」这件事几乎没有特设假设,只要凑齐三样原料——一份动作数据集、一个能逐帧标注上去的命令信号、一个衡量该命令跟踪的奖励——就能把一个相对简单的动作模仿策略扩成命令条件策略。作者点名的下一步是其它欠约束的命令模态,比如从稀疏的手部与底盘输入做遥操作:策略要重建全身行为,和 HuMBLE 对 SE(2) 命令做的事在结构上是同一件。再往外是全身 loco-manipulation 与人形遥操作,用更大规模、更多行为模态的人体动作数据;一个简单 MLP 能不能装下这些、这条两阶段流水线能不能吃下这种复杂度的数据分布,是作者留给自己的核心问题。
金句
风格不靠某个学出来的隐空间目标去守,而靠一条显式的参考跟踪奖励去守——于是「像人」和「听命令」之间的平衡不再是一次赌博,而是一个可以拧的旋钮:把多少并行环境留给参考,就保住多少步态。