Uber 法律修订代理诞生记:四轮迭代磨出律师信任的 AI
Uber 把合同修订代理做进 Word:四轮迭代(RAG→反馈→语气→代理式修改)后审阅时间降 20%+、AI 决策准确率 91%,提示词归律师所有。
很少有领域像法律工作这样要求精确与审慎,这也让它成为检验 AI agent 能否进入日常专业工作的最硬考场之一。从 2024 年初到 2025 年,在今天这些 agent harness 尚未普及之前,Uber 构建了第一代法律修订代理(Legal Redlining Agent,LRA)。它帮助 Uber 法务团队处理大批量的合同谈判,既不牺牲信任与合规,也不取代律师的判断。
这段经历里最持久的教训,与模型或架构无关,而是如何把一个 agent 真正带进律师的日常工作。Uber 从业务问题出发:源源不断的合同谈判中存在大量可重复的修订(redline)工作。他们把工具做到律师原本就在工作的地方——Microsoft Word 里,让 LRA 在既有工作流中标记有风险的修订并给出修改建议;再与律师紧密迭代 agent 该做什么,2025 年在法务团队试点,把反馈持续折回产品。
本文记录 Uber 把第一代系统带进实践所学到的东西:如何界定问题、如何赢得律师的信任、如何借助他们的反馈改进 agent;最后交代第一代系统的实际工作方式,以及在 agent 技术已经演进的今天,团队会如何重新解决这个问题。
2026 年 3 月 9 日,LRA 作为 Uber 法务部门申报材料的一部分,获得 ALM Legalweek Leaders in Tech Law Awards 的「年度最具创新力法务部门」奖。
问题:高风险、高摩擦
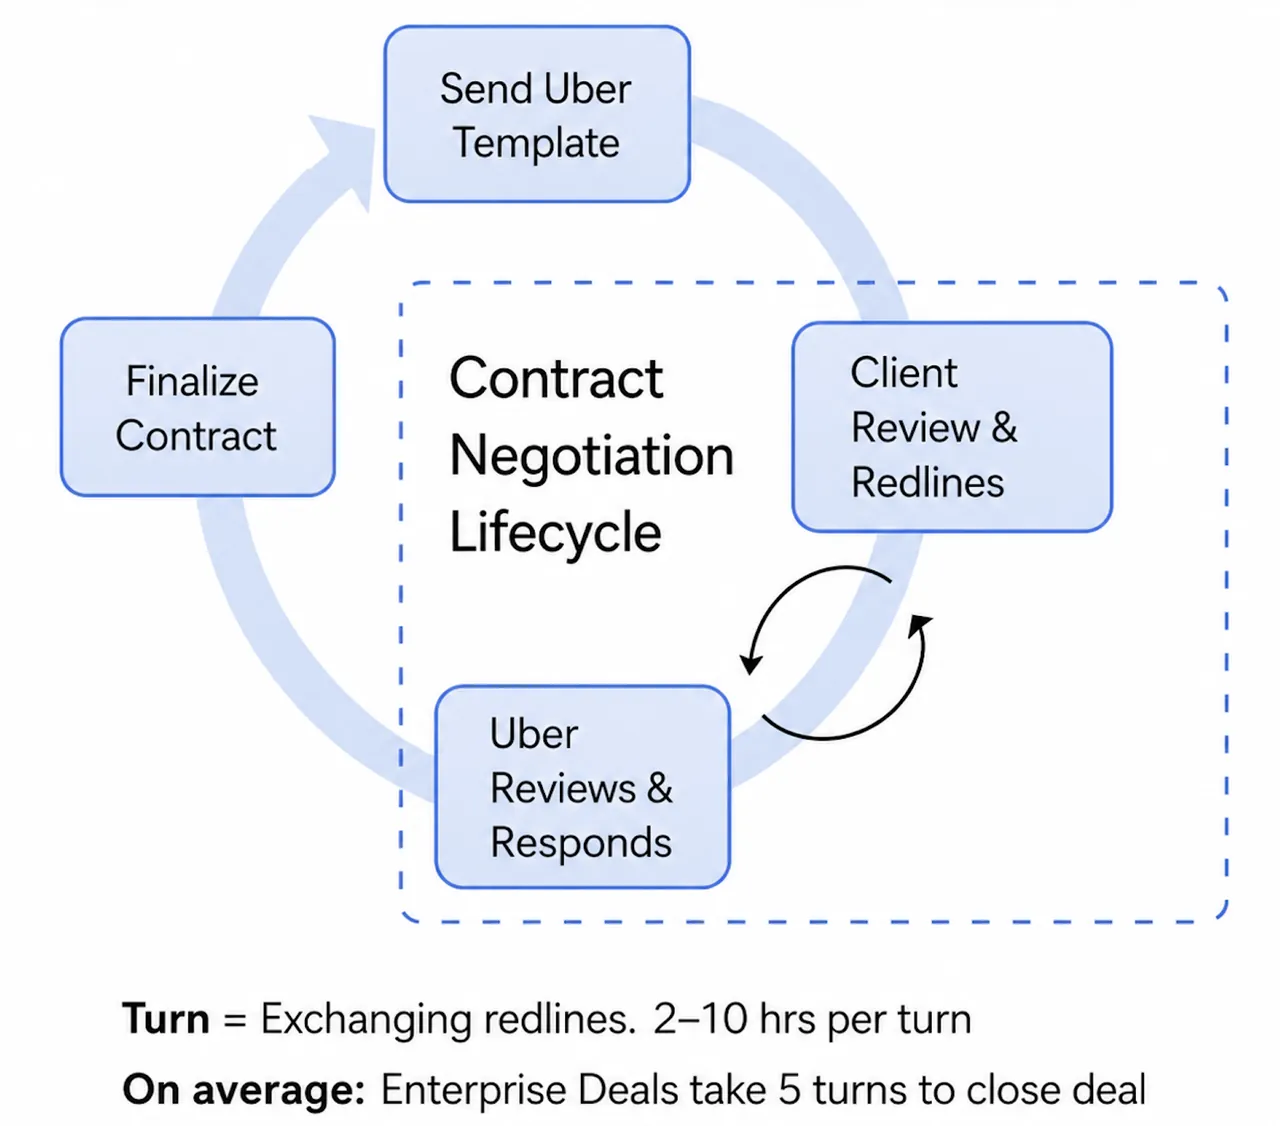
Uber 每年要谈判数千份合同,每一份背后都有法务团队在审阅与磋商。这个过程耗时、重复,常常成为交易、入驻与发布的瓶颈。它是高风险、重细节的工作,精确性至关重要,而延误会向销售、入驻和发布各个环节扩散。
但在这个高风险流程内部,埋着一种出人意料的结构性:相似的条款、跨客户可重复的修订、稳定的法律推理模式。换句话说,那里存在一个清晰的系统。
由于法务工作对 Uber 属于任务关键型,团队看到了机会:把可重复的部分自动化,把律师的时间留给复杂的判断,同时不牺牲质量与一致性。
解法:AI 驱动的修订代理
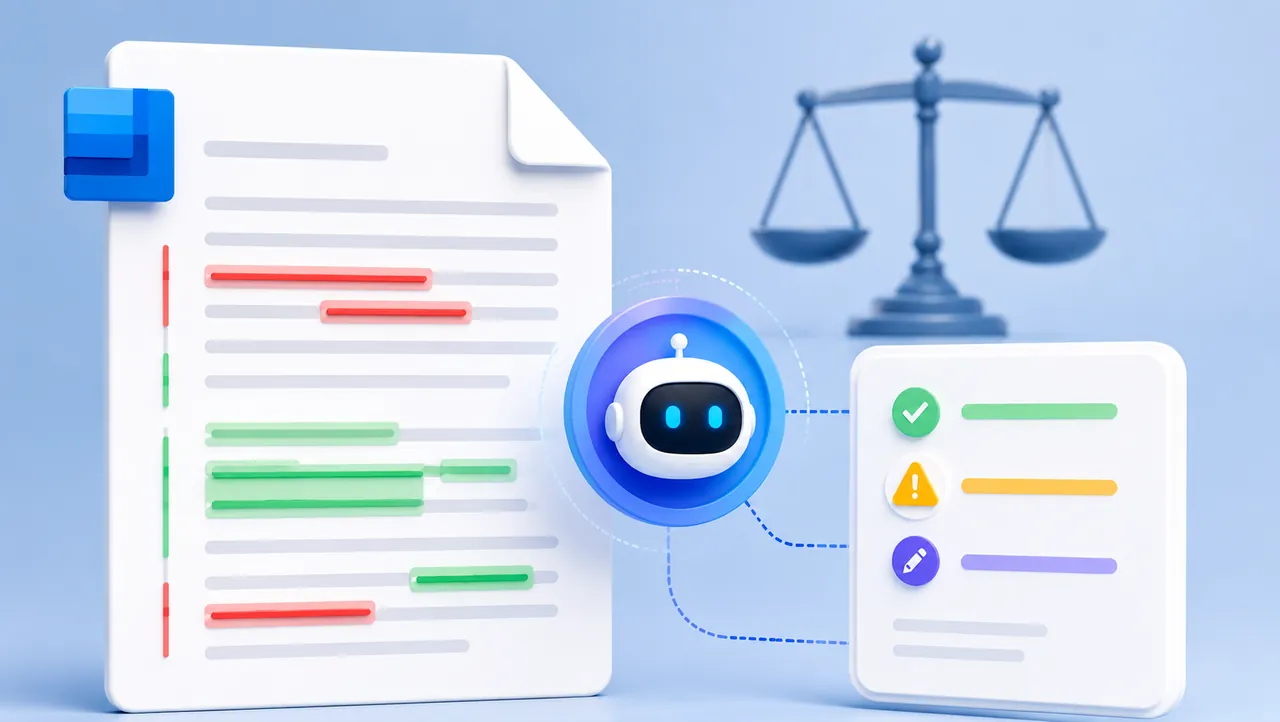
法律修订代理是一个直接集成进 Microsoft Word 的 AI 助手插件,落在律师原本的工作位置上。它审阅客户编辑、理解意图、给出符合政策的响应建议、生成结构化批注、标记风险,并从反馈中持续学习。它组合了六项能力:
- 文档审阅:识别修订,区分客户做的编辑与 Uber 律师做的编辑。
- 意图检测:解释一处修改究竟想达到什么目的。
- 符合政策的建议:接受、拒绝或修改条款。
- 批注生成:向对方解释 Uber 的法律立场。
- 风险标记:标出需要律师深入审阅的条款。
- 自学习反馈闭环:持续改进后续建议。
在法务团队上线以来,Uber 观察到平均合同审阅时间下降超过 20%,AI 生成决策的准确率达到 91%。律师的反馈包括:「它真的为我省了时间,尤其是批注建议。」
法律修订代理是什么?
插件分析 Microsoft Word 文档,识别来自外部方的所有修订;再用 AI 处理这些变更,试图理解客户的意图与法律含义,并把拟议变更与团队的法律政策及指引做比对。
基于这一分析,插件生成一系列建议:推荐动作、给客户的拟议批注(用法律推理为建议辩护)、以及每处变更的风险等级评估。Uber 律师随后逐条审阅建议,决定接受、拒绝或修改,再最终并入给客户的回复。
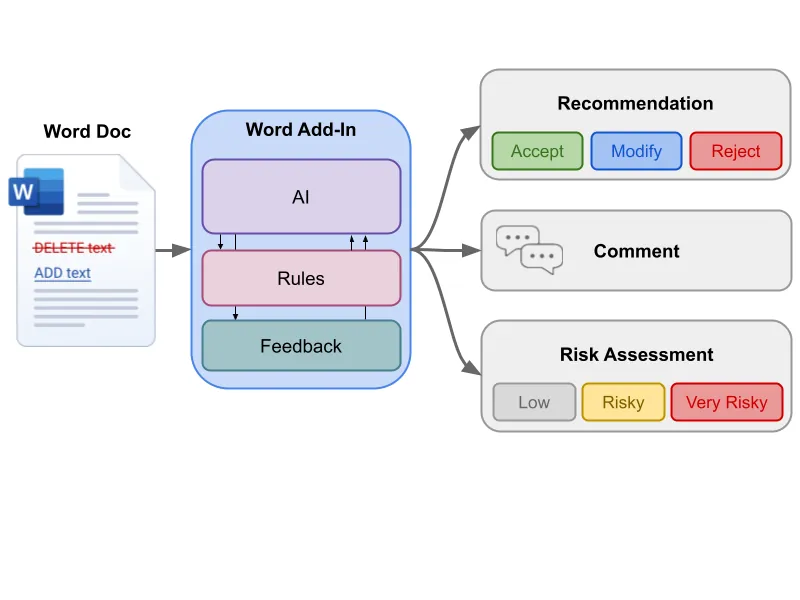
四轮迭代,走向律师信任的 agent
上面这套系统并非一次成型。走到这里经历了四次大迭代,每一次都教给他们「法律 AI 到底需要什么」的硬教训。过程中团队使用了 Uber 的 GenAI Gateway,得以把精力完全放在打磨产品逻辑上,并与领域专家紧密协作。
| 迭代 | 重点 | 硬教训 |
|---|---|---|
| 1. RAG | playbook 检索 + LLM 裁决 | 语义相似、语气、泛化在真实谈判中全部失效 |
| 2. 反馈 | 来自律师决策的自学习闭环 | 细粒度反馈(期望动作、批注、最终文本)才让 agent 变准 |
| 3. 语气 | 独立的语气调制环节 | 塑造输出声音的提示词必须归领域专家所有 |
| 4. 代理式修改 | 起草反提案、规则库 | 起草妥协条款才是真正省时间的地方;硬政策需要确定性护栏 |
迭代 1:RAG
最初的方案是搭一个基础 RAG(检索增强生成)系统。法务团队提供既有 playbook 与谈判回合样例。假设是:摄入这些 playbook、检索语义相关段落,再把这些段落连同对方拟议变更一起喂给 LLM,系统就能给出合理决策。
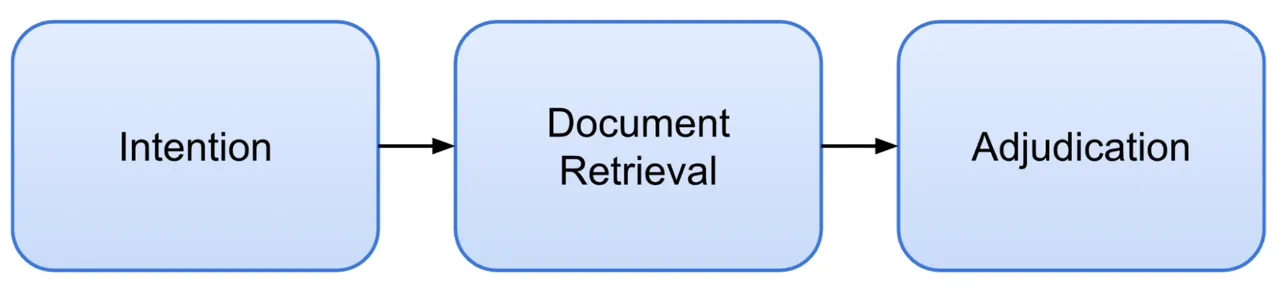
三个问题很快出现:
- 语义相似不准。用来做嵌入的「键」与要检索的内容性质差异很大,导致语义相似搜索不精确,应用决策不可靠。
- 语气不当。谈判中回复的语气至关重要。应用经常生成要么过度防御、要么过分积极的回复,造成不自然、不可接受的沟通。
- 缺乏泛化。遇到 playbook 未明确覆盖的谈判场景时,应用几乎随机应答,在新情境下没什么用。
迭代 2:反馈
认识到只用 playbook 的局限后,团队明白 agent 必须更具适应性、能从真实交互中持续学习,于是构建了由律师直接反馈驱动的自学习闭环。最初的反馈机制很简单:保存律师的决定(接受/拒绝/修改)、原文、修订和一个「踩」的信号。这提供了基本误差信号,但缺少关键细节。
为加深系统理解,反馈闭环演进为记录律师的期望动作与具体批注;当 AI 获得起草修改的能力后,又进一步收集律师实际使用的最终修改文本。这份细粒度数据成为转折点:它让系统能把对方的意图直接映射到律师精确、改进后的语言上。agent 开始明显变准,逐渐适应团队偏好的风格与谈判姿态。
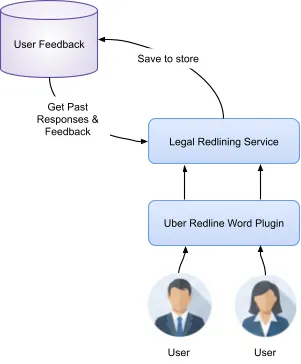
团队还开始在建议界面里直接展示相关的历史反馈与规则。这让律师看到为什么会生成这条建议,建立信任,也让他们清楚看到是什么影响了 AI 的输出。
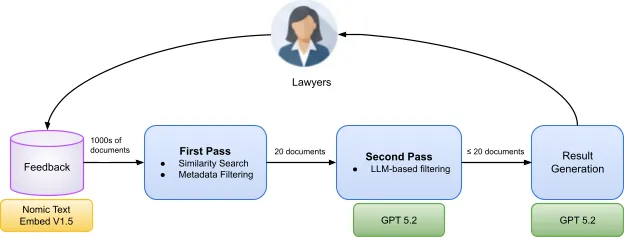
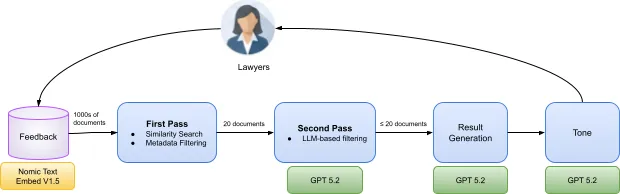
运行时,agent 查询已积累数千次历史交互的反馈库。系统先做带元数据过滤的相似搜索,把候选缩到约 20 篇相关文档;再经过第二层过滤,用最先进的 LLM 校验其与用户及对方意图的一致性;然后分析最相关的样例,决定接受还是拒绝拟议变更,并为对方生成批注。
为构造后续提示词的上下文,团队实现了指数衰减加权算法:优先近期决策,确保 agent 适应法律立场的漂移、缓解概念漂移,同时保持同意/不同意样例的均衡分布。这种动态、均衡的 few-shot 提示让修订工具近乎实时地学习用户偏好与政策细节,无需手动微调模型。
迭代 3:语气
为了解决语气这一顽疾,团队在处理流水线末端加了一次额外的 LLM 调用,专门调制输出的语言风格。但法律谈判中的语气比听起来难得多。早期输出在两种失败模式间摇摆:有时过度防御、对抗;有时又不当地迁就、讨好。两者都不符合律师在真实谈判中克制、专业的语气。
突破来自与内部法务团队的紧密协作。既然语气是法律沟通的关键成分,工程师就让律师直接拥有定义期望语气与对话风格的具体语言。工程团队管理三段式提示词的「骨架」,内部法务团队管理它的「内容」。
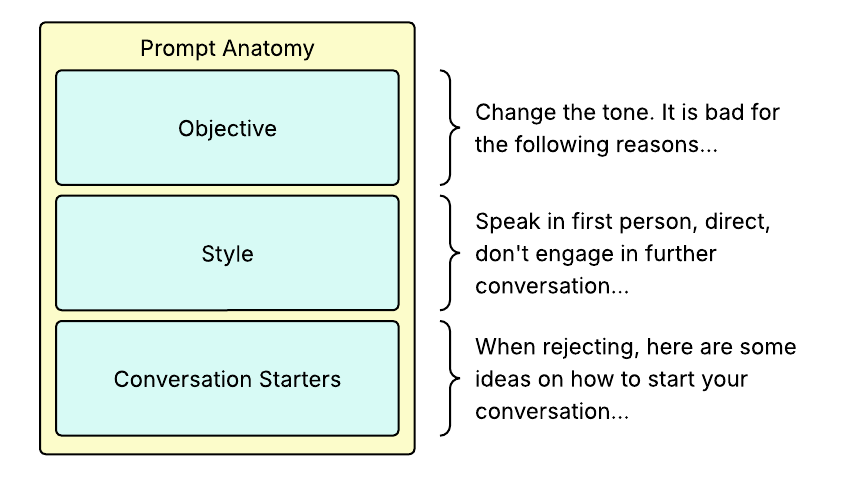
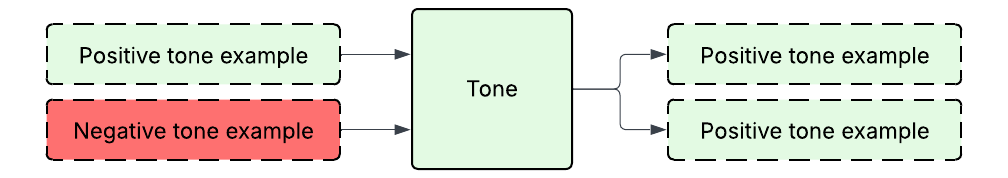
律师最先更新的是 objective 段。它定义语气调制 agent 的角色,并实现一种主动且悲观的反思技术:假定 agent 生成的批注已经带有此前遇到过的那些问题。其他反思技术往往靠复杂循环收敛到期望行为;团队发现,「假定质量差」不会影响正面样例,却能以很高的可靠性、仅一次就纠正负面样例。他们把这归因于复杂度下降:单条提示词里 LLM 少做一个决策;没有循环也限制了 token 用量与延迟。
接着,提示词规定律师偏好的风格:由于 agent 是代表律师给出第一轮回复,它必须直接、第一人称、不进行闲聊。最后一段是开场句,由 Uber 内部律师撰写作为 few-shot 样例。几天之内,律师就把它调校到与自己的声音精确一致。
这带来一个关键洞察:直接影响输出格式的提示词,应由应用的领域专家或最终用户撰写与管理,AI 团队负责引导以确保符合提示词最佳实践。
迭代 4:代理式修改
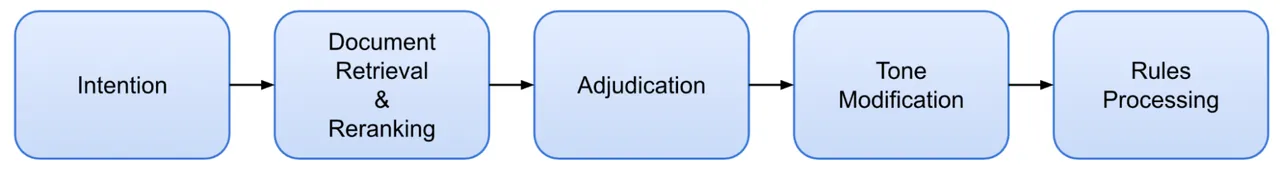
判断接受还是拒绝一处变更固然有价值,但对律师来说真正省时间的是起草反提案。简单的生成式文本经常幻觉出条款内容,或偏离合同的定义术语。为此团队从简单文本生成走向代理式工作流:当得出 MODIFY 决策时,引用历史反馈与规则来精炼条款。这让工具能帮律师起草高质量的妥协语言,既反映既往法律意见,也纳入公司对每一类问题的整体风险立场。
规则库
最后,团队意识到律师经常使用自己的模板,且模板常跨团队共享。这带来两个好处。其一,可重复的问题:律师收到的问题有大量共性,反复用一致语气表述 Uber 立场非常耗时。其二,一致的搜索键:原始文档始终使用相同语言,因此文档发生变更时可以生成可靠的搜索键。
为利用这些好处,Uber 为律师构建了规则库:律师可以在原始模板文档中选中重要或常被修改的文本,并为其关联一条规则。一条规则封装 Uber 的立场、任何退让位置、以及期望的应用响应示例。当应用检测到变更时,对修改后的句子在规则索引上做语义向量搜索;若某条规则高置信命中,就注入上下文窗口;为确保严格遵循,流水线末端再加一步 LLM 校验,确认最终输出与检索到的规格精确一致。
当工具扩展到更多业务线时,规则库还有第二个好处:帮助律师在全公司范围内保持法律立场的一致。
架构
架构遵循瘦客户端模式:Word 插件负责文档交互与用户输入,Python 后端编排所有 AI 操作。律师触发分析时,后端运行 LangGraph 工作流,并行执行意图检测、风险评估与政策查询;向量存储(OpenSearch)提供记忆层,检索相关规则与历史反馈来支撑每一个决策。
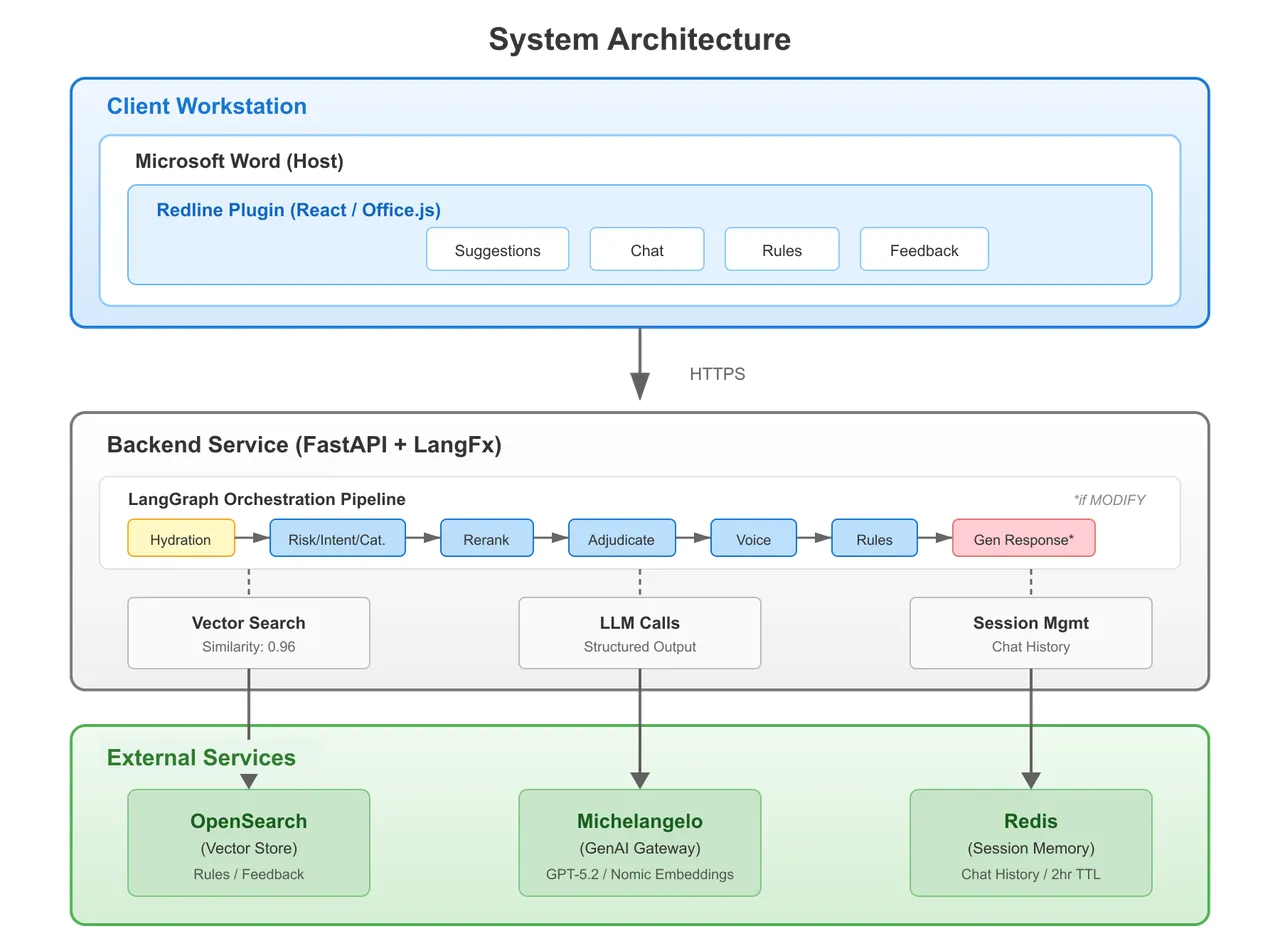
Microsoft Word 插件:在律师工作的地方见面
一个关键设计决策是把它做成 Microsoft Word 插件,而不是独立 Web 应用。律师生活在 Word 里,要求他们在工具间复制粘贴会直接杀死采纳率。插件基于 React 与 TypeScript,以任务窗格形式与文档并排运行;通过 Office JavaScript API 与 Word 通信,读取修订标记、应用修改、高亮待审条款。
这次集成并非没有挑战。Office JavaScript API 天生慢,需要在应用层做激进缓存、尽量减少与 Word 的往返来优化;修订标记 API 存在边缘情况,某些文档结构会导致崩溃,需要防御式加载策略;修订中被删除的文本返回空字符串,迫使团队维护自己的文本状态以准确显示 diff。这些约束塑造了架构:瘦客户端小心地编排 Word 操作,后端承担全部 AI 重活。
高性能编排
团队通过并行化独立图节点同时优化延迟与准确率。例如 Intention 节点分析对方的实质意图时,Risk Level 节点并发评估该条款的危险画像。
混合决策引擎:规则 vs 学习
为在灵活性与合规之间取得平衡,系统对「硬逻辑」与「软逻辑」区别对待。对不可谈判的政策,使用确定性规则引擎:与标准 RAG 不同,它只在目标句子的严格语义匹配时触发;规则一旦命中,就作为硬护栏覆盖模型。对可谈判的细节(语气、策略),依赖概率性的反馈闭环。这种双轨让系统从第一天起就靠规则给出高置信结果,同时让反馈闭环积累数据去处理更复杂、非结构化的场景。
基于反馈的自学习
自学习能力的核心是一个免除手动微调的反馈闭环。系统对每一次律师交互捕获完整快照:原始上下文(合同文本、对方修订)、AI 的分析(意图、风险等级),以及最关键的——律师的完整回应:最终决定、实际应用的文本修改、写下的理由。这份细粒度数据让系统不仅建模「决定了什么」,还建模「为什么」,从而在未来的相似场景中复现资深律师的分寸感。
时间加权自学习
为防止概念漂移(模型过度依赖过时的法律立场),团队实现了基于指数衰减的自定义反馈采样算法:为上下文窗口检索 few-shot 样例时,对每次历史交互计算权重:
weight = exp(-lambda * age_days)
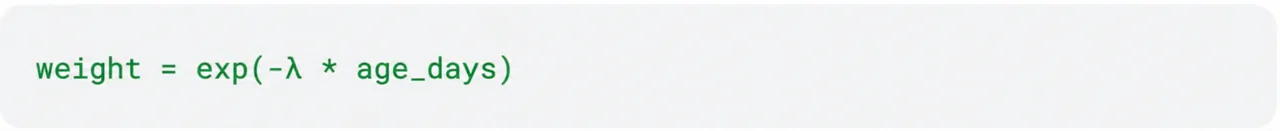
其中 lambda 对应可配置的半衰期,目前设为 365 天。这确保模型适应法律立场的漂移,而不过度依赖过时先例。实际上,系统近乎实时地学习团队当前的偏好,就像人类同事感知新规范一样。
数据存储与向量检索
知识库依赖 OpenSearch,使用 nomic-embed-text-v15 嵌入做高维语义检索,维护两个主索引:
- 规则索引:存储法律政策,按目标句子向量化。
- 反馈索引:存储历史谈判数据,按对方意图(而非原始文本)向量化,从而捕获语义相同但措辞不同的变更。
检测到新修订时,系统对这两个索引做语义向量搜索,检索最相关的规则与历史决策,确保 AI 拥有给出建议所需的精确上下文。
提升规则与反馈的检索精度
这个问题空间的一个优势是:谈判总是从同一份源合同开始。因此学习与反馈可以锚定到同一文档多轮交互中的相同段落。系统先把法律合同按 ;、. 或换行符切成小块;每当遇到修订,就回查原始源句子,检索保证相关的历史出现或显式规则;每当用户提供反馈,也使用同一句逐字源句子入库。
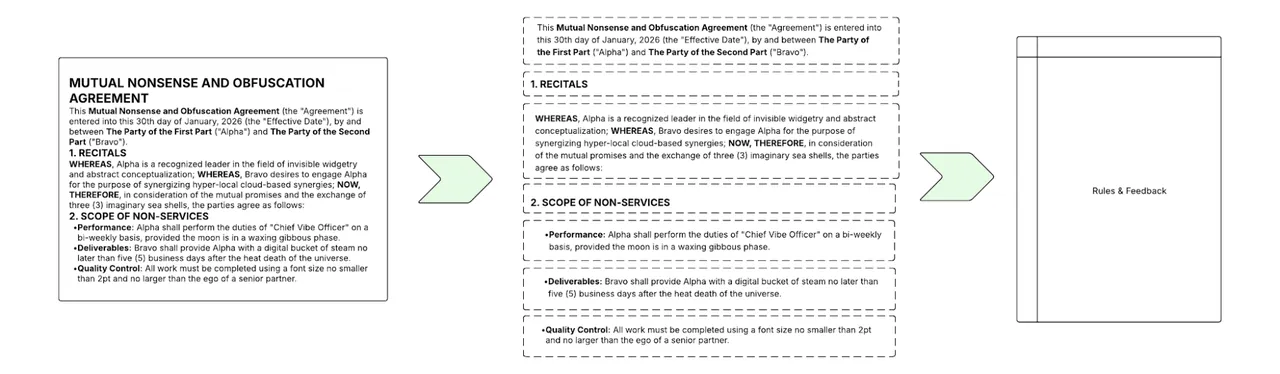
查询与输入嵌入的对称性对搜索性能至关重要。在这里,存储的嵌入与查询的嵌入保证相似,因为它们都源自同一份合同。相似搜索仍然必要,因为文档可能随每轮律师批注发生细微变化。
会话记忆
对话式界面用 Redis 维护会话状态,允许律师就文档追问。幕后持续运行 LLM-as-a-judge 评估,监控检索上下文的质量(document_quality_metric)与模型对公司规则的遵循度(rule_adherence_metric)。
今天的做法:harness 工程
作为 Uber 全公司 Agentic AI 努力(含 Legal AI)的一部分,团队正在探索 Claude Code、OpenCode 等 agentic harness,结合 skills 来结构化并自动化工作流;同时将探索引入法律本体与知识图谱,为法律概念与关系提供语义基础,实现更一致的解释与更可靠的推理。
结语
从最初的 RAG 系统,到整合用户反馈、打磨语气、实现健壮的规则库,这段迭代历程说明:构建一个真正有效的 AI 法律助手,是一个由持续学习与领域专家紧密协作驱动的迭代过程。每一个遇到的挑战都成为加深理解、打磨系统的机会,最终得到一个更准确、更适应、更以用户为中心的工具,在复杂的法律谈判中真正增强人类的专业能力。
来源:Uber Engineering Blog《Building Uber's Redlining Agent》,作者 Austin Greco、Meghana Somasundara、Frank Tenente(uber.com/us/en/blog/building-ubers-redlining-agent,2026-10-08)。本文为全文翻译与改编,已删除原页商业推广段落;全部配图与演示视频来自原文。
原文来源:Uber Engineering Bloghttps://www.uber.com/us/en/blog/building-ubers-redlining-agent/