Skip to content
MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

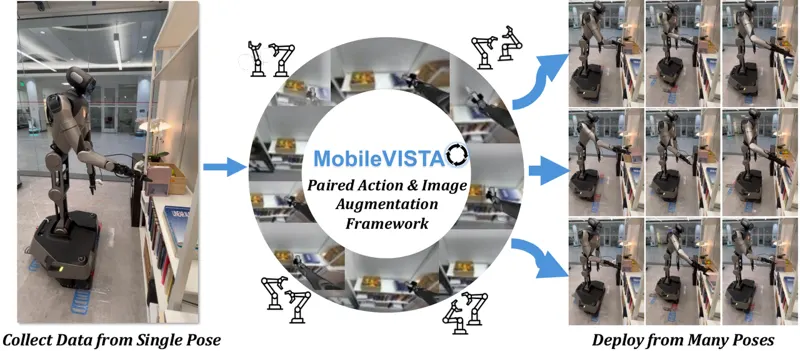
移动操作策略大多照着一个站位采的示范学出来,部署时底座偏几厘米,第一视角画面和末端轨迹就一起偏,成功率断崖式下滑。MobileVISTA 不重采数据,而是把已有示范「搬」到新站位。视觉侧先按 (r,θ)~(√u·15cm, 2πv) 采样盘面偏移与 ±5° 偏航,用天空盒掩码(仿真里 GR-1 标红、Franka 标黄;真机走 URDF 深度阈值 0.995 再膨胀 5px)把机器人抠掉,Open3D 反投影成点云、按相机外参升到世界系平移 Δp,再用重定向动作正运动学算出的新外参重投影,被遮挡的洞交给 E2FGVI 补,最后把机器人渲到新位置合成回去(仿真 512×512,真机 6× 上采样)。动作侧是闭式变换:p'_t=T⁻¹[p_t;1]、R'_t=R_inv_yaw·R(r_t)、夹爪原样透传,双臂绕中点偏航,再用 mink IK(FrameTask 1.0/1.0、PostureTask 1e-5、≤20 步)解回关节。数据量仿真 1:1(200→200)、真机 1:10(50→500)。GR-1 的 Can Sort 在 r=15cm 从微调 π0.5 的 0.320 提到 0.527,Pouring 0.460 对 0.013;双臂 Franka 的 Box 从基线最高的 0.087(DP3)提到 0.247,Drawer 0.413 反而高过仿真 oracle 的 0.393。真机 Book Stacking 随机站位抓到 17/25、放上书堆 13/25,三个基线只有 1-2/25。消融指向关键在「机器人几何随站位变」:只做动作变换几乎无增益(0.00-0.11),固定机器人几何会丢掉 Pouring +0.47、Can Sort +0.28、Box +0.24。补图质量 PSNR 也压过 GEN3C(Can Sort 25.02 对 16.29 dB),单帧耗时 2.39-4.31 分钟(L40S)对 GEN3C 的 13.65-16.85 分钟(H200)。

移动操作Data Augmentation
Wistreich, Suzannah, Tian, Stephen, Huang, Isabella · 332次阅读 · 2026年10月5日
EgoLAP:通过语言-动作推理从第一视角人类数据中学习

EgoLAP:通过语言-动作推理从第一视角人类数据中学习

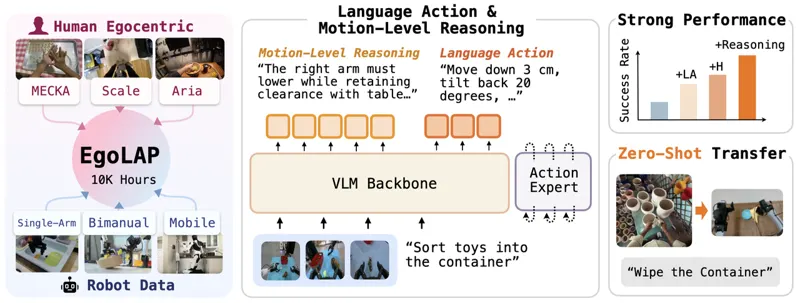
第一视角人类视频规模大、行为多样,但人手与机械臂之间的具身差异使原始人类轨迹难以直接作为机器人控制的监督信号。EgoLAP 的核心主张是:低层动作是具身特定的,但其背后的运动意图可以跨人类与机器人迁移。框架把运动意图写成两种共享的文本目标——用结构化、时间抽象的自然语言动作(language action)概括一秒内位姿与夹爪的变化,用运动级推理(motion-level reasoning)给出接触、几何与物体 affordance 层面的物理依据,二者串成一条人-机共享的语言动作思维链。模型以 PaliGemma-2B 为 VLM 主干,配一个 3 亿参数、从零初始化的动作专家,经流匹配预测连续动作块;文本目标只监督主干(知识隔离),推理期仅 rollout 动作专家、不生成任何文本,因而不牺牲实时控制。在约 1 万小时人-机混合数据(ABC、EgoVerse、OXE 等)上预训练后,EgoLAP 在定制双臂真机上取得 80.1% 的平均任务进度,比 FAST、OAT 等动作表示高 2.3 倍;在零样本双臂仿真上达 38.3%,比直接用同域真机数据训练的 ABC-VLA 高 1.8 倍。运动级推理与语言动作强协同(真机 +35.6 点),而对非语言 token 几乎无益;跨 embodiment 技能检索最多提升 25 点,表明共享文本目标重塑了表征几何。

视觉语言动作模型操作
Lihan Zha, Shresth Grover, Tenny Yin · 614次阅读 · 2026年10月6日

本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。