PAPER DEEP DIVE
VLAct:表示中心的VLA继续预训练
VLAct 将 VLA 继续预训练重新定义为表示学习:以 Qwen3-VL-4B 为基座,在 DROID、InternA1、RoboCoin、MolmoAct 等全开源多本体机器人数据上继续预训练,用冻结视觉编码器与下半 LLM 的浅层保护加字幕混合保留 VLM 先验,用 OFT、PI、GR00T 三个连续动作头协同监督避免表示坍缩到单一扫码几何,并以 20 维部分统一动作空间(共享夹爪维、掩码非活跃维)与周期关节 wrap-aware 损失对齐跨本体动作语义。预训练组件在微调时全部丢弃、只留骨干。固定下游微调协议下,LIBERO-Plus 达 82.6%、VLA-Arena 54.8%、RoboTwin 2.0 达 92.5%、DOMINO 成功率 18.50,真机单臂与双臂全面超过未预训练基线;RoboCasa-GR1 人形本体仅用 20% 下游数据即超过全数据 GR00T-N1.6。全部结果仅用开源数据与 16 卡训练取得。
论文元信息
标题:Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models
作者:Senqiao Yang、Chengyao Wang、Yuxin Chen、Zixuan Wang、Longxiang Tang、Haokun Gui、Jinhui Ye、Changsheng Lu、Xiaoyang Wu、Mingkang Zhu、Pengguang Chen、Shu Liu、Zhuotao Tian、Hengshuang Zhao、Bei Yu、Jiaya Jia
链接:arXiv:2608.27550(v2)· 项目页 starvla.github.io/VLAct · 代码 github.com/starVLA/VLAct(已开源,MIT 许可,训练脚本与权重承诺释放)
训练语料:DROID、InternA1、RoboCoin、MolmoAct 四套全开源机器人数据,混入字幕数据做表示锚定;基座为 Qwen3-VL-4B,训练框架为 StarVLA。
算力:继续预训练 16 卡;真机微调 8×H800、5 万步。全部结果在固定下游微调协议下取得。
一句话总结
VLAct 把 VLA 继续预训练从「在预训练分布上拟合动作」改写为「塑造可迁移的视觉-动作表示」:浅层保护与字幕混合保住 VLM 先验,多头协同监督防止表示坍缩到单一动作头,部分统一动作空间与 wrap-aware 损失对齐跨本体动作语义,最终用 16 卡与全开源数据训出超越多个工业级系统的骨干。
研究背景与动机
视觉与语言基础模型的进步长期由数据、参数与算力三条 scaling 曲线驱动。这条范式之所以成立,并不只是因为语料体量大,而是因为网页语料天然覆盖了极宽的视觉与语义变化。VLA 模型自然想继承同一范式:更多机器人轨迹,原则上应当支撑更通用的机器人策略。
但机器人轨迹无法从网页抓取。它们必须通过具身执行产生,依赖人类遥操作或精心设计的数据采集协议;而策略需要泛化的空间是组合且连续的,横跨场景、物体、任务目标、本体与接触动力学。于是即便最大的机器人数据集,也只是物理交互空间的稀疏采样,覆盖既不完整也不均匀。
这并不否定规模的价值,而是改变了规模应当扮演的角色。如果继续预训练无法指望穷尽覆盖,那么它的成败就不只取决于采了多少轨迹,而取决于这些轨迹能否诱导出可迁移的视觉-动作表示。论文因此提出一个固定预算下的问题:在机器人数据预算给定时,继续预训练怎样才能学到超越训练轨迹本身的表示?
论文的回答是表示中心视角:把继续预训练看作把机器人轨迹蒸馏为骨干中可复用的视觉-动作知识的过程。一个有用的 VLA 骨干不仅要预测预训练数据里的动作,还要内化关于物体、可供性、空间关系与动作条件下物理交互的可迁移先验,供下游策略在新任务、新场景、新本体上复用。
需要澄清术语。这里的「继续预训练」指从一个已预训练好的 VLM 出发,在任何下游任务微调之前,先在广域、多本体机器人轨迹上训练;而非从零预训练基础模型。π0、π0.5、GR00T N1/N1.5 等通用 VLA 系统采用的正是这一设定,通常称之为 VLA pre-training,论文改用更精确的说法。
预备知识:四类动作头
论文的几乎所有设计都围绕「动作头」这一轴展开,因此先固定四种代表性动作头的定义。FAST 保留 VLM 的自回归接口,把动作块编码为离散动作 token 序列 $z_{1:M}=\mathrm{Tok}_{\mathrm{FAST}}(A_t)$,用标准下一 token 预测目标训练:
$$\mathcal{L}_{\mathrm{FAST}}=-\sum_{m=1}^{M}\log p_\theta(z_m\mid H_t,\,z_{<m})$$
推理时自回归生成 token 再经逆 tokenizer 还原连续动作。OFT 去掉 tokenizer,在骨干序列后追加固定数量的动作查询 token,用小 MLP 并行回归整个动作块:
$$\mathcal{L}_{\mathrm{OFT}}=\frac{1}{K\,d_a}\sum_{k=0}^{K-1}\left\|g_\phi(h^{\mathrm{act}}_{t,k})-a_{t+k}\right\|_1$$
PI 与 GR00T 则用流匹配生成连续动作块:采样噪声 $\epsilon\sim\mathcal{N}(0,I)$ 与流时间 $\tau\in[0,1]$,沿线性概率路径 $A_t^\tau=(1-\tau)\,\epsilon+\tau\,A_t$ 学习速度场 $u_t=A_t-\epsilon$,训练目标为
$$\mathcal{L}_{\mathrm{PI}}=\mathbb{E}_{A_t,\epsilon,\tau}\left[\left\|v_\phi(A_t^\tau,\tau;H_t)-(A_t-\epsilon)\right\|_2^2\right]$$
GR00T 的目标形式相同,但把流匹配放进显式分离的双系统架构:VLM 充当慢速语义模块,DiT 风格的动作模块充当快速运动生成模块,并以机器人状态 $s_t$ 与本体标识 $e$ 为条件。四者的共同点是都在监督「未来动作块」,差异在于解码几何:离散自回归、一次性回归、迭代流匹配、双系统流匹配。这一差异正是后文表示坍缩问题的来源。
方法详解
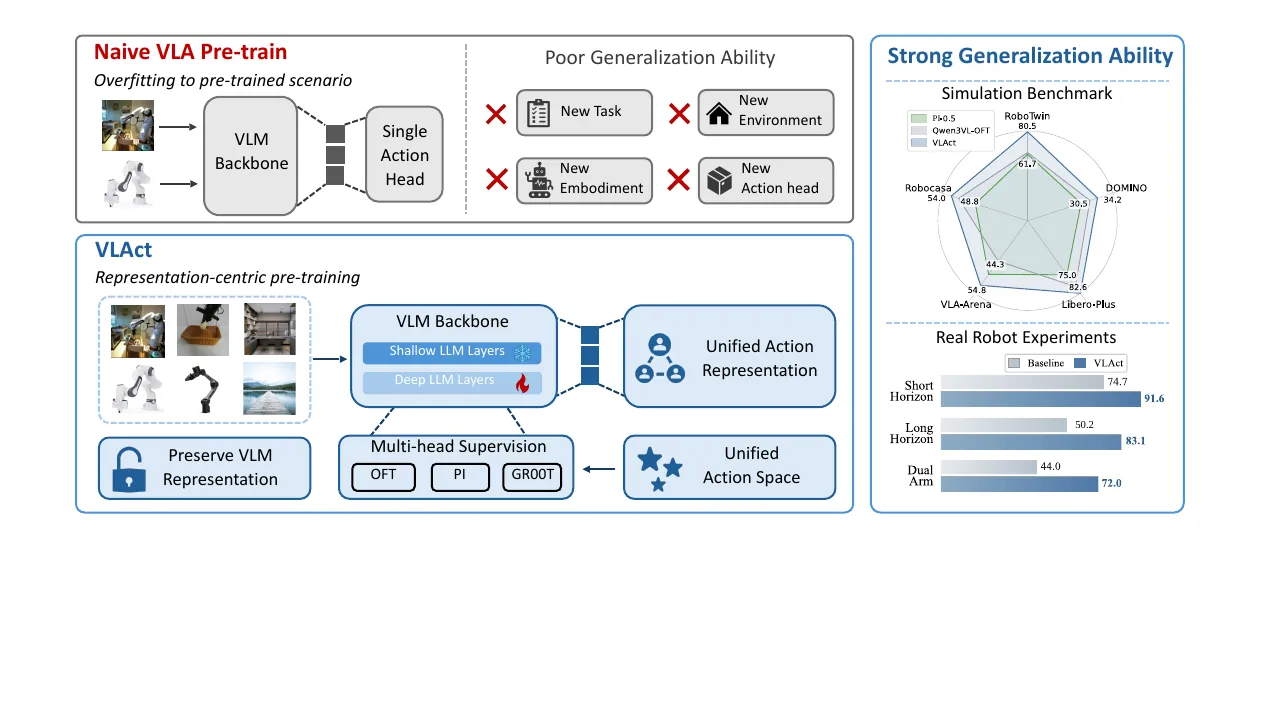
图1:VLAct 总览。朴素的 VLA 预训练过拟合预训练场景,在新任务、新环境、新本体、新动作头上全部失效;VLAct 以表示为中心的预训练同时改善仿真基准与真机实验。
动机实验:动作监督如何重塑骨干
论文先做一个控制实验(图2):固定 Qwen3-VL-4B 骨干,只改变预训练与微调所用的动作头,观察骨干表示如何被重塑。结论有两条。其一,离散监督可以迁移但损失信息:FAST 预训练的骨干换上连续 GR00T 头后略优于从零微调,但保留 FAST 头本身远差于连续头,说明离散 token 只教了粗动作结构,丢掉了操纵所需的细粒度时间与幅值信息。
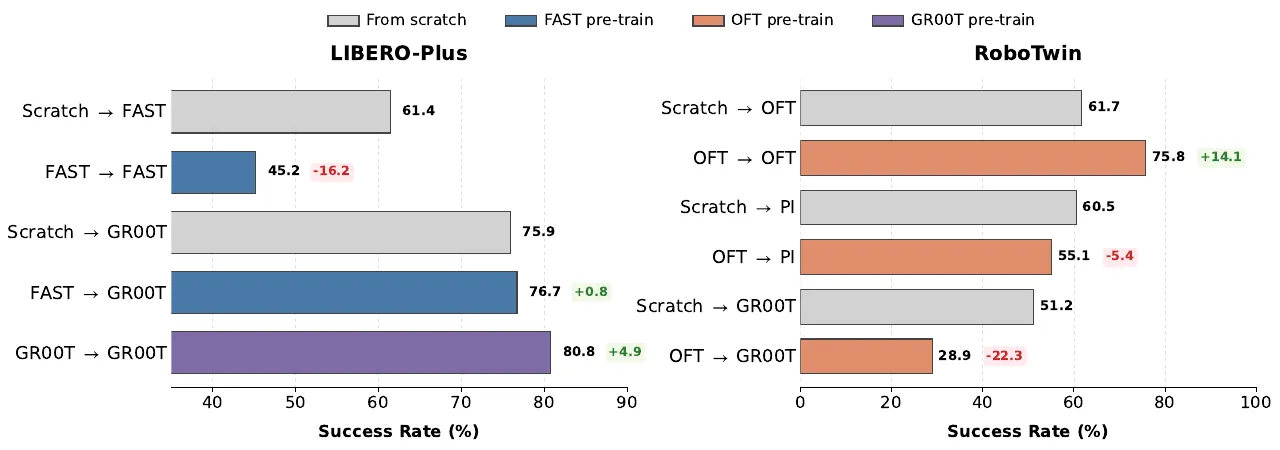
图2:动作监督重塑 VLA 骨干表示。FAST 预训练可迁移到 GR00T 头但受离散化信息损失限制;OFT 预训练在同头微调时提升明显,换到 PI 或 GR00T 头却显著退化,呈现头特定的表示坍缩。
其二,单头连续监督会诱发「头特定表示坍缩」:OFT 预训练在下游仍用 OFT 时提升很大,但同一骨干配 PI 或 GR00T 头时表现很差。动作信息并非不存在,而是被组织成只对预训练头友好的几何形态,其他头解不出来。同头成绩因此高估了骨干的可复用性。论文把这一现象在附录中称为 decoder lock-in。
由此得到三条朴素继续预训练的失效模式:端到端全量更新会侵蚀宽域视觉-语言特征;单一动作头监督使骨干过特化到该头的解码几何;本体专属输出空间把物理上可比的行动(如夹爪开合)隔离在各自头部里。VLAct 的三个组件分别对应这三条。
组件一:浅层保护与字幕混合,保住 VLM 先验
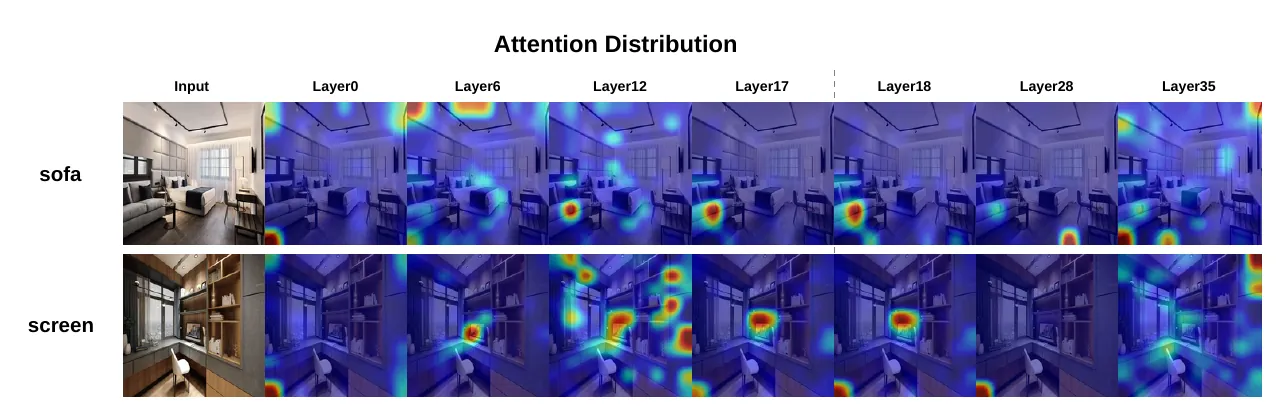
图6:逐层注意力可视化。低层广泛关注视觉与空间信息,深层聚焦语义与任务相关区域,这构成冻结视觉编码器与下半 LLM 层的依据。
机器人轨迹的视觉多样性远低于网页语料:固定机位、重复的操纵场景、本体特定的动作相关性。若预训练时端到端更新全部参数,窄分布的梯度会在模型学会稳健的动作条件特征之前,就把骨干推离它原有的通用表示。逐层注意力可视化(图6)显示低层承载宽域视觉与空间信息、深层承载语义与任务区域,因此论文在预训练阶段冻结整个视觉编码器与 LLM 的下半层,只更新上半层与动作头;下游微调时再全部解冻。这一简单策略在 LIBERO-Plus 上带来 3.7 个点、在 Agilex 上带来 3.4 个点的提升(附录 C:全量更新 78.9,只冻视觉编码器 81.3,冻视觉编码器加下半 LLM 82.6)。
字幕混合是第二个锚。论文对比五类辅助监督(字幕、BBox-QA、Point-QA、Spatial-QA、纯语言指令),发现字幕数据的单一来源增益最强:LIBERO-Plus 从机器人-only 的 75.0 提升到 82.6。原因直观——详细字幕在物体、属性、空间关系与场景上下文上提供稠密监督,最接近原 VLM 的预训练分布。每个预训练 batch 同时含机器人样本与辅助样本,目标为
$$\mathcal{L}_{\mathrm{total}}=\mathcal{L}_{\mathrm{action}}+0.5\,\mathcal{L}_{\mathrm{VLM\text{-}CE}}$$
其中 0.5 是辅助交叉熵的固定权重。值得注意的是纯语言指令数据也能带来增益:它与机器人感知和控制毫无直接关系,其增益只能解释为表示层面的「保 regime」与特征更新多样化,而非任务迁移。
组件二:多头协同监督,把头的多样性变成监督信号
针对头特定坍缩,VLAct 在同一骨干上并行挂三个连续头 OFT、PI、GR00T。给定同一视觉-语言输入,骨干产出共享隐表示 $z$,三个头各自从 $z$ 预测同一真值动作块,目标为三者之和:
$$\mathcal{L}_{\mathrm{action}}=\mathcal{L}_{\mathrm{OFT}}+\mathcal{L}_{\mathrm{PI}}+\mathcal{L}_{\mathrm{GR00T}}$$
设计刻意简单:不引入新动作头,也不引入对齐模块,而是用头的多样性本身作监督。三个头对同一动作预测问题施加不同的目标与解码偏置,骨干就无法依赖只对某一个头有用的特征;要同时压低三个损失,它必须把动作信息编码成多种参数化都能读取的形式。由于三个头共享同一次骨干前向,多头监督只增加轻量的头部计算,不重复骨干计算。
协同监督因此承担两个角色:让骨干更头无关,改善向替代下游头的迁移;同时正则化表示,即使下游头与预训练头相同也更强。附录 E 的实验把这两点分开验证。以 PI 为下游微调头:无预训练 60.5;仅 OFT 预训练反而降到 55.1(lock-in);OFT+GR00T 预训练(PI 未参与)升到 63.1;三头全参与时 77.0。加入第二个预训练头,把「未见头」的微调结果从低于从零基线拉回高于基线,这正是多样性减少 decoder lock-in 的直接证据。
同头适配也不吃亏:对 OFT、PI、GR00T 三个下游头,头多样性预训练相对单头预训练分别提升 1.7、1.6、4.3 个点(61.7→78.8→80.5、60.5→75.4→77.0、51.2→71.7→76.0 的链条中最后两环)。增益温和,但说明多头监督没有以牺牲同头性能为代价。
组件三:部分统一动作空间与 wrap-aware 损失
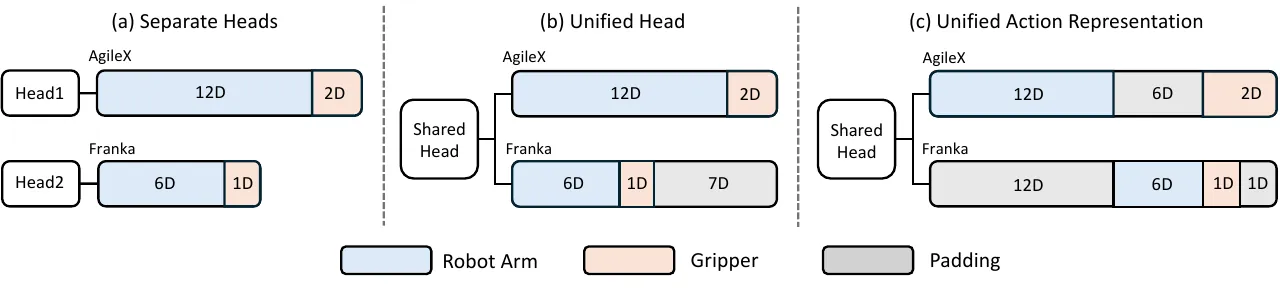
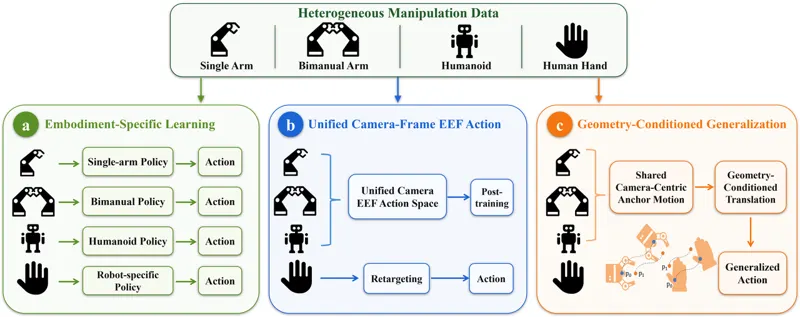
图4:三种跨本体输出设计对比。本体专属头隔离监督;完全统一空间会把物理含义不同的坐标强行对齐;VLAct 只在物理可比的维度(如夹爪开合)上共享坐标,其余维度掩码。
跨本体的常见做法是每个机器人挂一个专属头或输出投影,灵活但把共享结构藏进各自头部;另一种极端是把低维本体 padding 到公共维度的完全统一空间,会把物理含义不同的坐标 naive 地对齐。VLAct 取中间路线:一个共享动作头,每步输出固定 20 维向量 $\hat{a}_{t+k}\in\mathbb{R}^{20}$,维度按「本体角色」分配:第 1–6 维为双臂本体(如 AgileX)左臂 6 个绝对关节角,第 7–12 维为右臂 6 个绝对关节角,第 13–18 维为单臂本体(如 Franka)的 6 维 delta 末端位姿,第 19 维为共享夹爪坐标(Franka 单夹爪与 AgileX 左夹爪共用),第 20 维为双臂本体的右夹爪坐标。
训练时每个样本只在其本体的活跃维度上贡献损失,非活跃维度被掩码。这一布局保留各语料原生的底层动作约定(Franka 用 delta eef,AgileX 用绝对关节角),不强迫所有本体进入同一控制器参数化,只在角色层面对齐输出坐标;架构上不需要本体适配器、路由模块或本体条件解码器。消融(附录 I.2)显示:分离头 78.5/81.1(RoboTwin/LIBERO-Plus),统一头但不做空间对齐 79.5/81.4,完整统一动作表示 80.5/82.6。
最后一个细节是周期关节的角度回绕。绝对关节角定义在周期空间上:$\pi+\epsilon$ 与 $-\pi+\epsilon$ 物理上几乎同一姿态,数值却相差近 $2\pi$。论文先在数据侧把所有绝对关节角维度回绕到规范区间:
$$a_{\mathrm{wrap}}=(a+\pi)\bmod 2\pi-\pi$$
再在损失侧修正边界处的距离度量:当目标接近 $-\pi$ 而预测接近 $+\pi$ 时,朴素残差接近 $2\pi$,物理上却几乎为零。定义回绕残差
$$\delta_{\mathrm{wrap}}=\big((\hat{a}-a)+\pi\big)\bmod 2\pi-\pi,\qquad \mathcal{L}_{\mathrm{wrap}}=\left|\delta_{\mathrm{wrap}}\right|$$
并把它加到每个头原有的目标上,得到每个头的最终目标
$$\mathcal{L}^{(h)}_{\mathrm{total}}=\mathcal{L}^{(h)}_{\mathrm{action}}+\mathcal{L}^{(h)}_{\mathrm{wrap}}$$
对 OFT 该作用在直接回归输出上;对 GR00T 与 PI 作用在去噪/流匹配生成结束后的最终动作样本上,而非中间噪声或速度预测。该项只施加于绝对关节角维度,夹爪命令与 delta 末端平移等非周期维度排除在外。RoboTwin 基线设置下的消融:直接回归原始关节角 75.5,加数据侧统一关节空间 78.6,再加 wrap-aware 损失 80.5。
整体流程与代码对应
flowchart TB
  subgraph PT["VLAct 继续预训练 16 GPU"]
    A["开放机器人数据 DROID InternA1 RoboCoin MolmoAct"] --> B["Qwen3-VL-4B 共享骨干"]
    C["字幕混合 LLaVA-ReCap-CC3M OneVision"] --> B
    B --> D["浅层保护 冻结视觉编码器与下半 LLM"]
    B --> E["多头协同监督 OFT PI GR00T 共享同一隐表示"]
    B --> F["部分统一动作空间 20 维布局 掩码非活跃维"]
    E --> G["wrap-aware 损失 周期关节残差取模"]
    F --> G
    D --> H["L_action 加 0.5 倍 L_VLM-CE"]
    E --> H
    G --> H
  end
  subgraph FT["下游微调 固定协议"]
    I["丢弃预训练头与字幕流"] --> J["重新初始化任务专属动作头"]
    J --> K["LIBERO-Plus VLA-Arena RoboTwin2.0 DOMINO"]
    J --> L["RoboCasa-GR1 RoboDojo 真机 Franka"]
  end
  H --> I
开源仓库 starVLA/VLAct 中可以逐条对上论文的三个组件。wrap-aware 损失落在 starVLA/model/modules/action_model/flow_matching_loss.py:blend_angular_wrap_abs_error 用 torch.remainder(raw_diff + math.pi, 2*math.pi) - math.pi 计算回绕残差,并以 0.5/0.5 的混合系数并入原始绝对误差,再由 angular_mask 限定只作用于关节角维度;OFT 框架在 QwenOFT.py:309 调用它,PI 与 GR00T 头则走 flow_matching_loss_with_endpoint_wrap。部分统一布局落在 starVLA/model/framework/QwenHybrid_xrobot_padding.py:DISJOINT_ACTION_LAYOUT_DIM = 20、DISJOINT_DUAL_ARM_JOINT_SLICE = slice(0, 12)、DISJOINT_SINGLE_ARM_EEF_SLICE = slice(12, 18),配合 MULTI_ROBOT_ACTION_SPECS 按 robot_tag 校验各语料动作维度(franka/oxe_droid 为 7 维 delta eef,interna1_split_aloha/robocoin 为 14 维关节加夹爪),三个头共享同一次编码器前向。浅层保护则不是新代码,而是配置驱动:training/trainer_utils/trainer_tools.py:151 的 freeze_backbones 按 config.trainer.freeze_modules 的模块路径列表冻结子模块。
实验结果
实验协议是这篇论文论证力的关键:在所有 VLAct 对比中,唯一变化的是 VLM 骨干权重——动作头及其全新初始化、下游数据、优化器与微调预算全部相同。因此 7.6 到 21.4 个点的增益只能归因于骨干表示本身。预训练只用全开源数据与 16 卡。
单臂 Franka。LIBERO-Plus 在标准 LIBERO 训练、扰动测试集评估的设定下,VLAct 以 82.6 的总分超过同骨干同头的 Qwen3VL-OFT(75.0)7.6 个点,也超过阿里的大规模系统 Abot-M0(80.5)2.1 个点;增益集中在 Camera、Robot、Noise、Layout 四个扰动维度,说明表示层面的预训练带来的是更稳健的视觉-空间表示。VLA-Arena 上 VLAct 在 Safety、Distractor、Extrap.、Long-H. 四个轴上全部第一,平均 54.8,比同骨干基线高 21.4 个点,比最强公开基线 π0.5 高 10.5 个点,其中 Long-Horizon 与 Safety 分别领先 21.0 与 11.7 个点。
| 方法 | Camera | Robot | Lang. | Light | Bg. | Noise | Layout | 总分 |
|---|---|---|---|---|---|---|---|---|
| OpenVLA-OFT | 56.4 | 31.9 | 79.5 | 88.7 | 93.3 | 75.8 | 74.2 | 69.6 |
| π0 | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.8 | 53.6 |
| π0-FAST | 65.1 | 21.6 | 61.0 | 73.2 | 73.2 | 74.4 | 68.8 | 61.6 |
| Abot-M0 | 60.4 | 67.9 | 86.4 | 96.2 | 91.6 | 86.4 | 82.6 | 80.5 |
| Qwen3VL-OFT(同骨干基线) | 47.0 | 60.1 | 87.0 | 96.3 | 95.3 | 73.1 | 79.2 | 75.0 |
| VLAct | 73.9 | 68.4 | 81.5 | 96.7 | 96.7 | 86.0 | 83.3 | 82.6 |
表1:LIBERO-Plus 各扰动维度成功率(%)。所有模型在标准 LIBERO 上训练、在扰动测试集上评估。
双臂 AgileX。RoboTwin 2.0 的 Base 设置每任务仅 50 条干净轨迹,VLAct-OFT 达到 80.5,比同骨干基线 61.7 高出近 19 个点;Data Scaling 设置下达到 Clean 92.5 / Random 90.8,超过 InternVLA-A1、Being-H0.7、Motus、LingBot-VLA、Abot-M0 与 π0.5,仅略低于 HoloBrain-0 与 Fast-WAM。更值得注意的是头无关性:同一 VLAct 骨干换 GR00T 头为 76.0/89.6/87.4,换 PI 头为 77.0/93.0/88.8,PI 头甚至拿到最高 Clean 成绩,三个头彼此相差不到 3.4 个点——迁移的确实是骨干表示而非某个头。动态操纵基准 DOMINO 上,VLAct-OFT 以 18.50 的成功率与 34.20 的操纵分双双第一,比同骨干基线高 7.64 与 3.71。
| 方法 | 族 | Base(Clean) | Data Scaling(Clean) | Data Scaling(Random) |
|---|---|---|---|---|
| π0 | Flow | 46.4 | 65.9 | 58.4 |
| π0.5 | Flow | 60.2 | 82.7 | 76.8 |
| LingBot-VLA | Flow | – | 88.6 | 86.7 |
| Abot-M0 | AML | – | 86.1 | 85.1 |
| InternVLA-A1 | Flow | – | 89.4 | 89.6 |
| Being-H0.7 | Flow | – | 90.2 | 89.6 |
| Fast-WAM | WAM | – | 91.9 | 91.8 |
| HoloBrain-0-QW | Diff. | – | 91.9 | 92.3 |
| Qwen3VL-OFT(同骨干基线) | OFT | 61.7 | 88.2 | 88.3 |
| VLAct(OFT 头) | OFT | 80.5 | 92.5 | 90.8 |
| VLAct(GR00T 头) | Flow | 76.0 | 89.6 | 87.4 |
| VLAct(PI 头) | Flow | 77.0 | 93.0 | 88.8 |
表2:RoboTwin 2.0 任务成功率(%)。Base 每任务 50 条干净轨迹;Data Scaling 每任务再加 500 条域随机专家轨迹。
真机与跨本体迁移。真机平台为 Franka Research 3 七自由度臂,外部 RealSense D435 加腕部 D405,图像统一缩到 224 像素。单臂短程域内任务 VLAct 平均 92.5 对基线 77.5;新物体域外任务 90.0 对 73.3 与 65.0;长程任务擦桌与舀豆 86.6/80.0 对 73.3/33.3;更难的长程域外(延长序列、完全替换物体)82.5/83.3 对 47.5/46.6;只在单臂数据上预训练的 VLAct 迁移到双臂协调达到 72.0 对 44.0,叠裤子与叠毛巾这类形变与同步要求高的任务增益最大(70 对 40、50 对 20)。
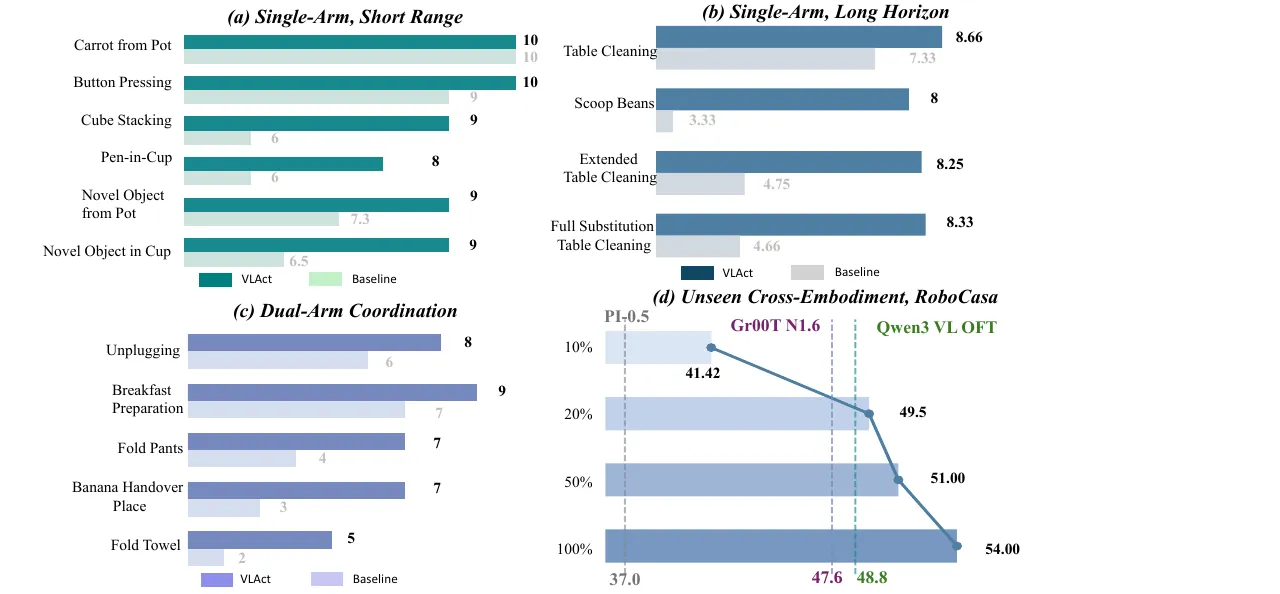
图5:真机评测(a–c)与 RoboCasa-GR1 跨本体迁移(d)。VLAct 在单臂短程、长程与双臂协调上全面超过未预训练基线,并只用 20% 下游数据超过全数据 GR00T-N1.6。
跨本体是最硬的检验:GR-1 人形与 ARX X5 双臂平台在继续预训练阶段被完全留出、一条轨迹都不参与。RoboCasa-GR1 全量微调下 VLAct 达 54.0,超过全量数据的 Qwen3VL-OFT(48.8)、GR00T-N1.6(47.6)与 π0.5(37.0);只用 20% 下游轨迹即达 49.5,已不低于全量 Qwen3VL-OFT,50% 数据 51.0,全量 54.0。RoboDojo 官方 2026-08-24 榜单的 35 个策略中,VLAct 平均分第 8、成功率第 6(10.66 分 / 7.60%),在四个被明确标注的世界-动作模型条目中全面超过最强的 X-WAM(7.69 / 3.83),并超过小米 Robotics-0、GalaxeaVLA G0、LingBot-VLA 与 Abot-M0 等工业系统;相对同骨干的 StarVLA-α 条目提升 4.26 分与 4.36 个点。
| 消融组件 | 设置 | 结果 |
|---|---|---|
| 浅层保护 | 全量更新 / 只冻视觉编码器 / 冻视觉编码器加下半 LLM | LIBERO-Plus 78.9 / 81.3 / 82.6;RoboTwin 77.1 / 79.3 / 80.5 |
| 辅助共训练 | 机器人-only / 仅字幕 / 混合辅助 | LIBERO-Plus 75.0 / 82.6 / 82.5 |
| 头多样性(下游 PI 头) | 无预训练 / 仅 OFT / OFT+GR00T / 三头 | PI 微调 60.5 / 55.1 / 63.1 / 77.0 |
| 统一动作表示 | 分离头 / 统一头 / 统一动作表示 | RoboTwin 78.5 / 79.5 / 80.5;LIBERO-Plus 81.1 / 81.4 / 82.6 |
| wrap-aware 损失 | 基线 / 加统一关节空间 / 再加 wrap 损失 | RoboTwin 75.5 / 78.6 / 80.5 |
| 异构 UMI 数据 | 原混合 / 加 2 万条 RealOmin 轨迹 | LIBERO-Plus 82.6 / 83.7 |
表3:组件消融汇总(数字取自附录 C、D、E、F、G、I 的各表)。每个组件都在固定其余设置的前提下单独验证。
最后一个开放性检验:往预训练混合里加入 2 万条用 UMI 手持夹爪采集、本体与采集范式都不同的 RealOmin 轨迹(动作转为 delta eef 以兼容布局),LIBERO-Plus 从 82.6 升到 83.7。这说明这套配方能吸收异构数据而不是被其扰乱——对「开源数据还能怎么加」是一个实用的正面信号。
局限性
其一,作者自述记忆能力是明显短板。RoboDojo 的六个能力轴中,VLAct 的 Memory 只有 0.66 分 / 0.56% 成功率,而榜首 DM0.5 在该轴为 47.74 / 47.44;增益集中在 Precision 与 Long-Horizon。需要在线维护与调用历史信息的任务,正是当前表示中心配方没有覆盖的能力。
其二,作者也承认混合辅助共训练(82.5)略低于仅字幕(82.6):预训练总步数固定时,混入多种辅助源会稀释最强来源字幕数据的采样频率。这意味着「混多少、怎么混」仍是一个预算分配问题,论文只给了固定配比的快照。
其三,从实验设计看还有两点保留。多头协同监督的额外算力只通过骨干间接回收——预训练头在微调时被整体丢弃,因此多头的成本是否值得,取决于下游是否真的换头,论文的真机与主结果仍以 OFT 头为主;此外骨干规模固定在 4B、真机每任务仅 10 次试验、RoboDojo 榜单不归一化训练算力,配方在更大骨干与更严格统计下的表现仍是开放问题。
总结与展望
VLAct 的贡献不在某个新模块,而在把「继续预训练」这件事的目标函数重新定义:不是拟合预训练分布上的动作,而是塑造一个在任务、本体、环境、动作头四个轴上都可迁移的骨干表示。浅层保护与字幕混合回答「别弄坏什么」,多头协同监督回答「别过特化到什么」,部分统一动作空间与 wrap-aware 损失回答「该在哪里共享」。三个答案都由控制实验支撑,且全部在固定下游协议下验证,使增益可以干净地归因于骨干。
对实践者的直接含义是:VLM 骨干应当被视为 VLA 的一等设计变量,而不是从通用视觉-语言预训练继承来的固定部件。在数据与算力预算有限时,把预算花在表示设计上的边际收益,可能高于再堆一倍轨迹。论文的开放姿态(全开源数据、16 卡、承诺释放脚本与权重)也使这条轴线可以被独立复现与推进。
金句
有效的 VLA 继续预训练,要求设计轨迹数据如何塑造骨干表示,而不是简单地在预训练分布上优化动作预测。