PAPER DEEP DIVE
VioLA:用人类数据学通用人形控制策略
VioLA 把人形通才策略的预测目标从关节指令换成身体与手部运动隐码,冻结的控制器负责执行,人类与机器人演示因此共用同一个动作空间;1.406 亿帧训练数据里 93.2% 来自人类,真机 G1 零样本运动成功率 100%、操作 88.6%。
论文:VioLA: Learning Generalist Humanoid Control Policies from Human Data(arXiv:2610.12435,arxiv.org/abs/2610.12435)
作者:Mert Albaba、Jens Beißwenger、Anna Manasyan、Daniel Marta、Michael J. Black、Wieland Brendel、Andreas Krause、Georg Martius、Martin Riedmiller(Vesoma、ETH Zürich、MPI-IS、University of Tübingen、ELLIS Institute;Albaba 与 Beißwenger 为共同一作)
项目页:viola.is.tue.mpg.de 代码状态:论文摘要声明代码与 checkpoint 将会发布,但项目页目前只标「Code (coming soon)」,GitHub 上也没有对应仓库,本文按「承诺开源、代码待发布」记录。
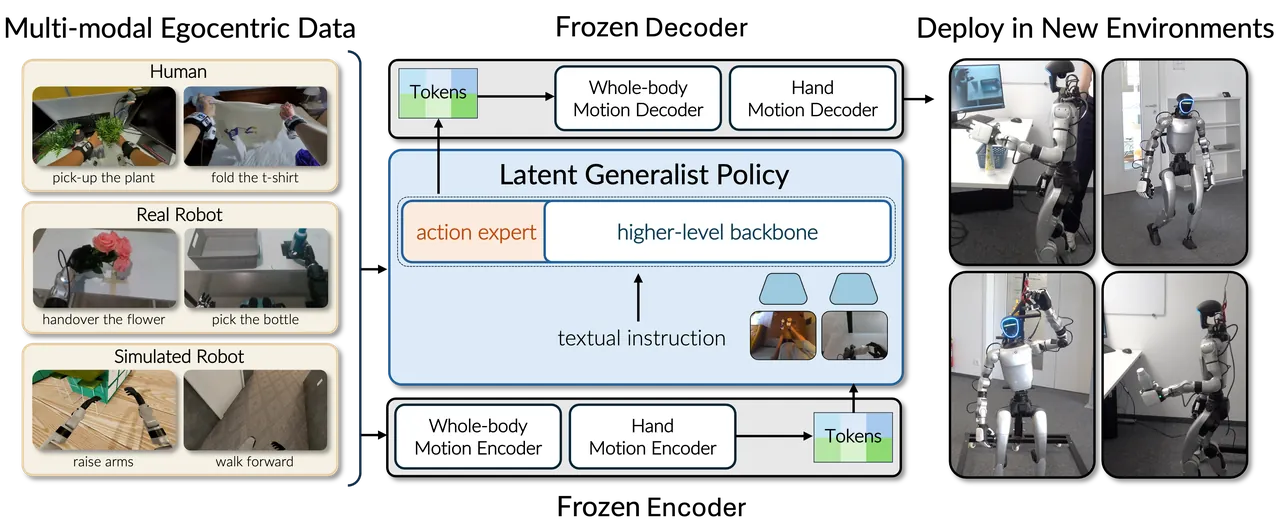
图 1:VioLA 总览。左:人类与机器人动作编码器把演示写进共享的身体与手部潜在空间;中:通才策略从视觉、语言与本体感知预测运动隐码;右:冻结的机器人控制器执行预测。带标注的人类动作因此能在策略自己的动作空间里充当监督信号。
一句话总结
VioLA 让通用人形策略不再预测关节指令,而是预测身体与手部的运动隐码,把「全身怎么协调、怎么保持平衡」交给冻结的 SONIC 身体控制器与手部解码器;由于配对编码器把人类与机器人动作映进同一个空间,1.406 亿帧训练数据里 93.2% 的人类录像可以直接充当动作标签,真机 Unitree G1 上不做任何任务微调即取得运动 30/30、操作 31/35。
研究背景与动机
设想让一台人形机器人「走到桌边把笔记本合上」。它要找到桌子、走过去、伸手够到屏幕、把盖子压下去,全程不能失去平衡。视觉-语言-动作模型(VLA)与世界-动作模型(WAM)已经靠演示学习在机械臂上把这类指令跟随做得相当好,但同样的通才能力搬到人形上时,会撞上两堵墙:一是策略必须预测什么,二是能拿来训练的演示从哪来。
第一堵墙是动作空间。全身控制要求腿、躯干、手臂与手指一起动:伸手会改变重心,迈步会改变手能够到的范围。一个直接预测关节指令的通才策略,必须同时学会「这些自由度如何协调」和「这条指令要的是哪个动作」两件事。而协调这一半,全身控制器其实已经解决了:给定一段期望动作,预训练全身控制器能在保持平衡的同时算出跟随它所需的关节指令;更新的潜在运动控制器甚至接受编码器产出的紧凑向量(运动隐码)作为期望动作的表示。
第二堵墙是数据。人形遥操作需要一台机器人加一名操作员,录很多任务、很多环境的代价极高。现有人形通才(GR00T、$\Psi_{0}$)都要针对目标任务用额外机器人演示微调后才部署,等于每换一个任务再采一轮数据。相比之下,人类走路、伸手、拿东西的录像数量大得多,但人的动作不是机器人指令:录像里没有策略通常要学的那个关节命令。
已有路线各自付了代价。HumanPlus 让机器人在录制时物理影子跟随,等于每条人类演示仍要一台机器人陪跑;重定向路线把人类动作 retarget 到机器人再监督策略;Being-H0 预训练预测 tokenized 的人腕与手指动作,后训练阶段再加一个机器人动作头;LAPA、WholeBodyVLA 从视频推潜在动作,仍靠机器人演示学机器人指令预测;UniT 学共享的人-人形 token,但共享 token 只用于对齐特征,本身不送控制器执行。共同点是:人类信号要么进不了部署时的动作输出,要么每条人类演示仍需要一份机器人侧的对应物。
本文的观察是:第一堵墙的解里已经装着第二堵墙的答案。SONIC 这类潜在控制器的人类编码器与机器人编码器共享同一个身体潜在空间——编码一个人走路的隐码,被配对控制器解码后就能让机器人走路。身体控制器不指挥手指,那就按同样结构单独预训练一个手部模块补齐:人类与机器人手编码器共享一个空间,手控制器把手隐码变成手指指令。于是通才策略可以只预测运动隐码:它决定何时、往哪动,冻结控制器决定关节怎么动。人类录像因此天然带上了策略动作空间里的标签,不需要为每条录像再录一遍机器人。
贡献有三条:其一,VioLA 本身,一个预测身体与手部运动隐码、由预训练控制器把预测转成协调关节指令的通用人形策略;其二,一条把人类与机器人演示统一转成潜在目标的数据管线,产出 781 小时训练数据、其中 93% 是人类;其三,真机 Unitree G1 上零样本的运动与操作结果,以及 VLA 与 WAM backbone 的对照、人类与机器人监督的对照,包括纯人类数据训练也能在真机上完成运动任务。
预备知识
FSQ 运动码与参考窗口。 每个编码器输出 64 坐标的运动码,由两个 32 维有限标量量化(FSQ)码展平而成,坐标取值 $\{k/16:k=-16,\ldots,15\}$,记该网格为 $\mathcal{G}$。身体码与手码格式相同,但编码器与解码器各自独立。一个码概括从当前帧开始的一段参考窗口:50 Hz 下,SONIC v1.1 的机器人编码器与手部编码器读偏移 $0,5,\ldots,45$ 的 10 帧,人类身体编码器读连续 10 帧 $0,1,\ldots,9$;窗口超出演示长度时重复最后一帧。参考窗口决定「一个码代表什么」,策略的 chunk 长度 $H$ 决定「一次预测多少个连续的码」。
flow matching 的时间约定。 动作专家以 flow matching 训练:目标 chunk 与同形高斯噪声按插值时间 $\tau$ 混合,网络学习速度场;推理从 $\tau=1$ 的纯噪声出发,沿学到的速度反向积分到 $\tau=0$ 的干净动作 chunk。编码器输出虽是量化码,动作专家仍按连续坐标回归。三个 backbone 各自保留自己的时间采样器:$\pi_{0.5}$ 取 $\tau=0.999b+0.001$、$b\sim\operatorname{Beta}(1.5,1)$;DiT4DiT 取 $\tau=b/0.999$ 并把时间离散成 1,000 个条件桶;GR00T 方向相反,采样 $r=0.999(1-b)$、构造 $(1-r)\bm{\epsilon}+r\mathbf{Z}_{t}$ 并回归 $\mathbf{Z}_{t}-\bm{\epsilon}$,令 $\tau=1-r$ 并反号即回到统一约定。
实时分块(RTC)。 部署时策略计算下一个 chunk 期间,机器人正在执行上一个 chunk 的一部分;两个独立预测在交接处可能不一致,产生动作跳变。RTC 把「推理结束前将被执行的那部分 latents」固定为下一预测的条件,让新 chunk 从当前运动接着长。本文把 RTC 放进运动隐空间执行,并在实验部分量化它对交接连续性的影响。
方法详解
共享潜在动作空间
合笔记本这个动作需要伸手够到盖子并压下去,同时保持平衡。身体运动编码器把一小段录制动作概括为一个向量,即运动隐码;它的配对解码器是一个预训练全身控制器:给定隐码与机器人近期状态,输出腿、躯干、手臂的指令,在保持平衡的同时跟随被编码的动作。手部编码器概括手指动作,配对解码器把手隐码变成手指指令。VioLA 要学的,就是从场景与指令预测这些身体与手部隐码:对合笔记本任务,它预测站立、伸手与手部动作,而预训练的身体控制器与手解码器决定执行它们的关节指令。
身体侧直接使用 SONIC 的预训练编码器与控制器,它的人类与机器人编码器把动作映进同一个身体潜在空间。由于身体控制器不指挥手指,作者按同样结构单独预训练了一个手部编解码模块:其人类与机器人手编码器同样把动作映进一个共享空间。每个编码器用 64 坐标隐码概括一小段窗口,二者拼接定义 VioLA 的 128 维动作 $\mathbf{z}_{t}=[\mathbf{z}_{t}^{\mathrm{body}};\mathbf{z}_{t}^{\mathrm{hand}}]$。身体与手部隐码一起预测,是为了让伸手与手指动作能够互相对时。
给定第一人称图像 $I_{t}$、指令 $\ell$ 与机器人本体感知 $\mathbf{s}_{t}$,策略 $p_{\theta}$ 预测连续 $H$ 步动作的 chunk:
$$\widehat{\mathbf{Z}}_{t}\sim p_{\theta}(\mathbf{Z}_{t}\mid I_{t},\ell,\mathbf{s}_{t}),\qquad \mathbf{Z}_{t}=[\mathbf{z}_{t},\ldots,\mathbf{z}_{t+H-1}]^{\mathsf{T}}. \tag{1}$$
chunk 的每一行为一个控制步提供一组身体与手部隐码。由于配对编码器同时接受人类与机器人动作,两种来源的演示都能监督这些预测——这是整篇论文数据策略的起点。
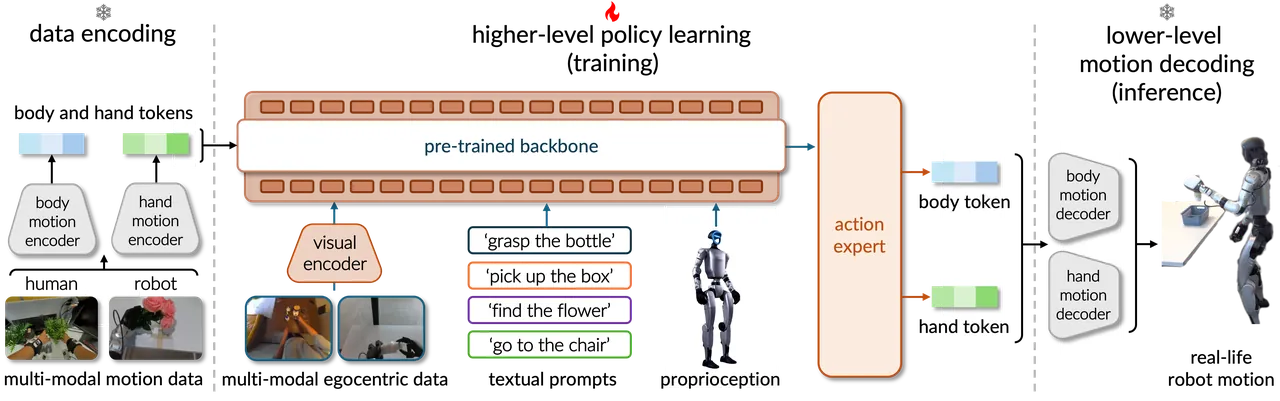
图 2:方法总览。左:冻结的运动编码器从人类或机器人演示构造身体与手部动作目标;中:通才策略从第一人称图像、指令与本体感知预测运动隐码,是训练中唯一被更新的部件;右:冻结的身体控制器与手部解码器把预测隐码变成机器人关节指令。人类与机器人编码器为同一组解码器产出目标。
冻结的运动模块:身体侧与手侧的账
SONIC v1.1 的身体编码器输入 1,751 个坐标,内容是在仿真机器人航向系下表达的参考动作;身体解码器输入当前 64 坐标码加 10 帧本体历史(关节偏移、关节速度、基座角速度、投影重力、上一动作),共 994 个输入坐标;输出 29 维,经控制器默认姿态与动作尺度换算成关节位置目标。控制频率 50 Hz,每次更新内含 4 个 200 Hz 物理步。手侧模块的人类与机器人手编码器把动作映进共享的 64 坐标空间,Dex3 与 Inspire 两个解码器分别把码翻译成对应硬件的手指轨迹。训练通才策略时,所有运动编码器与解码器一律冻结:策略学的是预测它们的码,而不是学手部先验本身。
目标编码:人类与机器人进同一个空间
一条带标注的人类合笔记本录像包含人的图像、指令,以及完成动作所用的身体与手部运动,但没有机器人关节指令。人类运动编码器把这些运动映进 VioLA 的动作空间;机器人演示经对应的机器人编码器进入同一空间。对演示源 $e\in\{\mathrm{human},\mathrm{robot}\}$,时刻 $t$ 的目标为
$$\mathbf{z}_{t}=\bigl[E^{e}_{\mathrm{body}}(\mathbf{m}_{t}^{\mathrm{body}};\gamma_{t});\,E^{e}_{\mathrm{hand}}(\mathbf{m}_{t}^{\mathrm{hand}})\bigr]. \tag{2}$$
其中 $\mathbf{m}_{t}^{\mathrm{body}}$ 与 $\mathbf{m}_{t}^{\mathrm{hand}}$ 是从 $t$ 开始的短标注动作窗口,$\gamma_{t}$ 是表达期望身体运动所用的机器人航向;连续目标拼成 chunk $\mathbf{Z}_{t}$。没有手部标注的演示只监督身体预测,手部坐标在损失中被置零。
闭环仿真标注:补上人类演示缺的本体感知
人类数据还缺策略的一个必需输入:机器人本体感知。作者用冻结身体控制器在仿真里跟踪演示动作来获得它。这里有一个容易被忽略的细节:身体目标依赖执行机器人当前的航向,而执行者的航向可能与演示者不同——如果机器人转向桌子比录像里的人慢,下一个隐码就必须编码「还剩多少转向」。全程沿用人的航向等于假设机器人完全跟住参考,这在物理上不成立。因此目标要闭环计算:每个仿真步里,编码器用仿真机器人当前航向算码,控制器把码解码成关节指令,仿真器前进一步:
$$\mathbf{z}_{t}^{\mathrm{body}}=E^{e}_{\mathrm{body}}\!\left(\mathbf{m}_{t}^{\mathrm{body}};\,\gamma(\mathbf{s}_{t}^{\mathrm{sim}})\right),\qquad \mathbf{s}_{t+1}^{\mathrm{sim}}=\mathrm{Sim}\!\left(\mathbf{s}_{t}^{\mathrm{sim}},\,D_{\mathrm{body}}(\mathbf{z}_{t}^{\mathrm{body}},\mathbf{h}_{t}^{\mathrm{sim}})\right). \tag{3}$$
在时刻 $t$,图像 $I_{t}$、仿真状态 $\mathbf{s}_{t}^{\mathrm{sim}}$ 与编码目标 $\mathbf{z}_{t}^{\mathrm{body}}$ 在仿真器前进前配对。人类样本用这个仿真状态当身体本体感知,机器人样本保留录制的本体感知。手部状态输入用数据里存的值:机器人演示的手部目标取 commanded 手指运动(若有),手部本体感知取 measured 运动——抓取时 commanded 手指可以闭得比物体允许的更远,这两者在抓取阶段是实质性不同的量。所有目标在通才策略训练前算完;训练过程不跑仿真、也不更新任何运动模块。这条管线的意义在于:把带标注的人类动作转成潜在目标,不需要为每条录像单独优化一个到机器人关节的映射。
训练:GR00T N1.7 的 action expert 改预测 128 个隐坐标
两种来源的演示现在形式完全一致:一张图、一条指令、一个机器人状态、一个目标运动 chunk,因此用同一个预测头、同一个损失训练。VioLA 以 GR00T N1.7 为 backbone(Cosmos-Reason2 视觉-语言骨干加 flow-matching 动作 transformer),保留其 flow-matching 目标,只把 action expert 的输出改成每步 128 个隐坐标。对目标 chunk $\mathbf{Z}_{t}$、同形噪声 $\bm{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I})$ 与插值时间 $\tau$,
$$\mathbf{X}_{t,\tau}=(1-\tau)\mathbf{Z}_{t}+\tau\bm{\epsilon},\qquad \mathbf{U}_{t}=\bm{\epsilon}-\mathbf{Z}_{t}, \tag{4}$$
以 backbone 特征与机器人状态(合记 $\mathbf{c}_{t}$)为条件的动作专家 $v_{\psi}$ 被训练从 $\mathbf{X}_{t,\tau}$ 输出 $\mathbf{U}_{t}$:
$$\mathcal{L}_{\mathrm{motion}}=\mathbb{E}_{\bm{\epsilon},\tau}\!\left[\sum_{n\in\mathcal{B}}\sum_{k=0}^{H-1}\sum_{j=1}^{128}w_{nkj}\bigl(v_{\psi}(\mathbf{X}_{t,\tau},\tau\mid\mathbf{c}_{t})_{n,kj}-U_{n,kj}\bigr)^{2}\right], \tag{5}$$
其中 $n$ 索引批次 $\mathcal{B}$ 中的样本(各自带自己的目标 chunk、噪声与条件),$k$ 索引 chunk 内步,$j$ 索引隐坐标;权重 $w_{nkj}$ 归一化损失,并对没有目标的坐标(例如无手部标注录像的手坐标)取零。两种归约方式对应不同 backbone。$\pi_{0.5}$ 先对每一步的已标注坐标求平均:
$$w_{nkj}=\frac{m_{nkj}}{NH\max(1,\sum_{j^{\prime}}m_{nkj^{\prime}})}. \tag{6}$$
GR00T 与 DiT4DiT 则对整批所有有效坐标求平均(GR00T 分母加 $10^{-6}$,DiT4DiT 要求至少一个有效坐标):
$$w_{nkj}=\frac{m_{nkj}}{\sum_{n^{\prime},k^{\prime},j^{\prime}}m_{n^{\prime}k^{\prime}j^{\prime}}}. \tag{7}$$
满标注批次下两者只差一个数值偏移;缺手部标注时,前者给每个动作步等权,后者给每个已标注坐标等权。人类与机器人样本走同一个 action expert、同一个损失,模型不接收任何显式的人类/机器人来源标签;运动编码器与解码器全程冻结。
三种 backbone 的接口:同一动作空间,不同条件
为检验方法是否绑定某个模型,作者把同一套动作空间接到两个 VLA 与一个 WAM 上:GR00T N1.7、$\pi_{0.5}$、DiT4DiT。三者预测同样的每步 128 坐标(64 身体 + 64 手),不做目标归一化;chunk 长度与状态条件按各 backbone 原样保留:GR00T 用 $H=40$,其余 $H=50$。$\pi_{0.5}$ 的状态是 110 个离散化值:29 个身体关节偏移、3 个重力坐标、14 个 Dex3 表示的当前手指位置,以及一个延迟 50 tick 的 64 坐标手码——这一秒延迟是为了防止手码的参考窗口泄露未来目标;训练时该延迟码以 0.5 概率置零,部署时也可置零。GR00T 的状态编码器吃 46 个值(29 关节偏移、14 手指位置、3 重力),状态 dropout 0.2,人类与机器人样本共用同一个 action expert 与 embodiment tag;DiT4DiT 用 32 个值。
| Backbone | chunk 长度 H | 状态条件 | 运动目标缩放 |
|---|---|---|---|
| $\pi_{0.5}$ | 50 | 110 值,tokenized | 恒等 |
| GR00T N1.7 | 40 | 46 值,state encoder | 恒等 |
| DiT4DiT | 50 | 32 值,state encoder | 恒等 |
表 1:三种 backbone 的 VioLA 接口(论文表 2)。所有变体预测同样的 128 个身体与手部坐标,不做目标归一化。
DiT4DiT 是世界-动作模型:除动作外还要预测跟随当前图像的未来视频帧 $\mathbf{V}_{t}$,两项损失相加:
$$\mathcal{L}_{\mathrm{WAM}}=\mathcal{L}_{\mathrm{video}}(\mathbf{V}_{t}\mid I_{t},\ell)+\mathcal{L}_{\mathrm{motion}}(\mathbf{Z}_{t}\mid I_{t},\ell,\mathbf{s}_{t}). \tag{8}$$
它用 Cosmos-Predict2.5-2B,取第 17 层特征条件化动作 transformer;训练时视频分支接受当前帧加偏移 $12,24,36,48$ 的四个未来帧监督,动作损失的梯度也回传更新视频 backbone;部署时只有当前观测可用,未来视频特征由模型自己预测。对人类片段而言,录制的未来帧监督视频预测,编码的身体与手部运动监督动作预测。
部署执行:50 Hz 下把隐码变成关节指令
部署时 VioLA 从机器人相机图、指令与本体感知预测一个运动 chunk;每个控制步,身体控制器把当前身体隐码与近期本体历史 $\mathbf{h}_{t}$ 变成关节指令,手部解码器把手隐码变成手指指令:
$$\mathbf{u}_{t}^{\mathrm{body}}=D_{\mathrm{body}}\!\left(\widehat{\mathbf{z}}_{t}^{\mathrm{body}},\mathbf{h}_{t}\right),\qquad \mathbf{u}_{t}^{\mathrm{hand}}=D_{\mathrm{hand}}^{\mathrm{robot}}\!\left(\widehat{\mathbf{z}}_{t}^{\mathrm{hand}}\right). \tag{9}$$
身体与手部指令以 50 Hz 更新。身体控制器每次更新都读机器人变化中的状态,因此通才策略计算下一个 chunk 期间,关节协调不中断。手部解码器从每个手隐码重建 10 帧,执行取第 5 帧(0-based)并做 5 tick 滑动平均,再转成手部关节指令;第 0 帧单独用于重建当前手部状态。Unitree G1 配 Inspire 五指手、每手 6 个主动关节,预测隐码经 Inspire 解码器产出 12 个手指目标;对以 14 值 Dex3 手状态训练的策略,measured Inspire 动作先编码再用 Dex3 解码器重建——被改变的是呈现给策略的状态表示,执行目标仍走 Inspire 解码器。编码器目标落在 FSQ 网格上,但动作专家预测连续坐标:$\pi_{0.5}$ 的执行路径把预测 clip 到 $[-1,1]$ 后直接送解码器,不做取整。
连续执行还要求相邻 chunk 在交接处一致。VioLA 在运动隐空间里做 RTC:下一个预测以「推理完成前将被执行的那些 latents」为条件,使新 chunk 带着它必须延续的运动。交接连续性用相邻 20 ms 控制步之间身体隐码的 L2 变化度量:$\Delta_{t}=\|\mathbf{z}_{t}^{\mathrm{body}}-\mathbf{z}_{t-1}^{\mathrm{body}}\|_{2}$,chunk 切换处的尖峰即为跳变。
数据与训练调度:781 小时里 93.2% 是人类
训练池由人类录制 EgoSuite(源自 EgoStandard)与四个机器人语料组成:Humanoid Everyday、PSI、UnifoLM-WBT、LeVERB。转换后共 31,988 条演示、140,572,312 帧、780.96 小时;人类数据占 episodes 的 64.6%、frames 的 93.2%。EgoSuite 从 26,382 条源 episodes 保留 20,680 条(5,702 条在转换与过滤中被排除);统一 loader 为评测保留 338 条 Humanoid Everyday;$H=50$ 时 LeVERB 的 3,555 条里有 46 条提供不出一个完整动作 chunk。Humanoid Everyday 与 UnifoLM-WBT 提供 commanded 手部运动,PSI 因无 commanded 轨迹而提供 measured 手部运动,人类手部目标来自拟合的 MANO 轨迹,LeVERB 只提供身体目标。
| 语料 | Episodes | Frames | 小时 | 目标 |
|---|---|---|---|---|
| Humanoid Everyday(真机 G1) | 4,064 | 2,962,764 | 16.46 | 身体+手 |
| PSI(真机 G1) | 835 | 1,431,454 | 7.95 | 身体+手 |
| UnifoLM-WBT(真机 G1) | 2,854 | 4,454,240 | 24.75 | 身体+手 |
| LeVERB(仿真 G1) | 3,555 | 713,279 | 3.96 | 仅身体 |
| EgoSuite(人类录制) | 20,680 | 131,010,575 | 727.84 | 身体+手 |
| 合计 | 31,988 | 140,572,312 | 780.96 | — |
表 2:转换后的演示池(论文表 1)。全部统一到 50 Hz;小时数按帧数除以 50 Hz 计。训练时的暴露程度由采样权重决定,而非语料体积。
训练调度是 150k 步纯人类演示,随后 50k 步对五个语料各以 0.20 概率均匀采样;批大小恒定,因此该调度期望把 80% 的训练样本分给人类数据——与人类占可用帧 93.2% 是两回事。robot-only 变体全程用四个机器人语料,在 50k 与 200k 步评测;human-only 变体全程用人类演示。所有变体都不做任务专属适配。
flowchart TD
  H[Human recordings EgoSuite
SMPL body and MANO hand motion] --> HENC[Frozen human body and hand encoders]
  R[Robot corpora Humanoid Everyday PSI UnifoLM-WBT LeVERB] --> RENC[Frozen robot body and hand encoders]
  SIM[Closed-loop sim tracking with frozen body controller
supplies robot heading and proprioception] --> HENC
  SIM --> RENC
  HENC --> TGT[Latent targets 64 body plus 64 hand FSQ coords
chunk Z of H steps]
  RENC --> TGT
  TGT -->|flow matching supervision| POL
  IMG[Egocentric image I_t] --> POL
  LANG[Instruction ell] --> POL
  PROP[Robot state s_t] --> POL
  POL[Latent generalist policy
GR00T N1.7 or pi_0.5 or DiT4DiT backbone
the only trained component] --> ZH[Predicted chunk with RTC conditioning
on latents executing during inference]
  ZH --> DB[Frozen SONIC v1.1 body controller
29 joint targets at 50 Hz]
  ZH --> DH[Frozen hand decoder
frame 5 of 10 plus 5-tick moving average]
  DB --> G1[Unitree G1 with Inspire hands]
  DH --> G1
图 3:VioLA 的训练与执行数据流。冻结编码器把两种演示写进同一潜在空间,通才策略是唯一被训练的部件,冻结解码器把预测变回关节指令。
实验结果
评测设置
真机是带 Inspire 五指手的 Unitree G1,在作者实验室评测。6 个运动/姿态任务的指令取自 LeVERB,7 个操作任务取自 Humanoid Everyday;两个语料同时贡献训练演示,因此评测任务与训练任务族重叠——被 held-out 的是具体 episodes、实验室环境与物体实例,且 Humanoid Everyday 的保留 split 完全不进训练。这里的 zero-shot 指部署时不做任务专属微调。每个策略每任务测 5 次;success 要求完成指令,progress 给部分完成打分(例如 robot-only 策略坐下但手臂仍伸直记 0.5);任务等权平均,报一个标准误。运动任务限时 5 s(Bend Down 10 s),操作任务无固定限时,但动作如何收尾也计入 progress;除 Stand Up 从坐姿开始外,其余从 idle 站姿开始。只有满分记 success。
零样本运动:30/30
6 个任务覆盖保持姿态、抬臂、弯腰、行走、坐定与从椅子站起。VioLA 预测每条指令对应的身体与手部动作,冻结身体控制器产出协调的身体指令、手解码器产出手指指令,30 次试验全部成功。发布的 GR00T N1.7 只会站定,5/30(16.7%);$\Psi_{0}$ 一次都没完成(0/30)。也就是说,VioLA 在作者实验室里不需要任何任务微调就能跟住全部六条运动与姿态指令;Bend Down 序列展示了完整的全身姿态变化:机器人从站立下沉到蹲姿并保持。
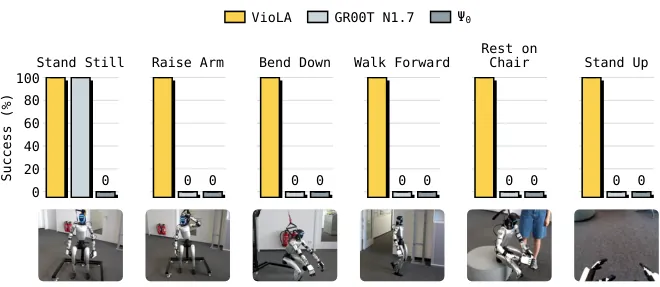
图 4:运动与姿态任务成功率(论文图 3 上半)。六个任务各 5 次试验:VioLA 全满,GR00T N1.7 仅站定非零,Ψ₀ 全零;照片为各任务现场。
零样本操作:31/35
操作额外要求身体把手送到物体处、手指在正确时刻动作以移动、抓取或释放物体。VioLA 完成 31/35(88.6%):Rotate Chair、Close Laptop、Place Dumpling、Close Kettle、Push Duck 全部 5/5,Hang Coat 4/5,Store Shampoo 2/5。这些任务覆盖推与合,也覆盖接取、搬运与放置。发布的 GR00T N1.7 35 次全败;$\Psi_{0}$ 只完成 3 次椅子旋转、其余全败(3/35,8.6%)。
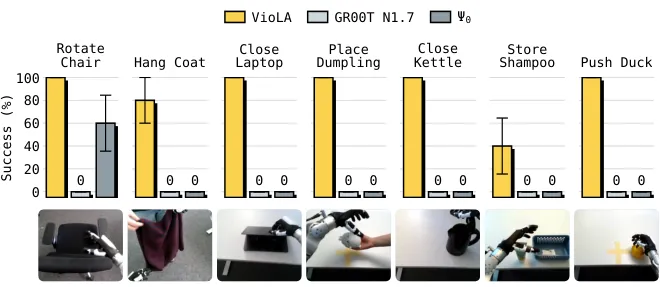
图 5:操作任务成功率(论文图 3 下半)。Ψ₀ 只在 Rotate Chair 上有约六成成功率;Store Shampoo 上 VioLA 约四成、其余两家为零。
四次失败集中在「拿到」与「拿住」:Store Shampoo 的失败是伸手去抓时把瓶子碰倒;图 6 末行是一次失败的挂衣执行——机器人接住了大衣,却在完成折叠与归还前把它掉了。这些例子说明,够到物体或完成初次抓取并不等于操作成功。单独分析的搬瓶任务至今无解:所有 VioLA 变体 5 次全败,失败阶段各不相同——抓取时机、从抓到走的切换、直立放置;把它计入后 VioLA 的操作成功率从 31/35(88.6%)降到 31/40(77.5%)。
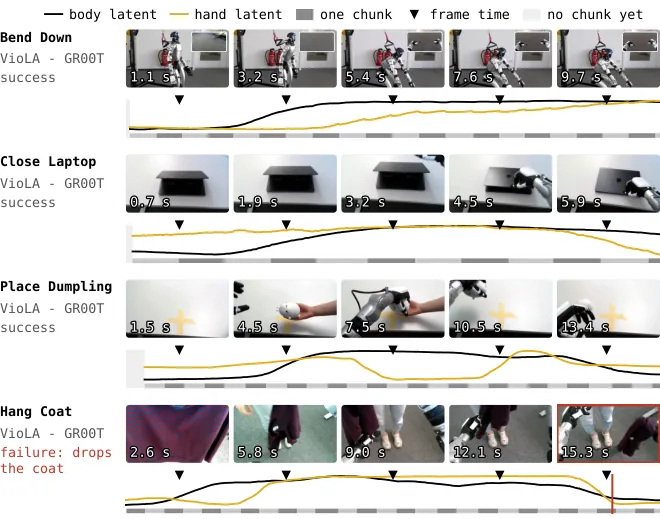
图 6:从身体动作到物体交互(论文图 4)。弯腰、合笔记本、放饺子玩具三行成功执行,末行挂衣失败(红色标记)。黑/金曲线是执行的身体与手部隐码在第一主成分上的投影(分别解释 63–91% 与 47–87% 方差),灰带为连续动作 chunk,三角对齐图像时间戳。
| 策略 | 运动/姿态(6 任务 × 5 次) | 操作(7 任务 × 5 次) |
|---|---|---|
| VioLA(GR00T N1.7 backbone) | 30/30(100%) | 31/35(88.6%) |
| GR00T N1.7(发布版) | 5/30(16.7%,仅站定) | 0/35(0%) |
| $\Psi_{0}$(发布版) | 0/30(0%) | 3/35(8.6%,仅椅子旋转) |
表 3:真机零样本主结果。三家都不做任务专属微调;VioLA 的关节指令由冻结控制器产出。
运动 token:复杂动作的描述其实很短
由于相邻隐码预测可能产生几乎相同的动作,作者把相似预测归组、每组记一个 distinct motion token,身体与手分开计数、每次执行单独起一组。一次完整的椅子旋转执行平均用 60 个身体 token 与 31 个手 token;合笔记本用 82 与 43;这两项执行平均时长 10.0 s 与 9.3 s。站定与抬臂分别约 20 与 36 个身体 token,行走要 182 个;手侧计数同样反映动作内容:抬臂只用 1 个手 token,椅子旋转与合笔记本需要多个手部动作。
归组距离在整数网格上量:把 64 坐标隐码映射到网格坐标后取 L1 距离,
$$\mathbf{q}=\mathrm{clip}\bigl(\mathrm{round}(16\mathbf{z}),-16,15\bigr),\qquad d(\mathbf{q},\mathbf{q}^{\prime})=\sum_{j=1}^{64}|q_{j}-q^{\prime}_{j}|. \tag{10}$$
按时间扫描,保留首个预测;后续预测若与最近保留代表的距离不超过阈值 $\rho$ 则归入该组,否则成为新代表(代表是原始预测向量,不是均值或取整向量)。阈值用解码姿态标定:84 条标定 episodes(32 椅子旋转 + 32 合笔记本 + 各 10 条放饺子与推鸭)加 21 条 held-out;参考预算取 SONIC 报告的真机 MPJPE-L 25.7 mm(14 个连杆)与作者实测的手部 commanded-vs-observed 差异 1.44 cm(83 条 Humanoid Everyday、6 个指尖代理、32,516 帧)。满足「95% 标定 episodes 的 episode 误差在参考预算内」的允许阈值是身体 16、手 96,论文报更细的 8 与 32 以压住腕部与单指偏差:身体阈值 16→8 把标定 episodes 的平均腕部 p95 从 5.09 cm 降到 3.03 cm,手阈值 96→32 把最差手指 p95 从 1.08 cm(椅子旋转)与 1.25 cm(合笔记本)降到 0.31 cm。细阈值下,全部 84 条标定、21 条 held-out 与 3 条椅子-alt 迁移 episodes 都满足均值预算;跨标定与 held-out 的最大 episode 级 p95 均误差为身体连杆 1.234 cm、指尖代理 0.294 cm。
| 任务 | 身体 token(均值) | 手 token(均值) | 平均时长 (s) |
|---|---|---|---|
| Stand Still | 19.8 | 2.8 | 7.0 |
| Raise Arm | 35.6 | 1.0 | 4.8 |
| Walk Forward | 182 | 16.0 | 5.8 |
| Rotate Chair | 60.4 | 31.4 | 10.0 |
| Close Laptop | 82.2 | 43.2 | 9.3 |
表 4:每次完整执行的 distinct 运动 token 均值(论文图 5 读数,阈值身体 8 / 手 32,每任务 5 条录制)。
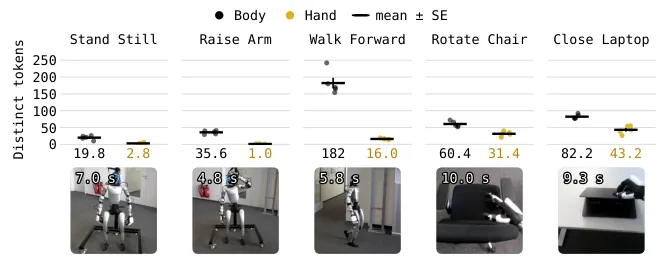
图 7:运动 token 计数(论文图 5)。每个点是一次完整录制的 distinct 身体(黑)/手(金)token 数;横线为均值、须为一个标准误。下方数字为均值计数与时长。
这组数字把「预测问题变了多少」说得很具体:每个身体 token 描述一段协调动作,由冻结控制器结合机器人变化中的状态转成关节指令;每个手 token 经手解码器指定手指动作。复杂执行只需少量 distinct 运动预测,而控制器仍在每个控制步更新关节——通才策略学的是「产出哪些动作、何时产出」,协调性由预训练运动模块复用。
人类数据到底贡献了什么
纯人类数据训练的 VioLA 变体在运动任务上 12/30(40%):弯腰 4/5、行走 3/5、坐定 2/5、从椅子站起 3/5;站定与抬臂指令跟不住。它还能跟住「走到黄色沙发」并蹲下——这些行为在通才策略训练里没有任何机器人演示,说明编码后的人类动作确实是可用于真机行为的动作监督,只是当前还覆盖不了全部六条指令。
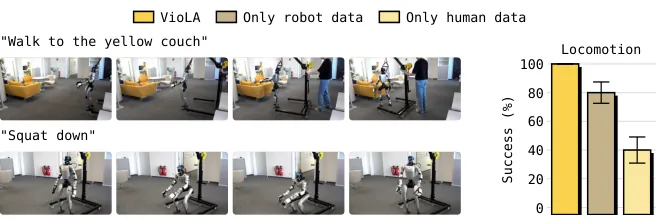
图 8:人类演示教会机器人行为(论文图 6)。左:纯人类策略执行「走到黄色沙发」与「蹲下」;右:human-then-mixed 30/30、robot-only 24/30、human-only 12/30 的运动成功率对比,三者同 backbone、同冻结运动模块,robot-only 与 human-then-mixed 均为 200k 步。
有机器人数据时,200k 步后 human-then-mixed 的 VioLA 30/30,robot-only 24/30(80%):差距来自弯腰(robot-only 5 次全败)与一次坐定(手臂没放下)。同等更新次数下,human-then-mixed 把运动成功率抬高 20 个百分点。操作侧则相反:robot-only 33/35(94.3%)对 VioLA 31/35(88.6%);robot-only 五次洗发水全成但水壶只成四次,VioLA 水壶全成、洗发水只成两次,其余五个任务计数相同。结论是分工式的:人类数据补上了 robot-only 策略缺失的身体动作,而抓握洗发水这类精细交互仍是机器人演示更强。
| 训练数据 | 运动成功率 | 操作成功率 |
|---|---|---|
| human-then-mixed(VioLA 主调度) | 30/30(100%) | 31/35(88.6%) |
| robot-only(200k 步) | 24/30(80%) | 33/35(94.3%) |
| human-only | 12/30(40%) | — |
表 5:人类与机器人监督的对照(论文 4.5 节)。三者均为同一 GR00T backbone 与冻结运动模块的 VioLA 变体。
backbone 对比:GR00T 最强,WAM 也能学会
三个变体用同一训练数据与预算、同样预测每步 64+64 坐标、由同样的冻结运动模块执行,因此这是 VLA 与 WAM 在人形学习上的一次同协议对照。运动任务上 GR00T 与 DiT4DiT 都 30/30,$\pi_{0.5}$ 20/30(66.7%)——站定、抬臂、坐定、站起能成,行走与全幅弯腰失败。操作把差距拉得更开:VioLA(GR00T)31/35(88.6%),$\pi_{0.5}$ 16/35(45.7%),DiT4DiT 9/35(25.7%);部分完成把 progress 抬到 51.4% 与 29.4%。行为层面:三个变体椅子旋转全成;$\pi_{0.5}$ 合笔记本与放饺子也全成,但四次抓到大衣后掉衣;DiT4DiT 拇指没能合拢大衣,一次放饺子以抓起后掉落告终。冻结的身体控制器与手解码器三者共享,差异全部来自通才策略的预测:成功操作需要把「伸手—抓取—释放」的序列维持到任务结束。
预测延迟上,GR00T 160.2 ms、$\pi_{0.5}$ 208.6 ms、DiT4DiT 248.5 ms,对应重规划间隔 559.9 / 608.4 / 648.0 ms(统计覆盖 161 / 83 / 57 条 episodes、3,871 / 2,554 / 1,035 个 chunk)。50 Hz 下每次预测约相当于 8–12 个控制步,期间机器人一直在动——这正是「从进行中运动到下一个预测的过渡」成为执行必要组成部分的原因,也是 RTC 必须存在的原因。
| Backbone | Episodes | Chunks | 预测延迟 (ms) | 重规划间隔 (ms) |
|---|---|---|---|---|
| GR00T | 161 | 3,871 | 160.2 ± 1.8 | 559.9 ± 1.8 |
| $\pi_{0.5}$ | 83 | 2,554 | 208.6 ± 0.6 | 608.4 ± 0.6 |
| DiT4DiT | 57 | 1,035 | 248.5 ± 2.5 | 648.0 ± 2.4 |
表 6:实测 chunk 时序(论文表 3)。均值 ± 一个标准误,跨 recorded episodes。
RTC:交接处的跳变确实被压下去了
在 Stand Still 与 Raise Arm 上对比开/关 RTC:前者检验保持姿态时的一致性,后者检验目标姿态变化时的连续性。无 RTC 时,chunk 切换附近反复出现尖峰,连站定也不例外;开 RTC 后,切换处的变化回到切换间波动的水平。在展示的 5.1 s 窗口内,最大步变化 Stand Still 从 0.332 降到 0.064,Raise Arm 从 0.455 降到 0.070。附录 A.9 说明这四条 trace 的预测延迟本身略有不同(Stand Still 开/关 RTC 分别 138.9 / 154.1 ms,Raise Arm 130.0 / 155.3 ms),chunk 切换间隔约 537 / 552 ms 与 529 / 553 ms;报的是这四条例子的最大值,不是多次试验的平均。
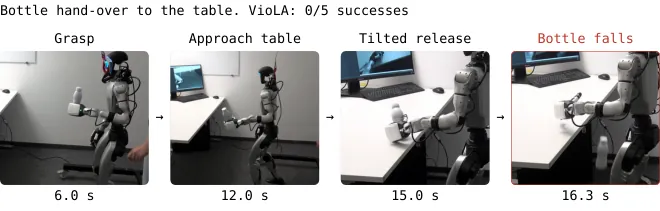
图 9:搬瓶任务在释放阶段失败(论文图 10)。机器人从人手中接瓶、走向桌子、在瓶子倾斜时张开手,瓶子随后倒下;时间戳为片段起始秒数。该任务 0/5,与七个主操作任务分开报告。
局限性
作者自述三条。其一,VioLA 复用预训练身体与手部模块,能力上限就是这些模块能执行的动作集合;手解码器只输出手指位置指令、没有接触力反馈,操作试验里「伸手去抓」与「抓完拿住」仍是难点,把接触反馈引入手部控制是作者点名的改进方向。其二,从人类录像学习需要身体与手部动作标注,扩展到更多视频取决于能否可靠估计这些运动;且当前调度下人类监督并非全面占优——human-then-mixed 提升运动、robot-only 的操作成功率反而更高,如何在保留运动收益的同时改善物体交互是开放问题。其三,主评测只有一台 Unitree G1、13 个任务、每任务 5 次,跨任务、跨环境、跨本体的更广泛测试尚未做。
从评审视角看还有几处值得点名。其一,zero-shot 的口径是「任务族在训练里、held-out 的是 episodes、环境与物体实例」,不是任务级零样本,读结论时不能外推成「任意新指令都能跟」。其二,搬瓶任务单列后操作成功率是 77.5% 而非 88.6%,且所有变体(含 200k 步 robot-only)在该任务上全败,说明「抓取—行走—直立释放」的复合链是当前方法的系统性短板,而非某个 backbone 的偶发问题。其三,RTC 的连续性证据只来自四条 recording 的最大步变化,作者也明确说这是例子而非统计量;token 计数则依赖阈值选择,虽然附录给了标定与敏感性曲线,但「60 个 token 描述一次椅子旋转」这类结论对阈值仍敏感。其四,人类数据的贡献与调度耦合:主调度下人类样本期望占 80%,robot-only 对照用满 200k 步机器人数据,二者在操作上的差距有多少来自数据配比、多少来自数据性质,论文没有拆解。其五,代码与 checkpoint 尚未发布,项目页只标 coming soon,复现性目前无法验证。
总结与展望
VioLA 的关键一步不是新模型,而是换掉了通才策略的输出:当动作空间是「冻结控制器能执行的运动隐码」时,协调与平衡被外包给已经训好的模块,策略只需要决定做什么动作、何时做;而同一空间对人类与机器人动作同时开放,人类录像于是从「不能用的素材」变成「自带标签的演示」。140.6M 帧、93.2% 人类的训练池,与真机 30/30、31/35 的零样本结果,是这条路线目前最直接的证据;纯人类数据训练仍能取得 40% 运动成功,则把「人类视频能否监督真机行为」从设想变成了可测量的事实。
它也给社区留下一串清晰的问题:手部缺接触反馈时,抓取与持物的可靠性上限在哪;人类监督的收益能否从身体动作扩展到物体交互;当 backbone 换成会预测未来视频的 WAM 时,视频分支对人类数据还有多少利用空间;以及把这套潜在动作接口接到更多本体上时,冻结控制器的可迁移性如何。对做真机人形的团队而言,这篇论文给出的可操作结论很朴素:先把低层控制器训到能稳定执行潜在动作,再让上层策略在这个空间里学——数据瓶颈会因此从「机器人演示」松动到「带标注的人类动作」。
金句
「解决第一个障碍的方案里,已经装着第二个障碍的答案:当控制器能执行潜在动作时,人类的动作本身就成了机器人策略的动作标签。」