BLOG
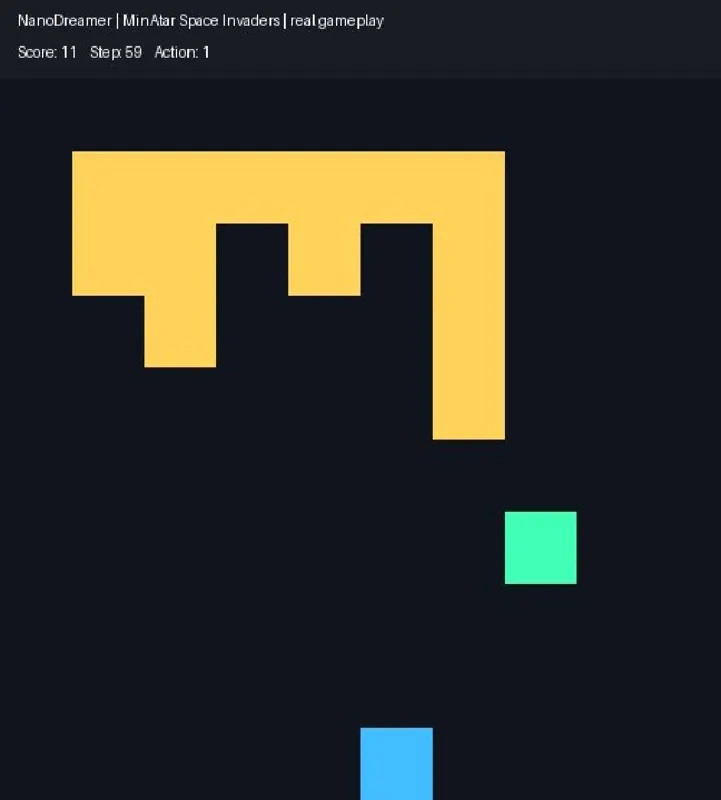
作者从 autograd 和张量库开始,在 MacBook 上造出 750k 参数 Dreamer。Actor 完全在想象 rollout 中训练,最终在 5 个 MinAtar 游戏全部超过随机基线;文章完整保留奖励错位、critic 过度乐观、CNN/多步 rollout 重建与消融结果。
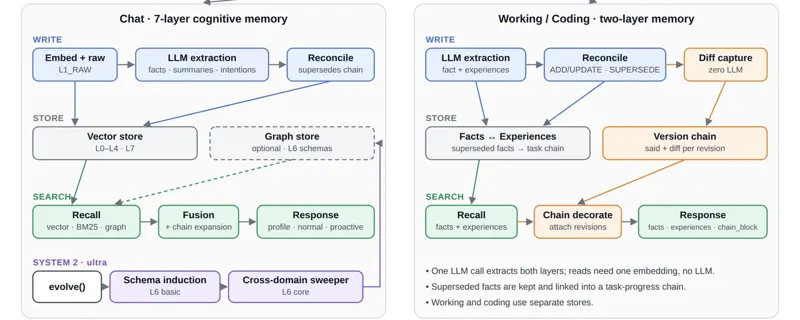
腾讯混元开源 Hy Memory 2.0:3B 激活的专用写入模型 Hy-Memory-30B-A3B、hy-memory SDK 与本地优先 MemHub,四 harness 宏平均 55.49 超 Opus 5。
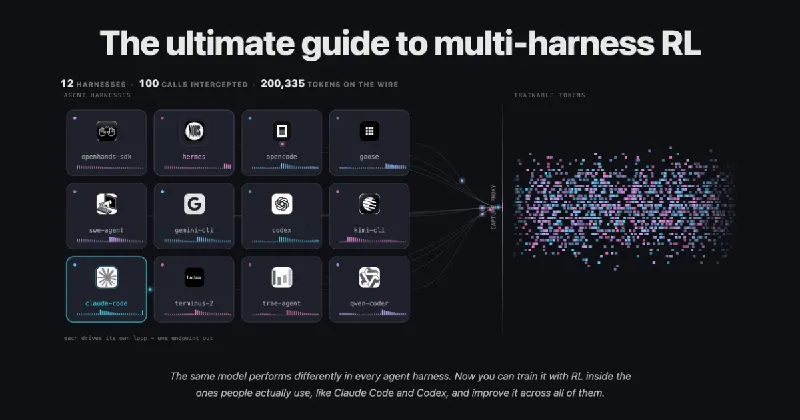
同一个模型换个 agent harness 表现判若两人:GLM-5.2 在 SWE-bench Pro 上一个 harness 23%、另一个 52%;受控实验里换 harness 移动 13 个点,同 harness 换模型只移动 2.5–5 个点。Hugging Face 团队(Adithya S Kolavi、Joel Niklaus、Lewis Tunstall、Leandro von Werra 等,联合 Liquid AI)发布的这篇长文给出开放解法:在 Claude Code、Codex、OpenCode、Mini-SWE-Agent 这些真实 harness 里做 agentic RL,harness 一行代码不改。框架三件套——OpenEnv 提供与环境/训练器共享的标准接口,capture proxy 以「会话即钥匙」方式截获模型端点上的精确 token id、逐 token 行为 logprob 与损失掩码(强制全分布采样,top_p=1.0),Harbor 提供 40+ harness 适配器与 26 种沙箱后端,TRL 的 Async GRPO 消费带掩码的训练序列。用 1 万小时级数据之外的实打实数字说话:LFM2.5-2.6B 四 harness 训练后平均 pass@1 从 42.2% 升到 54.2%,四个 harness 全涨,已解任务工具调用少 31%;只训 OpenCode 的对照组增益几乎锁在自己家里。文章还诚实交代了 SFT 对照(RL 54.6% vs SFT 47.5%)、Qwen 先涨后崩的完整归因(输出预算耗尽、不交卷空转、奖励项被钻空子导致 0.740→0.178)以及 proxy 并发上限等工程边界。
Odyssey(联合 UCL AI Centre 与巴塞尔大学)10 月 1 日发布 PROWL-2:首个把「任务策略课程」与「世界模型修复课程」耦合进同一持续训练循环的框架。核心洞见:想象训练中高学习信号的轨迹是歧义的——可能是策略真弱点,也可能只是世界模型预测错了;不加分拣地优先学习等于强化模型自己的幻觉。PROWL-2 用一道保真度门把「有用」与「可信」分开判定:可信的高潜力想象经验进策略课表,不可信的连同其已存储的真实延续一起送进修复池,由随机初始化+KL 锚定的开发者策略在真实环境中修复,修好重审再放行。SMACv2 九场景全部第一(5v5 提 4–18%、10v10/10v11 提 20–91%);MQE 难任务大幅领先——Gate-3 70.4% vs 骨干 29.8%、Shepherd-Hard 28.2% vs 7.3%,其余基线全为 0。消融证明两份课表并非可加:只修不排课收益边际,只排课不加门在九个场景全部低于骨干,加门后同一套课程变成最大单项增益。框架对世界模型架构与 MARL 算法完全不可知,后续指向人形机器人协作与长视野多智能体游戏。
Physical Intelligence(Sergey Levine 团队,2026-03-19)发布 RL Token(RLT):冻结预训练 VLA,外挂编码器-解码器把内部嵌入压缩成信息瓶颈式的 RL token,再以约 1M 参数的 actor-critic 在真机上做在线 RL,只精修任务临界相位(编辑 VLA 动作块而非从零生成,BC 正则锚定 + 参考动作 dropout)。四个亚毫米级任务临界相位提速最高 3×,螺丝成功率 20%→65%,网线插入一半回合快过所有人类遥操作演示——只需 15 分钟真实机器人数据。
Asimov 开源 2 万美元 DIY 人形套件:25 自由度硬件、加工代码、CAN 接线陷阱,与零微调 sim-to-real 行走策略全解。
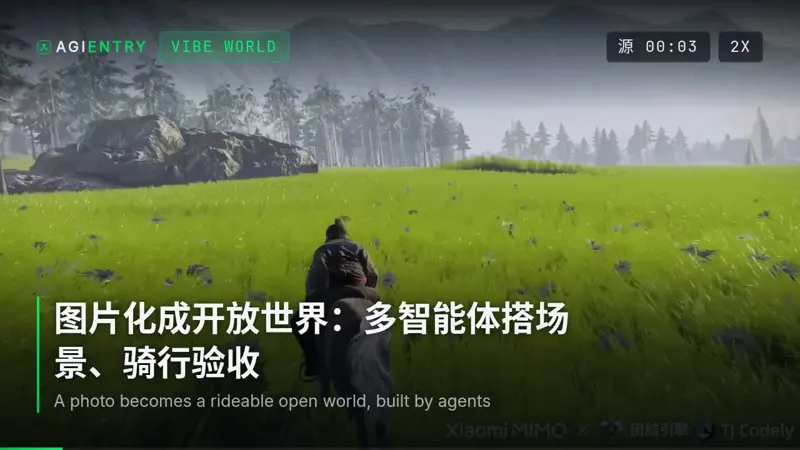
小米开源 MiMo-V2.6 Pro/Flash:30 步 Live RL、约 75 万条轨迹、$850k/$2.62M 成本公开;AA 指数 46 登顶开源,DeepSWE v1.1 样本外 +17/+14 分;Vibe World、CUA、科研与内容创作全演示,7k+ RL 环境一并开源。
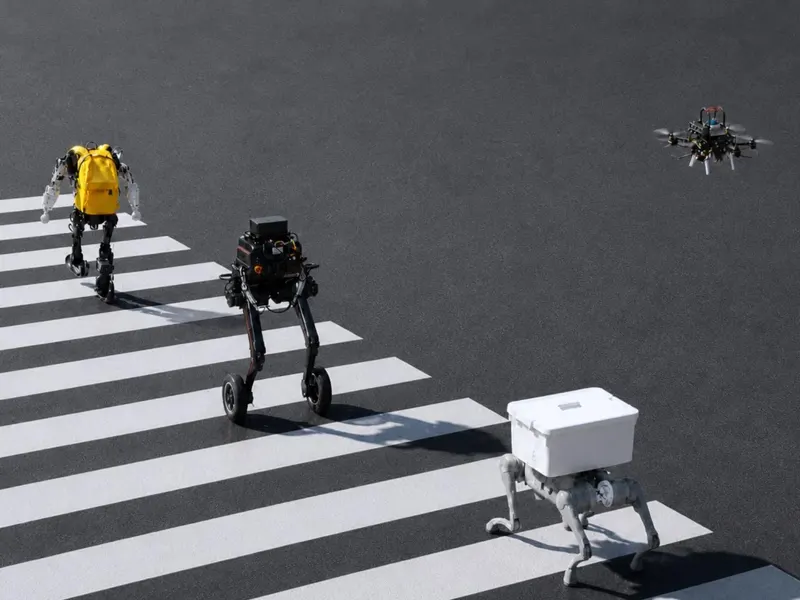
Light Origins 发布 LightNav-0:Real2Sim2Real 数据引擎把 2000+ 互联网真实场景变成可复用仿真世界,产出 4000+ 小时视觉-语言-动作经验,经三阶段后训练在 10 项仿真设置中刷新纪录,并零样本迁移到人形、四足、空中与轮式机器人。
Meta Reality Labs Research 开源 Project SuperDex:以自研接触优先物理引擎为核心,叠加工具链与 Gymnasium 风格 RL 接口的灵巧操作仿真平台,支持软体/杆腱/非凸接触、VR 遥操作合成数据,并展示形状分拣策略零样本迁移到真实机械手。
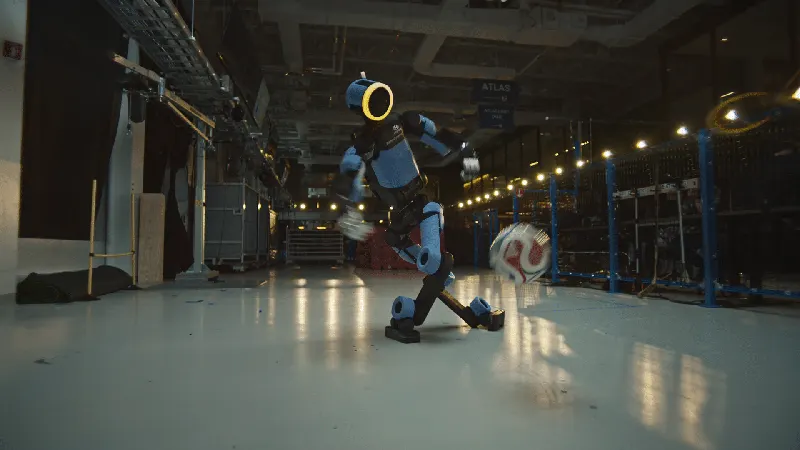
波士顿动力教 Atlas 学踢足球,用动作捕捉+强化学习训练幽灵弧线球。足球要求的全身协调能力可直接迁移到工业操作任务。
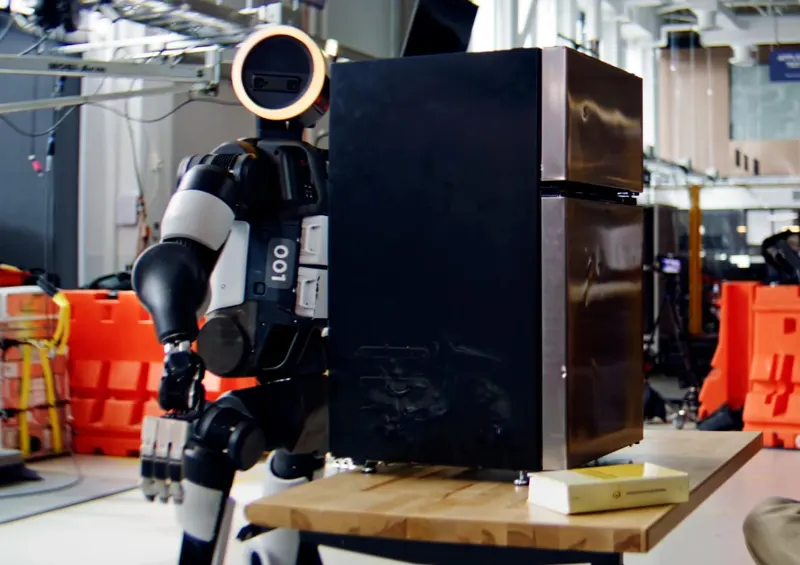
波士顿动力分享 Atlas 通过强化学习训练全身举重行为的方法:从参考轨迹到奖励设计、GPU 大规模仿真、真实硬件测试的迭代循环,展示物理智能的基础构建块。
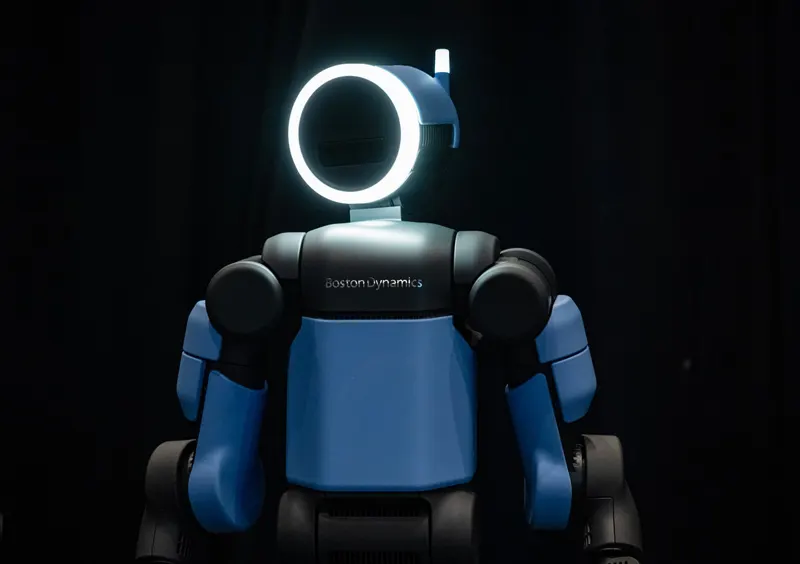
波士顿动力回顾 Atlas 十年进化历程:从液压跑酷研究平台到电动工业人形机器人。2026 年与现代汽车集团发布生产级 Atlas,已在现代超级工厂进行零件排序部署。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。