NanoDreamer:只有 750k 参数,却在想象中学会玩 5 个游戏
作者从 autograd 和张量库开始,在 MacBook 上造出 750k 参数 Dreamer。Actor 完全在想象 rollout 中训练,最终在 5 个 MinAtar 游戏全部超过随机基线;文章完整保留奖励错位、critic 过度乐观、CNN/多步 rollout 重建与消融结果。
Benjamin Bai 喜欢电子游戏,也开始读世界模型和具身智能,所以 Dreamer 对他有天然的吸引力。但他面对一个现实问题:没有 GPU。他没有等硬件,而是从底层造了一个极小的 Dreamer:自己写 autograd 引擎、张量库、神经网络层、优化器和 Transformer,让整套系统小到能在 MacBook 上训练。
最终得到的是 NanoDreamer:一个约 750k 参数的世界模型加 actor-critic,能学会玩全部 5 个 MinAtar 游戏。每个游戏使用独立权重,但架构和训练配置完全相同。它不依赖专家演示,也没有任何手工策略;策略从自己的真实对局中学习,而 actor 完全在世界模型的想象 rollout 中训练。每个游戏训练 500,000 个真实策略步,在 M5 Pro 上约 3 小时。
本文是 Benjamin Bai 原文的完整双语改编版,保留了失败的第一版。没有把故事直接从最终架构讲起,因为调试路径才是这个项目最有价值的部分。
第一版有多难?
Bai 先读 DreamerV3 和 DreamerV4,再把想法拆成三件事:世界模型学习游戏如何运行;actor 在模型的预测内部选择动作;critic 估计短想象视野之外的回报。
flowchart LR
    F["游戏帧"] --> E["MLP 编码器
64 维 latent"]
    E --> H["latent 历史"]
    H --> T["因果 Transformer
8 步上下文"]
    A["Actor 动作"] --> T
    T --> P1["下一 latent"]
    T --> P2["标量奖励"]
    T --> P3["继续概率"]
    H --> AC["Actor / Critic MLP"]
    P1 --> R["5 步想象 rollout"]
    P2 --> R
    P3 --> R
    R --> AC
第一版编码器是 MLP autoencoder,把每帧压成 64 维 latent,先训练重建,再冻结权重。MinAtar 画面大多数格子是空的,所以如果损失让空格子主导,模型只要预测一张几乎空白的画面就能拿到很低的重建误差。作者因此使用加权二元交叉熵,让漏掉有物体的格子付出更高代价:
$$ \mathcal L_{\mathrm{reconstruction}} =-\operatorname{mean}_i\left[ w_i x_i\log \hat x_i+ (1-x_i)\log(1-\hat x_i) \right]. $$
其中 $x_i$ 是某个通道中一个格子的真实占用值,$\hat x_i$ 是预测概率,$w_i$ 依据稀有程度给有物体的格子更高权重。若 $x_i=1$,损失项是 $-w_i\log \hat x_i$。预测 0.9 的损失约为 $0.105w_i$,预测 0.1 的损失约为 $2.303w_i$,自信的错误会被罚得更重。
预测器读取 8 步 latent 与动作历史,由两个因果 Transformer block 组成,宽度 64,注意力头数 4。三个预测头分别输出下一 latent、奖励和继续概率:
$$ \hat z_{t+1}=z_t+\Delta z_t, \quad \mathcal L_{\mathrm{next\ latent}} =\mathrm{MSE}(\hat z_{t+1},E(x_{t+1})), $$
$$ \mathcal L_{\mathrm{reward}}=\mathrm{MSE}(\hat r_t,r_t), \qquad \mathcal L_{\mathrm{continuation}}=\mathrm{BCE}(\hat c_t,c_t). $$
预测 latent 还会被解码并与真实下一帧比较,发生变化的格子获得更高权重,这样小型移动弹体不容易被忽略。第一版世界模型损失为:
$$ \mathcal L_{\mathrm{world}} =\mathcal L_{\mathrm{next\ latent}} +2\mathcal L_{\mathrm{reward}} +0.2\mathcal L_{\mathrm{continuation}} +0.5\mathcal L_{\mathrm{predicted\ frame}}. $$
这些系数是手工平衡权重,不是从 Dreamer 推导出的理论值,也没有经过受控比较证明最优。各项损失尺度不同,所以系数 2 并不表示奖励的重要性严格是其他项的两倍。
actor 从 replay 中的真实历史出发选择动作,模型预测下一 latent、奖励和继续概率,预测 latent 再送回模型,actor 继续选择,如此重复 5 个想象动作。简化后的回报目标是:
$$ G_0=\hat r_0+\gamma\hat r_1+\gamma^2\hat r_2+\gamma^3\hat r_3 +\gamma^4\hat r_4+\gamma^5V(s_5). $$
实际实现使用 $\lambda$-return:
$$ G_t^\lambda=\hat r_t+\gamma\hat c_t \left[(1-\lambda)V(s_{t+1})+\lambda G_{t+1}^\lambda\right], \qquad G_5^\lambda=V(s_5). $$
作者取 $\gamma=0.99$、$\lambda=0.95$。继续概率 $\hat c_t$ 会在模型认为想象回合结束时截断未来收益。每个决策都有自己的回报目标,advantage 由 critic 的期望构成:
$$ A_t=\operatorname{sg}(G_t^\lambda-V(s_t)), $$
$$ \mathcal L_{\mathrm{actor}} =-\mathbb E_t[\log \pi(a_t\mid s_t)A_t], \qquad \mathcal L_{\mathrm{critic}} =\mathbb E_t[(V(s_t)-\operatorname{sg}(G_t^\lambda))^2]. $$
正 advantage 让被采样动作更可能出现,负 advantage 则抑制它。stop-gradient 让学习目标在一次更新中保持固定,熵奖励鼓励探索。但问题在于:actor 能拟合想象回报,不代表想象回报符合真实游戏。
它没有工作
第一轮只训练约 20,000 步,agent 甚至不开枪。30 局平均得分 0.03,而随机策略得 4.3。它只会左右移动,最后以 0 分结束。
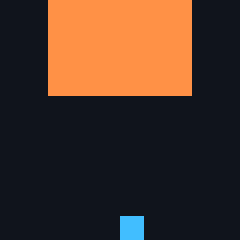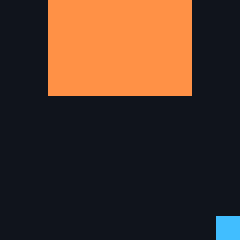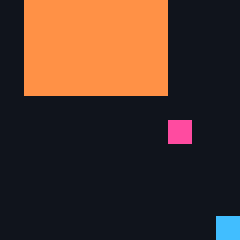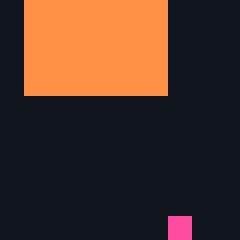
第一个诊断对象是奖励预测。Bai 在真实游戏和模型中重放完全相同的动作,然后比较真实转移与预测转移。一个例子是:模型在第 4 步预期约 1.19 分,真实射击在第 5 步得 1 分,而模型恰好在第 5 步几乎预测为 0;没有奖励发生时,它甚至预测出小的负奖励。actor 拿到的是错误的学习信号。
在更多轨迹上,随着模型向前滚动,奖励时序迅速失准。1 步预测约有 72% 的奖励事件落在正确时间步;到 8 步,只剩约 1%。
| 预测步数 | 奖励时序正确数 | 比例 |
|---|---|---|
| 1 | 83 / 116 | 72% |
| 3 | 23 / 128 | 18% |
| 5 | 23 / 124 | 19% |
| 8 | 1 / 121 | 1% |
不可靠的想象奖励还会污染 critic。一次诊断中,critic 的平均估计是 10.46,而真实折扣回报平均只有 3.16。actor 因此同时面对错位奖励和过度乐观的价值基线。
改变学习方式
模型能从真实历史预测,却很难从自己的预测继续滚动。Bai 做了两项改动。第一,把 actor 的真实对局加入 replay,而不是只训练随机经验。流程变成:真实对局,保存轨迹,更新编码器与世界模型,然后 actor 和 critic 在想象中练习。策略变化后,它新造成的错误也会进入训练数据。
第二,测试多步预测。不再只从真实历史预测一步,而是把每个预测 latent 送回模型,用记录到的真实动作驱动 rollout,再和真实未来 latent 比较。一个实验在 5 步 rollout 上微调模型 600 次更新:
$$ \mathcal L_{\mathrm{rollout}}^{\mathrm{latent}} =\mathrm{step\ 1\ 误差} +\mathrm{step\ 2\ 误差} +\cdots +\mathrm{step\ 5\ 误差}. $$
在单独的 5 步检查中,600 次 rollout 更新把 latent 预测误差降低约 18%,奖励预测误差降低约 9%。但预测更好不等于 agent 更好。把在线 replay 和 rollout 训练结合后,Space Invaders 在约 50k 步达到 4 分左右,然后停滞,仍然接近随机策略。
重建表示和 rollout
Bai 回到较早的 DreamerV2 思路,并用诊断结果重新设计画面表示与未来练习。弹体可能出现在任意列,MLP 必须为每个位置单独学特征;CNN 可以在整个棋盘上复用同一组局部滤波器。于是“展平图像加 MLP”的编码器换成共享 3×3 卷积。
预测器也要练习使用自己的输出。重建版保留 3 步生成 rollout,并更频繁采样稀有奖励事件,再用重要性权重纠正采样偏差。
为验证效果,Bai 用相同动作重放早期模型和重建模型。两者都从 8 个真实帧出发,预测 8 步。评估使用 30 局随机对局的轨迹,共 1,314 个 rollout 窗口。
| 预测步数 | 第一版 | 重建模型 |
|---|---|---|
| 1 | 53 / 93 = 57% | 81 / 93 = 87% |
| 3 | 21 / 97 = 22% | 53 / 97 = 55% |
| 5 | 6 / 95 = 6% | 40 / 95 = 42% |
| 8 | 0 / 93 = 0% | 26 / 93 = 28% |
重建模型的奖励时序和累计奖励都更准。5 步累计奖励误差从 0.313 降到 0.125,约降低 60%。但它并非全面更好:第 5 步的误报从 6 增加到 27。它找到更多真实奖励,也预测了更多没有发生的奖励。
还有一个反直觉现象。对某一次射击,第一版解码出的想象画面恰好比重建版更接近真实画面,尽管在更大的测试上重建模型的奖励时序明显更好。看起来更干净的想象画面,不等于对决策更有用的奖励预测。
最终方案
更好的预测只有在 actor 能利用时才有价值,所以最终版还改变了行为学习。actor 和 critic 不再只看当前 latent 加一帧变化,而是接收 Transformer 对最多 16 帧和先前动作的摘要。一个独立 action MLP 把历史摘要与当前动作结合,再交给预测头,这样 actor 可以先基于历史选择动作,模型再预测该动作的后果。critic 同时加入真实 replay 回报,以约束此前的过度乐观。
flowchart LR
    X["MinAtar 帧"] --> C["CNN 编码器
16-32-64 通道"]
    C --> Z["64 维 latent"]
    Z --> H["latent 与动作历史
最多 16 步"]
    H --> T["因果 Transformer
宽度 128,2 层,4 头"]
    T --> S["历史摘要 h_t"]
    S --> A["Actor"]
    S --> V["分布式 Critic"]
    S --> M["Action MLP"]
    A --> AT["选中动作"]
    AT --> M
    M --> L1["下一 latent 头"]
    M --> L2["255-bin 奖励头"]
    M --> L3["继续概率头"]
    L1 --> D["解码器和预测帧"]
    L1 --> I["5 动作想象 rollout"]
    L2 --> I
    L3 --> I
    I --> A
    I --> V
CNN 编码器把每帧压成 64 个数,解码器用加权二元交叉熵重建观测通道。与第一版不同,预测损失现在也训练编码器。一个缓慢移动的目标编码器提供 latent 目标,避免预测器追着编码器的每次更新跑:
$$ \bar\theta_E \leftarrow 0.99\,\bar\theta_E+0.01\,\theta_E. $$
带上横线的 $\bar\theta_E$ 是目标编码器权重。每次更新保留旧目标的 99%,取当前编码器的 1%;梯度不会更新目标网络。
Transformer 读取最多 16 帧和先前动作,包含两个因果 block,宽度 128,注意力头数 4。一个小 MLP 把摘要 $h_t$ 与当前动作结合,随后三个头预测下一 latent、奖励分布和继续概率。对第 $k$ 个生成步:
$$ \begin{aligned} \ell_k={}&\mathcal L_{\mathrm{next\ latent}} +\mathcal L_{\mathrm{predicted\ frame}}\\ &+2\mathcal L_{\mathrm{reward}} +0.2\mathcal L_{\mathrm{continuation}}. \end{aligned} $$
下一 latent 用对目标编码器输出的均方误差训练;预测帧用加权二元交叉熵;奖励头对 two-hot 目标做交叉熵。symlog 变换把奖励映射到 $[-5,5]$,概率质量再分配到相邻两个 bin:
$$ \operatorname{symlog}(r) =\operatorname{sign}(r)\log(1+|r|), \qquad b=\frac{\operatorname{symlog}(r)+5}{10}\times254. $$
继续概率用二元交叉熵。3 个生成步都会把自己的预测送回模型;25% 的采样起点来自奖励事件,重要性权重纠正这种混合采样。世界模型总损失是:
$$ \mathcal L_{\mathrm{world}} =\mathcal L_{\mathrm{reconstruction}} +\mathcal L_{\mathrm{one\text{-}step}} +\frac13\sum_{k=1}^{3}\ell_k. $$
重建项检查真实帧;one-step 项检查从真实历史出发的 latent 和解码帧预测;平均后的 3 步项检查由模型自身输出生成的未来。目标 latent 会 detach。
actor 和 critic 读取 Transformer 的历史摘要。从 replay 出发,actor 选择 5 个想象动作;世界模型预测每个动作的奖励和继续概率,target critic 估计 rollout 之后的剩余价值:
$$ \begin{aligned} G_t^\lambda&=\hat r_t+\gamma\hat c_t \left[(1-\lambda)\bar V(h_{t+1})+\lambda G_{t+1}^\lambda\right],\\ G_5^\lambda&=\bar V(h_5). \end{aligned} $$
这里仍取 $\gamma=0.99$、$\lambda=0.95$。actor 目标用运行中的回报范围 $S$ 缩放 advantage,并加一个小熵奖励:
$$ \begin{aligned} A_t&=\operatorname{sg}\left( \frac{G_t^\lambda-V(h_t)}{\max(1,S)} \right),\\ \mathcal L_{\mathrm{actor}} &=-\mathbb E_t\left[ w_t\left(A_t\log\pi(a_t\mid h_t)+0.001\mathcal H\right) \right]. \end{aligned} $$
其中 $w_t$ 用预测继续概率折扣后续状态,$\mathcal H$ 是策略熵。actor 的梯度穿过动作概率,不穿过世界模型。critic 使用 3 步真实 replay 回报,加上权重较小的想象回报损失:
$$ \mathcal L_{\mathrm{critic}} =\mathcal L_{\mathrm{real\ replay}} +0.3\,\mathcal L_{\mathrm{imagined}}. $$
两项都把分布式价值 bin 拟合到 detach 后的 two-hot 目标。真实样本使用 replay 重要性权重;想象样本使用继续概率权重。target critic 每次更新向当前 critic 移动 2%。
训练先从 4,000 个随机环境动作开始,随后 actor 持续采集真实对局。每 8 个策略步更新一次世界模型、actor 和 critic。随机动作探索从 40% 开始,到 26,250 个策略步降到 5% 下限,让 agent 仍有机会尝试当前偏好之外的动作。
五个游戏的结果
最早出现希望的是 200k 策略步时的 Space Invaders 和 Breakout 曲线:Space Invaders 得 12.87,随机基线 4.51,接近随机的 3 倍;Breakout 得 3.04,随机基线 0.44,接近随机的 7 倍。
随后,Bai 用相同架构和超参数、独立权重训练全部 5 个 MinAtar 游戏,每个 500,000 策略步。下表最终分数是每个 agent 在 100 局全新游戏上的平均值,评估上限 1,000 个动作。
| 游戏 | 随机基线 | NanoDreamer |
|---|---|---|
| Space Invaders | 4.14 | 22.61 |
| Breakout | 0.37 | 5.03 |
| Asterix | 0.40 | 1.50 |
| Seaquest | 0.28 | 3.93 |
| Freeway | 0.15 | 11.23 |
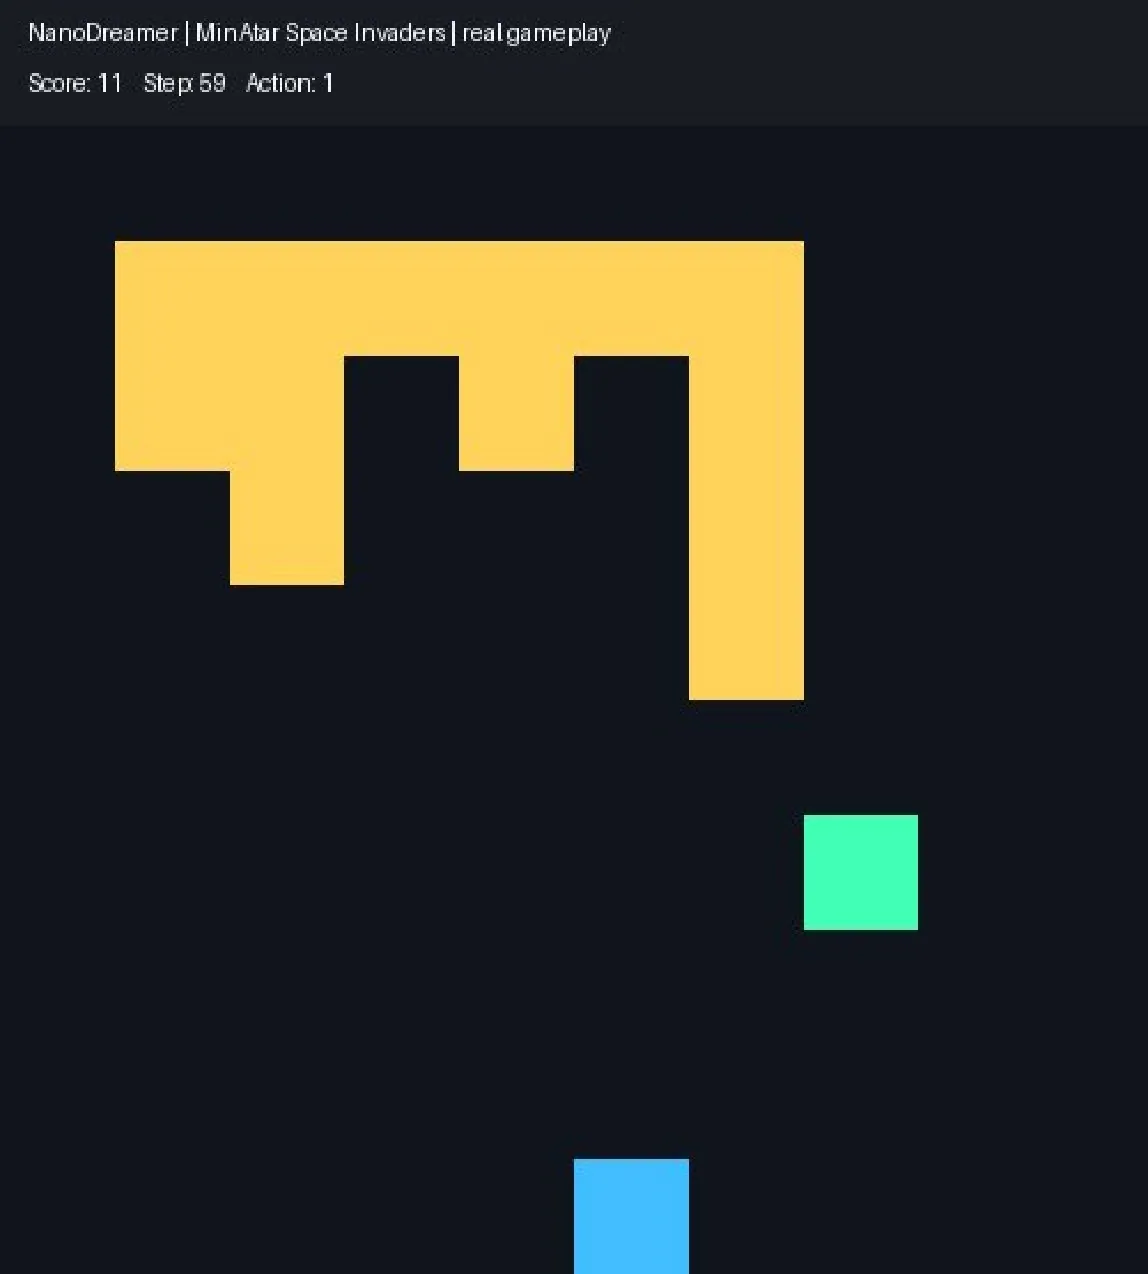
同一个约 750k 参数的小架构在全部游戏中超过随机基线。分数不能跨游戏直接比较,因为每个环境的得分机会不同。作者展示的 32 分 Space Invaders 片段是被选出的单局,不是平均成绩。
消融与诚实的局限
作者没有把最终配方说成每一项都必然必要。长时间训练后,他移除或替换单个训练信号,同时保持 actor 的完全想象训练。所有比较都用 150,000 真实策略步、100 局评估和 200 动作上限。
| 问题 | 比较 | 观察结果 |
|---|---|---|
| 预测误差应该训练编码器吗? | 联合训练编码器 vs 只做重建 | 种子 0 中,只做重建在 Space Invaders 更高:11.26 对 9.32;在 Breakout 接近:2.98 对 2.92。 |
| Critic 需要真实回报吗? | 完整混合 critic vs 只用想象回报 | 想象-only 在两个 Space Invaders 种子都更好:15.82/15.14 对 9.32/11.16;在 Breakout 上依赖种子:4.82/1.40 对 2.92/1.48。 |
| 简单选择能组合吗? | 完整配方 vs 想象-only critic vs 加重建编码器,种子 1 | Space Invaders:11.16、15.14、12.59;Breakout:1.48、1.40、5.08。 |
“只重建编码器 + 想象-only critic”在 Breakout 达到 5.08,而前两个配方停在约 1.4-1.5;在 Space Invaders 上它超过完整配方,但低于联合编码器加想象-only critic。这些效应不能简单相加,组合版本又只有一颗训练种子。
架构搜索也没有得出单一结论。把 Transformer 宽度从 64 扩到 128、block 从 2 扩到 3 后,世界模型从约 109k 参数涨到 613k。部分奖励指标改善,但对局表现没有稳定提升。作者还尝试了小型 RSSM、空间 token 和去噪实验,希望保留局部细节或建模更复杂未来;但检查点和训练条件不同,有些运行太短,无法把早期失败归因到某个单一架构原因。一次 RSSM 实验还有 replay bug:8 步窗口要求丢弃短回合,某随机数据集中 300 回合有 231 回合太短。重建后的 replay 保留短终止窗口并对 padding 做掩码。
| 设置 | 值 |
|---|---|
| latent 大小 | 64 |
| CNN 通道 | 16 → 32 → 64,3 × 3 滤波器 |
| Transformer | 宽度 128,2 block,4 注意力头 |
| 历史上下文 | 16 步 |
| 奖励 / 价值分布 | 255 bins,symlog 范围 -5 到 5 |
| 世界模型 / 真实回报视野 | 3 步 |
| Actor 想象视野 | 5 步 |
| 世界模型 batch | 32 个 replay 上下文 |
| 想象 batch | 64 个起始上下文 |
| 初始随机经验 | 4,000 个环境动作 |
| 更新频率 | 每 8 个策略步更新 1 次 |
| Replay 容量 | 200,000 条转移 |
| 奖励事件采样 | 25% 事件起点 + 75% 均匀起点,并做重要性纠正 |
| 优化器 | Adam |
| 学习率 | 世界模型 0.0002,actor 0.00004,critic 0.0001 |
| 梯度裁剪 | 每个优化器范数 5 |
| 折扣 / 回报混合 | γ = 0.99,λ = 0.95 |
| Actor 熵系数 | 0.001 |
| 策略概率混合 | 99% 学习概率 + 1% 均匀分布 |
| 随机动作探索 | 初始 40%,到 26,250 策略步降到 5% |
| 目标编码器 / critic 更新 | 每次更新 1% / 2% |
| 生成步损失权重 | latent 1,帧 1,奖励 2,继续 0.2 |
| Critic 损失权重 | 真实 replay 1,想象 0.3 |
MinAtar 奖励没有做自定义 shaping。开火、移动或存活都没有额外分。更频繁采样奖励事件、对奖励分 bin,只会改变训练数据分布和预测形式,不会给环境增加奖励。rollout 和评估上限也可能在环境自身计时器结束前终止记录回合;Freeway 尤其如此,它的环境计时器超过最终评估的 1,000 动作上限。
| 结果 | 评估设置 |
|---|---|
| 更长训练曲线 | 每个检查点 100 局,200 动作上限,各检查点评估种子不同 |
| 最终五游戏表 | 500k 训练步,每个游戏 100 局新游戏,1,000 动作上限 |
| 训练选择图表 | 匹配 150k 训练步,100 局,评估种子 920000,200 动作上限 |
| 训练选择终点检查 | 300 局,评估种子 940000,200 动作上限;一次运行在 184,712 步因时间上限停止 |
最终表每个游戏只有一颗训练种子;辅助比较有一或两颗种子。更多评估局数能降低对某个已保存策略的不确定性,但不能证明结果在训练种子间稳定。
分数之外
NanoDreamer 改变了 Bai 读论文的方式。架构图不再是他最先盯住的对象;假设、训练数据、诊断和支撑结论的实验更重要。他也开始区分两件常被混在一起的事:让 agent 工作起来,与理解它为什么工作。NanoDreamer 达成了前者,后者仍是开放问题。
接下来的问题也很具体:64 维 latent 丢掉了哪些信息?想象 rollout 什么时候变不可靠?agent 能否在信任自己的想象之前识别这种不可靠性?作者还保留了更游戏化的路线:继续用喜欢的游戏构建可用算法,比如 Smash Ultimate 或 Deadlock。
来源:Benjamin Bai,NanoDreamer: Learning to Act Through Imagination,2026 年 10 月。代码:benyebai/NanoDreamer。本文为完整双语改编版,并标注原文来源。
原文来源:Benjamin Baihttps://www.benjamin-bai.com/projects/nanodreamer