Mundo:从看见一个地方,到模拟那里会发生什么
拍几张照片,Mundo 就把它变成可探索、可编辑、可模拟的世界:3D 代理体加场景程序驱动仿真,视频模型渲染结果,支持新视角探索与机器人 Real-to-Sim。
Mundo 想去哪儿就去哪儿!
拍几张照片,Mundo 就能把这个房间变成一个可以探索、可以模拟的世界。你可以从任意视角环视房间,让抽屉滑开、让苹果飞出去,或者让一个机器人走进来把包放在床上。Mundo 会把这一切发生的过程渲染成这个房间的视频。
项目主页 · 把一个地方的几张视角图,变成一个可以探索、编辑、模拟的世界。
TL;DR
世界模型刻画环境的结构、外观与动力学,以支撑重建与模拟。Mundo 从某个具体地方的照片出发构建这样一个世界:它用 3D 代理体(proxy)表示场景的布局与物体,再用场景程序定义它们的物理属性;仿真器计算物体如何运动与相互作用,视频模型则以输入图像为视觉上下文把结果渲染出来。你可以从新视角探索这个环境、修改其中的物体,并在里面模拟机器人任务。
Mundo 是如何工作的
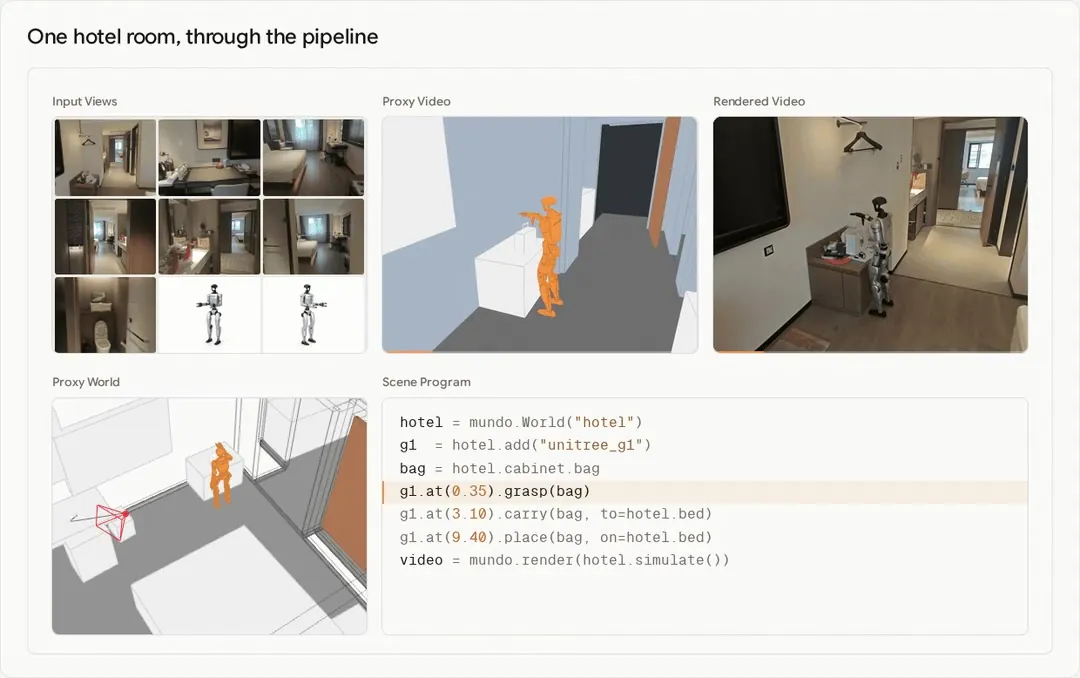
给定多视角图像或一段视频,Mundo 先重建场景,并把场景的布局与物体表示为显式的 3D 代理体。一个代码世界(code world)[1] [2] 在仿真运行过程中维护并更新这个代理体状态;仿真状态被渲染成代理帧(proxy frames),用来引导视频模型生成场景的外观与运动。
1. 构建代理世界
Mundo 用 3D 包围盒来表示场景:包围盒近似物体的形状,同时与输入视角中物体的位置和尺寸高度吻合。代理世界分两阶段构建。首先,3D 基础模型 [3] [4] [5] [6] 从输入视角恢复相机位姿与稠密几何;Mundo 用 3D 检测器 [7] 为每个主要物体得到初始包围盒。随后,一个视觉-语言模型(VLM)智能体通过"分析-合成"循环 [8] 精炼代理世界:智能体在渲染引擎 [9] 中编辑场景程序,从输入相机视角渲染代理体,再把渲染结果与原图对比,决定下一步改什么。
为什么要用智能体
3D 检测器常常漏检物体或给错标签,其包围盒的空间精度也不高。对某些场景(如户外场景或物体密集的场景),我们还需要定义"一个盒子应该装下什么"。视觉推理可以在这里帮上忙。
我们在同一间酒店房间、同样的输入几何下对比 Boxer [7]、SpatialLM [11] 与 Mundo。图中分别给出三者在 3D 中的重建,以及叠加在某个输入视角上的效果。在这个例子里,Boxer 与 SpatialLM 漏掉了一些物体,也有些盒子偏离了它所代表的物体;Mundo 的盒子与图中物体贴合得更紧。
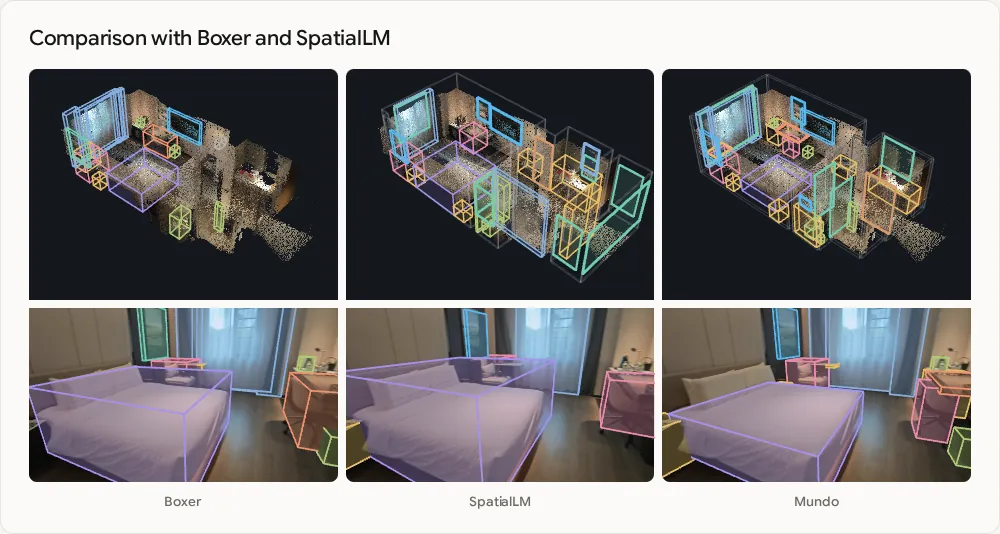
我们用智能体把视觉推理与数值优化结合起来。VLM 能可靠地发现漏掉的物体、罩住两个物体的盒子、或开错方向的门,但它没法把盒子的某条边定位到几厘米以内;数值优化能把盒子拟合得很准,但也可能拟合到杂物或错误的边缘上。
智能体负责决定"修什么"和"信哪份证据"。它在多个视角上标出物体边缘,优化器据此拟合盒子的位置、尺寸与偏航角;只有当拟合结果在某个未参与拟合的视角上同样吻合时,这次拟合才会被保留。
每轮编辑之后,一个独立的评审智能体在不修改结果的前提下,把代理世界与所有输入视角逐一比对。若评审通过、几何不再改善、或达到编辑次数/时间上限,循环停止;否则编辑智能体依据评审的发现进行下一轮。我们很高兴看到近几个月智能体能力快速提升,这极大增强了视觉推理的效果。
为什么用包围盒
包围盒是物理 3D 摆放的良好表示,而稠密、细粒度的物体重建通常引入冗余。对 Mundo 的空间探索而言,盒子通常已经足够,因此可以省略细几何细节。盒子还为刚体仿真提供了简单的表示——只要交互不需要精细的接触几何,这就行得通。
多数情况下,只有参与细粒度交互的物体才需要更细的几何。智能体可以为这些物体建一个粗糙模型,或使用 TRELLIS [12] 等 3D 生成器。往仿真里添加新物体时,Mundo 也可以从现有资产库检索,例如直接载入一个带物理属性、可用于仿真的 R1 机器人模型。
2. 跑在代码上的世界
Mundo 把世界保存为代码。场景程序是一个代码世界模型 [1] [2],它显式记录物体、位姿与物理属性,并定义状态随时间更新的规则;程序可以读取并修改状态,从而在重建出的场景中模拟运动与交互。
Mundo 的大部分仿真跑在 MuJoCo [10] 上,不过其它仿真引擎或自定义脚本也能承担类似角色。智能体读取场景,推导出仿真所需的物理参数(质量、摩擦、施加的力等),再据此编写场景程序;仿真器在重力下计算运动与交互,包括碰撞、接触与机器人操作。这些结果随后引导视频模型的渲染。
对世界的多数编辑都通过同一个场景程序完成:添加物体、修改物理属性、移动相机或把相机装到机器人上。下面的程序为便于阅读做了简化,真实程序要复杂得多。
office  = mundo.World("office")      # 9 张照片
drawer  = office.pedestal.drawer(3)
apple   = office.add("apple", inside=drawer, mass=0.20)
monitor = office.monitor              # 4.2 kg

t = office.timeline()
t.at(0.60).run(drawer.open(0.28))
t.at(1.90).run(apple.float_to(front_of=monitor))
t.at(3.20).playback(rate=0.2)  # 仅展示
t.at(3.45).run(apple.throw(at=monitor.top, speed=13.5))
t.at(5.00).freeze(7.5)  # 子弹时间
t.at(15.40).playback(rate=1.0)

sim   = office.simulate(engine="mujoco", hz=960)
video = mundo.render(sim, office.camera("dolly"),
steps=50)3. 代理帧与渲染器
Mundo 用选定的相机从仿真世界中渲染代理帧。在这些帧里,物体按类别以纯色显示(如上图中左侧)。上下文帧连同目标相机轨迹下的代理视频一起,被注入视频扩散模型用于渲染。我们把上下文视角与目标相机轨迹对齐到第一个上下文视角的相机坐标系。
我们用视频 VAE 编码代理视频与上下文视角,把得到的 token 作为参考 token 追加到目标视频的 token 序列之后。对于相机信息,我们加入一个相机编码器:它把每个代理帧与上下文视角的相机参数转换为 Plücker 射线,并在第一个 transformer 块之前把相应嵌入加到对应 token 上;没有相机信息的参考图像则获得一个可学习嵌入。
形式化地,渲染流水线可以写作
$$S_{t+1} = f(S_t, a_t)$$
$$x_{1:T} \sim p_\theta\big(\cdot \mid \pi(S_{1:T}, c_{1:T}),\ \{(I_k, c_k)\}_{k=1}^{K},\ y\big)$$
| 符号 | 含义 |
|---|---|
| $S_t$ | 第 $t$ 步的世界状态,包含物体、位姿与物理属性 |
| $a_t,\ f$ | 第 $t$ 步的动作,以及代码世界执行的状态转移(由脚本或仿真给出) |
| $\pi,\ c_t$ | 代理渲染器,以及第 $t$ 帧的相机 |
| $I_k,\ c_k$ | 第 $k$ 个上下文视角及其相机 |
| $y,\ \theta$ | 文本描述,以及视频模型的参数 |
| $x_{1:T}$ | 生成的帧 |
为什么要代理视频
代理视频是 3D 仿真结果传递给视频模型的通道。物体运动、碰撞的时间与位置、相机视角都在 3D 中计算;代理视频把这些信息渲染成 2D 视频扩散模型能够跟随的帧。实验中,相比仅用相机嵌入,以代理视频为条件能带来更精确的相机控制与更高的场景保真度。
长视频分块生成
对长视频,渲染器以 124 帧为一块做流式推理;每块的最后 34 帧被重新编码为下一块的固定前缀,从而保证块与块之间运动连续。
对非常大的场景或上下文视角很多的输入,我们为每一块单独选择上下文视角;随着相机移动,不断更新选择以覆盖即将到来的相机路径。
4. 训练
Mundo 的渲染器在"视频对"上训练:同一段场景的真实或渲染视频,以及它的代理视频。训练数据包含约 4 万对,来自多个数据集,覆盖真实室内扫描、合成室内场景、驾驶、手-物交互、单物体与游戏画面,以及我们自渲染的数据。在这些数据上,我们用 124 帧、640×480 分辨率的片段微调了 MiniMax-H3 的 Ref2VA [13]。
对自渲染的数据,我们可以自行选择相机轨迹、交互与上下文视角,也可以加入额外参考,例如一张"将要进入场景的物体"的图像。
这个世界支持什么
下面的示例展示 Mundo 能做什么,更多示例见项目主页。
空间探索。 给定 1 到 12 张真实地方的上下文图像,Mundo 沿你指定的相机路径生成新视角;它以输入图像为视觉上下文,并推断输入未覆盖的区域。
更多上下文图像给 Mundo 更多场景证据,也可能揭示此前未见的区域,从而减少需要推断的部分;但任何输入视角都没覆盖的区域,仍然只能靠推断。
物理交互。 观察物体在由输入图像重建的场景中如何运动与碰撞,跨环境探索各种交互。
动态仿真与机器人。 Mundo 在由上下文图像重建的环境里模拟机器人导航与物体交互,支持 Real-to-Sim 工作流中的机器人测试与训练。3D 代理体记录了"每个物体是什么、在哪里",机器人可以利用这些信息,在语义指定的起点与终点之间规划路线。
局限性
Mundo 仍有一些局限。
- 速度。 当前版本并不快。对"探索真实地方"里那样的场景,重建通常要十到二十分钟;从代理体渲染视频在 8 张 A800、20 步推理下约 1.5 帧/秒。我们尚未对视频模型推理做加速,StreamRender-H3 [14] 等技术有望提升渲染速度。
- 细粒度交互。 小物体在重建场景中容易"飘";渲染涉及抓取小物体的交互时,视频模型也容易出现幻觉。
- 记忆。 Mundo 还没有长时程记忆机制。虽然上下文视角有助于保持静态场景,但在长时间的动态变化之后、或此前被遮挡的区域重新进入视野时,Mundo 可能无法一致地保持场景细节。
总体来看,Mundo 在"定制化世界模型"上展现了有希望的结果。即便如此,这个问题仍值得从其它角度审视:真正的智能从何而来,它会不会是无所不包的形态?这是一个有趣的问题,值得静下心来慢慢想。
欢迎到项目主页看看 Mundo。
参考文献
- Yiwen Chen, Guosheng Lin, Chi Zhang. Code World Model: Coding Agent as World Brain. arXiv:2608.25927, 2026. arxiv.org/abs/2608.25927
- MirroS Team. AgentGarten: Code Worlds for Evolving Agents. Blog post, 2026. mirros.ai/blog/worlds-for-evolving-agents
- Yihang Luo, Shangchen Zhou, Yushi Lan, Xingang Pan, Chen Change Loy. 4RC: 4D Reconstruction via Conditional Querying Anytime and Anywhere. ICML, 2026. arxiv.org/abs/2602.10094
- Yifan Wang, Jianjun Zhou, Haoyi Zhu, et al. π³: Permutation-Equivariant Visual Geometry Learning. ICLR, 2026. arxiv.org/abs/2507.13347
- Jianyuan Wang, Minghao Chen, Nikita Karaev, et al. VGGT: Visual Geometry Grounded Transformer. CVPR, 2025. arxiv.org/abs/2503.11651
- Haotong Lin, Sili Chen, Junhao Liew, et al. Depth Anything 3: Recovering the Visual Space from Any Views. ICLR, 2026. arxiv.org/abs/2511.10647
- Daniel DeTone, Tianwei Shen, Fan Zhang, et al. Boxer: Robust Lifting of Open-World 2D Bounding Boxes to 3D. ECCV, 2026. arxiv.org/abs/2604.05212
- Kirill Mazur, Nikita Karaev, Matthew Chang, Jitendra Malik, Nur Muhammad Shafiullah. AgentSTAR: Agentic Shape Tracking and Reconstruction from Monocular Videos. arXiv:2609.24487, 2026. arxiv.org/abs/2609.24487
- Blender Foundation. Blender: The Free and Open Source 3D Creation Software. www.blender.org
- Emanuel Todorov, Tom Erez, Yuval Tassa. MuJoCo: A physics engine for model-based control. IROS, 2012. doi.org/10.1109/IROS.2012.6386109
- Yongsen Mao, Junhao Zhong, Chuan Fang, et al. SpatialLM: Training Large Language Models for Structured Indoor Modeling. NeurIPS, 2025. arxiv.org/abs/2506.07491
- Jianfeng Xiang, Zelong Lv, Sicheng Xu, et al. Structured 3D Latents for Scalable and Versatile 3D Generation. CVPR, 2025. arxiv.org/abs/2412.01506
- MiniMax. MiniMax-H3. Software, 2026. github.com/MiniMax-AI/MiniMax-H3
- Yanzuo Lu, Tian Ye, Yitong Li, et al. StreamRender-H3: Interactive Coding Worlds with Real-time Streaming Diffusion Render. Blog post, 2026. nvlabs.github.io/Sana/Sol-Engine/StreamRender-H3
引用
@misc{luo2026mundo,
  author = {Yihang Luo and Zunnan Xu and Shangchen Zhou and Yushi Lan and
            Kang Liao and Zerui Gong and Xiaoming Wu and Qingyi Tao and
            Zhonghua Wu and Bixuan Jin and Fei Wang and Zhi Hou and
            Xiaogang Wang and Xingang Pan and Chen Change Loy},
  title = {{Mundo}: Customized World Model},
  year = {2026},
  url = {https://mundo-world-model.github.io/}
}来源:Mundo: From seeing a place to simulating what happens there,Hugging Face Blog,2026 年 10 月 23 日。本文为完整翻译改编,媒体素材来自作者项目资产。
原文来源:Hugging Face Bloghttps://huggingface.co/blog/Luo-Yihang/mundo-world-model