Odyssey 发布 PROWL-2:保真度门控双课程——让世界模型的失败变成策略进步的燃料,而不是策略错误的来源
Odyssey(联合 UCL AI Centre 与巴塞尔大学)10 月 1 日发布 PROWL-2:首个把「任务策略课程」与「世界模型修复课程」耦合进同一持续训练循环的框架。核心洞见:想象训练中高学习信号的轨迹是歧义的——可能是策略真弱点,也可能只是世界模型预测错了;不加分拣地优先学习等于强化模型自己的幻觉。PROWL-2 用一道保真度门把「有用」与「可信」分开判定:可信的高潜力想象经验进策略课表,不可信的连同其已存储的真实延续一起送进修复池,由随机初始化+KL 锚定的开发者策略在真实环境中修复,修好重审再放行。SMACv2 九场景全部第一(5v5 提 4–18%、10v10/10v11 提 20–91%);MQE 难任务大幅领先——Gate-3 70.4% vs 骨干 29.8%、Shepherd-Hard 28.2% vs 7.3%,其余基线全为 0。消融证明两份课表并非可加:只修不排课收益边际,只排课不加门在九个场景全部低于骨干,加门后同一套课程变成最大单项增益。框架对世界模型架构与 MARL 算法完全不可知,后续指向人形机器人协作与长视野多智能体游戏。
世界模型许诺了什么,又在哪里兑现不了
多智能体强化学习(MARL)有一个昂贵的旧账:协调行为很难学。部分可观测性让每个智能体只能基于残缺信息行动,智能体之间的依赖又让联合状态-动作空间随人数爆炸式增长——model-free 方法(QMIX、MAPPO 这一族)通常要消耗大量真实环境交互,团队级的配合行为才浮出水面。
世界模型(World Models)是社区开出的药方:学一个环境动力学模型,让策略在「想象」出的轨迹上训练,而不是在真实环境里试错。Dreamer 一系、以及 MAMBA、CoDreamer、MARIE、DIMA、SeqWM 等多智能体世界模型,都把这套样本效率红利带进了协作 MARL。
但一旦轨迹可以按需生成,一个新问题立刻浮出水面:哪些想象出来的经验值得学?
核心歧义:高学习信号 ≠ 好经验
课程学习方法(prioritized replay、PLR、UED 一系)用「学习潜力」选经验——典型代理指标是 TD 误差或价值损失:策略预测不准的地方,就是它有东西可学的地方。这个前提在真实环境里成立,因为经验来自环境本身;放进世界模型里这个前提就断了。一条高误差的想象轨迹是歧义的:
- 它可能暴露了任务策略的真实弱点——这正是你想让策略练的;
- 也可能只是世界模型预测错了——动力学本身在环境里根本不会发生,策略学它只会把模型的幻觉当成真实。
模型误差在想象训练中复利累积(compounding model error)是 model-based RL 的经典失败模式。此前的方法各修一头:IMAC 按学习潜力给想象经验排课表,但假设世界模型在策略学习期间是冻结的;PROWL-1 用对抗式的 developer 策略主动找世界模型的失效并持续修复,但对策略在哪儿训练没有任何课程。两者明明互相依赖——模型误差恰好在策略训练的地方最致命,而训练只有在模型准确的地方才可靠——却从没被耦合到一起。
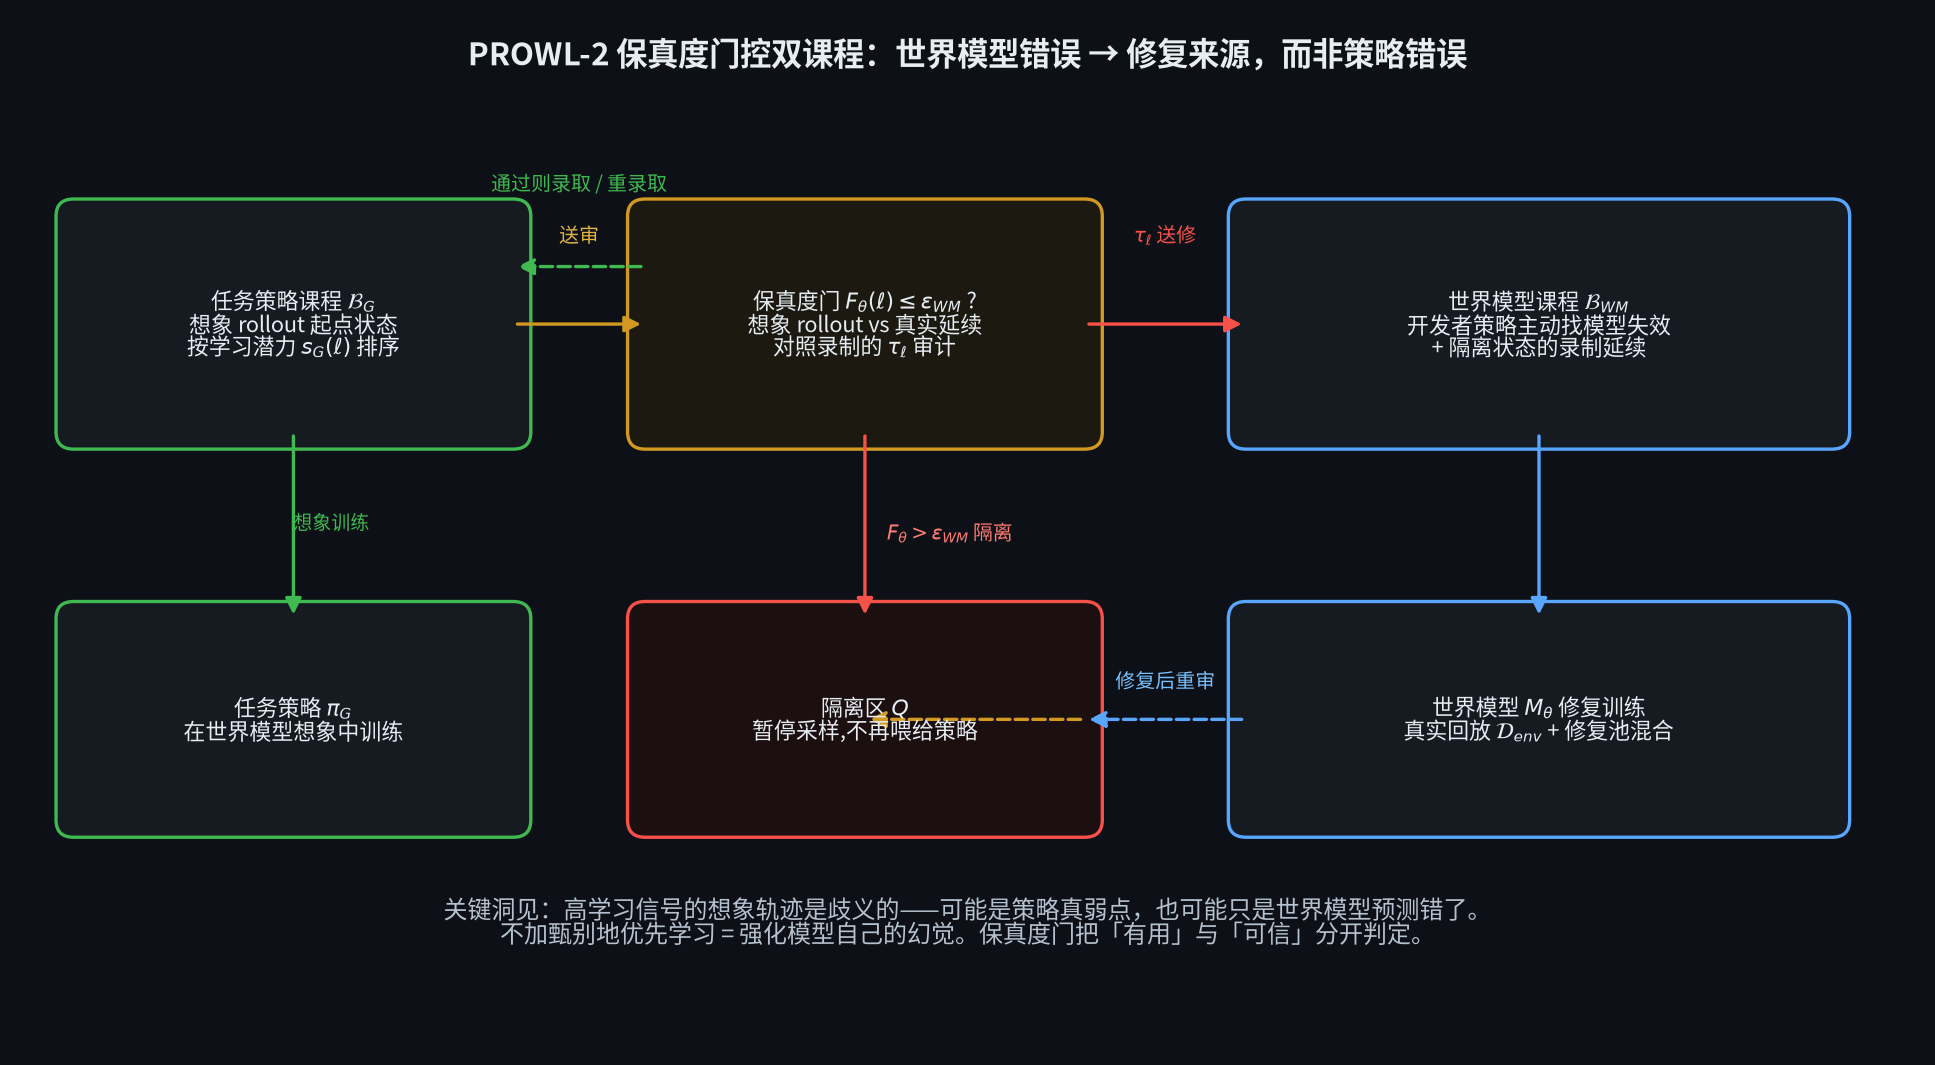
保真度门控双课程:想象轨迹先过保真度门,可信的高学习潜力经验进策略课程,不可信的连同其真实延续一起送进世界模型修复池,修复后重审再放行(图:本站据论文绘制)
PROWL-2:一套训练循环,两份课表,一道门
Odyssey(作者 Ahmet H. Güzel、Jenny Seidenschwarz、Jeffrey Hawke,与 UCL AI Centre、Basel 大学合作)10 月 1 日发布的 PROWL-2 是第一个把这两件事放进同一个持续训练循环的框架。系统里有三个学习者:
- 任务策略 $\pi_G$——我们要训练的多智能体策略,完全在世界模型的想象 rollout 里学习;
- 开发者策略 $\pi_D$——从不替任务行动,只在真实环境的自己的实例里搜索世界模型失效的状态;
- 世界模型 $M_\theta$——它自己也是学习者,一边吃正常回放,一边在开发者找到的失效和任务策略撞上的失效上被修复。
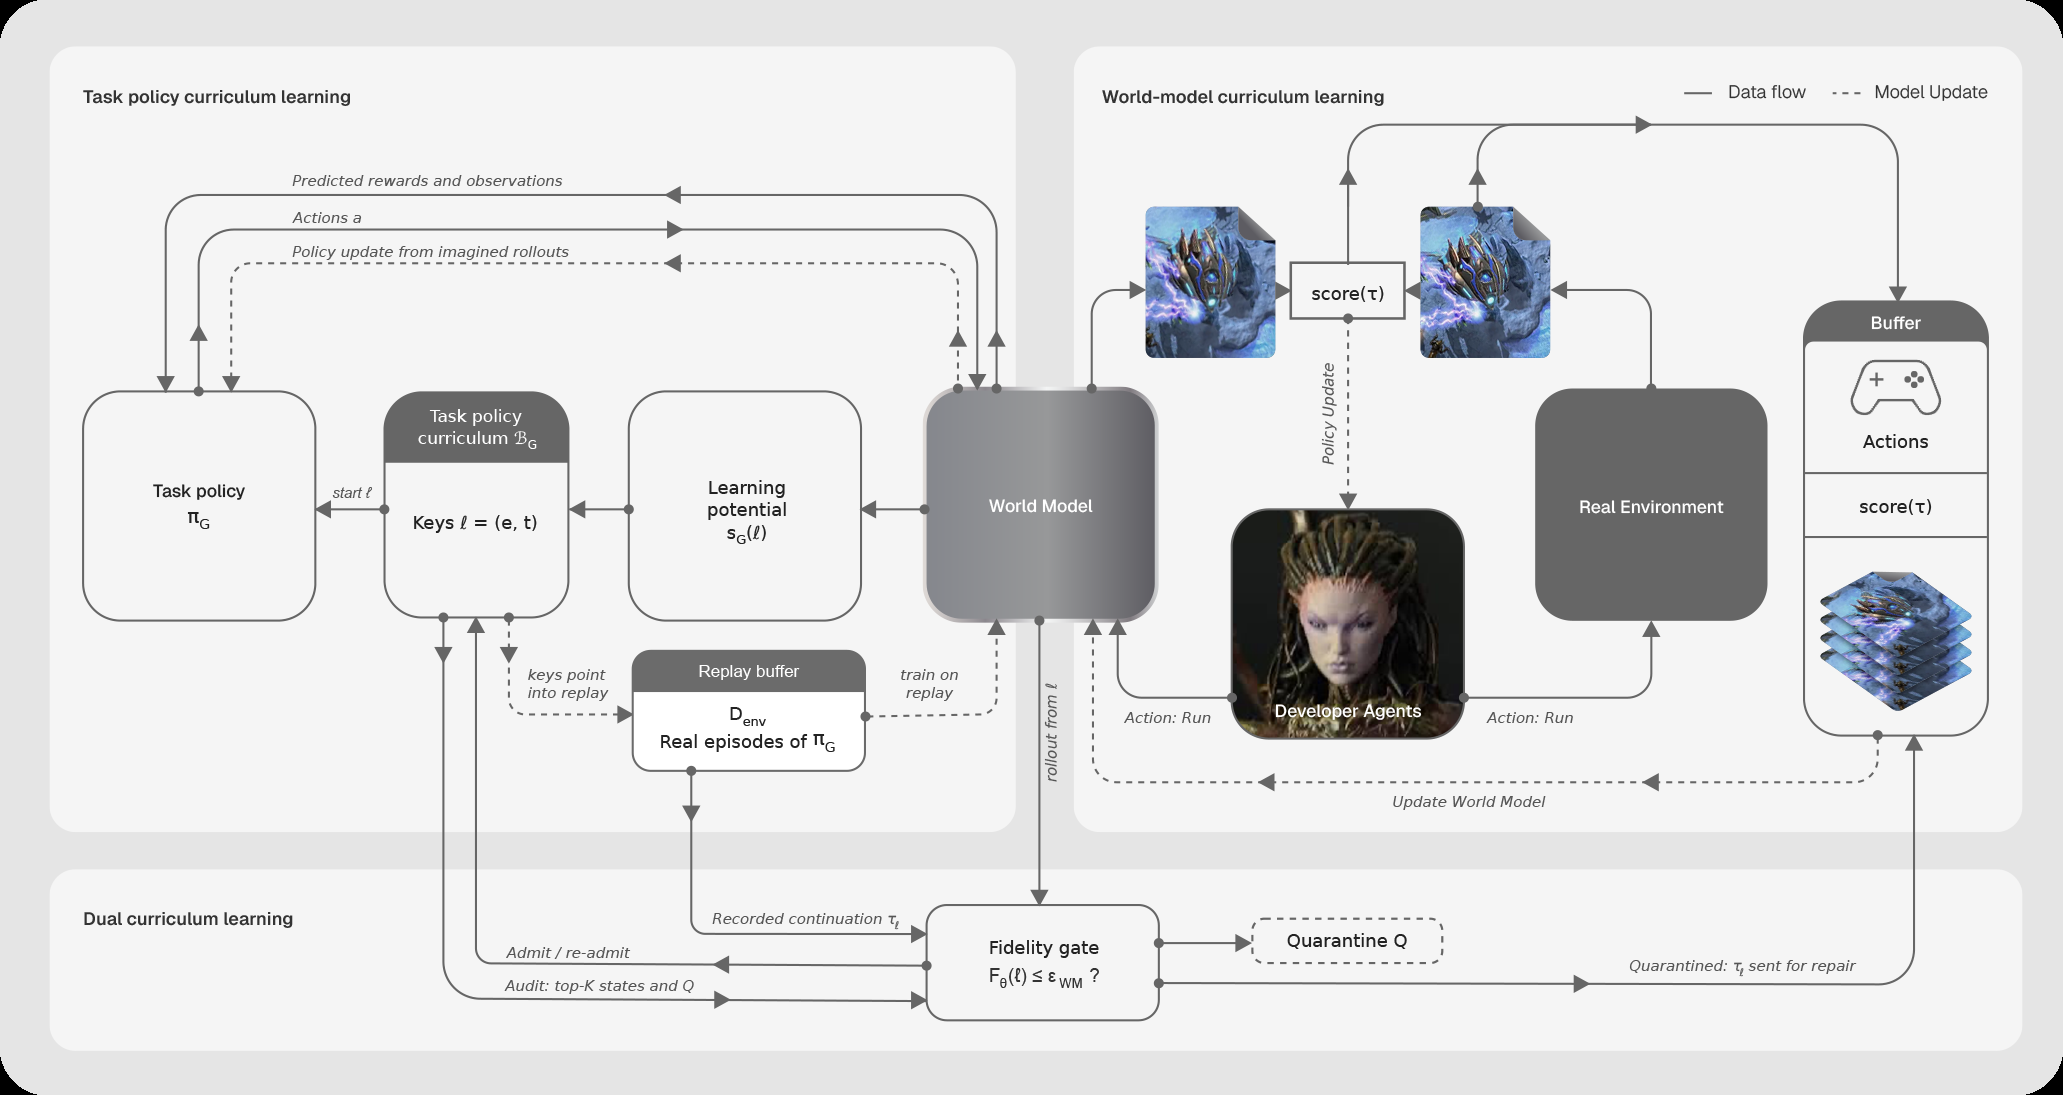
PROWL-2 总览:左上任务策略课程、右上世界模型课程、下方双课程经保真度门耦合(图源:论文 Figure 1)
第一份课表:任务策略课程(在哪练)
把 IMAC 的优先级机制扩展到多智能体:课程缓冲 $\mathcal{B}_G$ 里的起点状态 $\ell=(e,t)$ 索引一段录制剧集中所有智能体的联合动作-观测历史,想象从这一点把整个团队一起向前滚。学习潜力沿用 IMAC 的正价值损失,对智能体取平均(SMACv2 的 actor–critic 骨干);MQE 的规划器骨干则改在真实回放上按 critic 的 TD 残差幅度 $|\delta Q|$ 采样。按 PLR 的 rank 优先级 + 新鲜度抽batch,其余均匀。
第二份课表:世界模型课程(在哪修)
开发者策略由 PPO 训练,目标函数(Eq. 2)在探索奖励之外加了一项 KL 锚,把 $\pi_D$ 拉住在其随机初始化的参考策略 $\pi_{ref}$ 附近——这一处细节相当反直觉:不从任务策略复制初始化,反而拿到更高的任务胜率(消融证实),KL 锚还避免了无锚时的熵坍缩。与 UED 里找「任务策略失效」的对抗者不同,开发者找的是「世界模型的失效」。
失败分数 $s_{fail}$(Eq. 4)不看单一重建损失,而是选控制相关的错误:SMACv2 上是友军死亡时机、可用动作掩码分歧、奖励误差、观测误差四项;MQE 上是各智能体 1–3 步潜变量误差加奖励误差。每项对运行统计标准化后等权平均。奖励公式(Eq. 3)里还有学习进度项 $\beta_{LP}(s^{before}-s^{after})$——如果修完之后错误没变小,说明这是模型学不会的错误,搜索就会绕开它。
那道门:保真度门控(能不能信)
这是 PROWL-2 真正的新组件。关键工程巧思:任务课程里的每个起点状态都指向回放缓冲 $\mathcal{D}_{env}$,其真实延续 $\tau_\ell$ 已经存好了——所以审计不需要任何新交互。门把世界模型从 $\ell$ 沿录制动作前滚,逐项算错误 $E_k$,对固定参考统计(训练开始前在骨干随机回放上算一次、永不更新)标准化,得到保真度误差(Eq. 6):
$$F_\theta(\ell)=\sum_{k\in C} w_k\frac{E_k(\tau_\ell)-\mu^{ref}_k}{\sigma^{ref}_k}$$
$F_\theta(\ell)>\epsilon_{WM}$ 的状态被隔离:留在 $\mathcal{B}_G$ 里但不被采样,其真实延续进 $\mathcal{B}_{WM}$ 送修——这直接切断了「模型错误抬高学习潜力 → 策略继续在错误上训练」的反馈环。每 $N_{gate}$ 步审计两组:$\mathcal{B}_G$ 里优先级最高的 $K$ 个状态(课程最爱抽的、模型错得最伤的),以及全部隔离状态(看修复有没有生效)。连续通过 $n_{pass}$ 次则在修好的模型下重算学习潜力、放回训练;连续失败 $n_{fail}$ 次则从两份课表里删除。
阈值也有讲究:SMACv2 上 $\epsilon_{WM}=0.5$,定在骨干参考数据保真度误差的第 72–83 百分位——固定阈值而不是每次审计的百分位,因为后者不管模型多准都会隔离固定比例的状态;固定阈值随模型变好自动放行更多状态,且一次设定、九个场景通用、零调参。
开发者策略在 MQE 上的变体
值得注意的工程细节是:MQE 上开发者不再是一个独立训练的策略,而是任务规划器本身,跑在自己的环境实例里,加一个 $\beta_{acq}|Q_1-Q_2|$ 的双 critic 分歧奖励,把它引向世界模型可能失效的状态。论文特意强调:分歧奖励只影响开发者在哪采集数据;哪些经验最终进入任务策略训练,永远由保真度门裁决,绝不由分歧决定。这守住了框架的立场——ensemble 分歧可以是搜索启发式,但不能是准入判据。
实验:门是唯一的功臣
论文在两类任务上验证:SMACv2 九个程序化战斗场景(Terran/Protoss/Zerg × 5v5/10v10/10v11,离散控制,MARIE actor–critic 骨干)和 MQE 多智能体四足环境(Gate-2/3 过窄门、Shepherd 赶 1/9 只羊,连续控制,SeqWM 规划骨干)。
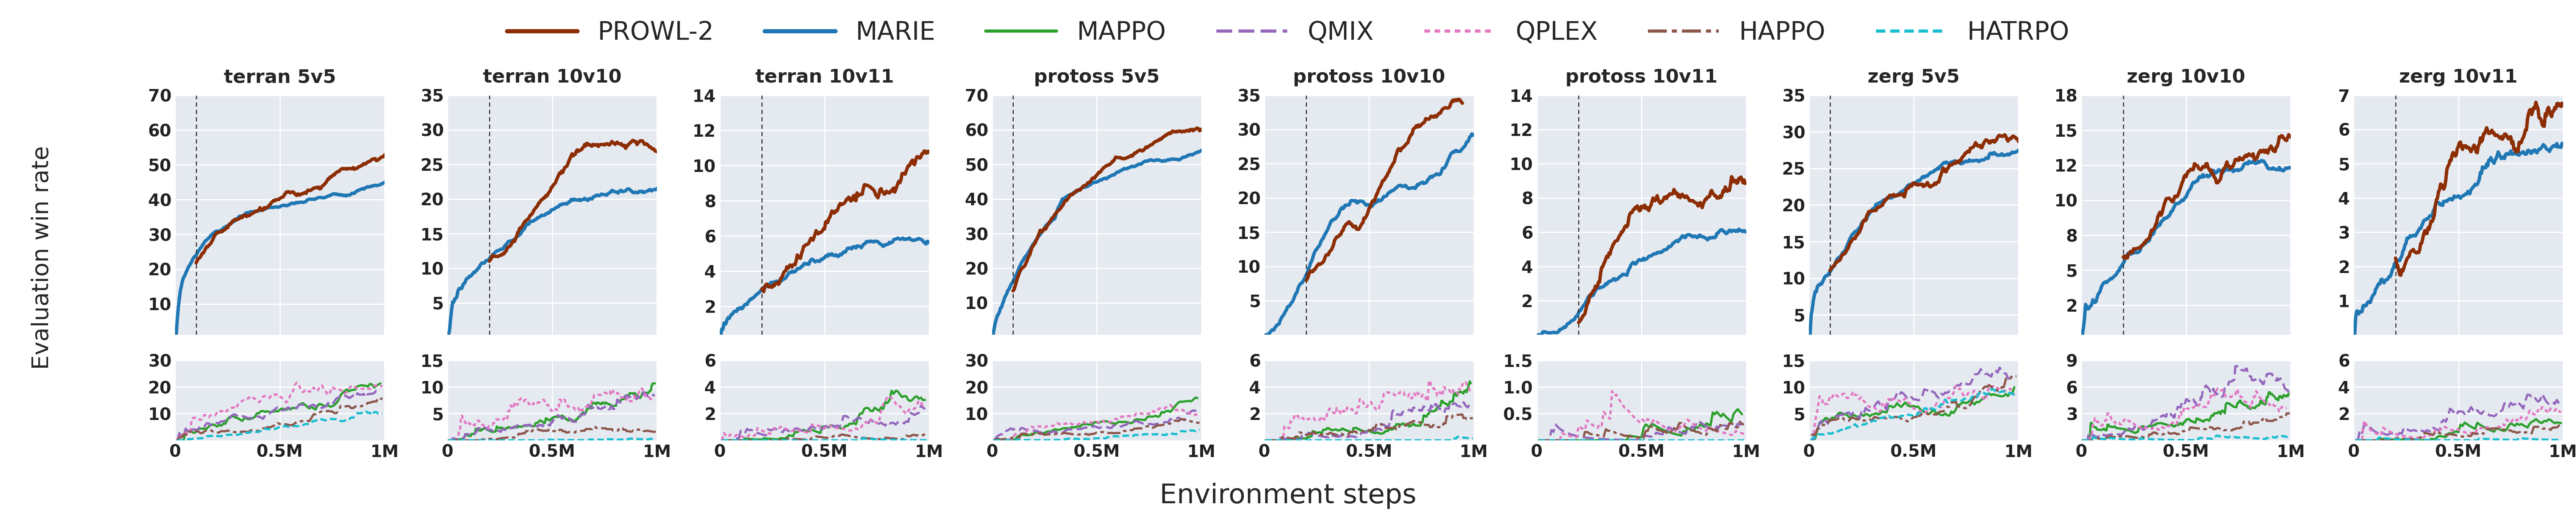
SMACv2 九场景:上排 PROWL-2 vs MARIE 骨干,下排五个 model-free 基线(图源:论文 Figure 2)
SMACv2:PROWL-2 在全部九个场景拿下最高平均胜率,且不改骨干架构与目标函数——差距纯粹来自课程与修复机制。规模越大差距越大:5v5 相对骨干提升 4–18%,10v10/10v11 提升至 20–91%。代表性数字(胜率,3 seeds):
| 场景 | 最强 model-free | MARIE 骨干 | PROWL-2 |
|---|---|---|---|
| Terran 5v5 | 21.2(QPLEX) | 45.0 | 52.9 |
| Terran 10v11 | 3.3(QMIX) | 5.6 | 10.7 |
| Protoss 5v5 | 16.1(MAPPO) | 54.1 | 60.2 |
| Protoss 10v10 | 5.1(MAPPO) | 27.9 | 34.8 |
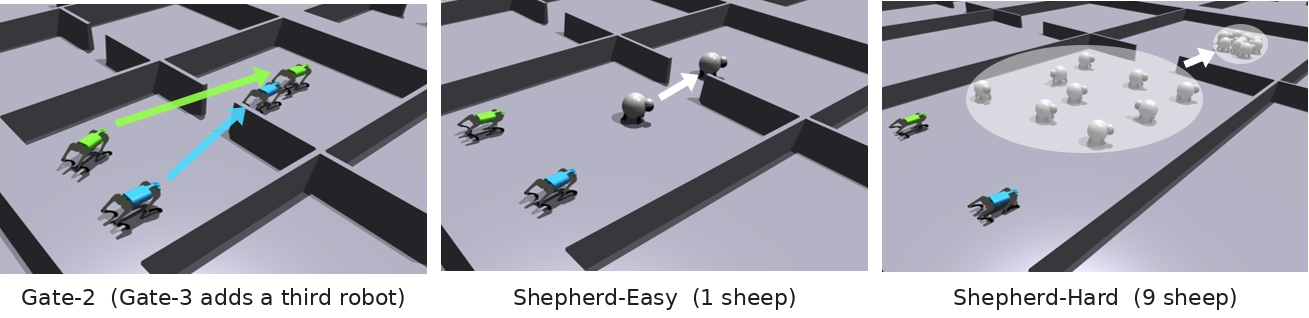
MQE 任务:Gate-n 让 n 只四足尽快无碰撞过窄门;Shepherd 让两只四足把 1 只(Easy)或 9 只(Hard)羊赶进目标区(图源:论文 Figure 3,渲染自 Xiong et al. 2024)
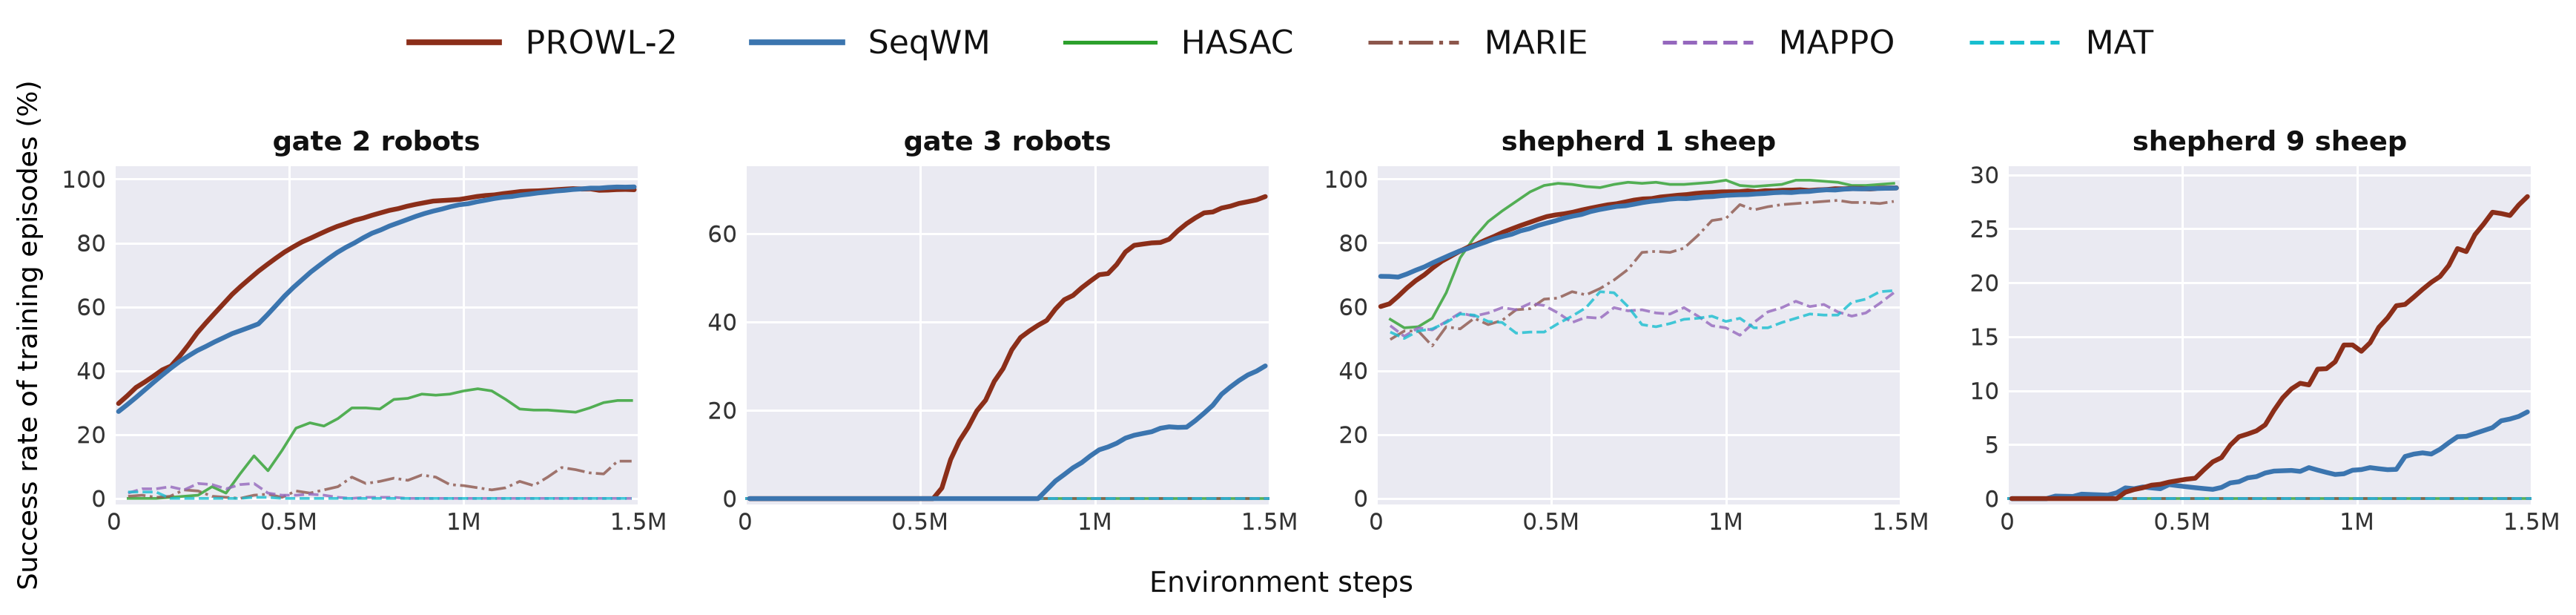
MQE 四任务成功率曲线,1.5M 环境步(图源:论文 Figure 4)
MQE:难度对上就见真章——Gate-2 和 Shepherd-Easy 上各强方法都饱和(PROWL-2 99.2%,与 HASAC 的 99.7% 半点之差);难任务上彻底拉开:
| 任务 | 全部基线 | SeqWM 骨干 | Dual(无门) | PROWL-2 |
|---|---|---|---|---|
| Gate-3 | 0.0 | 29.8 | 12.3 | 70.4 |
| Shepherd-Hard | 0.0 | 7.3 | 7.7 | 28.2 |
消融是全文最有信息量的部分——两份课表不是可加的:
- 只修不排课(Repair):九场景全超骨干,但七个在一个标准误之内——修复买了票却没上车;
- 只排课不加门(Dual):九个 SMACv2 场景全部低于骨干——没有门的无想象课程就是让策略喝模型幻觉;
- 加上门(PROWL-2):同一套课程瞬间变成最大单项增益,Gate-3 从 12.3% 跳到 70.4%。PROWL-2 相对 Repair 的增量在九分之八的场景超过 Repair 相对骨干的增量。
附录消融还验证了:用随机隔离或模型不确定性(ensemble 分歧)隔离同样数量的状态都不行——必须对着真实轨迹量出来的保真度才有判别力;分歧只能当开发者的搜索启发式,永远不能当准入判据。
与既有方法的两条分界线
为了准确定位,论文划了两条清晰的界线。第一条是对课程/UED 一系(PLR、PAIRED、ACCEL、MAESTRO):它们选出的关卡最终在真环境里执行,所以被优先的学习信号永远不会是模拟器自己的造物;想象训练取消了这个保证,这正是保真度门要补上的缺口。第二条是对单智能体 model-based RL 的选择性信任一系(短/自适应 rollout、不确定性加权目标、MOPO/COMBO 式不确定性惩罚):它们的思路是「模型不可靠的地方就少信一点」,而 PROWL-2 是「对真实轨迹量出不可靠,就把那块经验挡下、送去修、修好再放行」——不只是降权,而是修复闭环。保真度也始终是「对着录制延续兑现的预测误差」,不是 ensemble 分歧那种不确定性估计。
为什么两份课表不能简单相加(数学直觉)
论文给了一个很值得琢磨的因果链解释。设起点状态 $\ell$ 的学习潜力为 $s_G(\ell)$(Eq. 1,想象 rollout 的正价值损失),门测得的保真度误差为 $F_\theta(\ell)$(Eq. 6)。当 $F_\theta(\ell)$ 很大时,想象 rollout 的下一个 latent 状态 $\hat z_{t+1}$ 与真实延续偏离,TD 残差 $\hat\delta_t=\hat r_t+\gamma\hat d_t V_\psi(\hat z_{t+1})-V_\psi(\hat z_t)$ 中的 $\hat r_t,\hat d_t$ 都是模型编出来的数——于是 $s_G(\ell)$ 被一个虚假的高误差抬起来。课程按 $s_G$ 排序,自然优先抽到这类状态;策略在这些状态上更新,把价值函数的误差往模型幻觉的方向拉。下一轮模型再生成类似幻觉,误差更大——正反馈。
门的作用是把排序改成条件排序:只有满足 $F_\theta(\ell)\le\epsilon_{WM}$ 的状态参与 $\arg\max_\ell s_G(\ell)$。于是「高学习潜力」不再能单独决定优先级,它必须和「可信」同时成立。这解释了消融里那个刺眼的数字:Dual(无门)在全部九个 SMACv2 场景低于骨干——不是课程不好,而是课程在错误的地图上导航。而 Repair 单独也不够,因为它修复的区域由开发者策略的兴趣决定,未必是任务策略正在训练的地方;门恰好把两者对齐:被隔离的状态 = 任务策略最想学($s_G$ 最高)× 世界模型最不准($F_\theta>\epsilon$)的交集,这正好是最值得修的地方。
结果表之外:隔离状态的命运与阈值的稳定性
主表之外还有几组附录实验补全了机制故事。隔离的失效是否真的可修?论文验证了被门标记的失效绝大多数在若干轮修复后保真度回到阈值之内——「可修复性」成立,门才不会变成单向的黑洞。门控对照实验里,随机隔离或按不确定性隔离同样数量的状态,性能都明显低于按保真度隔离——证明收益来自「隔离对了状态」,而不是「隔离」这个动作本身。开发者初始化消融显示随机初始化优于复制任务策略(后者会让搜索过早收敛到任务策略已覆盖的区域);KL 锚消融显示去掉锚后开发者策略熵坍缩、失效发现停滞。学习潜力分数消融确认 IMAC 式正价值损失优于绝对 TD 误差。
起点状态池是怎么长起来的
还有一个容易被忽略的机制细节:课程缓冲 $\mathcal{B}_G$ 里的起点状态并非静态快照。当一个状态在修复后的世界模型下重新通过审计,它的学习潜力会在新模型下重算——同一个起点,模型变准之后它的想象轨迹质量变了,优先级自然也要变。这个重算让课程能够「随模型进步逐步加难」:早期被隔离的困难状态,修复之后带着重估的潜力回到课表,成为策略下一步的主食。课表的难度上界由世界模型的能力上界决定,而门保证策略永远只在前者允许的范围内碰后者的边界。相比之下,IMAC 的课表建立在一个冻结的模型上——课表的天花板从第一天就锁死了。
评测协议:数字是怎么数的
为保证对比干净,评测协议设计得相当严格:每 500 步跑 10 局随机策略评估,不计入交互预算;报告的胜率是每个种子最后 200 个评估点的平均,3 个种子取均值±标准误。所有方法在相同任务策略更新数下对比;SMACv2 上每种子先单独训练骨干至 100K(5v5)或 200K 步(10v10/10v11)——世界模型损失曲线拐点之后——PROWL-2 与全部消融臂从这个共同检查点分叉(学习曲线图中的虚线),分叉前所有臂完全一致。MQE 的成功以任务完成判定(过门无碰撞 / 全部羊入区),不是「没报错就算成」。
诚实的边界
论文自己列了限制:SMACv2 上 1M 步预算是 MARIE 原文的五倍,比较同时覆盖学习速度与终性能;MQE 上 1.5M 步低于 SeqWM 原文的 4M,两个世界模型学习器在难任务上都还在涨,渐近差距是否保持是开放问题;保真度目标($E_k$ 的选择)是按领域手工挑的,换域要重挑;开发者策略的真实搜索在 SMACv2 上额外花费 1–2 倍任务交互(MQE 上计入预算仍领先)。未测单智能体场景。
另外几处设计权衡值得展开。其一,世界模型修复的训练配比(Eq. 5):$D_{WM}\sim(1-\rho_{WM})\,D_{env}+\rho_{WM}\,\mathcal{B}_{WM}$,修复池条目按优先级的 softmax 抽取,开发者条目优先级随时间衰减、跌破下限即驱逐——修复是持续滴灌而非一次性回炉,模型不会在旧失效上过拟合。其二,分支点选择:每个种子先单独训骨干到 100K/200K 步(世界模型损失曲线拐点之后),PROWL-2 与所有消融臂从同一检查点分叉,保证对比公平。其三,修复成本核算:每个开发者周期做 25 次修复更新,只比 MARIE 骨干多约 6% 的世界模型梯度步;Repair 消融背上同样的交互与修复成本却只换来边际提升,说明 PROWL-2 的收益确实来自「门把两份课表接对了」,而非更多算力。
为什么值得机器人社区关注
Odyssey 把 PROWL-2 定位成「体验机器」(Experience Machines)路线的一环:当游戏、机器人和集群系统越来越多地依赖在学出来的模拟器里训练的智能体,「哪些模拟经验可信」就从技术细节升级成了地基问题。论文明确点名后续方向是人形机器人协作——接触丰富的动力学让世界模型错误更频繁——以及长视野多智能体游戏。其基础世界模型 Odyssey-3 被描述为供给「有根基的想象经验」的来源,PROWL 则是让这些经验「可信且随学习者进步逐步加难」的机制。框架本身对世界模型架构与 MARL 算法完全不可知——它只改「训什么」,不改「怎么训」——这意味着现有 Dreamer 系或多智能体世界模型管线可以直接叠上去。
一句话总结:在世界模型里训练智能体,不仅要决定哪些想象经验「有用」,还要决定哪些「可信」——把这两件事分开判,模型的失败就从策略错误的来源变成了策略进步的燃料。
参考
- 原文:Odyssey — Introducing PROWL-2: Jointly Learning Simulation and Decision-Making(2026-10-01),odyssey.systems/introducing-prowl-2
- 论文 PDF:prowl.odyssey.ml/PROWL-2.pdf(Güzel, Seidenschwarz, Hawke, Bogunovic — UCL AI Centre / Odyssey / Univ. of Basel)
- 前作:PROWL-1(arXiv:2605.18803)、IMAC(Güzel et al., NeurIPS 2025)
- 骨干:MARIE(Zhang et al., 2024, arXiv:2406.15836)、SeqWM(Zhao et al., ICLR 2026)
- 基准:SMACv2(Ellis et al., 2023)、MQE(Xiong et al., IROS 2024)
- 相关:Odyssey《The Era of Multi-Agent Imagined Experience》、《Our Path to Superintelligence》、Agora-2