Astranomy:GPT-6 Astra 作为原生机器人策略的实证研究
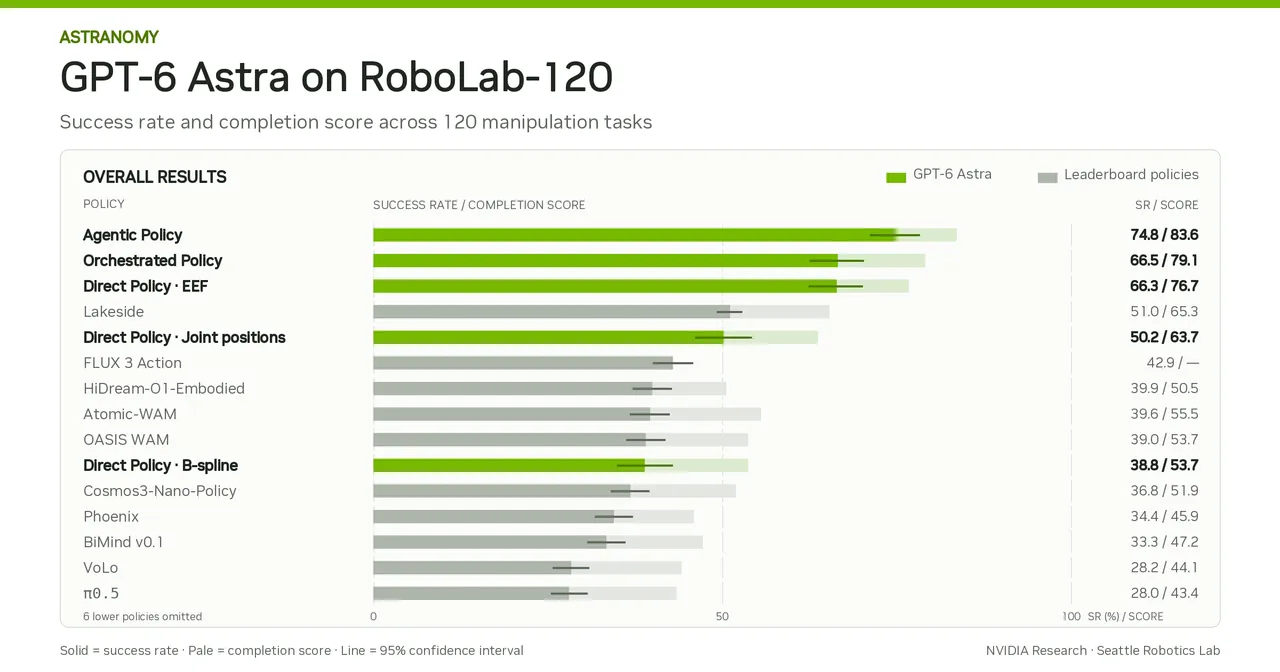
NVIDIA 实证研究 GPT-6 Astra 原生机器人策略:RoboLab-120 上 Agentic 配置 74.8% 登顶,但每次推理 18.56 秒、每成功回合 3090 万 token。
机器人基础模型(RFM)靠机器人数据训练成控制策略,而 GPT-6 Astra 是在互联网语料上训练出来的。NVIDIA 西雅图机器人实验室(SRL)问了一个更根本的问题:这个差异真的重要吗?一个完全没有做过机器人策略微调的通用多模态模型,只要把控制接口写进提示词,能不能在真实操作任务上闭环?他们在 2026 年 10 月 14 日发布的技术报告《Astranomy》给出了一个有限定但足够震撼的答案:在 120 项任务的 RoboLab 基准上,Astra 在最佳配置下达到 74.8% 的成功率,超过榜单上所有专门训练的策略;代价是平均每次推理 18.56 秒、每个成功回合最多烧掉 3090 万 token。
通用模型已经具备作为原生机器人策略执行通用抓放的能力。真正悬而未决的问题不再是它能不能控制机械臂,而是这样的延迟与 token 账单是否值得。
本文完整梳理这份报告:团队把 Astra 接到机器人上的三种方式、决定它能否工作的推理期消融实验、决定它能否落地的运行时经济学,以及仍然存在的失败模式。
核心结论
- 能力是真实的。在 RoboLab-120 上,Direct Policy 成功率 66.3%,Agentic Policy 74.8%,Orchestrated Policy 66.5%。Agentic 配置比榜单上最强的参照策略 Lakeside(51.0%)高出 23.8 个百分点,也压过专门训练的 π0.5(28.0%)与 Cosmos3-Nano-Policy(36.8%)等 VLA/WAM。
- 外壳与模型同等重要。同一份模型权重,仅把调用方式从无状态 API 换成保留历史的持久 Codex 会话,成功率就从 66.3% 跳到 74.8%。
- 提示词里的几何标定是最大的单一杠杆。对 Direct Policy 而言,把夹爪与相机标定写进提示词可把成功率从 19.3% 提到 72.7%。没有它,模型无法把像素换算成指令动作。
- 记忆比像素重要。在 agentic 设定下,保留模型自己的文本历史(计划、动作、推理记录)比保留历史图像更有价值;完整历史在 23 任务子集上达到 100%。
- 能力不等于可部署性。推理占估计回合总时长的 94.9–97.8%。一个酸奶放置任务实际机械臂运动约 5.2 秒,算上 Astra 的思考时间后估计要 3 分 57 秒。
问题本身:训练出来的机器人策略,还是提示出来的通用模型?
视觉-语言-动作模型(VLA)与世界动作模型(WAM)的做法,是在预训练骨干上用机器人轨迹微调出控制能力。训练一旦完成,动作参数化、本体条件与时间上下文就被固定下来:推理期的接口就是训练数据烙进去的样子。通用多模态模型没有这些承诺。它的动作表示、它对机器人几何的理解、它的观测窗口,全都是写进提示词、每次运行都可以改的东西。
这种灵活性正是本研究的价值所在。Astra 的上下文窗口长到能装下整个回合,作者因此可以把控制接口当作实验变量而非设计常量。一个直接后果是可变长度动作块:对末端执行器与关节位置控制,Astra 在提示给定的范围内自行决定每次调用输出多少个动作,于是两次观测之间的间隔随决策难度自适应,而不是被模型结构写死。
此前已有工作暗示这条路可行:在 RoboDojo 上以 agentic 方式评测 Astra、把 Astra 当作具身策略、以及通过预训练全身控制器做导航与人形控制。Astranomy 是系统化版本:它把模型自身能力与外围系统提供的支撑分离开来,并且给两者都标上价格。
把 Astra 接到机器人上的三种方式
报告在方法论上最关键的一步,是拒绝"模型在控制机器人"这种含糊说法。三种配置把分工写得明明白白。
| 配置 | 谁产生动作 | 外壳提供了什么 |
|---|---|---|
| Direct Policy | Astra 单独完成,无状态 API 调用 | 什么都没有。固定的观测到动作映射,调用之间不保留历史。支持末端执行器目标、关节目标或关节空间 B 样条,块长在给定范围内自选。 |
| Agentic Policy | 持久 Codex 会话中的 Astra | 完整交互历史、可选的图像检查与计算工具、持久笔记,以及每次动作后的运动反馈。每个决策输出一个末端目标,保持 1–5 个控制步。 |
| Orchestrated Policy | Cosmos3-Nano-Policy 提案,Astra 审查 | Astra 作为带有限记忆的监视器。它可以接受微调世界动作模型给出的 15 步提案、修改它,或用自己的末端执行器目标直接接管。 |
三者都在闭环中运行:输入为三个相机视角(左肩、右肩、腕部,384×216 像素)加本体感知与语言指令,执行体为仿真 DROID 机器人(Franka Panda 机械臂 + Robotiq 2F-85 夹爪),控制频率 15 Hz,推理期间暂停仿真。除模型本身作为被试变量外,所有配置统一使用 medium 推理强度的 GPT-6 Astra。
基准:RoboLab-120
RoboLab 是一个高保真仿真基准,目标是检验通用操作能力与对语言的鲁棒性。它强调多步骤任务,并刻意在场景与目标不变的前提下变化指令的具体程度,从而把"对措辞敏感"与"物理执行困难"分离开。完整套件 120 项任务;消融实验在 30 任务子集上进行,覆盖十个能力组:从物体选择与容器放置,到重定向、货架操作、计数与顺序执行,再到带排除规则的长程清理任务。
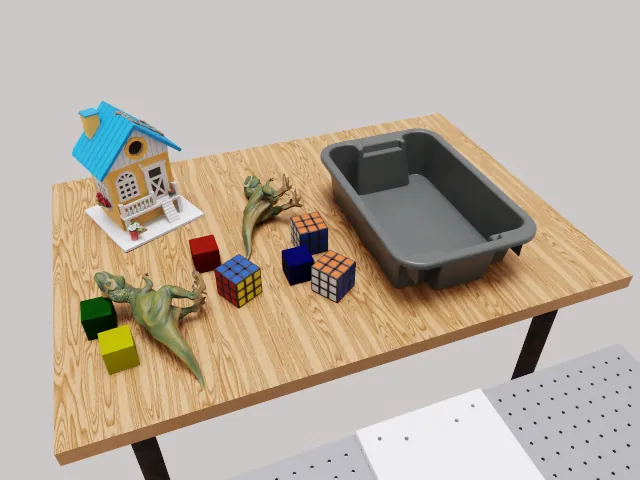
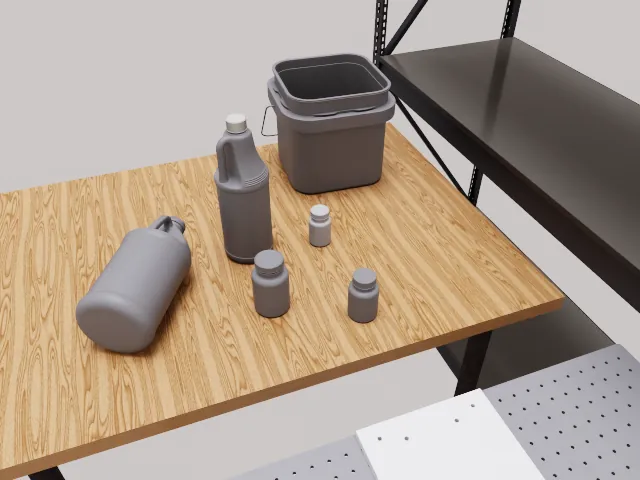
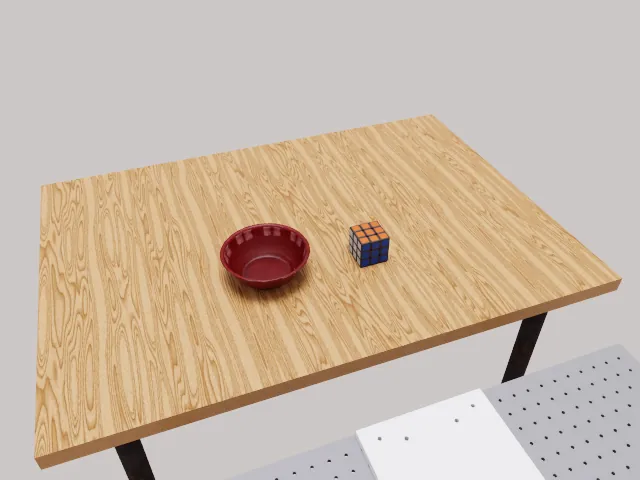
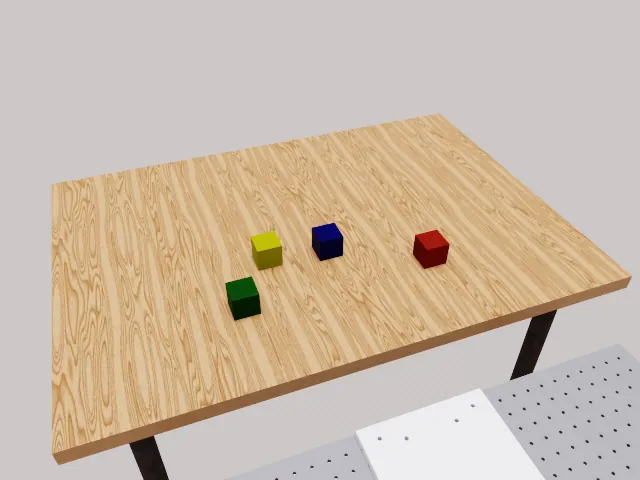
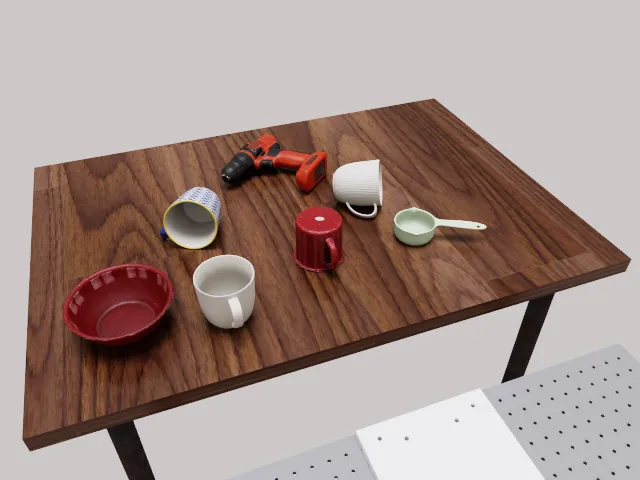
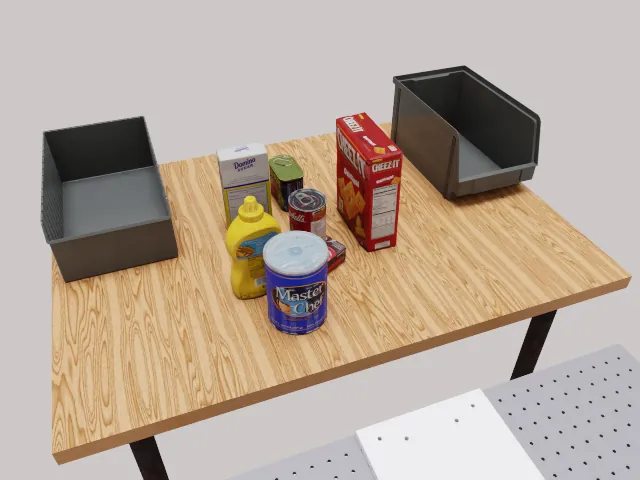
全文使用两个指标。成功率(SR)统计被仿真器判定完成的回合;Score 额外计入部分完成度,因此"放好四个中的三个"与"碰倒一个"不会同分。成功回合记 100 分。
总榜结果
在完整 120 任务套件上,排序毫无悬念:Agentic Policy 以 74.8% SR / 83.6 分领先,Orchestrated Policy 66.5% / 79.1% 紧随其后,末端执行器动作的 Direct Policy 为 66.3% / 76.7%。作为参照,榜单上非 Astra 的最强条目是 Lakeside 51.0%、FLUX 3 Action 42.9%、专门训练的 Cosmos3-Nano-Policy 36.8%;π0.5 为 28.0%。
有两个细节值得注意。其一,Direct Policy 的分数高度依赖动作表示:末端执行器位姿 66.3%,关节位置只有 50.2%,B 样条仅 38.8%,所以"Astra 直接当策略"不是一个数字而是一族数字。其二,Agentic 的结果与 Direct 出自同一份权重,两者之间没有做任何微调,改变的只是调用约定。
消融实验揭示了什么
动作表示:末端执行器胜出,但外壳会抹平差距
在 30 任务子集上,Direct Policy 用绝对末端执行器位姿得 72.7%,绝对关节位置 48.7%,关节空间三次 B 样条 37.3%。在每一族表示中,绝对表示都优于 delta 与 relative 变体。B 样条条件值得多看一眼,因为它是最激进的接口:策略输出 6 个 8 维系数向量,每个含 7 个绝对关节位置加 1 个夹爪指令,客户端据此构造夹紧三次样条,
$$C(u)=\sum_{i=0}^{6} N_{i,3}(u)\,P_i,\qquad u\in[0,1],$$
并把当前状态作为 \(P_0=[q_{\text{current}};\ \mathbb{1}(g_{\text{current}}\geq 0.5)]\) 前置,节点向量为夹紧形式 \((0,0,0,0,\tfrac14,\tfrac12,\tfrac34,1,1,1,1)\),再对长度为 \(H\) 的动作块按 \(C(k/H)\) 采样。Astra 确实能原生产出这些系数,但产得还不够好,暂时竞争不过朴素的末端执行器目标。
换到 Agentic 外壳下情况就变了:末端执行器 86.0% 对关节位置 84.0%,差距仅 2.0 个百分点。当模型能在每个短片段之后重新观测、重新规划并纠错时,动作空间的选择就没那么要紧了。作者还测试了动作 horizon:允许 16–32 个动作的块使模型调用次数减少 62%、完成时间相近,但成功率掉 6 个点,因为更长的开环片段无法中途纠偏。默认的动态 3–15 区间是合理的折中。
提示词中的几何:全报告最大的单一效应
Direct Policy 只用最小提示词时成功率 19.3%。加入夹爪几何(法兰到指垫的偏移、钳口朝向、夹爪闭合度到指垫中点的查表)与相机几何(外参、归一化内参、腕相机倾角)后,同一模型达到 72.7%。中间档位为仅夹爪 35.3%、仅相机 62.7%。这个效应在运动本身上肉眼可见:base 提示词下机械臂会在酸奶杯上方反复悬停对位;加上完整几何后,它一次完成接近、抓取与放置。
在 Agentic 设定下,同样的几何文本只把成功率从 83.3% 提到 86.0%,但去掉它会让控制步数增加 14.7%。作者的假设是:持久 agent 能从自己的观测-动作历史中估计几何,并借助短片段与显式跟踪反馈逐步修正对位,于是提示词不再是标定的唯一来源。实践层面的读法是:如果你无状态地跑通用模型,标定文本不是可选装饰,它就是接口本身。
上下文:记忆比像素重要
对 Direct Policy,只给当前观测得 49.3%;补上 t−14 与 t−7 两个历史观测即升到默认的 72.7%。把窗口拉长(t−29)或加密(五帧)都没有额外收益,说明视觉历史的价值在约 1–2 秒处饱和。
agentic 的上下文消融更惊人。五个条件把文本历史(模型自己的先前消息、计划、动作调用与推理记录)与视觉历史分开。完整文本 + 完整视觉历史在 23 任务子集上达到 100%;完整文本 + 仅当前图像仍有 87.0%;而只有完整视觉历史、没有文本历史则跌到 56.5%。保留模型说过和做过的一切,比保留它看过的一切更值钱。只保留最近两轮 assistant 消息(73.9%)也不如完整文本历史,说明价值在于"尝试过什么"的完整记录,而不是滚动摘要。
任务描述:措辞敏感性是 Direct Policy 的问题
把精确指令("把小红酸奶放进红碗里")换成模糊指令("把它收好"),Direct Policy 掉 8.7 个点(72.7% → 64.0%),而 Agentic Policy 几乎不受影响(86.0% → 85.3%)。持久 agent 能靠上下文和自己已经做过的事消解歧义,无状态调用者不能。
报告还测试了基于视频的上下文学习:从同一任务此前一次成功 rollout 中按 1 Hz 采样帧、给出全部三个视角,代替语言指令。视频条件下的成功率 87.9%,对照语言条件在匹配子集上为 90.0%。示范帧是可用的任务描述,但在这个基准上,一句话仍然是更好的接口。
模型选择:这种能力并不普遍
在完全相同的 Direct Policy 配置下,GPT-6 Astra 得 72.7%,GPT-6 Sol 33.3%,Claude Opus 5.5 25.3%,GPT-6 Luna 2.0%。原生闭环控制是这个家族中前沿模型的能力,而不是任何大型多模态模型的涌现属性。把推理强度从 medium 提到 xhigh 对成功率影响很小,却增加了延迟与 token 成本,因此默认保持 medium。
Agentic 外壳:工具与计划可选,历史不可选
Agentic 外壳提供可选 shell 工具:Python 执行、图像裁剪、几何计算、持久笔记。开启后 150 个回合全部使用了工具,平均每回合 19.7 次工具调用,内容包括立体视觉三角化、夹爪位姿算术、逆运动学与放大裁剪。汇总成功率从 86.0% 变为 88.0%。审计给出的诚实结论是:Astra 用不用工具常常得出同一个决定;工具是"可用能力",不是"测得的优势"。
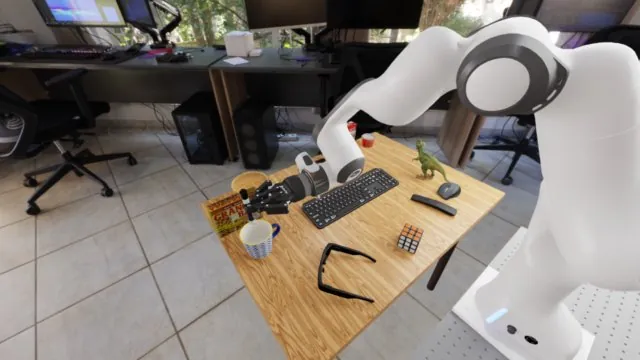
显式计划指令呈现同样的模式:要求模型把任务分解为子目标并跟踪进度得 86.0%;去掉该指令得 90.0%;明确禁止写计划得 81.0%。rollout 转录显示,即使被禁止写计划,进度跟踪依然会出现,因为保留的对话历史里本来就含有已完成子目标的记录。运动误差反馈类似:默认提供时,51% 的回合中出现显式跟踪引用,但只占下一步动作解释的 1.14%;去掉反馈后成功率从 85.9% 变为 85.2%。agent 会用自己的动作历史与新鲜本体感知重建跟踪误差。
Orchestrated Policy:前沿模型在学习型策略身上抓到了什么
当 Astra 监视 Cosmos3-Nano-Policy 时,它在全部仿真步的 14.5% 上介入。把连续介入决策归并为 4254 个块并用 VLM 分类:抓取问题占介入的 64.4%,目标选错或计划错误占 20.2%;放置、操作与搬运失败占其余大部分,0.3% 无法归类;有 10 项任务完全不需要介入。读法是:微调过的世界动作模型在接近与搬运上称职,但恰恰在最需要闭环抓取纠错的地方最弱,而这正是推理型监视器增值之处。值得注意的是,orchestrated 组合(66.5%)并没有超过 agentic 外壳下原生生成动作的 Astra(74.8%),所以把动作委托给专家模型目前还不是白拿的收益。
账单:延迟与 token
能力是标题,运行时表格才是小字条款。在 RoboLab-120 的成功回合上,末端执行器的 Direct Policy 平均每次推理调用 18.56 秒,推理占估计回合总时长的 97.0%。Agentic Policy 平均每次调用 13.37 秒(占 97.8%);Orchestrated 拆成 Astra 决策 11.50 秒与 WAM 提案 2.74 秒(合计 94.9%)。专门训练的参照模型每个动作块快两到三个数量级:H200 BF16 下 π0.5 为 46.96 ms、Cosmos3-Nano 为 713.76 ms、FLUX 3 Action 为 397.74 ms。
| 配置 | 单次调用延迟 | 推理占回合时长 | 每成功回合 token / 成本 |
|---|---|---|---|
| Direct Policy · EEF | 18.56 s | 97.0% | 160k / $1.96 |
| Direct Policy · jointpos | 20.19 s | 97.4% | — |
| Direct Policy · B-spline | 21.68 s | 97.0% | — |
| Agentic Policy | 13.37 s | 97.8% | 30.9M / $36.40 |
| Orchestrated Policy | 11.50 / 2.74 s | 94.9% | 11.0M / $17.72 |
| FLUX 3 Action (WAM) | 397.74 ms | 16.1% | n/a |
| Cosmos3-Nano-Policy (WAM) | 713.76 ms | 25.6% | n/a |
| π0.5 (VLA) | 46.96 ms | 4.6% | n/a |
token 经济学是更锋利的那一面。Direct Policy 每个成功回合约 16 万 token、1.96 美元。换来额外 8.5 个点成功率的 Agentic Policy,每个成功回合消耗 3090 万 token、36.40 美元,token 数约为前者的 190 倍。Orchestrated 居中,1100 万 token、17.72 美元。酸奶任务的视频把延迟变得具体:估计 3 分 57 秒的回合里,真正的机械臂运动只有约 5.2 秒,其余时间都在等下一个动作块。任何"模型思考时世界仍在动"的应用,在这些数字下都够不着;推理期间暂停仿真,正是这些结果得以成立的前提。
Astra 何时、如何失败
失败模式有信息量而不猎奇。贯穿 RoboLab-120 的反复出现的短板,是把"尝试操作"转化为"完成抓取、搬运或放置":夹爪围着物体反复调整却抓不牢,或物体被碰离原位却永远到不了目的地。在线运动纠错并不保证物理进展。在 agentic 设定下,持续的失败清单包括:目标选错、夹爪被卡住的不稳定或妨碍性抓取、不完整的操作序列、搬运途中丢物体,以及重复无效动作或始终捡不回掉下桌物体的恢复尝试。辅助手段平均提升了可靠性,但并不能稳定地解决抓取误差,且收益因任务而异。
还有一类任何提示词都修不了的、属于部署形态的失败:每次调用 18.56 秒,需要对快速变化场景做反应的任务根本无从谈起。报告也明确说,这些结果确立的是暂停仿真器内的能力,而非实时胜任力。
需要记住的局限
- 每任务仅 5 个回合。推理成本限制了试验次数,回合间波动未被刻画,较小的消融差距也未被确立为统计显著。应把消融看作"哪些设计选择值得进一步研究"的证据,而不是已定的效应量。
- 暂停仿真、仅抓放。没有接触丰富的插入或装配,没有长程移动操作,没有动态任务,也没有任何"模型思考时物体仍在动"的场景。
- 只能看到接口层。模型通过公开接口评测,服务端内部处理无法与模型能力分离,因此消融刻画的是部署系统对接口变化的响应。
结论
Astranomy 把机器人策略的问题从"通用模型行不行"改写为"在什么接口下、以什么代价行"。接口层面的答案是具体且可迁移的:绝对末端执行器目标、一两秒的视觉历史、提示词里显式的夹爪与相机标定,以及最重要的一条——让模型记住自己说过和做过什么。代价层面的答案同样具体:97% 的挂钟时间在思考,表现最好的配置每次成功要花三十六美元。对离线、高价值、低动态的操作任务,提示驱动的前沿模型如今是一个正当的策略选项,而且在这个基准上是被测得最好的那一个。对任何实时运动的任务,专门训练的模型仍是唯一可行的控制器;报告留下的真正开放问题是:哪些决策值得在两者之间委托。
来源:Astranomy: An empirical study of GPT-6 Astra as a native robot policy,Yang、Khetan 与 Zhang,NVIDIA 西雅图机器人实验室,2026 年 10 月 14 日。图与视频转载自原报告。
原文来源:NVIDIA Research (Seattle Robotics Lab)https://research.nvidia.com/labs/srl/projects/astranomy/