BLOG
OpenRUA 的五层统一 harness 让 Qwen 无深度在 RoboDojo 达 31.39 分、真机零样本达 53.50 分,并揭示空间定位、几何计算与真机开放流程的边界。
Hugging Face 用五步课程串起智能体后训练:SFT 学轨迹,蒸馏传概率,GRPO 优化结果,环境承接多回合行动,异步 harness 让训练接近真实部署。
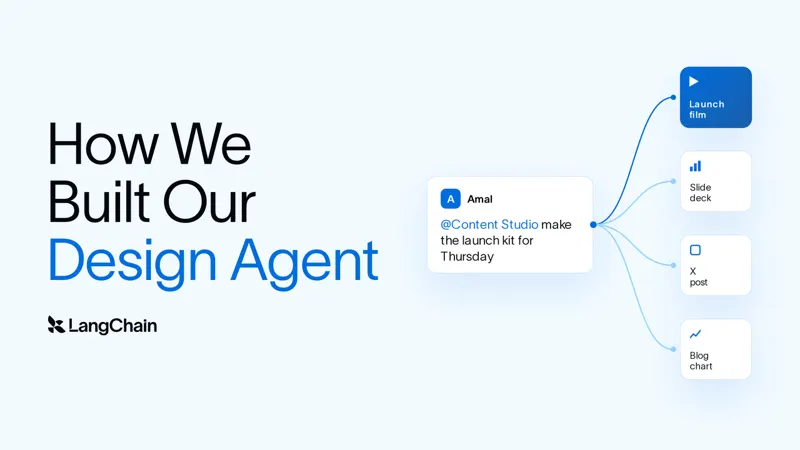
LangChain 拆解 Slack 设计智能体 Content Studio:把设计师品味写进 skills、wiki、代码 gate 与两层记忆,再用持久沙箱、双运动引擎和异步子智能体完成长任务。
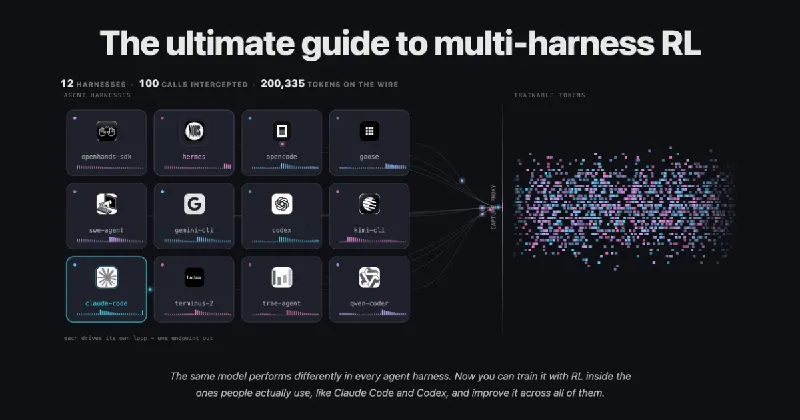
同一个模型换个 agent harness 表现判若两人:GLM-5.2 在 SWE-bench Pro 上一个 harness 23%、另一个 52%;受控实验里换 harness 移动 13 个点,同 harness 换模型只移动 2.5–5 个点。Hugging Face 团队(Adithya S Kolavi、Joel Niklaus、Lewis Tunstall、Leandro von Werra 等,联合 Liquid AI)发布的这篇长文给出开放解法:在 Claude Code、Codex、OpenCode、Mini-SWE-Agent 这些真实 harness 里做 agentic RL,harness 一行代码不改。框架三件套——OpenEnv 提供与环境/训练器共享的标准接口,capture proxy 以「会话即钥匙」方式截获模型端点上的精确 token id、逐 token 行为 logprob 与损失掩码(强制全分布采样,top_p=1.0),Harbor 提供 40+ harness 适配器与 26 种沙箱后端,TRL 的 Async GRPO 消费带掩码的训练序列。用 1 万小时级数据之外的实打实数字说话:LFM2.5-2.6B 四 harness 训练后平均 pass@1 从 42.2% 升到 54.2%,四个 harness 全涨,已解任务工具调用少 31%;只训 OpenCode 的对照组增益几乎锁在自己家里。文章还诚实交代了 SFT 对照(RL 54.6% vs SFT 47.5%)、Qwen 先涨后崩的完整归因(输出预算耗尽、不交卷空转、奖励项被钻空子导致 0.740→0.178)以及 proxy 并发上限等工程边界。
阿里 2026 Handbook 精读:三个真实案例(AIDC 数字投手、千问用增 Agent、万有无界)、五大挑战与四层企业级 Agent 基础设施。核心数据:编码仅占研发链路 <1%(1 小时编码 vs 3 周上线)、交付周期减半、缺陷率降 70%、变更失败率降 90%+;「云上 Scrum」组织形态、Session→Commit→Change→Workitem 度量归因、Guardrail 三态门控(UNKNOWN 永不视作 PASS)、以及「把自己蒸馏完就没位置了」的组织代价反思。
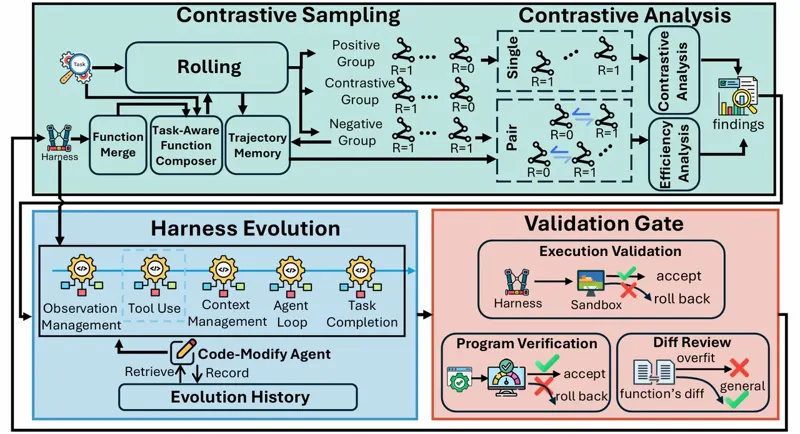
ModularRSI 把 agent harness 拆成五个功能模块,用 2000 条与下游基准隔离的演化实例、对比轨迹诊断和验证门做独立演化,再合并模块。TB 演化 harness 在 Terminal-Bench 2.0 上把 Acc 从 47.57 提到 52.43,且改进能跨领域迁移到 SWE-Bench Verified,并跨模型迁移到 GLM-5.2、MiniMax-2.5 与不同 DeepSeek 版本。
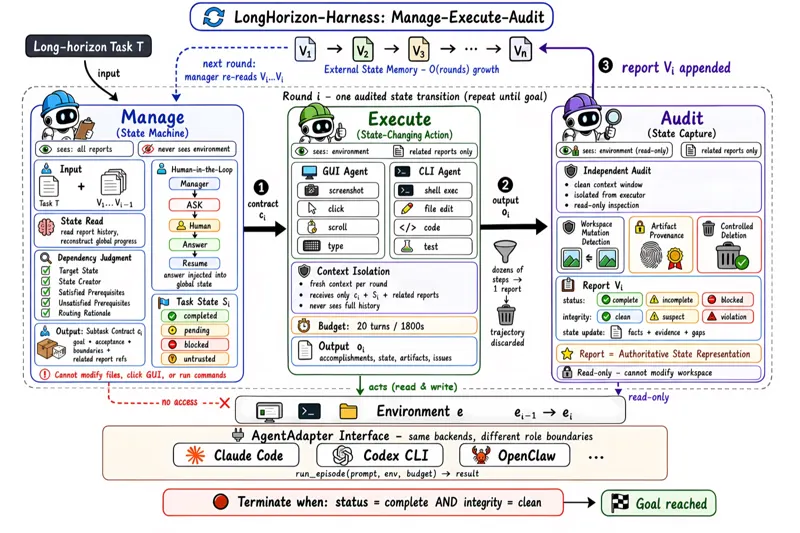
AMAP-ML提出LongHorizon-Harness:MEA循环把长程任务变为独立审计的状态转移。同一模型下WeaveBench通过率51.8→80.7,OSWorld 2.0完成率3倍提升。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。