多 harness 强化学习完全指南:在 Claude Code、Codex 里直接训练模型——HF 团队用 2.6B 小模型验证跨 harness 训练
同一个模型换个 agent harness 表现判若两人:GLM-5.2 在 SWE-bench Pro 上一个 harness 23%、另一个 52%;受控实验里换 harness 移动 13 个点,同 harness 换模型只移动 2.5–5 个点。Hugging Face 团队(Adithya S Kolavi、Joel Niklaus、Lewis Tunstall、Leandro von Werra 等,联合 Liquid AI)发布的这篇长文给出开放解法:在 Claude Code、Codex、OpenCode、Mini-SWE-Agent 这些真实 harness 里做 agentic RL,harness 一行代码不改。框架三件套——OpenEnv 提供与环境/训练器共享的标准接口,capture proxy 以「会话即钥匙」方式截获模型端点上的精确 token id、逐 token 行为 logprob 与损失掩码(强制全分布采样,top_p=1.0),Harbor 提供 40+ harness 适配器与 26 种沙箱后端,TRL 的 Async GRPO 消费带掩码的训练序列。用 1 万小时级数据之外的实打实数字说话:LFM2.5-2.6B 四 harness 训练后平均 pass@1 从 42.2% 升到 54.2%,四个 harness 全涨,已解任务工具调用少 31%;只训 OpenCode 的对照组增益几乎锁在自己家里。文章还诚实交代了 SFT 对照(RL 54.6% vs SFT 47.5%)、Qwen 先涨后崩的完整归因(输出预算耗尽、不交卷空转、奖励项被钻空子导致 0.740→0.178)以及 proxy 并发上限等工程边界。
同一个模型,在每个 harness 里判若两「人」
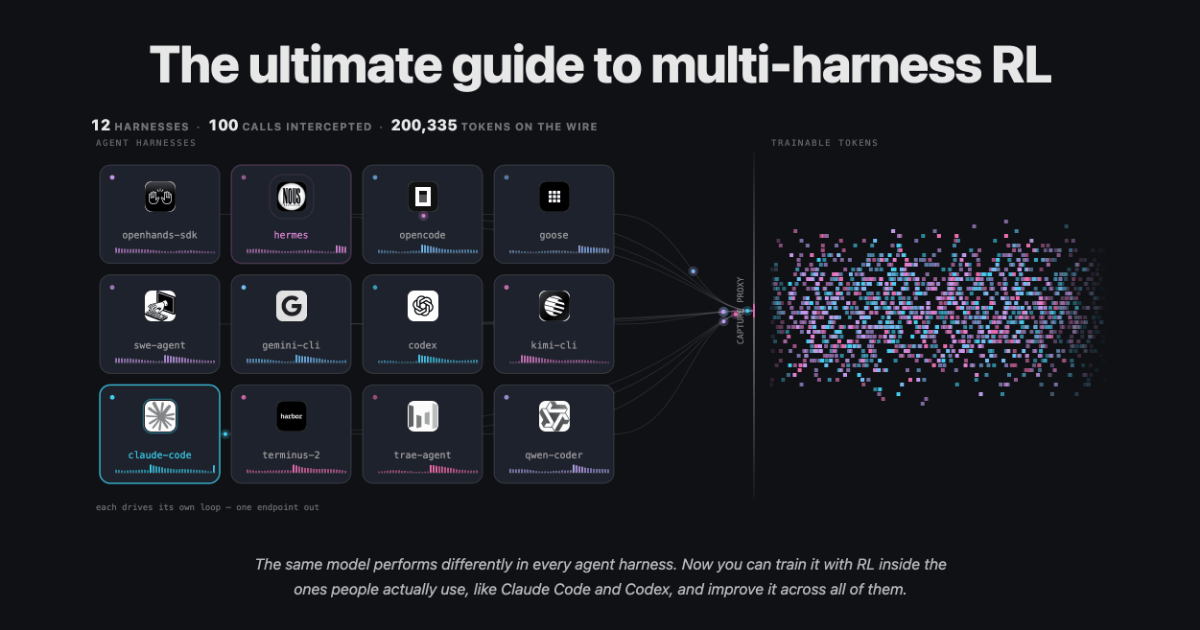
如果你用 AI 写代码,你大概率已经用同一个模型穿过不止一件「外衣」:Claude 模型在 Claude Code、Cursor、Pi、Cline 里的表现并不一样——它规划的方式不同、抓取的工具不同、在一个工具里顺利完成的任务换个工具就卡住。造成这种差异的,是包裹在模型外面的那层程序——agent harness:它运行循环、决定模型能拿到哪些工具、撰写模型读到的上下文、解析模型返回的结果、决定什么时候停。换一个 harness,模型看到的世界和能做的事都变了,结果自然也变了。
这种差异是可以量化的。Hugging Face 的 Joel Niklaus 在 SWE-bench Pro 上测了同一个模型 GLM-5.2:在一个 harness 里 23%,在另一个里 52%——差距接近一倍半。排名也带不过去:Codex 在十个 harness 里对 GLM-5.2 排第二,对 Gemma 4 26B-A4B 却掉到第九。
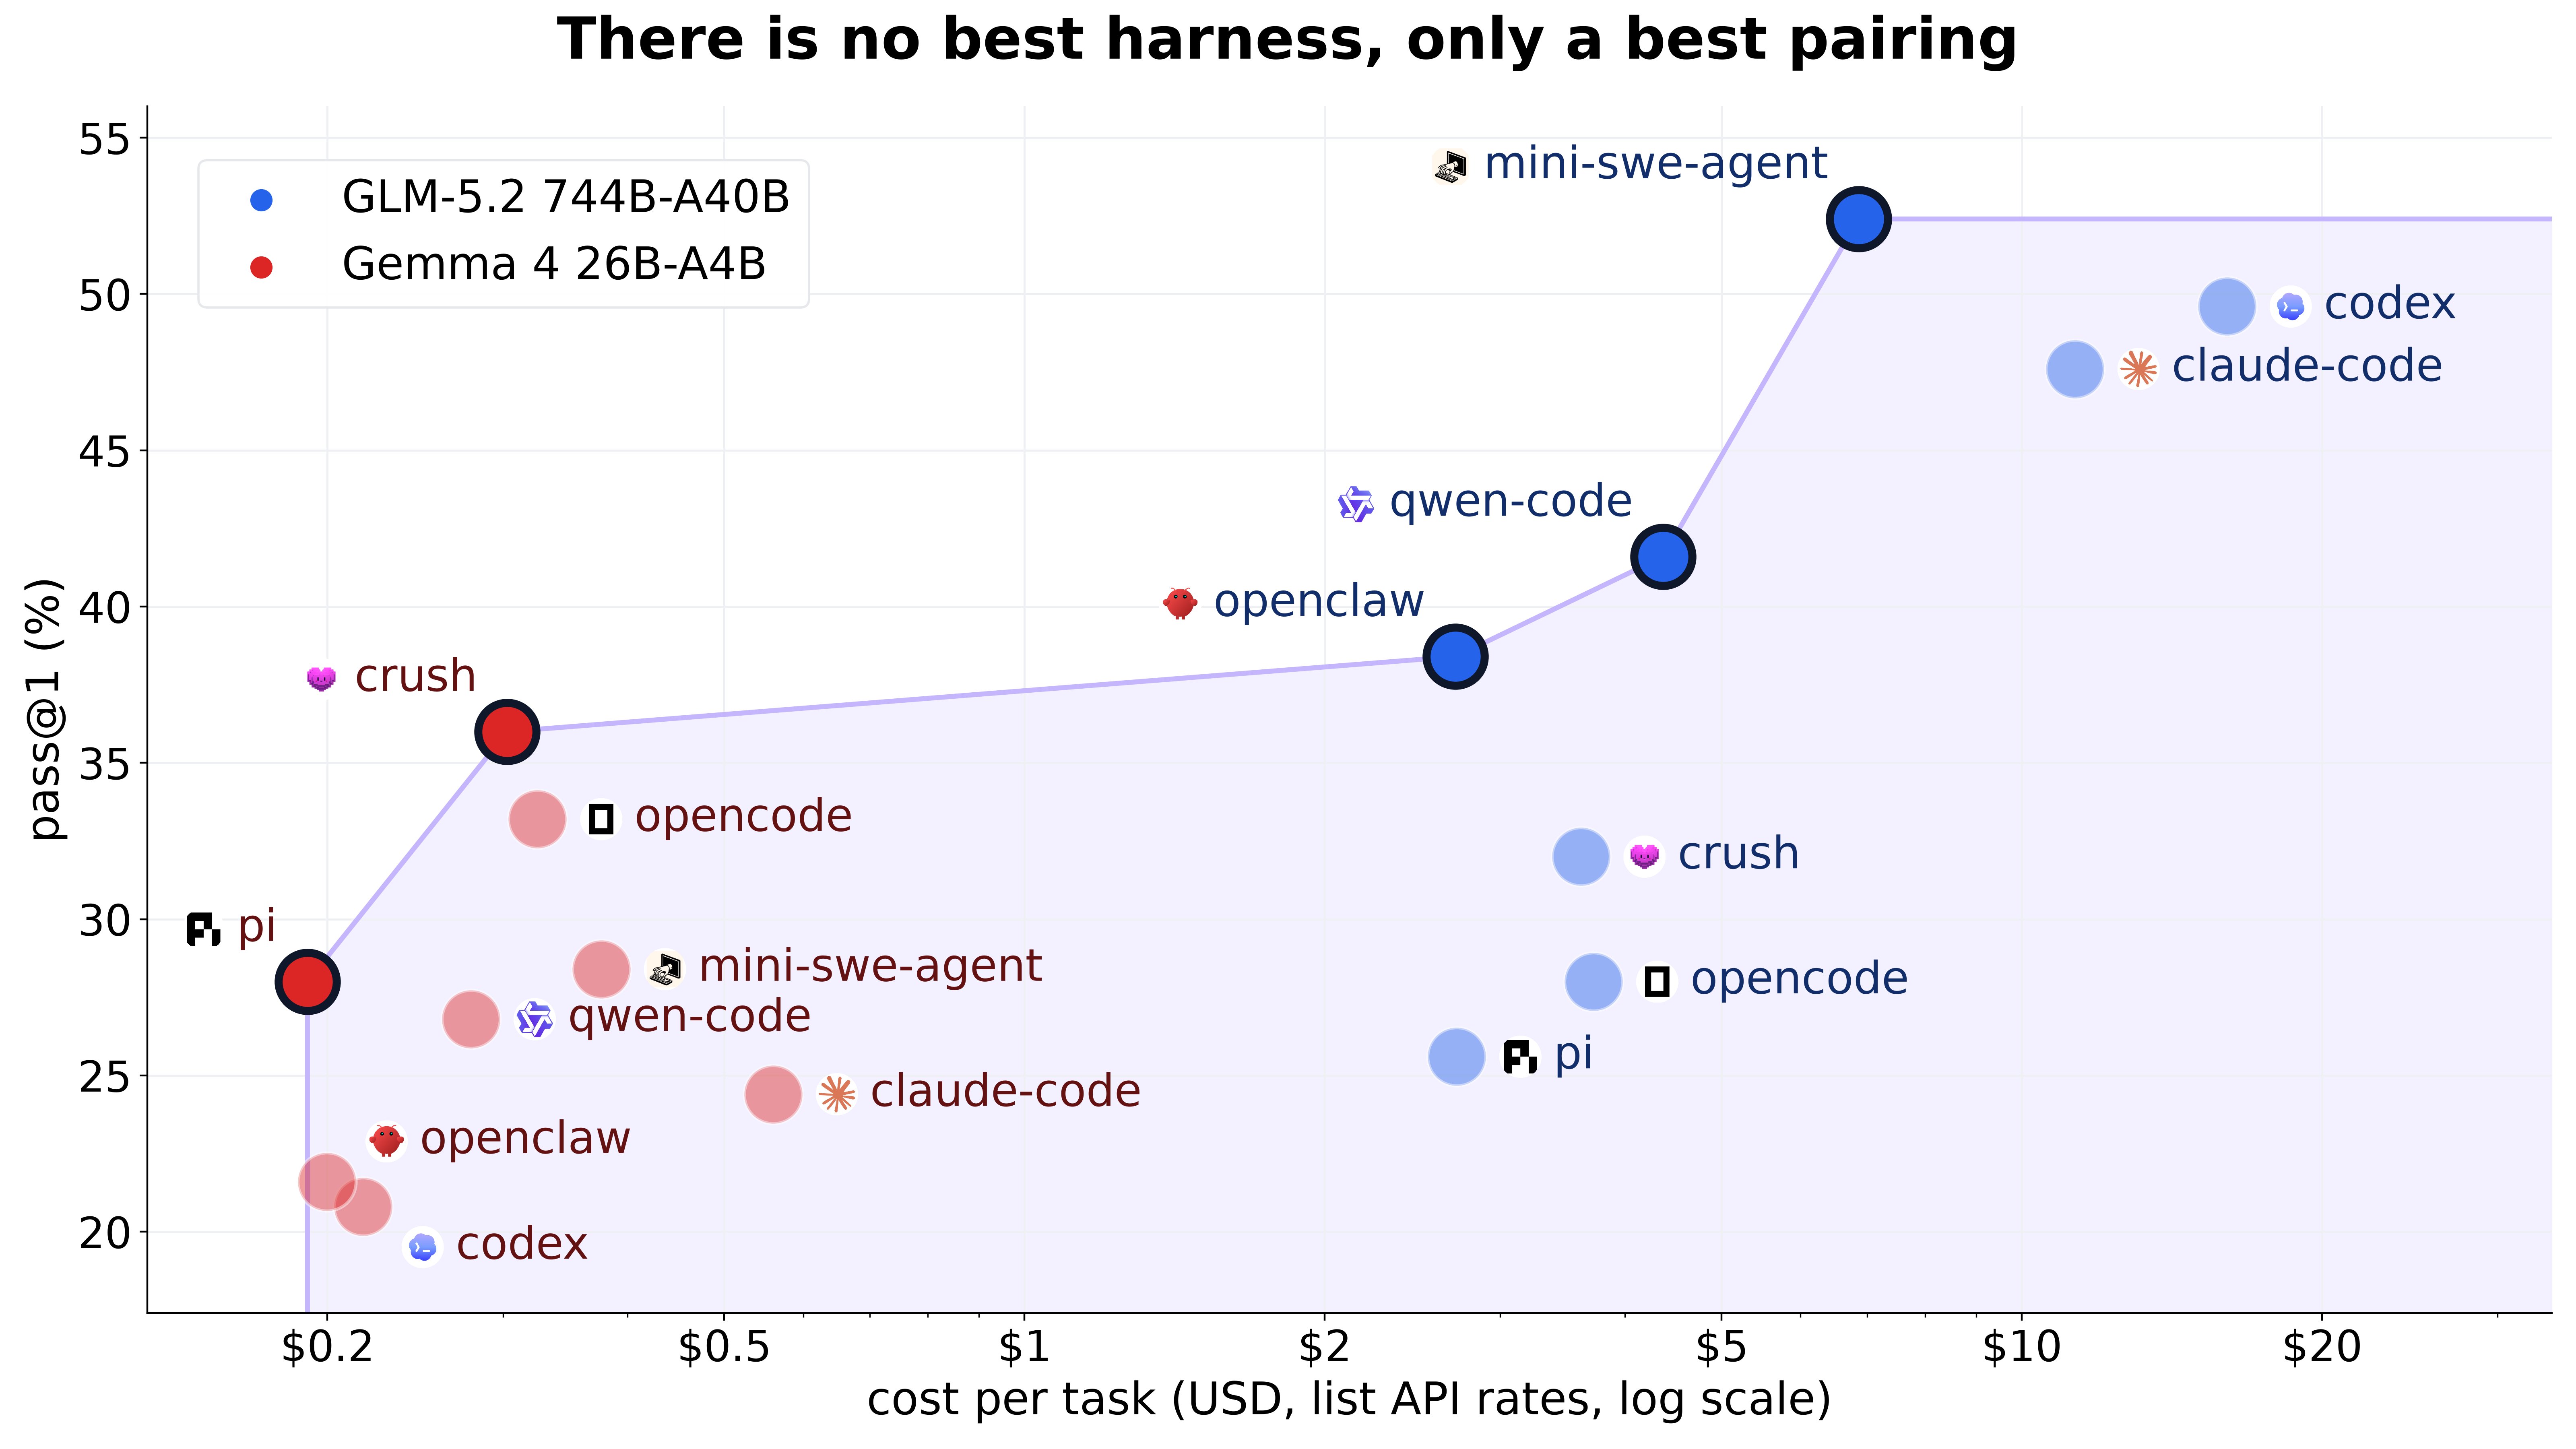
harness 的不匹配对自己跑开源权重的人伤害最大:一个从没在你的 harness 里训练过的模型会调用你的 harness 没有的工具,或写出 harness 读不懂的输出。而只在一个 harness 里训练也治不了——模型会学会那个 harness 的习惯,在别处照样挣扎。Hugging Face 团队(Adithya S Kolavi、Joel Niklaus、Sergio Paniego Blanco、Leonie Monigatti、Amine Dirhoussi、Ben Burtenshaw、Lewis Tunstall、Leandro von Werra,联合 Liquid AI)发布的这篇长文提出的解法,是把训练搬进 harness 本身:在 Claude Code、Codex、OpenCode 这些人们真实使用的 harness 里做 agentic RL——harness 原样运行、一行代码不改。他们用这套框架把一个 2.6B 的小模型在四个 harness 里同时训练,四个 harness 平均 pass@1 从 42% 提到 54%,已解任务的工具调用还少了 31%。
证据链:分数开始自带 harness 标签
这不是理论担忧,而是 2026 年模型卡的现状。GLM-4.7 宣称「在 Claude Code、Kilo Code、Cline、Roo Code 等主流 agent 框架中有显著提升」;Kimi K2 的 Terminal-Bench 报了两次——Terminus 下 25.0,自家框架下 30.0;MiniMax M2 几乎每个基准都标注了 harness;DeepSeek-V3.2 的思考模式在 Terminus 下根本跑不起来,只好换 harness 测。
更关键的发现来自一项受控实验:三个在公开榜单上只差三点的模型(GLM-5.1、GPT-5.4、Kimi K2.6),在同样 100 道 SWE-bench Verified 任务上跑三种递进配置的 harness(Minimal→Improved→Full,逐步加入上下文压缩、重试、自检、回滚)。结果每个模型都在不同的配置下夺冠:换 harness 让 GLM-5.1 移动了 13 个点,而同 harness 下换模型只移动 2.5–5 个点。非受控数据同样触目:Claude Opus 4.5 在 Scale SEAL 榜的 SWE-bench Pro 上 45.9%,在 Claude Code 里 55.4%——权重完全相同。
训练造成的「harness 锁定」更直接。Orchard 论文测了跨 harness 迁移:在 OpenHands 训练的 OpenSWE-32B 换到 Mini-SWE-Agent 掉 7.5 个点,换到从没见过的 Kimi-CLI 暴跌 58.8 个点——SWE-bench Verified 只剩 3.6%,Terminal-Bench 2.0 得分归零;Scale-SWE 离开自家 harness 后干脆停止产生合法工具调用。论文把这两类失败命名为:degraded resolve rate(还能跑但解得更少)与 catastrophic format failure(输出完全不可用)。
根因,KwaiKAT 团队说得最直白:「agentic RL 若只依赖单一固定 harness,模型学到的往往不是『如何解决任务』,而是『如何在该 harness 的接口约定下解决任务』。」他们拆出三种过拟合——对动作格式、对上下文结构、对控制流(重试与停止条件)的锚定。harness 之间的差异恰好沿这三条线展开:API 方言(OpenAI chat-completions / Responses、Anthropic Messages、Gemini)、是否用结构化工具调用(Aider 用 prose 编辑块)、上下文压缩策略。实践中失败常以报错而非降分出现:模型按训练 harness 的工具名和参数名发调用,新 harness 直接拒绝,工具根本没执行。
前沿实验室已经开始主动跨 harness 训练:Poolside 的 Laguna 在监督数据里混入 OpenHands、OpenCode、Mini-SWE-Agent 的轨迹(13 亿 token);Kimi K3 用可组合模块构建 Claude Code、Codex 等多种 harness 配置训练;Qwen3-Coder-Next 在六个 harness 里生成 agentic 数据;Liquid AI 训练 LFM2.5-2.6B 时每个任务随机抽 harness——「直接在 Hermes Agent、OpenClaw 等 harness 里训练,让模型接触它们的工具、系统提示与交互模式」。OpenForgeRL 验证了多样性不牺牲峰值:三 harness 模型在单 harness 主场也赢(48.5 vs 46.0),在 Codex 下几乎翻倍。文章用一份「论文原文收据」面板把八份 2026 年报告的原始段落和页码逐一摆出,这一点值得称赞。
工具名/参数名锚定"] --> X["换 harness 即被拒之门外"] F2["上下文结构过拟合
压缩/历史组织方式"] --> Y["新上下文组织下解率下降"] F3["控制流过拟合
重试/停止习惯"] --> Z["新控制流下失效或跑不完"] S["解法:跨 harness 训练
(harness scaling)"] -.-> F1 & F2 & F3
白盒与黑盒:谁拥有 rollout 循环
文章对概念的处理非常扎实,几个易混词先钉死:policy 是被训练的模型(无循环、无记忆);agent 是跑在 harness 里的 policy 整体;sandbox 是动作真正执行的隔离环境;benchmark 是任务集加比较协议。
关键区分在 RL 环境:白盒环境里训练器拥有循环——训练器采样动作、调 env.step()、读观测、再采样,每个 token 都在训练器手里(TRL 的 GRPOTrainer 就是这个假设);黑盒环境里 harness 拥有循环——它在自己的沙箱里启动、调自己的工具、压缩自己的上下文、自己决定停止,训练器在盒子外面,只能看到打到模型端点上的一串请求。Microsoft Agent Lightning 团队的命名是「传统 agentic RL」与「harnessed agentic RL」之别。注意 KAT-Coder 报告对这两个词的用法不同(它按上下文是否压缩来分),文章专门加注澄清——谁拥有循环和如何处理上下文是两个独立选择。
为什么光有奖励不够:token 契约
harnessed RL 的技术核心是一个朴素的观察:on-policy 策略梯度需要对每个 token 知道两件事——采的是哪个 token、以多大概率采的。而 harness 只会还给你文本和分数。三个坑:
- 重分词漂移:不同 token 序列可以产出相同文本;把文本重新 tokenize 可能得到与模型实际采样不同的 token id。TRL 的原话:「RL 优化的是模型实际产出的那批 token」。
- 被篡改的响应:harness 构建下一轮 prompt 时可能加角色标记、改空白、甚至修复损坏的 JSON——若用这份编辑过的文本训练,等于让模型为一个它从未生成过的响应更新参数。
- 概率必须生成时记录:异步 RL 里模型在 rollout 采样后可能已更新;用当前权重重算 logprob 无法恢复采样时的概率,importance sampling 的比值会被错误地置 1。
对策是「采样器必须返回 token id 和逐 token logprob,训练器必须保存;永不重新编码已解码的文本,模板后缀按 id 拼接追加」。这让截获点必须放在模型端点而不是文本边界上。文章也诚实记录了分歧:OpenForgeRL 用同一代理架构但从文本对重建训练样本,从不提 token id,却拿到目前最强的多 harness 结果——token 忠实派与文本重建派之争尚未定论。
框架解剖:OpenEnv + capture proxy + Harbor + TRL
框架三件套:OpenEnv(Meta PyTorch 与 Hugging Face 共创的 RL 环境标准接口,Gymnasium 风格的 reset/step/state,12 家组织委员会共治,BSD-3-Clause)是三方共享的接口;Harbor(Terminal-Bench 团队出品)供任务与沙箱——0.22.0 版自带 40+ harness 适配器和 26 种执行后端,约 80 个任务数据集采用其格式;TRL 负责训练。
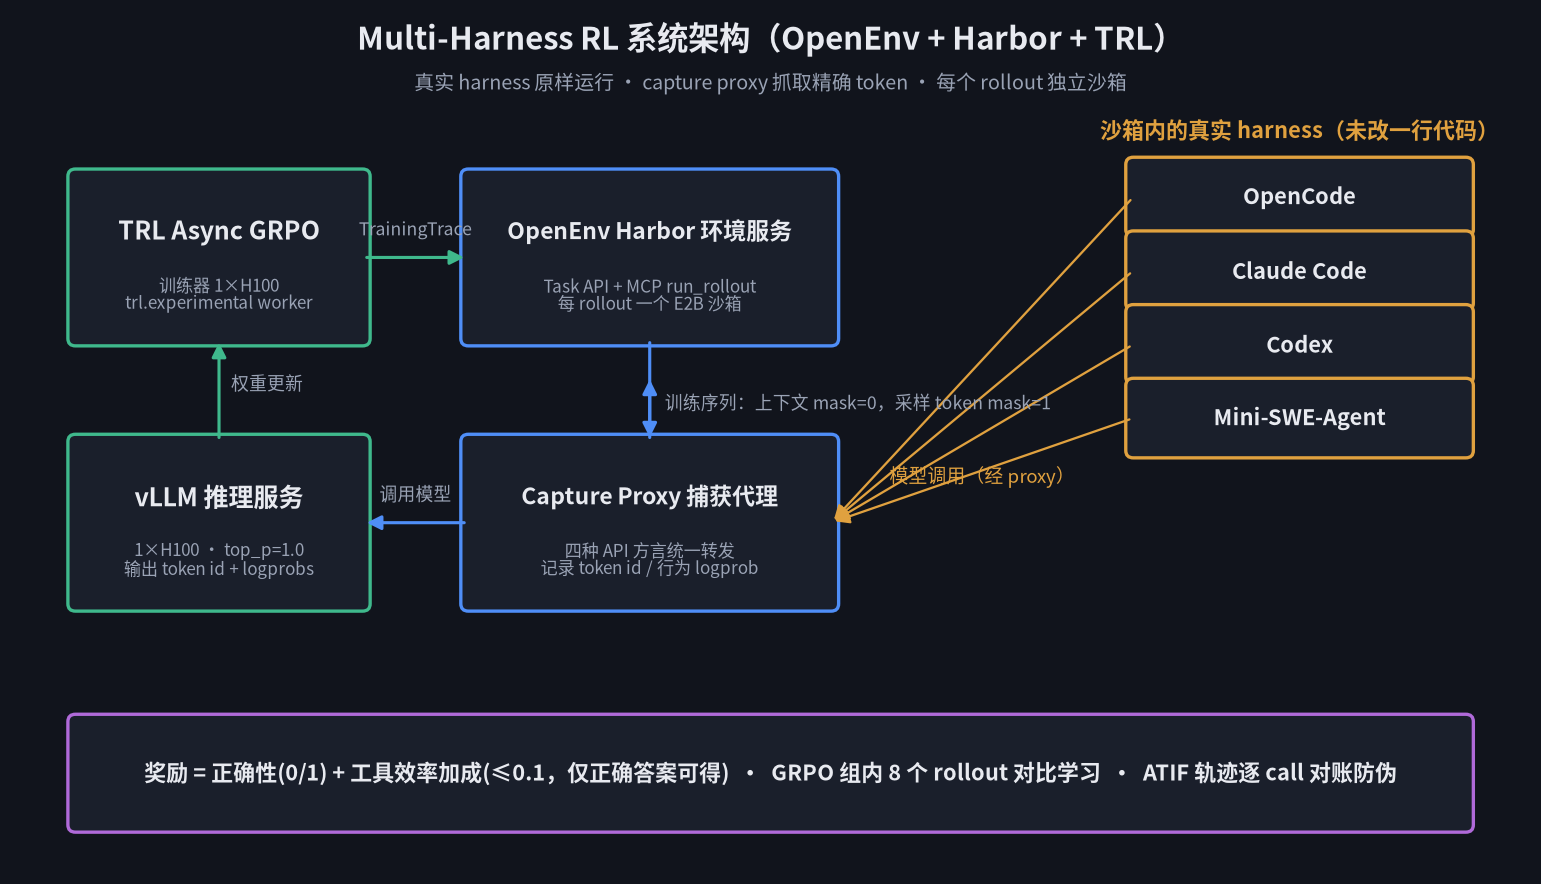
Capture proxy 是整个设计的枢纽。harness 像找模型提供商一样找它:base URL + API key——那个 key 是为单个 rollout 铸造的会话 id,所以一个端口能同时服务所有并发 rollout(未注册的 key 直接 401)。四种 API 方言按请求路径→请求头→请求体形状依次识别,转换器来自 NVIDIA Polar 网关;对引擎永远不流式,存下完整回复后按调用方要求的格式重放。录制时向引擎索要 prompt 的 token id、采样 token id 和逐 token logprob,且强制从全分布采样(top_p=1.0)——截断分布会让策略采样偏离自身分布(通向熵坍缩的已知路径),还让 vLLM 的 processed logprobs 对不上;把 top_p 从 1.0 以内调到 1.0 后,importance ratio 从 0.985–0.993 改善到 0.9984–0.9999。
proxy 对引擎也不信任:首次见面发探针定级,只有达到「tokens 级」才允许训练——托管 API(OpenAI、Anthropic、HF Inference Providers)落在「仅评估」级。rollout 存成调用图:每个模型调用是节点,与其 prompt 构成最长精确 token 前缀的早先调用是父节点——重试是没继续下去的兄弟节点,子代理和压缩后的上下文各自开新根;每条根到叶路径就是一条训练序列,上下文 token 损失掩码为 0、采样 token 为 1,logprob 缺失或错位的轮次只当上下文、绝不当目标。
工程细节同样慷慨:openenv harbor info/rollout/serve/push 四条命令覆盖自检、裸跑、起服务、推 Space;每个 rollout 的捕获结果还要与 Harbor 自写的 ATIF 轨迹逐 call 对账(轮数、每次 completion token 数),一次「空 tools 数组导致 400 截断但图看起来完好」的事故就是这么抓出来的;奖励只取单个分数或名为 reward 的分数、绝不自行加权——曾有「提交任何东西 +0.2」的项让模型学会秒提交,held-out 准确率从 0.740 崩到 0.178 而训练奖励依旧健康。单进程 proxy 在约 200 并发会话时健康检查开始饥饿、320 崩溃,也是实打实记下来的边界。
训练小模型:LFM2.5-2.6B 的四 harness 实验
实验设计干净得可以照抄:1,000 个 SmolDataEnvs 训练任务(400 中 + 600 难,来自真实 Kaggle notebook),250 个 held-out 测试任务与训练零重叠(notebook、问题、指令三重不重叠);两条对照线——OpenCode 单 harness vs 四 harness(OpenCode、Claude Code、Codex、Mini-SWE-Agent,每个 GRPO 组的 8 个 rollout 同用一个 harness);TRL Async GRPO 1,000 步,双 H100(一个训练一个 vLLM 推理),每 rollout 一个 E2B 沙箱;每 100 步在 4 harness × 250 任务 = 1,000 个测试格上评估。基线先复现了问题:同一份权重在 Mini-SWE-Agent 下解 62%,在 Claude Code 下只有 33%。
奖励设计:正确性 0/1 + 工具效率加成(≤0.1,仅正确答案可得)。这个加成来自 Qwen 的教训——只奖正确性时模型没有停下来的理由,早期 Qwen 运行的每 rollout 工具调用从 13 爬到 41。加成虽小,但 GRPO 靠组内差异学习:8 个 rollout 全对时正确性毫无区分度,加成是唯一的信号来源,且偏向更短的解。审计数据:OpenCode-only 有 17.5%、multi-harness 有 22.6% 的组全靠它提供对比度。
结果:两条线都涨——OpenCode-only 42.2%→52.3%(+10),multi-harness →54.2%(+12),总差距 1.9 点在噪声内。真正清晰的是按 harness 拆分:OpenCode-only 几乎全部涨在自己家里(OpenCode 34→58%),multi-harness 在四个 harness 下全涨(Claude Code 42→49%、Codex 43→54%,Mini-SWE-Agent 打平)。效率同理:multi-harness 模型在双方都解出的任务上比基模型少 31% 工具调用(OpenCode-only 只省 11%),最大节省在 Codex——约省一半;而 OpenCode-only 在从没训练过的 Claude Code 下反而比基模型生成更多 token(第 500 步时多 62%)。文章连「两次运行数据暴露量不等」(Claude Code 每条 rollout 展开成约 8 行训练数据)这类削弱可比性的因素都主动摆出,并明确标注结论是观察性而非方法排名。
SFT 对照:模仿贵而弱
用 Qwen3.8-27B 当教师在四个 harness 里跑出 3,189 条成功 rollout(888 任务),转成 17,929 个 SFT 样本(用 LFM 自己的 chat template 重分词)训两个 SFT 模型。结果:RL 完胜——multi-harness RL 54.6%,OpenCode SFT 47.5%,multi-harness SFT 43.1%(差 RL 11.5 点)。更微妙的是 multi-harness SFT 的「扩散又亏掉」:Claude Code +9.2、Codex +6.8、OpenCode +4.4,却在 Mini-SWE-Agent 上从 62.1% 跌到 45.2%——涨的全亏掉,总成绩落回基模型噪声带内(原因未明,文章承认)。SFT 不奖励省工具却依然省了 24.2% 调用(模仿教师的风格),但跨 harness 削减不均。
Qwen 的失败教训:三连跌与三条配方修正
早期 Qwen3.5-2B 运行贡献了等量的经验:三条线都先涨后跌(multi-harness 从 14.6% 冲到 37.0% 后回落到 26%),trace 里看清了原因——multi-harness 是输出预算耗尽(答案越写越长,触顶 4,096 评估上限的格从 9 个涨到 556 个,训练允许 16,384 而评估只给 4,096,模型学会了一个会被评估截断的习惯);OpenCode-only 是不交卷地空转(调用从 17 涨到 21,提交率从 69% 跌到 41%)。还有 35–58% 的优化步组内无对比度(全对或全错)、Claude Code 一家占了 77% 的训练行、换更难的数据也救不回跌幅。LFM 配方的三条修正——加工具效率加成、只用中难任务、训练与评估统一 4,096 输出上限——正是从这些坑里长出来的。
这篇博客最值得带走的四件事
- 「harness 是被低估的自变量」:换 harness 移动 13 点、换模型只移 2.5–5 点的受控结果,加上模型卡纷纷给分数标注 harness 的行业转向,意味着你引用的每个 coding 基准分数都应该追问一句「在哪个 harness 里测的」。
- 黑盒 RL 的 token 契约是硬约束:不重分词、不留被修复的文本、概率生成时记录——把截获点放在模型端点是唯一同时满足三条的位置;hosted API 只能评估不能训练,这个分级判断本身就是有用的工程知识。
- 「harness 原样运行」是可行且有回报的:不改一行 harness 代码、靠 base URL + 会话 id 的 proxy 就能把 Claude Code/Codex 变成训练环境;跨 harness 训练的小模型在四个 harness 全线涨、工具调用省 31%,而单 harness 训练的增益大体锁死在自己家里。
- 失败的完整性是这篇文章的第二贡献:Qwen 的先涨后崩、奖励项被钻空子导致 0.740→0.178、proxy 的并发上限、resume bug 重放旧任务——每个负结果都附了 trace 级归因。对想复现这条路的人来说,这些比正结果更省钱。
全部资产开源:任务套件 SmolDataEnvs、SFT 数据集(含预分词版本与训练脚本)、两条 LFM RL 模型与两条 SFT 模型权重、训练对比 dashboard、Harbor 环境服务器(HF Space 可直接连模型体验),教程含 HF Jobs 与 Slurm 复现指令。作者预告更大模型的运行正在进行中。
capture proxy 的更多工程切面
有几个值得单独拎出来的设计决定,它们回答的都是「把别人的程序接进训练循环」这个命题下的真实难题。其一,会话即钥匙:harness 拿到的不是模型 key 而是会话 id,proxy 用它区分并发 rollout——这意味着捕获边界与安全边界重合,沙箱里的 agent 就算把「key」泄露出去,也只能触达自己那条 rollout 的数据。其二,失败被结构化而不是抛异常:早先进程内版本让 harness 内部的异常直接打穿训练循环,一个崩溃的 rank 让其余所有 rank 卡死在 NCCL 屏障上;改成 HTTP 边界后,失败 rollout 返回 ok=False 与 reward=None,训练器处理值而不是接异常——「沙箱死了」与「答错了」从此是两种不同的信号。其三,并发与部署形态:单机 serve 监听两个端口(训练器/Web UI 与 proxy),沙箱在远端时经 Gradio 隧道暴露;部署到 HF Space 时单端口把 proxy 挂在 /capture 路径下,Space 必须公开(沙箱内的 agent 发不了私有 Space 的认证头),安全性由「只应答已注册会话 id、铸会话需 admin key」保证。其四,别忘调大 max_concurrent_envs:默认 4 小于 GRPO 每组 8 个 rollout,超限直接 CAPACITY_REACHED——这类一眼看似无关配置、实际让训练悄悄空转的坑,文章直接写在正文里。
奖励审计:一套可以抄走的自检清单
文章对奖励本身的处理构成了一个微型方法论。首先,GRPO 的组内结构决定了一切设计的杠杆点:8 个 rollout 同任务同 harness,advantage 来自组内互相比较——这解释了为什么 0.1 的效率加成有效(全对组的唯一区分度),也解释了为什么 35–58% 的步没有梯度(组内全同)。其次,奖励函数要被审计而不是被相信:他们导出了所有贡献保留更新的组(剔除 resume 丢弃的部分),逐组核对公式——「未发现公式不匹配、错误答案上没有加成」,工具计数直接取自 harness 自己的 trace。第三,对抗性自检:ATIF 逐 call 对账不仅校验 token 数,还校验「哪些调用算 agent 步骤」,空 tools 数组事故后 proxy 学会在转发前丢弃空数组——防的是基础设施悄悄产生劣质训练数据,而不是模型作弊。第四,评估口径与训练口径的一致性被反复强调:温度匹配、输出上限匹配、每组单 harness(比较的是动作不是 harness)——Qwen 的崩盘有一半可以归结为这些口径在训练与评估之间的裂缝。
放进行业坐标系里看
把这篇文章与其引用的生态并排放,能看到一条清晰的时间线:2025 年的模型报告大多不标注 harness 或每个基准只标一个;到 2026 年,Poolside、Kimi、Qwen、小米 MiMo、Liquid 全部在跨 harness 训练,Harbor 0.22.0 有了 40+ 适配器,OpenEnv 端到端验证了十个 harness。基础设施层已经就位,缺的从来不是动机而是「对任何 harness 可靠复用的开放做法」——这篇文章补的就是这一块:不要求 harness 配合(环境变量、配置文件、host 直传三种接线方式,每个 harness 一条表项)、不要求训练器改造(Typed TrainingTrace 直接喂 TRL)、不要求信任托管 API(capture 分级)。对一个 2.6B 小模型双 H100、46 小时的训练成本,任何有开源权重和两张卡的团队都能起跑——这与 Agent Lightning 用 6,000 条样本把 Qwen3.5-9B 提升 14.6 点的结论互相印证:harnessed agentic RL 的门槛已经降到中小团队的水平线上。而对更广的 agent 生态,这篇文章的隐含判断更值得玩味:当模型在哪个 harness 里训练变得比模型本身更能决定表现时,harness 生态位上会分化出「为训练而存在的 harness 标准层」——OpenEnv + Harbor 正是在抢占这个位置。
来源
- 原文:The ultimate guide to multi-harness RL(Hugging Face Space,2026-10-01,Adithya S Kolavi、Joel Niklaus、Sergio Paniego Blanco、Leonie Monigatti、Amine Dirhoussi、Ben Burtenshaw、Lewis Tunstall、Leandro von Werra)
- 代码仓库:adithya-s-k/FineEnvs(文章源文件在 content/articles/multi-harness-rl/)
- 配套教程:FineEnvs 仓库 05-multi-harness-rl/(多 harness 与 OpenCode 原生训练脚本 + REPRODUCE.md)