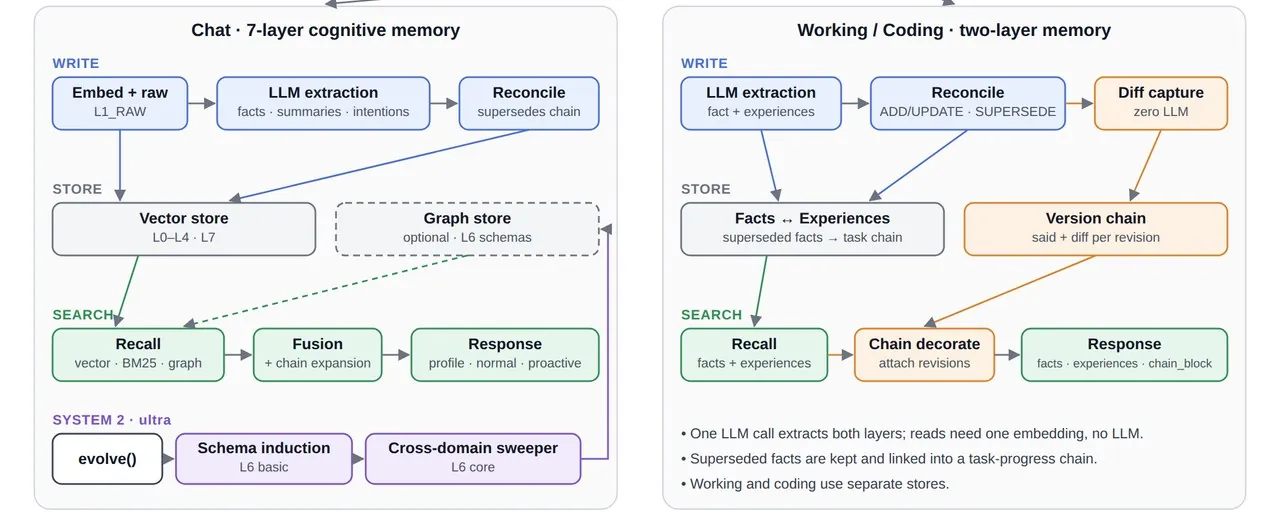
腾讯混元开源 Hy Memory 2.0:用一个 3B 激活的专用模型,替通用大模型做“记忆写入”
腾讯混元开源 Hy Memory 2.0:3B 激活的专用写入模型 Hy-Memory-30B-A3B、hy-memory SDK 与本地优先 MemHub,四 harness 宏平均 55.49 超 Opus 5。
一条推文背后的三件套:模型、SDK、桌面端
线索来源:meng shao (@shao__meng) 在 X 上的解读推文(2026 年 10 月 16 日,引用腾讯混元官方发布推文)。本文在推文之外通读了 Hy-Memory 开源仓库、Hugging Face 模型卡、技术报告 arXiv:2610.22196 与 MemHub 文档后撰写。
2026 年 10 月 16 日,腾讯混元把「Hy Memory 2.0」一次性开源成三件东西:一个只做记忆写入的 MoE 模型 Hy-Memory-30B-A3B(30B 总参、约 3B 激活),一个可编程的记忆框架 hy-memory SDK(PyPI 已发到 2.0.4,Apache-2.0),以及一个本地优先的桌面端加 CLI 产品 MemHub(v1.0.4)。meng shao 的推文把这套组合压缩成一句判断:与其在通用大模型外面套一个记忆框架(Mem0、MemOS 那一类),不如用一个便宜的专用模型替通用模型做记忆写入——既省钱,又能跨框架工作。
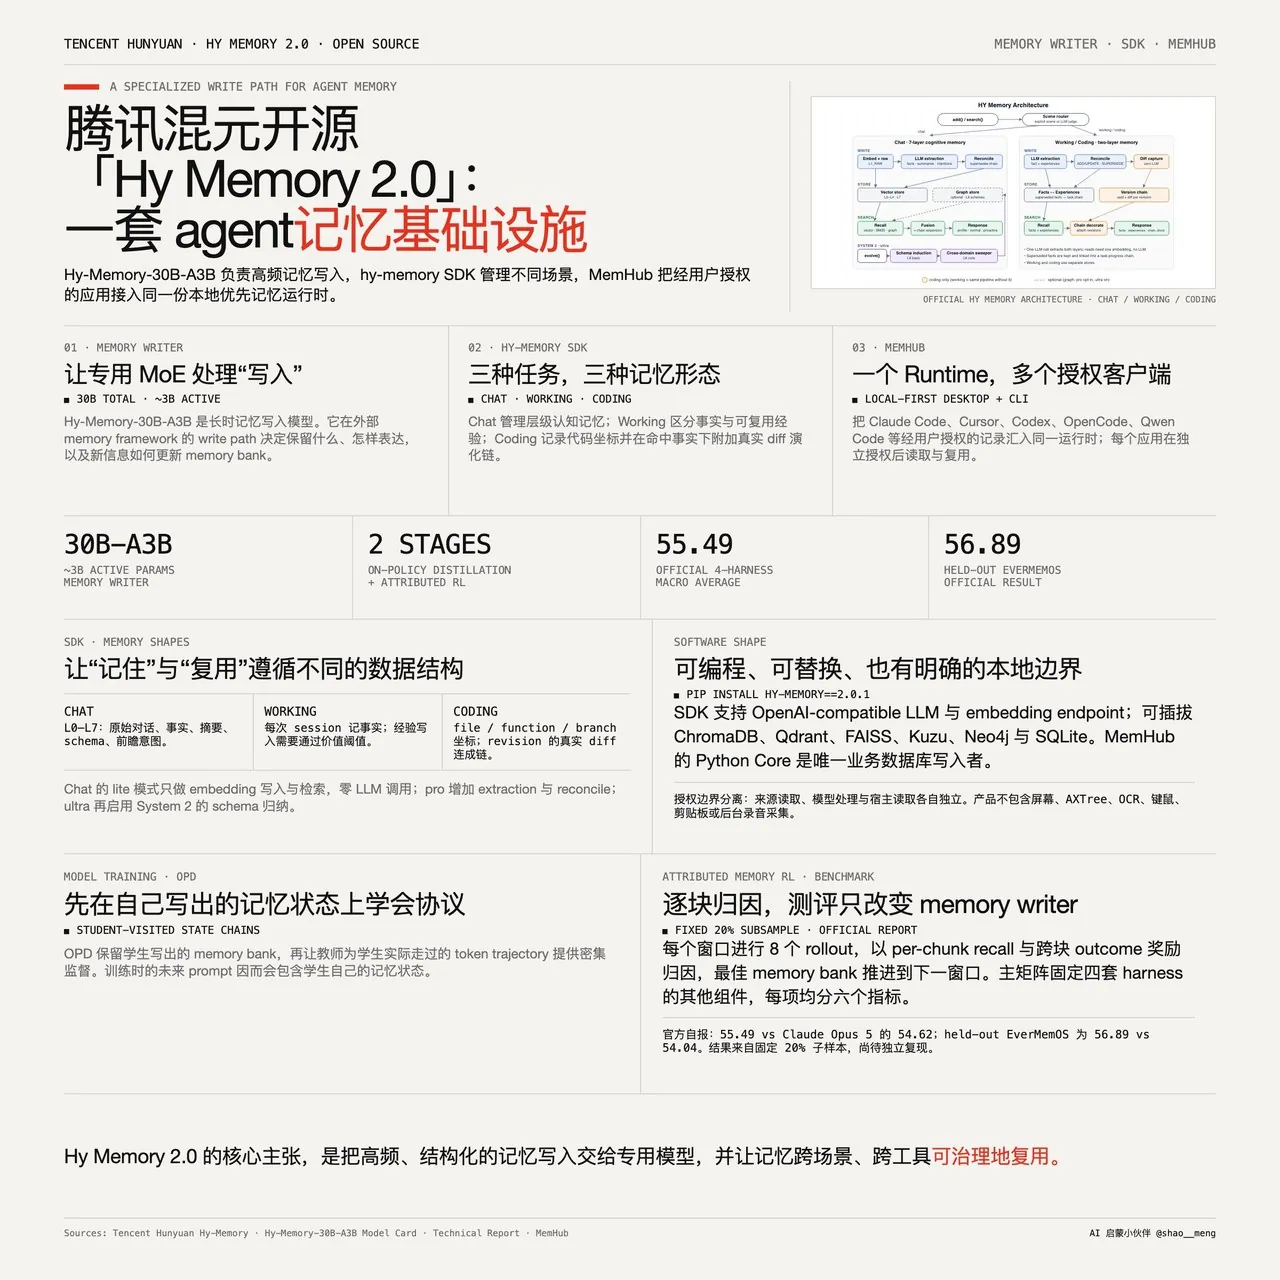
这句判断值得展开,因为「记忆写入」恰恰是整套长期记忆系统里最被低估、也最贵的一环。
为什么写入才是记忆系统里最贵的一环
任何长期记忆系统都可以拆成三段:写入器把一次交互变成持久化记忆操作;检索器为未来的查询挑出相关记录;读者(答案模型)用这些记录作答。
flowchart LR
  W["写入器 writer:记什么、怎么记、如何更新旧状态"] --> B[("记忆库 bank")]
  B --> R["检索器 retriever"]
  R --> A["读者 reader / 答案模型"]
  A --> Q["回答"]
主流做法把写入器实现为「通用大模型 + 一段很长的框架专用 prompt」。这带来两个问题。其一是信息论上的:框架无法恢复写入器漏掉的信息,读者再强也推不出一条从未入库的事实;反过来,不加选择地全存又会推高存储成本并制造检索干扰。其二是成本上的:写入是高频调用——每一轮对话、每一次工具调用都要过一遍写入器,而读取相对稀疏;让旗舰模型付这份钱,账单会随会话长度线性放大。
所以 Hy Memory 2.0 的赌注是:把写入训练成一种可迁移的模型能力,而不是某个框架的 prompt 技巧。技术报告给出的证据是,同一个模型在 Mem0、MemOS、Hy-Memory 三套 harness 内训练之后,连训练时没见过的 EverMemOS 也能直接接管写入路径。
Hy-Memory-30B-A3B:一个只干写入的 MoE
模型本体是混元 Hy3 系列的 30B-A3B 指令微调 checkpoint:总参 30B、激活约 3B,推理成本接近一个 3B 模型,这正是「高频写入调用」能承受的形状。
| 项 | 值 |
|---|---|
| 架构 | HYV3 MoE |
| 层数 / 隐层宽度 | 48 层 / 2048 |
| 专家 | 128 选 8,另加 1 个共享专家;专家隐层 768 |
| 注意力 | GQA,32 个查询头 / 4 个 KV 头,head_dim 128 |
| 词表 / 最大位置 | 120,832 / 262,144 |
第一阶段:Memory On-Policy Distillation
OPD 不让教师另外生成一条理想轨迹,而是让冻结的 Hy3 旗舰教师对学生自己采样出来的 token 流做前向,返回 top-50 分布;损失是在学生访问过的前缀上的 top-k 反向 KL 近似:
$$\mathcal{L}_{\mathrm{OPD}}=\frac{1}{|\mathcal{T}|}\sum_{(i,j)\in\mathcal{T}}\ell_{i,j},\qquad \ell_{i,j}=\sum_{v\in\mathrm{top}\text{-}50}\pi_{\theta}(v\mid x_{i,<j})\left[\log\pi_{\theta}(v\mid x_{i,<j})-\log\pi_{T}(v\mid x_{i,<j})\right]$$
对记忆写入来说,on-policy 的收益不止于 token 前缀:每个 chunk 的 prompt 里携带的记忆库,也是学生自己之前写出来的,于是监督分布与部署分布对齐。配置上,每行 2 条 rollout、学习率 1e-6 恒定、熵系数 0.005;一次 harness 写入内的所有 LLM 调用保留为独立 segment,position id 在调用边界重置,避免把多次调用拼成一段伪造的对话。RL 的起点是 OPD 第 375 步。
第二阶段:归因记忆强化学习
RL 在同样的 harness 配置里执行。每个窗口(最多 5 个 chunk)开 8 条 rollout,从同一个父库的独立副本出发写完所有 chunk,再被奖励问题「体检」,得到逐 chunk 分数;总分最高的最终库晋升为同一序列下一窗口的初始库。on-policy 在这里是两层的:token 由当前策略采样,未来的 prompt 由该策略写出的库生成。
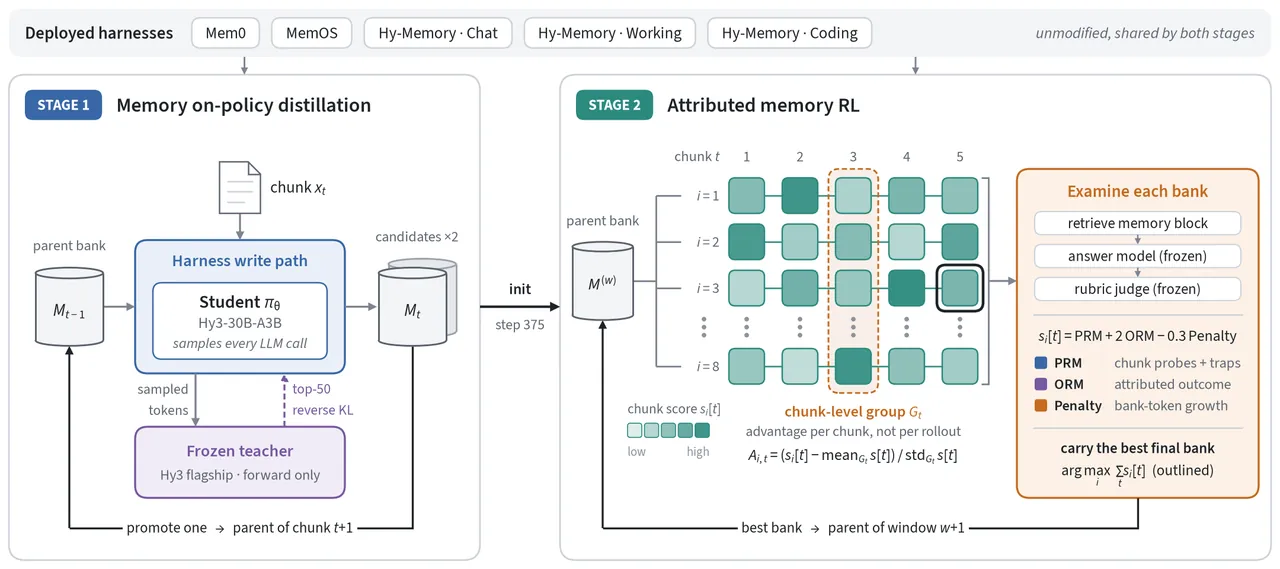
flowchart TD
  P["父库 M(t-1)"] --> R1["rollout 1:写完窗口内全部 chunk"]
  P --> R8["rollout 8:写完窗口内全部 chunk"]
  R1 --> S1["逐 chunk 分数 s_1[t]"]
  R8 --> S8["逐 chunk 分数 s_8[t]"]
  S1 --> W{"按 sum_t s[t] 排序"}
  S8 --> W
  W --> N["最高分最终库 = 下一窗口的父库"]
  W --> D["其余 7 个库丢弃"]
奖励由三部分构成。逐 chunk 召回奖励 prm 把正探针与陷阱探针的判分取平均(没有有效探针的 chunk 记 0 而不是 1):
$$\mathrm{prm}[t]=\frac{\sum_{i\in R_{t}}z_{i}+\sum_{j\in P_{t}}z_{j}}{|R_{t}|+|P_{t}|}$$
跨 chunk 的归因结果奖励 orm,用 gold fact 把「答案恢复了多少证据」记回引入该证据的 chunk,取平均以免标注者多写问题就抬高某个 chunk 的权重:
$$\mathrm{orm}[t]=\frac{1}{|Q_{t}|}\sum_{q\in Q_{t}}c_{q}[t]$$
库增长惩罚 pen 按 token 增长比例(而不是条目数——把条目写长同样能扩容)做指数加压:
$$x_{t}=\mathrm{clip}\!\left(\frac{g_{t}-\ell_{h}}{u_{h}-\ell_{h}},\,0,\,1\right),\qquad \mathrm{pen}[t]=\frac{e^{3x_{t}}-1}{e^{3}-1}$$
三者合成逐 chunk 分数,其中 $w_{\mathrm{prm}}=1$、$w_{\mathrm{orm}}=2$、$w_{\mathrm{pen}}=0.3$、$\gamma=0$——gold fact 归因已经处理了跨 chunk 的延迟证据,没必要再把未来的召回分反向广播:
$$s[t]=w_{\mathrm{prm}}\sum_{k\geq t}\gamma^{k-t}\,\mathrm{prm}[k]+w_{\mathrm{orm}}\,\mathrm{orm}[t]-w_{\mathrm{pen}}\,\mathrm{pen}[t]$$
优势按 chunk 列做组内归一(chunk-level GRPO),而不是整条轨迹一个分数:8 条 rollout 只在 chunk 0 共享同一个库,之后每条 rollout 看到的都是自己 earlier 动作写出的库,轨迹级评分会再次把一次判断广播到它所有的写入上。
$$A_{i,t}=\frac{s_{i}[t]-\mu_{t}}{\sigma_{t}+\epsilon}$$
每条 rollout 在每个 chunk 上只投一票:即使某个 harness 为该 chunk 发了三次 LLM 调用,三段共享同一优势、但不算三个独立观测,否则策略可以靠改变调用次数来操纵基线。有效 rollout 少于 2 的组优势记 0。
奖励数据:从失败面长出来的 16 万条探针
只用基准的最终问题做奖励,是一个低密度学习问题:一段长交互可能含几百条有用事实,却只有几个问题;没被问到的写入拿不到证据,答错也分不清是漏写、写糊、旧状态混淆、检索失败还是读者失败。于是奖励条目从写入的失败面构造,标注分两遍:
| Pass | 标注上下文 | 产出与考察目标 |
|---|---|---|
| 逐 chunk 探针(PRM) | chunk t 全文 + chunk t-1、t-2 的已抽取事实 | 原子事实、探针、陷阱与 rubric;考察 chunk t 是否写得精确且仍可召回 |
| 跨 chunk 结果(ORM) | 序列更早的事实 + 当前窗口全部事实 | 问题、证据 chunk、gold fact 与 rubric;考察跨 chunk / 跨会话的关系 |
PRM 这一遍只看前两个 chunk 的事实而非全历史,是实测出来的决定:全历史标注的输入 token 多 33 倍,而双 chunk 上下文让每条抽取事实多出 25% 的专有名词与 59% 的数字——看全序列时标注者的注意力会散开,事实变得泛化,而那正是要被探针抓住的失败模式。
| 探针类型 | 奖励在测什么 |
|---|---|
| Specificity | 精确的名字、数字、头衔、版本、路径与实体在写入后仍然存活 |
| 语义精确 | 否定、范围与事件含义没有被反转 |
| Plain recall | 一条持久的显式事实仍然可答 |
| 次要维度 | 主导话题没有抹掉较小的细节 |
| Transition | 新状态与被它取代的旧状态都被表示 |
| Should-not-store | 问候、空泛夸奖与通用助手话术没有入库 |
陷阱探针问的是「不该进长期记忆的内容」,参考答案是「库里没有这条记录」:一旦写入器把无关话术存了下来,检索就会把它暴露给读者,答案随之判错。它与增长惩罚互补——惩罚压体积,陷阱测语义选择性,把无关文本压缩成更短的条目也躲不过。
| 配置 | 处理单元 | 奖励条目 |
|---|---|---|
| Hy-Memory / Chat | 3,182 窗口;14,519 chunk | 41,990 召回;2,769 陷阱;15,281 ORM |
| Hy-Memory / Working | 1,971 窗口;8,902 chunk | 25,272 召回;1,537 陷阱;9,740 ORM |
| Hy-Memory / Coding | 1,154 窗口;5,187 chunk | 14,348 召回;178 陷阱;5,337 ORM |
| Mem0 | 3,182 窗口;14,516 chunk | 41,416 召回;1,969 陷阱;15,228 ORM |
| MemOS | 3,182 窗口;14,492 chunk | 41,550 召回;2,146 陷阱;15,241 ORM |
| 合计 | 12,671 窗口;57,616 chunk | 164,576 召回;8,599 陷阱;约 60.8k ORM |
最终产物还含 222,395 条 chunk 级 gold-fact 引用。gold fact 只对结果裁判可见,不进入记忆库、检索 query 或答案模型 prompt;判别性校验要求裁判对每条题目的 5 个合成答案按预期排序(参考与改写拿满分、部分答案拿部分分、干扰项与拒答拿 0 分),试点中忠实改写的平均得分保持在 0.90。
训练系统侧:16 节点 × 8 张 H20(共 128 卡),一个 batch 是 64 窗口 × 8 rollout = 512 条轨迹;目标函数是 PPO 式 clipped surrogate 配 chunk-level GRPO 优势,先按序列均值再按 token 均值聚合,不加 KL 惩罚;学习率 5e-6 恒定;rollout 时的 MoE 路由在训练时回放;上下文为 28,672 prompt token 加 4,096 response token。
hy-memory SDK:三种场景,三套记忆形态
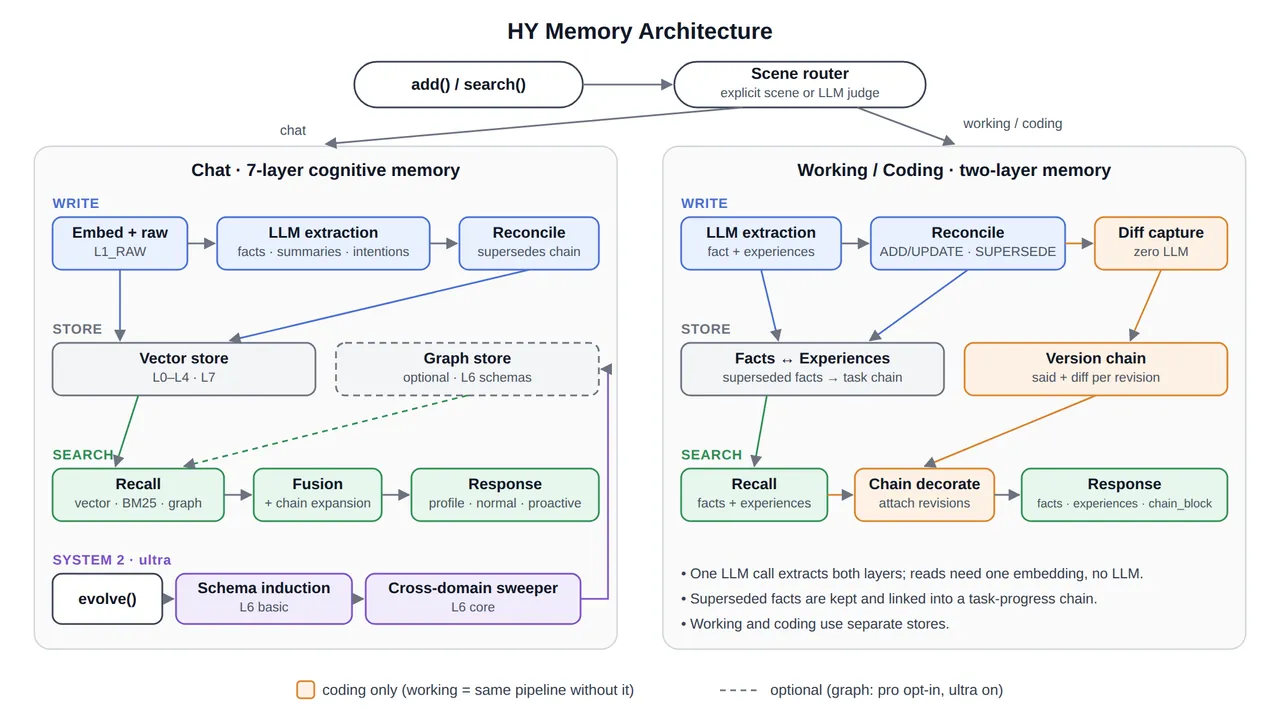
add() / search() 先过场景路由,再进入 Chat 或 Working / Coding 链路;橙色部分为 Coding 独有,去掉即为 Working。scene | 面向的任务 | 记忆形态 |
|---|---|---|
chat | 闲聊、个人信息、偏好、一般问答 | 分层记忆(L0–L7) |
working | 文档、表格、研究、财经分析、内容创作、电脑操作等生产力任务 | 双层:会话事实 + 可复用经验 |
coding | 编码、调试、测试、构建、API/SDK、脚本、SQL 等软件工程任务 | 同 working 的双层,外加代码版本演进链(diff 链) |
Chat:L0–L7 八层认知记忆
面向个人长期记忆,原始对话被逐层抽象成事实、摘要、画像与更高层的认知结构。注意编号从 L0 起,且 L4/L5 目前是保留位:
| 层 | 名称 | 内容 |
|---|---|---|
| L0 | BASIC_INFO | 基础信息 |
| L1 | RAW | 原始对话(append-only) |
| L2 | FACT | 原子事实(版本化、不可变记录) |
| L3 | SUMMARY | 会话摘要 |
| L4 / L5 | IDENTITY / KNOWLEDGE | 保留 |
| L6 | SCHEMA | 心智模型(抽象叙事模板,图层) |
| L7 | INTENTION | 前瞻意图(带有效期,过期后转为普通事实) |
处理模式分三档:lite 只做 embedding 写入与检索、不调 LLM、忽略 scene,是零 LLM 开销的纯向量 RAG;pro 加上 LLM 抽取与 reconcile 冲突处理,图数据库可选(默认关);ultra 再加 System 2 的图式归纳与跨域 sweeper(由 evolve() 显式触发),图数据库自动开启。检索侧 search_mode="default" 固定走 chat、零 LLM;agentic 模式才自动做场景分类、query 改写与时间范围解析。
Working:事实层 + 经验层
一次带工具调用的会话会同时产出两层记忆:事实层(WorkingFact)记录这次会话做了什么,每次会话恰好 1 条、不设门槛,保证「做过的事一定记得」;经验层(Experience)记录下次遇到类似任务可以直接复用的做法,0–N 条、需通过价值门槛,负责「学到的东西能复用」。两层互链(fact.derived_experience_ids 对 experience.source_fact_ids),旧事实被覆盖时以 superseded 状态保留,并可经任务进展链回溯演化过程。
Coding:双层记忆 + 版本演进链
Coding 与 Working 复用同一套 pipeline 与 schema,区别有三:抽取规范面向软件工程(主语必须是代码或决策,记录文件 / 函数 / 分支等精确坐标而不粘贴代码本体);存储完全隔离(coding_memory_cv.db 与 *_cv 向量集合);以及多出版本演进链。
演进链存在的理由很具体:事实层刻意不粘代码,把预算留给坐标,于是「被撤掉的那一版代码」不会出现在事实里——而那一版往往既不在工作区也不在 HEAD,事后读不回来。演进链以零 LLM 的方式把每一版的真实 diff 存下来,并且是装饰器而非检索器:向量层决定返回哪几条事实,链只负责在每条事实下挂出它所涉及代码的全部改动版本(每版的用户原话加真实 diff)。链的来源是本地 Git diff 或工具轨迹中带 path / old / new 的确定性替换动作;一条 thread 对应「某分支、某文件、某函数的某一块」,由 user_id 与 workspace_id 共同隔离。
pip install hy-memory                 # 核心(含 ChromaDB 与 Kuzu),最新 2.0.4
pip install "hy-memory[all]"          # + Qdrant / FAISS / Neo4j / MySQL 缓存 / 本地 rerank

export MEMORY_LLM_MODEL="deepseek-chat"            # 任意 OpenAI 兼容端点
export MEMORY_EMBEDDER_MODEL="text-embedding-v3"
export MEMORY_EMBEDDING_DIMS=1024
from hy_memory import HyMemoryClient
client = HyMemoryClient(mode="pro")
client.add("用户喜欢科幻电影,特别是《星际穿越》", user_id="user_1")
results = client.search("用户喜欢什么类型的电影?", user_ids=["user_1"], limit=10)
for mem in results["memories"]["normal"]: # profile / normal / proactive 三路
print(f" [{mem['score']:.2f}] {mem['content']}")
# coding 场景:写入必须带工具调用轨迹,返回事实 / 经验 / 演进链三块
result = client.search("Which timeout implementation was finally kept?",
scene="coding", user_ids=["user_123"],
workspace_id="github.com/example/service",
branch="fix/search-timeout", limit=5)
result["facts"], result["experiences"], result["chain_block"]MemHub:把跨工具记忆做成本地优先的产品
MemHub 是这套 SDK 面向终端用户的形态:一次安装、一个 Runtime、一份数据、多种客户端。它把用户明确授权的 AI 对话与编码记录(Claude Code、Cursor、Codex、OpenCode、Qwen Code 等)汇总到本地受管 Runtime 与数据目录,再按授权向宿主应用提供跨应用记忆召回——「在 Cursor 里学到的偏好,Claude Code 也能用」。
几条值得注意的工程与隐私边界:Python Core 是唯一记忆数据面与唯一业务数据库写入者;来源读取、模型处理、宿主读取是三条相互独立的授权边界;产品不包含屏幕、Accessibility/AXTree、OCR、键鼠、剪贴板或后台录音采集;SQLite 数据默认在 ~/.one-memory。npm 包 memhub-cli 只承载约 384 KB 的 bootstrap CLI,postinstall 不下载 Runtime、不注册服务、不改 shell profile,只有用户显式执行 memhub install 后才下载并校验完整 Runtime。平台覆盖 Linux x64/arm64 与 macOS(签名加公证),Windows 不支持;当前仍是 preview 阶段。
成绩怎么读:四个 harness、六个指标、一张 20% 子样本表
评测只换写入器:harness 版本与 prompt、检索配置、答案模型与裁判全部固定,每个写入器都从空库自建记忆库。主矩阵的每个基准在固定 20% 子样本上评估;每个 harness 分是六个指标(LoCoMo Judge、LongMemEval、PersonaMem-v2、Travel SPS、Shopping PS、CMB)的等权平均,总分是四个 harness 的等权平均。
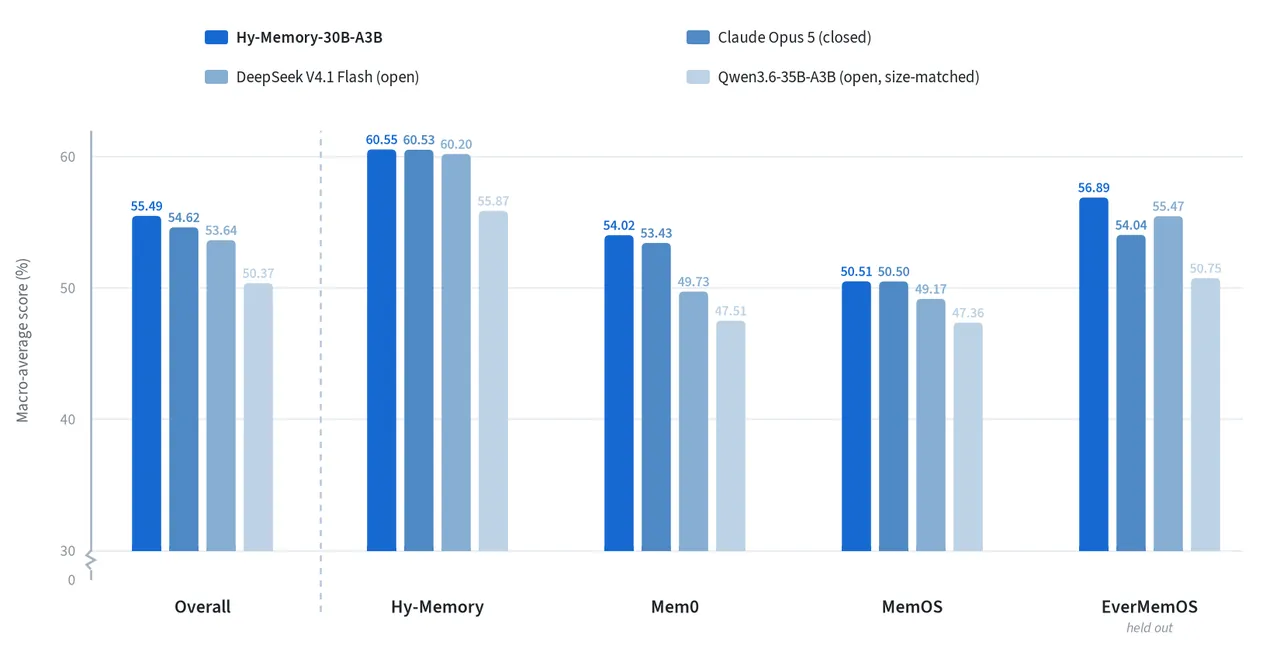
| 记忆写入器 | Mem0 | Hy-Mem. | MemOS | EverMem. | 平均 |
|---|---|---|---|---|---|
| Hy-Memory-30B-A3B | 54.02 | 60.55 | 50.51 | 56.89 | 55.49 |
| Claude Opus 5 | 53.43 | 60.53 | 50.50 | 54.04 | 54.62 |
| DeepSeek V4.1 Flash | 49.73 | 60.20 | 49.17 | 55.47 | 53.64 |
| Hy3 | 45.99 | 58.06 | 50.19 | 52.30 | 51.63 |
| Qwen3.6-35B-A3B | 47.51 | 55.87 | 47.36 | 50.75 | 50.37 |
| Hy3-A3B Base | 40.20 | 50.39 | 49.05 | 50.98 | 47.66 |
| Qwen3-30B-A3B | 39.81 | 45.67 | 45.44 | 46.57 | 44.37 |
相对 Opus 5,宏平均 +0.87(Mem0 +0.60、Hy-Memory +0.02、MemOS +0.01、EverMemOS +2.86)。报告自己说得很清楚:MemOS 与 Hy-Memory 上 0.01–0.02 的差距是持平,不是统计上分辨出的差异;真正硬的证据是两条——held-out 的 EverMemOS 上 +2.86(其中 Travel SPS +10.65、CMB +13.66),说明学到的是模型级的写入能力而非对训练 harness 协议的记忆;以及相对真正的初始化 checkpoint(Hy3-A3B Base,47.66)提升 7.84 分,说明训练方法本身有效。
| 方法 | 训练对象 | 奖励形态 |
|---|---|---|
| Memory-R1 | 记忆管理器 + 答案 agent | 最终答案奖励 |
| MemAgent | 循环文本压缩(记忆即模型内部状态) | 终端可验证奖励 |
| Mem-α | 多组件库上的构造策略 | 下游 QA + 格式 / 压缩 / 操作质量奖励 |
| MemCoE | 个性化记忆的 guideline 与演化策略 | guideline 对齐的过程反馈 |
| Hy-Memory-30B-A3B | 只训写入器,读者与裁判冻结;跨多个既有 harness | 逐 chunk 探针 + gold-fact 归因 ORM + 陷阱与增长惩罚 + chunk-level GRPO |
必须保留的诚实边界:这是官方技术报告的自报成绩,主矩阵用固定 20% 子样本,独立复现尚待出现;报告明确列出了还没做的消融——chunk 级对窗口级 GRPO、gold-fact 归因对广播 ORM、探针加陷阱对仅探针、增长惩罚、二元对 rubric 奖励、OPD 初始化对通用 SFT、单 harness 对混合 harness 训练;归因是证据式而非反事实的,恢复出 gold fact 并不证明某次写入导致了该答案;汇总分也可能掩盖提升究竟来自抽取、更新、删除、reconcile 还是面向检索的表示。
推文本身有两处需要校正。其一,SDK 的 Chat 分层是 L0–L7(L4/L5 保留),不是 L1–L7。其二,「比同架构基座 Qwen3-30B-A3B 提升约 11 分」把参照系说混了:RL 的真正起点是 Hy3-A3B Base(47.66 → 55.49,+7.84);Qwen3-30B-A3B(44.37)只是同尺寸开源参照,55.49 减 44.37 约 11.1 分是「整套训练相对同尺寸参照」的差距,不是相对初始化 checkpoint 的提升。推文其余数字(55.49 对 54.62、EverMemOS 56.89 对 54.04)与报告一致。
九种「看起来很健康」的静默失败
技术报告第 9 节是全文最像工程日志的一段:每一种失败在指标上都「看着没病」,直到某个不变量被检查。
- 库没有跨窗口持久化:磁盘上仍有文件、奖励仍非零。检查方法是重新打开 checkpoint 的库、验证一条已知记录。
- 教师没返回 top-k:请求依然成功,但 OPD 梯度全零。缺字段必须抛错,并监控教师 token 覆盖率。
- 逐 chunk 映射缺失:fallback 把一个分数广播到所有 segment。缺映射必须抛错。
- 某个配置被硬编码调度表漏掉:磁盘上仍有合法产物。调度 manifest 必须与声明的 harness 集合对账。
- 用字符串规则给语义打分:聚合奖励看起来合理。语义条件属于裁判 rubric,不属于子串代码。
- 「读全部」悄悄分页:库条目数停在默认上限的平台上。分页与 token 记账必须单独测。
- 写入失败被 checkpoint 成空库却标记完成。平台故障必须可重试,并从分母中剔除。
- 沙箱共享了轨迹身份:请求挂到错误的 rollout 上仍返回成功。每个请求必须校验 bank 与轨迹身份。
- 格式错误的输出被当成环境错误:坏动作从训练里消失。策略错误应保留为低奖励的合法轨迹。
统辖规则:一个坏的策略动作必须拿到低奖励;一次平台故障绝不能被伪装成策略行为。
局限与下一步
除了上面未做的消融,报告承认:跨优化器步的信用被截断,更早库里的错误拿不到回溯梯度;one-vote 分组稳住了基线,但多调用 chunk 仍会携带更多 loss 质量;rubric 奖励降低了稀疏性,但仍需人工一致性与裁判敏感性审计;奖励产物覆盖 Chat / Working / Coding,却不覆盖所有长期记忆 workload;held-out 框架只有 EverMemOS 一个;多种子重复训练留待未来。
自己跑一遍
# 模型:vLLM(报告测试 v0.31.0)部署,served-model-name 必须是 hy-memory
vllm serve tencent/Hy-Memory-30B-A3B --served-model-name hy-memory
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
resp = client.chat.completions.create(
model="hy-memory",
messages=[
{"role": "system", "content": "Extract explicit user facts and preferences ... "
'Return only a JSON object with a "memories" list.'},
{"role": "user", "content": "My name is Alex. I live in Seattle ..."},
],
temperature=0.0, max_tokens=512,
extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}}, # 无思考模式
)# MemHub:npm bootstrap 之后显式安装 Runtime
npm i -g memhub-cli
memhub install && memhub serve # start / stop / status / doctor / uninstall对做 Agent 基础设施的团队来说,这次开源真正可复用的未必是那个 55.49 分,而是三件更朴素的东西:把写入器从「prompt 技巧」变成「可评测、可训练、可替换的模型能力」的方法论;一套按场景切分记忆形态、并用价值门槛与 diff 链控制库噪声的工程 schema;以及那份把九种静默失败写进论文的诚实。
来源:meng shao (@shao__meng) 的 X 推文(2026-10-16);Tencent-Hunyuan/Hy-Memory 仓库 README 与 docs;Hugging Face tencent/Hy-Memory-30B-A3B 模型卡;技术报告 arXiv:2610.22196;MemHub README。基准数字均出自官方技术报告的固定 20% 子样本,属自报成绩。
原文来源:X @shao__menghttps://x.com/shao__meng/status/2111082839068246301