PAPER DEEP DIVE
智能体世界动作模型(AW-0)
近期的世界动作模型为机器人操作提供了视觉前瞻与未来预测,但缺少显式的组合式技能复用机制。智能体机器人将基于代码的规划与推理同可复用技能相结合,却往往缺少对物理动力学的预测性支撑。我们提出 AW-0,一个将基于代码的规划与联合视频、动作预测相融合的智能体世界动作模型框架。我们在统一的混合 Transformer 架构中,将代码、未来视频与机器人动作作为三条耦合的生成流联合建模。该架构中的代码专家生成参数化技能例程与控制逻辑,视频专家与动作专家则生成未来视觉状态与底层运动指令。代码承担两种互补角色:它在世界模型内部组织多步预测与控制,并把技能表示为可供后续智能体执行复用的程序。我们进一步提出自动化整理流程,为机器人视频与人类视频轨迹标注对齐的程序,并将反复出现的例程整合为可复用技能库。在 RoboTwin 2.0 与真实双臂操作任务上的评估显示,该方法相较视觉-语言-动作模型与世界动作模型基线提升了任务表现,并在语言遵循、语义推理与鲁棒性方面取得增益,表明智能体代码能够在世界动作模型中连接规划、预测与执行。
论文元信息
标题:Agentic World Action Models(智能体世界动作模型,AW-0)
作者与单位:Zhuoyang Liu、Dantong Niu、Botong Zhang、Boning Shao、Jing Wang、Ruijie Zheng、Yuvan Sharma、Runyu Lu、Jiaming Liu、Renrui Zhang、Roei Herzig、Yutong Bai、Ken Goldberg、Danfei Xu、Yuke Zhu、Guanzhi Wang、Linxi “Jim” Fan、Trevor Darrell;加州大学伯克利分校、英伟达、宾夕法尼亚大学。前四位作者贡献相同,Yuke Zhu、Guanzhi Wang、Linxi Fan 与 Trevor Darrell 共同指导。
链接:arXiv:2610.30136v1 [cs.RO],2026 年 10 月 21 日;论文全文 https://arxiv.org/abs/2610.30136 ;项目页 https://agentic-wam.github.io/ ;代码 https://github.com/ZhuoyangLiu2005/agentic-wam ;预训练权重 https://huggingface.co/miniFranka/agentic-wam-pretrain-yamego3k-soup-e1 。
代码状态:官方仓库以 BSD 2-Clause 许可证发布,包含预训练、下游微调、真实机器人部署与 RoboTwin 2.0 评测代码。仓库说明写得很清楚:完整训练代码与一个预训练检查点已经公开,但预训练语料以及作为视频专家起点的 Cosmos-Predict2.5-2B 检查点不随仓库分发。因此从零复现完整预训练仍缺数据与初始权重,从已发布检查点开始做任务微调则具备可操作路径。
一句话总结
AW-0 把技能程序、未来视频与连续动作放进同一个混合 Transformer 中联合去噪:代码专家给出参数化技能计划,视频专家想象未来画面,动作专家输出动作块。它在 RoboTwin 2.0 的干净设置取得 80.8% 成功率,在 8 个真实双臂任务上平均评分 71.1%,比最强基线高 25.1 个百分点;混合执行又把随机化设置的成功率从 20.6% 提升到 29.2%,代价是干净设置降到 63.1%。
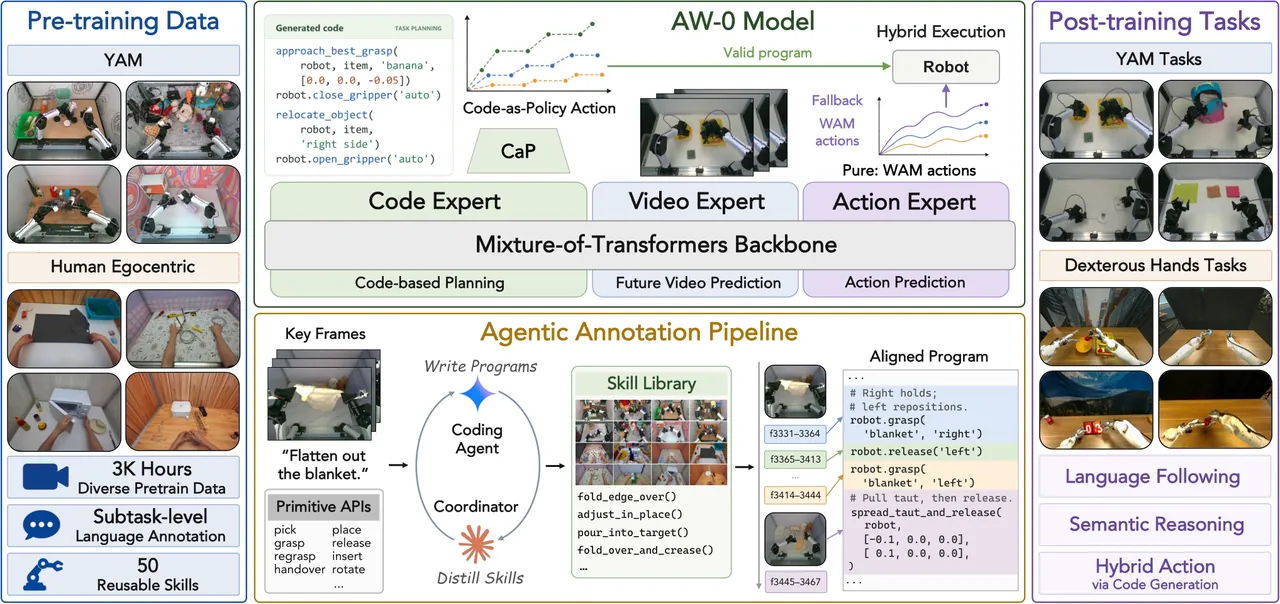
图 1:AW-0 总览(论文图 1)。模型把技能程序、未来视频与动作作为三条耦合流,在同一去噪循环中生成;程序既可以作为动作专家的规划条件,也可以在混合执行时被解释为可调用技能的代码。
研究背景与动机
机器人操作模型过去十年从任务专用的视觉运动策略,走到连接视觉、语言与动作的基础模型。与此同时,视频预测长期被当作学习世界演化的信号:先想象未来,再决定动作。世界动作模型把这两条线合在一起,用预测出的未来表征约束控制,让策略不只拟合当前观测到动作的映射,还要对物体运动、接触与低层动作后果作出预判。
但预测视频与动作块本身并不回答一个更长程的问题:一个多步骤任务应该如何拆解,应该调用哪些可复用技能,技能参数如何绑定到当前场景,多个子任务又如何接续。单纯的视频扩散模型可以生成看似合理的未来,却不一定把“先抓拉链、再拉开、最后把物体放进包内”这种技能结构显式写出来。参数规模越大,这个问题越突出:模型需要同时覆盖视觉动力学与技能组合,训练信号却只告诉它下一帧和下一段动作。
智能体机器人提供了互补的结构。程序化的执行框架可以选择技能与工具、把参数绑定到场景、跟踪进度并在观测变化时重规划。代码因此成为一种高密度、可组合、可检查的中间表示。可是传统代码智能体又常常缺少对真实物理动力学的预测性支撑:它知道该调用哪个技能,却不知道这个技能在接触丰富的场景里会把世界带向哪里。
AW-0 的出发点是让这两种能力在同一模型里互相约束。代码不再是外挂在策略外面的规划器,而是与视频、动作一起被去噪的生成流;视频专家与动作专家在每一层都能读到代码,代码专家也能看到当前多视角观测。这样,代码既组织多步预测,又保留为可复用程序,供后续智能体执行。论文的核心主张可以概括成一句:程序给世界模型提供语义骨架,世界模型给程序提供物理落地。
问题定义与预备知识
模型把技能程序表示成离散词元序列,把未来观测表示成预训练变分自编码器编码的连续视频潜变量,把机器人运动表示成一定时域内的动作块。三者分别记作程序、未来视频与动作,条件上下文由当前多视角观测、语言指令、机器人状态以及前序程序切片的紧凑记忆组成。联合生成目标因此是一个以场景与指令为条件、同时覆盖三种模态的概率模型:
$$\mathcal{C}_{t}=\{\mathcal{O}_{t},L,S_{t},M_{t}\},\qquad p_{\theta}(C_{0},Z_{0},A_{0}\mid\mathcal{C}_{t}).\tag{1}$$
动作块覆盖固定长度时域,论文下游实验默认取 32 步。机器人状态与动作被映射到一个跨本体共享的 64 维空间:每一侧包含 9 维末端位姿、22 维灵巧手关节角与 1 维平行夹爪开度,两侧相加正好 64 维。某个本体用不到的维度被置零且不做归一化,其余维度按逐维第 1 与第 99 百分位归一化。这样,YAM 的平行夹爪与 Tianji–Sharpa 的 22 自由度灵巧手就能共享同一套输入输出投影,尽管两者真正使用的自由度并不相同。
$$S_{t},A_{t}\in\mathbb{R}^{64},\qquad 64=2\times(9+22+1).\tag{2}$$
连续模态用流匹配建模。对视频与动作分别取一个噪声水平,把真实样本与高斯噪声做线性插值,模型回归从噪声指向数据的速度。噪声水平不是直接均匀采样,而是经过一个 shift 映射,把训练质量集中到高噪声区间;视频侧还额外使用来自预训练分布的 Beta 采样,以保留视频扩散模型原有的噪声课程。公式写成:
$$X_{\sigma_{m}}^{m}=(1-\sigma_{m})X_{0}^{m}+\sigma_{m}\epsilon_{m},\qquad \epsilon_{m}\sim\mathcal{N}(0,I),\qquad \sigma_{m}=\phi_{\gamma_{m}}(u_{m})=\frac{\gamma_{m}u_{m}}{1+(\gamma_{m}-1)u_{m}}.\tag{3}$$
代码侧使用离散吸收掩码。每个程序词元以概率 r 被替换成掩码词元,模型只在被掩码的位置上计算交叉熵。视觉前缀、指令与填充位置不参与程序损失;每个非空训练目标至少掩蔽一个程序词元,避免出现“没有监督信号”的退化批次。掩码过程可以写成:
$$\widetilde{c}_{i}=\begin{cases}[\mathrm{MASK}],& b_{i}=1,\\ c_{i},& b_{i}=0,\end{cases}\qquad b_{i}\sim\mathrm{Bernoulli}(r).\tag{4}$$
方法详解:三条生成流如何耦合
AW-0 的主干是三个模态专家的混合 Transformer。三个专家各自保留查询、键、值的投影、层归一化与前馈网络,但在每一层通过一次带掩码的联合注意力交换信息。每个专家内部是双向注意力,专家之间按代码、视频、动作的顺序做块状因果注意力:代码可以看到当前观测与指令,视频可以看到代码,动作可以看到代码与视频。论文的消融把顺序从“视频到动作”“视频到代码再到动作”改成“代码到视频再到动作”,性能随之变化,说明让视频生成读取代码不是可有可无的接线,而是语义计划真正进入未来预测的通道。
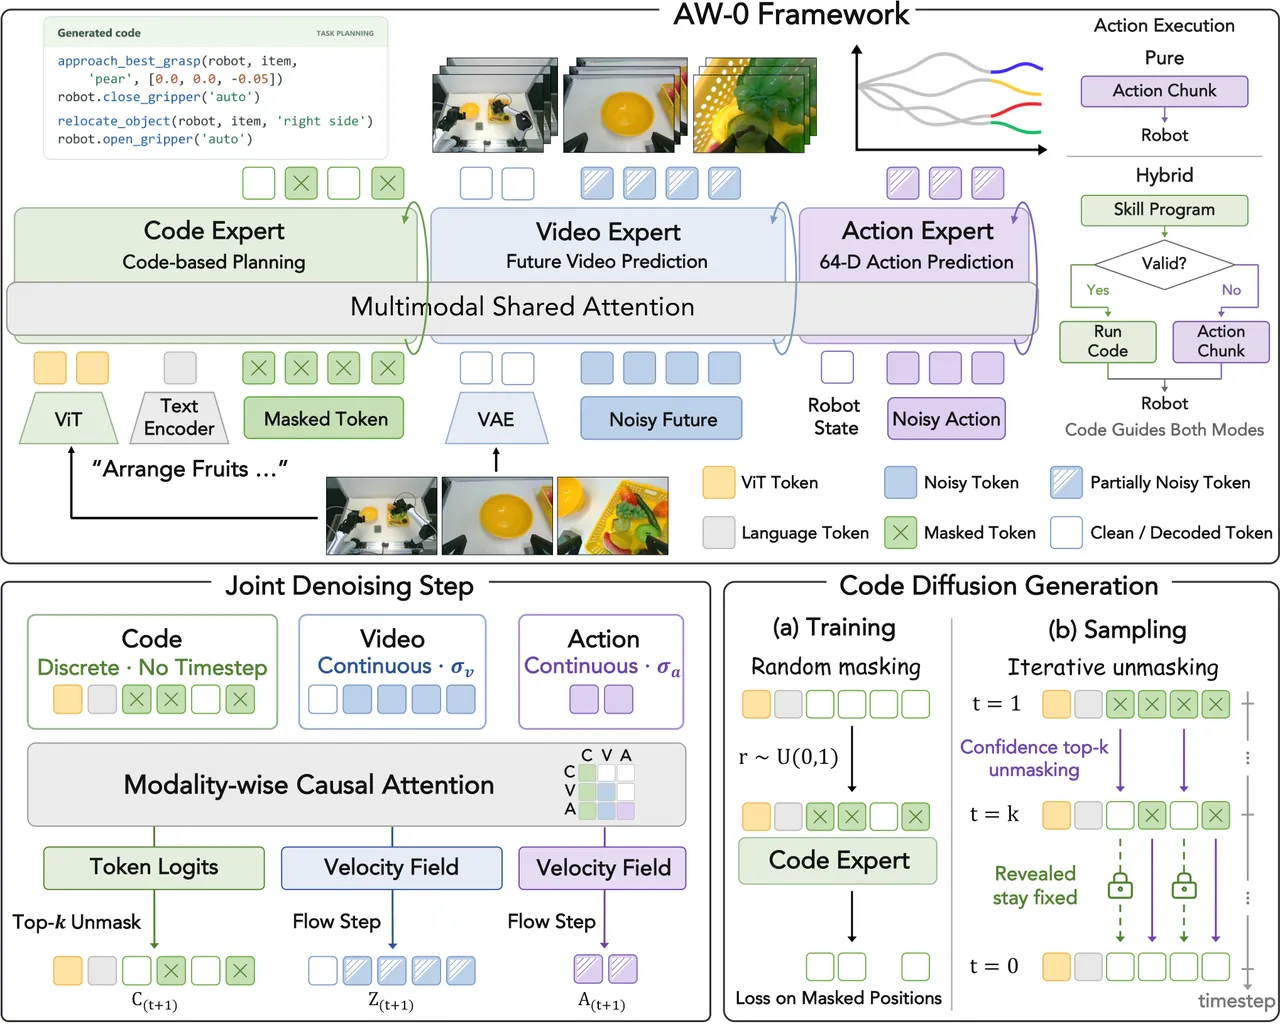
图 2:AW-0 框架(论文图 2)。代码专家从多视角观测与指令生成技能程序;视频专家以 Cosmos-Predict2.5 为起点预测未来潜变量;动作专家输出连续动作块。三者在 28 层中逐层联合注意力,顺序为代码、视频、动作。
三个专家都是 28 层,查询、键、值被投影到共同的 2048 维注意力空间,每层 16 个注意力头、每头宽度 128。代码专家以 SDAR-1.7B 为主体,冻结其词元嵌入、层归一化、前馈网络与词表输出头,只训练混合注意力投影与调制参数;视觉侧使用冻结的 Qwen3-VL-2B 视觉塔,再加一个可训练的投影合并层。视频专家从 Cosmos-Predict2.5-2B 的 DiT 初始化,替换成冻结的 Wan2.2 变分自编码器,该编码器有 48 个潜变量通道;由于通道数变化,视频 DiT 的输入输出投影需要重新初始化。动作专家是一个独立的动作 DiT,从零初始化,并额外接收机器人状态条件。
观测侧每个视角在 224×320 分辨率下经过空间合并得到 70 个视觉词元,三个视角共 210 个前缀词元。训练时给指令与程序共 512 个词元的预算,视觉前缀单独追加;推理时程序画布默认 128 个词元。视频侧在 0 到 32 的时间偏移上取 9 帧,只用第一帧作为观测条件,其余帧是预测目标。这个设计把“看见当前”和“想象未来”分开:当前帧干净地进入条件,未来帧从噪声开始去噪。
代码专家还维护一份前序程序切片的记忆。单个观测往往不足以判断任务进度,于是历史切片被压缩成 32 个可学习记忆槽,作为前缀词元读回代码流。训练时缓冲里放前序标注切片,并以一定概率替换成模型自己的预测;推理时每个回合重置,随着每个解码切片增长。记忆不是一个外挂的文本摘要,而是与代码词元一起参与注意力的连续表示。官方配置里这套记忆默认关闭,这一点在复现代码时需要单独打开。
联合去噪的每一步,三个专家同时输出代码 logits、视频速度与动作速度。代码流为视频与动作提供规划上下文,动作专家又读取视频表征,因此三种模态在整个迭代过程中共同演化,而不是先生成代码、再冻结代码去生成视频、最后生成动作。代码画布的揭晓采用置信度排序:每一步提交当前最确定的若干掩码位置,直到整个画布完成。这个解码顺序与训练时的随机掩码分布一致,避免了自回归模型在训练时看真前缀、推理时看自己生成前缀的暴露偏差。
训练目标需要同时平衡视频生成与预测指导。视频噪声从预训练分布与均匀分布的混合中采样,再用重要性权重把每个目标拉回自己的分布:视频项用预训练密度权重,动作与代码项用均匀参考权重。权重裁剪后按批归一化到单位均值,避免某个模态的损失尺度压倒其它模态。写成期望形式:
$$u_{v}\sim q(u)=\alpha p_{\mathrm{pre}}(u)+(1-\alpha)p_{\mathrm{ref}}(u),\qquad p_{\mathrm{ref}}=U(0,1).\tag{5}$$
$$w_{v}(u)=\frac{p_{\mathrm{pre}}(u)}{q(u)},\qquad w_{g}(u)=\frac{p_{\mathrm{ref}}(u)}{q(u)},\qquad \mathcal{L}=\mathbb{E}_{u_{v}\sim q}\!\left[\lambda_{v}\bar{w}_{v}\ell_{v}+\bar{w}_{g}(\lambda_{a}\ell_{a}+\lambda_{c}\ell_{c})\right].\tag{6}$$
论文取混合系数 0.5,视频、代码、动作的损失权重分别为 1、0.5、1,视频与动作的 shift 都取 5。这个权重安排把代码放在辅助位置:它不追求在像素层面压过视频,而是用较低权重提供稳定的语义条件。消融显示,去掉代码后推理延迟从 0.23 秒降到 0.19 秒,只省 0.04 秒,却让 8 个真实任务全部变差,说明代码流的收益不是用更多计算换来的边际提升。
下面的流程图把一次重规划中的真实数据流画出来。它强调两个容易在阅读论文时混淆的点:代码在默认模式下只是符号计划,不直接执行;只有混合执行才会把代码送进解释器,并由仲裁器决定是否接管当前阶段。
flowchart TD
    O["多视角观测 O_t"] --> CTX["条件上下文
观测 指令 状态 记忆"]
    L["语言指令 L"] --> CTX
    S["机器人状态 S_t"] --> CTX
    M["程序记忆 M_t"] --> CTX
    CTX --> C["代码专家
掩码离散扩散"]
    C --> C0["技能程序 C_0
参数化技能调用"]
    C0 --> V["视频专家
未来视频潜变量 Z_0"]
    C0 --> A["动作专家
动作块 A_0"]
    V --> A
    C0 --> D{"是否混合执行"}
    D -->|否| A
    D -->|是| G["阶段 依赖 语法 白名单 非空 门控"]
    G -->|通过| E["解释器执行代码切片"]
    G -->|拒绝| A
    E --> R["环境观测与下一次重规划"]
    A --> R
自动标注与技能库
方法要成立,前提是训练数据里有与视频轨迹时间对齐的程序。论文没有手工写这些程序,而是搭了一条三阶段的自动标注管线。第一阶段每个任务抽一个回合,让 Gemini 3.1 Pro 依据只声明不实现的底层接口写子任务级技能程序;Claude Code 运行 Claude Opus 4.8 充当协调者,把反复出现、跨任务通用的片段提炼成技能。第二阶段冻结技能库,用最终词表重新标注抽样回合,形成“子任务到程序”的缓存。第三阶段标注剩余语料:如果当前子任务的接触与运动证据和缓存条目匹配,就直接复用;否则让编码智能体生成新标注并写回缓存。
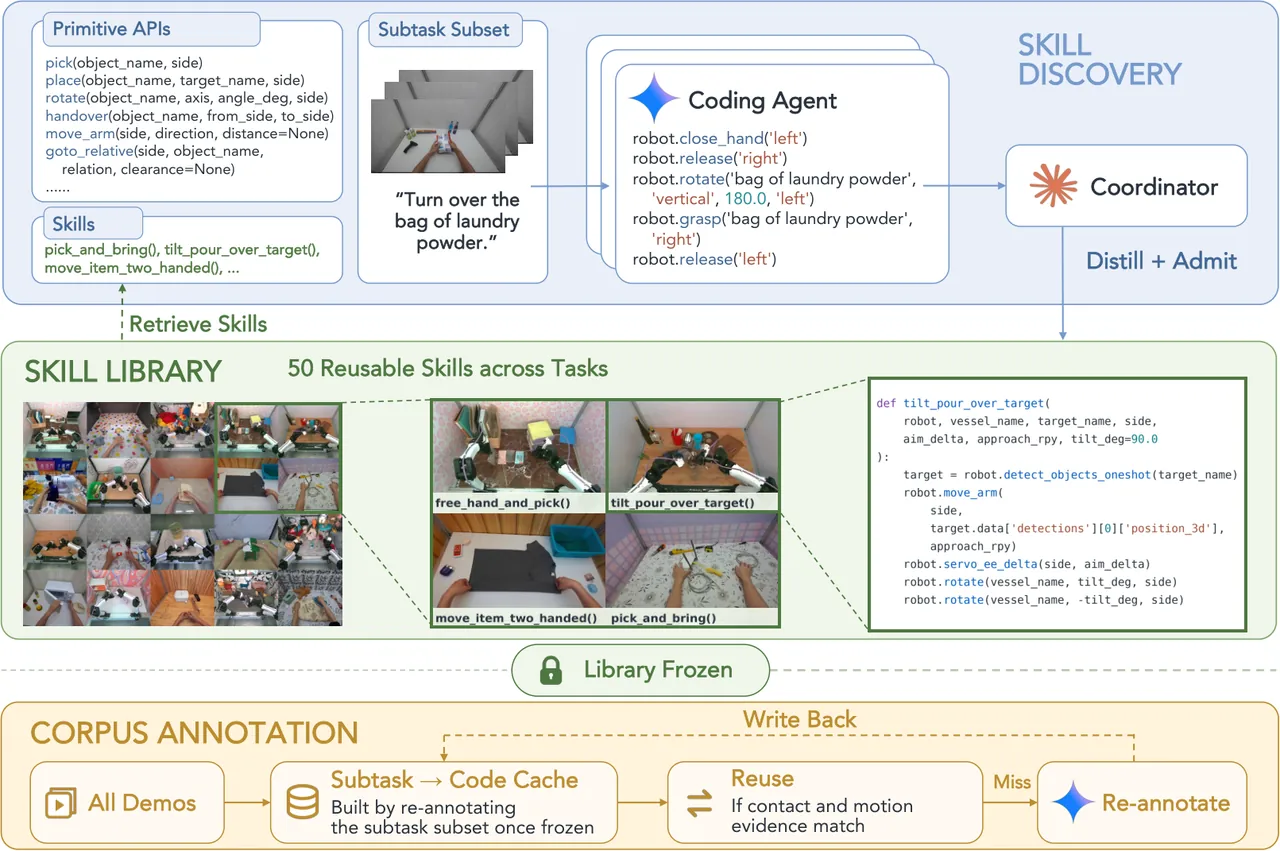
图 3:自动标注管线(论文图 3)。编码智能体按预定义底层接口写子任务程序,协调者把重复模式提炼为技能;技能库冻结后,缓存按接触与运动证据匹配复用,未命中才生成新标注。
最终得到 50 个技能条目,其中 23 个面向 YAM 平行夹爪,27 个面向第一视角人类演示。技能不是“抓取”“放置”这类泛化动词,而是带接触语义的具体例程:例如沿拉链缝拉动、双手交替拍平织物、用棘轮动作拧开螺纹件、把长物体从袋口一步步抽出来。每个底层接口声明它会产生哪些接触事件,程序因此能和演示中的接触证据对齐,而不是只靠视频帧的视觉相似度。
预训练语料由两个真实数据源组成。YAM 部分有 73,101 个回合、1,919.3 小时、279 个任务,每个回合平均 13.5 个程序切片;第一视角人类部分有 175,541 个回合、993.9 小时、327 个任务,每个回合平均 6.2 个切片。两者合计 248,642 个回合、2,913.2 小时、606 个任务、2,075,373 个切片。人类数据只有单个头戴相机,训练时把同一视角复制到三个输入槽;手部运动被重定向成每只手 22 维的关节目标。
| 数据源 | 回合数 | 时长(小时) | 任务数 | 程序切片数 | 每回合切片 |
|---|---|---|---|---|---|
| YAM 机器人 | 73,101 | 1,919.30 | 279 | 986,314 | 13.5 |
| 第一视角人类 | 175,541 | 993.91 | 327 | 1,089,059 | 6.2 |
| 合计 | 248,642 | 2,913.22 | 606 | 2,075,373 | 8.3 |
表 1:预训练语料统计(论文表 7)。切片是带时间对齐的程序单元,不是视频帧;YAM 的切片密度约为人类数据的 2.2 倍,反映了机器人演示中更细的子任务划分。
训练配方与实现细节
预训练先在大规模 YAM 与人类数据上学习统一生成先验,再对每个下游任务用 100 条演示做 20 个 epoch 的联合微调。真实机器人任务沿用同一套优化器、预热与混合精度设置,但批大小与学习率按任务调整:YAM 配置每卡批大小 4、梯度累积 1、学习率 10⁻⁴、权重衰减 10⁻²;RoboTwin 配置使用两个八卡节点,每卡批大小 6,等效批大小 96,学习率 2×10⁻⁴,权重衰减 10⁻²,训练 100,000 个优化步。下游微调会迁移形状兼容的预训练参数,并在本体维度变化时重新初始化动作与状态投影。
RoboTwin 2.0 的训练数据是 50 个任务、每任务 50 条干净演示,共 2,500 个回合;每个任务做 50 次 rollout,报告干净与随机化两种设置的平均成功率。随机化覆盖背景与桌面纹理、光照、桌面高度与干扰物。真实世界评测使用 8 个任务,YAM 与 Tianji–Sharpa 各 4 个;每个任务 100 条演示用于微调,评测时每个任务做 3 个训练种子 × 16 次 rollout,初始物体位姿随机,评分使用按子步骤给部分分的加性评分表。
两个真实平台各有三路 RGB 输入:头部或顶部相机看桌面,左右腕部相机看局部操作。YAM 是固定底座的双 6 自由度机械臂加平行夹爪,用主从臂遥操作采集,扳机控制夹爪开合;Tianji–Sharpa 是 Tianji 人形躯干加两只 22 自由度 Sharpa 灵巧手,用 Manus 手套与 PICO 追踪器采集腕部位姿,手指动作重定向到 22 维关节目标。AW-0 在两个平台上都使用同一套 64 维状态动作表示,但 YAM 预测相对末端位姿加绝对夹爪目标,Tianji–Sharpa 预测相对末端位姿加绝对手指关节目标。
实验结果
RoboTwin 2.0 的主结果呈现出清晰的分裂:AW-0 默认模式在干净设置达到 80.8%,比最强基线 WLA 的 64.8% 高 16.0 个百分点;随机化设置掉到 20.6%,低于 π0.5 的 27.7%,但仍高于 DreamZero 的 17.6%。混合模式把随机化设置提升到 29.2%,同时把干净设置拉到 63.1%。两种模式的平均分别是 50.7% 与 46.2%,说明默认模式更适合受控环境,混合模式更适合视觉分布偏移明显的环境。
| 方法 | 干净设置成功率(%) | 随机化设置成功率(%) | 平均(%) |
|---|---|---|---|
| π0.5 | 54.9 | 27.7 | 41.3 |
| DreamZero | 33.6 | 17.6 | 25.6 |
| EgoScale | 26.2 | 2.9 | 14.5 |
| WLA | 64.8 | 3.6 | 34.2 |
| AW-0 默认 | 80.8 | 20.6 | 50.7 |
| AW-0 混合 | 63.1 | 29.2 | 46.2 |
表 2:RoboTwin 2.0 主结果(论文表 1)。50 个任务,每任务 50 次 rollout;混合模式使用单独采集的代码即策略演示,因此比较的是两套完整配置,而不是只切换执行方式。
真实世界的 8 个任务跨度很大:YAM 上要整理水果、装背包、换灯泡、叠毛巾;Tianji–Sharpa 上要用夹子取水果、发牌、翻记分牌、解魔方。AW-0 的平均评分是 71.1%,最强基线 DreamZero 是 46.0%,差距 25.1 个百分点。优势最大的任务是需要语义选择的“整理水果”(91.7% 对 70.8%)和需要精细双手协调的“解魔方”(72.1% 对 52.3%);需要工具使用的“用夹子取水果”从 π0.5 的 7.3% 提升到 54.2%,说明代码流提供的技能结构对工具类任务尤其有效。
| 方法 | 整理水果 | 装背包 | 换灯泡 | 叠毛巾 | 夹子取水果 | 发牌 | 翻记分牌 | 解魔方 | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| π0.5 | 70.8 | 49.7 | 63.8 | 81.7 | 7.3 | 13.1 | 26.3 | 36.1 | 43.6 |
| DreamZero | 53.3 | 36.7 | 67.4 | 79.8 | 22.6 | 37.1 | 28.4 | 42.5 | 46.0 |
| EgoScale | 37.5 | 27.3 | 60.2 | 53.3 | 17.6 | 25.6 | 40.8 | 24.9 | 35.9 |
| WLA | 39.6 | 29.6 | 56.0 | 74.6 | 14.2 | 22.9 | 29.7 | 52.3 | 39.9 |
| AW-0 | 91.7 | 64.6 | 75.0 | 84.4 | 54.2 | 58.3 | 68.8 | 72.1 | 71.1 |
表 3:真实世界 8 任务评分(论文表 2)。每个任务 3 个训练种子 × 16 次 rollout,按子步骤加性评分;前四列是 YAM 平行夹爪,后四列是 Tianji–Sharpa 灵巧手。
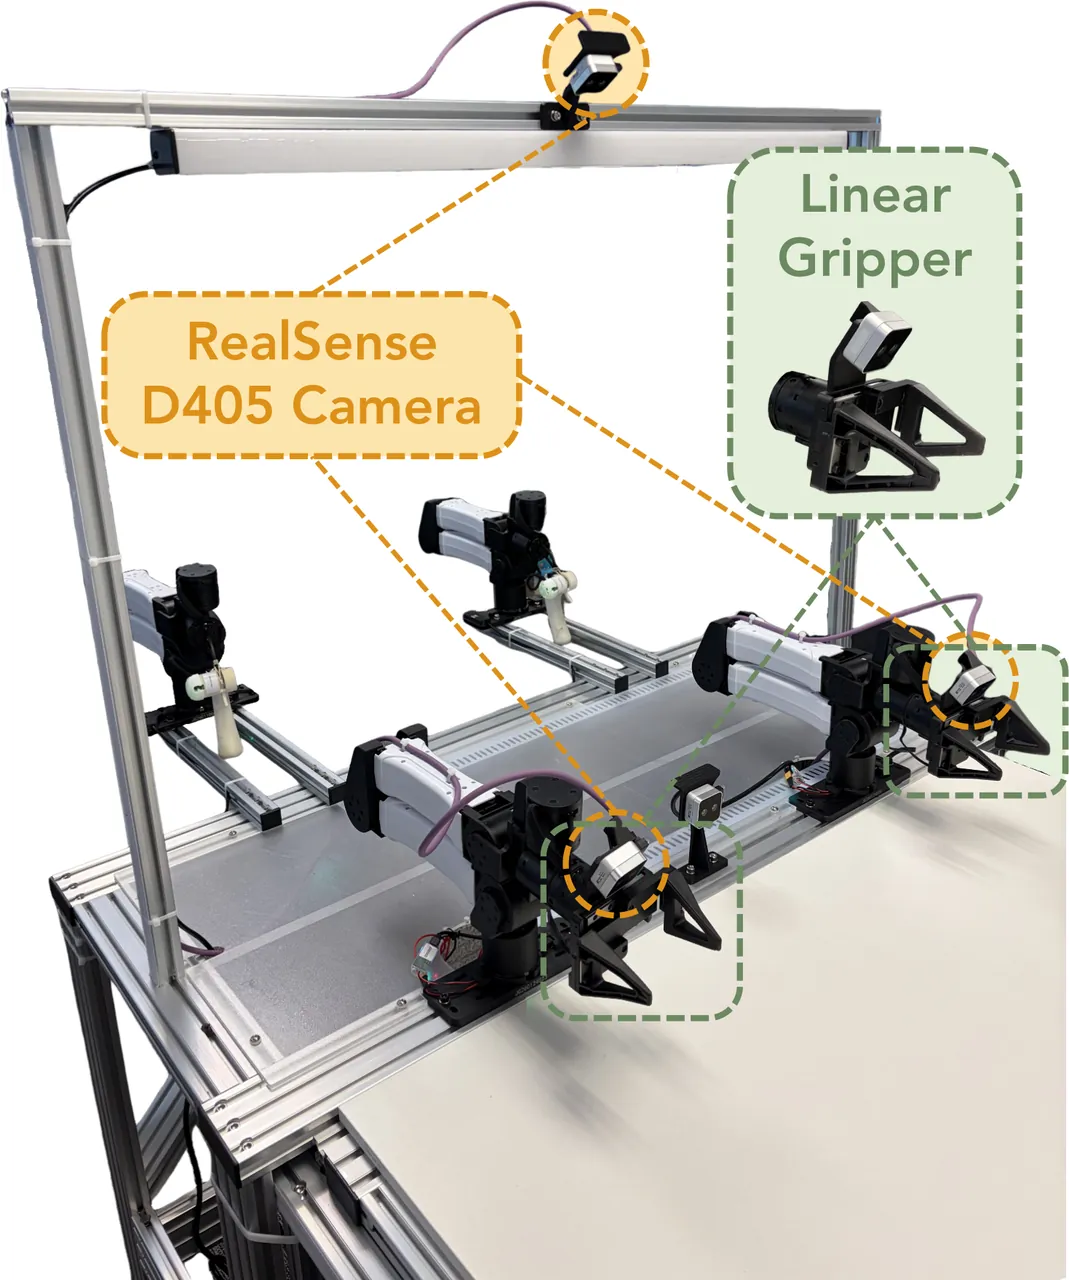
图 4:YAM 平台(论文图 20a)。固定底座双 6 自由度机械臂加平行夹爪,顶部一台 RealSense D405 与每腕各一台相机;底部相机不参与策略输入。
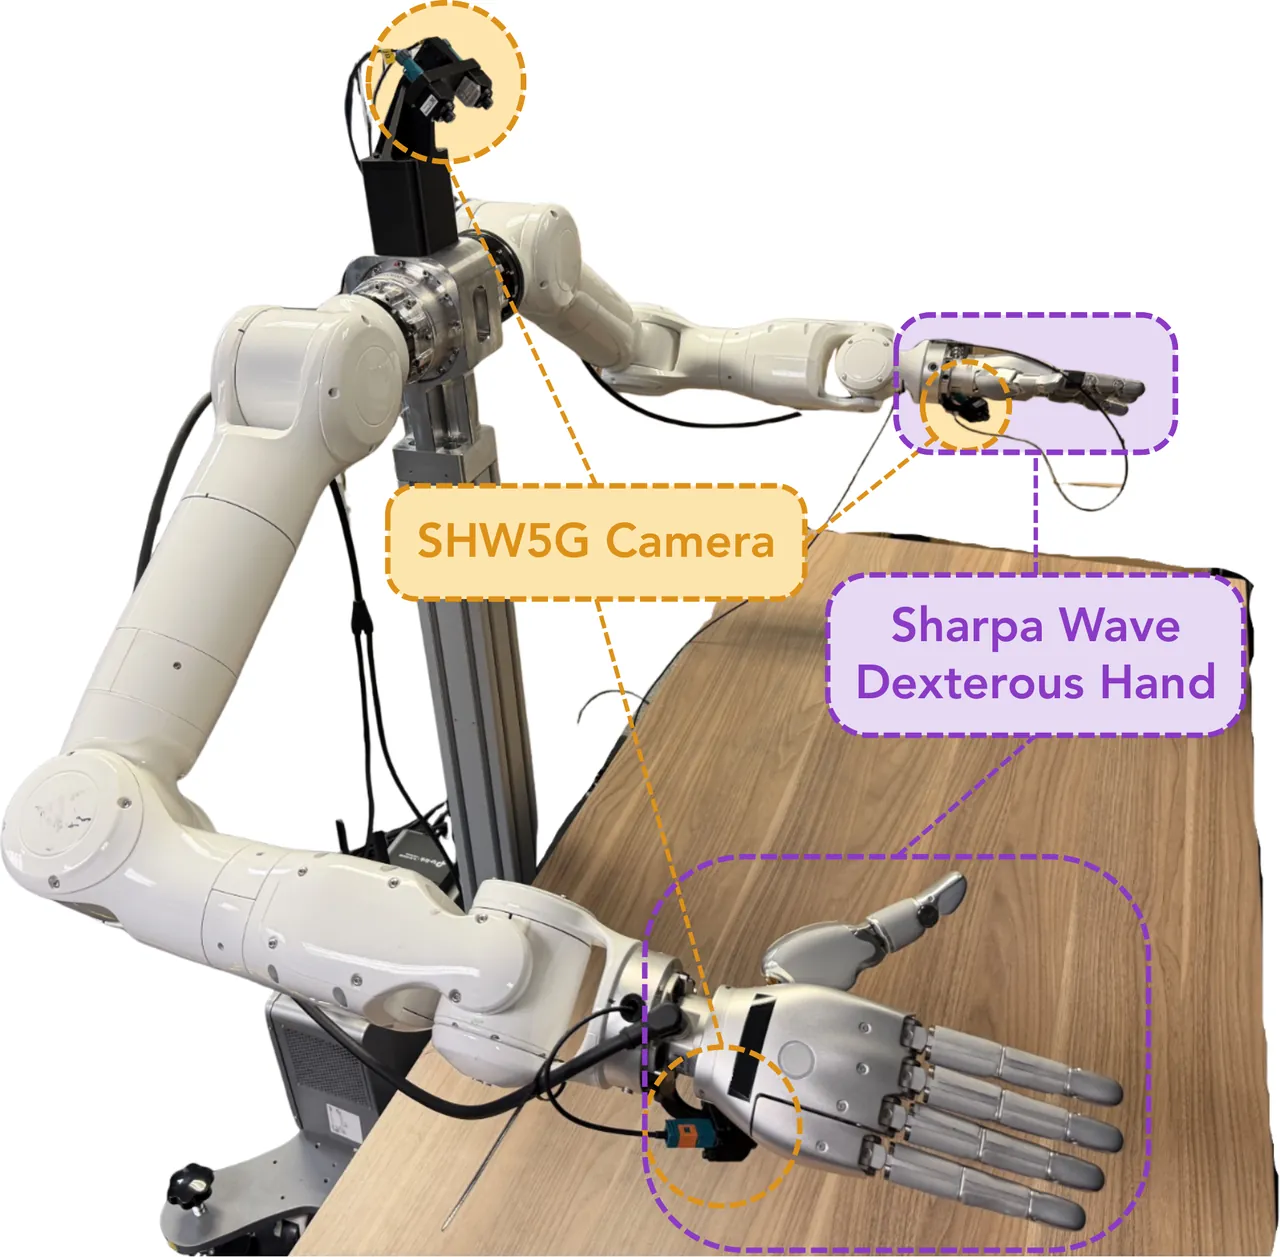
图 5:Tianji–Sharpa 平台(论文图 20b)。Tianji 躯干带两只 22 自由度 Sharpa Wave 灵巧手,头部一台 SHW5G 相机与每腕各一台相机。
代码如何进入预测:定性证据
论文用两组未来帧对比说明代码不是只影响动作头。第一组指令是“整理水果,使左碗里最后只剩芒果”。在相同场景与相近初始观测下,AW-0 的预测把交互指向芒果;用自然语言子目标替代代码的变体在苹果与芒果之间摇摆;去掉代码流的模型直接指向苹果。三者都没有看到最终答案,差别来自条件表示:技能调用里的对象参数把语言里的“只剩芒果”落成了具体的操作对象。
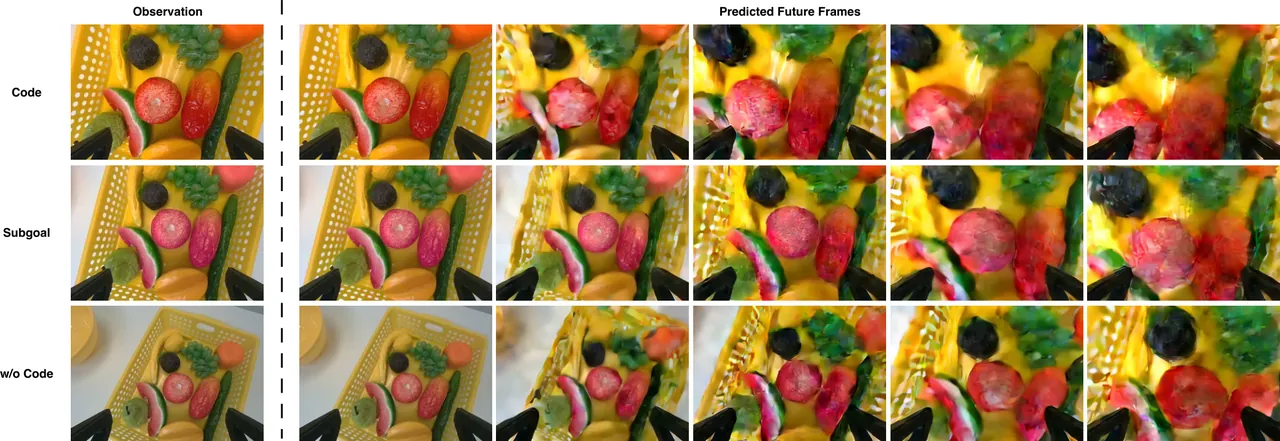
图 6:整理水果任务的未来帧预测(论文图 33)。同一行从左到右是预测时间推进;AW-0 的对象选择与指令一致,语言子目标与无代码变体出现目标歧义或错误。
第二组是发牌任务里把牌插入窄槽的最后阶段。这个动作要求手、牌与插槽的相对位姿同时对齐,任何轻微偏移都会让牌卡在槽口。AW-0 预测出的牌更稳定地对准并进入槽口;语言子目标与无代码变体在手指与牌的接触区域出现模糊和形变,插入轨迹也不连贯。作者据此认为,显式技能调用与对象参数让视频专家更容易预测“手应该把牌带到哪里”,从而给动作专家提供更可靠的预测表征。
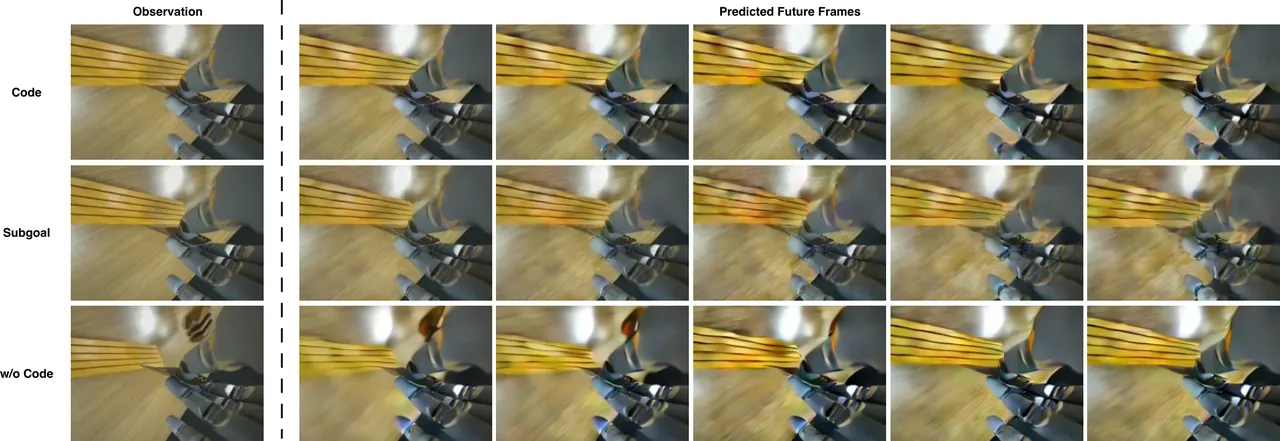
图 7:发牌任务的精细插入预测(论文图 34)。AW-0 的牌与槽口对齐更稳定,两个对照变体在接触区域出现模糊与不连贯的插入序列。
混合执行:代码与动作块如何分工
默认模式下,代码只是一份符号计划,动作块才是真正驱动机器人的输出。混合模式把代码送进解释器:每次重规划,策略同时返回一个动作块与一个代码切片;仲裁器先看代码切片的阶段是否未完成、是否不低于已尝试阶段、失败次数是否未超上限,再看它读取的变量是否都在共享命名空间中定义,最后检查语法、白名单与非空性。只有全部门控通过,代码才接管当前阶段;一旦尝试执行,同一次前向产出的动作块就被丢弃,即使代码抛异常也不例外,下一轮重新观测再规划。
论文强调检查的是“未经修复的原始切片”。这一点在官方代码里有出入:仓库的仲裁器在门控前调用修复函数,修复失败后还会尝试基于最近邻的修复路径,然后重新做白名单检查。也就是说,论文描述的“原样检查”与发布代码的“先修再查”不是同一套流程。两者都可能合理,但复现论文数字时必须明确用的是哪一版,否则混合模式的成功率不能直接对比。
混合执行的效果有明显的环境依赖。干净设置里动作专家本身已经很强,代码通道接管反而把成功率从 80.8% 拉到 63.1%;随机化设置里动作专家退化到 20.6%,代码通道在成功回合中承担了 35.0% 的仿真步,把成功率抬到 29.2%。把所有回合计入时,代码只占干净设置 8.5%、随机化设置 5.6% 的步数,因为失败回合会跑满步数上限,且几乎都由动作通道驱动,把分母拉得很大。这个统计口径很重要:不能把“成功回合中代码占 35%”误读成“所有回合中代码占 35%”。
| 设置 | 回合集合 | 代码执行步数占比 | 直接动作步数占比 | 每回合步数 |
|---|---|---|---|---|
| 干净 | 全部 | 8.5% | 91.5% | 26,720 |
| 干净 | 成功 | 14.5% | 85.5% | 11,549 |
| 干净 | 失败 | 6.3% | 93.7% | 52,687 |
| 随机化 | 全部 | 5.6% | 94.4% | 41,716 |
| 随机化 | 成功 | 35.0% | 65.0% | 8,400 |
| 随机化 | 失败 | 3.7% | 96.3% | 55,483 |
表 4:混合执行中两个控制通道的仿真步数占比(论文表 12)。成功回合里代码承担更多物理时间,失败回合几乎全部由直接动作跑满步数上限。
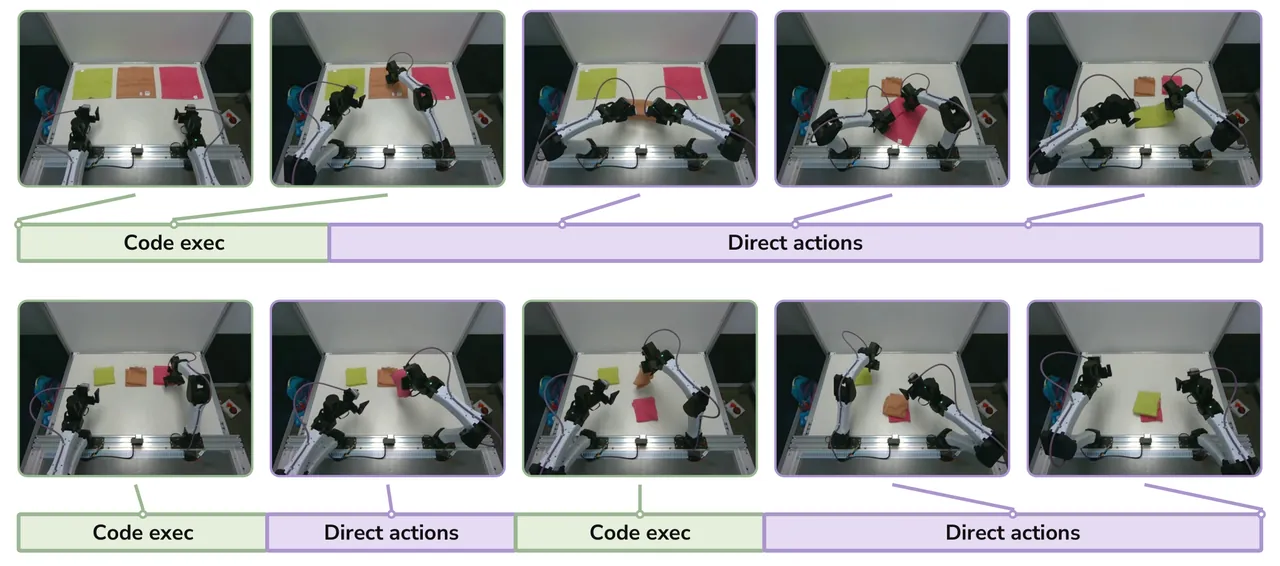
图 8:真实叠毛巾任务的混合执行(论文图 35)。绿色片段由代码执行,紫色片段由动作专家直接输出;叠、压等灵巧动作主要依赖直接动作,接近与堆叠等结构化动作更多由代码接管。
真实世界的混合实验只在 YAM 的叠毛巾任务上做,混合执行得 90.6%,动作块执行为 84.4%。这个提升不能单独归因于“代码更强”:混合配置与默认配置使用了不同的演示采集管线,默认用 RoboTwin 原生运动规划器采集,混合用代码即策略程序采集,因为后者天然带有可执行的对齐程序。论文在附录里明确承认,这个比较评估的是两套完整配置,而不是把执行方式单独隔离出来。因此 90.6% 对 84.4% 应该读作“混合配置在这项任务上更好”,不能读作“同一模型只切换执行方式就提升 6.2 个点”。
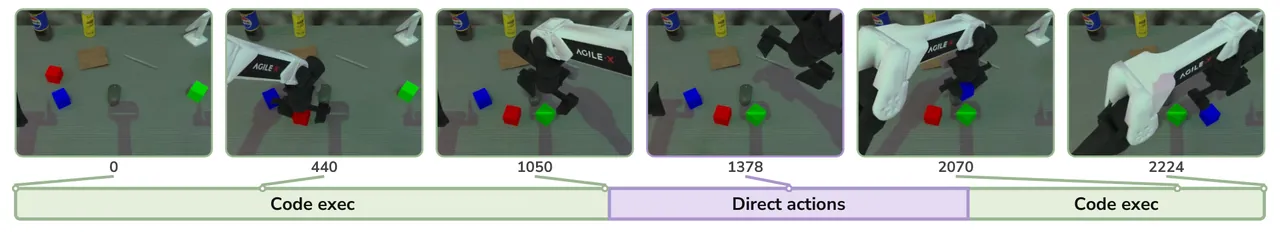
图 9:RoboTwin 混合执行的两个典型回合(论文图 37)。上例积木排序几乎全程由代码完成;下例双瓶抓取中代码完成定位与接近,但抓取不稳定,动作专家接管后完成抓取,代码再恢复执行。
代码生成质量与消融
代码专家的语法能力明显强于语义能力。预训练检查点在验证集上的教师强制损失是 0.535,教师强制词元准确率 0.897,自由生成的可解析率 0.875;但实体 F1 只有 0.534,底层接口名 F1 只有 0.365,技能调用率 0.292。把视觉观测在样本间打乱会让代码损失上升 1.774,说明预测确实依赖视觉上下文,不是只靠语言先验背模板。把这些数字放在一起看:模型大概率能写出“看起来像程序”的东西,但对象名、参数与接口选择仍经常错。
| 指标 | 数值 | 含义 |
|---|---|---|
| 教师强制损失 | 0.535 | 给定真前缀时的词元交叉熵 |
| 教师强制准确率 | 0.897 | 给定真前缀时的词元命中率 |
| 视觉打乱后的损失增量 | 1.774 | 越大表示代码越依赖视觉条件 |
| 自由生成可解析率 | 0.875 | 生成结果能被解析为合法程序的比例 |
| 实体 F1 | 0.534 | 引号内对象名与参考程序的重叠 |
| 底层接口 F1 | 0.365 | 机器人接口名与参考程序的重叠 |
| 技能调用率 | 0.292 | 生成程序中出现技能式辅助调用的比例 |
表 5:预训练代码专家的验证指标(论文表 10)。高语法合法性与低语义 F1 并存,说明“能解析”不等于“能执行正确”。
定性例子把这种差距具体化。YAM 的“用布擦键盘”验证样本里,模型正确调用了擦洗技能,保留了对象参数、手臂分配与循环结构,但位移参数多写了两个元素;Tianji–Sharpa 的“解魔方”在线部署里,模型正确选择了按住魔方的技能、对象与手别,却把注释写坏,导致原始输出无法直接执行。这些错误不是语法层面的小瑕疵,而是“技能选对了、参数或格式错了”的典型失败,正好解释了为什么默认模式只把代码当条件,而不直接执行。
消融从三个方向拆解收益。视觉条件方面,代码专家用 ViT 特征时 8 个任务平均 71.1%,换成视频 VAE 特征后掉到 55.6%;装背包从 64.6% 降到 39.6%,解魔方从 72.1% 降到 53.9%。VAE 特征为像素重建优化,保留了纹理与颜色,却不利于区分“该抓拉链还是该抓包身”这类语义差异;ViT 特征更适合技能选择。生成范式方面,联合去噪平均 71.1%,自回归只有 54.5%,8 个任务里赢 7 个,唯一例外是换灯泡(75.0% 对 79.2%)。联合去噪把端到端延迟从 0.55 秒降到 0.23 秒,提速 2.39 倍,说明它不是用更多迭代换质量。
| 消融维度 | 配置 | 8 任务平均评分(%) | 备注 |
|---|---|---|---|
| 代码视觉条件 | ViT 特征 | 71.1 | 论文默认 |
| 代码视觉条件 | VAE 特征 | 55.6 | 装背包与解魔方跌幅最大 |
| 代码生成范式 | 联合去噪 | 71.1 | 延迟 0.23 秒 |
| 代码生成范式 | 自回归 | 54.5 | 延迟 0.55 秒,慢 2.39 倍 |
| 规划内容 | 完整程序 | 优于无注释、无技能与自然语言子目标 | 8 个任务中 7 个胜出 |
| 规划内容 | 去掉技能调用 | 发牌从 58.3 降到 42.0 | 技能抽象本身有独立贡献 |
表 6:关键消融(论文表 3、表 4 与图 7)。注意力顺序的实验进一步显示“代码到视频再到动作”优于“视频到动作”和“视频到代码再到动作”,但论文没有给出三种顺序的完整平均值。
规划内容的三组对比也值得展开。完整程序在 8 个共享任务上都优于去掉注释的代码,说明解释性文字帮助模型把程序结构与任务意图连起来;去掉技能调用后所有任务都下降,发牌从 58.3% 掉到 42.0%,说明“技能”不是底层接口的语法糖,而是把一段接触时序压缩成一个可复用单元;完整程序在 7 个任务上优于自然语言子目标,说明结构化的对象参数与调用顺序比一句“先做这个再做那个”更能约束动作生成。
代码可用性与复现边界
官方仓库的结构与论文方法基本一一对应。`src/agenticwam/models/cosmos_mot/generic_mot.py` 的 `GenericMoT.forward()` 在每一层把所有专家的查询、键、值拼接起来做一次带掩码的联合注意力,再把结果切回各专家;`agenticwam_model.py` 实现三模态联合去噪、代码置信度揭晓与联合推理;`models/experts/code_expert.py` 支持 `joint`、`blockdiff` 与 `ar` 三种代码目标,默认是 LLaDA 式全局掩码;`models/experts/code_memory.py` 实现带置信度门控的循环记忆;`robotwin/hybrid_eval/arbiter.py` 实现混合执行的阶段、依赖、语法、白名单与非空门控。这些文件让“论文里的架构”不只是论文里的方块图。
可复现的起点是 Hugging Face 上的预训练检查点,仓库说明它包含 YAM 与第一视角人类混合数据训练一个 epoch 后的全部训练权重。冻结的公共组件从各自发布页加载:Wan2.2 视频变分自编码器、Cosmos-Reason1 指令编码器、SDAR-1.7B 代码主体与 Qwen3-VL-2B 视觉塔。仓库支持 YAM、Tianji–Sharpa 与 RoboTwin 三条下游路径,也提供从 LeRobot 分片、64 维统计量、指令嵌入到预检、训练、部署的完整脚本。
复现边界同样清楚。预训练语料不公开,Cosmos-Predict2.5-2B 的起始检查点不公开,因此无法从零重跑论文的 2,913 小时预训练;能重跑的是从已发布检查点开始的任务微调、RoboTwin 训练与混合评测。代码里还有两处与论文叙述不完全一致:仲裁器在门控前做修复,而论文附录说检查原始切片;模型配置里 `code_memory` 默认关闭,而论文把 32 槽记忆写成方法的一部分。这两点不会让代码不可用,但会让“照默认配置跑出来的结果”和“论文描述的算法”之间存在解释空间,做复现实验时应该把配置差异写进实验记录。
许可证是 BSD 2-Clause,允许商用与修改,但公共模型组件各自保留原许可证。仓库最后一次提交在 2026 年 10 月 22 日,紧接论文发布,说明代码与论文是同一轮工作流产出的;README 里仍留着“待补 arXiv 链接”的注释,也说明工程发布早于论文索引完全同步。对读者而言,最实用的入口不是从零训练,而是用预训练检查点复现一个真实任务的后训练,再把代码专家单独拿出来评估程序质量。
局限与失败模式
第一类局限来自程序落地。代码流从自动标注的演示与人工策展的技能库学习,规划质量受标注准确率与技能覆盖范围限制。模型可以选对技能却写错参数,语法合法不等于执行正确;当任务需要技能库之外的接触模式时,模型只能在已有技能里勉强组合。论文提出的改进方向是用执行反馈反过来改程序与技能库,但当前系统没有在线学习,失败不会自动变成新的训练信号。
第二类局限来自预测鲁棒性。结构化规划提升了世界动作模型的平均表现,却没有消除对视觉分布偏移的敏感。RoboTwin 随机化设置下默认模式从 80.8% 掉到 20.6%,说明代码提供的语义骨架不能替代像素级未来预测的泛化。混合执行用代码通道补上了一部分鲁棒性,但它的收益依赖底层感知与控制原语是否可靠,也依赖仲裁器是否能判断“这段代码比动作块更可能成功”。当前仲裁只看有效性,不预测相对收益,所以在干净设置里会错误接管,反而拉低成功率。
第三类局限来自评测范围。真实世界的混合执行只在 YAM 的叠毛巾任务上做,因为灵巧手平台还没有对应的代码即策略系统;8 个真实任务虽然覆盖两种本体,但每个任务只有 100 条演示、48 次评测 rollout,任务数量与场景多样性仍然有限。论文也承认没有在线学习,系统不会在部署中持续改技能库或改仲裁策略。这些限制不影响“代码可以作为世界动作模型的规划接口”这一核心证据,但决定了它离长期自主智能体还有距离。
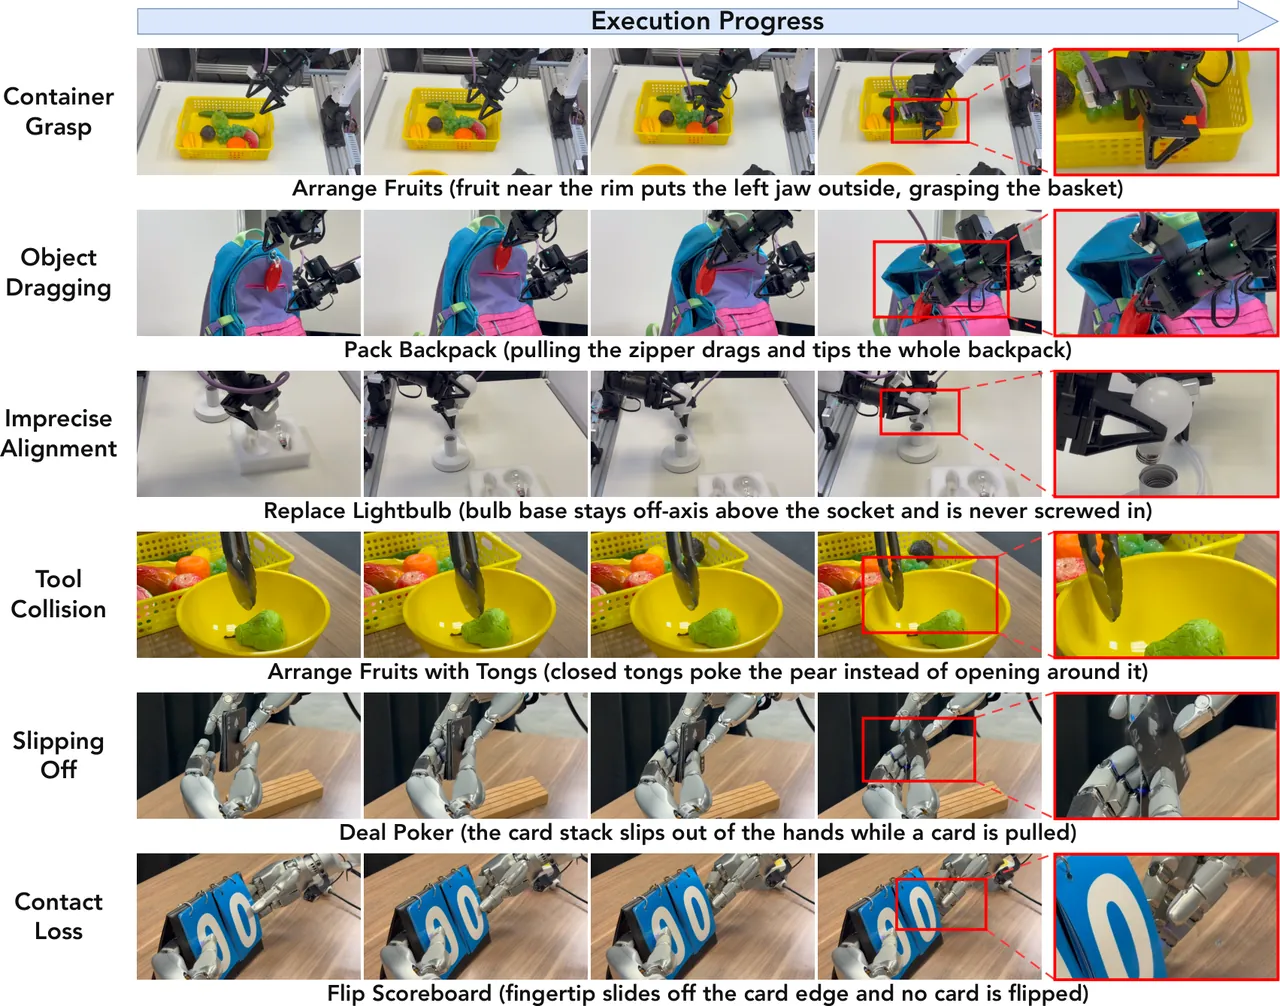
图 10:六类真实失败(论文图 36)。每行一个案例,红框标出失败发生的局部区域;失败集中在遮挡下的抓取几何、可形变物体稳定、精细对准、工具协同、双手交接与持续接触。
失败案例可以按“世界模型缺了什么”来读。整理水果时夹爪左颚越过篮沿,闭合时抓到篮壁而不是水果,缺的是对周围几何与闭合路径间隙的估计;装背包拉链时包体倾倒,缺的是支撑手与拉动手的协同反馈;换灯泡时灯泡底座与灯座未对准,缺的是位置与角度的联合精细对齐;用夹子取水果时夹尖闭着戳向梨,缺的是工具开合与接近轨迹的协调;发牌时左手没接稳牌堆,缺的是交接瞬间的抓取建立与释放时序;翻记分牌时指尖滑脱,缺的是绕装订线转动时的持续接触。这些都不是“再多生成几帧视频”能自动解决的问题,它们需要把接触状态、工具状态与双手时序显式纳入条件。
结论
AW-0 把代码从策略外部的规划器变成世界动作模型内部的一条生成流。它用混合 Transformer 让代码、视频与动作逐层交换信息,用自动标注管线把机器人视频与人类视频变成带技能程序的监督,用联合去噪让语义计划在每一轮迭代中约束未来预测与动作生成。RoboTwin 2.0 与 8 个真实任务的结果说明,这种结构在干净环境、语义选择与工具使用上都有明显收益;混合执行则展示了代码作为可执行技能接口的另一面,但它的收益强烈依赖环境与仲裁质量。
从研究路线看,这篇论文最重要的不是某一个百分点,而是把“程序”放进了世界模型的生成过程。过去的代码智能体把程序当外部控制器,过去的世界动作模型把未来视频与动作当内部表征,两者各自缺一块:前者缺物理预判,后者缺组合结构。AW-0 用联合去噪把两块接起来,并用技能库把“程序”从一次性计划变成可复用资产。它也诚实地暴露了接缝:程序语义不够准、视觉偏移仍会打崩预测、仲裁器不会估计相对收益、灵巧手缺少代码执行接口。
金句与启示
这篇论文最值得带走的一句话是:代码在世界动作模型里不是动作的替代品,而是让未来视频与动作共享同一套语义骨架的“可执行中间表示”。对做具身智能系统的团队,实践启示有三条:先把技能库与接触证据对齐,再谈代码生成;把代码当条件时,重点评估它对视频预测的对象选择与接触时序有没有真实影响;把代码当执行通道时,仲裁器必须估计“这段代码是否比动作块更可能成功”,否则有效性门控会在强策略场景里帮倒忙。