PAPER DEEP DIVE
面向世界动作模型的无数据持续学习:整流生成回放
基于预训练视频生成模型的世界动作模型(WAM)能快速适配新机器人任务,但在顺序微调下会遗忘旧任务。经验回放(ER)靠重演旧任务数据缓解遗忘,而机器人场景中策略往往只以权重形式部署、训练数据并不随权重共享,旧数据常常不可得。本文研究 WAM 能否通过重生成自己的过去实现无数据持续学习:关键观察是 WAM 可以自回归地重生成旧任务的完整 rollout 并回放以缓解遗忘,但直接回放原始 rollout 仍远不如回放真实数据,原因有二——其一,WAM 无法识别任务已完成,在任务结束后继续生成无目的动作;其二,开环生成下生成的动作会逐渐偏离生成的观测。为此提出整流生成回放 R²-WAM:用智能体式评估器在任务完成处截断生成的 rollout,并滤除动作与观测物理不一致的 rollout。在 LIBERO 四个套件与五个真实世界任务上,R²-WAM 相比顺序微调将遗忘降低 90% 以上,且在完全不接触旧任务数据的前提下接近经验回放的效果。分析进一步揭示 WAM 的遗忘集中在逆动力学建模:被遗忘的 WAM 仍能生成旧任务视觉上合理的观测,但其生成的动作已经失败。
论文信息 标题:Data-Free Continual Learning for World Action Model with Rectified Generative Replay(R²-WAM)。作者:Kaipeng Fang、Hangxu Liu、Chaojian Shi、Yunsong Zhou、Hongzi Zhu、Minyi Guo、Jingkuan Song、Lianli Gao(周与高为共同指导)。机构:电子科技大学、上海人工智能实验室、复旦大学、上海交通大学、同济大学、上海创新研究所。链接:arXiv 2610.18038;项目页 kaipengfang.github.io/r2-wam。代码状态:论文声明代码将在正式发表后 release,截至精读时仓库尚未公开,故本文无源码可对照,方法细节以全文与附录为准。骨干模型为 LingBot-VA,光流估计采用 Track4World。
一句话总结
世界动作模型可以仅凭任务指令自回归地重新生成自己学过的任务 rollout,但原始 rollout 既不会在任务完成时停下、又存在观测与动作的开环漂移;R²-WAM 用「完成感知截断 + 光流物理一致性过滤」两步整流后再回放,在完全不保留旧任务数据的前提下把遗忘相对顺序微调降低九成以上,逼近使用真实数据的经验回放。
一、研究背景与动机
真实部署的机器人会不断遇到新任务,因此一个实用的策略必须在学习新任务的同时保住旧任务,这就是持续学习要解决的问题。在众多机器人策略范式里,世界动作模型(World Action Model, WAM)借助强大的预训练视频生成模型, jointly 预测未来观测与机器人动作,成为近年最受关注的方向之一。作者首先实测发现:对 WAM 做顺序微调时,模型对新任务适应得很好,却会在先前任务上彻底崩溃,即典型的灾难性遗忘。
缓解灾难性遗忘的经典路线有两条。一条是约束参数更新,例如用 Fisher 信息加二次惩罚的 EWC、或用知识蒸馏对齐旧模型输出的 LwF,但这类正则化方法在机器人策略上保留的知识很少;另一条是经验回放(Experience Replay, ER),维护一个旧任务演示的缓冲池,在微调新任务时把旧数据混进去一起训练。ER 至今仍是机器人持续学习中最稳健有效的方法之一。
然而 ER 有一个隐含假设:旧任务的演示数据会随任务一起被保存下来。现实中的机器人策略往往只以权重形式交付,训练它的数据并不随之共享,部署方手里根本没有旧任务的演示。于是作者提出一个更苛刻也更贴近部署现实的设定——无数据持续学习:模型在适应完一个任务后,只带走该任务的指令与更新后的参数,其演示数据与任务环境都不再可访问。
在这个设定下,WAM 提供了一个独特的机会。因为它本身建模了世界如何演化,能够自回归地预测未来观测与动作,所以理论上它可以把学过的任务重新 rollout 出来,当作回放数据。论文由此提出核心问题:一个 WAM 能否利用自身的生成能力,达到与经验回放同等效果的无数据持续学习?
作者的答案是肯定的,但有一个关键前提:原始生成的 rollout 不能直接回放。他们把差距归因于两个缺陷。其一,WAM 没有「任务已完成」的概念,也收不到外部停止信号,生成会跑满固定步数,任务做完后仍继续产生无目的的动作,例如放下物体后又回去重抓;其二,开环生成把模型自己的预测喂回自身而缺乏物理接地,误差不断累积,生成的动作逐渐与生成的观测脱节。R²-WAM 的全部工作就是针对这两个缺陷做整流。
二、预备知识
论文把每个操作任务 $\mathcal{T}_k$ 建模为一条指令 $\ell_k$ 与一个专家演示集 $\mathcal{D}_k$,每条轨迹 $\tau_i^k=\{(o_t,a_t)\}$ 由视觉观测与机器人动作组成。持续学习考虑一个被所有任务共享、以指令为条件的策略 $\pi_\theta(a_t\mid o_{\leq t},\ell_k)$,每个阶段用当前任务的演示做行为克隆:
$$\mathcal{L}_{\mathrm{BC}}(\theta;\mathcal{D}_k)=\mathbb{E}_{\tau\sim\mathcal{D}_k}\left[\sum_{t=0}^{|\tau|-1}-\log\pi_\theta(a_t\mid o_{\leq t},\ell_k)\right] \tag{1}$$与只把观测映射到动作的普通策略不同,WAM 还预测自己的动作会产生哪些未来观测。给定任务 $\mathcal{T}_k$ 与轨迹前缀 $\tau_{\leq t}$,它建模如下联合条件分布,其中 $H$ 为 chunk 大小,即一步内预测的观测与动作数量:
$$p_\theta\bigl(o_{t+1:t+H},\,a_{t:t+H-1}\mid \tau_{\leq t},\,\ell_k\bigr) \tag{2}$$实验采用 LingBot-VA 作为代表性 WAM:一个 5.1B 参数的扩散 Transformer(30 层、隐维 3072、FFN 14336),作用在 Wan VAE 产出的 48 通道潜变量上,文本条件来自冻结的 UMT5-XXL。在 LIBERO 上它观察两路 128×128 视角,每个 chunk 预测 4 个潜帧,即 $H=16$ 个动作,截断也以 16 步为粒度。生成在 chunk 之间自回归、在 chunk 之内扩散,推理沿用官方配置:观测 20 步去噪、动作 50 步去噪的 flow-matching 采样器,观测与动作的无分类器引导分别为 5.0 与 1.0。作者唯一改动的是动作归一化:每个任务用自身的 1 与 99 百分位归一化,而非全局统一范围。
三、方法详解:生成、整流、回放
第一步,仅凭指令生成 rollout。对每个已学任务 $\mathcal{T}_j$,R²-WAM 只把指令 $\ell_j$ 喂给当前模型 $\mathrm{WAM}_{k-1}$。由于 WAM 建立在视频生成模型之上、且微调时保留了「把初始观测也当作预测目标」的能力,rollout 从采样初始观测 $\hat{o}_0\sim p_\theta(o_0\mid\ell_j)$ 开始,然后逐 chunk 推进:先由已生成历史预测接下来 $H$ 个观测,再以其为条件预测对应动作:
$$\hat{o}_{t+1:t+H}\sim p_\theta\bigl(\cdot\mid\hat{\tau}_{\leq t},\ell_j\bigr)\;\longrightarrow\;\hat{a}_{t:t+H-1}\sim p_\theta\bigl(\cdot\mid\hat{\tau}_{\leq t},\hat{o}_{t+1:t+H},\ell_j\bigr) \tag{3}$$如此重复到预设 horizon $T$,得到 rollout $\hat{\tau}_j=\{(\hat{o}_t,\hat{a}_t)\}_{t=0}^{T-1}$。horizon 取 $\lfloor \bar{L}/16\rfloor+2$ 个 chunk($\bar{L}$ 为该任务演示的平均长度),即比典型演示长约两个 chunk;作者强调这只是为了方便设 horizon,也可由人工估计任务时长或先探针式生成几条 rollout 来定,且因为截断会在完成处切掉多余部分,horizon 只要足够长即可,精确值影响很小。每个任务采样 $M=40$ 条候选。
缺陷一与完成感知自适应截断。WAM 认不出任务何时完成,任务做完后仍会继续生成重抓、徘徊等无目的动作,这些尾巴若进入训练就会污染该任务的行为。为此 R²-WAM 用一个视觉语言模型作为 agentic 评审,为每条候选 rollout 定位完成点。它不把整段视频喂进去,而是从 rollout 的后段均匀抽帧(最后 20% 或至少 40 步内每 2 步取一帧),并给每帧附上步序号、夹爪指令与末端速度等来自动作序列的标注;由动作检测到的运动终点或夹爪释放帧被标记为 [BOUNDARY],其余为 [SAMPLE],因为正确的截断通常落在边界上。每帧同时给出外部与腕部两个视角,并附一段由动作序列检测出的运动分段摘要。
评审还获得一个同任务的 in-context 示例:一条由人工标出可接受截断区间的生成 rollout(每个任务一条),用来校准它对「完成」的判断。给定指令与上述输入,评审先由指令推导目标状态与各子目标的满足步,再判断任务是否达成,并返回结束步 $\hat{t}_{\mathrm{end}}$,即完成动作彻底结束的点(例如物体已释放、夹爪已回撤);对多子目标任务则取最后一个子目标完成处。随后在 $\hat{t}_{\mathrm{end}}$ 之后的 chunk 边界截断,保留已完成交互、剔除其后动作;被判为未完成任务的 rollout 直接丢弃。提示词还规定了细致的判定规则:放置类子目标必须等物体稳定落位且夹爪由闭合转为张开才算满足,非持握类子目标(推、滑、转)则忽略夹爪、追踪交互运动的转折点;子目标以最后一次成功尝试为准;相邻候选犹豫时取较晚者;若某子目标始终未出现则置 accomplished 为假并取最后一个候选步。
作者用 200 条人工标注的截断区间检验评审精度:更强的 VLM 截断更准,从 Qwen3-VL 的 73.5% 到 GPT-5.6 Sol 的 93.5%,其余实验用 Terra(91.0%)以平衡精度与成本;去掉 in-context 示例降到 78.0%,说明任务终点本身有歧义、示例起到了锚定作用;去掉动作标注降到 76.0%,说明完成时刻往往难以只凭观测判断、动作的运动线索很有帮助。
缺陷二与基于光流的物理一致性过滤。开环生成造成的观测—动作漂移需要量化,但旧任务环境已不可访问,无法真正执行生成的动作看会发生什么。幸运的是机器人本体完全由 URDF 与相机参数确定,因此可以在不含任何环境物体的「仅机器人」仿真中执行生成的动作,作为参照。具体地,把截断后 rollout 的动作在 robot-only MuJoCo 场景里执行,记录机器人自身的光流 $\Phi_{\mathrm{sim}}$;同时用密集三维跟踪器 Track4World 从生成的观测估计光流 $\Phi_{\mathrm{pred}}$。只在机器人像素上比较二者(一个像素仅当仿真器在帧对的两帧中都把它标为运动机器人才计入),于是该分数衡量的是「生成视频里的机器人是否按生成动作所暗示的方式运动」,任务物体不参与打分。物理一致性分数定义为:
$$s_{\mathrm{flow}}(\tilde{\tau})=\lambda_{\mathrm{2D}}\,d_{\mathrm{2D}}\bigl(\Phi_{\mathrm{pred}},\Phi_{\mathrm{sim}}\bigr)+\lambda_{\mathrm{3D}}\,d_{\mathrm{3D}}\bigl(\Phi_{\mathrm{pred}},\Phi_{\mathrm{sim}}\bigr) \tag{4}$$其中 $d_{\mathrm{2D}}$ 与 $d_{\mathrm{3D}}$ 分别度量两路光流在图像平面与三维相机空间的分歧,归一化到 $[0,1]$ 后对全部机器人像素与帧对取平均,分数越低越一致;权重取 $\lambda_{\mathrm{2D}}=\lambda_{\mathrm{3D}}=0.5$,在所有仿真套件与真机上都不改。按 $s_{\mathrm{flow}}$ 排序保留前 $N$ 条作为该任务的回放集 $\mathcal{R}_j$。真机变体上,夹爪指令换成拇指与其余指尖的平均距离并映射到同一开合尺度,末端速度由臂关节指令经正运动学算出,光流过滤只用头部相机,提示词其余不变。
第三步,用整流后的 rollout 回放。R²-WAM 完全照搬 ER 的回放方式,只是把真实演示缓冲 $\mathcal{B}_{<k}$ 换成整流 rollout 的并集 $\mathcal{R}_{<k}=\bigcup_{j<k}\mathcal{R}_j$,在阶段 $k$ 于 $\mathcal{D}_k\cup\mathcal{R}_{<k}$ 上最大化式 (2) 的似然来微调。每个 $\mathcal{R}_j$ 只生成一次并缓存供后续所有阶段复用,因此 $\mathcal{R}_{<k}$ 在规模上与 ER 的缓冲一致却不含任何真实数据。实验取 $M=40$、$N=20$(即 $M=2N$),回放数据与新任务演示等权混合。
flowchart TD
  A["WAM k-1 学完任务 k-1"] --> B["仅凭指令生成 M=40 条 rollout"]
  B --> C["VLM 评审抽后段帧加动作标注
定位完成步 t_end"]
  C --> D{"是否完成任务"}
  D -- 否 --> E["丢弃该 rollout"]
  D -- 是 --> F["在 t_end 后的 chunk 边界截断"]
  F --> G["robot-only MuJoCo 执行动作
得光流 Phi_sim"]
  F --> H["Track4World 读生成视频
得光流 Phi_pred"]
  G --> I["按 s_flow 排序保留 top-N=20"]
  H --> I
  I --> J["缓存为 R k-1 供后续复用"]
  J --> K["与新任务演示 D k 等权混合微调"]
  K --> L["得到 WAM k 进入下一阶段"]
成本。在单节点四张 H200 上,为一个 LIBERO-Spatial 任务生成并整流回放集约需 18 分钟,约为该任务微调(1000 步、1.8 小时)的六分之一,且每个任务只付一次:生成 40 条候选 11 分钟,完成感知截断(40 次 VLM 调用、约 180 万输入 token)3.5 分钟,Track4World 光流 1.5 分钟,仅机器人仿真打分与 top-N 选择 2 分钟。生成耗时随候选数 $M$ 与 horizon 线性增长,截断则受 VLM 接口而非算力限制。
四、实验结果
仿真用 LIBERO 的四个套件(Spatial、Object、Goal、10),每套件 10 个任务、每任务 50 条演示;真机用 7 自由度臂加 20 自由度灵巧手、头腕双相机,在共享桌面上顺序学五个「用某食材做三明治」任务,观测 30 Hz、resize 到 256×320,动作为 27 维关节指令。指标沿用任务矩阵:$c_{i,k}$ 为任务 $i$ 在学完任务 $k$ 后的表现(仿真为 50 次成功率、真机为 20 次进度率),据此计算
$$\mathrm{SR}=\tfrac{1}{K}\sum_i c_{i,K},\quad \mathrm{NBT}=\tfrac{1}{K}\sum_{k<K}\tfrac{1}{K-k}\sum_{j>k}(c_{k,k}-c_{k,j}),\quad \mathrm{Plasticity}=\tfrac{1}{K}\sum_k c_{k,k} \tag{5}$$SR 是最终检查点在所有任务上的平均表现,NBT 衡量遗忘(每个任务从刚学会到之后各检查点的平均跌幅),Plasticity 衡量学新任务的能力。真机因长程任务用二值成功会掩盖部分进展,改用四步计分(抓起指定食材、放到面包上、抓起上层面包、合上三明治)除以 4 的进度率,前两步用错食材不得分。所有方法共享同一骨干、训练表与评测协议,仿真三种子、每任务 50 次试验,真机每任务 20 次。
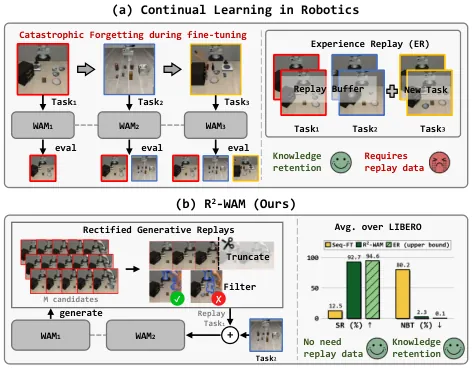
图1:(a) 顺序微调的 WAM 会遗忘旧任务,经验回放能保留但需要旧数据;(b) R²-WAM 用整流生成回放实现无数据持续学习,平均成功率逼近 ER。
主结果。在四个 LIBERO 套件上,不回放的方法全部崩溃:Seq-FT 平均 SR 仅 12.5、NBT 高达 80.19,Seq-LoRA、EWC、LwF 也只在 11–15 之间徘徊,说明正则化与参数隔离对 WAM 几乎无效。回放真实演示的 ER 达到 94.6/0.09/94.7,是上界。直接回放未整流 rollout 的 R-WAM 已把平均 SR 从 12.5 提到 70.4,证明「自生成回放」本身有效;而 R²-WAM 进一步到 92.7/2.33/94.7,与 ER 平均只差 1.9 个百分点,在 LIBERO-10 上差 5.2 个百分点,且相对 Seq-FT 把遗忘降低九成以上。分套件看,R²-WAM 在 Spatial、Object、Goal 上分别为 94.0、95.5、92.2,甚至略超 ER 的 94.0、97.3、92.8 中的两项。
| 方法 | Spatial SR/NBT | Object SR/NBT | Goal SR/NBT | LIBERO-10 SR/NBT | 平均 SR/NBT/Plast. |
|---|---|---|---|---|---|
| Seq-FT | 11.2 / 86.07 | 21.2 / 67.84 | 9.8 / 84.87 | 7.6 / 82.00 | 12.5 / 80.19 / 94.4 |
| Seq-LoRA | 9.6 / 75.42 | 17.6 / 52.47 | 9.8 / 68.72 | 7.4 / 71.24 | 11.1 / 66.96 / 84.4 |
| EWC | 12.0 / 85.59 | 23.6 / 62.19 | 10.0 / 84.55 | 7.8 / 82.24 | 13.3 / 78.64 / 95.0 |
| LwF | 13.0 / 85.14 | 27.6 / 61.76 | 10.4 / 83.70 | 8.6 / 78.96 | 14.9 / 77.39 / 94.2 |
| ER(真实数据,上界) | 94.0 / 0.54 | 97.3 / −1.83 | 92.8 / 2.11 | 94.1 / −0.46 | 94.6 / 0.09 / 94.6 |
| R-WAM(原始回放) | 76.1 / 11.97 | 83.1 / 18.93 | 51.2 / 27.31 | 71.3 / 7.63 | 70.4 / 16.46 / 89.1 |
| R²-WAM(本文) | 94.0 / 2.90 | 95.5 / −0.31 | 92.2 / 2.00 | 88.9 / 4.73 | 92.7 / 2.33 / 94.7 |
表1:四个 LIBERO 套件的持续学习结果(三种子均值),回放方法均用每旧任务 20 条。
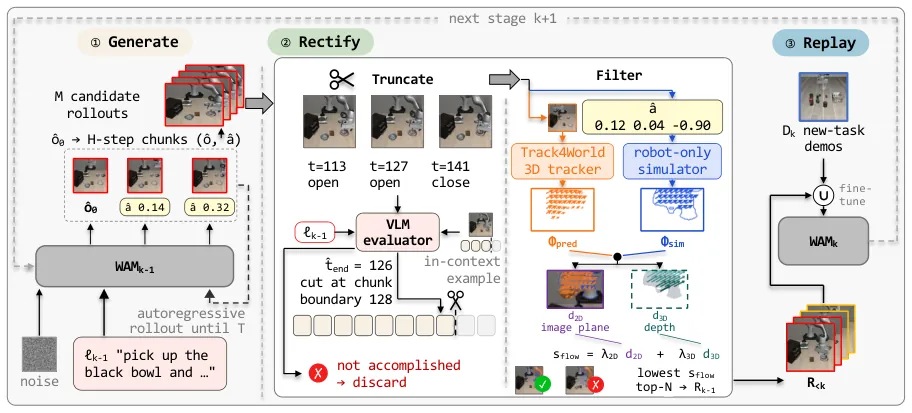
图2:R²-WAM 总览。学完任务 k−1 后,WAM ① 仅凭指令生成 M 条候选 rollout;② 先在完成处截断、再按物理一致性过滤;③ 保留的 top-N 与旧任务整流 rollout 一起,与新任务演示混合微调出 WAM k,下一阶段重复。
真机结果。在五个三明治任务上,ER 为 91.8/2.27/94.8,Seq-FT 为 28.5/65.62/98.8(塑性极高但遗忘严重),R²-WAM 为 89.5/3.45/93.8,同样在无旧数据下逼近 ER。定性观察显示 Seq-FT 的遗忘随任务数递增:刚学会时四步全对,多学一个任务后就跳过指定食材只做两步面包动作,再多学几个任务连面包步骤也退化;而 ER 与 R²-WAM 在四个任务之后仍能用相同动作完成第一个任务。两者共有的失败模式是放置精度下降(煎蛋途中滑落、芝士在面包边缘释放后滑下),与任务间干扰一致。
| 方法(真机五任务) | SR ↑ | NBT ↓ | Plast. ↑ |
|---|---|---|---|
| ER(真实数据) | 91.8 | 2.27 | 94.8 |
| Seq-FT | 28.5 | 65.62 | 98.8 |
| R²-WAM(本文) | 89.5 | 3.45 | 93.8 |
表2:真机五任务顺序学习结果,指标基于四步进度率(每任务 20 次试验)。
消融与机制分析。在 LIBERO-Spatial 上,去掉截断使 SR 从 94.0 跌到 70.8、NBT 升到 13.73,去掉过滤跌到 80.8、NBT 7.02,两者都不做(R-WAM)为 76.1/11.97,说明两步整流缺一不可且截断贡献更大。物理一致性分数确实可执行性相关:把 400 条 rollout 按 $s_{\mathrm{flow}}$ 从最一致到最不一致分五组后在仿真中执行,可完成任务的比例从 82.5% 单调降到 41.2%。轨迹可视化显示生成轨迹整体形态与真实一致但随 rollout 推进逐渐偏离,且释放点比抓起点偏得更多;被保留的 rollout 明显比被滤掉的更贴近真实轨迹,印证过滤确实在挑漂移小的样本,但残余偏离也解释了与 ER 在长程套件上的差距。
| 变体(LIBERO-Spatial) | SR ↑ | NBT ↓ | Plast. ↑ |
|---|---|---|---|
| R-WAM(无整流) | 76.1 | 11.97 | 93.6 |
| 去掉截断 | 70.8 | 13.73 | 89.2 |
| 去掉过滤 | 80.8 | 7.02 | 91.4 |
| R²-WAM 完整 | 94.0 | 2.90 | 95.7 |
表3:整流两组件的消融,每行去掉一个组件。
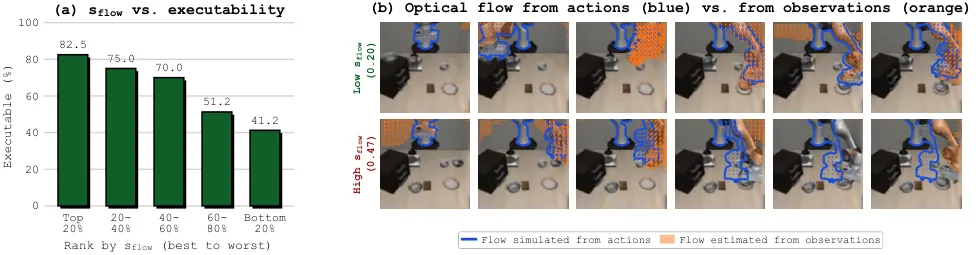
图4:(a) 按 $s_{\mathrm{flow}}$ 分五组后在仿真中执行,可完成比例从最一致的 82.5% 降到最不一致的 41.2%;(b) 低分与高分 rollout 的两路光流,蓝色来自动作仿真、橙色来自观测估计。
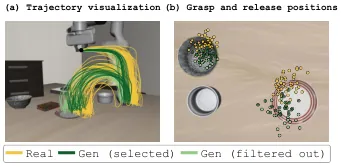
图5:(a) 某 LIBERO-Spatial 任务上 50 条真实演示与 40 条生成 rollout(20 条被保留、20 条被滤掉)的轨迹;(b) 俯视图对比抓取与释放位置,释放点漂移更明显。
缓冲规模与遗忘诊断。把每旧任务回放数从 1 扩到 50,两种方法都快速提升并在 20 条后 plateau,故主实验取 20;有趣的是 buffer=1 时 R²-WAM 反而胜过 ER(79.2 对 69.6),作者推测生成 rollout 反映模型学到的典型行为、比单条可能不典型或带噪的真实演示是更稳的锚点。诊断研究用 teacher forcing 分别探针两种能力,并以相对保留率
$$r(\Delta)=\frac{1}{K-\Delta}\sum_{i=0}^{K-1-\Delta}\frac{p_{i,i+\Delta}}{p_{i,i}} \tag{6}$$度量遗忘。结果显示 Seq-FT 几乎完全忘掉逆动力学建模:该能力保留率在学一个新任务后跌到 8% 且不再恢复,而 R²-WAM 全程保持在 75% 以上;视频预测则大体保留(Seq-FT 78%、R²-WAM 85% 以上)。换言之,一个已遗忘的 WAM 仍能想象出视觉合理的旧任务观测,只是它生成的动作不再能完成任务——遗忘集中在动作侧,这也指明整流应当校验的正是动作这一支。与 ReGen 式回放(用真实初始观测起 rollout、无一致性过滤)相比,其变体在 LIBERO-Spatial 仅 68.0,远低于 R²-WAM 的 94.0,说明保留真实初始观测并不能替代「从指令重新生成并整流」。
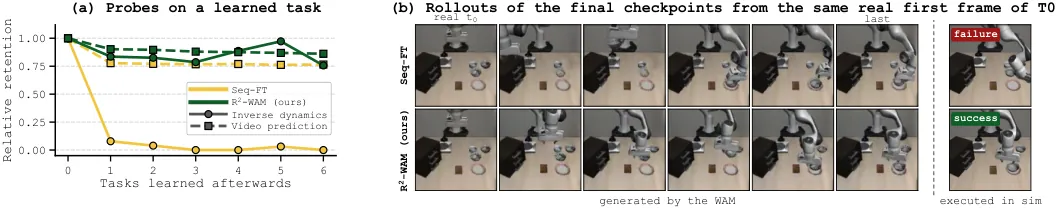
图6:(a) 两种被探针能力的相对保留率随后续任务数的变化,圆点实线为逆动力学、方块虚线为视频预测,黄为 Seq-FT、绿为 R²-WAM;(b) 最终检查点从同一真实首帧生成的 rollout,右端帧为在仿真中执行生成动作的结果,Seq-FT 失败而 R²-WAM 成功。
五、局限性
作者自述其一:与 ER 仍存在小差距,且在长程任务上最大,说明过滤只是缓解而未根治观测—动作漂移;在训练期对齐两路信号、或用外部世界模型为生成接地,是值得探索的方向。作者自述其二:真机实验回放类方法的塑性下降,提示任务间干扰同样需要处理。
笔者补充其一:完成感知截断依赖 VLM 接口与人工标注——每个任务需要一条人工标好截断区间的 in-context 示例,且 40 次调用约 180 万输入 token 的成本不可忽略,评审精度(默认 Terra 91%)也直接决定了回放数据质量。补充其二:物理一致性过滤要求机器人有准确的 URDF 与相机内外参,才能在仅机器人仿真中复现光流,对缺乏标定的平台不适用;horizon 也仍需演示平均长度或人工时长估计,并非完全零信息。
六、总结与展望
R²-WAM 给出了一个清晰的结论:WAM 的生成能力本身就是一种记忆。只要先解决「不会停」与「开环漂移」两个缺陷,模型重新生成的过去就足以充当回放数据,在完全不保留旧任务数据的前提下逼近经验回放。消融证明截断与过滤缺一不可,诊断则把遗忘定位到逆动力学建模这一支,解释了为什么 WAM 能重生成自己的过去、也指明动作侧才是需要校验的部分。
展望上,这条路线把持续学习的存储成本从「数据」转移到「算力 + 一次性的生成缓存」,对只以权重交付的部署形态尤其友好。若进一步在训练期对齐观测与动作、引入外部世界模型接地、或把整流思想扩展到 VLA 与视频世界模型的数据合成,无数据持续学习有望成为机器人策略的默认能力。
金句
「我们问:一个 WAM 能否通过重生成自己的过去,实现无数据的持续学习?」
「一个已遗忘的 WAM 仍能对旧任务产出视觉合理的观测,而它生成的动作却失败——遗忘集中在逆动力学建模。」
「生成 rollout 反映模型为某任务学到的典型行为,因而比单条真实演示是更稳的锚点。」