PAPER DEEP DIVE
Depth Anything V4:基于 4D 高斯溅射上黎曼流匹配的动态四维场景重建(已撤稿存档)
【撤稿存档】arXiv 摘要页标注本文已被作者撤稿(This paper has been withdrawn by Jiaming Fan),v2(2026-08-20)仅余 1KB 撤稿记录,撤稿原因为“Major errors in research”,本站收录仅作批判性阅读与文献存档。论文本身提出 Depth Anything V4(DAV4):从单目视频重建动态 4D 场景,把黎曼流匹配(RFM)直接定义在 4D 高斯溅射参数的非欧流形(尺度、旋转、不透明度)上,使概率路径上的每个中间状态都保持合法,无需事后投影。作者用同数据、同架构、同测试时优化(TTO)协议的确定性 MLP 基线隔离贡献:MLP+TTO 为 0.762,RFM+TTO 为 0.806,+0.044 即 RFM 的孤立增益;欧氏流匹配加投影的消融仅 0.684 且 12.3% 高斯参数非法。预训练 360 GPU-小时,在超过一万场景的部署规模下摊销成本才具竞争力;不确定性以负高斯对数似然与期望校准误差量化;训练损失不使用人工标注深度。
Depth Anything V4:在 4D 高斯溅射的参数流形上做黎曼流匹配
撤稿声明(阅读前必读)
本文(arXiv:2608.18388)已被作者撤稿。arXiv 摘要页以灰框标注「This paper has been withdrawn by Jiaming Fan」,v2 版本(2026-08-20)仅余 1KB 的撤稿记录,作者登记的撤稿理由是「Major errors in research」(研究存在重大错误),该版本亦不再附带许可证。本站收录此文仅作文献存档与批判性阅读:下文的方法、公式与全部实验数字均忠实转录自撤稿前留存的 v1 全文,不代表本站认可其结论仍然成立;任何引用都应同时注明其撤稿状态。论文声明的项目页仓库已不可访问(404),作者账号下无任何公开仓库,因此文中数字目前无法由第三方复核。
论文:Depth Anything V4: Dynamic 4D Scene Reconstruction via Riemannian Flow Matching on 4D Gaussian Splatting | 作者:Jiaming Fan, Jian Lu, Jinling Jia, Chenbin Zhang | 机构:南京邮电大学人工智能学院、自动化学院 | 链接:https://arxiv.org/abs/2608.18388 | 代码:未公开(声明的项目页 https://github.com/fjm123456789/Depth-Anything-4 返回 404) | 状态:已撤稿(v2,2026-08-20)
一句话总结
DAV4 把流匹配的概率路径直接铺设在 4D 高斯溅射参数的非欧流形(尺度、旋转、不透明度)上,使采样路径上的每个中间态都保持合法,并用同数据、同架构、同测试时优化协议的确定性回归基线隔离出 +0.044 F-score 的公式化增益;但作者在提交两天后以「研究存在重大错误」撤回了全文。
研究背景与动机
Depth Anything 系列(V1、V2、V3)确立了前馈式单目深度估计的路线:从半监督学习、合成数据精炼到多视角几何推理,三代模型共享同一个判别式回归范式,输出逐像素的点估计,单帧推理约 38 毫秒。这条路线的代价是明确写在设计里的:不做时间建模,不输出分布,也不重建体积化的场景表示。对机器人导航与实时感知而言这是合理的取舍,但对离线内容创作、三维档案化与动态场景理解而言,点估计深度图并不够用。
动态场景重建的另一条路线是逐场景优化。4D Gaussian Splatting、Deformable-GS、Dynamic 3DGS 等方法为每个场景单独优化一组随时间变形的高斯,完整优化需要数千次迭代(本文报告 4D-GS 全优化约 2100 毫秒每场景),且每个新场景都要从零开始。优化成本无法在场景之间摊销,这使它难以服务大规模视频语料。
生成式先验提供了第三种可能:把「从观测到场景表示」的映射学进网络权重,推理时只需采样。流匹配(flow matching)作为连续归一化流的一种 simulation-free 训练范式,已经在图像与分子生成中验证了效率与稳定性;其黎曼推广(Riemannian Flow Matching, RFM)进一步允许概率路径定义在曲率非零的流形上。问题在于:4D 高斯溅射的参数并不住在欧氏空间里。
尺度必须为正、旋转必须落在 SO(3)、不透明度必须落在开区间 (0,1)。在欧氏空间里对两组高斯参数做线性插值,中间态会走出这些约束——出现负尺度或非单位四元数——只能靠事后投影(截断、Gram-Schmidt 正交化)把样本「救回」流形。投影既切断了概率路径的连续性,也让训练目标与采样路径不再一致。图 1 把这一直观画得很清楚:左侧欧氏直线穿过流形之外,右侧测地线始终留在流形之内。
本文的出发点由此而来:把 RFM 的条件向量场直接定义在 4DGS 参数的乘积流形上,让训练目标、采样路径与参数约束三者自洽。与 V1 到 V3 追求速度不同,DAV4 明确把自己定位为离线高保真重建(单场景 420 毫秒),与实时路线互补。更值得注意的是它的实验姿态:作者意识到「预训练 + 测试时优化」本身就足以带来可观增益,于是构造了一个确定性 MLP 基线,把公式化贡献从工程贡献中剥离出来。
预备知识:参数流形与黎曼流匹配
一个 3D 高斯溅射场由 N 个高斯组成,每个高斯携带中心 $\bm{\mu}\in\mathbb{R}^{3}$、尺度 $\mathbf{s}\in\mathbb{R}_{>0}^{3}$、旋转 $\mathbf{q}\in\mathrm{SO}(3)$、颜色(球谐系数)$\mathbf{c}$ 与不透明度 $\alpha\in(0,1)$。4D 扩展沿用 4D-GS 的分解:场景在视频时间 $\tau$ 的形态写成静态基场加上一个由时间条件 MLP 预测的增量,
$$\mathcal{S}(\mathbf{x},\tau)=\mathcal{S}_{3D}(\mathbf{x})\oplus\Delta_{\bm{\phi}}(\mathbf{x},\tau),\quad \Delta_{\bm{\phi}}(\bm{\mu}_{i},\tau)=\mathrm{MLP}_{\bm{\phi}}(\gamma(\bm{\mu}_{i}),\gamma(\tau)),$$
其中 $\gamma(\cdot)$ 是位置与时间的频率编码,增量经 $\tanh$ 限制幅度。这个分解把「动态」压缩成一个有界的残差场,静态结构由基场承担。
流匹配在流形 $\mathcal{M}$ 上用测地插值定义条件概率路径:从噪声样本 $\mathcal{G}_z$ 到目标样本 $\mathcal{G}_1$ 的路径与对应的条件向量场为
$$\mathcal{G}_{t}=\mathrm{Exp}_{\mathcal{G}_{z}}\!\left(t\cdot\mathrm{Log}_{\mathcal{G}_{z}}(\mathcal{G}_{1})\right),\quad u_{t}(\mathcal{G}_{t}\mid\mathcal{G}_{1},\mathcal{G}_{z})=\frac{\mathrm{Log}_{\mathcal{G}_{t}}(\mathcal{G}_{1})}{1-t},$$
训练目标则是让网络向量场 $v_{\bm{\theta}}$ 在路径点上回归该条件场,$\mathcal{L}_{\text{RFM}}=\mathbb{E}\left[\lVert v_{\bm{\theta}}(\mathcal{G}_{t},t)-u_{t}\rVert^{2}_{\mathcal{M}}\right]$。由于 $u_t$ 有闭式解,训练不需要求解 ODE,这是流匹配相对扩散模型最大的工程优势。
三个非欧分量各自有对应的流形操作。尺度取对数后做几何平均插值,$\tilde{\mathbf{s}}=\log\mathbf{s}$,$\mathbf{s}_{t}=\mathbf{s}_{z}^{1-t}\mathbf{s}_{1}^{t}$,保证中间尺度恒正;旋转用 SO(3) 的指数/对数映射走测地线;不透明度经 logit 变换 $\tilde{\alpha}=\log(\alpha/(1-\alpha))$ 映射到整条实轴后按欧氏测地线插值。附录 B 给出正确性论证的骨架:条件场 $u_t$ 是高斯负对数似然在切空间上的梯度,匹配它即在最小平移意义下最小化模型分布与目标分布的 KL 散度。
方法详解
表示层。DAV4 的输出对象是随视频时间演化的 4DGS 场,采用上节的静态基加残差分解,残差 MLP 以频率编码的位置与时间为输入。选择分解式而非逐帧独立重建,是为了让时间一致性内建于表示:同一组基高斯在所有帧共享身份,运动只体现在有界增量上。
黎曼流匹配先验。先验网络 $v_{\bm{\theta}}$ 的训练目标在式 (2) 的基础上加入条件:
$$\mathcal{L}_{\text{RFM}}=\mathbb{E}\left[\left\lVert v_{\bm{\theta}}(\mathcal{G}_{t},t,f_{\text{img}},\gamma(\tau))-u_{t}\right\rVert^{2}_{\mathcal{M}}\right],$$
即向量场同时以流时间 $t$、冻结 DINOv2-L 提取的图像特征 $f_{\text{img}}$ 与视频时间 $\tau$ 为条件。范数在乘积流形上按各分量的切空间度量求和:尺度与不透明度在对数/logit 坐标下是欧氏范数,旋转用 SO(3) 切空间范数。条件化是本文与「无条件生成高斯」的关键差别——它让先验成为「给定这段视频,场景应当长什么样」的条件分布。
确定性 MLP 基线(控制实验的锚点)。为隔离 RFM 的贡献,作者把流匹配目标整体替换为对教师目标的 L2 回归:
$$\mathcal{L}_{\text{MLP}}=\mathbb{E}_{\mathcal{G}_{1}\sim p_{\text{teacher}}}\left[\left\lVert \mathrm{MLP}_{\bm{\phi}}(f_{\text{img}},\gamma(\tau))-\mathcal{G}_{1}\right\rVert^{2}\right],$$
骨干、Perceiver、解码头、预训练数据、数据增强、学习率日程与 TTO 协议全部保持一致,唯一变量是损失函数(附录 C)。这个基线的存在使后文的 +0.044 有了明确的归因对象:它不是「更多参数」或「更多数据」的功劳,而是概率化公式本身的功劳——至少按 v1 的陈述如此。
自监督教师。流匹配需要目标样本 $\mathcal{G}_1$,而真实 4DGS 标注并不存在。教师是一个用纯自监督损失训练的 4DGS 头:
$$\mathcal{L}_{\text{teacher}}=\lambda_{r}w(t)\mathcal{L}_{\rm render}+\lambda_{e}\mathcal{L}_{\rm equiv}+\lambda_{f}\mathcal{L}_{\rm flow}+\lambda_{\rm scale}\mathcal{L}_{\rm scale}+\lambda_{\rm reg}\mathcal{L}_{\rm reg}.$$
五项各司其职:渲染损失保证光度一致;SE(3) 等变损失配合刚性评分注入几何先验;RAFT 光流一致性损失负责消解时间方向的歧义;尺度正则借用 Depth Anything V2 的中值深度提供度量尺度(作者明确披露这是弱监督);高斯正则抑制退化基元。全文反复强调的一点是:人工标注深度从未进入训练损失。
测试时优化(TTO)。采样得到的场还要再 refinement 一轮。TTO 把渲染损失的梯度直接加到 ODE 右端,作为引导项:
$$\frac{d\mathcal{G}_{t}}{dt}=v_{\bm{\theta}}(\mathcal{G}_{t},t,f_{\text{img}},\gamma(\tau))+w_{\text{guide}}\cdot\nabla_{\mathcal{G}}\mathcal{L}_{\text{render}}(\mathcal{G}_{t}).$$
所有用到 TTO 的方法(4D-GS+TTO、MLP+TTO、RFM+TTO)共享同一协议:20 个梯度步、学习率 $10^{-3}$、Adam、同一渲染损失。协议统一是控制实验成立的前提,也是本文实验设计里最值得肯定的一点。
架构。每个高斯先编码为潜向量 $\mathbf{z}_{i}=\mathrm{Enc}_{\rm gauss}(\cdot)$(维度 64),Perceiver 把变长集合压缩为 512 个定长 token $\mathbf{H}$(4 层、隐维 256),解码端用交叉注意力把全局 token 读回每个高斯 $\mathbf{h}_{i}=\mathrm{CrossAttn}(\mathbf{z}_{i},\mathbf{H}_{\rm out})$,再由 MLP 头输出增量 $\Delta\mathcal{G}_{i}$,多头分别预测位置、尺度、四元数与不透明度(图 2)。冻结的 DINOv2-L 提供语义特征,向量场估计器是一个 4 层 Transformer,条件输入经正弦嵌入注入。
flowchart TB
    V[Monocular video frames] --> DINO[Frozen DINOv2-L backbone]
    DINO --> PER[Perceiver: variable set to M=512 tokens]
    PER --> VF[Transformer vector field estimator]
    EMB[Sinusoidal embedding of flow time t and video time tau] --> VF
    VF --> COARSE[Coarse ODE stage: 10 steps, global layout]
    COARSE --> FINE[Fine ODE stage: 20 steps, local detail]
    FINE --> GS[4DGS field: position, scale, quaternion, opacity]
    GS --> RENDER[Differentiable rendering loss]
    RENDER -. guidance gradient, weight 0.01 .-> FINE
    subgraph MFD[Probability path on parameter manifolds]
        SC[Scale: log-space geodesic]
        RO[Rotation: SO(3) Exp/Log geodesic]
        OP[Opacity: logit-space geodesic]
    end
    VF --> MFD
    MFD --> GS
粗到细采样。算法 1 把 ODE 积分分成两段:粗阶段 10 步、步长 $1/N_c$,只负责全局布局;细阶段 20 步、步长减半,负责细节,并允许在右端加入任务损失的引导梯度(权重折半为 $w/2$,对应半步长的稳定性补偿)。噪声初值 $\mathcal{G}_0\sim\mathcal{N}(0,\mathbf{I})$ 定义在各流形的切空间坐标上。场景规模固定为 10 万个高斯。
不确定性量化。生成式先验的天然副产品是分布:从 K=10 个不同噪声初值出发跑 10 条独立 ODE 轨迹,对每个高斯参数取跨样本方差。校准指标用负高斯对数似然(NGLL),直接在参数空间计算,
$$\mathrm{NGLL}=-\frac{1}{N}\sum_{i}\left[-\frac{1}{2}\log(2\pi\sigma_{i}^{2})-\frac{(\theta_{i}-\hat{\theta}_{i})^{2}}{2\sigma_{i}^{2}}\right],$$
其中 $\sigma_i^2$ 是经验方差,从而绕开高维密度估计;ECE 则按 10 个等宽置信 bin 计算,逐像素置信度取方差的倒数。
成本模型。预训练耗时 360 GPU-小时,即 $1.296\times10^{6}$ GPU-秒;单场景推理 420 毫秒。摊销成本写成 $420+1.296\times10^{6}/N$ 毫秒每场景:N=1000 时为 1716 毫秒,劣于逐场景优化;N=10000 时降到约 550 毫秒,开始优于 4D-GS 全优化的 2100 毫秒。作者据此把适用边界划在「万级场景以上的离线批处理」。
实验结果与解读
评测覆盖四个基准:Dynamic-Sim(100 个带 4DGS 真值的合成动态场景)、KITTI Dynamic(KITTI Tracking 中 50 段含运动车辆与行人的序列)、ETH3D 与 ScanNet(新视角合成)。预训练语料为 WebVid-10M 的无标注视频与 MegaDepth 的无标注图像。表 1 是全文的实验核心,它把总增益拆成三个可归因的因子。
| 方法 | 预训练 | TTO | Dynamic-Sim F1 | KITTI F1 |
|---|---|---|---|---|
| 4D-GS(5000 iter) | 否 | 否 | 0.781 | 0.623 |
| 4D-GS(100 iter) | 否 | 否 | 0.702 | 0.552 |
| 4D-GS + TTO | 否 | 是 | 0.748 | 0.598 |
| MLP | 是 | 否 | 0.718 | 0.578 |
| MLP + TTO | 是 | 是 | 0.762 | 0.615 |
| RFM(DAV4) | 是 | 否 | 0.758 | 0.612 |
| RFM + TTO(DAV4) | 是 | 是 | 0.806 | 0.652 |
| 增量:TTO | +0.046 | +0.046 | ||
| 增量:预训练 | +0.014 | +0.017 | ||
| 增量:RFM | +0.044 | +0.037 |
读这张表要注意三件事。其一,TTO 本身就是强基线:仅 20 步测试时优化就把欠优化的 4D-GS 从 0.702 抬到 0.748(+0.046),任何新方法都必须先越过这条线。其二,预训练的边际贡献其实不大(+0.014),说明「把数据灌进网络」在这项任务上并不自动带来收益。其三,RFM 的孤立增益 +0.044(KITTI 上 +0.037)大于预训练增益的三倍,且两个模型共享数据、架构与 TTO 协议。同时也要诚实记录一个不利的读数:不加 TTO 的 RFM(0.758)略低于加了 TTO 的 MLP(0.762),说明概率化先验与测试时优化是互补关系而非替代关系。
新视角合成(表 2)上,DAV4 在相同 TTO 预算下比随机初始化的 3D-GS 高 2.79 dB(ETH3D:25.13 对 22.34),甚至超过 5000 次全优化的 3D-GS(24.12 dB);ScanNet 上同样领先 20 步基线 2.24 dB(23.82 对 21.58)。LPIPS 从 0.23 降到 0.16,说明增益不只是像素级对齐,也体现在感知质量上。作者在此处主动标注了比较的先天偏差:3D-GS 用随机初始化,DAV4 用预训练初始化,这个优势是方法自带的,无法从对比中剔除。
| 方法 | ETH3D PSNR | ETH3D SSIM | ETH3D LPIPS | ScanNet PSNR | ScanNet SSIM | ScanNet LPIPS |
|---|---|---|---|---|---|---|
| 3D-GS(20 iter TTO) | 22.34 | 0.83 | 0.23 | 21.58 | 0.81 | 0.26 |
| 3D-GS(5000 iter) | 24.12 | 0.86 | 0.19 | 23.05 | 0.84 | 0.22 |
| MLP + TTO | 24.01 | 0.85 | 0.20 | 22.85 | 0.83 | 0.23 |
| DAV4(RFM + TTO) | 25.13 | 0.88 | 0.16 | 23.82 | 0.86 | 0.19 |
时间条件消融(表 3)给出了另一个干净的因果读数:去掉视频时间 $\tau$ 条件后,KITTI Dynamic 上的时间一致性从 0.92 跌到 0.78,F-score 从 0.806 跌到 0.742。没有 $\tau$ 的模型只能学到时间平均的静态先验,运动线索无从进入向量场;这一项 +0.14 的一致性增益,是「动态」二字在本文中最直接的证据。图 4 的收敛曲线则从效率侧补了一刀:DAV4 在 20 个 TTO 步内到达约 0.80 的平台,而逐场景 4D-GS 需要 500 次以上迭代才逼近同一水平。
几何公式化的价值在表 5 中最为直观。把流匹配换回欧氏线性插值加事后投影(尺度截断为正、旋转做 Gram-Schmidt),F-score 掉到 0.684,且 12.3% 的采样高斯在投影前参数非法;黎曼版本为 0.806,非法比例 0.01%。换句话说,欧氏路径有近八分之一的样本需要被「抢救」,而抢救本身带来了 0.122 的质量损失。图 3 的 KITTI 定性对比与图 5 的不确定性热图(运动车辆与遮挡边界方差高、静态背景方差低)共同支撑了「校准良好」的定性结论。
| 方法 | F1 | 非法高斯比例 |
|---|---|---|
| 欧氏流匹配 + 事后投影 | 0.684 | 12.3% |
| 黎曼流匹配(本文) | 0.806 | 0.01% |
不确定性方面(表 4),多假设采样的 DAV4 取得 NGLL −1.58、ECE 0.058,显著优于 MC-Dropout(−0.82 / 0.18)与深度集成(−1.15 / 0.12)。对下游系统而言,这意味着「模型知道自己在哪里不确定」:遮挡与运动边界的高方差可以直接作为拒绝采样或补测视角的依据。效率侧(表 6)则划清了适用边界:420 毫秒每场景是 Depth Anything V3 的 11 倍,只有当部署规模超过一万场景时,摊销后的 550 毫秒才让预训练投入回本。
| 方法 | NGLL(越低越好) | ECE(越低越好) |
|---|---|---|
| MC-Dropout | −0.82 | 0.18 |
| 深度集成 | −1.15 | 0.12 |
| DAV4 | −1.58 | 0.058 |
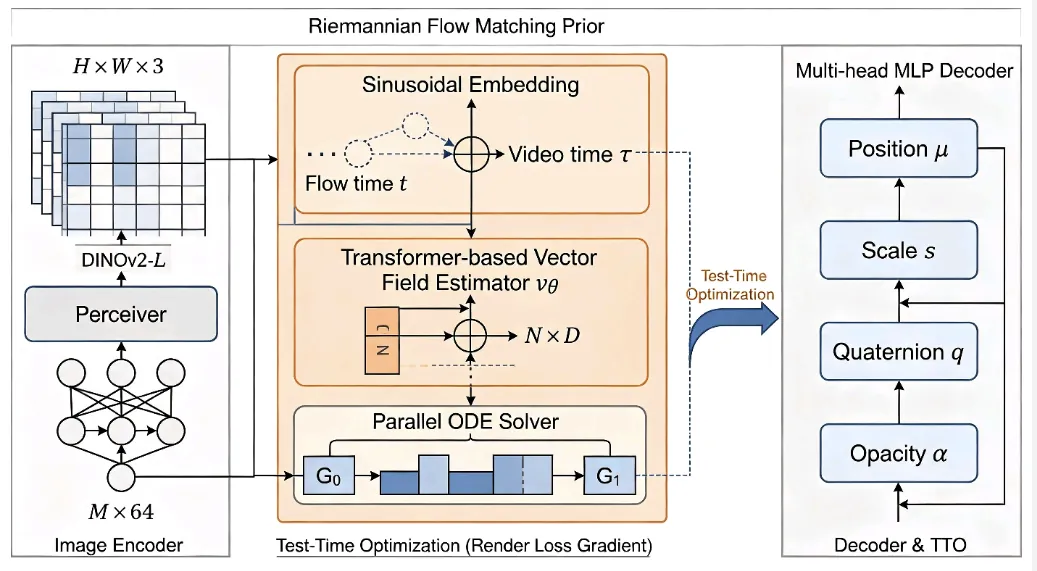
图 2:DAV4 总体架构。冻结 DINOv2-L 与 Perceiver 产出潜 token,黎曼流匹配先验在流时间 t 与视频时间 τ 条件下估计向量场,ODE 求解器粗到细生成高斯,最后由测试时优化以渲染损失 refine。
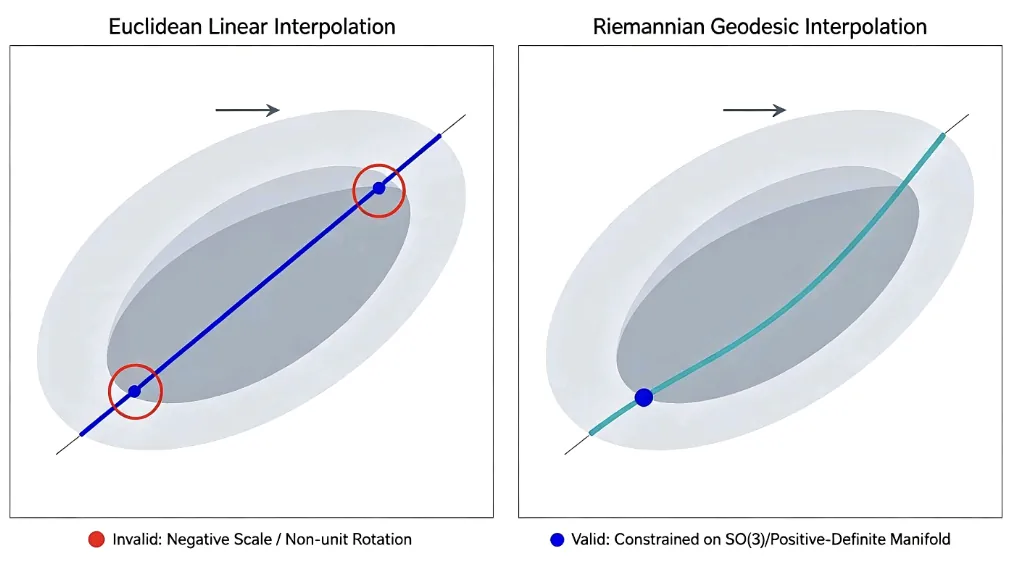
图 1:欧氏线性插值(左)会走出流形,产生负尺度或非单位旋转,需要事后投影;黎曼测地插值(右)的中间态始终合法。
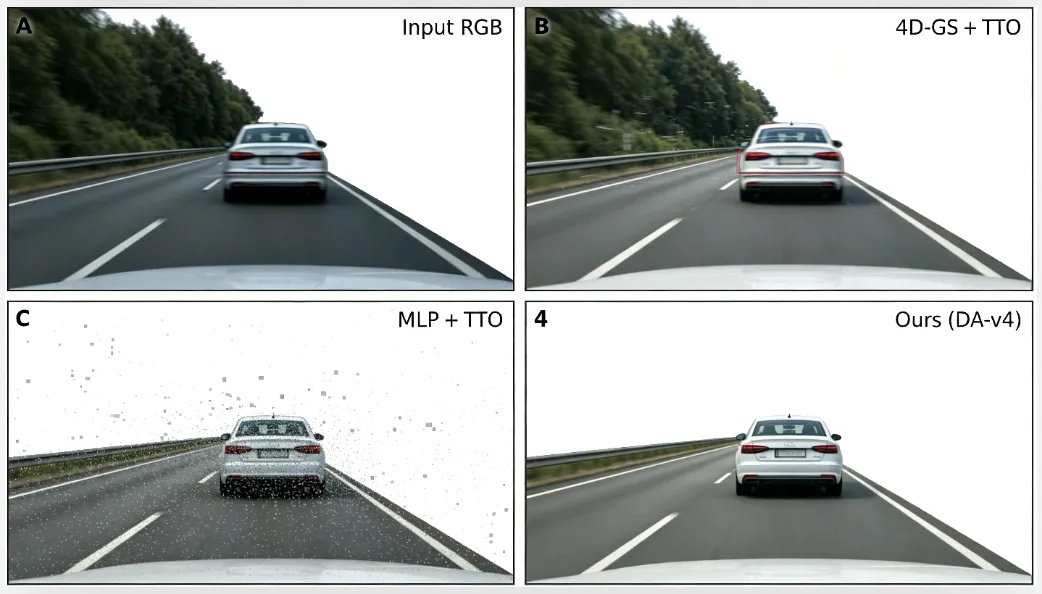
图 3:KITTI Dynamic 定性对比。DAV4(右下)相对 4D-GS+TTO(右上)与 MLP+TTO(左下)边界更锐利、漂浮伪影更少。
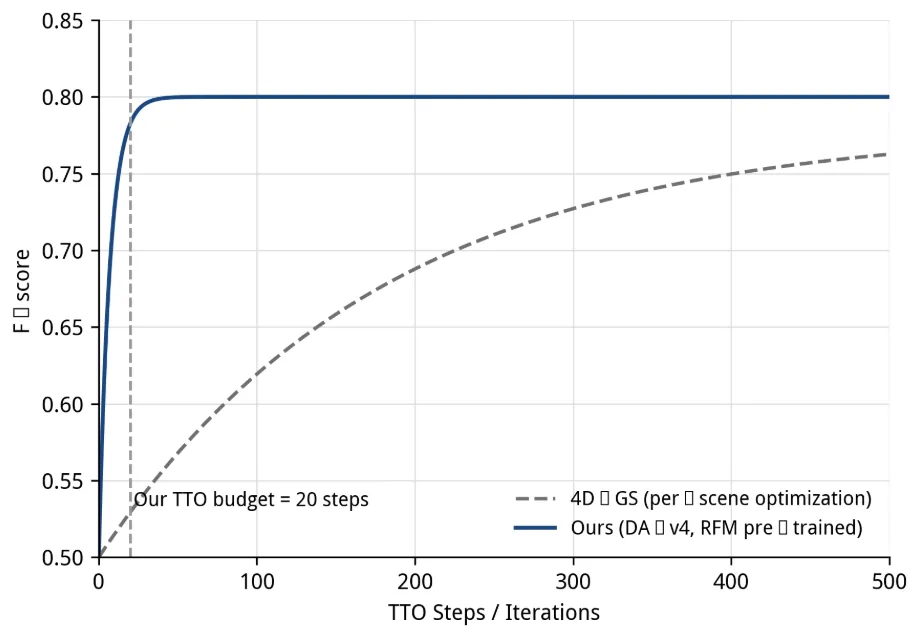
图 4:TTO 收敛曲线。DAV4 在 20 步预算内到达平台,逐场景 4D-GS 需要 500 次以上迭代。
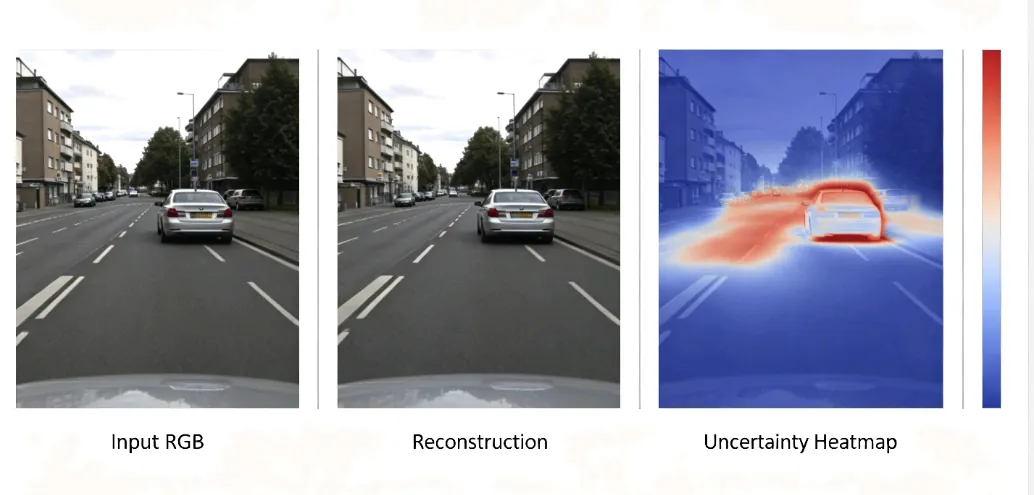
图 5:不确定性可视化。运动车辆与遮挡区域方差高(红),静态背景方差低(蓝)。
局限性
作者自述四条局限:420 毫秒的推理不适合实时机器人与自动驾驶;360 GPU-小时的预训练门槛不低;与 3D-GS 的新视角对比存在随机初始化对预训练初始化的先天偏差;渲染损失梯度不是保守向量场,因此 TTO 引导缺乏严格的能量函数解释——最后一条尤其诚实,它承认式 (7) 的引导项在数学上只是启发式。
在此之上还有几条必须写明的判断。第一,也是最重的一条:作者本人以「研究存在重大错误」撤回了全文,且未说明错误位于何处。在代码与数据均不公开、Dynamic-Sim 为作者自建合成集、KITTI Dynamic 协议细节缺失的情况下,表 1 到表 6 的全部数字目前只是无法复核的声明;+0.044 的孤立增益应当按「待证命题」而非「已证结论」阅读。第二,控制实验的「同架构」承诺只由附录 C 的一段文字背书,MLP 基线与 RFM 的输出头参数量、初始化是否逐项一致没有表格可查。第三,用 K=10 条轨迹的参数方差近似预测分布,对 ECE 的 10-bin 估计而言样本量偏小,尾部校准的结论比较脆弱。第四,教师损失中的尺度正则依赖 Depth Anything V2 的中值深度,作者虽披露为弱监督,但「无标注深度」的表述与「借用另一个深度模型的输出」之间存在语义张力。
总结与展望
抛开撤稿不谈,DAV4 的文本提出了一条清晰的技术命题:当场景表示的参数自带几何约束时,生成式先验的概率路径应当尊重这些约束,而不是在欧氏空间里走完再投影。控制实验的设计——用同数据同架构的确定性回归基线剥离公式贡献——也是这类「先验 + 优化」混合方法应当效仿的报告规范;TTO、预训练、公式化三项增益被分别量化为 +0.046、+0.014、+0.044,读者可以自行判断哪一部分值钱。
它的撤稿同样有教学意义:一篇在实验设计上显得格外谨慎的论文,仍然可能因为未被指明的重大错误而被作者整体撤回,而缺乏可复现工件会让社区连错误在哪里都无从查起。对后续工作而言,流形上的流匹配(尺度对数空间、SO(3) 测地线、logit 坐标)作为工程配方依然成立,facebookresearch 的 riemannian-fm 与 flowmm 等开源实现提供了可复核的参照;真正需要重新验证的,是「把这些配方用在 4DGS 参数上能带来多大增益」这一具体声明。