PAPER DEEP DIVE
Thinker-WM:共享多模态具身世界模型
统一建模 RGB、度量深度与机器人动作,在共享表征中完成世界预测、策略推断与多模态生成。
一句话总结:Thinker-WM 将 RGB、度量深度与机器人动作送入同一组动态 Transformer 参数中联合演化,再以模态专用编码器和解码器保留各模态边界,从一个检查点覆盖世界预测、策略推断与多模态生成。
研究背景与问题
具身智能中的“世界模型”通常被描述为根据当前观测和任务指令预测未来。问题在于,真实交互未来并不只包含图像:机器人看到的纹理、场景的几何结构以及机器人执行的动作共同决定下一刻。只生成RGB视频的模型容易获得视觉上合理的结果,却不一定理解动作如何改变物体位置和接触关系;只输出动作的策略则缺少对场景演化与几何约束的显式建模。
已有路线大致可以分为两类。第一类以视频生成模型为基础,将动作作为附加条件或外接动作头使用。这样的系统能够利用大规模视觉先验,但动作往往停留在输入或输出边界,视频分支与动作分支没有在内部表征中共同更新。第二类方法训练面向控制的视觉语言动作模型,其优势是直接输出动作,却较少生成未来深度与完整视觉观测。两类方法都把“感知未来”和“行动生成”拆成了不同接口。
本文的出发点是把不同模态的差异集中在接口处处理,把物理耦合放在共享表征中学习。RGB给出外观,深度给出度量几何,动作解释场景变化的原因。三者具有不同的统计结构和输出语义,所以不能简单拼接成同一种token;但它们又受同一个世界过程约束,所以不能各自独立预测。Thinker-WM 因此采用“表示层统一,而不是输入输出层统一”的设计。
论文的后训练目标进一步针对具体机器人:共享世界知识负责泛化,机器人专用记录负责执行接口与视觉统计的适配。作者强调,这种适配仍发生在同一参数化框架内,并未为每个应用重新拆出一个独立网络。
论文定义与总体结构
给定当前观测 $o_t$ 和任务级条件 $c$,模型直接学习RGB、深度和动作未来轨迹的联合分布:
$$p\left(v_{t+1:t+H},d_{t+1:t+H},a_{t+1:t+H}\middle|o_t,c\right).$$
这个式子的关键不在输出数量,而在联合性。若视频与动作分别生成,再通过后处理对齐,那么条件只在接口上传递;联合分布则要求同一动态过程同时解释外观变化、几何变化和动作后果。
整体信息流可以概括为模态编码器、统一动态Transformer(UDT)以及模态解码器:
$$(o_t,c)\rightarrow\left\{\mathcal{E}_v,\mathcal{E}_d,\mathcal{E}_a,\mathcal{E}_l\right\}\rightarrow\mathcal{U}\rightarrow\left\{\mathcal{D}_v,\mathcal{D}_d,\mathcal{D}_a\right\}\rightarrow(\hat v,\hat d,\hat a).$$
这里 $\mathcal{E}_l$ 不是第四个生成流。它由冻结的Qwen3-VL-2B提取任务、场景和动作描述,再经线性桥接与四个残差MLP块形成条件序列。生成负担留给视频、深度和动作,语言负责结构化任务引导。
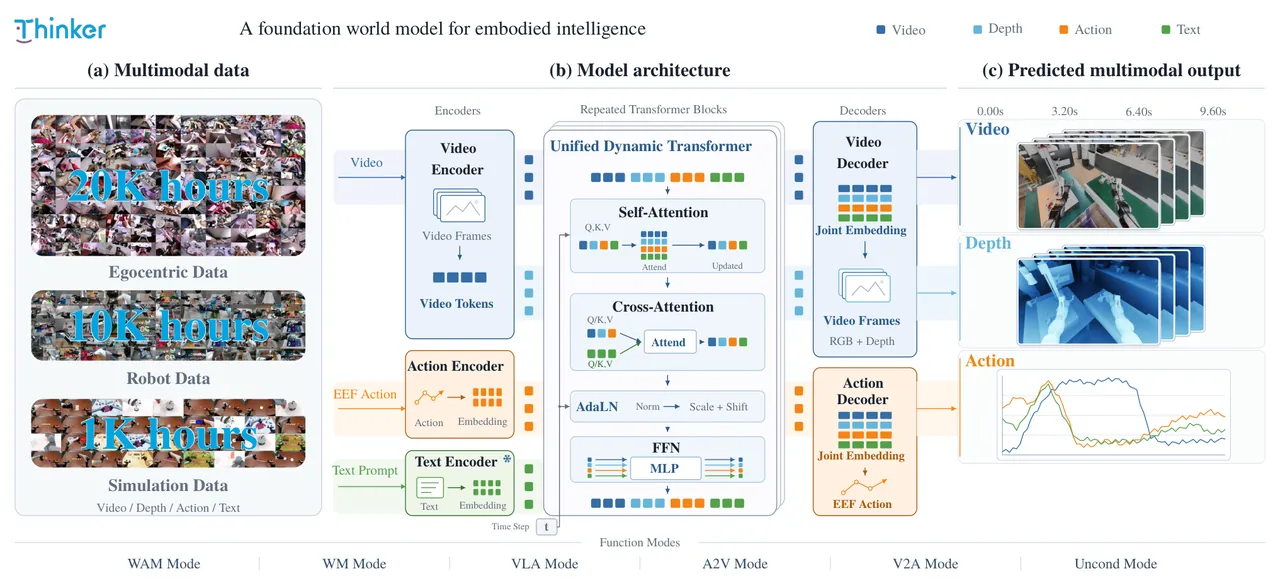
图1:论文总览。左侧是预训练混合数据,中间是共享UDT与模态专用路径,右侧是同一参数化下的开环生成。
统一表征如何构造
视觉潜空间与深度通道
RGB与深度均由冻结的Wan2.2 VAE压缩。640×480分辨率下,49帧窗口变成 $13\times30\times40$ 的潜空间网格;随后采用 $(1,2,2)$ 的patch划分,每个视觉流得到 $13\times15\times20=3900$ 个token。两者共享时空拓扑,便于在同一注意力序列中对齐,但仍使用不同的输入投影与输出投影。
这种设计避免了两种常见误区。第一,不能只把深度当作三通道图片无条件混入RGB,因为二者的物理含义不同;第二,也不能把深度完全隔离成辅助任务,因为那样几何信息只能影响辅助损失,无法在生成过程中改变动作表征。共享拓扑加专用投影,是本文在“共性”和“差异”之间的折中。
flowchart LR
    RGB["RGB 49x480x640"] --> VAE["Wan2.2 VAE"]
    DEP["Metric depth"] --> LOG["Log codec 0.15 to 4.0 m"]
    LOG --> VAE
    VAE --> LAT["Latent 13x30x40"]
    LAT --> PAT["Patch 1x2x2"]
    PAT --> VIS["3900 visual tokens"]
    ACT["Robot action"] --> SLOT["Unified slots U=20"]
    SLOT --> REL["Relative EEF and validity mask"]
    REL --> ATOK["288 steps to 48 action tokens"]
    TXT["Task Scene Action"] --> VLM["Frozen Qwen3-VL"]
    VLM --> CTX["Language context"]
    VIS --> UDT["Shared dynamics Transformer"]
    ATOK --> UDT
    CTX --> UDT
    UDT --> OUTV["RGB decoder"]
    UDT --> OUTD["Depth decoder"]
    UDT --> OUTA["Action decoder"]
实现中,深度使用对数编码,把米制深度压缩到可逆的灰度域。源码的默认编码可写成:
$$v=1-\frac{\log z-\log z_{\mathrm{near}}}{\log z_{\mathrm{far}}-\log z_{\mathrm{near}}},\qquad z\in[z_{\mathrm{near}},z_{\mathrm{far}}].$$
官方推理配置采用 $z_{\mathrm{near}}=0.15$ 米、$z_{\mathrm{far}}=4.0$ 米。对数间距让近处小尺度几何获得更细的表示,同时把远距离差异压缩到可控范围。解码器反向恢复米制深度。
跨本体动作槽
不同机器人在自由度、坐标系和控制约定上差异很大。论文将每个机器人的原始动作映射到统一的20维动作槽,其中包括双臂末端执行器的位置增量、相对六维旋转和夹爪状态。槽映射及有效位掩码为:
$$\tilde a_u=\begin{cases}a_{\pi_r(u)},&\pi_r(u)\geq0,\\0,&\pi_r(u)=-1,\end{cases}\qquad m_u=\begin{cases}1,&\pi_r(u)\geq0,\\0,&\pi_r(u)=-1.\end{cases}$$
无效槽既不参与加噪,也不进入损失。这一点很重要:如果只是把缺失自由度补零,模型会把“该机器人没有这个关节”误当成“这个关节应保持零位移”。六维旋转使用相对于条件帧的姿态:
$$\Delta p_t=p_t-p_0,\qquad R_t^{\mathrm{rel}}=R_0^{\top}R_t.$$
相对表示消除了全局坐标系和相机姿态造成的部分差异,使不同场景中的动作更容易比较。每个本体另有八个可学习机器人token,与语言条件共同构成交叉注意力上下文:
$$c=[\,r_{1:8}\;;\;h_{\mathrm{und}}\,].$$
动作与视频按固定的六比一频率对齐。48帧视频对应288个动作步,再经时间卷积压成48个动作token,模型宽度为3072。这样动作token与视觉潜序列拥有相同时间长度,同时大幅减少序列长度。
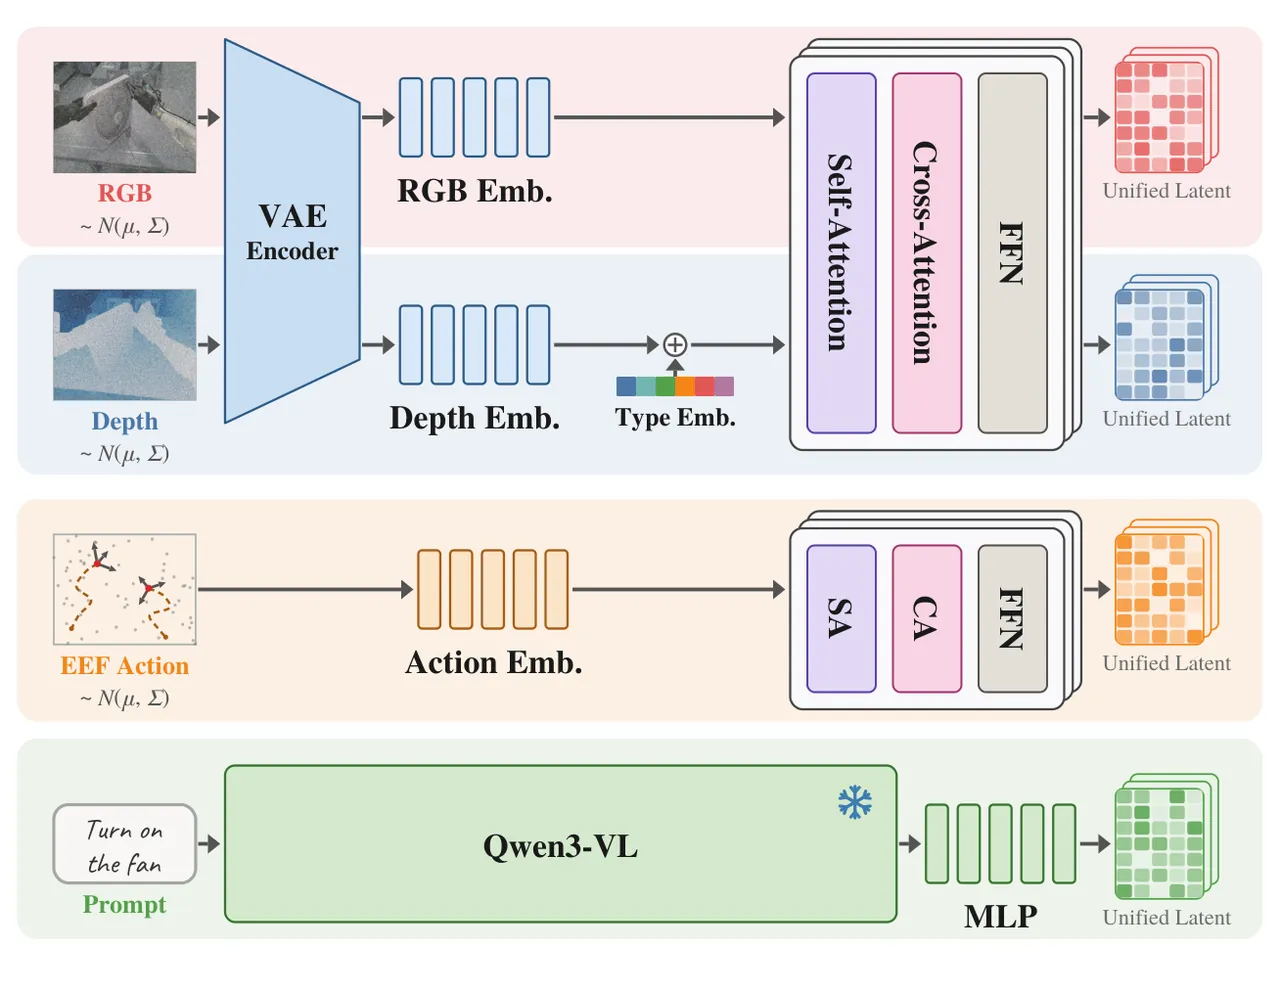
图2:多模态编码与解码。各模态先进入专用投影,再在UDT中共享动态演化;机器人身份通过条件token注入。
共享动态Transformer
RGB、深度和动作潜变量沿token维拼接后送入UDT:
$$z'=\mathcal{U}\left([\,z_v^0\,;\,z_d^0\,;\,z_a^0\,],h_{\mathrm{und}}\right).$$
UDT不是简单地把所有模态放进一个无约束注意力池。预训练阶段采用有向注意力:RGB与动作可以相互读取,深度可以读取RGB、动作和自身,但RGB及动作不读取深度。这样,深度监督可以通过梯度塑造共享权重,又不让不完整的深度伪标签直接扰动预训练视觉和动作路径。
进入后训练后,数据范围收窄到具有较可靠深度的机器人记录,深度才向双向交互开放。此时RGB和动作也能读取几何流,深度从单向辅助信号变成共同演化的状态变量。源码中的注意力选择在 `thinkerwm/uni/branch.py:100` 明确写出了这一方向性,而推理配置中的 `depth_detach_video_kv` 控制预训练式几何读取时是否截断视频键值梯度。
语言路径同时保留原始任务表示和逐层更新后的表示。第 $k$ 个UDT块的键和值由两者拼接生成:
$$K_k=W_K[\,h_{\mathrm{und}}^0;\,h_{\mathrm{und}}^k\,],\qquad V_k=W_V[\,h_{\mathrm{und}}^0;\,h_{\mathrm{und}}^k\,].$$
这相当于同时保留“原始指令说了什么”和“当前多模态状态如何理解指令”。如果只使用更新后的语言表示,早期条件可能在深层被稀释;如果只使用原始表示,语言又无法跟随生成状态调整。
六种功能模式
模型为每种功能显式定义哪些模态被生成、哪些作为干净条件、哪些完全省略,而不是只依赖随机模态dropout。条件模态把流时间设为0,于是 $x_{\sigma=0}=x$,编码器直接接收原始表示,同时不计该模态的预测损失。
| 模式 | 训练配置 | 功能 |
|---|---|---|
| WAM | 视频流与动作联合去噪 | 联合世界与动作生成 |
| WM | 省略动作分支 | 视觉世界预测 |
| VLA | 第一帧保持干净,生成动作 | 由当前观测推断策略 |
| A2V | 注入干净动作并去掉提示 | 动作条件视频生成 |
| V2A | 注入干净视频并去掉提示 | 视频到动作生成 |
| Uncond | 去掉提示后联合去噪 | 无分类器引导分支 |
模式比例为 $0.5:0.1:0.1:0.1:0.1:0.1$。一半优化步用于完整联合分布,其余五个模式各有固定份额。模式由全局训练步决定并在所有数据并行rank间一致,避免不同rank计算不同分支而导致同步优化不一致。
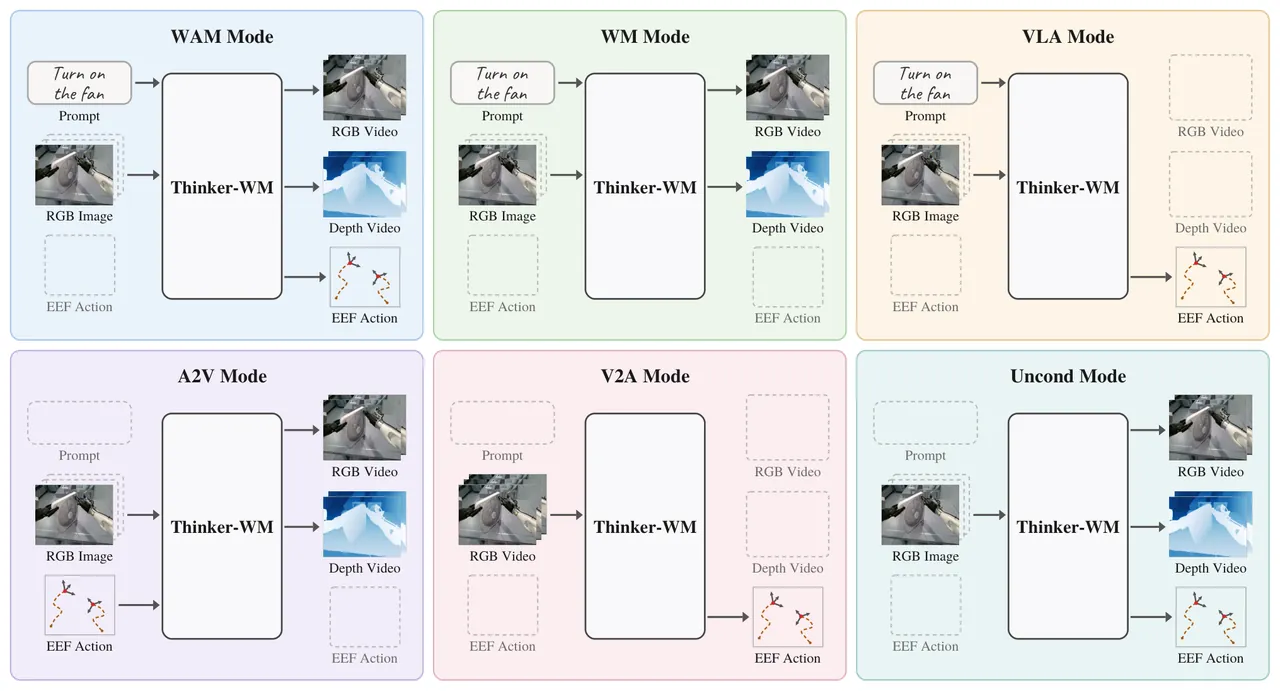
图3:预训练阶段的模态注意力。深度单向读取RGB和动作;语言只通过交叉注意力提供条件。
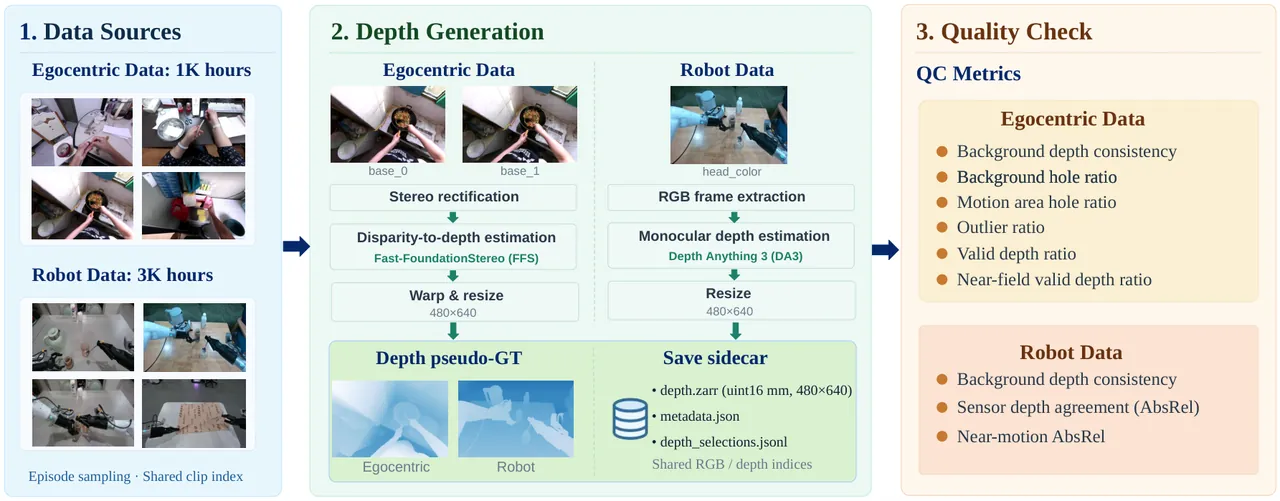
图5:同一网络在六种功能模式下的输入、条件与输出组合。
流匹配目标与训练课程
对模态 $m\in\{v,d,a\}$,干净表示 $x_m$ 与高斯噪声 $\epsilon_m$ 按流时间 $\sigma_m$ 插值,模型回归从噪声指向数据的速度:
$$x_{m,\sigma_m}=(1-\sigma_m)x_m+\sigma_m\epsilon_m,\qquad u_m^\star=\epsilon_m-x_m.$$
时间网格采用shifted schedule:
$$\sigma(s)=\frac{\mathrm{sh}\cdot s}{1+(\mathrm{sh}-1)\cdot s}.$$
RGB和深度使用 $\mathrm{sh}=6.0$,动作使用 $\mathrm{sh}=1.0$。视觉token数量大,高噪声阶段决定全局场景结构,因此需要更多训练质量;动作序列只有48个token且连续性强,近似均匀的时间覆盖更合适。推理时视频和深度执行50步,动作执行10步。
动作损失只统计当前本体真正拥有的自由度:
$$\mathcal{L}_a=\mathbb{E}\left[\frac{\sum_{u=1}^{U}m_u\|\hat u_{a,u}-u_{a,u}^{\star}\|_2^2}{\sum_{u=1}^Um_u+\varepsilon}\right].$$
给定功能模式 $r$,总损失仅覆盖被生成模态集合 $\mathcal{G}(r)$:
$$\mathcal{L}_{\mathrm{total}}=\sum_{m\in\mathcal{G}(r)}\lambda_m\mathcal{L}_m(\theta;r).$$
训练不是把所有数据一次性混合。第 $s$ 阶段使用当前主数据与少量历史回放:
$$\mathcal{D}_s=(1-\epsilon_s)\mathcal{D}_s^{\mathrm{main}}+\epsilon_s\mathcal{D}_s^{\mathrm{replay}},\qquad\epsilon_s\ll1.$$
阶段0继承Wan2.2的通用视觉先验;阶段1只更新视频路径,使模型适应机器人视角;阶段2联合加入动作与几何;阶段3使用目标机器人数据完成执行接口与视觉统计的专门化。EWMBench总分随之从2.63升到3.34、4.44和4.66,说明课程顺序并非装饰性流程,而是和最终生成质量同步推进。
联合训练时,视频与动作共享基础噪声进度,再加入独立小幅抖动:
$$\tilde\sigma_m=\mathrm{clamp}(u+\delta_m,0,1),\qquad\delta_m\sim\mathrm{Uniform}(-0.10,0.10).$$
共享进度使两个流在推理时能够同步去噪,抖动则避免训练只看到完全相同的噪声等级。源码实际为视觉和动作使用不同的sigma网格,这属于工程实现细节;论文给出的核心约束是共享基础进度与受控扰动。
# 模式与耦合采样接口,节选自官方推理代码
# thinkerwm/thinker_wm/infer.py:355
def inference_step(..., num_inference_steps=50,
                   action_num_inference_steps=None,
                   predict_video=True, predict_action=None):
    # 缺失模态由 None/全零判定,条件模态以干净表示输入
    ...
该接口把视频与动作的预测开关、条件输入和去噪步数放在同一调用中,和论文的六模式训练表相对应。官方发布的是推理代码与检查点加载流程,训练数据工厂和完整预训练流水线并未随仓库开放。
实验结果
EWMBench:外观、运动与语义的共同评分
EWMBench包含7个操作任务的21个回合。每个回合生成三个候选视频并按Hausdorff距离选取一个,共评价63个视频。总分为八个归一化维度的和。Thinker-WM取得4.66,高于Qwen-RobotWorld的4.60;更明显的差异在运动相关指标,nDTW从0.6708升到0.7102,Dyn从0.3429升到0.3630。
| 模型 | SceneC↑ | HSD↑ | Dyn↑ | nDTW↑ | Overall↑ |
|---|---|---|---|---|---|
| Veo3 | 0.8415 | 0.2130 | 0.1932 | 0.1613 | 3.49 |
| Sora2 | 0.8526 | 0.2807 | 0.3494 | 0.2754 | 3.89 |
| LVP | 0.8795 | 0.4248 | 0.0433 | 0.6226 | 4.05 |
| Qwen-RobotWorld | 0.9142 | 0.5660 | 0.3429 | 0.6708 | 4.60 |
| Thinker-WM | 0.8877 | 0.5638 | 0.3630 | 0.7102 | 4.66 |
结果揭示了一个重要差别:视觉保真度高并不自动带来动作一致性。Veo3的SceneC为0.8415、CLIP为0.8965,但HSD只有0.2130;Thinker-WM的SceneC略低,却在轨迹和动态上更强。论文的解释是动作并非附着在视频生成器后面的独立输出,而是在联合生成过程中共同塑造未来。
进一步把真实动作序列作为干净条件后,Overall升到5.03,HSD升到0.7369,nDTW升到0.8736。Dyn只从0.3630变为0.3636,说明动作条件主要改善轨迹和运动路径一致性,并非把所有指标等幅抬高。这个模式对比最直接地回答了“动作是否真的被视频分支使用”。
WorldOlympiad与WorldArena
WorldOlympiad机器人榜单覆盖400个操作回合、超过十种实体机器人及多种相机位置。Thinker-WM的All分数为0.740,3D Consistency为0.531,Interaction为0.765,均排名第一。三项核心分数按等权平均:
$$S_{\mathrm{All}}=\frac{1}{3}\left(S_{\mathrm{phys}}+S_{\mathrm{3D}}+S_{\mathrm{interact}}\right).$$
| 模型 | Physical↑ | 3D Cons.↑ | Interact.↑ | All↑ |
|---|---|---|---|---|
| Uranus | 0.925 | 0.511 | 0.730 | 0.722 |
| Cosmos-Predict-2.5 | 0.937 | 0.479 | 0.721 | 0.712 |
| LingBot-World | 0.949 | 0.393 | 0.710 | 0.684 |
| Thinker-WM | 0.923 | 0.531 | 0.765 | 0.740 |
WorldArena Track-1采用仿真环境中的十二项指标平均值,论文明确排除对帧率和采样密度敏感的Dynamic Degree、Flow Score和Motion Smoothness。Thinker-WM的EWMScore为71.73,高于DexWorldEngine的71.01和BWM-Fast的70.97。其Depth Accuracy为92.49,Photometric Consistency为46.33,说明几何与时序光度稳定性是主要增益来源;Image Quality只有37.26,并非所有单项都领先。
深度与闭环控制
在48条AgiBot验证序列上,Thinker-WM的深度AbsRel为0.1360、RMSE为0.1790米,优于RynnWorld-4D的0.1625和0.2075米。作者把深度有效范围统一到0.15至4.0米后重新比较,RynnWorld-4D的AbsRel仅从0.162517变为0.162474,因此提升不能用评价区间解释。
| RoboTwin turn_switch配置 | RGB与深度交互 | 6K | 7K | 8K | 总体成功率 |
|---|---|---|---|---|---|
| 仅RGB | 无 | 12/20 | 12/20 | 12/20 | 60.0% |
| RGB加深度 | 单向 | 12/20 | 12/20 | 14/20 | 63.3% |
| 完整模型 | 双向 | 15/20 | 15/20 | 15/20 | 75.0% |
单向深度只把成功率从60.0%提高到63.3%,双向交互则达到75.0%。这说明“增加一个深度预测任务”与“让几何表征参与动作生成”不是同一件事。后者在每个测试检查点都优于两个对照配置。RoboTwin 2.0的50任务平均成功率进一步达到Clean 92.6%、Randomized 91.4%,只下降1.2个百分点。
运动探针与共享表征
为了判断视频token是否真的编码了动作相关信息,论文在冻结的UDT视频特征上训练轻量运动头。离线教师由SpatialTrackerV2产生三维轨迹,再与真实末端轨迹做每窗口Sim(3)对齐:
$$\tilde C_t=sRC_t+t,\qquad \Delta\tilde C_t=sR\Delta C_t.$$
因为探针只关心位移,平移在差分后消失。运动损失同时约束端点误差和运动幅值:
$$\mathcal{L}_{\mathrm{motion}}=\frac1{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\|x_t-y_t\|_2+\frac1{|\mathcal{T}|}\sum_{t\in\mathcal{T}}\left|\|x_t\|_2-\|y_t\|_2\right|.$$
在96个保留的AgiBot窗口上,动作MSE降至0.116,并随训练检查点单调下降。它不证明视频表征等价于动作,却提供了“冻结视觉特征中可恢复执行位移”的直接证据。
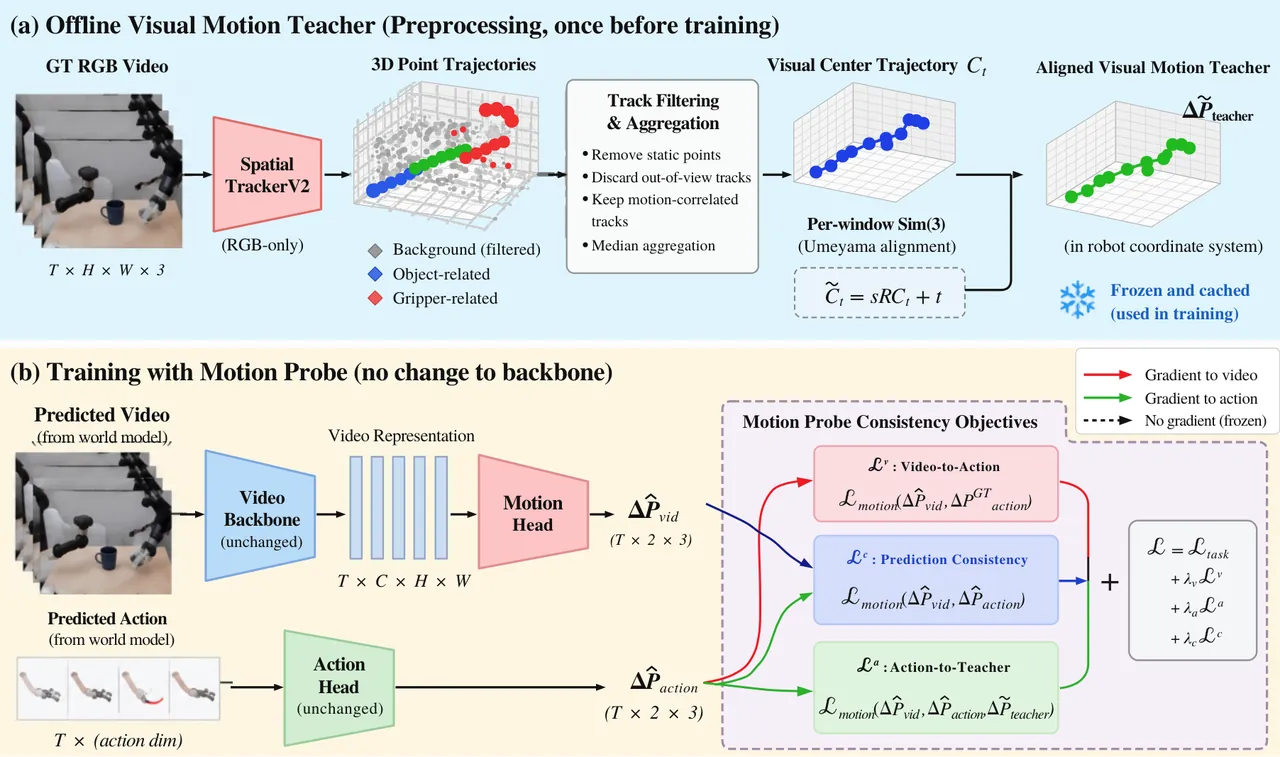
图6:运动探针。SpatialTrackerV2构造离线视觉运动教师,冻结UDT后只用轻量头回归末端位移。
代码映射与可复现性
官方仓库当前提交为 `44cdb51`,定位是单卡推理发布。动作槽映射可在 `configs/inference_example.yaml` 中直接看到,例如AgiBot A2-D把本地26维动作映射到统一20维槽,并将旋转向量转换为相对六维旋转。`thinkerwm/thinker_wm/action_repr.py:161` 负责从相对旋转恢复绝对姿态:
# thinkerwm/thinker_wm/action_repr.py:161
def relative_rotation_6d(state_rot, action_rot, repr_name, quat_order="xyzw"):
    r_s = repr_to_matrix(state_rot, repr_name, quat_order)
    r_i = repr_to_matrix(action_rot, repr_name, quat_order)
    r_rel = r_s.transpose(-1, -2).unsqueeze(-3) @ r_i
    return matrix_to_6d(r_s), matrix_to_6d(r_rel)
这行代码和论文的 $R_t^{\mathrm{rel}}=R_0^{\top}R_t$ 一致。另一个能对应论文的组件是 `thinkerwm/thinker_wm/depth_codec.py:20` 的对数深度编解码;它让推理输入、网络潜空间与米制深度输出之间存在明确的逆变换。
局限与讨论
第一项是作者明确承认的真实机器人闭环缺口。RoboTwin上的75.0%和50任务成功率证明了仿真控制能力,但论文没有在真实机器人上执行在线策略、扰动恢复或长期任务。真实传感器噪声、接触不确定性和安全约束仍可能显著改变结果。
第二,深度监督只覆盖约4000小时机器人数据,而总机器人数据约10000小时。几何并非全部训练样本都有高质量标签;本文用单向注意力减轻伪深度的影响,但无法消除覆盖不均。
第三,长时生成依靠推理时把48帧窗口自回归串联,训练阶段没有直接优化模型生成轨迹上的长期漂移。没有长期闭环误差统计时,短窗口指标不能保证数十秒后的稳定性。
第四,WorldArena结果采用排除三项运动指标的十二项协议。这样处理有帧率敏感性依据,但也意味着“十二项第一”不能等同于“全部指标第一”。论文的基准成绩均为作者报告,尚无独立复现实验。
第五,50步视觉去噪与10步动作去噪带来明显计算成本,论文没有给出延迟、显存与吞吐数据。对需要高频闭环控制的机器人,这个部署问题与方法性能同样重要。
结论与展望
Thinker-WM最有价值的地方在于把“动作是否真正进入世界模型”变成了可检验的结构问题。统一动作槽解决跨本体边界,共享UDT让RGB、深度和动作共同更新,六个功能模式复用同一参数化,运动探针则检查冻结视觉表征是否保留执行信息。实验结果支持这条路线在开环生成和仿真闭环中优于只生成视频的基线。
下一步需要补上的不是再增加一个漂亮演示,而是三项硬证据:真实机器人闭环、长期生成漂移曲线,以及推理延迟与训练规模的关系。只有这些证据齐备,共享多模态世界模型才能从基准领先转化为可部署的机器人基础设施。
共享不是把所有模态压成同一种token,而是让它们在同一动态过程中互相解释,同时保留各自能够被执行的边界。