PAPER DEEP DIVE
GloSplat:联合位姿与外观优化的快速精确三维重建
GloSplat 把运动恢复结构初始化与三维高斯泼溅统一为联合位姿—外观优化:在训练中保留显式特征轨迹作为独立几何锚点,并与高斯均值分别优化,从而避免光度梯度和致密化造成位姿漂移。快速版采用检索式图像对选择,精度版采用全量匹配;两类版本均在无位姿新视角合成基准上取得领先的精度—速度权衡,为机器人仿真场景重建提供了高效工具。
作者:Tianyu Xiong、Rui Li、Linjie Li、Jiaqi Yang
论文:arXiv:2603.04847v1,2026 年 3 月 5 日,cs.CV / cs.GR
代码状态:截至精读时未找到公开仓库。作者称补充材料中包含用于核验的代码,完整实现将在论文录用后公开。
机器人相关性:论文将高质量三维重建定位为机器人仿真的基础能力,但实验只覆盖新视角合成基准,尚未在机器人导航、操作或真实仿真闭环中验证。
一句话总结
GloSplat 把相机位姿从传统三维高斯训练的“冻结输入”改成可优化变量,在训练高斯外观时持续用特征轨迹的重投影误差修正相机,并保留独立的 SfM 路标点作为几何锚点。它在 MipNeRF360、Tanks and Temples 和 CO3Dv2 上提高了渲染质量,同时把 1000 张图像的端到端重建时间压到 GPU COLMAP 的约十三分之一。
研究背景与问题
三维高斯泼溅已经能够从带位姿图像中快速拟合高质量场景,但它的质量依赖一个常被忽略的前提:相机位姿必须足够准确。常规流程先运行运动恢复结构,估计相机内外参和稀疏点云,再把结果固定下来训练高斯。位姿估计一旦有偏,后续优化只能在高斯颜色、尺度和位置上补偿误差,难以恢复真正的几何关系。
运动恢复结构本身又存在速度问题。增量式流程逐张注册相机、反复做局部优化,图像数量增加后容易表现出超线性耗时;穷举特征匹配同样会随着视角数量增长而迅速变重。另一类免 COLMAP 方法借助前馈网络直接预测位姿,速度更快,但在大场景、弱纹理或视角覆盖复杂的数据上,精度和稳定性仍可能不足。
论文关注的核心矛盾不是简单地把“SfM”和“3DGS”串起来,而是两种优化信号会发生冲突。参考图像中的特征轨迹提供几何约束,适合校正相机;渲染图像与输入图像的光度损失提供外观信号,适合改善高斯。如果直接让光度梯度同时改写相机和高斯位置,高斯可能通过移动或生成局部结构解释错误的投影,而相机也可能吸收原本属于几何的误差。
GloSplat 因此提出联合位姿与外观优化。它既不把位姿视为永远正确的先验,也不让位姿完全服从渲染损失,而是把光度监督、特征轨迹重投影和全局 SfM 初始化放进同一套训练过程。论文给出的两个版本分别面向快速部署和最高质量:GloSplat-F 使用检索配对和轻量学习特征,GloSplat-A 使用兼容 COLMAP 的穷举匹配路线。
预备知识
三维高斯泼溅用一组带位置、协方差、不透明度和视角相关颜色的椭球体表示场景。给定相机位姿后,系统把高斯投影到图像平面并做可微光栅化,通过逼近输入图像更新高斯的属性。高斯数量、致密化策略和相机精度都会影响结果;即使外观参数很灵活,错误的相机轨迹也会让训练在多个视角之间产生无法统一的重建。
SfM 的另一项产物是特征轨迹。每个轨迹把同一三维路标点在多张图像中的观测串起来。全局 SfM 可以先通过相对旋转做旋转平均,再估计相机中心和路标位置,最后用重投影误差做光束法平差。GloSplat 同时利用这两部分信息,但特意不让稀疏路标点和高斯均值共享同一个可学习参数。
方法详解
三阶段总览
系统分为三个阶段。第一阶段从无位姿图像中提取局部对应关系,并决定哪些图像之间需要匹配;第二阶段使用 GPU 全局 SfM 同时估计所有相机位姿和稀疏点;第三阶段在三维高斯训练中加入位姿优化与光束法平差。论文的结构图把前两个阶段画成冻结预处理,把第三阶段标为真正的核心贡献。
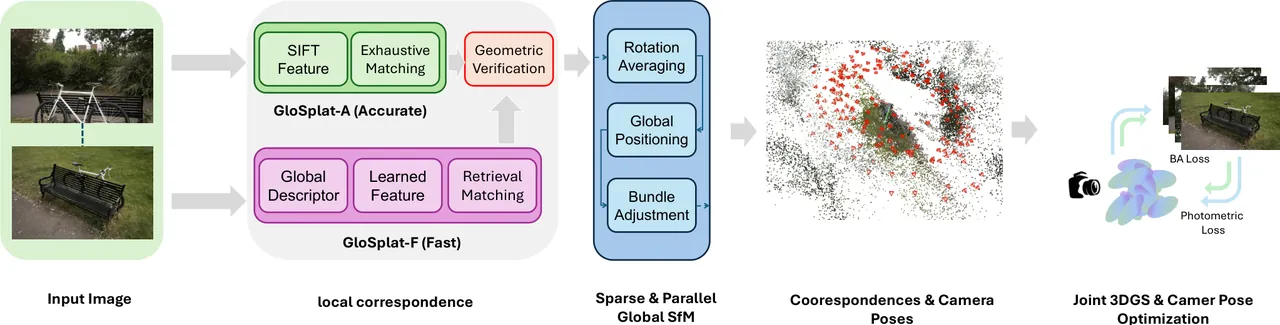
图 1:论文 Figure 2 的系统流水线。输入图像先进入冻结的局部对应提取,随后由全局 SfM 初始化相机与路标点,最后联合训练高斯和相机位姿。
flowchart TD
  A["Unposed images"] --> B["Frozen local correspondence"]
  B --> C{"Pair strategy"}
  C -->|"GloSplat-F: MegaLoc top-k + XFeat/LightGlue"| D["Retrieval matching graph"]
  C -->|"GloSplat-A: SIFT exhaustive"| E["Exhaustive matching graph"]
  D --> F["Global SfM initialization"]
  E --> F
  F --> G["Camera poses plus SfM tracks"]
  G --> H["3DGS photometric optimization"]
  H --> I["Joint Huber BA on tracks"]
  I --> J["Updated cameras and Gaussians"]
  J --> H
图中的回环是关键区别。传统流水线在进入 3DGS 后不再更新相机,而 GloSplat 每轮训练都同时接收渲染误差和轨迹重投影误差。前者让场景外观逼近真实照片,后者把相机和路标拉回多视图一致的几何关系。
快速路线与精度路线
GloSplat-F 面向快速重建。它先用 MegaLoc 做图像检索,为每张图选择前五个候选,缩小匹配图;局部特征使用 XFeat,最多提取 4096 个关键点和 64 维描述子,再用 LightGlue 完成匹配。由于匹配边数受固定数量的近邻限制,图像规模增大时计算量更接近线性增长。
GloSplat-A 面向最高精度。它使用与 COLMAP 兼容的 SIFT 特征和穷举匹配,得到更完整的对应关系,再交给全局 SfM。两条路线共享后续的联合优化框架,但速度与精度的差异同时来自特征类型和匹配图,因此不能把二者之间的全部差距只归因于检索策略。
冻结预处理意味着特征网络、匹配器和候选检索都不接收下游重建梯度。这样做保留了成熟局部特征的稳定性,也避免在训练后期不断改变对应关系导致优化目标漂移。代价是检索阶段漏掉的有效视角无法由后续位姿优化补回。
全局 SfM 初始化
全局 SfM 首先通过相对旋转约束同步全部相机朝向。论文采用的旋转目标写为:
$$\mathcal L_{rot}=\sum_{(i,j)\in\mathcal E}\rho_{GM}\left(\left\|\log(R_{ij}^\top R_jR_i^\top)\right\|^2;\sigma\right)$$其中 i 与 j 是存在相对观测的两台相机,Rij 是从匹配得到的相对旋转,Ri 和 Rj 是待估计的全局旋转。目标比较相对旋转与全局旋转的合成结果,并用稳健核降低错误边的影响。
旋转初始化之后,系统估计相机中心并利用轨迹方向约束位置。对于一条包含路标 Xk 的轨迹,每个观测规定路标应沿该像素对应的视线方向。位置相关目标写为:
$$\mathcal L_{pos}=\sum_k\sum_{(i,p)\in\mathcal T_k}\left\|(I-b_{ip}b_{ip}^\top)(X_k-c_i)\right\|^2$$bip 表示第 i 张图中观测 p 的归一化视线方向,ci 是相机中心,Tk 是包含路标 k 的所有观测。投影矩阵去掉视线方向上的分量,因此它主要约束路标、相机中心与成像射线之间的横向几何关系。
完成旋转和位置初始化后,SfM 阶段使用 Huber 重投影损失:
$$\mathcal L_{BA}^{SfM}=\sum_k\sum_{(i,p)\in\mathcal T_k}\rho_{Huber}\left(\|\pi_i(X_k)-x_{i,p}\|^2\right)$$πi(Xk) 是三维路标在第 i 台相机中的投影,xi,p 是实际二维特征位置。Huber 核限制了离群匹配对大范围相机调整的支配。全局初始化提供的是稳定起点,而不是最终答案。
训练期的联合优化
进入 3DGS 后,系统同时优化高斯参数和相机位姿。光度损失比较渲染图与实际输入:
$$\mathcal L_{photo}=(1-\lambda_{SSIM})\|\hat I-I\|_1+\lambda_{SSIM}(1-SSIM(\hat I,I))$$论文设置 λSSIM=0.2。第一项约束逐像素亮度差异,第二项保留局部结构。这个损失对高斯外观很强,却并不直接知道同名特征点应该落在同一个三维位置;如果只依赖它,相机与高斯可以通过多种解共同降低训练图像误差。
GloSplat 因而在训练中保留一条基于特征轨迹的光束法平差项:
$$\mathcal L_{BA}^{joint}=\sum_k\sum_{(i,p)\in\mathcal T_k}\rho_{Huber}\left(\|\pi_i(X_k)-x_{i,p}\|^2;\delta\right)$$其 Huber 阈值为 δ=1.0。最终训练目标把两项相加:
$$\mathcal L=\mathcal L_{photo}+10^{-4}\mathcal L_{BA}^{joint}$$权重很小,是因为光度项覆盖整幅图像的大量像素,而轨迹项只在离散特征上生效。它不需要主导外观拟合,只需要持续提供几何方向,防止相机在高斯致密化过程中缓慢漂移。相机位置使用 Adam 优化,学习率设置为 1×10⁻⁵。
为什么保留独立的 SfM 路标
论文最重要的实现选择是让 SfM 轨迹点 {Xk} 与高斯均值 {μj} 保持为两组参数。一个自然的简化方案是把轨迹点直接绑定到高斯均值,让重投影损失更新高斯位置;这样参数更少,概念也更统一。但高斯的均值同时受到光度梯度和 MCMC 致密化中的重定位影响,局部高斯会为了解释某张图的颜色而移动,甚至被分裂或替换。
独立路标点不受这些外观操作支配。它像一组缓慢变化的几何锚点,给相机位姿提供稳定参照;高斯仍可自由改变形状和位置以拟合细节。消融实验显示,强行合并两组参数后,GloSplat-A 下降 0.22 dB,GloSplat-F 下降 0.19 dB。降幅不算灾难性,但它一致出现在两套不同匹配配置中,说明分离的价值来自优化动力学,而不是某一条预处理流水线的偶然结果。
实现上,系统使用 ngspalt 光栅器,并用 GPU 上的 cuDSS 稀疏求解器处理联合优化。训练进行 30000 次迭代,高斯数量上限为 300 万。作者报告联合优化带来的训练开销约为 3%,说明主要速度收益来自全局 SfM 和受限匹配图,而不是用昂贵的在线优化替换所有步骤。
实验设置与主要结果
论文在 MipNeRF360、Tanks and Temples 与 CO3Dv2 上评估新视角合成,指标包括 PSNR、SSIM 和 LPIPS。MipNeRF360 包含面向对象的室内场景和复杂户外场景,Tanks and Temples 包含更大规模的真实场景,CO3Dv2 则强调对象级多视角数据。所有速度比较在同一台 NVIDIA RTX PRO 6000 96GB 上完成,CPU 为 Ryzen 9 9950X,系统为 Ubuntu 24.04。
主表中,GloSplat-F 在三个数据集上均优于免 COLMAP 的 VGGT-X。MipNeRF360 的 PSNR 从 26.40 dB 提高到 27.77 dB,Tanks and Temples 从 24.77 dB 提高到 25.82 dB,CO3Dv2 从 31.85 dB 提高到 32.71 dB。对应增益分别为 1.37、1.05 和 0.86 dB。它还在 CO3Dv2 上超过使用 COLMAP 位姿的原始 3DGS,说明受限匹配加联合优化并没有把质量锁死在低精度路线。
| 方法 | MipNeRF360 | Tanks and Temples | CO3Dv2 |
|---|---|---|---|
| 3DGS† | 27.39 / .815 / .185 | 24.85 / .851 / .155 | 32.58 / .938 / .095 |
| MCMC† | 27.91 / .836 / .154 | 25.76 / .867 / .139 | 33.21 / .941 / .097 |
| MCMC | 22.19 / .548 / .282 | 21.42 / .679 / .278 | 25.71 / .712 / .201 |
| VGGT-X | 26.40 / .782 / .177 | 24.77 / .842 / .168 | 31.85 / .911 / .113 |
| GloSplat-F | 27.77 / .818 / .164 | 25.82 / .869 / .151 | 32.71 / .936 / .088 |
表中带 † 的方法使用 COLMAP 位姿,不带 † 的 MCMC 使用无 COLMAP 初始化。这个分组很重要。GloSplat-F 的目标不是在所有指标上超过拥有高质量 SfM 先验的版本,而是在不使用穷举 COLMAP 流程的前提下逼近甚至超过部分传统组合。它的 PSNR 在 MipNeRF360 上达到带位姿 MCMC 的 99.5%,在 Tanks and Temples 上 SSIM 略高,在 CO3Dv2 上则超过带位姿 3DGS。
在 COLMAP 兼容设置中,GloSplat-A 把 MipNeRF360 的平均 PSNR 提高到 28.86 dB。与之前最好的 Improved-GS 相比,PSNR 增加 0.67 dB,SSIM 从 .836 升到 .862,LPIPS 从 .186 降到 .139。作者将 LPIPS 的相对改善写为 25.3%,这比单看 PSNR 更能说明感知误差的下降。
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| 3DGS | 27.48 | .815 | .216 |
| AbsGS | 27.52 | .820 | .198 |
| PixelGS | 27.62 | .824 | .189 |
| MiniSplatting-D | 27.57 | .832 | .176 |
| TamingGS | 27.96 | .822 | .207 |
| 3DGS-MCMC | 28.01 | .835 | .186 |
| SteepGS | 27.05 | .795 | .247 |
| Perceptual-GS | 27.77 | .829 | .187 |
| Improved-GS | 28.19 | .836 | .186 |
| GloSplat-A | 28.86 | .862 | .139 |
定量结果背后的机制
论文的消融实验比主表更清楚地解释了增益来源。若完全冻结位姿,PSNR 只有 19.18 dB,比完整方法低 8.59 dB;若去掉重投影项、只保留光度监督,结果为 26.96 dB,下降 0.81 dB。前者说明无 COLMAP 初值不能忽略相机优化,后者说明光度梯度本身不足以稳定恢复几何。
去掉 MCMC 致密化后,结果降到 26.02 dB,下降 1.75 dB。联合位姿优化需要足够灵活的高斯集合来表示细节,否则正确的相机也无法弥补容量不足。COLMAP 穷举匹配加联合优化达到 28.52 dB;与初始路线比较,作者把总改善拆成联合优化贡献 0.61 dB、全局 SfM 贡献 0.34 dB。COLMAP 检索路线若不联合优化会跌到 17.93 dB,说明受限匹配图比穷举匹配更依赖训练期位姿修正。
特征与匹配器的替换也影响很大。SuperPoint+SuperGlue 得到 27.06 dB,比完整 GloSplat-F 低 0.71 dB;DISK 降到 19.65 dB,R2D2 降到 17.54 dB;NetVLAD 为 26.35 dB,OpenIBL 为 20.68 dB,DIR 则出现失败。这些结果限制了“任何现成特征都能被联合优化救回来”的推断。GloSplat 能补偿轻微位姿误差,却无法从严重错误或缺失的对应图中重建可靠几何。
速度与位姿质量
论文在 Courthouse 场景上比较 250 到 1000 张图像的端到端时间。250 张时,COLMAP 用时 644.6 秒,GloSplat-A 为 222.2 秒,VGGT-X 为 53.9 秒,GloSplat-F 为 100.2 秒。500 张时,四条路线分别为 1165.0、408.2、113.3 和 191.9 秒。小规模下,前馈模型 VGGT-X 有明显速度优势。
图像数量继续增加后,趋势发生变化。750 张时,GloSplat-F 用时 250.0 秒,已经低于 VGGT-X 的 249.6 秒附近并接近持平;到 1000 张时,GloSplat-F 为 327.8 秒,VGGT-X 为 398.9 秒,GloSplat-A 为 1371.3 秒,COLMAP 为 4349.2 秒。于是 GloSplat-F 相对 COLMAP 的加速达到 13.3 倍,相对 VGGT-X 约为 1.2 倍;GloSplat-A 相对 COLMAP 仍快 3.2 倍。
| 输入图像数 | COLMAP | GloSplat-A | VGGT-X | GloSplat-F |
|---|---|---|---|---|
| 250 | 644.6 | 222.2 | 53.9 | 100.2 |
| 500 | 1165.0 | 408.2 | 113.3 | 191.9 |
| 750 | 2226.3 | 855.7 | 249.6 | 250.0 |
| 1000 | 4349.2 | 1371.3 | 398.9 | 327.8 |
这组时间并不表示 GloSplat 在所有规模下都快。它对小规模输入的固定开销较高,尤其在 250 到 500 张范围落后于 VGGT-X。真正的工程价值是尺度增长后的斜率:检索图让每张图只连接固定数量的邻居,而全局 SfM 能并行处理所有相机,减少了增量注册的串行瓶颈。
ScanNet 的位姿比较进一步说明这种机制不只改善图像指标。场景 0301_00 中,COLMAP 的旋转误差为 133.83°,ATE 为 0.169 米,PSNR 为 23.63 dB;3RGS 降到 9.30°、0.009 米和 30.11 dB;GloSplat-F 进一步达到 7.82°、0.007 米和 31.24 dB。另两个场景也呈现相似趋势。所有结果仍是离线评估,不能直接等价为机器人实时定位能力,但至少说明联合几何项确实改变了相机估计,而不只是提升渲染外观。
| 场景 | COLMAP R / ATE / PSNR | 3RGS R / ATE / PSNR | GloSplat-F R / ATE / PSNR |
|---|---|---|---|
| 0079_00 | 3.55° / .014 / 30.78 | 2.45° / .014 / 32.58 | 2.12° / .011 / 33.42 |
| 0301_00 | 133.83° / .169 / 23.63 | 9.30° / .009 / 30.11 | 7.82° / .007 / 31.24 |
| 0418_00 | 5.03° / .012 / 29.03 | 4.34° / .012 / 31.62 | 3.78° / .010 / 32.35 |
定性结果
Bonsai 场景的对比重点在细枝、叶片和背景边缘。原始参考图的枝条结构细且层次多,任何相机误差都可能使高频细节在多个视角之间无法对齐。GloSplat-A 在该场景报告 36.39 dB 和 0.060 LPIPS,VGGT-X 为 27.82 dB 和 0.083 LPIPS,PSNR 相差 8.57 dB。这个场景支持论文的核心论点:训练期相机修正对高细节、近距离对象更明显。
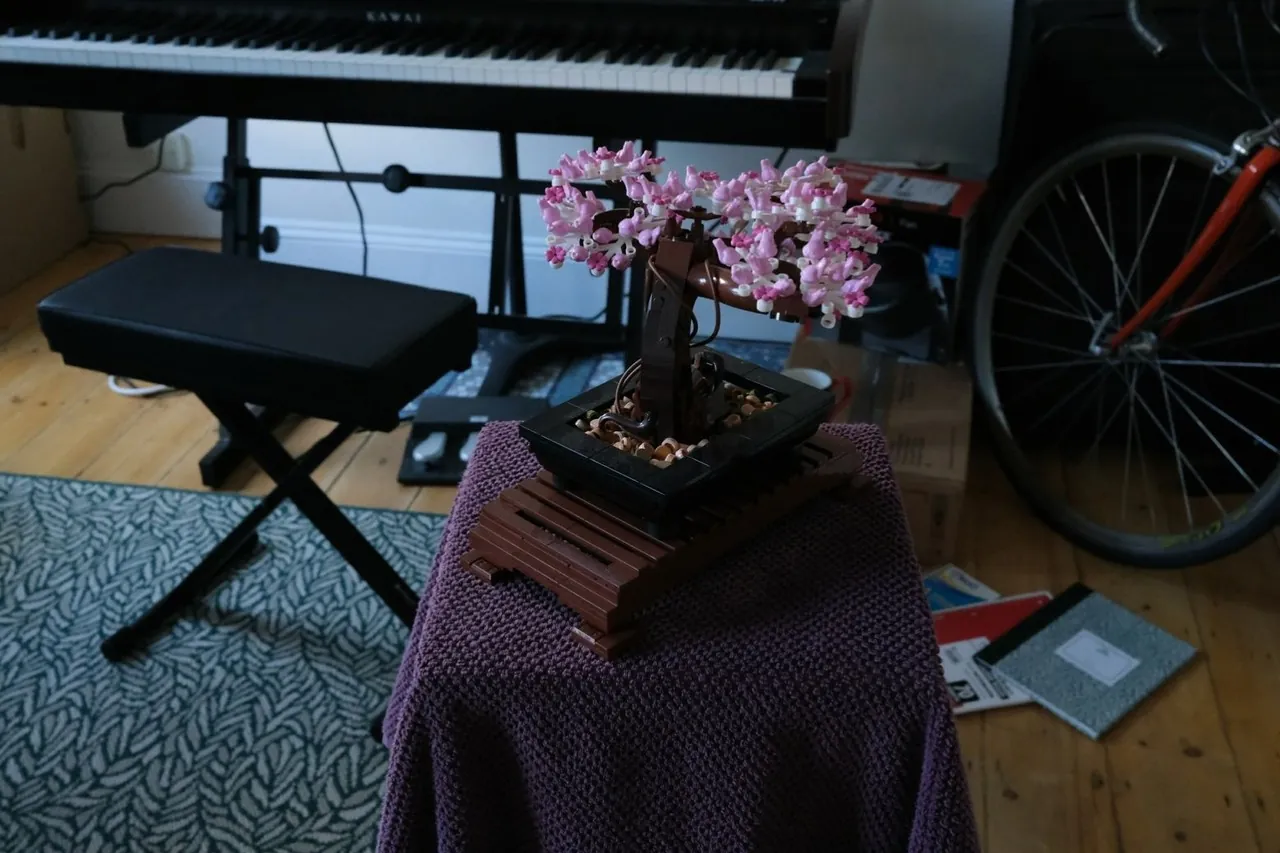
图 2:Bonsai 场景的真实参考视角,对应论文定性 Figure 4 的第一幅面板。
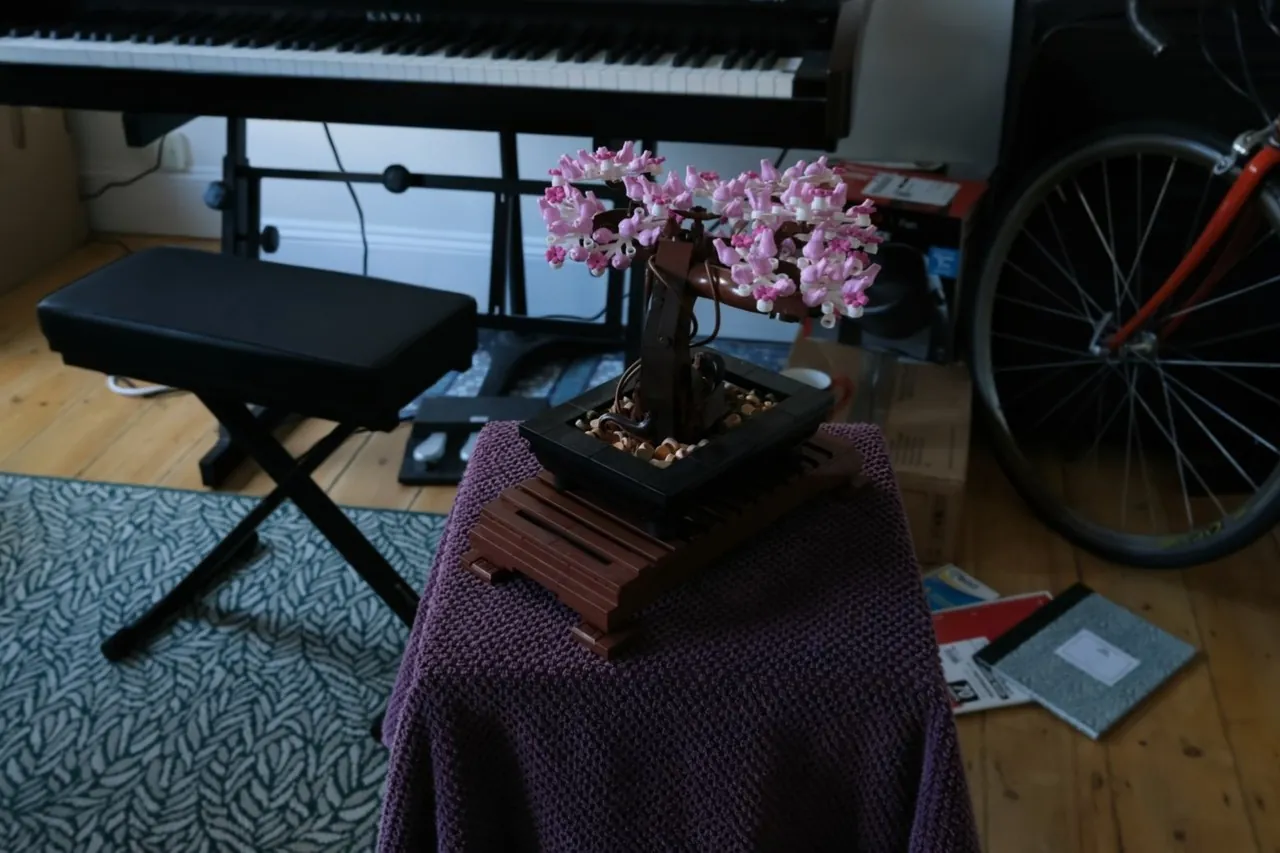
图 3:GloSplat-A 在 Bonsai 的渲染,论文报告 36.39 dB PSNR 与 0.060 LPIPS。
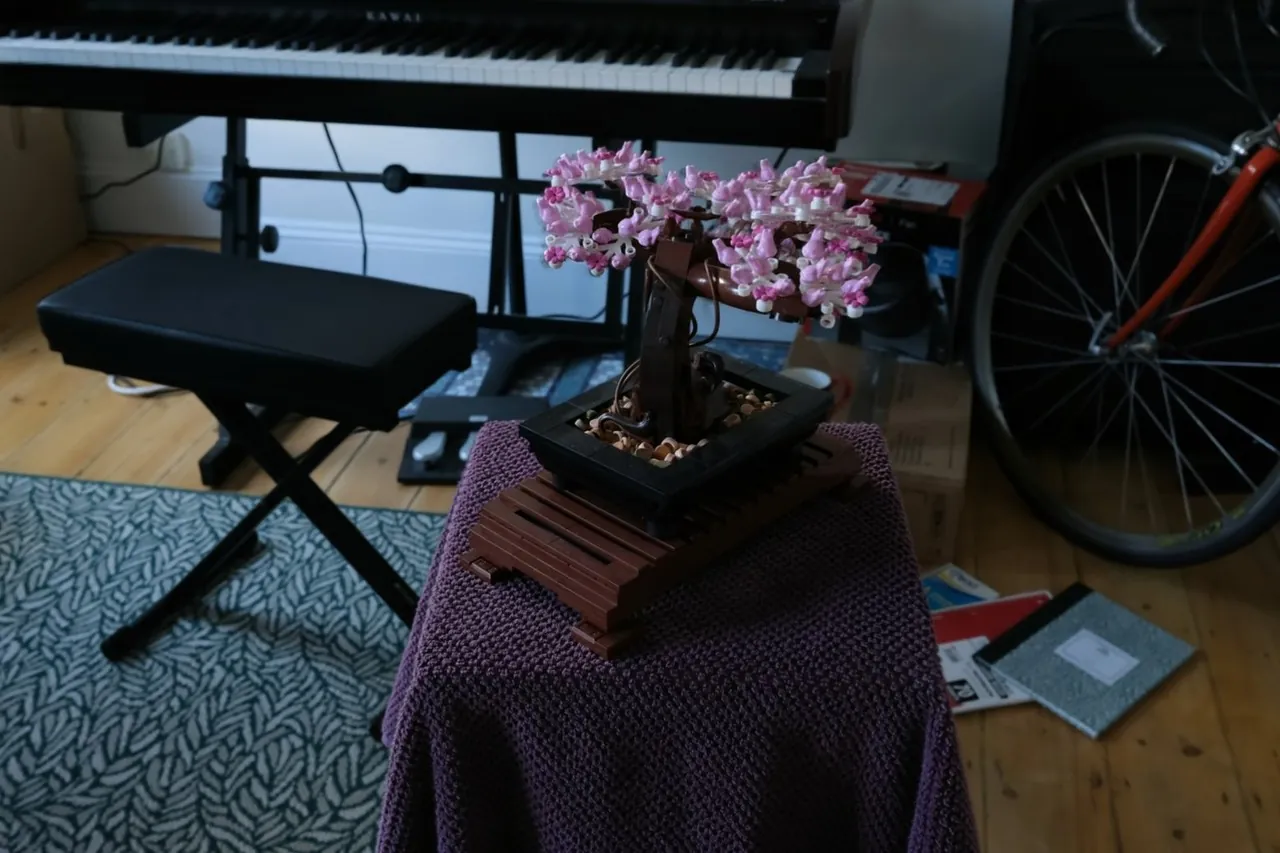
图 4:GloSplat-F 在 Bonsai 的渲染。它使用检索匹配与轻量特征,目标是接近高质量路线的视觉结果。
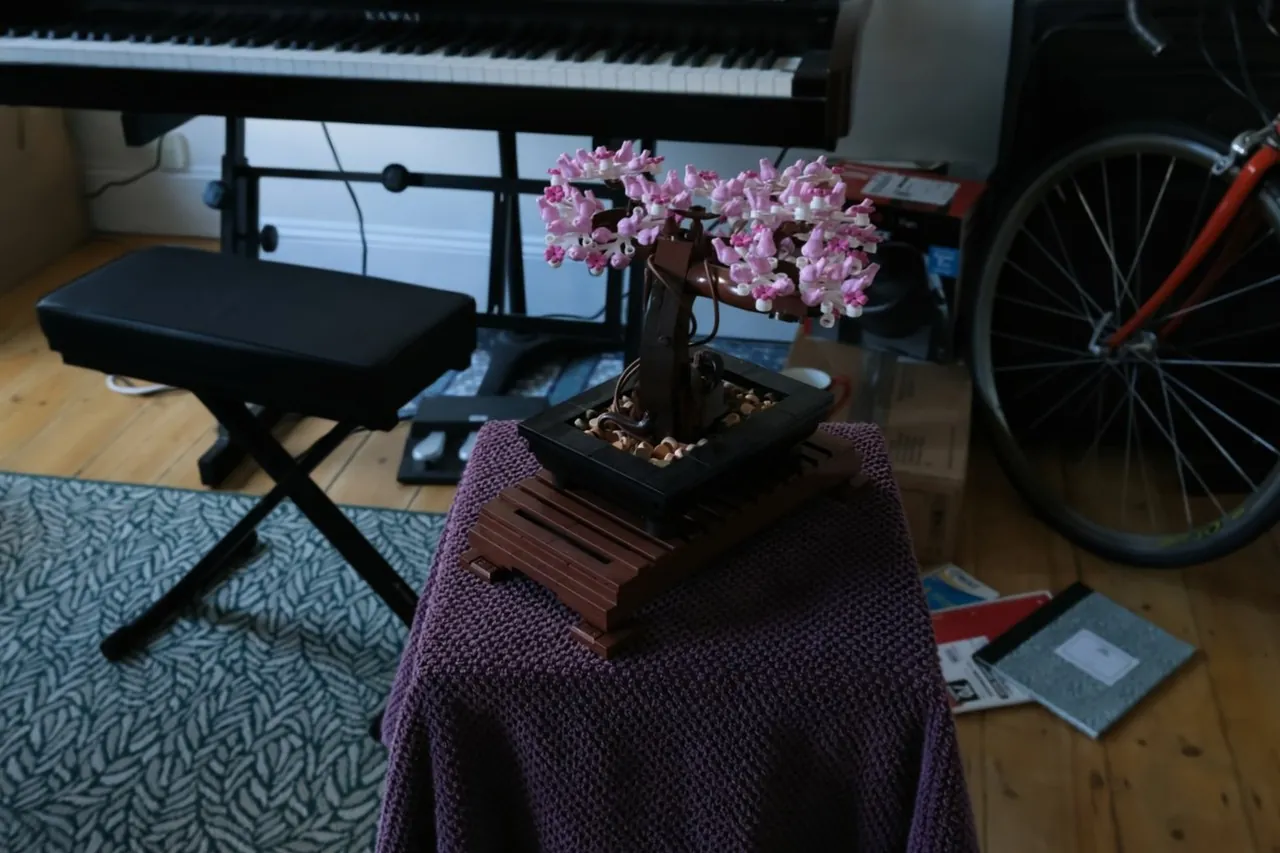
图 5:VGGT-X 在 Bonsai 的渲染,论文报告 27.82 dB PSNR 与 0.083 LPIPS。
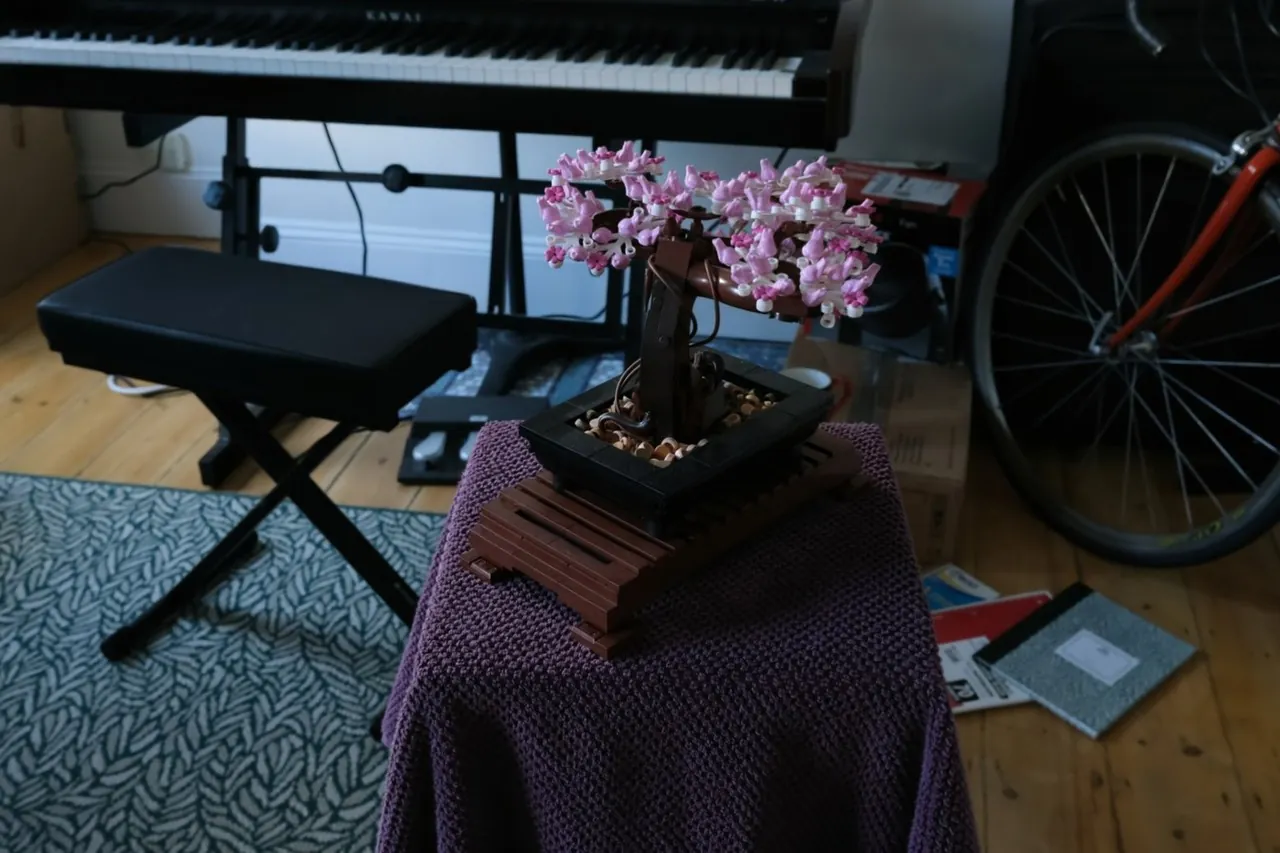
图 6:Improved-GS 在 Bonsai 的渲染,是论文 COLMAP 兼容比较中的强基线。
Flowers 场景则突出薄花瓣与密集植被。论文报告 GloSplat-A 为 24.88 dB 和 0.147 LPIPS,VGGT-X 为 18.13 dB 和 0.273 LPIPS,PSNR 提高 6.76 dB,LPIPS 相对降低约 46%。这类场景中,错误位姿带来的细结构重影很难只靠提高高斯数量解决,因为每个高斯仍需要在相机之间保持一致的投影关系。
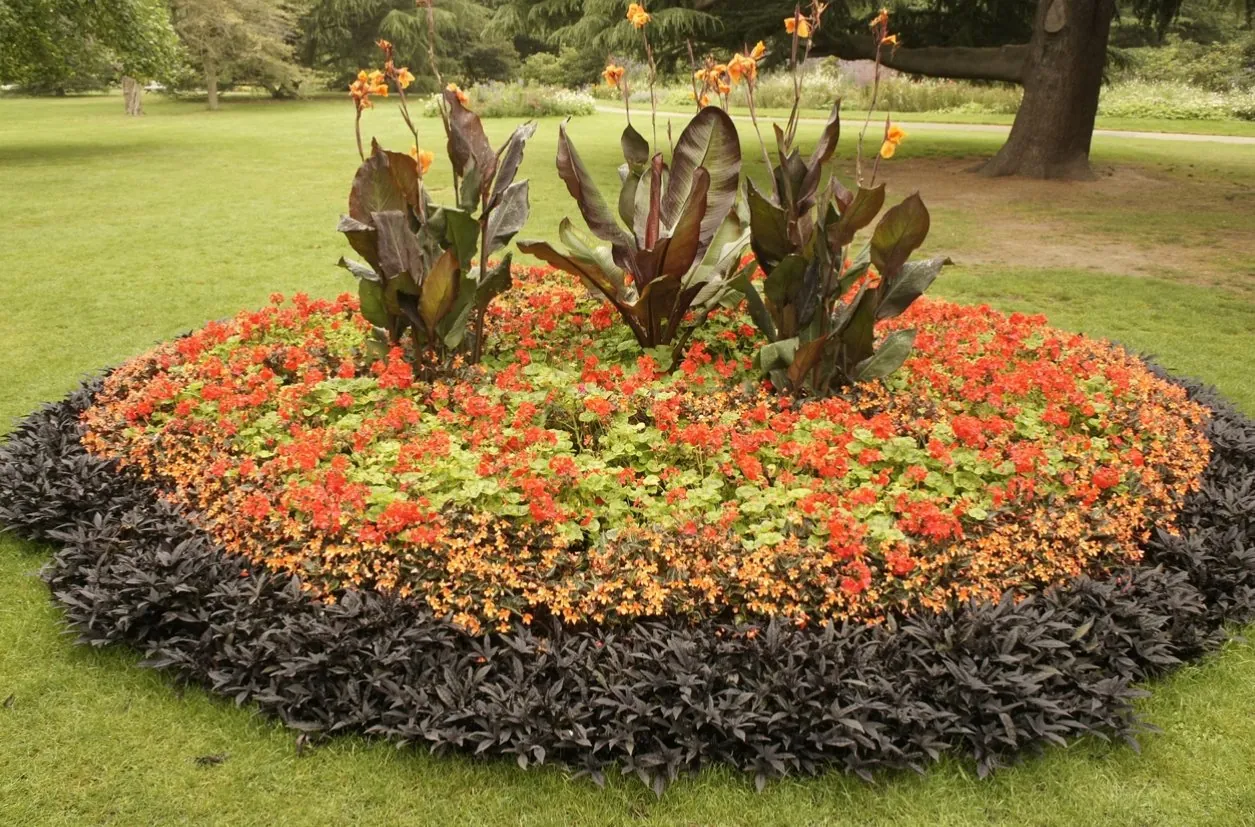
图 7:Flowers 场景的真实参考视角,包含密集花瓣和细小叶片。
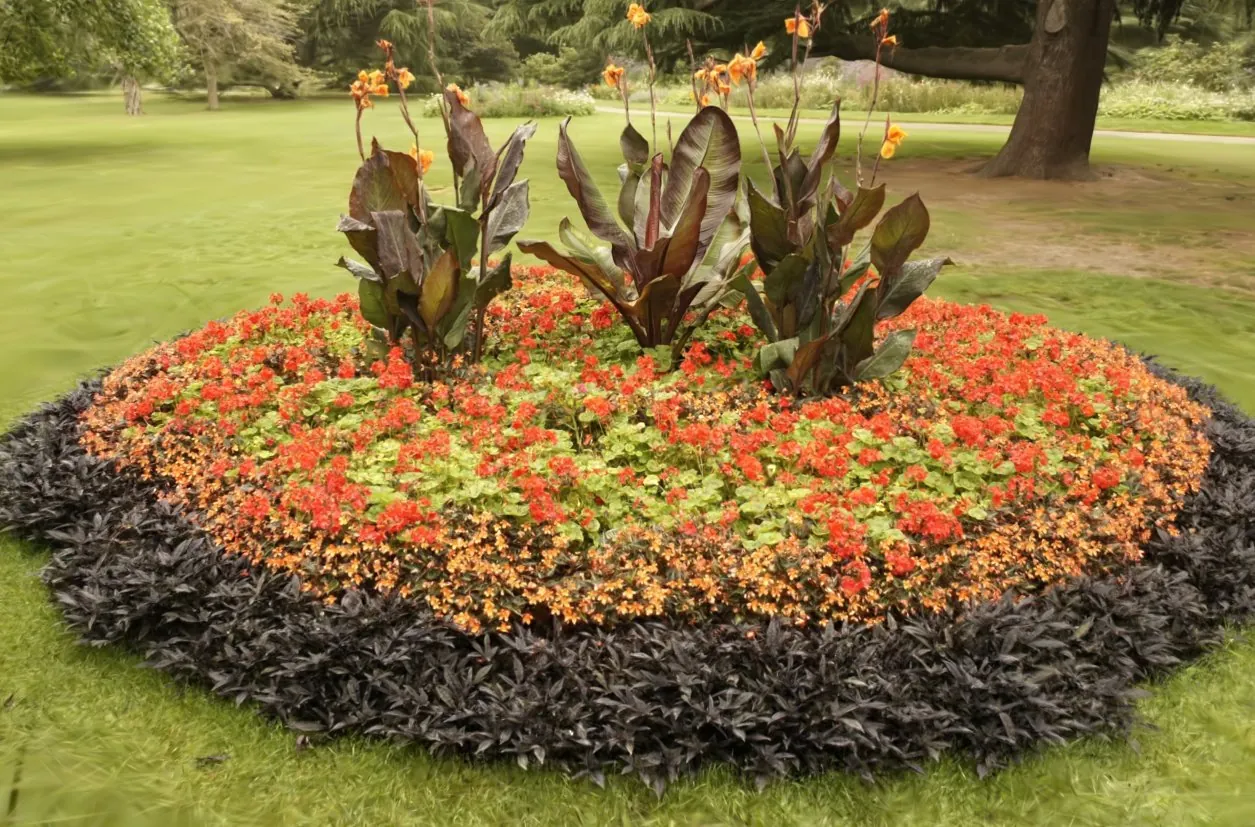
图 8:GloSplat-A 在 Flowers 的渲染,论文报告 24.88 dB PSNR 与 0.147 LPIPS。
论文还把定性结果扩展到 Garden 场景,并报告相对 VGGT-X 的 PSNR 增益为 5.69 dB。附录中三组场景的增益都集中在复杂细节与几何边缘,而不是单纯的色彩匹配。不过论文没有给出人工感知研究,也没有展示失败视角,因此定性图能够支持方法方向,却不足以覆盖真实部署中的全部退化条件。
局限与工程判断
第一项局限由作者明确承认:特征提取、匹配和配对检索仍是冻结的。联合优化不能把梯度传回特征网络,也不能主动发现检索阶段遗漏的视角。如果图像集合本身缺乏足够重叠,或检索器把关键观测排在前五之外,全局 SfM 会得到错误轨迹,后续光束法平差只能修正局部误差,无法凭空创造正确对应。
第二项局限是评测范围。论文宣称该重建流程可以服务机器人仿真,但实验只使用新视角合成基准,没有测量机器人导航、抓取或操作任务中的成功率,也没有测量在线运行延迟、内存峰值、连续视频顺序、低纹理环境或仿真到现实的迁移收益。因此这里得到的是高质量环境重建证据,不是机器人系统级证据。
第三项问题来自版本比较。GloSplat-F 与 GloSplat-A 同时改变了特征、匹配策略和图结构,论文报告的两者差距不能解释成“只换配对策略”的纯消融。实际选型需要在自己的图像规模、重叠程度和延迟预算上重测,而不能直接按 1000 张图像的单一场景曲线决定。
从系统角度看,300 万高斯上限、30000 次训练以及 GPU 稀疏求解都需要可观的显存与调参。论文给出约 3% 的联合训练额外开销,但没有把预处理、特征匹配、内存占用和所有失败案例放进同一张成本表。工业部署还关心恢复能力,例如某一批视角匹配错误后能否被检测并回退,这在论文中没有展开。
尽管存在这些边界,GloSplat 对机器人三维感知仍有直接启发。机器人采集视频通常存在连续运动、曝光变化和弱纹理区域,固定使用一次 SfM 结果会让小位姿偏差不断积累。把稀疏轨迹作为长期几何约束,把图像外观作为短周期监督,是一个可扩展的优化结构。真正落地时可以把冻结特征替换成任务专用的实时特征,也可以把联合优化限制在关键帧集合,以减少训练成本。
结论
GloSplat 的主要贡献不是“更复杂的三维高斯损失”,而是重新划分了位姿估计与外观优化的边界。全局 SfM 提供稳定初值,训练中的光度损失提高画面拟合,独立特征轨迹和 Huber 重投影项负责维持几何一致。三者在时间上连续、在参数上分离,使相机不会完全冻结,也不会被渲染梯度随意拖动。
实验结果支持这一设计:快速版本在三个数据集上超过 VGGT-X,在图像规模增大后表现出更好的时间增长曲线;高精度版本在 MipNeRF360 上达到 28.86 dB,并显著降低感知误差。最有价值的后续工作不是继续堆叠平均值,而是把方法放到机器人连续视频、主动视角选择和真实仿真任务中,测清它何时确实减少了重建误差,何时又会被冻结检索与计算预算限制。
金句
相机可以接受外观梯度的修正,但不能让外观梯度改写几何基准。GloSplat 的关键,是给每一轮渲染优化留一根不会随高斯移动而漂走的几何锚。