PAPER DEEP DIVE
UniQueR:用稀疏三维查询做前馈式三维重建
把前馈式重建从逐像素的 2.5 维预测改成一组稀疏三维查询的推断:查询位于全局三维空间而非某一帧的相机空间,因此能把高斯摆到从未被观测到的遮挡区域。默认 4096 个查询各派生 64 个高斯,合计约 26 万个基元,比逐像素方法少一个数量级。Mip-NeRF 360 三视角新视角合成 PSNR 达 22.70(AnySplat 为 20.08),单次前向 0.213 秒;32 视角下基元少 15 倍、显存省 40%、深度绝对相对误差从 0.062 降到 0.038。稠密视角纯前馈落后于 AnySplat,但作为逐场景优化的初值反超(PSNR 25.14 对 24.99)。代码未公开,未做复现。
论文元信息
标题:UniQueR: Unified Query-based Feedforward 3D Reconstruction
作者:Chensheng Peng, Quentin Herau, Jiezhi Yang, Yichen Xie, Yihan Hu, Wenzhao Zheng, Matthew Strong, Masayoshi Tomizuka, Wei Zhan
机构:Applied Intuition、加州大学伯克利分校、斯坦福大学
预印本:arXiv:2603.22851v1 [cs.CV],2026 年 3 月 24 日
会议:ECCV 2026(项目页已挂会议海报)
项目页:uniquer3d.github.io
代码状态:❌ 截至本文撰写时未提供公开代码。全文与项目页均未给出仓库链接,GitHub 亦无同名官方实现。可复现性只能依赖其明确声明的基座:DINOv2 编码器与点云头从 Pi3 初始化并冻结,数据处理沿用 MapAnything,测试时优化协议沿用 AnySplat。
一句话总结
UniQueR 把前馈式三维重建从「给每个像素预测一个深度或高斯」改成「让一组稀疏的可学习三维查询点去推断场景」——查询点活在全局三维空间而非某一帧的相机空间,因此可以把高斯摆到谁都没看见过的遮挡区域里,一次前向就能补出完整几何。
研究背景与动机
从二维照片恢复三维结构,是机器人、自动驾驶与数字内容生产共同依赖的底层能力。传统路线是运动恢复结构(SfM)、多视图立体(MVS)与同步定位与建图(SLAM):靠特征匹配与几何优化同时解出相机位姿与稠密点云。它们在受控环境下可靠,一旦遇到视角稀疏、纹理缺失或视觉歧义,匹配就会崩。
深度学习带来第二条路线:神经辐射场与三维高斯泼溅。这类方法把重建变成「每个场景优化一次」的过程,视觉保真度和多视角一致性都很好,但代价是单场景要跑几分钟甚至几小时,而且无法把大规模数据里学到的几何先验迁移到新场景——每来一个新场景都得从头优化一遍。
第三条路线就是近年的前馈式重建:DUSt3R、VGGT、Pi3 等工作证明,用 Transformer 或代价体积抽取多视图特征后,单次前向就能从二维观测直接恢复三维几何。它们通常输出深度图、法向图或点云图这类中间表示,凭借大规模数据里的深度先验获得了很强的泛化能力。这条路的吸引力在于它有可能成为机器人与具身智能通用的三维感知骨干网络。
但这里藏着一个结构性缺陷:这些表示本质上是逐像素对齐的 2.5 维。输出绑死在输入像素上,意味着模型只能描述「被看到的表面」。相机没照到的背面、被前景挡住的区域,在输出里根本没有对应的像素,于是重建结果在这些地方直接开洞。图 1 把这条分界线画得很清楚。
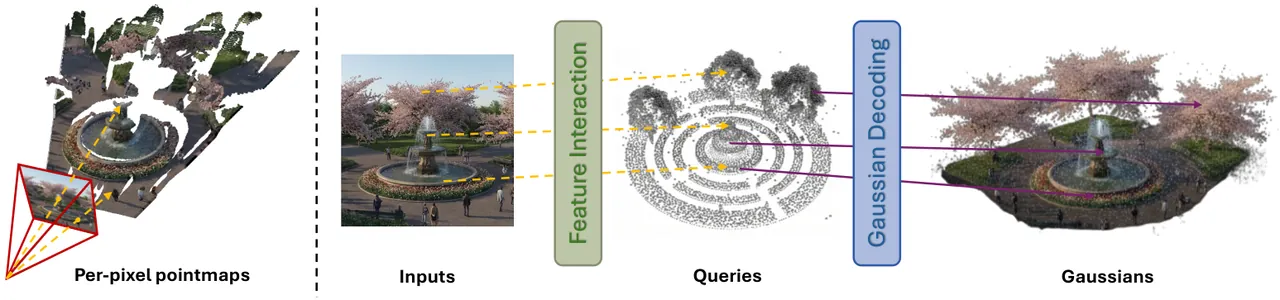 图 1:像素对齐方法与基于查询方法的对比。像素对齐的表示在无观测区域留下空洞,而 UniQueR 的查询可以在全局空间里覆盖被遮挡区域。
后续工作试图把前馈输出从点云扩展成更有表达力的表示:MVSplat、NoPoSplat 等直接预测与像素对齐的高斯,效率和完整性有提升,但「像素对齐」这个根本约束没有变——高斯的出生地仍然只能是输入像素的反投影位置。UniQueR 的出发点就是拆掉这个约束。
预备知识
三维高斯泼溅用一组带颜色与不透明度的三维高斯基元表示场景,通过可微的光栅化渲染成图像。它的价值在 UniQueR 里不是「渲染效果好」,而是提供了一座从三维几何通往二维监督信号的可微桥梁:只要有渲染器,就能用海量易得的 RGB 与深度信号去监督三维结构,而不必依赖昂贵的真值三维标注。
另一个前置是 DETR 式的查询范式:用一组可学习的查询向量,通过注意力从图像特征里聚信息,直接解码出检测结果。UniQueR 把它搬到三维重建上,但马上遇到了一个 DETR 不存在的问题——DETR3D 有三维包围盒当监督,查询可以从随机初始化稳定收敛;而三维重建没有这种逐查询的三维真值,随机初始化会让训练直接发散。这个矛盾催生了它的混合初始化设计。
方法详解
整体框架
输入是 $N$ 张无位姿的 RGB 图像 $\{\mathbf{I}_i\}_{i=1}^{N}$。系统维护 $Q$ 个可学习的三维查询 $\mathcal{Q}=\{\mathbf{q}_i\}_{i=1}^{Q}$,每个查询带一个三维位置 $\mathbf{p}_i$,并由它派生出 $K$ 个三维高斯。所有查询派生出的高斯集合
$$\mathcal{G}=\{\mathbf{g}_{ij}\}_{i=1,j=1}^{Q,K}$$
构成整个场景的表示,可在任意相机视角 $\pi\in\mathbb{SE}(3)$ 下可微渲染为 $\hat{\mathbf{I}}=\mathrm{Render}(\mathcal{G},\pi)$。默认配置为 $Q=4096$、$K=64$,合计约 26 万个高斯。
与此同时,图像侧沿用 VGGT 与 Pi3 的范式,映射出每帧的三维标注:相机位姿 $\mathbf{P}_i$、点云图 $\mathbf{X}_i$ 与置信度图 $\mathbf{C}_i$,即
$$f\big(\{\mathbf{I}_i\}_{i=1}^{N}\big)=\{(\mathbf{P}_i,\mathbf{X}_i,\mathbf{C}_i)\}_{i=1}^{N}$$
这一支不直接产出最终几何,而是为查询的更新提供先验。
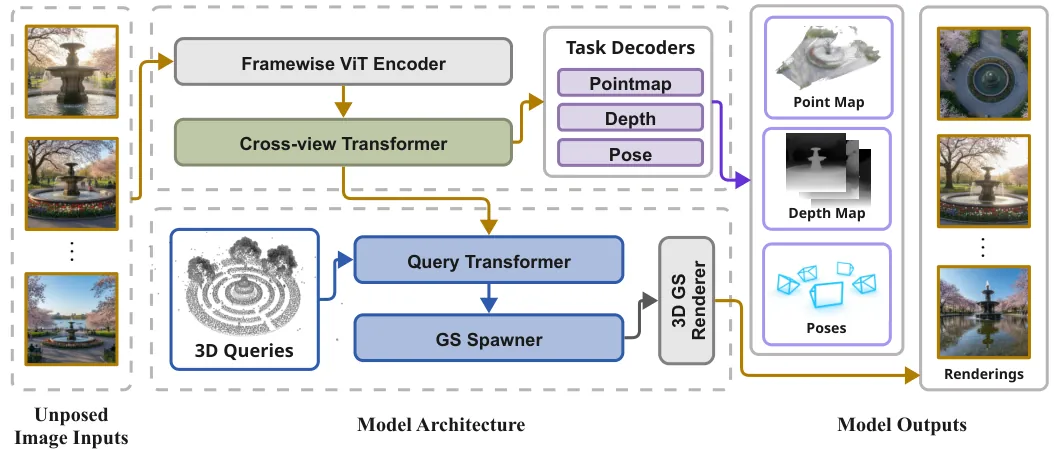 图 2:UniQueR 流水线总览。视觉编码器抽取每帧 token 并解码位姿与点云图,三维查询经与图像 token 的交叉注意力和查询间自注意力反复更新,每个查询派生出若干高斯,由可微泼溅渲染并接受 RGB 与深度监督。
图像分词与几何先验解码
每帧先用 DINOv2 这一视觉 Transformer 骨干抽取语义token:
$$\mathbf{T}_i=\mathrm{DINO}(\mathbf{I}_i)\in\mathbb{R}^{HW/p^{2}\times d}$$
其中 $p$ 为分块尺寸、$d$ 为token维度。选 DINOv2 的理由是它的语义表示足够强,这对后续跨视角关联很关键。随后按 VGGT 与 Pi3 的做法施加交替注意力 Transformer,在帧内注意力与帧间注意力之间交替:
$$\{\mathbf{T}_i^{l+1}\}=\mathrm{AA\text{-}Transformer}(\{\mathbf{T}_i^{l}\})$$
聚合后的token分两路使用。一路解码出相机位姿、点云图与置信度图,作为观测表面的几何先验;另一路送进查询 Transformer,供查询吸收信息。
查询初始化:一半接地气,一半去探险
这是全文最值得细读的一处设计。每个查询携带显式的三维位置,要占据场景中的某个空间区域。若沿用 DETR 那套随机可学习初始化,训练会因缺乏几何锚点而发散——因为这里没有三维真值来给每个查询分配监督目标。
作者的解法是混合策略:一半查询从第一阶段预测出的非度量点云图上采样,让它们落在与观测到的 2.5 维表面对齐的粗糙结构上;另一半作为可学习锚点,在三维空间里均匀采样,专门去探索和重建那些重建不足或根本没被观测的区域。前者保证稳定,后者保证完整。消融实验会告诉我们后者有多不可替代。
解耦注意力:把平方复杂度拆开
查询与图像token一起送进查询 Transformer:
$$\mathcal{Q}=\mathrm{QueryTransformer}(\mathcal{Q},\mathcal{T})$$
查询数量比稠密表示里的高斯数量少几个数量级,这是效率优势的来源。但随着输入图像数增加,图像token线性增长,注意力开销会失控。最直接的做法是把查询与图像token拼接后做全自注意力:
$$\mathcal{Q},\mathcal{T}=\mathrm{Self\text{-}Attn}([\mathcal{Q},\mathcal{T}])$$
其复杂度为 $\mathcal{O}((Q+NHW/p^{2})^{2})$,在高分辨率下昂贵到不可用。
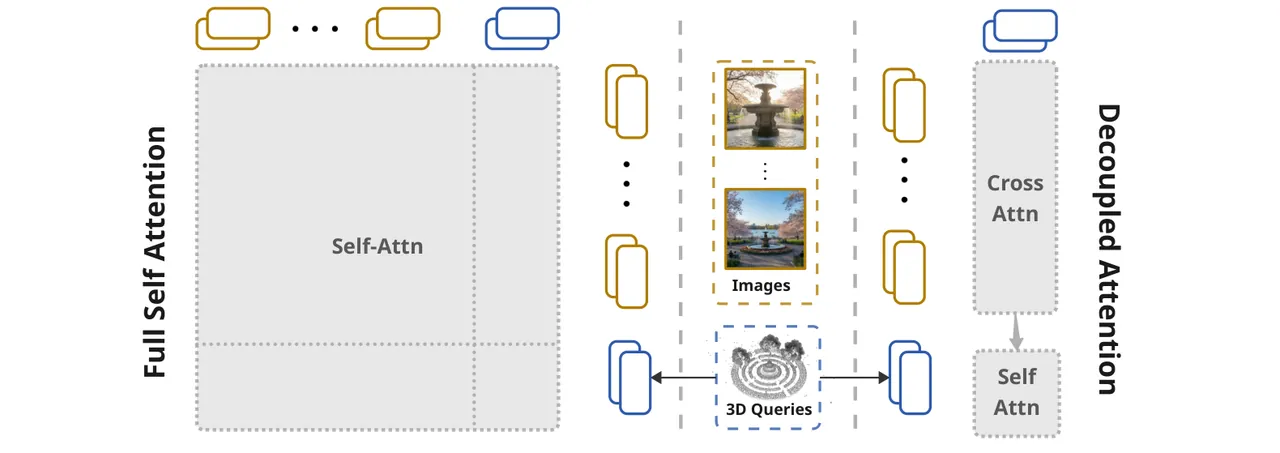 图 3:两种注意力设计的对比。上图为拼接后全自注意力,下图为本文的解耦设计:先由查询对图像做交叉注意力,再在查询之间做自注意力。
于是作者改用解耦设计:先让查询对图像token做交叉注意力吸收信息,再在查询之间做自注意力:
$$\mathcal{Q}=\mathrm{Cross\text{-}Attn}(\mathcal{Q},\mathcal{T}),\qquad \mathcal{Q}=\mathrm{Self\text{-}Attn}(\mathcal{Q})$$
复杂度降为 $\mathcal{O}(QNHW/p^{2}+Q^{2})$。这一改动换来的是实打实的显存节省,也让模型能扩展到更大的尺寸、更高的分辨率和更多的查询。
位置编码同样讲究:图像token的位置编码由预测的相机位姿转换成 Plücker 射线嵌入,查询则直接以自身的三维坐标作为位置嵌入。两侧都在同一个三维坐标系里说话,几何交互才有意义。
高斯派生与训练监督
有了三维真值缺失这个前提,三维高斯泼溅就成了唯一可行的监督通路:把三维基元渲染到图像平面,用丰富的二维信号去约束三维结构。具体地,每个查询 $\mathbf{q}_i$ 先预测一个查询自身的形变 $\delta\mathbf{q}_i$,让查询移动到几何一致的位置;再用一个多层感知机解码出 $K$ 个高斯偏移 $\delta\mathbf{g}_{ik}$,以残差方式叠加到变形后的查询中心上:
$$\mathcal{G}=\bigcup_{i=1}^{Q}\bigcup_{k=1}^{K}\big(\mathbf{p}_i+\delta\mathbf{q}_i+\delta\mathbf{g}_{ik},\ \Sigma_{ik},\ \mathbf{c}_{ik},\ \alpha_{ik}\big)$$
其中 $\Sigma_{ik}$、$\mathbf{c}_{ik}$、$\alpha_{ik}$ 分别是由外观解码器预测的协方差、颜色与不透明度。稀疏查询负责效率,派生出的稠密高斯负责细节。
监督信号有三项:渲染 RGB 的重建损失($\ell_1$ 与 LPIPS 组合)、渲染深度上的尺度不变深度损失,以及从骨干网络保留下来的相机损失:
$$\mathcal{L}=\mathcal{L}_{\mathrm{rgb}}+\lambda_d\mathcal{L}_{\mathrm{depth}}+\lambda_c\mathcal{L}_{\mathrm{cam}}$$
真正让「补全遮挡」这件事发生的是监督视角的选取策略:监督所用视角是输入视角的超集。给 3 张输入图时,会在 6 个视角(3 个输入加 3 个留出)上渲染并计算损失。如果模型只肯重建输入视角里看得见的部分,那么留出视角上就会出现空洞,这些空洞会被留出视角的真值图像直接惩罚。换句话说,模型必须为没看到的视角负责,才会学着去补没看到的几何。
训练采用分阶段策略:DINOv2 编码器与点云头从 Pi3 初始化并保持冻结,只训练相机头与查询 Transformer,用 AdamW(学习率 $1\times10^{-4}$,余弦衰减)在 32 张 A100 上以 $224\times224$ 分辨率训 100 轮,再以 $448\times448$ 微调 20 轮;每个样本随机采样 2 到 64 个输入视角。推理时还可沿用 AnySplat 的测试时优化,以预测的高斯为初值、预测位姿为输入,回渲到输入视角做若干步微调。
flowchart LR
  A[多视角无位姿图像] --> B[DINOv2 分词]
  B --> C[交替注意力 Transformer]
  C --> D[解码位姿 点云图 置信度]
  C --> E[图像 token 加 Plücker 位置编码]
  D --> F[点云图采样一半查询]
  G[均匀采样可学习锚点] --> H[混合查询初始化]
  F --> H
  H --> I[查询对图像交叉注意力]
  E --> I
  I --> J[查询间自注意力]
  J --> K[预测查询形变与 K 个高斯偏移]
  K --> L[派生高斯集合]
  L --> M[可微泼溅渲染 RGB 与深度]
  M --> N[输入视角加留出视角监督]
实验结果
稀疏视角:优势最明确的地方
表 2 是本文的主战场——只给 3 张或 6 张输入图的稀疏设定,指标在新视角上计算。
| 数据集 | 方法 | 视角数 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 时间(秒)↓ |
|---|---|---|---|---|---|---|
| Mip-NeRF 360 | NoPoSplat | 3 | 18.21 | 0.482 | 0.426 | 0.416 |
| Mip-NeRF 360 | AnySplat | 3 | 20.08 | 0.606 | 0.274 | 0.279 |
| Mip-NeRF 360 | UniQueR | 3 | 22.70 | 0.660 | 0.261 | 0.213 |
| Mip-NeRF 360 | NoPoSplat | 6 | 16.06 | 0.423 | 0.540 | 2.121 |
| Mip-NeRF 360 | AnySplat | 6 | 18.29 | 0.518 | 0.336 | 0.646 |
| Mip-NeRF 360 | UniQueR | 6 | 21.80 | 0.622 | 0.300 | 0.447 |
| VR-NeRF | NoPoSplat | 3 | 21.28 | 0.744 | 0.381 | 0.406 |
| VR-NeRF | AnySplat | 3 | 19.67 | 0.745 | 0.313 | 0.290 |
| VR-NeRF | UniQueR | 3 | 21.99 | 0.708 | 0.446 | 0.198 |
| VR-NeRF | NoPoSplat | 6 | 20.69 | 0.728 | 0.426 | 2.176 |
| VR-NeRF | AnySplat | 6 | 17.25 | 0.683 | 0.411 | 0.656 |
| VR-NeRF | UniQueR | 6 | 20.87 | 0.689 | 0.431 | 0.412 |
Mip-NeRF 360 上三视角 PSNR 从 AnySplat 的 20.08 提到 22.70,同时单次前向时间从 0.279 秒降到 0.213 秒——质量与速度同向改善,这在对比表里不常见。更值得注意的是基线的表现随视角变多而变差:NoPoSplat 在六视角下 PSNR 掉到 16.06、耗时涨到 2.121 秒,说明逐像素表示在输入变多时负担急剧上升;UniQueR 则稳定在 21.80 与 0.447 秒。
但 VR-NeRF 上有一处必须点出:UniQueR 的 PSNR 赢了(21.99 对 19.67),LPIPS 却明显输给 AnySplat(0.446 对 0.313)。感知指标与像素误差指标给出了相反结论,这通常意味着重建出的结构更完整、边界更确定,但高频纹理的还原不如对手。论文没有讨论这一点。
效率与几何精度
表 5 是最能说明设计取舍的一组数据,条件是 32 个输入视角、448×448 分辨率、单张 A100 80GB、批大小为 1。
| 方法 | 高斯基元数 | 显存占用 | 推理时间(秒) | 深度绝对相对误差 ↓ |
|---|---|---|---|---|
| AnySplat | 385 万 | 18.42 GB | 4.63 | 0.062 |
| UniQueR | 26 万 | 11.19 GB | 1.97 | 0.038 |
用 15 倍更少的基元,换来 40% 的显存下降、2.4 倍的加速,深度误差还从 0.062 降到 0.038。几何更准这一点尤其重要:它说明查询表示不是靠「稀疏所以糙」来换取效率,稀疏反而让每个基元都落在更有意义的位置上。
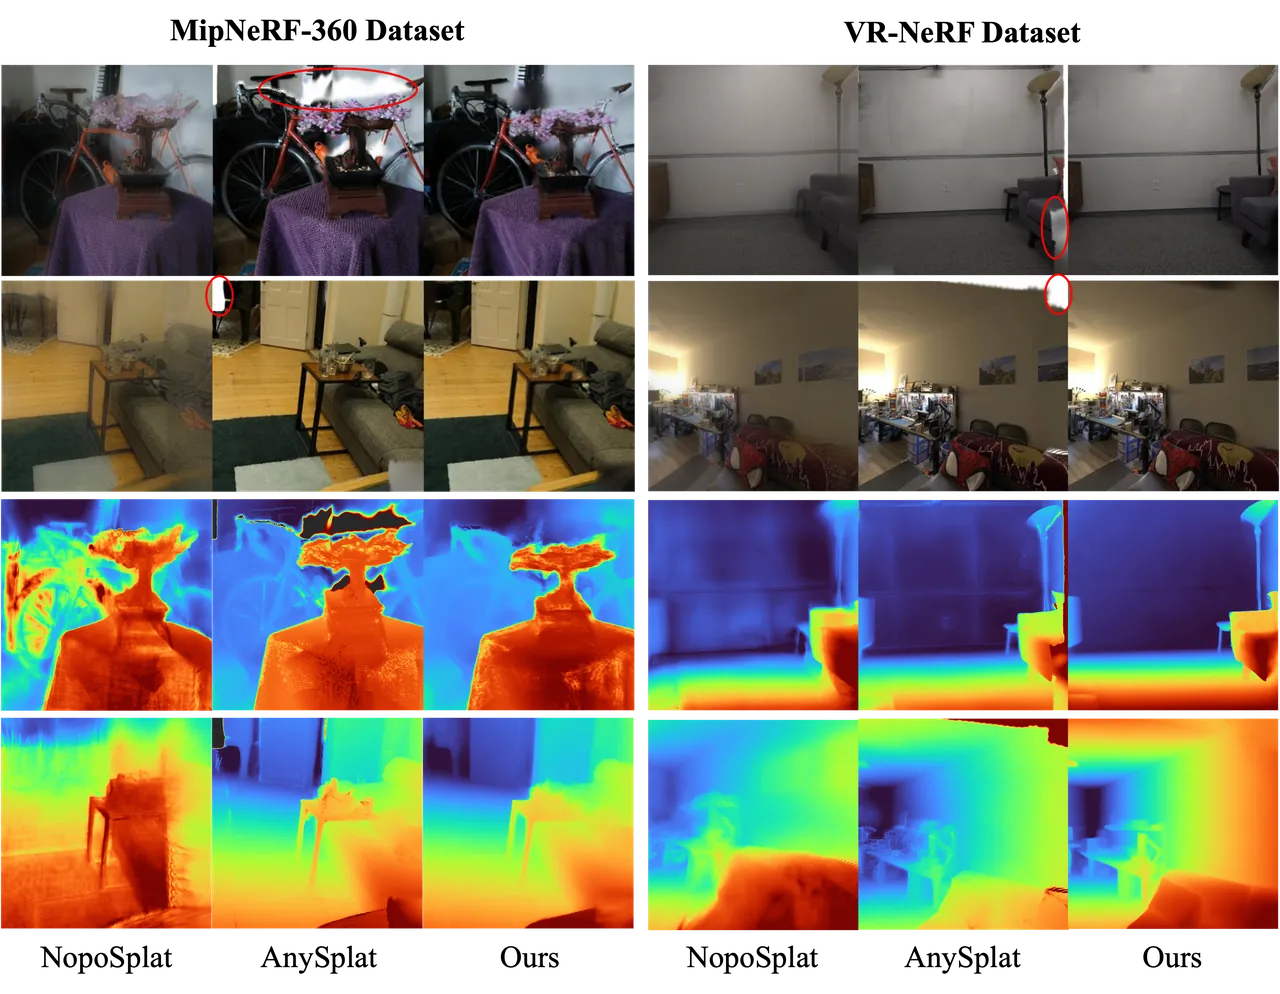 图 4:定性与几何对比。上排为新视角渲染的 RGB,下排为渲染深度。像素对齐的方法在无输入像素覆盖的区域出现空白与深度空洞,UniQueR 通过三维查询把这些区域补上。
稠密视角:优势消失,但换了个赢法
表 4 给出了 32 与 64 视角的稠密设定,这一组最容易被误读。
| 设定 | 方法 | 32 视角 PSNR | 32 视角 LPIPS | 64 视角 PSNR | 64 视角 LPIPS |
|---|---|---|---|---|---|
| 纯前馈 | AnySplat | 22.32 | 0.258 | 21.26 | 0.303 |
| 纯前馈 | UniQueR | 21.51 | 0.325 | 21.58 | 0.335 |
| 前馈+逐场景优化 | 3DGS + AnySplat | 24.99 | 0.227 | 23.71 | 0.266 |
| 前馈+逐场景优化 | 3DGS + UniQueR | 25.14 | 0.183 | 26.00 | 0.176 |
在纯前馈的稠密设定下,UniQueR 输给了 AnySplat:32 视角 PSNR 21.51 对 22.32,LPIPS 0.325 对 0.258。论文对此并不避讳,并给出了归因——它最多只有 $4096\times64=26.2$ 万个高斯,而逐像素方法会生成 $448\times448\times N$ 个基元,输入越多差距越悬殊。稀疏表示的预算是固定的,稠密输入并没有给它更多基元。
但一旦进入「前馈初始化 + 逐场景优化」的实际工作流,胜负立刻反转:以 UniQueR 的高斯做初值,3DGS 优化后达到 25.14(32 视角)与 26.00(64 视角),LPIPS 更是降到 0.183 与 0.176,明显优于以 AnySplat 为初值的结果。也就是说,它的价值在稠密场景下不是直接出图,而是给后续优化提供一个好得多的起点。原因也不难理解:更完整的初始几何加上更准的相机位姿,逐场景优化就不容易陷进局部最优。
位姿估计与消融
相机位姿方面,UniQueR 在 RealEstate10K 上取得 RRA@30 为 99.99、RTA@30 为 95.44、AUC@30 为 83.69,在 Co3Dv2 上为 99.05、97.44、88.52。与 Pi3(99.99、95.62、85.90 与 99.05、97.33、88.41)基本持平,在 Co3Dv2 上还略高。这个结果既在预期之内也值得说明:编码器本就从 Pi3 初始化,位姿能力很大程度是继承来的;论文把 RealEstate10K 上那点差距归因于 Pi3 训练时使用了私有数据。
表 6 的消融给出了两个关键结论。去掉渲染深度监督,PSNR 从 20.23 掉到 19.96,说明深度线索对稳定几何预测确有帮助;而把混合初始化换成纯随机初始化,PSNR 直接崩到 12.11、SSIM 掉到 0.259——比去掉深度严重得多。这印证了作者最初的判断:在没有三维真值监督的场景里,查询必须有一部分先落在有意义的几何位置上,训练才立得住。
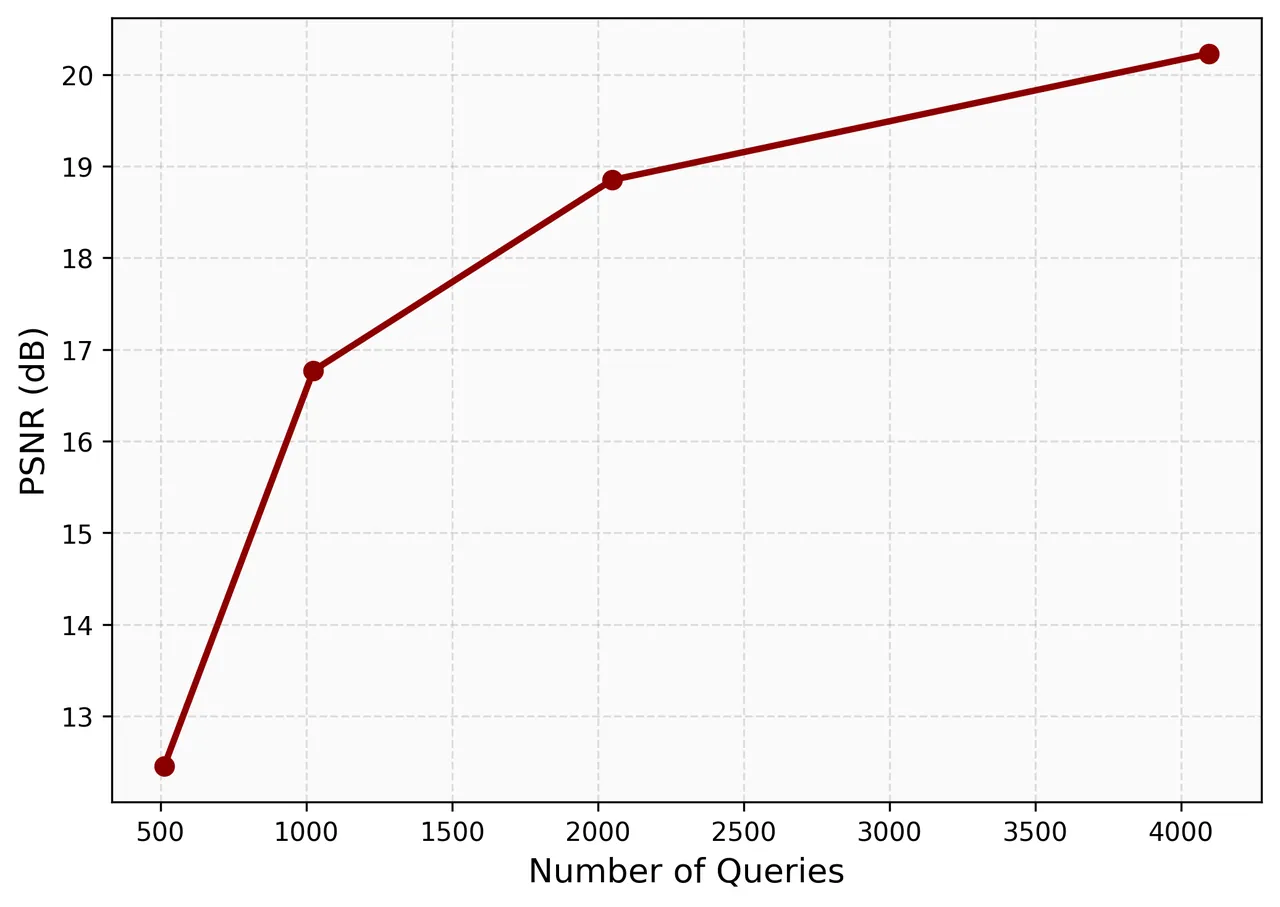 图 5:查询数量的消融。增加查询数持续提升 PSNR,呈现清晰的规模效应。
此外,查询数量、每查询高斯数(16、32、64)与模型容量三个维度上的消融都呈现一致的上升趋势,说明这套表示还远未饱和,规模扩展仍有空间。
局限性
作者自述的局限:框架不处理动态场景。查询表示是为静态场景设计的,把时序动态纳入查询形式是作者给出的下一步方向。
稠密视角下的前馈质量不占优。这是论文自己承认但容易被标题掩盖的一点:在 32 与 64 视角设定下,纯前馈的 PSNR 与 LPIPS 都落后于 AnySplat。它靠「更好的优化初值」赢回场面,可如果你的应用场景是输入很多且只跑一次前馈,那么当前的 UniQueR 并不是更好的选择。固定的基元预算是设计使然,也意味着这个短板不会随输入增多而自然消失。
VR-NeRF 上感知指标不一致。同一组实验里 PSNR 领先而 LPIPS 落后,论文没有给出解释。对看重主观观感的应用(比如内容生成),这个指标需要自己复核。
缺乏公开代码与独立复现。截至撰稿时没有官方实现,论文中所有数字均来自作者自测,我方未做复现。位姿能力又高度依赖从 Pi3 冻结继承的编码器,因此「这套查询机制单独贡献了多少」这个问题,在代码开放之前难以拆分验证。
总结与展望
UniQueR 的贡献不在把指标又推高一点,而在换掉了一个默认假设。过去的前馈重建默认「输出必须对齐输入像素」,这条约束让模型天生只能描述被看见的表面;UniQueR 把表示换成全局三维空间里的一组稀疏查询,约束就消失了——查询可以被放到没人看过的地方,只要渲染监督会为那些地方的缺失付出代价。
配套的三个工程判断同样扎实:解耦注意力把平方复杂度拆成两项之和,换来可观的显存余量;混合初始化用「一半接地气、一半去探险」解决了无三维真值时查询无法收敛的问题;而把监督视角设成输入视角的超集,则是让「补全遮挡」从愿望变成可优化的目标。三者缺一个,这套表示都立不住。
它也诚实地展示了代价:稀疏预算在稠密输入下会吃亏,只能靠给逐场景优化当更好的起点来找回场子。对机器人与具身智能这类往往只能拿到稀疏、部分观测的场景,这个交换是划算的;对输入密集的离线重建,目前还不是最优选。若能把基元预算做成随输入自适应,或把查询机制扩展到动态场景,这条路的覆盖面会再宽一截。
金句
「让模型为它没看到的视角负责,它才会去补全没看到的几何。」——监督视角设为输入视角的超集,是本文把「补全遮挡」从口号变成可优化目标的那一步。
「一半查询接地气,一半查询去探险。」——没有三维真值时,让一部分查询落在观测表面上保证稳定,另一部分在空间里自由探索保证完整,是这套表示能训练起来的前提。