PAPER DEEP DIVE
从单次演示中学习蒙特祖玛的复仇
仅用一次人类演示,把演示状态作为强化学习回合的起点并逐步后移,将稀疏奖励探索从指数级降到二次方;在《蒙特祖玛的复仇》上取得 74,500 分,超过此前所有公开结果。
一句话总结
把一条人类演示切成"从易到难"的课程:每个强化学习回合都从演示中的某个状态开始,学会之后再把起点逐步往前挪,最终在完全不依赖演示的情况下通关,并在《蒙特祖玛的复仇》上拿到 74,500 分。
研究背景与动机
无模型强化学习靠试错学习。策略梯度和 Q-learning 这类方法在回合开始时从环境初始状态出发,随机探索;只有当随机动作序列碰巧带来奖励,这些动作才会被强化。奖励密集时这套机制运转良好,但在需要一长串精确动作才能拿到第一个奖励的任务里,随机探索几乎不可能命中。
论文用一个非常直白的概率论证说明了困难所在。假设通关需要依次完成五个关键动作——下第一段梯子、抓住绳子、下第二段梯子、跳过骷髅、爬上第三段梯子——那么拿到第一把钥匙的概率就是这五个事件概率的乘积。每一项都小于 1,连乘之后得到的概率会小得惊人。作者给出的经验数字是:在《蒙特祖玛的复仇》里,均匀随机动作平均大约每 50 万步才能产生一次奖励。
更一般地,如果第一个奖励需要长度为 $N$ 的正确动作序列,那么随机策略期望需要探索大约 $\exp(N)$ 个时间步才能第一次见到奖励。这个指数级复杂度是稀疏奖励任务的核心障碍,也是 Atari 硬探索游戏长期被视为试金石的原因。
此前的工作大致分成两条路。一条是改进探索本身:伪计数、内在奖励、集成不确定性、基于预测误差的好奇心等。另一条是模仿学习:让智能体去复现演示中的动作或状态。前者在《蒙特祖玛的复仇》上收益有限,后者虽然有效,却要求演示质量足够高、数量足够多,否则策略会继承演示的次优性,甚至过拟合到某一条特定轨迹。
本文选择第三条路:不模仿演示的动作,而是只借用演示中的状态来重置环境,把长程探索问题拆成一串短程问题,奖励仍然由原始环境给出、由强化学习直接最大化。这个设计让智能体保留发现新解的自由,同时绕开了最致命的探索瓶颈。
预备知识
稀疏奖励与盲崖行走。论文用 Schaul 等人提出的 blind cliff walk 作为分析工具:一条长度为 $N$ 的一维悬崖,智能体从状态 0 出发,每步有两个动作,一个正确、一个掉下悬崖;只有到达最后一个状态才能拿到奖励。由于假设状态之间不能泛化,智能体必须为每个状态单独学习一个表格型策略,这使得该环境成为分析探索复杂度的理想沙盒。
分布式 PPO。训练侧采用 PPO(Proximal Policy Optimization)。实现中每个 rollout worker 收集固定长度 $L$ 的轨迹,中心优化器用裁剪后的策略梯度更新共享的 RNN 策略;价值函数同样使用裁剪,避免单次更新过大。论文没有为方法本身发明新的优化器,而是把"从演示状态重置"作为一层与算法无关的课程机制,因此 PPO、A3C、IMPALA 都可以直接套用。
回合、重置与隐藏状态。对 recurrent policy 来说,仅仅把环境状态恢复到演示中的某一帧还不够:策略的循环隐藏状态必须与"最近发生了什么"一致。论文因此要求先回放起点之前的若干步演示动作,用这些动作把 RNN 的隐状态"预热"到与当前局面匹配,再交给策略接管。
方法详解
1. 把演示变成一组可重置的状态。给定一条演示轨迹 $\{(\tilde{s}_t,\tilde{a}_t,\tilde{r}_t,\tilde{s}_{t+1})\}_{t=0}^{T}$,方法是让每个 rollout worker 从某个演示时刻 $\tau^*$ 的状态 $\tilde{s}_{\tau^*}$ 开始一整个回合。训练刚开始时,所有 worker 的起点都靠近演示末尾 $T$——此时智能体距离成功只差几步,探索问题几乎不存在,学习可以立刻发生。
2. 用成功率决定起点何时前移。中心优化器统计"本回合得分不低于演示在同一段上的得分"的比例:
$$\frac{\sum_{D} W_i}{\sum_{D} d_{i,t}} \ge \rho$$
其中 $W_i$ 是第 $i$ 个 worker 的成功计数,$d_{i,t}$ 标记回合是否结束,阈值 $\rho$ 在实验中取 20%。一旦成功率越过阈值,中心起点就向前移动一个固定步长:
$$\tau \leftarrow \tau - \Delta$$
这一步是整篇论文最关键的工程判断。作者在相关工作里明确说,他们试过预先写死课程,但在《蒙特祖玛的复仇》这种难任务上,动态调整起点是取得结果的前提。
3. 每个 worker 在窗口内随机取起点。为了避免所有 worker 卡在同一个状态、把策略训练成只会应付单一局面,每个 worker 并不直接使用中心起点 $\tau$,而是在一个小窗口 $\{\tau-D,\ldots,\tau\}$ 内均匀采样自己的 $\tau^*$。代码中这个窗口由 worker 编号映射到不同的演示位置实现:起始点等于演示长度减去"编号除以每组 worker 数",相当于把并行 worker 均匀铺在最近一段演示上。
4. 回放 K 步演示来预热 RNN。确定 $\tau^*$ 之后,worker 先把时间计数器设为 $\tau^*-K$,回放演示中紧邻起点的 $K$ 步动作,把观测、动作、奖励、终止信号都灌进策略,但把这些转移标记为"不可训练"。代码里用 actions_to_overwrite 队列实现:回放阶段返回 valid=False,这些样本随后在损失函数中被 VALID 掩码剔除。这样既恢复了隐藏状态,又不会让策略去模仿演示动作。
5. 策略接管,直到回合结束。回放结束后,智能体按当前策略 $\pi(\theta)$ 采样动作,与环境交互,得到真实奖励。回合结束时比较本段累计回报与演示在同一段的回报:
$$\sum_{t \ge \tau^*} r_t \ge \sum_{t \ge \tau^*} \tilde{r}_t$$
满足则该回合记为一次成功。代码还加了两条实用的终止规则:如果智能体得分已经达到演示的最终分数,就在若干额外帧后主动结束;如果动作数超过 50 且得分落后演示同一时刻的回报,也立刻终止。这两条规则把算力集中在"有希望"的回合上,是论文正文没有展开、但实现中真实存在的细节。
6. 课程结束,智能体独立通关。当中心起点退到 $\tau=0$,也就是从游戏真正的初始状态开始时,智能体已经学会了整条链路;此时演示不再参与任何决策,策略完全靠自己通关。作者把这一过程类比为动态规划:长序列被拆成 $N$ 个短片段,每段只需要在已有能力的基础上再学一小步。
7. 复杂度从指数降到二次。假设每个状态需要 $O(N)$ 步学会,$N$ 个状态依次学习,总代价是 $O(N^2)$;而从头探索需要 $O(\exp(N))$。论文在图 3 中给出了实测拟合:从头开始约等于 $6.0 \cdot 2^{N}$,使用演示起点约等于 $47 \cdot N^{2}$。这两个常数不是装饰——它们说明在 $N=18$ 时,差距已经跨过两个数量级。
8. 与模仿学习的边界。方法只要求能重置环境、能访问演示中的完整状态,不要求演示动作可执行、也不要求策略复现这些动作。代价是它比模仿学习更依赖环境控制权;收益是它直接优化任务回报,因此可以超越演示——论文中的智能体最终比人类演示多拿了 3,000 分,并发现了作者都不知道的机制。
flowchart TD
    A[单条人类演示 T 步] --> B[中心起点 tau 设为演示末尾]
    B --> C[每个 worker 在 tau-D 到 tau 之间取本地起点]
    C --> D[回放起点前 K 步演示
预热 RNN 隐状态并掩码]
    D --> E[策略接管并采样动作]
    E --> F{本段回报 >= 演示同段回报}
    F -->|是| G[成功计数 W 加一]
    F -->|否| H[不计数]
    G --> I{成功率 >= 20%}
    H --> I
    I -->|是| J[tau 前移 Delta]
    I -->|否| K[保持起点继续训练]
    J --> L{tau == 0}
    K --> L
    L -->|否| C
    L -->|是| M[智能体从初始状态独立通关]
实验结果
盲崖行走:复杂度分析得到验证。作者在 $N$ 从 1 到 18 的 blind cliff walk 上训练表格型策略,要求以 95% 的概率解出问题,并对 20 个随机种子取几何平均。图 3 显示:从初始状态出发的曲线紧贴指数拟合,使用演示起点的曲线紧贴二次拟合。这不是"看起来更好",而是两种渐进复杂度在同一个坐标轴上被直接测量出来。
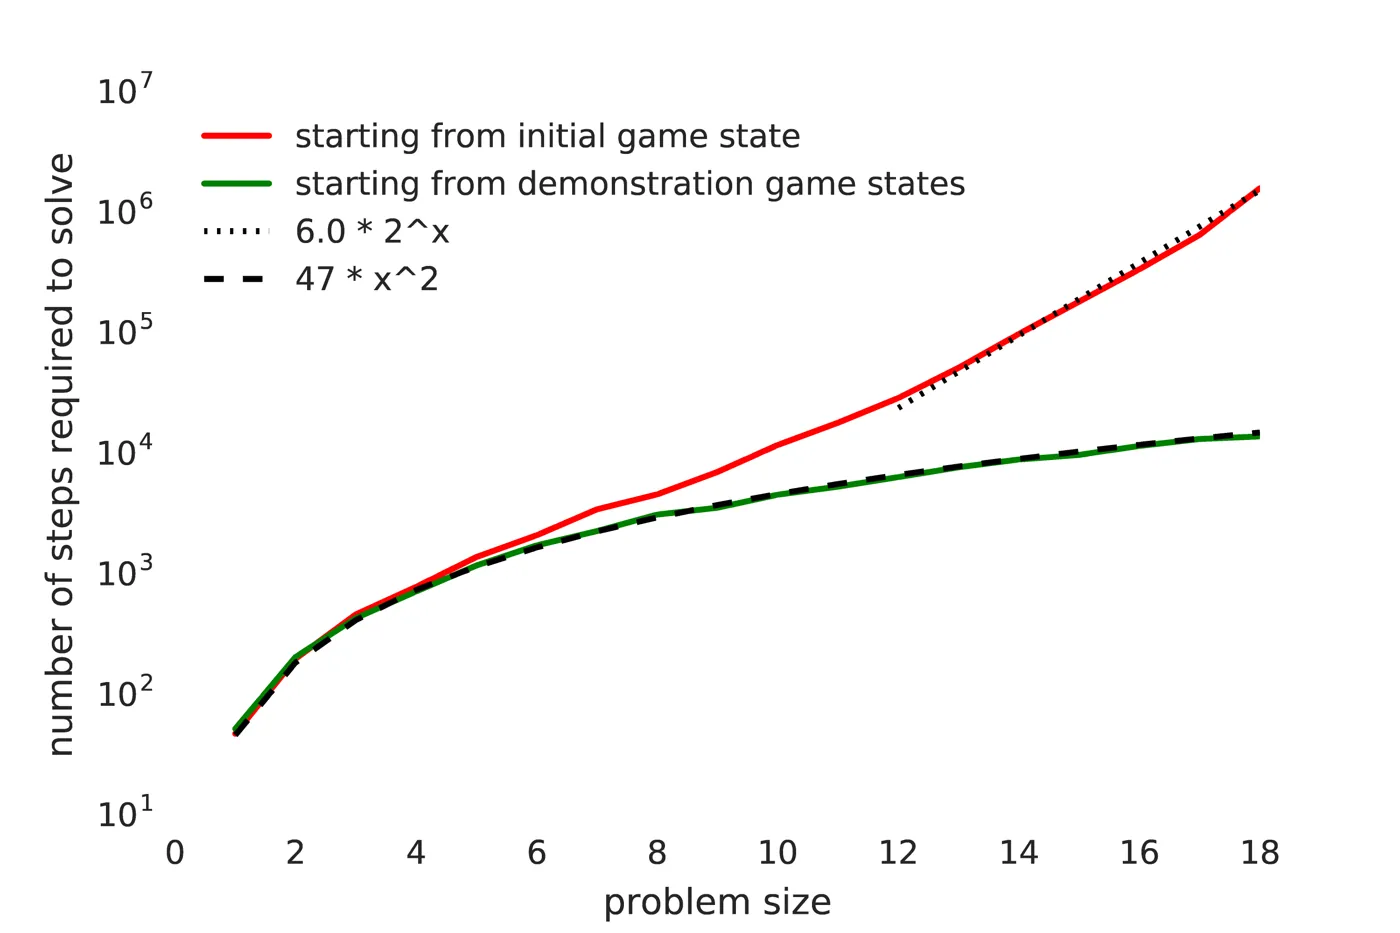
图 3:求解 blind cliff walk 所需步数。红色为从初始状态开始,绿色为从演示状态开始;虚线分别为 $6.0 \cdot 2^x$ 与 $47 \cdot x^2$ 拟合。
《蒙特祖玛的复仇》:一次演示换来 74,500 分。演示由作者用带"倒放时间、纠正失误"的工具辅助录制,得分 71,500,约 15 分钟;这个分数仍比不使用工具的高手低一个数量级以上。智能体最终在约 12 分钟内拿到 74,500 分,超过演示 3,000 分。超越的部分来自两处:多收集了钻石,以及在 4 分 25 秒时利用"钥匙会重新出现"的机制走了与演示不同的路线——后者是作者在录制演示时并不知道的。
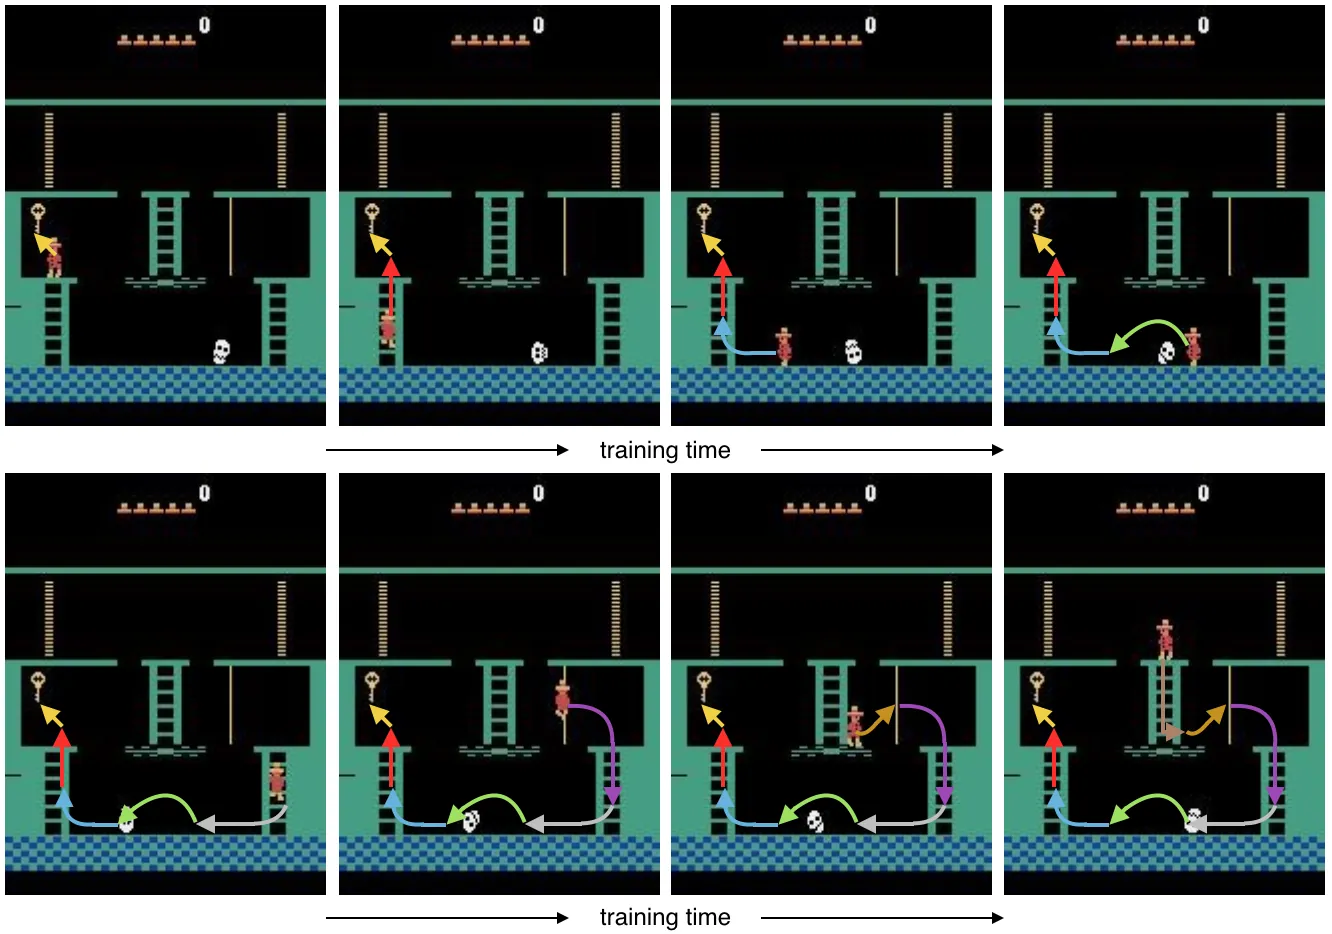
图 1:训练过程中的起点演化。智能体先学会在钥匙前起跳,再依次学会爬梯、抓绳、跳骷髅,最终从游戏初始状态独立通关。
| 方法 | 得分 |
|---|---|
| Count-based exploration(Ostrovski 等,2017) | 3,705.5 |
| Unifying count-based exploration(Bellemare 等,2016) | 6,600 |
| DQfD(Hester 等,2017) | 4,739.6 |
| Ape-X DQfD(Pohlen 等,2018) | 29,384 |
| Playing by watching YouTube(Aytar 等,2018) | 41,098 |
| 本文 | 74,500 |
训练规模。智能体使用一个比常规 Atari 策略大得多的卷积网络:输入是 $105 \times 80$ 的灰度画面,先过一层 $7 \times 5$、步长 $2 \times 2$、64 通道的二维卷积,再接四层三维卷积,空间核依次为 $5 \times 5$、$5 \times 5$、$5 \times 5$、$5 \times 3$,时间维核大小为 2、步长随层数按 $2^l$ 增长,通道数逐层翻倍。训练用 PPO,128 张 GPU、每张 8 个 worker,共 1024 个并行 rollout worker,累计约 500 亿帧,耗时两周。
| 项目 | 取值 |
|---|---|
| 观测尺寸 | 105 × 80 灰度 |
| 网络结构 | 1 层 2D 卷积 + 4 层 3D 卷积(时间核 2) |
| 优化算法 | PPO(GAE λ=0.95,γ∈[0.999, 0.9999]) |
| 并行规模 | 128 GPU × 8 worker = 1,024 个 rollout worker |
| 总训练帧数 | 约 500 亿帧 |
| 课程阈值 ρ | 20% |
| 训练时长 | 约 2 周 |
鲁棒性评估。为了检验策略是否只是记住了演示轨迹,作者用两种扰动方式重新评测:以 0.25 的概率重复上一动作(sticky actions),以及以 0.01 的概率随机动作。前者平均得分 10,000,后者 8,400。绝对分数下降明显,但作者指出这仍优于此前公开的全部结果;在回合开头插入 0 到 30 个随机 no-op,也没有显著破坏结果,多数 rollout 仍能达到演示的最终分数。
| 评测条件 | 平均得分 | 说明 |
|---|---|---|
| 干净评测 | 74,500 | 低熵采样,约 12 分钟 |
| Sticky actions(p=0.25) | 10,000 | 每帧以 25% 概率重复上一动作 |
| ε-greedy(ε=0.01) | 8,400 | 每帧 1% 概率随机动作 |
| 0–30 个随机 no-op | 不显著下降 | 多数 rollout 仍达到演示分数 |
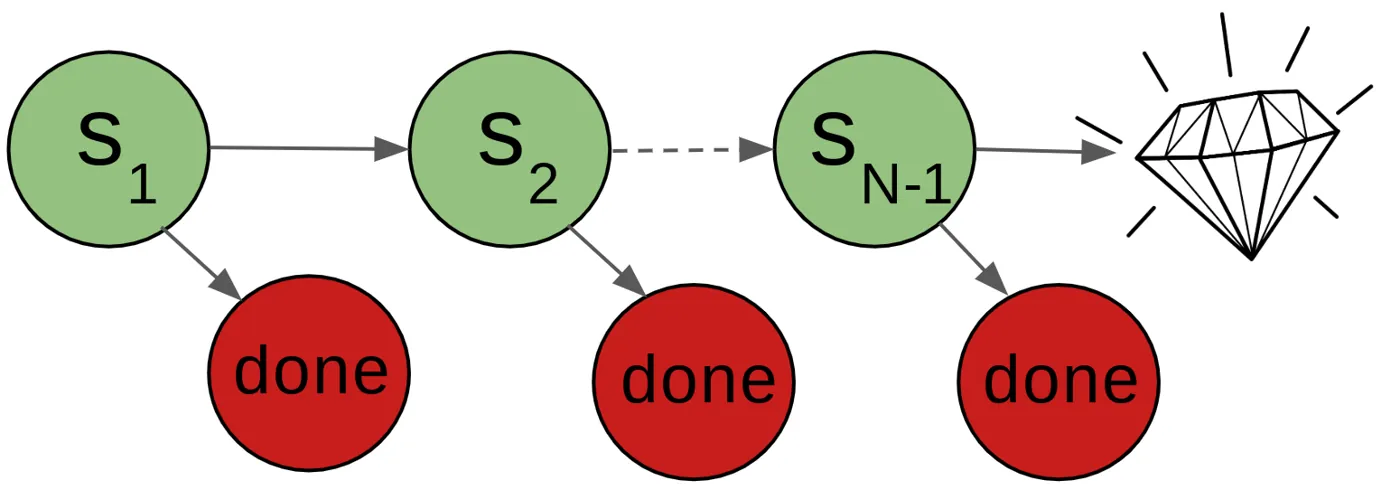
图 2:blind cliff walk。只有一条正确动作序列能走到终点拿到奖励,其余动作都会掉下悬崖;每个状态独立学习,因此问题规模可以直接控制探索难度。
局限性
1. 需要能任意重置环境。方法的前提是"可以把环境恢复到演示中的任意状态"。这在 Atari 模拟器里很容易,在真实机器人上却往往代价高昂甚至不可行。作者在相关工作中也承认,模仿学习路线不需要这种控制权,这是本文方法最硬的结构性限制。
2. 状态无法精确复现。作者自述,智能体从较早状态出发时,通常无法精确到达演示中稍后的状态:一方面是训练时的 frameskip 与录制演示时不同,另一方面是动作采样的随机性使精确复现某条动作序列几乎不可能。策略必须学会在"相似但不相同"的状态之间泛化。
3. 跨游戏泛化失败。同样的流程在《蒙特祖玛的复仇》上有效,但在 Gravitar 和 Pitfall 上明显更差;作者尝试更大更深的网络后只看到部分改善。他们推测这两款游戏需要更强的视觉理解,但没有给出系统性解决方案。
4. 对超参数高度敏感。作者明确写道,PPO 的熵奖励系数必须与学习率、奖励缩放一起仔细调,才能跑通完整课程;在 Gravitar 和 Pitfall 上他们根本找不到能跑通课程的组合。这种脆弱性意味着方法还不是"开箱即用"的通用方案。
5. 单次运行,无法估计方差。训练一次需要 128 张 GPU 跑两周,因此作者无法用多次独立运行来量化算法的一致性,只能报告单次结果。这一点在论文里被明确列为遗留工作,也是复现时最容易被低估的成本。
6. 与站点定位的关系。这篇论文本身是 Atari 硬探索研究,不是机器人论文;但它提出的"演示状态重置 + 动态课程"后来被大量用于机器人操作的课程学习与仿真重置。读者应把它当作方法源头来读,而不是当作机器人系统的直接结果。
总结与展望
这篇论文的贡献不在于发明了更复杂的网络或更强的探索奖励,而在于重新定义了演示的用途:演示不再是"要复制的标准答案",而是"可以借用的跳板"。通过把回合起点从演示末尾逐步移回开头,作者把一个指数级难度的探索问题改写成了一系列短程问题,并用成功率阈值自动控制课程推进。
对今天的具身智能研究,这个思路的价值反而更大。仿真环境天然支持任意状态重置,机器人操作、locomotion、灵巧手任务都可以把人类演示或专家轨迹切成分段起点,用"反向课程"把长程任务拆开;而在真实机器人上,难点会转化为"如何低成本地重置到目标状态",这正是后续 reset-free 学习、示范初始化课程等方向要解决的问题。
如果要把这篇工作继续往前推,至少有三个方向:一是把固定的成功率阈值换成对策略能力更敏感的自适应课程;二是把"状态重置"与少量在线纠正结合,减少对完整状态访问的依赖;三是在真实机器人上研究近似重置(例如用人类把物体摆回目标构型)是否足以保留二次复杂度的收益。
金句
演示不是要背诵的标准答案,而是一组可以反复借力的起跳点;真正被学习的,仍然是智能体自己走出来的那条路。