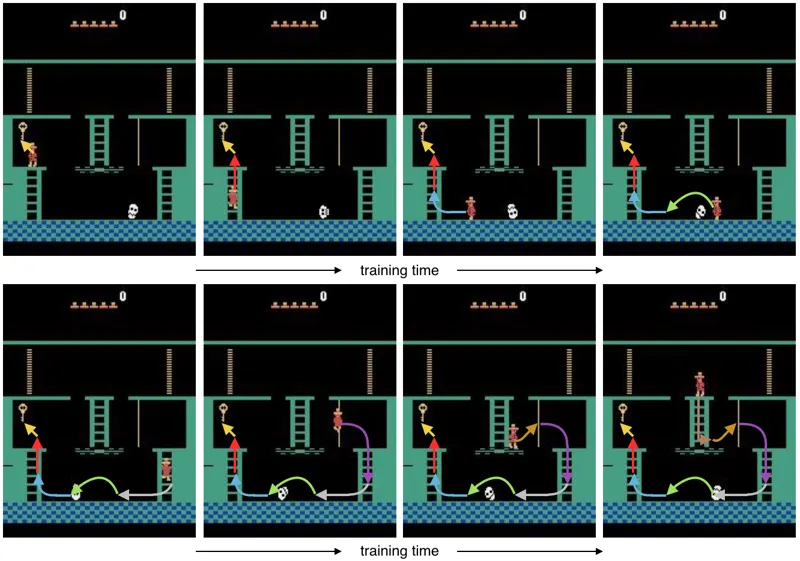
从单次演示中学习蒙特祖玛的复仇仅用一次人类演示,把演示状态作为强化学习回合的起点并逐步后移,将稀疏奖励探索从指数级降到二次方;在《蒙特祖玛的复仇》上取得 74,500 分,超过此前所有公开结果。Tim Salimans, Richard Chen · 22次阅读 · 2018年12月8日强化学习Sparse Reward2018年12月8日