Skip to content
← 标签

#Voice Cloning (4)

语音与音频影音创作梯顶A

VoiceStudio:把商用语音栈的整套工序搬到本地,并默认开给 agent

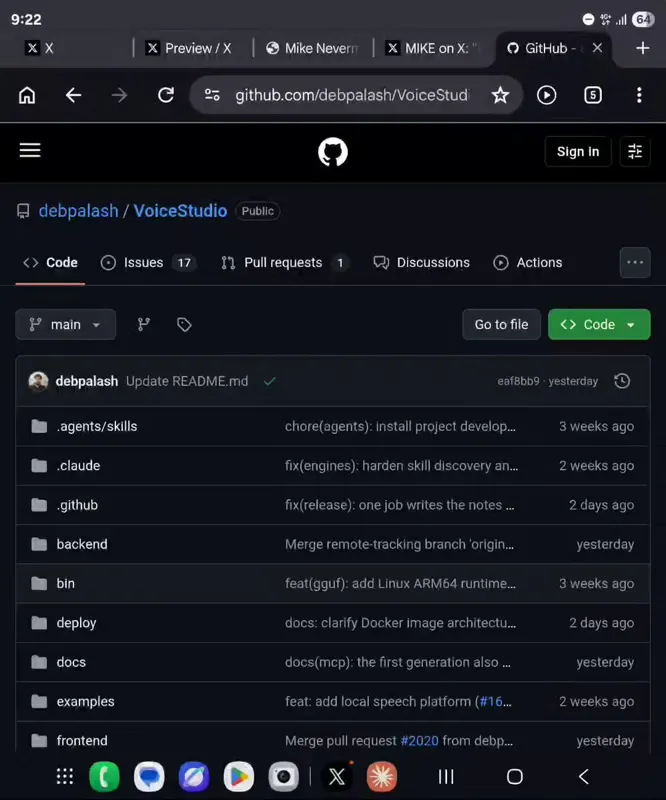
开源、完全本地的语音工作台(debpalash/VoiceStudio,AGPL-3.0,Python + Electron),自我定位为 ElevenLabs 的本地替代品:声音克隆、声音设计、视频配音、听写、转写与有声书制作,官方称覆盖 646 种语言。仓库 2026-04-09 建仓,到 2026-09-29 有 42,831 star / 5,005 fork。本站把它列为音频域本地自托管方向的梯顶,依据不是某个模型更强,而是抽象层有用:开源语音能力散落在十几个仓库里,各有自己的权重格式、设备要求、克隆接口与许可,拼一条「克隆音色→转写→对齐→配音→有声书」的产线,工程量主要花在粘合上;VoiceStudio 把 17 个 TTS 与 11 个 ASR 引擎收进统一注册表,逐引擎上报设备(CUDA/MPS/CPU)、是否可克隆、max_ref_seconds 与 ref_strategy,并给出可跑的工作流。对 agent 尤其关键:本地 API 与 MCP server 是产品自带的一等能力,README 直接给了可粘进 Claude Code / Codex / Cursor 的安装指令,还支持 npx skills add 装 skill,意味着编码 agent 可以把配音与转写当工具调用而不需要人点界面。参考音频口径也严谨:上限 75 秒,但真正进模型多少由引擎决定并逐引擎上报,超限时自动与已保存的转写会被忽略,给默认 OmniVoice 传超过 20 秒并附文本会以 [clone_ref_too_long] 直接报错。指标口径要说清:官方 docs/benchmarks.md 有一套真实 harness(逐阶段 profiling、内存不足拒绝启动、只收具名硬件与版本上的 RTF 热态与峰值显存、明确没有数字是估的),但结果一栏写着 No verified rows yet,所以本站不给它任何性能数字,卡片上只用本站自核的 GitHub star 数并据此记 A 档(可核验);这个 A 只针对数字为真,不针对它比 ElevenLabs 好。四条边界:AGPL-3.0 是强 copyleft 且带网络条款,嵌进对外 SaaS 需开放自己的服务端源码,闭源商用要么进程隔离只调本地 API(自行法律评估)要么改用 Apache-2.0 的 CosyVoice 3 / Kokoro 自行组装;模型各自有许可(Breeze-TTS-2 权重研究非商用、Supertonic-3 与 PocketTTS 需额外许可、GPT-SoVITS 要跑自己的 server),商用前逐模型核对;646 种语言是仓库自述,真实覆盖取决于所选引擎(Parakeet 25 种欧洲语言、FunASR 50+、Whisper 系更广),本站未逐语言核验;桌面端只剩 Electron,0.5.3 是最后一个 Tauri 版本,老用户必须迁移。它与 Eleven v4 在梯度上并存而不互相替代:一个代表闭源商用栈的质量上限与省心,一个代表本地自托管的数据主权与引擎可替换性。
42,831GitHub Stars(2026-09-29,本站经 GitHub API 核)已确认 · 2026-09
产品debpalash (open source)官网Repo
VoiceStudio:把商用语音栈的整套工序搬到本地,并默认开给 agent
语音与音频影音创作梯顶C

Eleven v4:把克隆保真度推到会反噬训练数据的一代

ElevenLabs 新一代语音合成模型,分 Eleven v4(最高质量档)与 Eleven v4 Turbo(实时档,中位推理延迟约 100ms,官方脚注明确不含应用与网络延迟)两个型号,官方口径是在输出质量、音色准确度、一致性、情感、演绎、audio tags 与语言覆盖上全面优于 v3 并建议迁移。本站把它列为音频域闭源语音方向的梯顶,依据是这一代把优化目标从「更好听」换成了「更像」:参考音色的音色、节奏、演绎与其他习惯一并复刻,官方自己承认准确度与个人偏好不总是同一件事、你可能仍更喜欢它在 v3 里的声音。配套的工程含义很硬——数据清洗的责任被推回使用方,官方把展示样例明确标注为未做任何后期(无 EQ、压缩、归一化、去齿音、去喷麦),并直说听到削波与喷麦大概率是训练数据里的、模型只是准确捕捉了下来。可交付面是三个数:Turbo 约 100ms、单次 10,000 字符约 10 分钟音频(v3 为 5,000,长文本分段接缝多一倍)、官方称 90+ 语言而 FAQ 逐条列出 87 种,这个差我们照原样并列不替它抹平。四条边界必须认清:跨语言口音是默认行为变更而非开关(生成语言与参考语言不一致时出目标语言的地道发音,做成 toggle 官方称仍是研究项目、无时间表),依赖「带母语口音说外语」的人设要先实测;控制面收窄,只剩 Stability 与 Similarity,Style 与 Speed 滑块取消、SSML 不支持,细粒度演绎改用 audio tags 且官方坦承还不完美;模型持续演化是官方明写的,发布后仍会继续训练、行为可能随时间变化,把音色当品牌资产的团队要周期性重测;Voice Design 生成的音色在 v4 上可能不那么有表现力。闭源不可自托管,数据必须过 ElevenLabs,克隆合规责任在使用方;可自托管对照是 CosyVoice 3、VibeVoice、Kokoro(语音)与 YuE2(音乐,非商业许可)。与本站已收的 Eleven v3 是同一商用栈上的两代,不是替代关系。置信度 C(厂商宣称):无第三方可核验基准,本站未做盲听。

~100msv4 Turbo 中位推理延迟(模型侧,不含应用与网络)厂商宣称 · 2026-09
生产ElevenLabs官网
Eleven v4:把克隆保真度推到会反噬训练数据的一代
语音与音频影音创作梯顶C

Gemini 3.8 Flash TTS:把导演级语音指导做成 API 参数

Google 的语音生成模型(gemini-3.8-flash-tts),官方定位 studio-grade voice fidelity、expressive acting 与 long-form stability,有声书翻车不是单句难听,是念到第三小时音色漂了。设计把作用域切开:文本字段严格当逐字稿,表演指令走另一条通道不会被念出来,修掉「(叹气)」被念出来的老问题;整轮风格走 speech_metadata.style,词级情感用竖线标签只影响那一个词。音色四类:预置、扩展库、语音设计 ID(自然语言造音色后复用)、克隆 ID,设计与克隆是 3.8 才补齐。规格:130 语言、自动检测输入语言,默认 WAV 24 kHz,单请求最多 2 个说话人且只能用预置音色。计费按音频 token、25 tokens 一秒,付费层每百万 tokens $0.50 输入 / $9.00 输出(至 2026-12-31,之后 $1.00/$18.00)。边界:24 kHz 非母带级;克隆合规责任在使用方。本站 12 个榜无语音榜,与 ElevenLabs v3 并列不排名。置信度 C(厂商宣称):未做可懂度测量与盲听对比。

全支持语音设计+克隆+多说话人厂商宣称 · 2026-09
产品Google官网
Gemini 3.8 Flash TTS:把导演级语音指导做成 API 参数