
OPEN SOURCE DEEP DIVE
VoxCPM2:在连续潜空间中生成多语言语音、设计与克隆音色
VoxCPM2 是 OpenBMB 基于 MiniCPM-4 构建的 2B 参数连续潜空间语音生成模型。它用 AudioVAE V2 把 16 kHz 参考音频编码为潜表示,再经 LocEnc、文本语义语言模型、残差声学语言模型与局部扩散生成潜块,原生解码为 48 kHz 语音。项目支持多语言合成、自然语言音色设计、参考音克隆、带文本续写克隆以及 LoRA/SFT 微调。文中会区分仓库实现事实与作者自报指标,并讨论流式部署、音色一致性和语音伪造风险。
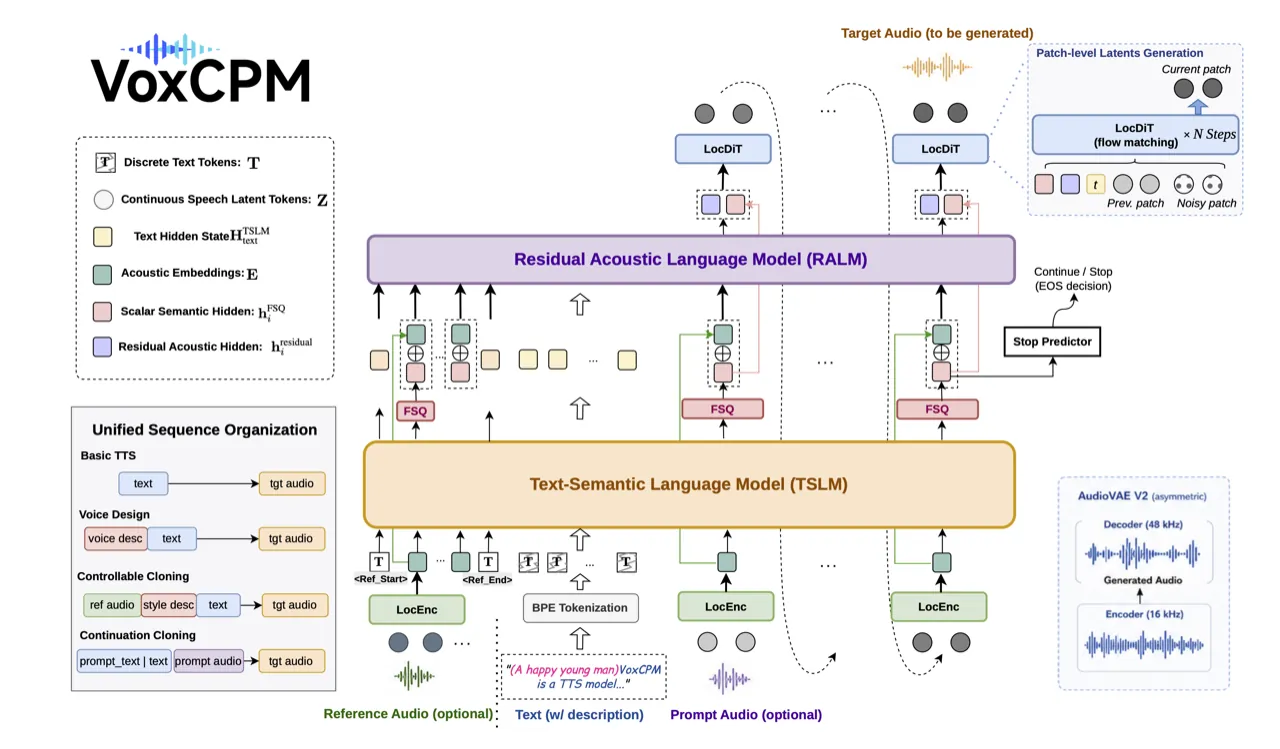
VoxCPM2 是 OpenBMB 在 VoxCPM 与 VoxCPM1.5 之后发布的 20 亿参数语音生成模型。它不是把波形先压成一套离散音频词表再预测编号,而是在 AudioVAE V2 的连续潜空间中完成条件建模与扩散生成。这个选择决定了模型的整条工程链路:参考音频先被编码成连续帧,局部编码器把相邻帧整理成语言模型可处理的 patch,文本语义模型与残差声学模型共同给出下一块潜表示的条件,局部扩散变换器再把这个条件变成可解码的音频潜块。模型原生输出 48 kHz 波形,同时支持多语言合成、自然语言音色设计、参考音色克隆、带准确转写的续写式克隆,以及全参数或 LoRA 微调。
先厘清“无分词器”究竟指什么
VoxCPM2 仍然需要文本分词器来处理输入文字,也使用了 FSQ 对部分语言模型隐藏状态做标量量化。因此,“无分词器”不能理解成整条模型没有任何离散化步骤。仓库真正避开的是传统语音生成里常见的离散音频分词器:音频不先被映射为有限的声学 token 编号,再由语言模型逐个分类。AudioVAE V2 编码器返回的是连续均值潜变量,局部扩散模块直接预测连续潜块;这条主要声学路径没有码本索引,也没有把每个时间片压成一个整数类别。
FSQ 在这套结构里承担的是语义与声学接口的规整,而不是替代音频编解码器。配置中 scalar_quantization_latent_dim=512、scalar_quantization_scale=9;标量量化层先把语言模型隐藏状态投影到 512 维,经过双曲正切把数值限制在可量化范围,再按九倍尺度四舍五入。训练时使用直通估计保留梯度,推理时直接返回量化后的连续向量。这样既约束了音频位置上的隐藏表示,又没有建立一张必须穷举和更新的语音码本。
| 层 | 仓库中的实际形态 | 对输出质量的影响 |
|---|---|---|
| 文本表示 | 文本分词器与 MiniCPM-4 词嵌入 | 处理语言、数字和标点,不是“无文本分词” |
| 声学表示 | AudioVAE V2 的连续潜帧 | 保留音色、韵律和细粒度声学变化,不走离散码本 |
| 语义接口 | 512 维 FSQ 隐藏状态,尺度为 9 | 规整音频位置的表示并稳定语言模型到声学模型的传递 |
| 生成核心 | 局部扩散变换器预测连续潜块 | 用多次迭代换细节,计算量高于单步分类式声学头 |
这种设计的收益是减少“码本容量与重建细节”之间的硬取舍,代价则转移到采样计算。每个语言模型 patch 都需要运行流匹配求解器,默认是十步欧拉积分、无分类器引导系数 2.0。低延迟部署不能只看参数量,还要把扩散步数、批大小、缓存和声码器开销一起测量。
LocEnc、TSLM、RALM、LocDiT 如何接成一条链
VoxCPM2 的生成主干可以写成四段。第一段 LocEnc 是局部编码器,把 AudioVAE 输出的四帧潜块压成一个语言模型时间步;它不负责从文本直接生成波形,而是把当前声学上下文变成可与文本嵌入混合的向量。第二段 TSLM 是文本语义语言模型,基座为 MiniCPM-4。它在一个因果序列中同时看到文本位置与声学位置,输出下一时间步的语义条件。第三段 RALM 是八层残差声学语言模型,输入由当前语言模型状态和当前声学嵌入拼接而成,专门补齐局部声学依赖。第四段 LocDiT 是局部扩散变换器,把两条语言模型状态投影后作为条件,在上一声学 patch 的约束下生成下一个包含四帧、每帧 64 维的潜块。
自回归循环里的顺序很关键。模型先编码已有的参考音频、提示音频和文本,并把 MiniCPM-4 与 RALM 的键值缓存填好。每轮生成时,TSLM 的隐藏状态与前一轮 RALM 的隐藏状态分别投影,再拼成扩散条件;LocDiT 生成新 patch 后,这个 patch 会重新经过局部编码器和输入投影,回灌给两个语言模型,同时成为下一轮扩散的声学前缀。停止头直接读取 TSLM 隐藏状态,判断是否结束;生成循环还设置最短与最长 patch 数,防止停止判断过早或无限运行。
| 阶段 | 输入 | 输出 | 职责边界 |
|---|---|---|---|
| LocEnc | [patch=4, latent=64] 的声学块 | 语言模型宽度的声学嵌入 | 局部压缩与跨模态对齐 |
| TSLM | 文本嵌入、参考声学嵌入、已生成声学嵌入 | 下一时间步语义状态 | 全局文本—语音语义建模 |
| RALM | TSLM 状态与当前声学嵌入的融合 | 残差声学状态 | 补足音素衔接、韵律和局部连续性 |
| LocDiT | 两条语言模型状态、上一声学块 | 下一块连续潜表示 | 十步流匹配采样与细节生成 |
| Stop Head | TSLM 当前隐藏状态 | 继续或结束的二分类 | 终止条件判断 |
这套分工避免让一个超大的语言模型同时承担“理解整句”和“恢复高频细节”两件尺度完全不同的事。TSLM 决定说什么、下一段大致怎么走;RALM 补充局部声学上下文;LocDiT 只在较短的下一块上做高分辨率迭代。代价是模块多、缓存多,工程上要同时管理两个语言模型的键值缓存、声学前缀和扩散采样状态。
AudioVAE V2 的非对称 16 kHz 到 48 kHz 路径
AudioVAE V2 的编码器输入采样率为 16 kHz,编码倍率依次为 [2, 5, 8, 8],总下采样倍数是 640。16,000 除以 640 得到每秒 25 个潜帧。语言模型并不直接消费每个 25 Hz 帧,而是把四帧组成一个 patch,因此有效语言模型速率是每秒 6.25 个 patch,每个 patch 对应 160 毫秒音频。这个速率比逐采样点生成低得多,又保留了连续向量,而不是用有限码本近似。
解码器走的是另一套倍率:[8, 6, 5, 2, 2, 2]。六段相乘得到 1920,25 个潜帧每秒乘以 1920,正好还原到 48,000 个采样点每秒。因此所谓“输入 16 kHz、输出 48 kHz”不是简单复制采样点,也不是外接一个独立超分模型;AudioVAE V2 的解码器在训练中直接学习从低采样率参考潜空间重建更宽频带的 48 kHz 波形。这个非对称设计减少了参考音频上传和编码成本,但输出中高频的真实性仍取决于训练数据与解码头,不能把采样率本身误当成音质保证。
| 参数 | AudioVAE V2 配置 | 计算结果或含义 |
|---|---|---|
| 编码输入 | 16,000 Hz | 参考音频与训练音频统一采样率 |
| 编码倍率 | [2, 5, 8, 8] | 总 hop 为 640,潜帧率 25 Hz |
| 潜表示 | 64 维连续向量 | 每个声学帧不是一个离散编号 |
| 语言模型 patch | 4 个潜帧 | 6.25 patch/秒,每块 160 ms |
| 解码倍率 | [8, 6, 5, 2, 2, 2] | 总上采样 1920,输出 48,000 Hz |
流式解码不是把整段潜序列反复解码后裁掉重叠部分。仓库提供带状态的流式解码上下文,在因果卷积与转置卷积上保存尾部历史,每个新 patch 只计算新增部分,再把跨块状态带入下一轮。这样既能保持块边界连续,也避免每来一块就重算整段前缀。实现上这是很实用的折中:模型仍然按 patch 自回归,解码器却可以持续吐波形。
音色设计、参考克隆与续写式克隆不是同一条路
VoxCPM2 对外看起来像三种“换声音”的能力,实际输入结构和可控边界不同。没有参考音频、只在目标文本开头括号里写自然语言描述,属于音色设计;它创建的是新音色,不绑定某个说话人。只传入参考音频、不提供参考转写,属于隔离参考模式;参考音频被包在专用起止标记之间,模型从中提取音色,再生成目标文本。传入提示音频及其准确转写,则进入续写模式;模型把提示音频当成已经说出的前缀,接着生成目标文本,因此音色、节奏、情绪和录音条件更容易被延续。两者同时提供时,仓库会先放隔离参考前缀,再放提示文本、目标文本和提示音频后缀,组合出更稳定的克隆条件。
命令行接口对模式有硬约束。音色设计命令不会接受提示音频或参考音频;克隆命令至少需要参考音频,或者同时提供提示音频与提示文本。这个约束值得保留,因为把描述、参考和转写随意混在一条无约束请求里,会让调用者误以为每种字段都只增加一点提示,实际却改变了训练时使用的序列排列。
| 使用方式 | 输入 | 模型内部条件 | 适合与不适合 |
|---|---|---|---|
| 音色设计 | 括号内声音描述加目标文本 | 无参考音频,描述作为文本前缀 | 适合创建全新角色音;结果有随机性,可能需要重试 |
| 隔离参考克隆 | 目标文本加一段参考音频 | 103 + 参考潜块 + 104 的独立前缀 | 适合短参考、希望克隆音色但不续写原句 |
| 续写式克隆 | 目标文本、提示音频、准确转写 | 提示文本与目标文本在前,提示音频作为后缀上下文 | 最适合保留原声的节奏、情绪与录音质感;转写必须准确 |
| 组合克隆 | 参考音频、提示音频、转写、目标文本 | 隔离参考前缀加续写后缀 | 同一段音频同时作为参考与提示时相似度通常更高,但成本也更高 |
“可控声音克隆”也不等于精确参数控制。仓库允许在文本开头加入“语速稍快、语气愉快”一类描述,让模型在保持音色的同时改变表达;作者同时明确写到,音色设计与可控克隆在不同运行之间可能变化,建议生成一到三次再挑选结果。固定随机种子有帮助,但不能把生成器理解成每次都能复现完全相同的表演。
训练包如何把参考音频与目标音频分开
参考模式训练样本的文本轨道可以直观写成 [103, 参考潜块, 104, 文本, 101, 目标潜块, 102]。103 和 104 是参考音频的起止标记,101 和 102 是目标音频的起止标记。音频特征轨道与文本标记逐位置对齐:参考潜块只出现在 103 与 104 之间,目标潜块只出现在 101 与 102 之间,其余位置由零声学块占位。文本掩码与音频掩码互斥,模型据此知道每个时间步应该读取文字还是声学向量。
更重要的是损失掩码。参考段、文本段、音频起止标记与结束标记全部为零,只有目标音频的每个 patch 参与扩散损失。这样参考音色提供条件,却不会让模型学习“复制参考波形”;目标音频才是需要预测的监督信号。停止头使用另一个标签,在最后一个目标音频位置标记结束。局部声学模型的输入还采用当前声学表示与上一轮状态错位的排列,避免在预测下一块时直接看到答案。
| 训练字段 | 参考区间 | 文本区间 | 目标音频区间 |
|---|---|---|---|
| 文本轨道 | 103 与 104 包围参考位置 | 真实文本 token | 101 与 102 包围目标位置 |
| 声学轨道 | 参考 AudioVAE 潜块 | 零占位 | 目标 AudioVAE 潜块 |
| 损失掩码 | 全部为 0 | 全部为 0 | 目标 patch 为 1 |
| 停止标签 | 0 | 0 | 最后一个目标 patch 为 1 |
扩散部分采用条件流匹配。训练时从真实目标潜块与高斯噪声之间构造插值路径,模型回归噪声减目标的向量场;仓库默认使用欧拉求解器、对数正态时间调度,并在训练中对约 10% 的条件做丢弃,让推理阶段的无分类器引导有对应的条件与无条件分支。推理端默认十步采样,并使用带零初始化的引导缩放。这里没有额外的离散声学交叉熵,误差主要通过连续潜空间回归传递。
流式部署、微调与真实资源成本
VoxCPM2 支持一次性生成和流式生成。一次性接口在全部 patch 生成完毕后解码整段潜序列;流式接口每生成一个 patch 就交给有状态 AudioVAE 解码器,先返回一段波形。流式模式会在生成前重用提示音频尾部若干 patch 作为声学前缀,降低块边界突变。仓库还提供提示缓存,可把固定参考音色的编码与语言模型预填充结果复用到多次请求,避免每条文本都重新编码参考音频。
运行环境方面,README 给出的要求是 Python 3.10 以上且低于 3.13、PyTorch 2.5 以上、CUDA 12 以上。官方安装说明给出基础 PyTorch 推理约 8 GB 显存;Docker 微调文档建议至少 16 GB,显存更宽裕时体验更好。这里的“8 GB”属于项目提供的部署参考,不是所有后端、批大小、上下文长度和并发组合的硬保证。
| 场景 | 项目给出的参考 | 上线时应验证 |
|---|---|---|
| 标准 PyTorch,RTX 4090 | 实时因子约 0.30 | 目标句长、扩散步数、批大小和并发下的端到端延迟 |
| Nano-vLLM 或 vLLM-Omni,RTX 4090 | 实时因子约 0.13 | 批处理吞吐、缓存命中、OpenAI 兼容接口的实际限制 |
| Apple M4 Pro,Q8 GGUF | 实时因子约 1.76 | 这不是实时速度;端侧可用性需按设备、量化和流式块延迟实测 |
| 基础推理 | 约 8 GB 显存 | 保存完整上下文、并发请求与声码器状态后的峰值 |
| Docker 微调 | 至少 16 GB 显存 | 全参数更新、优化器状态与更长样本会抬高占用 |
微调提供全参数与 LoRA 两条路。VoxCPM2 的 LoRA 配置默认作用于两个语言模型与局部扩散变换器,默认不作用于投影层;仓库示例使用秩 32、缩放系数 32。全参数配置的学习率为 1e-5,LoRA 配置为 1e-4。官方 README 声称五到十分钟音频即可适配特定说话人、语言或领域,但这应理解为“可以开始实验”的样本门槛,不是达到生产音质、覆盖口音和避免过拟合的充分条件。微调前应单独留出说话人、文本域和录音条件都不重合的验证集。
工程选型还要区分“实时因子”和“首包时间”。即使长句的实时因子低于 1,流式首块仍要等待语言模型预填充、至少一个扩散 patch 和声码器启动。固定参考音色时,提示缓存能显著减少每次请求的重复工作;多音色并发时,缓存容量与显存又会成为新的瓶颈。生产服务应分别记录首包延迟、每秒生成音频时长、尾包延迟和失败重试率。
项目自报指标说明什么,又遗漏了什么
下列数字来自 VoxCPM2 仓库 README,是项目团队组织的评测结果,不应写成第三方独立复现。Seed-TTS 是零样本语音合成常用评测集,词错误率或字错误率衡量可懂度,说话人相似度衡量音色接近程度。VoxCPM2 自报英文 WER 1.84、相似度 75.3,中文 CER 0.97、相似度 79.5,困难测试集 CER 8.13、相似度 75.3。它们说明仓库在若干公开子集上具有竞争力,但不能直接外推到噪声、远场、电话带宽、儿童声音或专业配音场景。
| 项目自报评测 | 指标 | 结果 | 阅读边界 |
|---|---|---|---|
| Seed-TTS 英文 | WER 越低越好 | 1.84% | 主要反映测试文本和参考条件下的可懂度 |
| Seed-TTS 英文 | SIM 越高越好 | 75.3% | 相似度指标不等同于人工听感的全部维度 |
| Seed-TTS 中文 | CER 越低越好 | 0.97% | 中文分词、数字与多音字处理会影响统计 |
| Seed-TTS 中文 | SIM 越高越好 | 79.5% | 需要独立检查情绪、语速与录音条件变化 |
| Seed-TTS 困难集 | CER / SIM | 8.13% / 75.3% | 困难集与常规集不可混为一谈 |
| 内部 30 语种 ASR | 平均错误率 | 1.68% | 30 个语种各 500 条,用 Gemini 3.1 Flash Lite 转写 |
30 语种平均错误率尤其需要拆开看。这个内部评测由项目团队构建样本,并通过一个指定的外部 ASR 接口判断转写是否一致;它衡量可懂度,不衡量音色自然度、情感准确性、方言真实性或长文本稳定性。README 同时声称支持九种中文方言,但公开材料没有给出一张与 30 语种内部测试同等细粒度的方言分项表,因此本文不把方言覆盖写成已经独立验证的结论。仓库列出的多语言基准里还存在明显的语言差异,例如部分语种的错误率远高于平均值,选型时应按实际业务语言单独测试。
音色设计的 InstructTTSEval 结果能说明模型对描述的可控性,但不能替代真实产品评估。描述词是否被正确理解、生成结果是否稳定、不同说话人之间是否可区分、相同描述多次采样是否一致,需要分别测。作者已经承认音色设计与可控克隆的稳定性仍是限制,并建议同一请求尝试一到三次。这类指标适合做模型比较,不适合作为“任何描述都能稳定生成”的产品承诺。
语音克隆带来的风险不能留到上线后再处理
VoxCPM2 的能力边界天然包含高保真说话人模仿。项目 README 明确禁止将其用于冒充、诈骗和虚假信息,并建议清楚标注 AI 生成内容。许可证允许商业开发并不意味着可以绕过人格权、隐私权、数据保护、消费者保护或平台规则。对真实人物声音进行克隆时,至少需要明确的权利基础与可验证的同意记录;对第三方上传的音频,还要确认平台是否取得了足以训练、克隆和生成衍生语音的授权。
技术防护应和数据治理一起设计。服务端可以限制参考音频时长与来源,不把原始生物特征音频长期留存,对生成音频加入不可感知或可验证的来源标记,对高风险文本触发人工审核,并为声音所有者提供投诉和撤下通道。仅依赖“禁止冒充”的使用条款不够,因为模型一旦开放,滥用路径往往发生在平台外。若产品面向公众,还应准备冒用事件的应急响应流程,而不是等第一起投诉再补。
训练数据治理也需要继续追问。README 给出了超过 200 万小时的训练规模与语种覆盖,但仓库本身没有在页面中完整展开每个数据源的授权、说话人同意、地域分布、去重方法、敏感内容过滤和生物特征数据保留周期。Apache-2.0 是代码与项目声明的模型许可,不等于所有训练素材都已获得无限制商业使用授权,也不等于部署者自动满足各地对声音生物特征的规定。采购或商用前应要求供应方提供数据 provenance、许可清单和删除机制。
| 风险 | 最低控制 | 验收证据 |
|---|---|---|
| 冒充与诈骗 | 身份验证、合成标记、高风险文本审核 | 冒用测试、拦截日志、人工复核记录 |
| 未经同意克隆 | 声音权利声明、同意凭证、投诉撤下流程 | 授权记录、删除时限、第三方审计 |
| 生物特征泄露 | 最小化留存、传输加密、访问审计 | 数据流图、保留周期、密钥与权限审计 |
| 训练素材版权 | 来源清单、许可核验、按地域限制 | 数据集卡、许可矩阵、供应链承诺 |
| 多语种质量误判 | 按业务语种建立盲测集 | 独立可懂度、自然度、相似度与稳定性报告 |
适合怎样的落地方式
VoxCPM2 最适合需要本地部署、可微调、48 kHz 输出和多种克隆条件的语音工作流,例如有明确声音授权的角色配音、企业自有播音员、无障碍朗读、交互式设备和多语种内容原型。它不应该是“上传任意人的声音即可生成”的无门槛接口。对于新闻播报、金融通知、医疗沟通和政府公告,还应把生成音频置于更强的人审、签名和来源验证流程中,因为这些场景的错误代价远高于普通娱乐内容。
上手建议与结论
第一次试用应从固定模型版本、固定随机种子和十步扩散开始,先比较无参考、音色设计、短参考克隆与续写克隆四种路径,再决定是否需要 LoRA。验证集不要只放同一说话人的干净录音,应加入目标业务里的口音、语速、数字、专有名词、背景噪声和长句。衡量指标至少包含字词错误率、首包延迟、完整生成延迟、人工自然度、相似度、重复或漏词率,以及失败后重试能否稳定收敛。
VoxCPM2 的核心价值不是“采样率写到了 48 kHz”,而是把连续声学潜表示、语义语言模型、残差声学语言模型与局部扩散组织成一条可训练、可流式、可微调的语音生成链。它的实现细节足够透明,适合工程团队做深入评估;但公开指标仍以项目自报为主,语种覆盖、方言质量、训练数据 provenance 和声音滥用风险都还没有被仓库页面完整回答。把模型当作一个强力的可授权语音生成组件,而不是天然可信的“任意声音复制器”,才是更稳妥的采用方式。