OPEN SOURCE DEEP DIVE
audio.cpp:把 110+ 个本地音频模型收进同一个 C++ 运行时
基于 ggml 的纯 C++ 音频推理框架,把 TTS、声音克隆、语音转换、语音识别、说话人分离、VAD、源分离、音频编解码与音乐生成等 110 多个模型族收进同一套原生运行时,后端覆盖 CUDA、HIP、Vulkan、Metal 与纯 CPU,入口有 CLI、OpenAI 风格服务、内嵌 WebUI 与 JSON 流水线;同机对拍 Python 参考实现,多条 TTS 路径快 1.8 到 5 倍,Q8 量化包最高降低 37% 峰值显存。
audio.cpp 是一个基于 ggml 的纯 C++ 音频推理框架:把 TTS、声音克隆、语音转换、语音识别、说话人分离、VAD、源分离、强制对齐、音频编解码乃至音乐与音效生成等一百多个模型族,收进同一套原生运行时里统一执行。截至 v0.9.1(2026-10-07),仓库收录 110 多个模型族、190 多个变体,运行在 Windows、Linux、macOS 上,后端覆盖 CUDA、HIP/ROCm、Vulkan、Metal 与纯 CPU。它要回答的问题很直接:本地音频模型能不能不靠十几个 Conda 环境和几百个 Python 包,也能跑得快、跑得稳、跨平台迁移不折腾。
它解决什么问题:把音频模型从 Python 环境里解放出来
本地音频生态的痛点不在模型本身,而在部署形态。同一个 TTS 模型一个仓库、一套依赖、一种推理脚本;换一家 ASR 再装一遍;语音转换又是第三套。README 开篇的描述很坦白:想试几个音频模型,就要在 Conda 环境、Python 包和依赖冲突之间反复周旋。audio.cpp 的做法是给这些彼此独立的研究代码一条共享的原生执行路径:模型权重按 GGUF 或原始精度加载,计算图落在 ggml 上,后端选择、会话管理、批处理、流式输出由框架统一负责,Python 只出现在少数模型的权重准备环节,而不是推理路径上。
第二个痛点是认知成本。音频模型的命名、谱系和架构差异极大,README 直接给出任务标签表:TTS、Clone、VC、S2S、ASR、Classify、Wake、Align、VAD、Diar、Codec、Sep、MIDI、Music、SFX、Edit、Design、Dialogue、Ctrl 共 18 类。配套的 Audio Model Architecture Atlas 把 107 个模型族按共享构件画成一张可交互的谱系图,读者能直接看到哪些模型共用同一个 AR 主干、哪一个声码器、哪一类 codec。这张图谱与仓库本体是同一套认知的两个出口。
架构:一层共享框架,84 个模型族目录
代码组织上,audio.cpp 把「框架」与「模型」切成两层。src/framework/ 是共享层:runtime/ 下有 session.cpp(会话生命周期与可复用状态)、graph_executor.cpp 与 graph_optimizer.cpp(ggml 计算图的执行与优化)、kv_cache.cpp、flow_kv_cache.cpp、bounded_static_kv_decode.cpp(自回归与 flow 两类解码的缓存)、greedy_causal_decoder.cpp、registry.cpp(模型族注册)等;同层还有 codecs/、conditioners/、decoders/、tokenizers/、modules/、model_spec/、package_manager/、sampling/ 等子目录,把声码器、条件编码、采样策略这些跨模型复用的部件单独沉淀。
src/models/ 下是 84 个模型族目录(ace_step、apollo、chatterbox、cosyvoice3、qwen3_tts、vibevoice 等),每个目录是一个模型族的加载器与执行路径;新移植先落 src/community_models/,评审负担比核心模型轻但仍要求可复现验证。src/capi/audiocpp.cpp 对外暴露 C ABI,是 Node.js 包装、Homebrew 分发等下游集成的入口。应用层在 app/:cli/、server/、streaming/、workflow/、model_manager/、gguf/,分别对应命令行、HTTP 服务、流式会话、JSON 流水线、模型下载管理与 GGUF 打包工具。
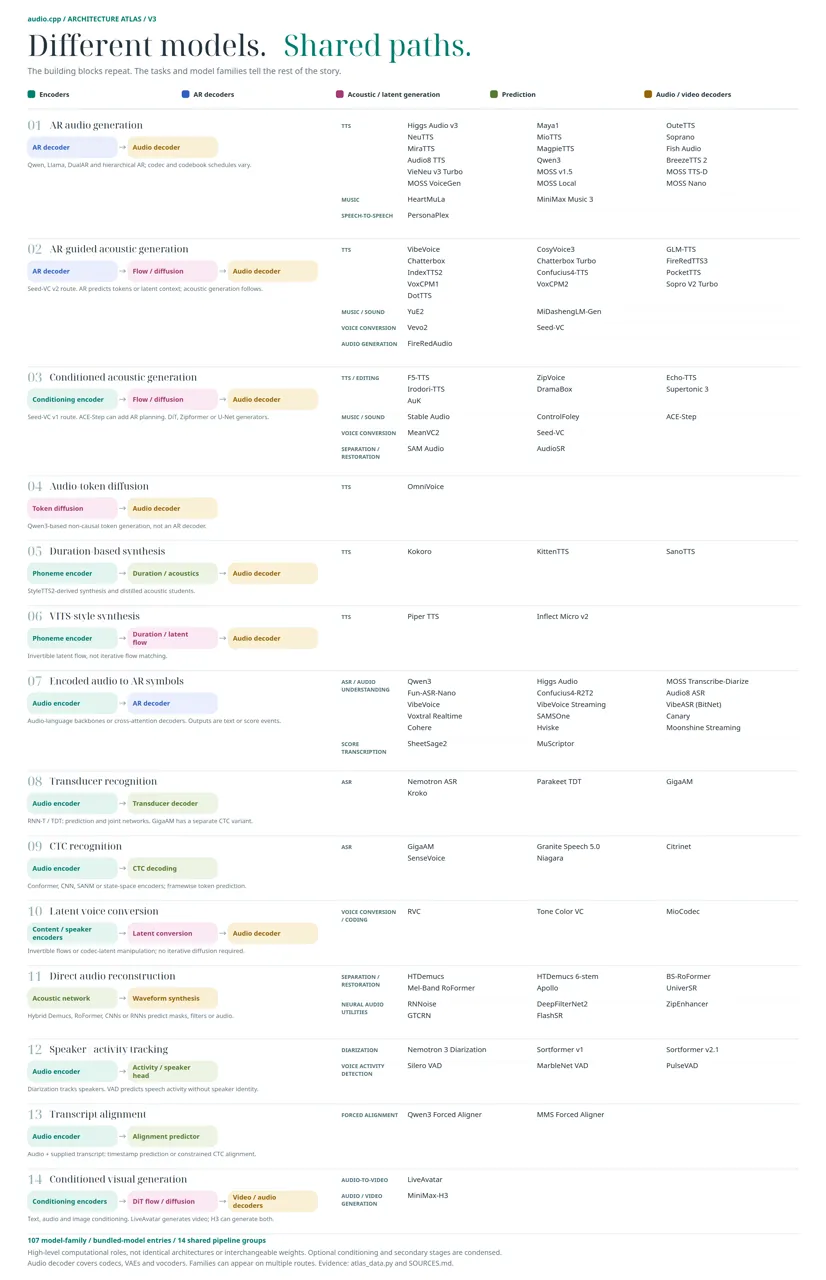
这套分层的收益在发布节奏上看得很清楚:0.5 到 0.9.1 五个版本里,模型族数量从 44 涨到 110 以上,而新增模型多数是「接已有共享构件」而非重写推理栈。README 里那句目标陈述就是这个意思:提供高度优化、可复用的音频模型构件,让新模型接入更快、共享部件改一次惠及多个家族、真实端到端推理路径保持高效与可维护。
任务覆盖:一张任务乘技术的矩阵
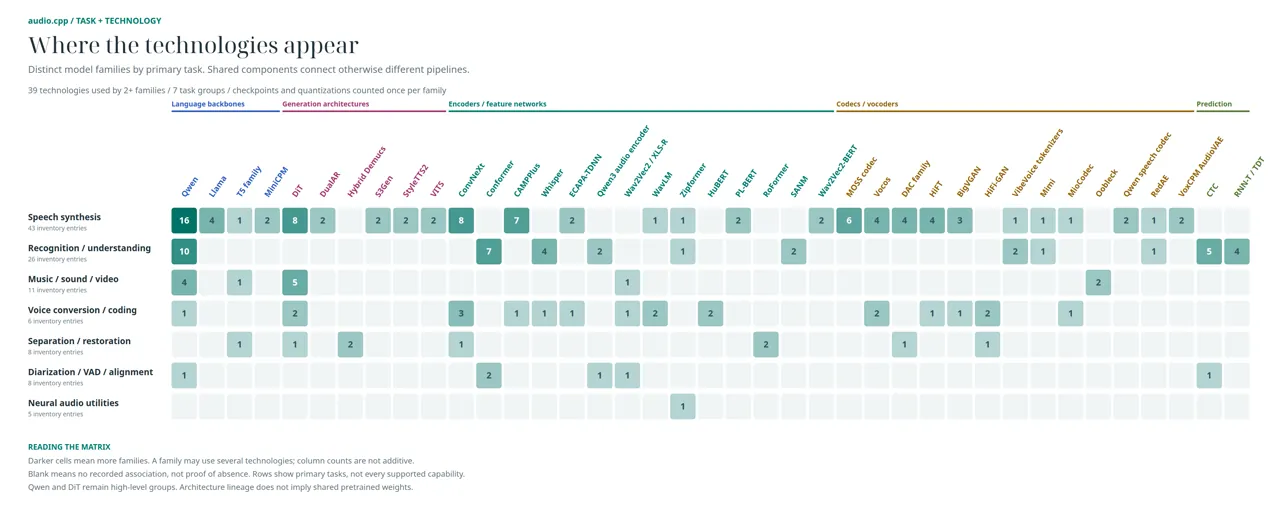
仓库自带的任务乘技术矩阵把覆盖范围说得很具体:语音合成方向 43 条模型记录,识别与理解 26 条,音乐/声音/视频 11 条,语音转换与编码 6 条,分离与修复 8 条,说话人分离/VAD/对齐 6 条,神经音频工具 3 条。技术列上,Qwen 系主干出现在 16 个家族里,DiT 与 ConvNeXt 各 8 个,CAM++ 7 个,MOSS codec 6 个;语言主干、生成架构、编码器、codec 与预测头五段各自成列,读者能一眼看出某个技术栈被哪些任务复用。
四种使用形态:CLI、OpenAI 风格服务、WebUI、JSON 流水线
入口层面,audio.cpp 给了四条路径。audiocpp_cli 是最直接的形态,--metrics 会打印离线端到端耗时、音频时长、RTF、实时倍速、采样率与声道数;audiocpp_server 提供 OpenAI 风格的 /v1/audio/speech、/v1/audio/transcriptions 以及更通用的 /v1/tasks/run、/v1/tasks/batch,现有 OpenAI 客户端代码改一个 base_url 就能接进来;内嵌的 SvelteKit WebUI 用 --ui 起在 8080 端口,带 Arena 标签页(同一输入排队多个模型或 GGUF 变体横向对比、带指标排序)与实验性的生成历史;app/workflow 支持 JSON 流水线,assets/pipeline/speech_redub.json 这类文件把多步任务串成一条可复现的链。编译侧还有 AUDIOCPP_MODEL_SET=full|core|custom 的复合构建开关,按需裁剪要编进二进制的模型族。
性能证据:与 Python 参考实现同机对打
性能章节的口径值得单独说:所有 Python 相对数字都在同一台 Ubuntu + RTX 5090 + CUDA 后端上,用框架运行时 API 直接对拍 audio.cpp 与对应 Python 参考路径,而不是拿 CLI 端到端数字去比;作者同时声明这批数字测于初版发布,多条路径此后已有明显改进,应读作「发布基线」而非「当前峰值」。
| 模型(单次请求) | 相对 Python 加速 | 端到端耗时降幅 |
|---|---|---|
| vevo2 | 5.03x | -80.11% |
| pocket_tts | 3.68x | -72.80% |
| miotts | 2.73x | -63.39% |
| moss_tts_local | 2.33x | -57.07% |
| qwen3_tts | 1.83x | -45.34% |
| vibevoice | 1.40x | -28.75% |
长会话形态(同一已加载会话连续服务多个请求)下增益依旧:pocket_tts 3.22x、qwen3_tts 2.74x、moss_tts_local 2.66x。这一列对真实应用更重要,因为模型加载、缓存状态与运行时初始化成本被摊到多次请求上。绝对速度看 RTF 表更直观:
| 模型 / 形态 | 音频时长 (s) | 实测耗时 (s) | RTF | 相对实时倍速 |
|---|---|---|---|---|
| pocket_tts(单次请求) | 8.08 | 0.26 | 0.032 | 31.09x |
| moss_tts_local(单次请求) | 9.60 | 0.97 | 0.101 | 9.91x |
| omnivoice(单次请求) | 9.00 | 1.32 | 0.146 | 6.84x |
| miotts(单次请求) | 20.40 | 3.30 | 0.162 | 6.18x |
| supertonic(长文本, CUDA) | 379.32 | 2.02 | 0.005 | 187.62x |
| supertonic(长文本, CPU) | 379.40 | 61.40 | 0.162 | 6.18x |
| pocket_tts(长文本) | 353.12 | 7.30 | 0.021 | 48.40x |
| vibevoice(长文本, 4 说话人) | 5615.73 | 1376.84 | 0.245 | 4.08x |
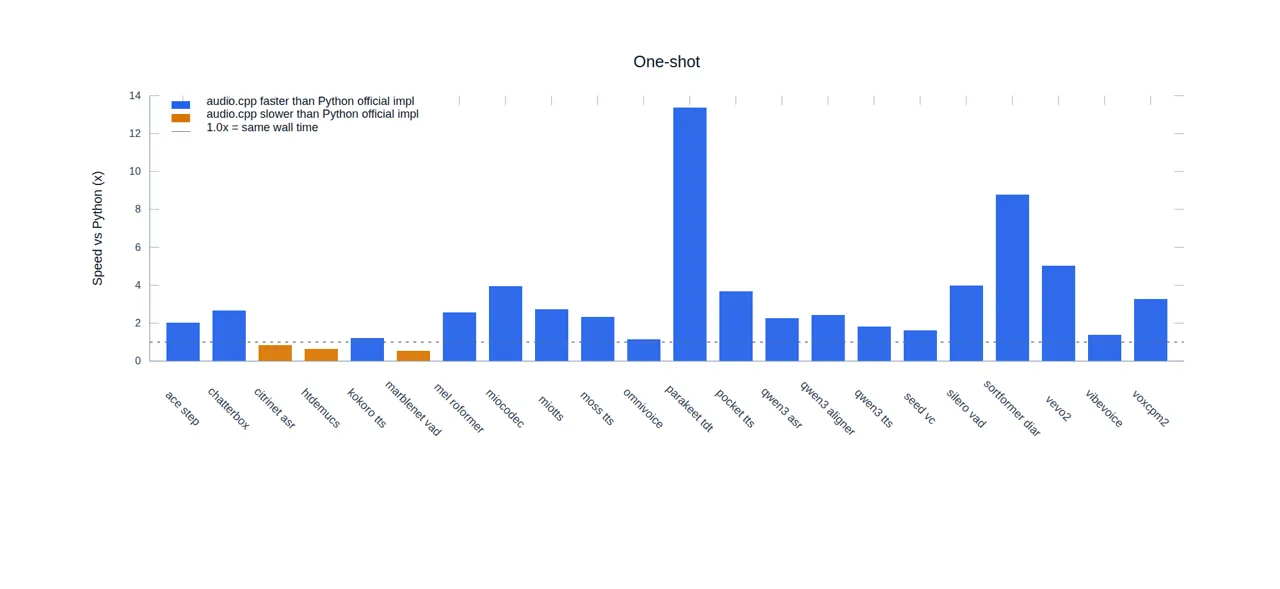
几个有代表性的实测数字:VibeVoice 1.5B 在 10 个扩散步、不做量化的条件下,18.2 分钟生成 93.9 分钟播客音频,约 5.15 倍实时;Supertonic 3 在 RTX 5090 上 3 分钟生成约 10 小时音频,CUDA 流式模式首包延迟 47 毫秒;在 TranscrIA 的法语真实会议音频基准上,audio.cpp 的 Nemotron 3.5 ASR 与其他实现打平 WER,端到端耗时只用了约四分之一。
GGUF 与量化:省显存是真,提速要逐模型验证
audio.cpp 的模型分发以 GGUF 包为主(Hugging Face 的 audio-cpp/audio.cpp-gguf 与 ModelScope 镜像),Q8 报告给出的结论是:测试包最高 1.53 倍提速、峰值显存降 37%。显存一列对消费级显卡意义最大:
| 模型 | 16-bit 峰值显存 (GiB) | Q8 峰值显存 (GiB) |
|---|---|---|
| higgs_audio_tts | 9.1 | 5.9 |
| fish_audio | 11.8 | 7.5 |
| voxtral_realtime | 10.7 | 7.6 |
但作者对量化的态度是少见的克制:低精度是「按模型、按路径」的优化,不是全局安全默认。ACE-Step 1.5 的低精度运行会在运行时报 ACE-Step planner masked decode found no valid token 而高精度正常完成;VeVo2 的非 fp32 输出在仓库自带的波形与 log-mel 相似度指标下明显偏离 fp32 参考,连输出长度都会漂移;而 Qwen3-TTS 上 q8_0 只比默认快约 3.8%,换来的是约 25% 的峰值显存下降。省显存买得到,免费午餐没有。
工程方法:一致性门禁与诚实的负结果
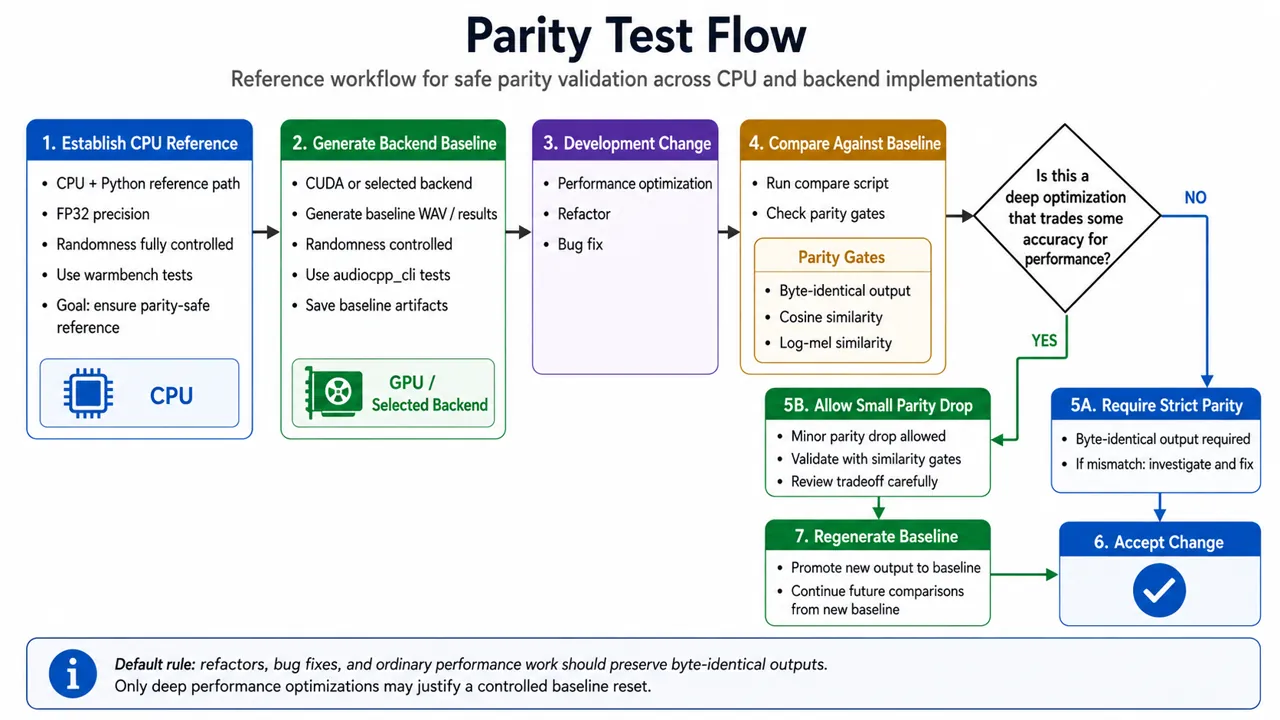
一个把 100 多个模型族塞进同一运行时的项目,最大的风险是「优化改坏了某个没人天天跑的路径」。audio.cpp 的对策是一套写进文档的一致性对拍工作流:先在 CPU 上以 fp32、完全受控的随机性建立 Python 参考输出,再为 CUDA 或目标后端生成基线 WAV;任何性能优化、重构或缺陷修复之后跑对比脚本,过三道门禁(字节一致、余弦相似度、log-mel 相似度);只有确属「以少量精度换性能」的深度优化才允许走受控的基线重置,普通改动必须保持字节一致。tests/warmbench.py 是这套对拍的执行器,tools/audiocpp_cli/run_audiocpp_cli_path_tests.py 则覆盖 CLI 路径。
局限与风险
把作者自己声明与实测能验证的部分放在一起:其一,性能数字是初版发布基线,仓库明说多条路径此后已大幅改进,引用时不应当作当前峰值;其二,GGUF 在这里是容器而非万能适配器,llama.cpp 或 whisper.cpp 的 GGUF 文件不会因为格式相同就自动兼容,张量名与元数据必须映射到对应模型族的实现;其三,Build_xcframework.sh 已经过时,框架重构后 Metal 与 Apple XCFramework 打包仍未重测;其四,lazy_load 只负责懒加载、不负责卸载,常驻多模型要靠 max_loaded_models 之类的上限控制;其五,部分模型的权重准备仍需要 Python 侧的管理器工具,「推理无 Python」不等于「全链路无 Python」;其六,后端与模型覆盖是 因模型而异的,同一后端在不同 family 上的支持度并不齐平。
生态位
audio.cpp 已经开始扮演「音频推理底座」的角色:Unsloth Studio 的语音、音乐与语音转文字由它驱动;FunASR 平台给出 Fun-ASR-Nano 与 SenseVoice 的部署示例;下游列表里有 16 个项目,包括把 /v1/audio/speech 包成零 Python Node.js 微服务的 AIRI Audio Server;Hugging Face 上有 audio-cpp/audio.cpp-gguf 权重仓与 Architecture Atlas 互动站点,macOS 侧有 Homebrew 分发渠道。对一个 2026 年 6 月才创建、10 月已到 v0.9.1 的仓库来说,这个生态扩张速度本身就是信号。
总结
audio.cpp 的价值不在某一个模型跑得多快,而在于它把「本地音频模型」从一堆互不相通的研究仓库,变成了同一套原生运行时上的可组合能力:共享框架层沉淀会话、计算图、缓存与声码器,模型层以模型族为单位快速接入,应用层给出 CLI、OpenAI 风格服务、WebUI 与 JSON 流水线四种出口。性能上有同机对拍的硬数字(TTS 多条路径 1.8 到 5 倍于 Python,Supertonic 3 长文本 187 倍实时),工程上有一致性门禁与公开负结果兜底,局限也写得坦白。对于需要在本机或自有服务器上跑 TTS、ASR、语音转换与分离的团队,它是目前少见的「推理路径不欠 Python 债」的选择。