
VINO:无标签三维场景表征学习
视频加载中
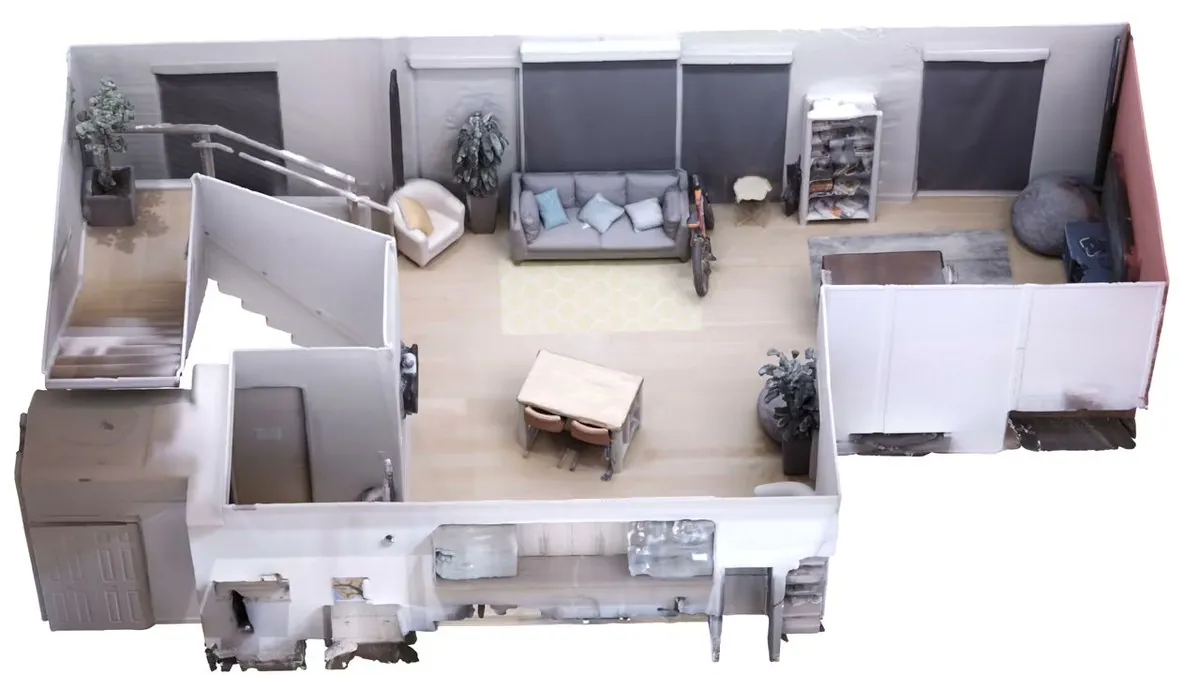
视频加载中VINO 用面向三维场景的 Volume Transformer 和重新设计的训练目标,仅从点云学习语义特征,探索三维自监督学习的通用表征。
Category: perception
Author: @robotsdigest
Date: 2026-11-07T00:00:00
Duration: 13.8s
VINO 用面向三维场景的 Volume Transformer 和重新设计的训练目标,仅从点云学习语义特征,探索三维自监督学习的通用表征。
 3:20
 0:49
 0:27
 0:44
 2:17
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。